Co to jest histogram?
Histogram (ang. histogram) to wykres rozkładu zmiennej ilościowej: zakres wyników dzieli się na sąsiadujące przedziały (klasy), a wysokość każdego słupka pokazuje, ile obserwacji wpadło do danego przedziału. Słupki przylegają do siebie, bo przedziały tworzą ciągłą skalę ilościową. Na osi pionowej można przedstawić liczebność, odsetek albo gęstość.
Histogram pokazuje to, czego nie widać w statystykach opisowych: kształt rozkładu, skośność, liczbę szczytów, luki i obserwacje odstające. Mimo to w publikacjach pojawia się rzadko. Weissgerber i in. (2015) przejrzeli 703 artykuły z czołowych czasopism fizjologicznych: dane ciągłe przedstawiano głównie na wykresach słupkowych i liniowych, a histogramy, wykresy rozrzutu i pudełkowe były rzadkością – choć słupki średnich mogą wyglądać identycznie dla zupełnie różnych rozkładów.
Jak powstaje histogram – krok po kroku
Przykład (dane symulowane): 160 studentów napisało kolokwium ze statystyki (0–40 pkt). 90 osób chodziło na dodatkowe ćwiczenia, 70 – nie. Średnia wynosi M = 23.04 (SD = 7.98), a wyniki mieszczą się od 7 do 39 punktów.
- Wyznacz zakres – skala kolokwium ma 0–40 punktów.
- Wybierz szerokość przedziału – np. 4 punkty, co daje 10 przedziałów: (0, 4], (4, 8] … (36, 40].
- Policz wyniki w każdym przedziale – w naszych danych kolejno: 0, 4, 12, 26, 26, 9, 37, 26, 17 i 3 osoby.
- Narysuj słupki o wysokości równej liczebności, bez przerw między nimi.
Zapis (20, 24] oznacza, że przedział nie zawiera 20, ale zawiera 24 – tak domyślnie liczą R i ggplot2. Ma to znaczenie przy danych całkowitych, gdy wyniki leżą dokładnie na granicach przedziałów.
Szerokość przedziału zmienia obraz
Ten sam zbiór danych może dać zupełnie różne histogramy. Rysunek 1 pokazuje wyniki kolokwium przy trzech szerokościach przedziału.
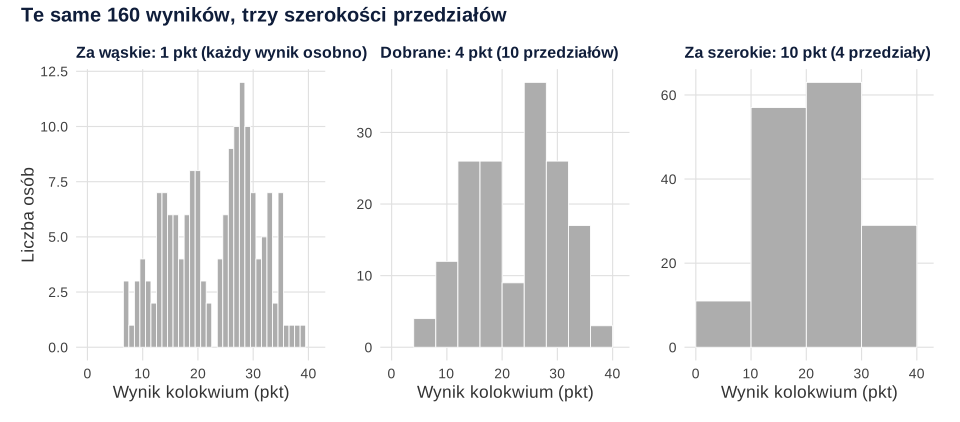
Przy przedziałach 1-punktowych widać głównie przypadkowe wahania. Przy 10-punktowych histogram sugeruje jeden szczyt w środku skali (57 i 63 osoby w dwóch środkowych przedziałach). Dopiero przedziały 4-punktowe ujawniają dwie podgrupy: wokół 16 i wokół 28 punktów, z doliną między nimi – w przedziale (20, 24] jest tylko 9 osób. Zanim opiszesz kształt rozkładu, sprawdź kilka szerokości przedziału.
Punktem wyjścia mogą być reguły wbudowane w programy:
- reguła Sturgesa – liczba przedziałów k = ⌈log₂n + 1⌉; domyślna w R; dla naszych danych 9 przedziałów;
- reguła Scotta – szerokość zależna tylko od liczebności próby i odchylenia standardowego (w R: 3.5 × SD × n−1/3). Scott (1979) wyprowadził ją jako szerokość asymptotycznie minimalizującą błąd odwzorowania gęstości, z rozkładem normalnym jako punktem odniesienia; tu 5.14 punktu;
- reguła Freedmana–Diaconisa – zamiast SD używa rozstępu ćwiartkowego: 2 × IQR × n−1/3, więc jest mniej wrażliwa na wyniki skrajne; tu 4.79 punktu.
Reguły to tylko start. ggplot2 bez podanej szerokości rysuje 30 przedziałów i wyświetla komunikat, żeby wybrać lepszą wartość – potraktuj go poważnie. Przy wynikach całkowitych wybieraj szerokości będące liczbami całkowitymi.
Jak czytać kształt histogramu
| Kształt | Co zwykle oznacza | Przykład w psychologii |
|---|---|---|
| Symetryczny, jeden szczyt | rozkład zbliżony do normalnego | wyniki dobrze skonstruowanego testu inteligencji |
| Długi prawy ogon | skośność prawostronna | czasy reakcji, liczba objawów w próbie nieklinicznej |
| Skupienie przy maksimum skali | skośność lewostronna, efekt sufitu | zbyt łatwy test, zadowolenie z zajęć |
| Dwa szczyty | dwie podgrupy o różnych średnich | osoby uczestniczące i nieuczestniczące w treningu |
| Pojedyncze słupki daleko od reszty | obserwacje odstające, ciężkie ogony (kurtoza) | błąd wpisania danych, nieuważne odpowiedzi |
Przy rozkładzie dwumodalnym średnia może opisywać mało kogo: w naszym przykładzie tylko 15 osób (9.4%) uzyskało wynik od 21 do 25 punktów, czyli w pobliżu średniej 23.04. Najczęstszy wynik (dominanta) to 28 punktów.
Uważaj na małe próby. Histogram wymaga około 30 obserwacji (Krzywinski i Altman, 2014), a ocena normalności „na oko” ma sens raczej przy n > 50, bo w małych próbach nawet dane z populacji normalnej rzadko wyglądają normalnie (Kim, 2012). Przy kilkunastu osobach lepiej pokazać pojedyncze punkty albo wykres pudełkowy, a normalność oceniać na wykresie Q-Q.
Histogram a wykres słupkowy
| Cecha | Histogram | Wykres słupkowy |
|---|---|---|
| Rodzaj zmiennej | ilościowa | kategorialna (nominalna lub porządkowa) |
| Oś pozioma | skala liczbowa podzielona na przedziały | kategorie |
| Słupki | przylegają do siebie | oddzielone przerwami |
| Kolejność słupków | wyznaczona przez skalę | dowolna, np. według liczebności |
Odpowiedzi na pojedyncze pytanie w skali Likerta (1–5) pokazuj na wykresie słupkowym; histogram ma sens dla sumy lub średniej z wielu pozycji.
Histogram z krzywą gęstości
Na histogram można nałożyć krzywą gęstości (jądrowy estymator gęstości), czyli wygładzony obraz rozkładu. Pomaga ona zobaczyć ogólny kształt niezależnie od granic przedziałów. Rysunek 2 pokazuje, że krzywa ma dwa szczyty – przy 16.8 i 28.1 punktu – a średnia leży w dolinie między nimi.
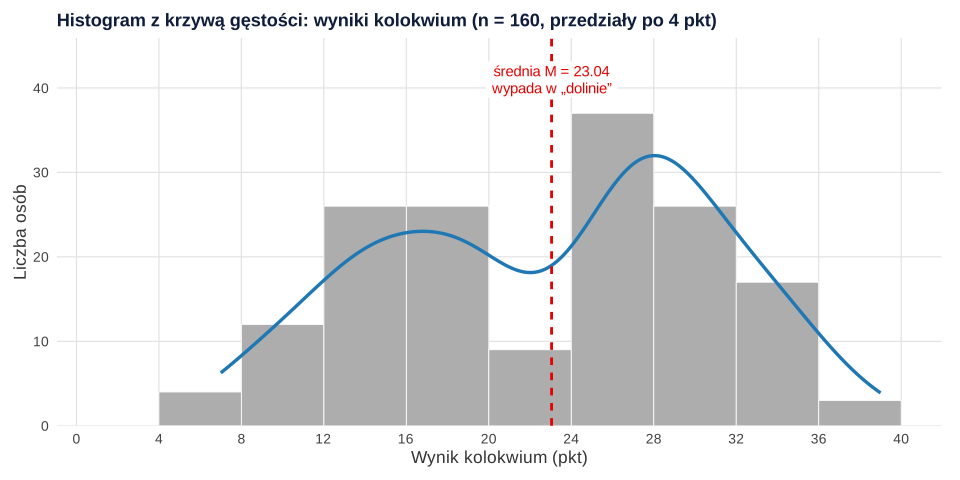
Krzywą gęstości traktuj jako ilustrację: jej kształt zależy od stopnia wygładzenia, a na brzegach może wychodzić poza możliwy zakres skali. Krzywa normalna nałożona dla porównania nie zastąpi oceny normalności.
Histogram w pracy dyplomowej – dobre praktyki
- Podpisz osie (zmienna i jednostka) i podaj liczebność próby.
- Szerokość przedziału wybierz świadomie i wpisz ją do podpisu.
- Porównując grupy, używaj tych samych przedziałów i tej samej skali osi (osobne panele jeden pod drugim).
- Nie stosuj efektu 3D, cieni ani wielu kolorów – jeden stonowany kolor wystarczy.
Przykładowy podpis rysunku w stylu APA:
Przykład w R
Kod odtwarza dane z przykładu, porównuje reguły doboru liczby przedziałów, liczy liczebności w przedziałach co 4 punkty i rysuje histogram z krzywą gęstości w pakiecie ggplot2 (rysunek 2 to ten sam wykres w stylu serwisu). W SPSS histogram narysujesz w menu Analiza → Opis statystyczny → Częstości → Wykresy → Histogramy.
Przedziały, liczebności i histogram w ggplot2
R
set.seed(5)
wyniki <- c(round(rnorm(90, 29, 4)), round(rnorm(70, 15, 4)))   # dwie podgrupy studentów
wyniki <- pmin(pmax(wyniki, 0), 40)                             # skala kolokwium 0–40 pkt

# ile przedziałów proponują reguły Sturgesa, Scotta i Freedmana–Diaconisa?
c(Sturges = nclass.Sturges(wyniki), Scott = nclass.scott(wyniki), FD = nclass.FD(wyniki))

# histogram „ręcznie”: przedziały co 4 pkt i ich liczebności
h <- hist(wyniki, breaks = seq(0, 40, by = 4), plot = FALSE)
data.frame(przedzial = paste0("(", head(h$breaks, -1), ", ", h$breaks[-1], "]"), n = h$counts)

# wykres do pracy: histogram z krzywą gęstości
library(ggplot2)
ggplot(data.frame(wyniki), aes(wyniki)) +
  geom_histogram(binwidth = 4, boundary = 0, fill = "grey70", colour = "white") +
  geom_density(aes(y = after_stat(count) * 4), colour = "#1f78b4", linewidth = 1) +
  labs(x = "Wynik kolokwium (pkt)", y = "Liczba osób") +
  theme_minimal(base_size = 13)
Wynik w R
Sturges   Scott      FD
      9       7       7
   przedzial  n
1     (0, 4]  0
2     (4, 8]  4
3    (8, 12] 12
4   (12, 16] 26
5   (16, 20] 26
6   (20, 24]  9
7   (24, 28] 37
8   (28, 32] 26
9   (32, 36] 17
10  (36, 40]  3
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Domyślna liczba przedziałów bez sprawdzenia – zbyt szerokie przedziały mogą ukryć dwa szczyty, zbyt wąskie – pokazać szum jako „kształt”.
- Porównywanie grup na histogramach o różnych przedziałach lub osiach – różnice w kształcie mogą wynikać z ustawień wykresu.
- Histogram dla zmiennej kategorialnej – dla kategorii i pojedynczych pozycji skali Likerta użyj wykresu słupkowego.
- Ocena normalności z histogramu małej próby – przy kilkunastu osobach kształt jest przypadkowy; sięgnij po wykres Q-Q.
- Słupki średnich zamiast rozkładu – wykres słupkowy średnich nie pokazuje, jak rozkładają się wyniki (Weissgerber i in., 2015).
Najczęstsze pytania
Co pokazuje histogram?
Histogram pokazuje rozkład zmiennej ilościowej: gdzie skupia się większość wyników, jak bardzo są rozproszone, czy rozkład jest symetryczny lub skośny, ile ma szczytów i czy występują wyniki odstające. Wysokość słupka to liczba (albo odsetek) obserwacji w danym przedziale.
Ile przedziałów powinien mieć histogram?
Nie ma jednej poprawnej liczby. Punktem wyjścia są reguły: Sturgesa (domyślna w R), Scotta (oparta na odchyleniu standardowym) i Freedmana–Diaconisa (oparta na rozstępie ćwiartkowym). Sprawdź kilka szerokości – zbyt szerokie przedziały mogą ukryć dwa szczyty, a zbyt wąskie pokazują głównie szum.
Czym różni się histogram od wykresu słupkowego?
Histogram przedstawia zmienną ilościową podzieloną na przylegające przedziały, a kolejność słupków wynika ze skali. Wykres słupkowy przedstawia kategorie (np. płeć, kierunek studiów), więc słupki są oddzielone i można je dowolnie uporządkować.
Jak zrobić histogram w R?
Najprościej funkcją hist(x), a do pracy – w pakiecie ggplot2: ggplot(dane, aes(x)) + geom_histogram(binwidth = 4). Zawsze ustaw binwidth świadomie, bo bez niego ggplot2 dzieli dane na 30 przedziałów.
Czy z histogramu można ocenić normalność rozkładu?
Tylko orientacyjnie i przy większych próbach – Kim (2012) zwraca uwagę, że w małych próbach nawet dane z populacji normalnej rzadko wyglądają normalnie. Do oceny normalności lepiej nadaje się wykres kwantylowy Q-Q, a w modelach – rozkład reszt.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Rozkład zmiennej na wykresie
Histogram przy czterech szerokościach przedziału, gęstość za gładka i za szorstka, ECDF, dwie grupy i skala Likerta – sześć rysunków z kodem R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kim, H.-Y. (2012). Statistical notes for clinical researchers: Assessing normal distribution (1). Restorative Dentistry & Endodontics, 37(4), 245–248. https://doi.org/10.5395/rde.2012.37.4.245 ● Otwarty dostęp
- Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@article{kim2012assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (1)}}, journal={Restorative Dentistry \& Endodontics}, year={2012}, volume={37}, number={4}, pages={245--248}, doi={10.5395/rde.2012.37.4.245}}@article{krzywinski2014visualizing, author={Krzywinski, Martin and Altman, Naomi}, title={{Visualizing samples with box plots}}, journal={Nature Methods}, year={2014}, volume={11}, number={2}, pages={119--120}, doi={10.1038/nmeth.2813}}@article{scott1979optimal, author={Scott, David W.}, title={{On optimal and data-based histograms}}, journal={Biometrika}, year={1979}, volume={66}, number={3}, pages={605--610}, doi={10.1093/biomet/66.3.605}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}