Co to są kwartyle?
Kwartyle (ang. quartiles) to trzy wartości, które dzielą uporządkowane dane na cztery części o podobnej liczbie obserwacji (Mishra i in., 2019). Pierwszy kwartyl Q1 oddziela 25% najniższych wyników, drugi kwartyl Q2 to mediana, a trzeci kwartyl Q3 oddziela 25% najwyższych wyników. Kwartyle są szczególnym przypadkiem kwantyli: Q1 to 25., a Q3 – 75. percentyl.
Kwartyle opisują położenie i rozproszenie danych bez założeń o kształcie rozkładu. Między Q1 a Q3 leży środkowe 50% wyników, a ich różnica to rozstęp ćwiartkowy (IQR = Q3 − Q1). Razem z wartością najmniejszą i największą kwartyle tworzą pięcioliczbowe podsumowanie rozkładu, które przedstawia wykres pudełkowy. W statystyce opisowej są naturalnym uzupełnieniem mediany przy skośnych rozkładach, takich jak czasy reakcji.
Jak obliczyć kwartyle? Przykład krok po kroku
Weźmy czasy reakcji 12 pierwszych osób z przykładu w haśle średnia (zadanie Stroopa, próby niezgodne) i uporządkujmy je rosnąco:
| Pozycja | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Czas (ms) | 496 | 531 | 536 | 570 | 574 | 583 | 601 | 606 | 652 | 732 | 764 | 837 |
Mediana leży między szóstym a siódmym wynikiem: (583 + 601) / 2 = 592 ms – tu wszystkie metody są zgodne. Z kwartylami jest trudniej, bo „jedna czwarta” rzadko wypada dokładnie na którymś wyniku. Metody najpierw wyznaczają pozycję kwartyla w uporządkowanym szeregu, a potem interpolują między sąsiednimi wynikami:
- Pozycja (n + 1)p – typ 6 według klasyfikacji Hyndmana i Fana; tak liczy SPSS. Pozycja Q1 = 13 × 0.25 = 3.25, więc Q1 = 536 + 0.25 × (570 − 536) = 544.5 ms. Pozycja Q3 = 13 × 0.75 = 9.75, więc Q3 = 652 + 0.75 × (732 − 652) = 712 ms.
- Pozycja 1 + (n − 1)p – typ 7, domyślny w R. Pozycja Q1 = 1 + 11 × 0.25 = 3.75, więc Q1 = 536 + 0.75 × 34 = 561.5 ms; pozycja Q3 = 9.25, więc Q3 = 652 + 0.25 × 80 = 672 ms.
- Zawiasy Tukeya – tak liczy funkcja
boxplot()w R. Q1 to mediana dolnej połowy danych, (536 + 570) / 2 = 553 ms, a Q3 – mediana górnej połowy, (652 + 732) / 2 = 692 ms.
Te same 12 wyników daje więc trzy różne trzecie kwartyle: 712, 672 albo 692 ms, a rozstęp ćwiartkowy wynosi odpowiednio 167.5, 110.5 albo 139 ms. Żaden z tych wyników nie jest błędny – to różne konwencje.
Dlaczego R, SPSS i Excel dają różne kwartyle?
Kwartyl z próby da się zdefiniować na wiele sposobów. Langford (2006) doliczył się co najmniej tuzina metod stosowanych w podręcznikach i programach (m.in. SAS, Minitab i Excel), które dla tych samych danych dają różne wyniki. Hyndman i Fan (1996) zwracają uwagę, że nawet w jednym programie bywa jedna definicja przy liczeniu kwantyla, a inna przy rysowaniu wykresu pudełkowego czy Q-Q. Rysunek 1 pokazuje, skąd biorą się te różnice.
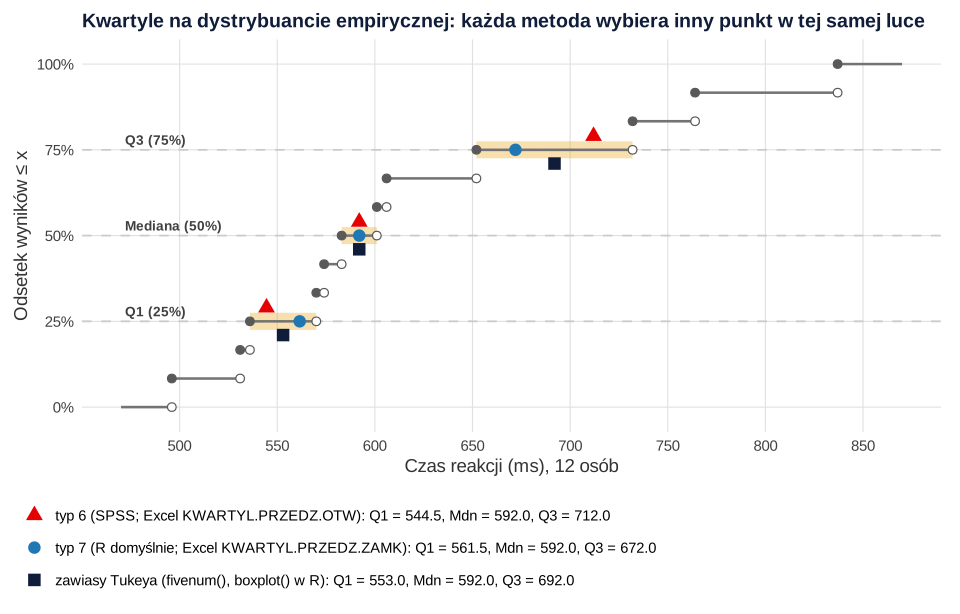
Dystrybuanta empiryczna pokazuje, jaki odsetek wyników jest nie większy niż x. Dokładnie 25% wyników jest nie większych niż każda wartość między 536 a 570 ms, więc definicja „wartość, poniżej której leży 25% danych” wskazuje cały przedział, a nie jeden punkt. Metody różnią się tym, który punkt z tej luki wybierają. Przy medianie luka jest wąska (583–601 ms), przy Q3 – szeroka (652–732 ms), stąd największa rozbieżność. W większych próbach luki się zwężają: dla wszystkich 120 osób Q1 wynosi 539.25 ms (typ 6) albo 541.75 ms (typ 7), a Q3 – 722.50 albo 719.50 ms.
| Program i funkcja | Metoda | Q1 (ms) | Q3 (ms) |
|---|---|---|---|
R: quantile(), summary(), IQR(); Excel: QUARTILE.INC (KWARTYL.PRZEDZ.ZAMK) | typ 7 | 561.5 | 672.0 |
| SPSS: Frequencies, Explore (wiersz Weighted Average); Excel: QUARTILE.EXC (KWARTYL.PRZEDZ.OTW) | typ 6 | 544.5 | 712.0 |
R: fivenum(), boxplot(); SPSS: Explore (wiersz Tukey's Hinges) | zawiasy Tukeya | 553.0 | 692.0 |
R: quantile(x, type = 8) | typ 8 | 550.2 | 698.7 |
Hyndman i Fan (1996) rekomendują jako standard estymator nieobciążony względem mediany – w R to type = 8. W praktyce ważniejsze od wyboru metody jest to, by stosować jedną konsekwentnie i napisać, jaką. Jeśli chcesz odtworzyć w R wyniki z SPSS, użyj quantile(x, type = 6).
Kwartyle, percentyle i normy
Kwartyle to tylko trzy z wielu kwantyli: decyle dzielą dane na dziesięć części, a percentyle (centyle) – na sto. W naszej próbie 10. percentyl czasu reakcji wynosi 508.8 ms, a 90. percentyl – 874.5 ms, więc około 10% osób odpowiadało szybciej niż 508.8 ms i około 10% wolniej niż 874.5 ms. Na percentylach opiera się wiele norm testowych: wynik osoby porównuje się z rozkładem w próbie normalizacyjnej. Kwantyle z próby wykorzystuje także wykres kwantylowy Q-Q, który zestawia je z kwantylami rozkładu teoretycznego.
Jak opisać kwartyle w pracy (APA)
Kwartyle podaje się najczęściej razem z medianą, gdy rozkład jest skośny: jako parę Q1 i Q3 albo w postaci IQR. W tabeli statystyk opisowych możesz dodać kolumny Q1 i Q3 (zob. tabela statystyk opisowych w APA). Ponieważ nie ma jednej metody liczenia kwartyli, Krzywinski i Altman (2014) zalecają, by w podpisie wykresu pudełkowego opisać sposób jego konstrukcji i liczebność próby – warto też podać program i metodę.
Porównując grupy, podaj medianę i kwartyle osobno dla każdej z nich. Jeśli ktoś będzie odtwarzał Twoje wyniki w innym programie, informacja o metodzie oszczędzi mu szukania „błędu”, którego nie ma.
Przykład w R
Kod porównuje kwartyle liczone różnymi metodami dla 12 osób i dla całej próby. W SPSS kwartyle obliczysz w menu Analyze → Descriptive Statistics → Frequencies → Statistics (Quartiles) albo w procedurze Explore (tabela Percentiles z wierszami Weighted Average i Tukey's Hinges).
Kwartyle trzema metodami
R
set.seed(53)
rt <- round(rnorm(120, mean = 500, sd = 50) + rexp(120, rate = 1 / 150))  # czasy reakcji (ms)
x <- rt[1:12]                                   # 12 pierwszych osób
sort(x)
quantile(x, c(0.25, 0.5, 0.75))                 # typ 7 – domyślny w R
quantile(x, c(0.25, 0.5, 0.75), type = 6)       # typ 6 – jak w SPSS
fivenum(x)                                      # min, zawiasy Tukeya, max (jak boxplot())
summary(x)                                      # kwartyle typu 7 i średnia
sapply(c(typ6 = 6, typ7 = 7, typ8 = 8),         # cała próba n = 120
       function(t) quantile(rt, c(0.25, 0.5, 0.75), type = t))
quantile(rt, c(0.10, 0.90))                     # percentyle 10 i 90
Wynik w R
 [1] 496 531 536 570 574 583 601 606 652 732 764 837
  25%   50%   75%
561.5 592.0 672.0
  25%   50%   75%
544.5 592.0 712.0
[1] 496 553 592 692 837
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
  496.0   561.5   592.0   623.5   672.0   837.0
      typ6   typ7     typ8
25% 539.25 541.75 540.0833
50% 594.50 594.50 594.5000
75% 722.50 719.50 721.5000
  10%   90%
508.8 874.5
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie kwartyli z różnych programów bez sprawdzenia metody – dla 12 osób Q3 wyniósł 672 ms w R i 712 ms według metody SPSS (Hyndman i Fan, 1996).
- Zapis „IQR = 541.75–719.50” – IQR to jedna liczba (Q3 − Q1 = 177.75); przedział zapisuj jako Q1 i Q3.
- Traktowanie kwartyla jak grupy osób – kwartyl to wartość graniczna. Jeśli dzielisz próbę na cztery grupy, nazwij je wprost, np. „25% osób z najkrótszym czasem reakcji”.
- Dzielenie zmiennej ciągłej na grupy kwartylowe bez potrzeby – tracisz informację i moc; jeśli to możliwe, analizuj zmienną w całości, np. w regresji liniowej.
- Kwartyle z bardzo małej próby – przy kilku obserwacjach metody dają bardzo różne wyniki; Krzywinski i Altman (2014) podają n = 5 jako minimum dla wykresu pudełkowego.
Najczęstsze pytania
Jak obliczyć kwartyle?
Uporządkuj wyniki rosnąco. Mediana (Q2) dzieli je na połowy, a Q1 i Q3 wyznacza się jako 25. i 75. percentyl, zwykle z interpolacją między sąsiednimi wynikami. W R: quantile(x, c(0.25, 0.5, 0.75)). Programy stosują różne metody, więc przy małych próbach wyniki mogą się różnić.
Dlaczego SPSS i R dają różne kwartyle?
Bo stosują różne definicje kwantyla z próby. SPSS wyznacza pozycję kwartyla jako (n + 1)p, co odpowiada typowi 6 w R, a R domyślnie używa typu 7. Dla 12 czasów reakcji z przykładu Q3 wyniósł 712 ms według metody SPSS i 672 ms w R. Aby uzyskać w R wynik jak w SPSS, użyj quantile(x, type = 6).
Co to jest pierwszy i trzeci kwartyl?
Pierwszy kwartyl (Q1) to wartość, poniżej której leży 25% uporządkowanych wyników, a trzeci kwartyl (Q3) – wartość, poniżej której leży 75% wyników. Między nimi mieści się środkowe 50% danych, a różnica Q3 − Q1 to rozstęp ćwiartkowy.
Czym różni się kwartyl od percentyla?
Kwartyle to szczególne percentyle: Q1 to 25., mediana – 50., a Q3 – 75. percentyl. Percentyle dzielą dane na 100 części, decyle na 10, a kwartyle na 4.
Jak zapisać kwartyle w APA?
Podaj je razem z medianą, np. Mdn = 594.50 ms (Q1 = 541.75, Q3 = 719.50) albo Mdn = 594.50 ms (IQR = 177.75). W opisie metody lub pod tabelą zaznacz, w jakim programie i jaką metodą liczono kwartyle.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w Excelu – zadania z rozwiązaniami
Dziesięć zadań z funkcjami Excela: odchylenie standardowe, kwartyle, CZĘSTOŚĆ, rozkład normalny, UFNOŚĆ.T, T.TEST, CHI.TEST, korelacja i REGLINP – z plikiem .xlsx.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →PoradnikBezpłatne programy do statystyki
jamovi, JASP, R, PSPP i G*Power: licencje, wersje i możliwości, ustawienia domyślne zmieniające wynik testu oraz wzory cytowania programu w pracy.
Czytaj →PoradnikStatystyka opisowa – zadania z rozwiązaniami
Dziewięć zadań jak na kolokwium: szeregi rozdzielcze, średnia ważona, mediana i kwartyle ze wzoru interpolacyjnego, wariancja, CV, skośność i reguła 1.5 IQR.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
- Langford, E. (2006). Quartiles in elementary statistics. Journal of Statistics Education, 14(3). https://doi.org/10.1080/10691898.2006.11910589 ● Otwarty dostęp
- Mishra, P., Pandey, C. M., Singh, U., Gupta, A., Sahu, C., & Keshri, A. (2019). Descriptive statistics and normality tests for statistical data. Annals of Cardiac Anaesthesia, 22(1), 67–72. https://doi.org/10.4103/aca.ACA_157_18 ● Otwarty dostęp
Cytowania BibTeX
@article{hyndman1996sample, author={Hyndman, Rob J. and Fan, Yanan}, title={{Sample quantiles in statistical packages}}, journal={The American Statistician}, year={1996}, volume={50}, number={4}, pages={361--365}, doi={10.1080/00031305.1996.10473566}}@article{krzywinski2014visualizing, author={Krzywinski, Martin and Altman, Naomi}, title={{Visualizing samples with box plots}}, journal={Nature Methods}, year={2014}, volume={11}, number={2}, pages={119--120}, doi={10.1038/nmeth.2813}}@article{langford2006quartiles, author={Langford, Eric}, title={{Quartiles in elementary statistics}}, journal={Journal of Statistics Education}, year={2006}, volume={14}, number={3}, doi={10.1080/10691898.2006.11910589}}@article{mishra2019descriptive, author={Mishra, Prabhaker and Pandey, Chandra M. and Singh, Uttam and Gupta, Anshul and Sahu, Chinmoy and Keshri, Amit}, title={{Descriptive statistics and normality tests for statistical data}}, journal={Annals of Cardiac Anaesthesia}, year={2019}, volume={22}, number={1}, pages={67--72}, doi={10.4103/aca.aca_157_18}}