Statystyka opisowa – zadania z rozwiązaniami: jak korzystać ze zbioru
Pierwsze kolokwium ze statystyki na ekonomii, zarządzaniu czy pedagogice prawie zawsze dotyczy statystyki opisowej. Trzeba ułożyć szereg rozdzielczy, policzyć z niego średnią, medianę i kwartyle, ocenić rozproszenie i asymetrię, a na koniec wskazać wartość odstającą. Poniżej znajdziesz statystykę opisową w zadaniach z rozwiązaniami: dziewięć zadań z danymi do policzenia na kalkulatorze, z historyjkami o gospodarstwach domowych, wynagrodzeniach, sprzedaży, obsłudze klientów i nieobecnościach uczniów.
Każde zadanie ma ten sam układ: treść z danymi, rozwiązanie krok po kroku (wzór, podstawienie, wynik pośredni, wynik końcowy), krótką interpretację i jeden typowy błąd. Najpierw spróbuj rozwiązać zadanie sam(a). Wszystkie liczby sprawdziliśmy w R (kod na końcu wpisu). Jeśli w rachunku ręcznym ostatnia cyfra wyjdzie inna, to zwykle skutek wcześniejszego zaokrąglenia.
Wzory dla szeregów rozdzielczych są standardowe i znajdziesz je w podręcznikach statystyki dla ekonomistów i menedżerów (np. Aczel i Sounderpandian, 2018) oraz dla pedagogów (King i Minium, 2009). Ten wpis to zbiór ćwiczeń, a nie wykład.
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | liczba osób w 40 gospodarstwach domowych | szereg rozdzielczy punktowy, częstości, częstości skumulowane |
| 2 | te same gospodarstwa | średnia, mediana i dominanta z szeregu punktowego |
| 3 | średnia ocen ze studiów i średnia cena w sklepie | średnia ważona |
| 4 | wynagrodzenia 80 pracowników firmy | szereg przedziałowy: średnia, mediana, kwartyle i dominanta (wzór interpolacyjny) |
| 5 | te same wynagrodzenia | wariancja, SD, współczynnik zmienności, współczynniki asymetrii |
| 6 | czas obsługi 10 klientów w okienku | kwartyle z danych surowych według różnych definicji |
| 7 | dzienna sprzedaż w dwóch oddziałach | współczynnik zmienności – porównanie grup |
| 8 | czas realizacji 15 zamówień | rozstęp, IQR, reguła 1.5 IQR, wykres pudełkowy |
| 9 | nieobecności 12 uczniów w semestrze | skośność momentowa i współczynnik Pearsona |
Dane do wszystkich zadań możesz pobrać w jednym pliku: statystyka-opisowa-zadania-dane.csv (format długi: zadanie, numer, grupa, zmienna, wartość, liczebność). Dla szeregów rozdzielczych kolumna „liczebność” zawiera wagi, a dla danych surowych ma wartość 1. Rachunki z danych surowych sprawdzisz też w kalkulatorze statystyk opisowych.
Zadanie 1. Szereg rozdzielczy punktowy i częstości skumulowane
Treść zadania
W ankiecie 40 gospodarstw domowych podało liczbę osób, które w nich mieszkają: 3, 2, 4, 1, 3, 3, 2, 5, 4, 3, 2, 1, 3, 4, 6, 2, 3, 3, 4, 2, 1, 3, 5, 4, 2, 3, 3, 4, 2, 1, 3, 4, 5, 2, 3, 6, 4, 2, 5, 1. Zbuduj szereg rozdzielczy punktowy z liczebnościami, częstościami (%) i częstościami skumulowanymi. Jaki odsetek gospodarstw liczy co najwyżej 3 osoby? Ile gospodarstw ma więcej niż 4 osoby?
Rozwiązanie krok po kroku
Krok 1. Liczebności. Wypisz wszystkie warianty cechy (od 1 do 6 osób) i policz, ile razy każdy występuje. Kontrola: suma liczebności musi wynosić N = 40.
Krok 2. Częstości. Częstość to liczebność podzielona przez N, np. dla 3 osób 12 / 40 = 0.30, czyli 30%.
Krok 3. Skumulowane. Dodawaj liczebności od góry: 5, 5 + 9 = 14, 14 + 12 = 26 itd. Ostatnia wartość musi być równa N, a ostatnia częstość skumulowana – 100%.
| Liczba osób x | Liczebność n | Częstość (%) | n skumulowane | % skumulowany |
|---|---|---|---|---|
| 1 | 5 | 12.5 | 5 | 12.5 |
| 2 | 9 | 22.5 | 14 | 35.0 |
| 3 | 12 | 30.0 | 26 | 65.0 |
| 4 | 8 | 20.0 | 34 | 85.0 |
| 5 | 4 | 10.0 | 38 | 95.0 |
| 6 | 2 | 5.0 | 40 | 100.0 |
| Razem | 40 | 100.0 |
Krok 4. Odczyt. „Co najmniej / co najwyżej” odczytujesz z kolumny skumulowanej. Co najwyżej 3 osoby: 65.00% gospodarstw (26 z 40). Więcej niż 4 osoby: 4 + 2 = 6 gospodarstw, czyli 15.00% (inaczej 100% − 85%).
Interpretacja
Najliczniejsze są gospodarstwa trzyosobowe (30%), a dwie trzecie gospodarstw ma najwyżej trzech członków. Duże gospodarstwa (5–6 osób) to 15% próby. Przy cesze ciągłej (np. dochód) grupujesz dane w przedziały jak w zadaniu 4.
Typowy błąd
Pomylenie „więcej niż 4” z „co najmniej 4”: to drugie obejmuje też gospodarstwa czteroosobowe i daje 14 gospodarstw (35.00%), a nie 6.
Zadanie 2. Średnia, mediana i dominanta z szeregu punktowego
Treść zadania
Na podstawie szeregu z zadania 1 oblicz średnią liczbę osób w gospodarstwie, medianę i dominantę.
Rozwiązanie krok po kroku
Krok 1. Średnia. W szeregu każda wartość występuje n razy, więc zamiast dodawać 40 liczb mnożysz warianty przez liczebności: 1 × 5 = 5, 2 × 9 = 18, 3 × 12 = 36, 4 × 8 = 32, 5 × 4 = 20, 6 × 2 = 12. Suma iloczynów wynosi 123.
Krok 2. Mediana. Przy N = 40 (parzyste) mediana to średnia wyników na pozycjach 20 i 21. W kolumnie skumulowanej szukasz pierwszej liczby ≥ 20: to 26 przy x = 3 (wcześniej było 14). Obie pozycje, 20. i 21., leżą więc w wariancie 3, a mediana Me = 3.
Krok 3. Dominanta. To wariant o największej liczebności: D = 3 (12 gospodarstw). Więcej o tej mierze: dominanta (moda, modalna).
Interpretacja
Przeciętne gospodarstwo liczy 3.08 osoby, połowa gospodarstw ma co najwyżej 3 osoby i najczęściej spotykane jest gospodarstwo trzyosobowe. Trzy miary są prawie równe, więc rozkład jest w przybliżeniu symetryczny. Średnia nie musi być liczbą całkowitą.
Typowy błąd
Policzenie średniej z samych wariantów (1 + 2 + … + 6) / 6 = 3.50 bez mnożenia przez liczebności – tak traktujesz rzadkie gospodarstwa sześcioosobowe na równi z częstymi trzyosobowymi.
Zadanie 3. Średnia ważona: oceny z punktami ECTS i średnia cena
Treść zadania
(a) Student ekonomii zaliczył semestr z ocenami: statystyka 3.0 (6 ECTS), mikroekonomia 3.5 (5 ECTS), rachunkowość 4.0 (4 ECTS), prawo gospodarcze 4.5 (3 ECTS), język obcy 5.0 (2 ECTS). Uczelnia liczy średnią ważoną punktami ECTS. Oblicz ją. (b) Sklep sprzedał 120 sztuk produktu po 15 zł, 80 sztuk po 18 zł i 50 sztuk po 22 zł. Jaka była średnia cena sprzedanej sztuki?
Rozwiązanie krok po kroku
Krok 1. Wzór. Średnia ważona to suma iloczynów wartości i wag podzielona przez sumę wag:
Krok 2. Oceny (a). Iloczyny ocena × ECTS: 18, 17.5, 16, 13.5, 10; ich suma to 75, a suma punktów ECTS – 20. Mw = 75 / 20 = 3.75.
Krok 3. Cena (b). Wagą jest liczba sprzedanych sztuk. Przychody: 120 × 15 = 1800 zł, 80 × 18 = 1440 zł, 50 × 22 = 1100 zł; razem 4340 zł za 250 sztuk. Średnia cena: 4340 / 250 = 17.36 zł.
Interpretacja
Zwykła średnia ocen wynosi 4.00, ale ważona tylko 3.75, bo najsłabsza ocena dotyczy przedmiotu z największą liczbą punktów. W sklepie średnia cena sprzedanej sztuki (17.36 zł) jest niższa niż średnia z trzech cen (18.33 zł), bo najwięcej sztuk sprzedano najtaniej.
Typowy błąd
Liczenie „średniej ze średnich” bez wag, np. 18.33 zł zamiast 17.36 zł. Ten sam błąd popełniasz, łącząc średnie dwóch klas o różnej liczbie uczniów – zawsze waż liczebnościami.
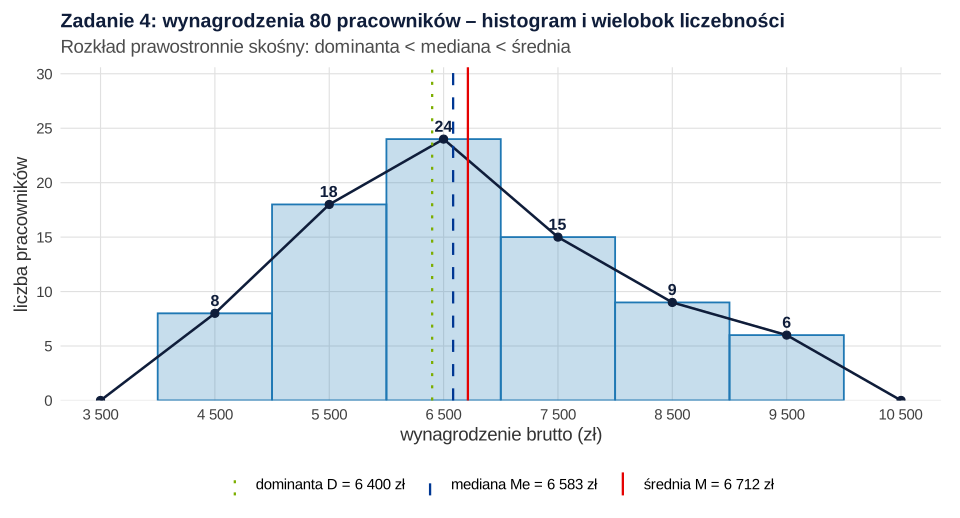
Zadanie 4. Szereg przedziałowy: średnia, mediana, kwartyle i dominanta
Treść zadania
Dział kadr podał rozkład miesięcznych wynagrodzeń brutto 80 pracowników firmy (w zł; przedziały domknięte lewostronnie, np. 4000 ≤ x < 5000). Oblicz średnią, medianę, pierwszy i trzeci kwartyl oraz dominantę.
| Wynagrodzenie (zł) | n | Środek x̊ | x̊ × n | n skumulowane |
|---|---|---|---|---|
| 4000–5000 | 8 | 4500 | 36 000 | 8 |
| 5000–6000 | 18 | 5500 | 99 000 | 26 |
| 6000–7000 | 24 | 6500 | 156 000 | 50 |
| 7000–8000 | 15 | 7500 | 112 500 | 65 |
| 8000–9000 | 9 | 8500 | 76 500 | 74 |
| 9000–10 000 | 6 | 9500 | 57 000 | 80 |
| Razem | 80 | 537 000 |
Rozwiązanie krok po kroku
Krok 1. Średnia. Nie znasz pojedynczych wynagrodzeń, więc każdy przedział reprezentuje jego środek. To przybliżenie (zakładasz równomierny rozkład w przedziale).
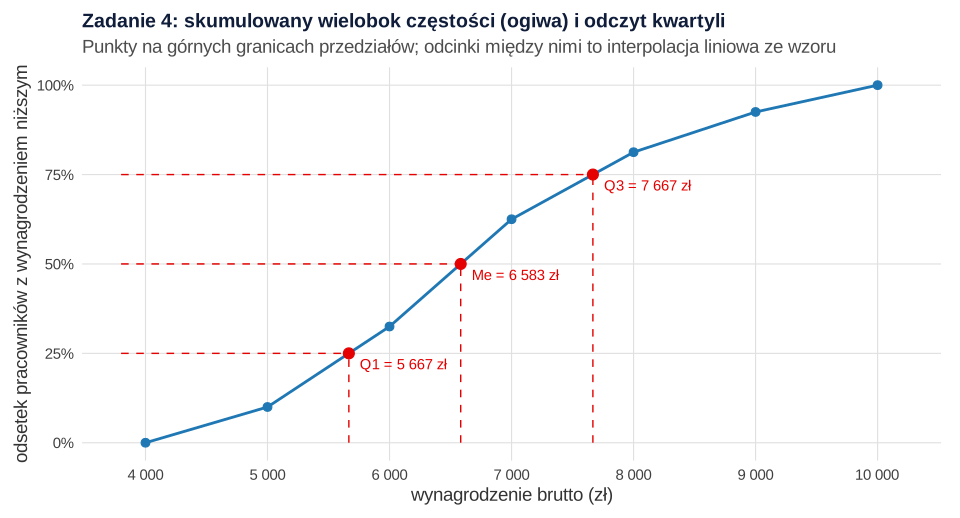
Krok 2. Wzór interpolacyjny. Dla kwantyla rzędu p wyznacz pozycję p × N, znajdź przedział, w którym n skumulowane po raz pierwszy ją osiąga, i interpoluj liniowo wewnątrz przedziału:
gdzie x0 to dolna granica przedziału kwantyla, nskum,−1 – liczebność skumulowana przed tym przedziałem, n0 – liczebność przedziału, a h – jego szerokość (tu 1000 zł).
Krok 3. Mediana (rząd 0.5): pozycja 40, przedział 6000–7000 (przed nim 26 osób, w nim 24):
Krok 4. Kwartyle. Q1: pozycja 20, przedział 5000–6000: 5000 + (20 − 8) / 18 × 1000 = 5666.67 zł. Q3: pozycja 60, przedział 7000–8000: 7000 + (60 − 50) / 15 × 1000 = 7666.67 zł. Rozstęp ćwiartkowy IQR = 7666.67 − 5666.67 = 2000.00 zł, a odchylenie ćwiartkowe Q = IQR / 2 = 1000.00 zł.
Krok 5. Dominanta. Przedział modalny to 6000–7000 (24 osoby). Wzór uwzględnia liczebności przedziałów sąsiednich (18 przed i 15 po):
Interpretacja
Przeciętne wynagrodzenie wynosi 6712.50 zł, ale połowa pracowników zarabia mniej niż 6583.33 zł, a najczęściej spotykane wynagrodzenie leży w okolicy 6400 zł. Środkowe 50% pracowników zarabia od 5666.67 do 7666.67 zł. Układ D < Me < M wskazuje na asymetrię prawostronną, typową dla wynagrodzeń; dlatego w opisie płac częściej podaje się medianę niż średnią.
Typowy błąd
Podanie środka przedziału mediany (6500 zł) jako mediany albo środka przedziału modalnego jako dominanty – to tylko pierwsze przybliżenie. Część podręczników liczy pozycję jako (N + 1) / 2 – stosuj wersję z wykładu.
Zadanie 5. Wariancja, odchylenie standardowe i asymetria z szeregu przedziałowego
Treść zadania
Dla wynagrodzeń z zadania 4 oblicz wariancję, odchylenie standardowe i współczynnik zmienności. Oceń asymetrię rozkładu współczynnikiem Pearsona (z dominantą i z medianą) oraz współczynnikiem kwartylowym.
Rozwiązanie krok po kroku
Krok 1. Przelicz na tysiące. Rachunek na liczbach w tysiącach złotych jest prostszy: środki 4.5, 5.5, …, 9.5, a średnia 6.7125 tys. zł. Odchylenia od średniej podnosisz do kwadratu i mnożysz przez liczebność przedziału.
| Środek x̊ | n | x̊ − M | (x̊ − M)² | n(x̊ − M)² |
|---|---|---|---|---|
| 4.5 | 8 | −2.2125 | 4.8952 | 39.1613 |
| 5.5 | 18 | −1.2125 | 1.4702 | 26.4628 |
| 6.5 | 24 | −0.2125 | 0.0452 | 1.0838 |
| 7.5 | 15 | 0.7875 | 0.6202 | 9.3023 |
| 8.5 | 9 | 1.7875 | 3.1952 | 28.7564 |
| 9.5 | 6 | 2.7875 | 7.7702 | 46.6209 |
| Razem | 80 | 151.387 |
Krok 2. Wariancja i SD. W statystyce opisowej szeregu (opisujesz całą zbiorowość 80 pracowników) dzielisz przez N:
Gdyby 80 osób było próbą, z której wnioskujesz o większej populacji, dzielisz przez N − 1: s² = 1.9163, s = 1384.30 zł. Przy 80 obserwacjach różnica to niecałe 9 zł. Więcej o obu wersjach: wariancja i odchylenie standardowe.
Krok 3. Współczynnik zmienności. V = s / M × 100% = 1375.62 / 6712.50 × 100% = 20.49%.
Krok 4. Asymetria. Współczynnik Pearsona z dominantą: As = (M − D) / s = (6712.50 − 6400.00) / 1375.62 = 0.227. Wersja z medianą: 3(M − Me) / s = 3 × (6712.50 − 6583.33) / 1375.62 = 0.282. Współczynnik kwartylowy opiera się tylko na kwartylach:
Interpretacja
Wynagrodzenia odchylają się od średniej przeciętnie o ok. 1376 zł, co stanowi 20.49% średniej. Wszystkie trzy współczynniki asymetrii są dodatnie, więc rozkład jest prawostronnie skośny, ale słabo. Współczynnik kwartylowy jest najmniejszy, bo patrzy tylko na środkowe 50% obserwacji. Ogólne omówienie miary znajdziesz w haśle skośność.
Typowy błąd
Liczenie kwadratów odchyleń bez mnożenia przez liczebności przedziałów – wtedy przedział z 6 osobami waży tyle samo, co przedział z 24.
Zadanie 6. Kwartyle z danych surowych – różne definicje
Treść zadania
Kierownik urzędu zmierzył czas obsługi 10 kolejnych klientów w okienku (w minutach): 6, 14, 3, 9, 20, 5, 11, 2, 8, 6. Oblicz medianę oraz pierwszy i trzeci kwartyl. Pokaż, jak wynik zależy od przyjętej definicji kwartyla.
Rozwiązanie krok po kroku
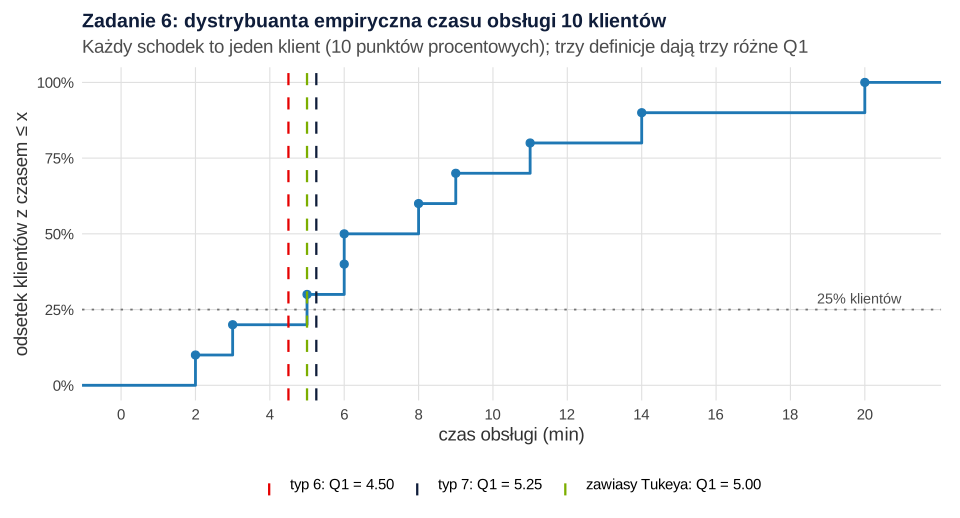
Krok 1. Uporządkuj dane: 2, 3, 5, 6, 6, 8, 9, 11, 14, 20. Mediana to średnia piątej i szóstej wartości: (6 + 8) / 2 = 7 minut – tu wszystkie metody są zgodne.
Krok 2. Metoda połówek (zawiasy Tukeya). Podziel dane na dolną połowę (2, 3, 5, 6, 6) i górną (8, 9, 11, 14, 20). Kwartyle to mediany połówek: Q1 = 5, Q3 = 11, IQR = 6.
Krok 3. Pozycja 1 + (n − 1)p (typ 7, domyślny w R; tak liczy też funkcja KWARTYL.PRZEDZ.ZAMK w Excelu). Pozycja Q1 = 1 + 9 × 0.25 = 3.25, czyli trzecia wartość plus ćwierć odległości do czwartej: 5 + 0.25 × (6 − 5) = 5.25. Pozycja Q3 = 7.75: 9 + 0.75 × (11 − 9) = 10.5. IQR = 5.25.
Krok 4. Pozycja (n + 1)p (typ 6; tak liczy SPSS). Pozycja Q1 = 11 × 0.25 = 2.75: 3 + 0.75 × (5 − 3) = 4.5. Pozycja Q3 = 8.25: 11 + 0.25 × (14 − 11) = 11.75. IQR = 7.25.
Interpretacja
Połowa klientów była obsługiwana krócej niż 7 minut, a środkowe 50% czasów mieści się mniej więcej między 5 a 11 minutami. Dokładne granice zależą od definicji: Q1 wynosi 4.5, 5 albo 5.25. Hyndman i Fan (1996) pokazali, że programy statystyczne stosują wiele różnych definicji kwantyli z próby, czasem różnych nawet w obrębie jednego programu, i zalecili jedną wspólną (w R to typ 8: tu Q1 = 4.83, Q3 = 11.25). W R wszystkie dziewięć typów daje dla tych danych Q1 od 3.00 do 5.25.
Typowy błąd
Uznanie, że wynik z innego programu jest „zły”. Przy małym n różne definicje dają różne kwartyle – na kolokwium stosuj metodę z wykładu, a w pracy napisz, którą definicję wybrałeś(-aś).
Zadanie 7. Współczynnik zmienności – porównanie dwóch oddziałów
Treść zadania
Sieć sklepów porównuje stabilność dziennej sprzedaży (w tys. zł) w dwóch oddziałach przez te same 8 dni. Oddział A (mały): 10, 14, 9, 13, 16, 11, 12, 11. Oddział B (duży): 42, 47, 38, 45, 50, 36, 44, 42. W którym oddziale sprzedaż jest względnie bardziej zmienna?
Rozwiązanie krok po kroku
Krok 1. Średnie. MA = 96 / 8 = 12.00, MB = 344 / 8 = 43.00 tys. zł.
Krok 2. Odchylenia standardowe (dane to próba 8 dni, więc dzielisz przez n − 1). A: odchylenia −2, 2, −3, 1, 4, −1, 0, −1; suma kwadratów 36; s² = 36 / 7 = 5.143; s = 2.268. B: odchylenia −1, 4, −5, 2, 7, −7, 1, −1; suma kwadratów 146; s² = 146 / 7 = 20.857; s = 4.567.
Krok 3. Współczynniki zmienności:
Interpretacja
W liczbach bezwzględnych sprzedaż oddziału B waha się bardziej: jego SD jest 2.01 razy większe, a rozstęp wynosi 14 tys. zł wobec 7 tys. zł w A. Względem typowego poziomu sprzedaży to jednak mały oddział A jest mniej stabilny – jego współczynnik zmienności jest 1.78 razy większy.
Typowy błąd
Wniosek z samych odchyleń standardowych, że „oddział B ma bardziej niestabilną sprzedaż”. Drugi błąd to liczenie współczynnika zmienności dla zmiennej bez prawdziwego zera (np. temperatury w °C albo wyniku przesuniętej skali) – wtedy iloraz SD / M nie ma sensu.
Zadanie 8. Rozstęp, IQR i reguła 1.5 IQR
Treść zadania
Sklep internetowy zanotował czas realizacji 15 zamówień (w dniach): 4, 6, 3, 21, 5, 2, 7, 4, 5, 9, 3, 6, 8, 5, 4. Oblicz rozstęp i rozstęp ćwiartkowy. Czy któreś zamówienie jest wartością odstającą według reguły 1.5 IQR? Jak ta wartość wpływa na średnią i medianę?
Rozwiązanie krok po kroku
Krok 1. Uporządkuj dane: 2, 3, 3, 4, 4, 4, 5, 5, 5, 6, 6, 7, 8, 9, 21. Rozstęp = 21 − 2 = 19 dni.
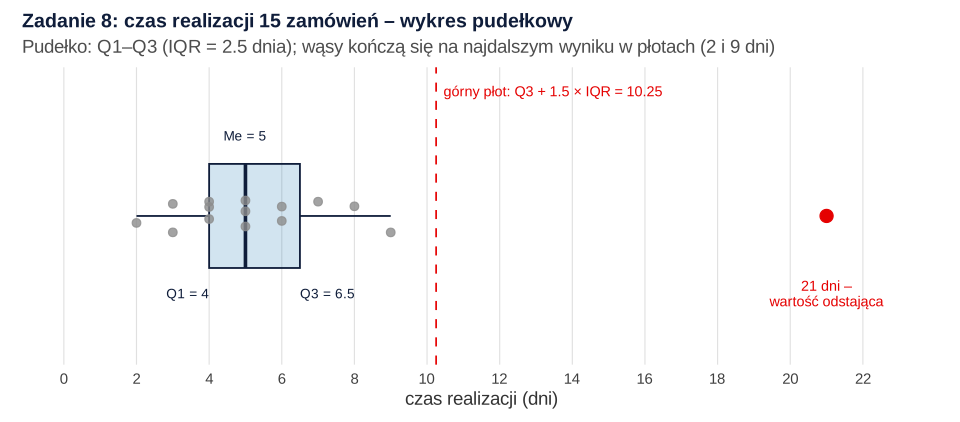
Krok 2. Kwartyle (typ 7, jak w R): pozycja Q1 = 1 + 14 × 0.25 = 4.5, czyli średnia czwartej i piątej wartości: Q1 = 4; pozycja Q3 = 11.5: (6 + 7) / 2 = 6.5. IQR = 6.5 − 4 = 2.5 dnia.
Krok 3. Płoty.
Poza płotami leży tylko zamówienie realizowane 21 dni. Leży też poza płotem 3 × IQR (6.5 + 7.5 = 14), więc jest wartością skrajną. Przy definicji kwartyli typu 6 (Q1 = 4, Q3 = 7, IQR = 3) górny płot wynosi 11.5 – wniosek się nie zmienia.
Krok 4. Wpływ na miary. Ze wszystkimi zamówieniami: M = 6.13, Me = 5, SD = 4.53 dnia. Bez zamówienia z 21 dniami: M = 5.07, Me = 5, SD = 1.98.
Interpretacja
Typowe zamówienie realizowano w 5 dni, a środkowe 50% zamówień w 4–6.5 dnia. Jedno zamówienie (21 dni) jest obserwacją odstającą: podnosi średnią o ponad dzień i ponad dwukrotnie zwiększa SD, a mediany nie zmienia. Ten sposób rysowania wąsów (najdalej 1.5 × IQR od pudełka) Krzywinski i Altman (2014) opisują jako wąsy w stylu Tukeya; regułę spopularyzowała eksploracyjna analiza danych (Tukey, 1977).
Typowy błąd
Automatyczne usunięcie wartości odstającej. Reguła 1.5 IQR tylko wskazuje obserwacje do sprawdzenia: najpierw ustal, czy to pomyłka we wpisie, czy prawdziwe zamówienie (np. towar sprowadzany na zamówienie). Co dalej, opisujemy we wpisie wartości odstające: jak je wykryć i co z nimi zrobić.
Zadanie 9. Skośność: współczynnik momentowy i współczynnik Pearsona
Treść zadania
Wychowawca zapisał liczbę nieobecności 12 uczniów klasy w semestrze: 2, 0, 5, 1, 3, 13, 1, 4, 2, 8, 3, 6. Oblicz momentowy współczynnik asymetrii i porównaj go ze współczynnikiem Pearsona. Jak zmienia się skośność bez ucznia z 13 nieobecnościami?
Rozwiązanie krok po kroku
Krok 1. Średnia i odchylenia. Suma nieobecności to 48, więc M = 48 / 12 = 4.00. Odchylenia od średniej (w kolejności z treści): −2, −4, 1, −3, −1, 9, −3, 0, −2, 4, −1, 2.
Krok 2. Kwadraty i sześciany. Suma kwadratów odchyleń wynosi 146, a suma sześcianów 666 (największy wkład: 9³ = 729 od ucznia z 13 nieobecnościami). Momenty centralne: m2 = 146 / 12 = 12.167, m3 = 666 / 12 = 55.500.
Krok 3. Współczynnik momentowy.
Programy często podają wersję z korektą na małą próbę: G1 = g1 × √[n(n − 1)] / (n − 2) = 1.503 (tak liczą m.in. SPSS i funkcja SKOŚNOŚĆ w Excelu). Inny wariant, b1 = g1 × [(n − 1) / n]3/2, daje 1.148. Joanes i Gill (1998) porównali te estymatory stosowane w pakietach statystycznych – przy 12 obserwacjach różnią się wyraźnie.
Krok 4. Współczynnik Pearsona. Rozkład ma trzy dominanty (1, 2 i 3 – każda występuje dwa razy), więc wersja z dominantą odpada. Z medianą (Me = 3) i SD = 3.643: 3 × (4.00 − 3) / 3.643 = 0.823.
Krok 5. Bez ucznia z 13 nieobecnościami: g1 = 0.640.
Interpretacja
Rozkład nieobecności jest wyraźnie prawostronnie skośny: większość uczniów opuściła 0–6 dni, a jeden – 13. Średnia (4.00) jest większa od mediany (3). Jeden uczeń odpowiada za większość skośności: bez niego współczynnik spada z 1.308 do 0.640. Przy liczbach całkowitych i małym n zachowaj ostrożność – von Hippel (2005) pokazał, że podręcznikowa reguła „przy skośności prawostronnej średnia leży na prawo od mediany” często zawodzi, zwłaszcza w rozkładach dyskretnych.
Typowy błąd
Porównywanie skośności z dwóch źródeł bez sprawdzenia wzoru: 1.308, 1.503 i 1.148 to ta sama skośność policzona trzema estymatorami. Zawsze napisz, którą wersję podajesz.
Ściąga: którą miarę wybrać w zadaniu
Zanim zaczniesz liczyć, sprawdź, czy dane są surowe, czy pogrupowane, i czy rozkład jest symetryczny.
| Sytuacja | Położenie | Rozproszenie | Na co uważać |
|---|---|---|---|
| Rozkład zbliżony do symetrycznego | średnia | odchylenie standardowe | N czy N − 1 – według polecenia |
| Rozkład skośny albo wartości odstające (płace, czasy) | mediana | IQR lub odchylenie ćwiartkowe | definicja kwartyli przy małym n |
| Szereg punktowy | średnia z wagami ni, mediana z kolumny skumulowanej | wariancja z wagami ni | nie licz średniej z samych wariantów |
| Szereg przedziałowy | średnia ze środków, mediana i dominanta ze wzoru interpolacyjnego | wariancja ze środków, kwartyle interpolacyjne | wynik jest przybliżeniem |
| Porównanie zmienności grup o różnych średnich | – | współczynnik zmienności | tylko dla cech z prawdziwym zerem |
| Ocena kształtu rozkładu | układ D, Me, M | współczynnik asymetrii | podaj, którym wzorem liczysz |
Jak te miary opisać w pracy dyplomowej, w tabeli i w tekście, pokazuje wpis statystyki opisowe w pracy. Jeśli piszesz pracę z ekonomii lub zarządzania, zobacz też statystykę w pracy z zarządzania i ekonomii.
Inne zbiory zadań
Statystyka opisowa to pierwszy blok materiału. Kolejne zbiory zadań z rozwiązaniami w tym samym układzie:
- prawdopodobieństwo i rozkłady – zadania z rozwiązaniami;
- estymacja i testowanie hipotez – zadania z rozwiązaniami;
- korelacja i regresja – zadania z rozwiązaniami;
- testy nieparametryczne – zadania z rozwiązaniami;
- statystyka medyczna – zadania dla pielęgniarstwa i kierunków medycznych;
- zadania ze statystyki na psychologii (testy t, χ², ANOVA, regresja).
Jeśli po kolokwium przychodzi czas na własne badanie do pracy dyplomowej, możesz skorzystać z konsultacji analizy statystycznej dla studentów – pomożemy dobrać miary i wyjaśnimy wyniki tak, żebyś umiał(a) je samodzielnie opisać.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone wzorem, tak jak na kartce, a tam, gdzie R ma gotową funkcję (mean, median, weighted.mean, quantile, fivenum, boxplot.stats), także nią jako kontrola. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–5: szeregi rozdzielcze, średnia ważona, wzór interpolacyjny, wariancja i asymetria
R
# B378 – zadania 1–5: szereg rozdzielczy punktowy i przedziałowy, średnia ważona,
# mediana, kwartyle i dominanta ze wzoru interpolacyjnego, wariancja, SD, CV i skośność z szeregu.
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)

# Zadanie 1. Liczba osób w gospodarstwie domowym (40 ankiet)
osoby <- c(3, 2, 4, 1, 3, 3, 2, 5, 4, 3, 2, 1, 3, 4, 6, 2, 3, 3, 4, 2,
           1, 3, 5, 4, 2, 3, 3, 4, 2, 1, 3, 4, 5, 2, 3, 6, 4, 2, 5, 1)
n_k <- table(osoby)
szereg <- data.frame(x = as.numeric(names(n_k)), n = as.vector(n_k))
szereg$proc <- 100 * szereg$n / sum(szereg$n)
szereg$n_skum <- cumsum(szereg$n)
szereg$proc_skum <- cumsum(szereg$proc)
cat("Zadanie 1\n")
cat("N =", length(osoby), "\n")
print(szereg, row.names = FALSE)
cat("Odsetek gospodarstw z co najwyżej 3 osobami =", z2(100 * mean(osoby <= 3)), "%\n")
cat("Gospodarstwa z więcej niż 4 osobami:", sum(osoby > 4), "=", z2(100 * mean(osoby > 4)), "%\n")
cat("Błąd – co najmniej 4 osoby zamiast więcej niż 4:", sum(osoby >= 4), "=", z2(100 * mean(osoby >= 4)), "%\n\n")

# Zadanie 2. Średnia, mediana i dominanta z szeregu punktowego (dane z zadania 1)
N <- sum(szereg$n)
M1 <- sum(szereg$x * szereg$n) / N
cat("Zadanie 2\n")
cat("Iloczyny x * n:", szereg$x * szereg$n, "; suma =", sum(szereg$x * szereg$n), "\n")
cat("Średnia = suma / N =", z3(M1), "\n")
cat("Pozycje mediany:", N / 2, "i", N / 2 + 1, "; wartość mediany =", median(osoby), "\n")
cat("Dominanta =", szereg$x[which.max(szereg$n)], "(liczebność", max(szereg$n), ")\n")
cat("Kontrola mean(osoby) =", z3(mean(osoby)), "\n")
cat("Błąd – średnia z samych wariantów 1–6 bez liczebności =", z2(mean(szereg$x)), "\n\n")

# Zadanie 3. Średnia ważona: średnia ocen ważona punktami ECTS oraz średnia cena
oceny <- c(statystyka = 3.0, mikroekonomia = 3.5, rachunkowosc = 4.0, prawo = 4.5, jezyk = 5.0)
ects  <- c(6, 5, 4, 3, 2)
cat("Zadanie 3\n")
cat("Iloczyny ocena * ECTS:", oceny * ects, "; suma =", sum(oceny * ects), "; suma ECTS =", sum(ects), "\n")
cat("Średnia ważona ECTS =", z2(sum(oceny * ects) / sum(ects)), "; kontrola weighted.mean() =",
    z2(weighted.mean(oceny, ects)), "\n")
cat("Błąd – zwykła średnia ocen =", z2(mean(oceny)), "\n")
cena  <- c(15, 18, 22)
sztuk <- c(120, 80, 50)
cat("Przychód z każdej ceny:", cena * sztuk, "; przychód razem =", sum(cena * sztuk), "; sztuk razem =", sum(sztuk), "\n")
cat("Średnia cena sprzedanej sztuki =", z2(weighted.mean(cena, sztuk)), "zł\n")
cat("Błąd – średnia z trzech cen =", z2(mean(cena)), "zł\n\n")

# Zadanie 4. Szereg przedziałowy: wynagrodzenia brutto 80 pracowników (zł)
dol <- seq(4000, 9000, by = 1000); h <- 1000
n4  <- c(8, 18, 24, 15, 9, 6)
N4 <- sum(n4); srodek <- dol + h / 2; skum <- cumsum(n4)
cat("Zadanie 4\n")
print(data.frame(przedzial = paste0(dol, "-", dol + h), n = n4, srodek = srodek,
                 x_razy_n = srodek * n4, n_skum = skum), row.names = FALSE)
M4 <- sum(srodek * n4) / N4
cat("N =", N4, "; suma x * n =", sum(srodek * n4), "; średnia =", z2(M4), "zł\n")
kwantyl_przedz <- function(p) {          # wzór interpolacyjny z pozycją p * N
  poz <- p * N4; k <- which(skum >= poz)[1]
  skum_przed <- if (k == 1) 0 else skum[k - 1]
  wynik <- dol[k] + (poz - skum_przed) / n4[k] * h
  cat(sprintf("rząd %.2f: pozycja %.0f, przedział %d-%d, n skum. przed = %d, n = %d -> %s zł\n",
              p, poz, dol[k], dol[k] + h, skum_przed, n4[k], z2(wynik)))
  wynik
}
Q1 <- kwantyl_przedz(0.25); Me <- kwantyl_przedz(0.50); Q3 <- kwantyl_przedz(0.75)
k <- which.max(n4)
D <- dol[k] + (n4[k] - n4[k - 1]) / ((n4[k] - n4[k - 1]) + (n4[k] - n4[k + 1])) * h
cat("Przedział dominanty:", dol[k], "-", dol[k] + h, "; dominanta =", z2(D), "zł\n")
cat("IQR = Q3 - Q1 =", z2(Q3 - Q1), "zł; odchylenie ćwiartkowe Q = IQR / 2 =", z2((Q3 - Q1) / 2), "zł\n\n")

# Zadanie 5. Wariancja, SD, współczynnik zmienności i skośność z szeregu przedziałowego (dane z zadania 4)
# Rachunek w tysiącach zł (mniejsze liczby), wynik końcowy z powrotem w zł.
sr_t <- srodek / 1000; M_t <- M4 / 1000
odch <- sr_t - M_t
cat("Zadanie 5\n")
print(data.frame(srodek_tys = sr_t, n = n4, odchylenie = odch, kwadrat = round(odch^2, 4),
                 kwadrat_razy_n = round(odch^2 * n4, 4)), row.names = FALSE)
SS <- sum(odch^2 * n4)
var_N <- SS / N4; var_N1 <- SS / (N4 - 1)
cat("Suma n * (x - M)^2 =", z3(SS), "(tys. zł)^2\n")
cat("Wariancja (N) =", formatC(var_N, format = "f", digits = 4), "; SD (N) =", z2(1000 * sqrt(var_N)), "zł\n")
cat("Wariancja (N - 1) =", formatC(var_N1, format = "f", digits = 4), "; SD (N - 1) =", z2(1000 * sqrt(var_N1)), "zł\n")
SD5 <- 1000 * sqrt(var_N)
cat("Współczynnik zmienności CV = SD / M =", z2(100 * SD5 / M4), "%\n")
cat("Skośność Pearsona (M - D) / SD =", z3((M4 - D) / SD5), "\n")
cat("Skośność Pearsona 3(M - Me) / SD =", z3(3 * (M4 - Me) / SD5), "\n")
cat("Współczynnik kwartylowy (Q3 + Q1 - 2Me) / (Q3 - Q1) =", z3((Q3 + Q1 - 2 * Me) / (Q3 - Q1)), "\n")
cat("Kolejność miar: D =", z2(D), "< Me =", z2(Me), "< M =", z2(M4), "\n")
Wynik w R
Zadanie 1
N = 40
 x  n proc n_skum proc_skum
 1  5 12.5      5      12.5
 2  9 22.5     14      35.0
 3 12 30.0     26      65.0
 4  8 20.0     34      85.0
 5  4 10.0     38      95.0
 6  2  5.0     40     100.0
Odsetek gospodarstw z co najwyżej 3 osobami = 65.00 %
Gospodarstwa z więcej niż 4 osobami: 6 = 15.00 %
Błąd – co najmniej 4 osoby zamiast więcej niż 4: 14 = 35.00 %

Zadanie 2
Iloczyny x * n: 5 18 36 32 20 12 ; suma = 123
Średnia = suma / N = 3.075
Pozycje mediany: 20 i 21 ; wartość mediany = 3
Dominanta = 3 (liczebność 12 )
Kontrola mean(osoby) = 3.075
Błąd – średnia z samych wariantów 1–6 bez liczebności = 3.50

Zadanie 3
Iloczyny ocena * ECTS: 18 17.5 16 13.5 10 ; suma = 75 ; suma ECTS = 20
Średnia ważona ECTS = 3.75 ; kontrola weighted.mean() = 3.75
Błąd – zwykła średnia ocen = 4.00
Przychód z każdej ceny: 1800 1440 1100 ; przychód razem = 4340 ; sztuk razem = 250
Średnia cena sprzedanej sztuki = 17.36 zł
Błąd – średnia z trzech cen = 18.33 zł

Zadanie 4
  przedzial  n srodek x_razy_n n_skum
  4000-5000  8   4500    36000      8
  5000-6000 18   5500    99000     26
  6000-7000 24   6500   156000     50
  7000-8000 15   7500   112500     65
  8000-9000  9   8500    76500     74
 9000-10000  6   9500    57000     80
N = 80 ; suma x * n = 537000 ; średnia = 6712.50 zł
rząd 0.25: pozycja 20, przedział 5000-6000, n skum. przed = 8, n = 18 -> 5666.67 zł
rząd 0.50: pozycja 40, przedział 6000-7000, n skum. przed = 26, n = 24 -> 6583.33 zł
rząd 0.75: pozycja 60, przedział 7000-8000, n skum. przed = 50, n = 15 -> 7666.67 zł
Przedział dominanty: 6000 - 7000 ; dominanta = 6400.00 zł
IQR = Q3 - Q1 = 2000.00 zł; odchylenie ćwiartkowe Q = IQR / 2 = 1000.00 zł

Zadanie 5
 srodek_tys  n odchylenie kwadrat kwadrat_razy_n
        4.5  8    -2.2125  4.8952        39.1613
        5.5 18    -1.2125  1.4702        26.4628
        6.5 24    -0.2125  0.0452         1.0838
        7.5 15     0.7875  0.6202         9.3023
        8.5  9     1.7875  3.1952        28.7564
        9.5  6     2.7875  7.7702        46.6209
Suma n * (x - M)^2 = 151.387 (tys. zł)^2
Wariancja (N) = 1.8923 ; SD (N) = 1375.62 zł
Wariancja (N - 1) = 1.9163 ; SD (N - 1) = 1384.30 zł
Współczynnik zmienności CV = SD / M = 20.49 %
Skośność Pearsona (M - D) / SD = 0.227
Skośność Pearsona 3(M - Me) / SD = 0.282
Współczynnik kwartylowy (Q3 + Q1 - 2Me) / (Q3 - Q1) = 0.083
Kolejność miar: D = 6400.00 < Me = 6583.33 < M = 6712.50
Zadania 6–9: kwartyle z danych surowych, współczynnik zmienności, reguła 1.5 IQR i skośność
R
# B378 – zadania 6–9: kwartyle z danych surowych (różne definicje), współczynnik zmienności,
# rozstęp, IQR i reguła 1.5 IQR, skośność momentowa i Pearsona.
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)

# Zadanie 6. Czas obsługi klienta w okienku (minuty), 10 klientów
czas <- c(6, 14, 3, 9, 20, 5, 11, 2, 8, 6)
x <- sort(czas); n <- length(x)
cat("Zadanie 6\n")
cat("Uporządkowane:", x, "; n =", n, "; mediana =", median(x), "\n")
poz7 <- 1 + (n - 1) * c(0.25, 0.75); poz6 <- (n + 1) * c(0.25, 0.75)
cat("Typ 7 (domyślny w R): pozycje", poz7, "-> Q1, Q3 =", quantile(x, c(0.25, 0.75), type = 7),
    "; IQR =", IQR(x, type = 7), "\n")
cat("Typ 6 (pozycja (n + 1)p): pozycje", poz6, "-> Q1, Q3 =", quantile(x, c(0.25, 0.75), type = 6),
    "; IQR =", IQR(x, type = 6), "\n")
cat("Zawiasy Tukeya (mediany połówek, fivenum):", fivenum(x)[c(2, 4)], "; IQR =", diff(fivenum(x)[c(2, 4)]), "\n")
cat("Typ 8 (zalecany przez Hyndmana i Fana): Q1, Q3 =", z2(quantile(x, c(0.25, 0.75), type = 8)), "\n")
cat("Wszystkie 9 typów (Q1):", z2(sapply(1:9, function(t) quantile(x, 0.25, type = t))), "\n")
cat("Wszystkie 9 typów (Q3):", z2(sapply(1:9, function(t) quantile(x, 0.75, type = t))), "\n\n")

# Zadanie 7. Dzienna sprzedaż (tys. zł) w dwóch oddziałach przez 8 dni
A <- c(10, 14, 9, 13, 16, 11, 12, 11)
B <- c(42, 47, 38, 45, 50, 36, 44, 42)
cat("Zadanie 7\n")
for (g in list(list("A", A), list("B", B))) {
  v <- g[[2]]; d <- v - mean(v)
  cat("Oddział", g[[1]], ": suma =", sum(v), "; M =", z2(mean(v)), "; odchylenia:", d, "; SS =", sum(d^2),
      "; s^2 =", z3(sum(d^2) / (length(v) - 1)), "; SD =", z3(sd(v)), "; CV =", z2(100 * sd(v) / mean(v)), "%\n")
}
cat("Stosunek SD (B / A) =", z2(sd(B) / sd(A)), "; stosunek CV (A / B) =", z2((sd(A) / mean(A)) / (sd(B) / mean(B))), "\n")
cat("Rozstęp A =", diff(range(A)), "; rozstęp B =", diff(range(B)), "\n\n")

# Zadanie 8. Czas realizacji zamówienia (dni), 15 zamówień; reguła 1.5 IQR
dni <- c(4, 6, 3, 21, 5, 2, 7, 4, 5, 9, 3, 6, 8, 5, 4)
y <- sort(dni)
cat("Zadanie 8\n")
cat("Uporządkowane:", y, "; n =", length(y), "\n")
cat("Rozstęp = max - min =", max(y), "-", min(y), "=", diff(range(y)), "\n")
for (t in c(7, 6)) {
  q <- quantile(y, c(0.25, 0.75), type = t); iqr <- unname(diff(q))
  cat("Typ", t, ": Q1 =", q[1], "; Q3 =", q[2], "; IQR =", iqr,
      "; płoty 1.5 IQR: [", q[1] - 1.5 * iqr, ",", q[2] + 1.5 * iqr, "]",
      "; płoty 3 IQR: [", q[1] - 3 * iqr, ",", q[2] + 3 * iqr, "]",
      "; poza płotami 1.5 IQR:", y[y < q[1] - 1.5 * iqr | y > q[2] + 1.5 * iqr], "\n")
}
cat("boxplot.stats()$out =", boxplot.stats(y)$out, "\n")
cat("Ze wszystkimi: M =", z2(mean(y)), "; Me =", median(y), "; SD =", z2(sd(y)), "\n")
bez <- y[y != 21]
cat("Bez wartości 21: M =", z2(mean(bez)), "; Me =", median(bez), "; SD =", z2(sd(bez)), "\n")
cat("Najdłuższy czas bez wartości odstającej (koniec wąsa) =", max(bez), "\n\n")

# Zadanie 9. Liczba nieobecności w semestrze, 12 uczniów jednej klasy
nb <- c(2, 0, 5, 1, 3, 13, 1, 4, 2, 8, 3, 6)
m <- length(nb); M9 <- mean(nb); d <- nb - M9
m2 <- sum(d^2) / m; m3 <- sum(d^3) / m
g1 <- m3 / m2^1.5
G1 <- g1 * sqrt(m * (m - 1)) / (m - 2)
b1 <- g1 * ((m - 1) / m)^1.5
cat("Zadanie 9\n")
cat("Uporządkowane:", sort(nb), "; n =", m, "; suma =", sum(nb), "\n")
cat("M =", z2(M9), "; Me =", median(nb), "; dominanty:", names(which(table(nb) == max(table(nb)))), "; SD (n - 1) =", z3(sd(nb)), "\n")
cat("Odchylenia od średniej:", d, "\n")
cat("Sześciany odchyleń:", d^3, "\n")
cat("Suma kwadratów =", sum(d^2), "; suma sześcianów =", sum(d^3), "\n")
cat("m2 = suma kwadratów / n =", z3(m2), "; m3 = suma sześcianów / n =", z3(m3), "\n")
cat("g1 = m3 / m2^1.5 (współczynnik momentowy) =", z3(g1), "\n")
cat("G1 = g1 * sqrt(n(n - 1)) / (n - 2) (SPSS, Excel) =", z3(G1), "\n")
cat("b1 = g1 * ((n - 1) / n)^1.5 =", z3(b1), "\n")
cat("Skośność Pearsona 3(M - Me) / SD =", z3(3 * (M9 - median(nb)) / sd(nb)), "\n")
nb_bez <- nb[nb != 13]; d2 <- nb_bez - mean(nb_bez)
cat("Bez ucznia z 13 nieobecnościami: g1 =", z3((sum(d2^3) / 11) / (sum(d2^2) / 11)^1.5), "\n")
Wynik w R
Zadanie 6
Uporządkowane: 2 3 5 6 6 8 9 11 14 20 ; n = 10 ; mediana = 7
Typ 7 (domyślny w R): pozycje 3.25 7.75 -> Q1, Q3 = 5.25 10.5 ; IQR = 5.25
Typ 6 (pozycja (n + 1)p): pozycje 2.75 8.25 -> Q1, Q3 = 4.5 11.75 ; IQR = 7.25
Zawiasy Tukeya (mediany połówek, fivenum): 5 11 ; IQR = 6
Typ 8 (zalecany przez Hyndmana i Fana): Q1, Q3 = 4.83 11.25
Wszystkie 9 typów (Q1): 5.00 5.00 3.00 4.00 5.00 4.50 5.25 4.83 4.88
Wszystkie 9 typów (Q3): 11.00 11.00 11.00 10.00 11.00 11.75 10.50 11.25 11.19

Zadanie 7
Oddział A : suma = 96 ; M = 12.00 ; odchylenia: -2 2 -3 1 4 -1 0 -1 ; SS = 36 ; s^2 = 5.143 ; SD = 2.268 ; CV = 18.90 %
Oddział B : suma = 344 ; M = 43.00 ; odchylenia: -1 4 -5 2 7 -7 1 -1 ; SS = 146 ; s^2 = 20.857 ; SD = 4.567 ; CV = 10.62 %
Stosunek SD (B / A) = 2.01 ; stosunek CV (A / B) = 1.78
Rozstęp A = 7 ; rozstęp B = 14

Zadanie 8
Uporządkowane: 2 3 3 4 4 4 5 5 5 6 6 7 8 9 21 ; n = 15
Rozstęp = max - min = 21 - 2 = 19
Typ 7 : Q1 = 4 ; Q3 = 6.5 ; IQR = 2.5 ; płoty 1.5 IQR: [ 0.25 , 10.25 ] ; płoty 3 IQR: [ -3.5 , 14 ] ; poza płotami 1.5 IQR: 21
Typ 6 : Q1 = 4 ; Q3 = 7 ; IQR = 3 ; płoty 1.5 IQR: [ -0.5 , 11.5 ] ; płoty 3 IQR: [ -5 , 16 ] ; poza płotami 1.5 IQR: 21
boxplot.stats()$out = 21
Ze wszystkimi: M = 6.13 ; Me = 5 ; SD = 4.53
Bez wartości 21: M = 5.07 ; Me = 5 ; SD = 1.98
Najdłuższy czas bez wartości odstającej (koniec wąsa) = 9

Zadanie 9
Uporządkowane: 0 1 1 2 2 3 3 4 5 6 8 13 ; n = 12 ; suma = 48
M = 4.00 ; Me = 3 ; dominanty: 1 2 3 ; SD (n - 1) = 3.643
Odchylenia od średniej: -2 -4 1 -3 -1 9 -3 0 -2 4 -1 2
Sześciany odchyleń: -8 -64 1 -27 -1 729 -27 0 -8 64 -1 8
Suma kwadratów = 146 ; suma sześcianów = 666
m2 = suma kwadratów / n = 12.167 ; m3 = suma sześcianów / n = 55.500
g1 = m3 / m2^1.5 (współczynnik momentowy) = 1.308
G1 = g1 * sqrt(n(n - 1)) / (n - 2) (SPSS, Excel) = 1.503
b1 = g1 * ((n - 1) / n)^1.5 = 1.148
Skośność Pearsona 3(M - Me) / SD = 0.823
Bez ucznia z 13 nieobecnościami: g1 = 0.640
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jak obliczyć medianę z szeregu rozdzielczego przedziałowego?
Wyznacz pozycję N / 2, znajdź w kolumnie liczebności skumulowanych przedział, który ją zawiera, i interpoluj: Me = x0 + (N/2 − nskum,−1) / n0 × h. W zadaniu 4 daje to 6000 + (40 − 26) / 24 × 1000 = 6583.33 zł. Kwartyle liczysz tak samo, z pozycjami N/4 i 3N/4.
Dlaczego kalkulator, Excel i R dają różne kwartyle dla tych samych danych?
Bo istnieje kilka definicji kwartyla z próby, a programy domyślnie używają różnych. Dla czasów obsługi z zadania 6 pierwszy kwartyl wynosi 4.5 (typ 6, jak w SPSS), 5 (mediana dolnej połowy) albo 5.25 (typ 7, domyślny w R). Przy dużych próbach różnice maleją; w pracy napisz, której definicji użyłeś(-aś).
Czy wariancję z szeregu rozdzielczego dzieli się przez N czy przez N − 1?
Gdy opisujesz całą badaną zbiorowość (np. wszystkich pracowników firmy), dzielisz przez N; gdy traktujesz dane jako próbę i wnioskujesz o populacji, dzielisz przez N − 1. W zadaniu 5 daje to s = 1375.62 zł albo 1384.30 zł. Na kolokwium stosuj wersję z wykładu.
Kiedy porównywać współczynniki zmienności, a kiedy odchylenia standardowe?
Odchylenia standardowe porównuj, gdy grupy mają podobne średnie i te same jednostki. Gdy średnie wyraźnie się różnią albo cechy mają różne jednostki, porównuj współczynniki zmienności. W zadaniu 7 większy oddział ma dwa razy większe SD, ale mniejszy współczynnik zmienności (10.62% wobec 18.90%).
Który wzór na współczynnik asymetrii stosować na kolokwium?
Ten, który podano na wykładzie, bo wyniki różnią się między wzorami. Dla tych samych nieobecności z zadania 9 współczynnik momentowy wynosi 1.308, wersja z korektą na małą próbę (jak w SPSS) 1.503, a współczynnik Pearsona z medianą 0.823. Wszystkie mają ten sam znak, więc wniosek o kierunku asymetrii się nie zmienia.
Powiązane hasła
Przeczytaj też
Zadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →PoradnikStatystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →Masz własne dane do pracy i nie wiesz, jak je opisać?
Pomożemy dobrać miary i analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aczel, A. D., & Sounderpandian, J. (2018). Statystyka w zarządzaniu (Wyd. 2). Wydawnictwo Naukowe PWN.
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- von Hippel, P. T. (2005). Mean, median, and skew: Correcting a textbook rule. Journal of Statistics Education, 13(2). https://doi.org/10.1080/10691898.2005.11910556 ● Otwarty dostęp
Cytowania BibTeX
@book{aczel2018statystyka, author={Aczel, Amir D. and Sounderpandian, Jayavel}, title={{Statystyka w zarządzaniu}}, year={2018}, edition={Wyd. 2}, publisher={Wydawnictwo Naukowe PWN}}@article{hyndman1996sample, author={Hyndman, Rob J. and Fan, Yanan}, title={{Sample quantiles in statistical packages}}, journal={The American Statistician}, year={1996}, volume={50}, number={4}, pages={361--365}, doi={10.1080/00031305.1996.10473566}}@article{joanes1998comparing, author={Joanes, D. N. and Gill, C. A.}, title={{Comparing measures of sample skewness and kurtosis}}, journal={Journal of the Royal Statistical Society: Series D (The Statistician)}, year={1998}, volume={47}, number={1}, pages={183--189}, doi={10.1111/1467-9884.00122}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{krzywinski2014visualizing, author={Krzywinski, Martin and Altman, Naomi}, title={{Visualizing samples with box plots}}, journal={Nature Methods}, year={2014}, volume={11}, number={2}, pages={119--120}, doi={10.1038/nmeth.2813}}@book{tukey1977exploratory, author={Tukey, John W.}, title={{Exploratory data analysis}}, year={1977}, publisher={Addison-Wesley}}@article{vonhippel2005mean, author={von Hippel, Paul T.}, title={{Mean, median, and skew: Correcting a textbook rule}}, journal={Journal of Statistics Education}, year={2005}, volume={13}, number={2}, doi={10.1080/10691898.2005.11910556}}