Zadania ze statystyki na psychologii: jak z nich korzystać
Na kolokwium ze statystyki na psychologii zwykle nie ma komputera. Jest kalkulator, tablice rozkładów i kilka zadań z krótką historyjką: wyniki testu inteligencji, lęk przed egzaminem, terapia przed i po. Poniżej znajdziesz 10 zadań ze statystyki z rozwiązaniami w takim właśnie stylu. Dane są małe (od 8 do 16 osób albo gotowa tabela), więc każde zadanie policzysz ręcznie w kilka minut.
Każde zadanie ma ten sam układ: treść z danymi, rozwiązanie krok po kroku (wzór, podstawienie, wynik pośredni, wynik końcowy i wartość krytyczna albo p), interpretację w stylu APA i jeden typowy błąd. Najpierw spróbuj sam(a), dopiero potem czytaj rozwiązanie. Wyniki zaokrąglamy do dwóch miejsc po kropce, a wszystkie liczby sprawdziliśmy w R (kod na końcu wpisu). Jeśli przy rachunku ręcznym wyjdzie Ci inna ostatnia cyfra, to zwykle skutek wcześniejszego zaokrąglenia, a nie błąd.
Ten wpis to zbiór ćwiczeń. Jeśli chcesz najpierw zobaczyć, jakie analizy pojawiają się w pracach z psychologii i po co psychologowi statystyka, przeczytaj statystykę dla psychologa i statystykę dla psychologów. Wzory i przykłady w zadaniach są standardowe – znajdziesz je w podręcznikach statystyki dla psychologów (King i Minium, 2009; Field, 2018).
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | lęk przed egzaminem u 8 studentów | średnia, mediana, SD (z n − 1) |
| 2 | wynik surowy w teście inteligencji | wynik z, skala IQ, sten, centyl |
| 3 | ilu studentów ma IQ 85–115, a ilu powyżej 130 | pole pod krzywą normalną |
| 4 | efekt Stroopa u 10 osób | 95% przedział ufności dla średniej (t) |
| 5 | trening relaksacji a lęk | test t dla prób niezależnych, d Cohena |
| 6 | objawy depresji przed terapią i po niej | test t dla prób zależnych, dz |
| 7 | samoocena a poczucie samotności | korelacja Pearsona, r², test istotności |
| 8 | płeć a strategia radzenia sobie ze stresem | χ² 2 × 2, liczności oczekiwane, φ |
| 9 | zapamiętywanie słów w ciszy, przy muzyce i w hałasie | ANOVA jednoczynnikowa, η², post hoc |
| 10 | godziny nauki a wynik egzaminu | regresja liniowa prosta, przewidywanie, R² |
Wartości krytyczne podajemy przy każdym zadaniu, ale warto umieć je odczytać samodzielnie z tablic rozkładów t, χ² i F. Dane do zadań z surowymi wynikami (wszystkie poza 2 i 3) możesz pobrać w jednym pliku: statystyka-psychologia-zadania-dane.csv (format długi: zadanie, osoba, grupa, zmienna, wartość). Plik otworzysz w SPSS, jamovi albo R i sprawdzisz w programie swoje rachunki.
Zadanie 1. Średnia, mediana i odchylenie standardowe
Treść zadania
Ośmiu studentów wypełniło skalę lęku przed egzaminem (wyniki od 10 do 50). Uzyskali: 24, 31, 28, 35, 22, 30, 41, 29. Oblicz średnią, medianę i odchylenie standardowe z próby.
Rozwiązanie krok po kroku
Krok 1. Średnia. Suma wyników wynosi 240, a n = 8.
Krok 2. Mediana. Uporządkuj wyniki: 22, 24, 28, 29, 30, 31, 35, 41. Przy parzystej liczbie wyników mediana to średnia dwóch środkowych: Me = (29 + 30) / 2 = 29.50.
Krok 3. Odchylenia i ich kwadraty. Odejmij średnią od każdego wyniku: −6, 1, −2, 5, −8, 0, 11, −1 (suma odchyleń zawsze wynosi 0 – to dobra kontrola). Kwadraty: 36, 1, 4, 25, 64, 0, 121, 1. Ich suma to SS = 252.
Krok 4. Wariancja i SD. W próbie dzielisz przez n − 1, czyli przez stopnie swobody:
Interpretacja
Studenci uzyskali średnio M = 30.00 punktu (SD = 6.00, Me = 29.50). Średnia i mediana są bliskie, więc jeden wysoki wynik (41) nie przesunął mocno średniej. Więcej o tym, co mówi odchylenie standardowe, przeczytasz w słowniku.
Typowy błąd
Dzielenie przez n zamiast n − 1: daje SD = 5.61 zamiast 6.00, czyli odchylenie populacji, a nie oszacowanie z próby (kalkulatory mają często dwa przyciski: σn i sn−1).
Zadanie 2. Wynik z, skala IQ, sten i centyl
Treść zadania
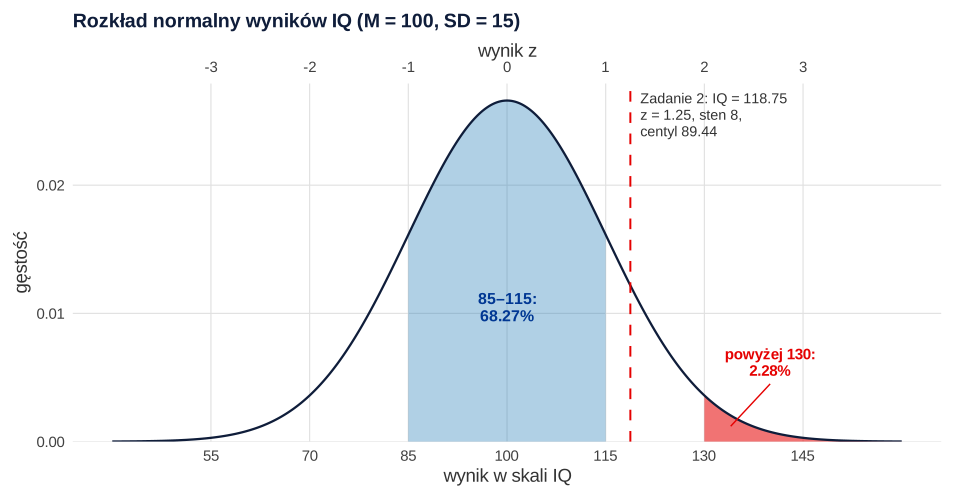
Studentka uzyskała 52 punkty surowe w teście zdolności poznawczych. W normach testu M = 42, SD = 8. Przelicz jej wynik na wynik z, wynik w skali IQ (M = 100, SD = 15), sten i centyl, zakładając rozkład normalny.
Rozwiązanie krok po kroku
Krok 1. Wynik z (standaryzacja):
Krok 2. Skala IQ. Każda skala standardowa to M + SD × z: IQ = 100 + 15 × 1.25 = 118.75. Przy okazji wynik tenowy: 50 + 10 × 1.25 = 62.50.
Krok 3. Sten. Skala stenowa ma średnią 5.5 i SD = 2: 5.5 + 2 × 1.25 = 8.00. Po zaokrągleniu i ograniczeniu do zakresu 1–10 – sten 8.
Krok 4. Centyl. Odczytaj z tablicy rozkładu normalnego pole na lewo od z = 1.25: 0.8944. Centyl = 89.44, czyli ok. 89.
Interpretacja
Wynik studentki leży 1.25 odchylenia standardowego powyżej średniej norm. Odpowiada to IQ ok. 119 i stenowi 8 (wynik wysoki); w grupie normalizacyjnej ok. 89% osób ma wynik niższy. W prawdziwym teście korzystaj z tabel norm z podręcznika – wzór to przybliżenie dla rozkładu normalnego.
Typowy błąd
Mylenie centyla z odsetkiem poprawnych odpowiedzi: centyl 89 nie znaczy „89% zadań dobrze”, tylko „lepiej niż ok. 89% grupy odniesienia”.
Zadanie 3. Ile osób mieści się w przedziale rozkładu normalnego
Treść zadania
Wyniki IQ mają rozkład normalny z M = 100 i SD = 15. Jaki odsetek osób ma IQ między 85 a 115, a jaki powyżej 130? Ile takich osób spodziewasz się na roku liczącym 200 studentów (zakładając, że rok nie różni się od populacji)?
Rozwiązanie krok po kroku
Krok 1. Zamień granice na z. 85 → z = −1.00; 115 → z = 1.00; 130 → z = 2.00.
Krok 2. Pole między −1 a 1. Z tablicy: Φ(1) − Φ(−1) = 0.6827, czyli 68.27%. Na 200 osób: 200 × 0.6827 = 136.54, czyli ok. 137 osób.
Krok 3. Pole powyżej 2. 1 − Φ(2) = 0.0228, czyli 2.28%. Na 200 osób: 200 × 0.0228 = 4.55, czyli ok. 5 osób.
Dla wprawy: IQ między 70 a 85 (z od −2 do −1) ma 13.59% osób, czyli 27.18 z 200.
Interpretacja
W rozkładzie normalnym ok. 68% wyników leży w odległości jednego SD od średniej, a tylko ok. 2% powyżej +2 SD. Na roku z 200 osobami IQ powyżej 130 miałoby więc ok. 5 osób.
Typowy błąd
Odczytanie z tablicy pola na lewo od z = 2 (0.9772) jako odsetka osób powyżej 130 – zawsze naszkicuj krzywą i zaznacz, którą część pola liczysz.
Zadanie 4. Przedział ufności 95% dla średniej
Treść zadania
Dziesięć osób wykonało zadanie Stroopa. Efekt interferencji (czas reakcji w próbach niezgodnych minus zgodnych, w ms) wyniósł: 85, 112, 96, 130, 74, 101, 118, 92, 105, 87. Oblicz 95% przedział ufności dla średniego efektu.
Rozwiązanie krok po kroku
Krok 1. Średnia i SD. M = 100.00 ms, SD = 16.81 ms (licz jak w zadaniu 1).
Krok 2. Błąd standardowy średniej. SE = SD / √n = 16.81 / √10 = 5.32.
Krok 3. Wartość krytyczna t. Przy df = n − 1 = 9 i 95% ufności: tkryt = 2.262.
Interpretacja
Średni efekt Stroopa wyniósł M = 100.00 ms, 95% CI [87.97, 112.03]. Przedział nie obejmuje zera, więc dane są zgodne z wyraźną interferencją. Przedział ufności opisuje precyzję oszacowania: przy 10 osobach jego szerokość to ok. 24 ms.
Typowy błąd
Użycie 1.96 z rozkładu normalnego zamiast t przy małej próbie: daje za wąski przedział [89.58, 110.42].
Zadanie 5. Test t dla prób niezależnych i d Cohena
Treść zadania
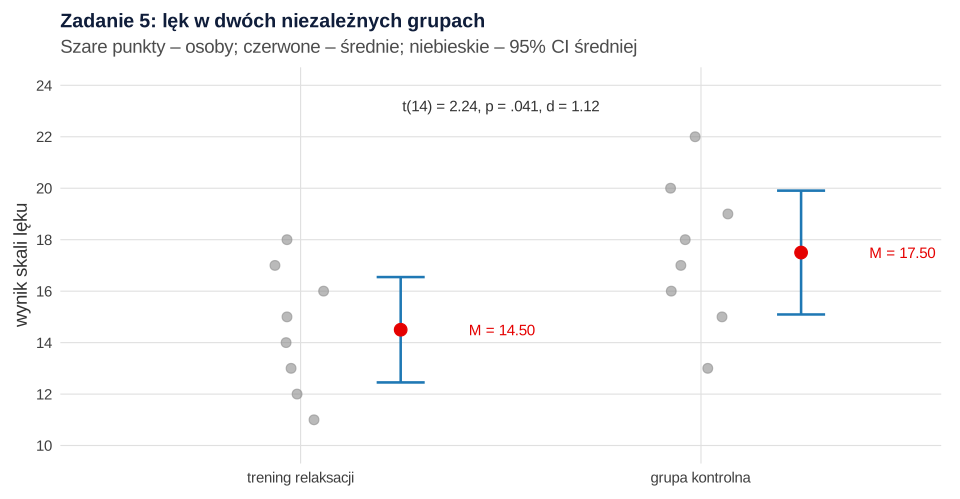
Ośmiu studentów przeszło trening relaksacji, ośmiu innych było w grupie kontrolnej. Przed sesją zmierzono poziom lęku (wyższy wynik = większy lęk). Trening: 14, 18, 12, 16, 11, 15, 13, 17. Kontrola: 19, 15, 17, 22, 13, 18, 16, 20. Czy grupy różnią się poziomem lęku (α = .05, test dwustronny)? Oblicz d Cohena.
Rozwiązanie krok po kroku
Krok 1. Statystyki opisowe. Trening: M = 14.50, SD = 2.45 (s² = 6.00). Kontrola: M = 17.50, SD = 2.88 (s² = 8.29).
Krok 2. Łączone SD (równe liczebności, więc to pierwiastek ze średniej wariancji):
Krok 3. Statystyka t. Błąd standardowy różnicy: SE = sp × √(1/8 + 1/8) = 1.34.
Krok 4. Decyzja. tkryt(14) = 2.145. Ponieważ 2.24 > 2.145, odrzucasz H0; dokładnie p = .041.
Krok 5. Wielkość efektu. d = (17.50 − 14.50) / 2.67 = 1.12. Według konwencji Cohena (1992) to efekt duży, ale przy 8 osobach na grupę oszacowanie jest bardzo nieprecyzyjne: 95% CI dla różnicy średnich to [0.13, 5.87].
Interpretacja
Więcej o tym teście: test t dla prób niezależnych i interpretacja d Cohena. W pracy empirycznej domyślnie wybierz test Welcha, który nie zakłada równych wariancji – tu daje prawie to samo: t(13.65) = 2.24, p = .042.
Typowy błąd
Podanie samego „p < .05” bez średnich, SD i wielkości efektu – Fritz i in. (2012) przejrzeli artykuły z jednego czasopisma psychologicznego z lat 2009–2010 i w dwóch trzecich artykułów z testami t nie znaleźli wielkości efektu.
Zadanie 6. Test t dla prób zależnych (terapia przed i po)
Treść zadania
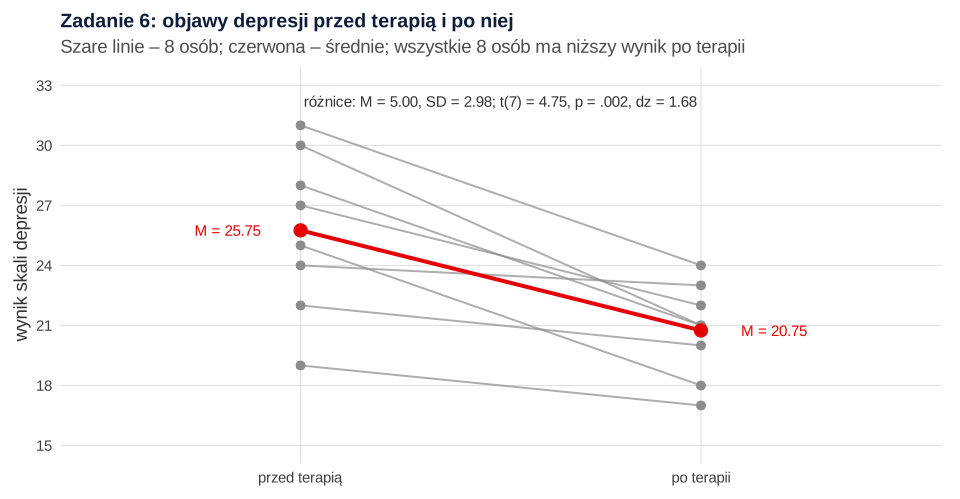
Ośmiu pacjentów wypełniło skalę objawów depresji przed terapią i po 10 sesjach. Przed: 28, 22, 31, 25, 19, 27, 24, 30. Po: 21, 20, 24, 18, 17, 22, 23, 21 (ta sama kolejność osób). Czy objawy się zmniejszyły? Oblicz dz.
Rozwiązanie krok po kroku
Krok 1. Różnice dla każdej osoby (przed − po): 7, 2, 7, 7, 2, 5, 1, 9.
Krok 2. Średnia i SD różnic. MD = 5.00, SDD = 2.98; SE = 2.98 / √8 = 1.05.
Krok 3. Decyzja. tkryt(7) = 2.365; 4.75 > 2.365, p = .002. 95% CI dla średniej zmiany: [2.51, 7.49].
Krok 4. Wielkość efektu. dz = MD / SDD = 5.00 / 2.98 = 1.68. Lakens (2013) szczegółowo porównuje miary efektu dla schematów wewnątrz- i międzyosobowych: dz uwzględnia korelację między pomiarami, więc nie jest tym samym co d z zadania 5. Zawsze napisz, którą miarę podajesz (zob. wielkość efektu dla prób zależnych).
Interpretacja
Bez grupy kontrolnej nie wiesz jednak, czy spadek to efekt terapii, czy np. upływu czasu. Szczegóły testu: test t dla prób zależnych.
Typowy błąd
Policzenie testu dla prób niezależnych na danych przed–po: daje t(14) = 3.01, p = .009, bo pomija korelację pomiarów (r = .69) i traktuje te same osoby jak dwie różne grupy.
Zadanie 7. Korelacja Pearsona i jej istotność
Treść zadania
Dziesięciu studentów pierwszego roku wypełniło skalę samooceny i skalę poczucia samotności. Samoocena: 30, 25, 34, 22, 28, 36, 20, 31, 26, 28. Samotność: 36, 44, 35, 42, 41, 37, 40, 39, 45, 41. Oblicz współczynnik korelacji Pearsona, r² i sprawdź istotność (α = .05).
Rozwiązanie krok po kroku
Krok 1. Średnie. MX = 28.00, MY = 40.00.
Krok 2. Sumy z odchyleń. Dla każdej osoby policz odchylenia od średnich, ich iloczyn i kwadraty. Suma iloczynów SP = −99, SSX = 226, SSY = 98.
Krok 3. Wariancja wspólna. r² = .443, czyli ok. 44% zmienności samotności wiąże się z samooceną.
Krok 4. Decyzja. |−2.52| > tkryt(8) = 2.306, p = .036.
Interpretacja
Zwróć uwagę na przedział ufności: przy 10 osobach prawdziwa korelacja może być zarówno bardzo silna, jak i bliska zera. Więcej: korelacja Pearsona.
Typowy błąd
Wniosek „niska samoocena powoduje samotność” – z korelacji nie wynika kierunek ani przyczyna; samotność może obniżać samoocenę albo obie zależeć od trzeciej zmiennej (zob. korelacja a przyczynowość).
Zadanie 8. Test chi-kwadrat 2 × 2 i współczynnik φ
Treść zadania
W grupie 60 studentów sprawdzono dominującą strategię radzenia sobie ze stresem przed sesją. Wśród 30 kobiet 12 wybierało strategię zadaniową, a 18 – emocjonalną. Wśród 30 mężczyzn 20 – zadaniową, a 10 – emocjonalną. Czy strategia zależy od płci? Oblicz φ.
Rozwiązanie krok po kroku
Krok 1. Liczności oczekiwane (przy braku związku): E = suma wiersza × suma kolumny / N. Strategia zadaniowa: 30 × 32 / 60 = 16; emocjonalna: 30 × 28 / 60 = 14 (tak samo w obu wierszach). Wszystkie E ≥ 5, więc test χ² jest odpowiedni.
| Płeć | Zadaniowa: O (E) | Emocjonalna: O (E) | Razem |
|---|---|---|---|
| Kobiety | 12 (16) | 18 (14) | 30 |
| Mężczyźni | 20 (16) | 10 (14) | 30 |
| Razem | 32 | 28 | 60 |
Krok 2. Składniki (O − E)² / E: 16/16 = 1.000 i 16/14 = 1.143, po dwa razy.
Krok 3. Decyzja. χ²kryt(1) = 3.84; 4.29 > 3.84, p = .038.
Krok 4. Siła związku. φ = √(χ² / N) = √(4.29 / 60) = .27.
Interpretacja
Więcej o teście: test chi-kwadrat niezależności, współczynnik φ i dłuższy przykład w poradniku test chi-kwadrat krok po kroku.
Typowy błąd
Nieświadome porównanie z programem, który dla tabeli 2 × 2 domyślnie stosuje poprawkę Yatesa (tak robi R): wtedy χ² = 3.28, p = .070 – zawsze napisz, którą wersję testu liczysz.
Zadanie 9. ANOVA jednoczynnikowa dla trzech grup
Treść zadania
Piętnaście osób uczyło się listy 20 słów w jednym z trzech warunków (po 5 osób). Liczba zapamiętanych słów: cisza – 12, 15, 10, 14, 9; muzyka – 17, 13, 16, 18, 11; hałas – 9, 12, 7, 13, 9. Czy warunek wpływa na zapamiętywanie? Wypełnij tabelę ANOVA i oblicz η².
Rozwiązanie krok po kroku
Krok 1. Średnie. Cisza: 12.00, muzyka: 15.00, hałas: 10.00; średnia ogólna: 12.33.
Krok 2. Suma kwadratów między grupami:
Krok 3. Suma kwadratów wewnątrz grup. W każdej grupie zsumuj kwadraty odchyleń od średniej grupy: 26 + 34 + 24 = 84.00.
Krok 4. Tabela ANOVA.
| Źródło | SS | df | MS | F |
|---|---|---|---|---|
| Między grupami | 63.33 | 2 | 31.67 | 4.52 |
| Wewnątrz grup | 84.00 | 12 | 7.00 | |
| Ogółem | 147.33 | 14 |
Krok 5. Decyzja i efekt. Fkryt(2, 12) = 3.89; 4.52 > 3.89, p = .034. η² = SSB / SST = 63.33 / 147.33 = .43. Lakens (2013) przypomina, że η² to oszacowanie z próby obciążone w górę – przy tak małej próbie traktuj je ostrożnie (zob. eta kwadrat).
Krok 6. Post hoc. Istotne F mówi tylko, że jakieś średnie się różnią. Test Tukeya pokazuje, że różni się tylko para muzyka–hałas (różnica 5 słów, p = .028); cisza nie różni się istotnie ani od muzyki (p = .213), ani od hałasu (p = .478).
Interpretacja
Pełny przykład z założeniami znajdziesz w poradniku ANOVA krok po kroku, a wzór tabeli w artykule – w haśle tabela APA dla ANOVA.
Typowy błąd
Zamiast jednej ANOVA trzy testy t dla każdej pary grup – każdy test dokłada ryzyko błędu I rodzaju, więc łączne ryzyko jest większe niż .05.
Zadanie 10. Regresja liniowa prosta i przewidywanie
Treść zadania
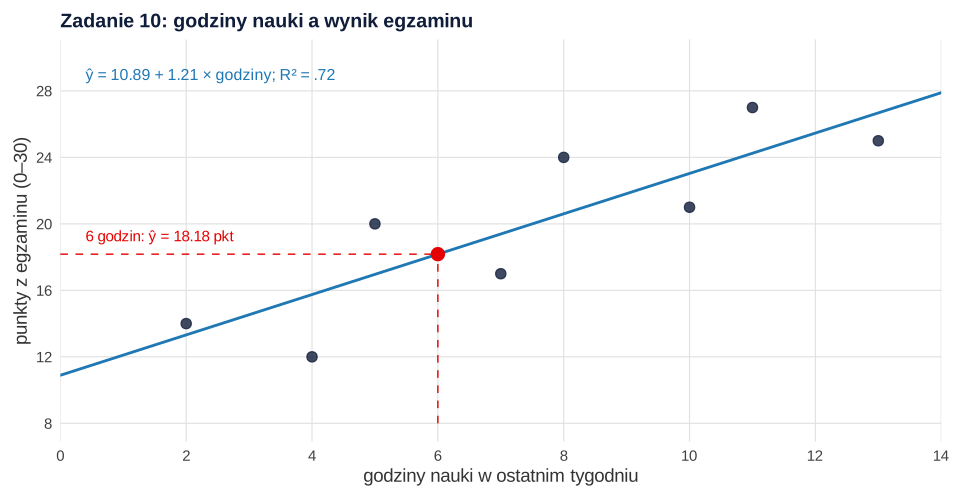
Ośmiu studentów podało liczbę godzin nauki w tygodniu przed egzaminem i uzyskało punkty (0–30). Godziny: 2, 4, 5, 7, 8, 10, 11, 13. Punkty: 14, 12, 20, 17, 24, 21, 27, 25. Wyznacz równanie regresji, przewidź wynik osoby, która uczy się 6 godzin, i oblicz R².
Rozwiązanie krok po kroku
Krok 1. Średnie i sumy. MX = 7.50, MY = 20.00; SP = 119, SSX = 98, SSY = 200 (liczysz jak w zadaniu 7).
Krok 2. Równanie i przewidywanie. ŷ = 10.89 + 1.21 × godziny. Dla 6 godzin: ŷ = 10.893 + 1.214 × 6 = 18.18 punktu.
Krok 3. Dopasowanie. R² = SP² / (SSX × SSY) = 119² / (98 × 200) = .72. Test nachylenia: t(6) = 3.95, p = .008 (w regresji prostej to ten sam test co F(1, 6) = 15.62).
Interpretacja
Stała a = 10.89 to przewidywany wynik osoby, która w ogóle się nie uczyła – ma sens tylko wtedy, gdy zero leży blisko zakresu danych. Więcej: regresja liniowa.
Typowy błąd
Przewidywanie poza zakresem danych: dla 30 godzin równanie daje 47.32 punktu, choć maksimum egzaminu to 30.
Jak wybrać test do zadania: krótka ściąga
Na kolokwium najwięcej punktów traci się nie na rachunkach, tylko na wyborze metody. Zanim zaczniesz liczyć, odpowiedz na trzy pytania: ile jest zmiennych, na jakiej skali są mierzone i czy grupy są niezależne (różne osoby), czy zależne (te same osoby dwa razy).
| Sytuacja w treści zadania | Metoda | Wielkość efektu |
|---|---|---|
| Opis jednej zmiennej ilościowej | M, Me, SD; przedział ufności dla średniej | – |
| Pozycja osoby względem norm | wynik z, skale standardowe, pole pod krzywą normalną | – |
| Dwie niezależne grupy, wynik ilościowy | test t dla prób niezależnych (w pracy: Welch) | d Cohena |
| Te same osoby zmierzone dwa razy | test t dla prób zależnych | dz |
| Trzy i więcej niezależnych grup | ANOVA jednoczynnikowa + post hoc | η² |
| Dwie zmienne ilościowe, pytanie o związek | korelacja Pearsona | r, r² |
| Przewidywanie jednej zmiennej z drugiej | regresja liniowa | R² |
| Dwie zmienne jakościowe (kategorie) | test χ² niezależności | φ (2 × 2) lub V Craméra |
Pełniejszy schemat, z testami nieparametrycznymi i modelami dla wielu zmiennych, znajdziesz we wpisie jaki test statystyczny do jakiej hipotezy. Pamiętaj też, że wartość p nie mówi, jak duży jest efekt – dlatego w każdym zadaniu podaliśmy osobno wielkość efektu, zgodnie z zaleceniami stylu APA (American Psychological Association, 2020).
Jeśli po kolokwium przychodzi czas na własne badanie do pracy dyplomowej, a dane są większe niż w tych zadaniach, możesz skorzystać z konsultacji analizy statystycznej dla studentów – pomożemy dobrać metodę i wyjaśnimy wyniki tak, żebyś umiał(a) je samodzielnie opisać.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone dwa razy: najpierw wzorem, tak jak na kartce, potem gotową funkcją R jako kontrola. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–4: statystyki opisowe, wynik z, sten, centyl i przedział ufności
R
# B375 – zadania 1–4: statystyki opisowe, wynik z, sten, centyl, rozkład normalny, przedział ufności
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R.
z2 <- function(x) formatC(x, format = "f", digits = 2)   # zapis z 2 miejscami po kropce

# Zadanie 1. Lęk przed egzaminem (8 studentów, wynik 10–50)
lek <- c(24, 31, 28, 35, 22, 30, 41, 29)
n <- length(lek); M <- sum(lek) / n
odch <- lek - M
cat("Zadanie 1\n")
cat("Suma =", sum(lek), "; n =", n, "; M =", z2(M), "\n")
cat("Odchylenia od średniej:", odch, "\n")
cat("Kwadraty odchyleń:", odch^2, "; suma kwadratów SS =", sum(odch^2), "\n")
cat("Wariancja (n - 1) =", z2(sum(odch^2) / (n - 1)), "; SD =", z2(sqrt(sum(odch^2) / (n - 1))), "\n")
cat("Kontrola: mean =", z2(mean(lek)), "; median =", z2(median(lek)), "; sd =", z2(sd(lek)), "\n")
cat("Uporządkowane:", sort(lek), "\n")
cat("Błąd: SD liczone z n zamiast n - 1 =", z2(sqrt(sum(odch^2) / n)), "\n\n")

# Zadanie 2. Wynik surowy 52 pkt w teście o normach M = 42, SD = 8
x <- 52; Mn <- 42; SDn <- 8
z <- (x - Mn) / SDn
sten <- min(10, max(1, round(5.5 + 2 * z)))
cat("Zadanie 2\n")
cat("z =", z2(z), "\n")
cat("Wynik w skali IQ (M = 100, SD = 15) =", z2(100 + 15 * z), "\n")
cat("Wynik tenowy (M = 50, SD = 10) =", z2(50 + 10 * z), "\n")
cat("5.5 + 2z =", z2(5.5 + 2 * z), "; sten =", sten, "\n")
cat("Centyl = 100 * pnorm(z) =", z2(100 * pnorm(z)), "\n\n")

# Zadanie 3. Odsetki osób w przedziałach IQ (M = 100, SD = 15) i liczba osób w grupie 200 studentów
cat("Zadanie 3\n")
p_85_115 <- pnorm(115, 100, 15) - pnorm(85, 100, 15)
p_130 <- 1 - pnorm(130, 100, 15)
p_70_85 <- pnorm(85, 100, 15) - pnorm(70, 100, 15)
cat("z dla 85, 115, 130, 70:", z2((c(85, 115, 130, 70) - 100) / 15), "\n")
cat("P(85 < IQ < 115) =", z2(100 * p_85_115), "%; oczekiwana liczba z 200 =", z2(200 * p_85_115), "\n")
cat("P(IQ > 130)      =", z2(100 * p_130), "%; oczekiwana liczba z 200 =", z2(200 * p_130), "\n")
cat("P(70 < IQ < 85)  =", z2(100 * p_70_85), "%; oczekiwana liczba z 200 =", z2(200 * p_70_85), "\n\n")

# Zadanie 4. Efekt Stroopa: różnica czasu reakcji (ms) u 10 osób, 95% przedział ufności dla średniej
stroop <- c(85, 112, 96, 130, 74, 101, 118, 92, 105, 87)
n4 <- length(stroop); M4 <- mean(stroop); SD4 <- sd(stroop)
SE4 <- SD4 / sqrt(n4); tkr <- qt(0.975, df = n4 - 1)
cat("Zadanie 4\n")
cat("n =", n4, "; M =", z2(M4), "; SD =", z2(SD4), "; SE =", z2(SE4), "\n")
cat("t krytyczne (df = 9, 95%) =", formatC(tkr, format = "f", digits = 3), "; margines błędu =", z2(tkr * SE4), "\n")
cat("95% CI = [", z2(M4 - tkr * SE4), ",", z2(M4 + tkr * SE4), "]\n")
cat("Kontrola t.test():", z2(t.test(stroop)$conf.int), "\n")
cat("Błąd: z = 1.96 zamiast t daje [", z2(M4 - 1.96 * SE4), ",", z2(M4 + 1.96 * SE4), "]\n")
Wynik w R
Zadanie 1
Suma = 240 ; n = 8 ; M = 30.00
Odchylenia od średniej: -6 1 -2 5 -8 0 11 -1
Kwadraty odchyleń: 36 1 4 25 64 0 121 1 ; suma kwadratów SS = 252
Wariancja (n - 1) = 36.00 ; SD = 6.00
Kontrola: mean = 30.00 ; median = 29.50 ; sd = 6.00
Uporządkowane: 22 24 28 29 30 31 35 41
Błąd: SD liczone z n zamiast n - 1 = 5.61

Zadanie 2
z = 1.25
Wynik w skali IQ (M = 100, SD = 15) = 118.75
Wynik tenowy (M = 50, SD = 10) = 62.50
5.5 + 2z = 8.00 ; sten = 8
Centyl = 100 * pnorm(z) = 89.44

Zadanie 3
z dla 85, 115, 130, 70: -1.00 1.00 2.00 -2.00
P(85 < IQ < 115) = 68.27 %; oczekiwana liczba z 200 = 136.54
P(IQ > 130)      = 2.28 %; oczekiwana liczba z 200 = 4.55
P(70 < IQ < 85)  = 13.59 %; oczekiwana liczba z 200 = 27.18

Zadanie 4
n = 10 ; M = 100.00 ; SD = 16.81 ; SE = 5.32
t krytyczne (df = 9, 95%) = 2.262 ; margines błędu = 12.03
95% CI = [ 87.97 , 112.03 ]
Kontrola t.test(): 87.97 112.03
Błąd: z = 1.96 zamiast t daje [ 89.58 , 110.42 ]
Zadania 5–10: testy t, korelacja, chi-kwadrat, ANOVA i regresja
R
# B375 – zadania 5–10: test t (niezależny i zależny), korelacja Pearsona, chi-kwadrat, ANOVA, regresja
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))   # bez zera przed kropką (p, r, R², φ, η²)

# Zadanie 5. Lęk po treningu relaksacji (n = 8) i w grupie kontrolnej (n = 8)
relaks <- c(14, 18, 12, 16, 11, 15, 13, 17)
kontrola <- c(19, 15, 17, 22, 13, 18, 16, 20)
n1 <- length(relaks); n2 <- length(kontrola)
sp <- sqrt(((n1 - 1) * var(relaks) + (n2 - 1) * var(kontrola)) / (n1 + n2 - 2))
t5 <- (mean(kontrola) - mean(relaks)) / (sp * sqrt(1 / n1 + 1 / n2))
cat("Zadanie 5\n")
cat("M relaks =", z2(mean(relaks)), "; SD =", z2(sd(relaks)), "| M kontrola =", z2(mean(kontrola)), "; SD =", z2(sd(kontrola)), "\n")
cat("Wariancje:", z2(var(relaks)), z2(var(kontrola)), "; SD łączone =", z2(sp), "; SE różnicy =", z2(sp * sqrt(1 / n1 + 1 / n2)), "\n")
cat("t(", n1 + n2 - 2, ") =", z2(t5), "; t krytyczne =", z3(qt(0.975, n1 + n2 - 2)), "; p =", bz(2 * pt(-abs(t5), n1 + n2 - 2)), "\n")
cat("d Cohena =", z2((mean(kontrola) - mean(relaks)) / sp), "\n")
tt5 <- t.test(kontrola, relaks, var.equal = TRUE)
cat("Kontrola t.test(): t =", z2(tt5$statistic), "; p =", bz(tt5$p.value), "; 95% CI różnicy [", z2(tt5$conf.int), "]\n")
w5 <- t.test(kontrola, relaks)
cat("Test Welcha: t(", z2(w5$parameter), ") =", z2(w5$statistic), "; p =", bz(w5$p.value), "\n\n")

# Zadanie 6. Objawy depresji przed terapią i po niej (te same 8 osób)
przed <- c(28, 22, 31, 25, 19, 27, 24, 30)
po    <- c(21, 20, 24, 18, 17, 22, 23, 21)
roz <- przed - po
t6 <- mean(roz) / (sd(roz) / sqrt(length(roz)))
cat("Zadanie 6\n")
cat("Różnice przed - po:", roz, "\n")
cat("M przed =", z2(mean(przed)), "; M po =", z2(mean(po)), "; M różnic =", z2(mean(roz)), "; SD różnic =", z2(sd(roz)),
    "; SE =", z2(sd(roz) / sqrt(length(roz))), "\n")
cat("t(", length(roz) - 1, ") =", z2(t6), "; t krytyczne =", z3(qt(0.975, length(roz) - 1)), "; p =", bz(2 * pt(-abs(t6), length(roz) - 1)), "\n")
cat("d_z =", z2(mean(roz) / sd(roz)), "\n")
tt6 <- t.test(przed, po, paired = TRUE)
cat("Kontrola t.test(paired): t =", z2(tt6$statistic), "; p =", bz(tt6$p.value), "; 95% CI [", z2(tt6$conf.int), "]\n")
bl6 <- t.test(przed, po, var.equal = TRUE)
cat("Błąd – test dla prób niezależnych: t(14) =", z2(bl6$statistic), "; p =", bz(bl6$p.value), "\n")
cat("Korelacja przed–po: r =", bz(cor(przed, po)), "\n\n")

# Zadanie 7. Samoocena i poczucie samotności (10 studentów)
samoocena <- c(30, 25, 34, 22, 28, 36, 20, 31, 26, 28)
samotnosc <- c(36, 44, 35, 42, 41, 37, 40, 39, 45, 41)
dx <- samoocena - mean(samoocena); dy <- samotnosc - mean(samotnosc)
r <- sum(dx * dy) / sqrt(sum(dx^2) * sum(dy^2))
t7 <- r * sqrt(length(dx) - 2) / sqrt(1 - r^2)
cat("Zadanie 7\n")
cat("M samoocena =", z2(mean(samoocena)), "; M samotność =", z2(mean(samotnosc)), "\n")
cat("Suma iloczynów odchyleń SP =", sum(dx * dy), "; SSx =", sum(dx^2), "; SSy =", sum(dy^2),
    "; pierwiastek z SSx * SSy =", z2(sqrt(sum(dx^2) * sum(dy^2))), "\n")
cat("r =", bz(r), "; r^2 =", bz(r^2), "; t(", length(dx) - 2, ") =", z2(t7), "; t krytyczne =", z3(qt(0.975, length(dx) - 2)), "\n")
ct7 <- cor.test(samoocena, samotnosc)
cat("Kontrola cor.test(): r =", bz(ct7$estimate), "; p =", bz(ct7$p.value), "; 95% CI [", z2(ct7$conf.int), "]\n\n")

# Zadanie 8. Płeć a dominująca strategia radzenia sobie ze stresem (N = 60)
tab <- matrix(c(12, 20, 18, 10), nrow = 2,
              dimnames = list(plec = c("kobiety", "mężczyźni"), strategia = c("zadaniowa", "emocjonalna")))
E <- outer(rowSums(tab), colSums(tab)) / sum(tab)
skladniki <- (tab - E)^2 / E
chi <- sum(skladniki)
cat("Zadanie 8\n"); print(tab)
cat("Liczności oczekiwane:\n"); print(E)
cat("Składniki (O - E)^2 / E:\n"); print(round(skladniki, 3))
cat("chi^2(1) =", z2(chi), "; chi^2 krytyczne =", z2(qchisq(0.95, 1)), "; p =", bz(pchisq(chi, 1, lower.tail = FALSE)), "\n")
cat("phi =", bz(sqrt(chi / sum(tab))), "\n")
cat("Odsetek strategii zadaniowej: kobiety =", z2(100 * tab[1, 1] / sum(tab[1, ])), "%; mężczyźni =", z2(100 * tab[2, 1] / sum(tab[2, ])), "%\n")
ch8 <- chisq.test(tab, correct = FALSE)
cat("Kontrola chisq.test(correct = FALSE): chi^2 =", z2(ch8$statistic), "; p =", bz(ch8$p.value), "\n")
ch8y <- chisq.test(tab)
cat("Z poprawką Yatesa (domyślnie w R dla 2 x 2): chi^2 =", z2(ch8y$statistic), "; p =", bz(ch8y$p.value), "\n\n")

# Zadanie 9. Liczba zapamiętanych słów w trzech warunkach (po 5 osób)
slowa <- c(12, 15, 10, 14, 9,    # cisza
           17, 13, 16, 18, 11,   # muzyka
           9, 12, 7, 13, 9)      # hałas
warunek <- factor(rep(c("cisza", "muzyka", "hałas"), each = 5), levels = c("cisza", "muzyka", "hałas"))
Mg <- tapply(slowa, warunek, mean); Mc <- mean(slowa); ng <- tapply(slowa, warunek, length)
SSb <- sum(ng * (Mg - Mc)^2); SSw <- sum((slowa - Mg[warunek])^2); SSt <- sum((slowa - Mc)^2)
dfb <- nlevels(warunek) - 1; dfw <- length(slowa) - nlevels(warunek)
F9 <- (SSb / dfb) / (SSw / dfw)
cat("Zadanie 9\n")
cat("Średnie w grupach:", paste(names(Mg), z2(Mg)), "; średnia ogólna =", z2(Mc), "\n")
cat("SS wewnątrz w grupach:", tapply((slowa - Mg[warunek])^2, warunek, sum), "\n")
tabela <- data.frame(zrodlo = c("między grupami", "wewnątrz grup", "ogółem"),
                     SS = round(c(SSb, SSw, SSt), 2), df = c(dfb, dfw, dfb + dfw),
                     MS = c(round(c(SSb / dfb, SSw / dfw), 2), NA),
                     F = c(round(F9, 2), NA, NA))
print(tabela, row.names = FALSE)
cat("F krytyczne (2, 12) =", z2(qf(0.95, dfb, dfw)), "; p =", bz(pf(F9, dfb, dfw, lower.tail = FALSE)), "; eta^2 =", bz(SSb / SSt), "\n")
m9 <- aov(slowa ~ warunek)
print(summary(m9))
print(TukeyHSD(m9), digits = 3)
cat("\n")

# Zadanie 10. Godziny nauki a wynik egzaminu (punkty 0–30), 8 studentów
godziny <- c(2, 4, 5, 7, 8, 10, 11, 13)
punkty  <- c(14, 12, 20, 17, 24, 21, 27, 25)
dx <- godziny - mean(godziny); dy <- punkty - mean(punkty)
b <- sum(dx * dy) / sum(dx^2); a <- mean(punkty) - b * mean(godziny)
cat("Zadanie 10\n")
cat("M godziny =", z2(mean(godziny)), "; M punkty =", z2(mean(punkty)), "; SP =", sum(dx * dy), "; SSx =", sum(dx^2), "; SSy =", sum(dy^2), "\n")
cat("b =", z3(b), "; a =", z3(a), "; przewidywanie dla 6 godzin =", z2(a + b * 6), "\n")
cat("R^2 =", bz(sum(dx * dy)^2 / (sum(dx^2) * sum(dy^2))), "\n")
m10 <- lm(punkty ~ godziny)
print(round(summary(m10)$coefficients, 3))
cat("Kontrola lm(): R^2 =", bz(summary(m10)$r.squared), "; F(1, 6) =", z2(summary(m10)$fstatistic[1]),
    "; przewidywanie predict() =", z2(predict(m10, data.frame(godziny = 6))), "\n")
cat("Ekstrapolacja (30 godzin) =", z2(predict(m10, data.frame(godziny = 30))), "\n")
Wynik w R
Zadanie 5
M relaks = 14.50 ; SD = 2.45 | M kontrola = 17.50 ; SD = 2.88
Wariancje: 6.00 8.29 ; SD łączone = 2.67 ; SE różnicy = 1.34
t( 14 ) = 2.24 ; t krytyczne = 2.145 ; p = .041
d Cohena = 1.12
Kontrola t.test(): t = 2.24 ; p = .041 ; 95% CI różnicy [ 0.13 5.87 ]
Test Welcha: t( 13.65 ) = 2.24 ; p = .042

Zadanie 6
Różnice przed - po: 7 2 7 7 2 5 1 9
M przed = 25.75 ; M po = 20.75 ; M różnic = 5.00 ; SD różnic = 2.98 ; SE = 1.05
t( 7 ) = 4.75 ; t krytyczne = 2.365 ; p = .002
d_z = 1.68
Kontrola t.test(paired): t = 4.75 ; p = .002 ; 95% CI [ 2.51 7.49 ]
Błąd – test dla prób niezależnych: t(14) = 3.01 ; p = .009
Korelacja przed–po: r = .688

Zadanie 7
M samoocena = 28.00 ; M samotność = 40.00
Suma iloczynów odchyleń SP = -99 ; SSx = 226 ; SSy = 98 ; pierwiastek z SSx * SSy = 148.82
r = -.665 ; r^2 = .443 ; t( 8 ) = -2.52 ; t krytyczne = 2.306
Kontrola cor.test(): r = -.665 ; p = .036 ; 95% CI [ -0.91 -0.06 ]

Zadanie 8
           strategia
plec        zadaniowa emocjonalna
  kobiety          12          18
  mężczyźni        20          10
Liczności oczekiwane:
          zadaniowa emocjonalna
kobiety          16          14
mężczyźni        16          14
Składniki (O - E)^2 / E:
           strategia
plec        zadaniowa emocjonalna
  kobiety           1       1.143
  mężczyźni         1       1.143
chi^2(1) = 4.29 ; chi^2 krytyczne = 3.84 ; p = .038
phi = .267
Odsetek strategii zadaniowej: kobiety = 40.00 %; mężczyźni = 66.67 %
Kontrola chisq.test(correct = FALSE): chi^2 = 4.29 ; p = .038
Z poprawką Yatesa (domyślnie w R dla 2 x 2): chi^2 = 3.28 ; p = .070

Zadanie 9
Średnie w grupach: cisza 12.00 muzyka 15.00 hałas 10.00 ; średnia ogólna = 12.33
SS wewnątrz w grupach: 26 34 24
         zrodlo     SS df    MS    F
 między grupami  63.33  2 31.67 4.52
  wewnątrz grup  84.00 12  7.00   NA
         ogółem 147.33 14    NA   NA
F krytyczne (2, 12) = 3.89 ; p = .034 ; eta^2 = .430
            Df Sum Sq Mean Sq F value Pr(>F)
warunek      2  63.33   31.67   4.524 0.0343 *
Residuals   12  84.00    7.00
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = slowa ~ warunek)

$warunek
             diff   lwr    upr p adj
muzyka-cisza    3 -1.46  7.464 0.213
hałas-cisza    -2 -6.46  2.464 0.478
hałas-muzyka   -5 -9.46 -0.536 0.028


Zadanie 10
M godziny = 7.50 ; M punkty = 20.00 ; SP = 119 ; SSx = 98 ; SSy = 200
b = 1.214 ; a = 10.893 ; przewidywanie dla 6 godzin = 18.18
R^2 = .723
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   10.893      2.543   4.284    0.005
godziny        1.214      0.307   3.952    0.008
Kontrola lm(): R^2 = .723 ; F(1, 6) = 15.62 ; przewidywanie predict() = 18.18
Ekstrapolacja (30 godzin) = 47.32
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jakie zadania ze statystyki są na kolokwium na psychologii?
Najczęściej: statystyki opisowe (średnia, mediana, SD), przeliczanie wyników surowych na z, steny i centyle, pola pod krzywą normalną, przedział ufności, test t dla prób niezależnych i zależnych, korelacja Pearsona, test χ², ANOVA jednoczynnikowa i regresja prosta. Zakres zależy od uczelni, więc porównaj go z sylabusem przedmiotu.
Czy na kolokwium ze statystyki liczy się SD z n czy z n − 1?
Gdy opisujesz próbę i wnioskujesz o populacji, dziel sumę kwadratów odchyleń przez n − 1. W zadaniu 1 daje to SD = 6.00, a dzielenie przez n – 5.61. Na kalkulatorze wybierz przycisk oznaczony s lub σn−1.
Skąd wziąć wartość krytyczną t, χ² i F na kolokwium?
Z tablic rozkładów: dla t potrzebujesz liczby stopni swobody i poziomu α (dwustronnie), dla χ² – df = (wiersze − 1)(kolumny − 1), dla F – dwóch liczb stopni swobody. Na przykład tkryt(14) = 2.145, χ²kryt(1) = 3.84, Fkryt(2, 12) = 3.89 przy α = .05.
Jak zapisać wynik zadania ze statystyki w stylu APA?
Podaj statystykę z liczbą stopni swobody, dokładne p do trzech miejsc i wielkość efektu, np. t(14) = 2.24, p = .041, d = 1.12. Przed wynikiem testu podaj średnie i SD grup, a p, r i η² zapisuj bez zera przed kropką.
Jak sprawdzić, czy dobrze rozwiązałem zadanie ze statystyki?
Wpisz dane do programu (R, SPSS, jamovi) i porównaj wynik z rachunkiem ręcznym. Drobne różnice na ostatnim miejscu po kropce wynikają zwykle z zaokrągleń w trakcie liczenia. Większe różnice oznaczają najczęściej zły test (np. niezależny zamiast zależnego) albo pomyłkę w n − 1.
Powiązane hasła
Przeczytaj też
Zadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →PoradnikStatystyka dla psychologa
Analizy w pracy dyplomowej z psychologii: typowe projekty, wynik kwestionariusza, alfa i omega, normy i steny, eksperyment i raport APA – z danymi i kodem R.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikStatystyka opisowa – zadania z rozwiązaniami
Dziewięć zadań jak na kolokwium: szeregi rozdzielcze, średnia ważona, mediana i kwartyle ze wzoru interpolacyjnego, wariancja, CV, skośność i reguła 1.5 IQR.
Czytaj →PoradnikPrawdopodobieństwo i rozkłady – zadania
Dziesięć zadań jak na kolokwium: prawdopodobieństwo warunkowe, wartość oczekiwana, rozkład dwumianowy, Poissona i normalny, CTG – z rozwiązaniami krok po kroku.
Czytaj →PoradnikEstymacja i testowanie hipotez – zadania
Dziesięć zadań jak na kolokwium: przedziały ufności (z, t, Wilson), liczebność próby, testy dla średniej i proporcji, test jednostronny, błąd II rodzaju i moc.
Czytaj →PoradnikKorelacja i regresja – zadania z rozwiązaniami
Dziesięć zadań: kowariancja, Pearson i Spearman, metoda najmniejszych kwadratów, R², przedział predykcji, reszty, punkt wpływowy, regresja wieloraka i kwartet Anscombe’a.
Czytaj →PoradnikTesty nieparametryczne – zadania
Dziesięć zadań jak na kolokwium: Mann–Whitney, test znaków, Wilcoxon, Kruskal–Wallis z Dunnem, Friedman i Spearman – z rangami i rozwiązaniami krok po kroku.
Czytaj →PoradnikStatystyka medyczna – zadania z rozwiązaniami
Dziesięć zadań dla pielęgniarstwa i kierunków medycznych: RR, OR, NNT, czułość i PPV, Fisher, McNemar, zapadalność, Kaplan–Meier i Wilcoxon – krok po kroku.
Czytaj →PoradnikPytania na egzamin ze statystyki
66 krótkich pytań z odpowiedziami w 9 działach – od skal pomiarowych i SD po wartość p, moc, wybór testu, regresję i pytania „wyjaśnij różnicę”.
Czytaj →Masz własne dane do pracy i nie wiesz, który test wybrać?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- Fritz, C. O., Morris, P. E., & Richler, J. J. (2012). Effect size estimates: Current use, calculations, and interpretation. Journal of Experimental Psychology: General, 141(1), 2–18. https://doi.org/10.1037/a0024338
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@book{field2018discovering, author={Field, Andy}, title={{Discovering statistics using IBM SPSS Statistics}}, year={2018}, edition={5th}, publisher={SAGE}}@article{fritz2012effect, author={Fritz, Catherine O. and Morris, Peter E. and Richler, Jennifer J.}, title={{Effect size estimates: Current use, calculations, and interpretation}}, journal={Journal of Experimental Psychology: General}, year={2012}, volume={141}, number={1}, pages={2--18}, doi={10.1037/a0024338}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}