Prawdopodobieństwo i rozkłady: zadania z rozwiązaniami – jak z nich korzystać
Rachunek prawdopodobieństwa i rozkłady to pierwszy duży blok statystyki na ekonomii, zarządzaniu, pedagogice czy psychologii. Na kolokwium wracają te same typy pytań: reguły dodawania i mnożenia, prawdopodobieństwo warunkowe, rozkład dwumianowy, Poissona i normalny, wartość oczekiwana i rozkład średniej z próby. Poniżej znajdziesz 10 zadań z prawdopodobieństwa i rozkładów z rozwiązaniami krok po kroku.
Każde zadanie ma stały układ: treść z liczbami, rozwiązanie (wzór, podstawienie, wynik pośredni i końcowy), krótką interpretację i jeden typowy błąd. Prawdopodobieństwa podajemy do czterech miejsc po kropce, tak jak w tablicach rozkładu normalnego. Wszystkie liczby sprawdziliśmy w R: każde zadanie policzono raz wzorem, a raz gotową funkcją (dbinom, ppois, pnorm, qnorm). Gdy rachunek z tablic daje inną ostatnią cyfrę, piszemy o tym przy zadaniu. Wzory są standardowe – znajdziesz je w podręcznikach, np. Aczel i Sounderpandian (2018), King i Minium (2009) czy Field (2018).
Historyjki są „z życia uczelni i firmy”, a nie o monetach i kostkach – Gigerenzer i in. (2007) zalecają uczyć statystyki na realnych problemach zamiast zabawkowych zadań o monetach.
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | studenci pracujący i mieszkający w akademiku; trzy egzaminy w sesji | reguła dodawania i mnożenia, zdarzenie przeciwne |
| 2 | tryb studiów a zaliczenie statystyki | prawdopodobieństwo warunkowe z tabeli 2 × 2, niezależność |
| 3 | przesiew ryzyka dysleksji w szkole | prawdopodobieństwo całkowite, odwracanie warunku |
| 4 | reklamacje w sklepie internetowym | wartość oczekiwana, wariancja i SD zmiennej dyskretnej |
| 5 | zgadywanie w teście wyboru | rozkład dwumianowy |
| 6 | zgłoszenia do uczelnianego helpdesku | rozkład Poissona |
| 7 | test kompetencji 250 kandydatów | rozkład normalny: standaryzacja, „ilu ma wynik powyżej” |
| 8 | próg stypendium i zajęć wyrównawczych | kwantyle rozkładu normalnego |
| 9 | odpowiedzi na ankietę e-mailową | przybliżenie dwumianowego normalnym, poprawka na ciągłość |
| 10 | czas oczekiwania w kolejce do dziekanatu | rozkład średniej z próby, CTG, symulacja |
Do zadań 7–10 przydadzą się tablice rozkładów t, χ², F i z. Dane jednostkowe do zadań 1–3 (tabele rozpisane na osoby) i rozkład z zadania 4 możesz pobrać w pliku prawdopodobienstwo-rozklady-zadania-dane.csv (format długi: zadanie, osoba, grupa, zmienna, wartość) i odtworzyć tabele krzyżowe w SPSS, jamovi albo R.
Zadanie 1. Reguła dodawania i reguła mnożenia
Treść zadania
a) W ankiecie wśród 120 studentów zarządzania 45 osób pracuje zarobkowo, 30 mieszka w akademiku, a 12 jednocześnie pracuje i mieszka w akademiku. Losujesz jedną osobę. Jakie jest prawdopodobieństwo, że pracuje lub mieszka w akademiku? A że ani jedno, ani drugie?
b) Student ekonomii zdaje w pierwszym terminie mikroekonomię z prawdopodobieństwem 0.75, statystykę – 0.60, a rachunkowość – 0.80. Przyjmij, że wyniki egzaminów są niezależne. Oblicz prawdopodobieństwo, że zda wszystkie trzy, że nie zda żadnego, że będzie miał co najmniej jedną poprawkę i że zda dokładnie dwa.
Rozwiązanie krok po kroku
Krok 1. Prawdopodobieństwa z liczebności (a). A – pracuje, B – akademik: P(A) = 45/120 = 0.3750, P(B) = 30/120 = 0.2500, P(A ∩ B) = 12/120 = 0.1000.
Krok 2. Reguła dodawania. Zdarzenia nie są rozłączne (12 osób należy do obu grup), więc odejmujesz część wspólną:
To 63 osoby ze 120. Zdarzenie przeciwne – „ani praca, ani akademik” – ma prawdopodobieństwo 1 − 0.5250 = 0.4750 (57 osób).
Krok 3. Reguła mnożenia (b). Dla zdarzeń niezależnych P(A ∩ B ∩ C) = P(A) · P(B) · P(C):
Krok 4. „Co najmniej jeden” przez zdarzenie przeciwne. „Co najmniej jedna poprawka” to zaprzeczenie „zdaje wszystkie”: 1 − 0.3600 = 0.6400.
Krok 5. „Dokładnie dwa”. Są trzy rozłączne sposoby (nie zdaje jednego z trzech przedmiotów), więc mnożysz w każdym wariancie i dodajesz: 0.75 × 0.60 × 0.20 + 0.75 × 0.40 × 0.80 + 0.25 × 0.60 × 0.80 = 0.09 + 0.24 + 0.12 = 0.4500. Kontrola: rozkład liczby zdanych egzaminów (0, 1, 2, 3) to 0.0200, 0.1700, 0.4500, 0.3600 – suma wynosi 1.
Interpretacja
Ponad połowa studentów (52.50%) pracuje albo mieszka w akademiku. Student z części b) ma 64% szans na co najmniej jedną poprawkę, choć każdy egzamin osobno zdaje raczej pewnie.
Typowy błąd
Dodanie P(A) + P(B) = 0.6250 bez odjęcia części wspólnej – osoby z obu grup liczysz wtedy dwa razy. W części b) pułapką jest samo założenie niezależności – wyniki egzaminów tej samej osoby zwykle są powiązane.
Zadanie 2. Prawdopodobieństwo warunkowe z tabeli 2 × 2
Treść zadania
Na roku jest 200 studentów: 120 na studiach stacjonarnych (90 zaliczyło statystykę w pierwszym terminie) i 80 na niestacjonarnych (48 zaliczyło). Oblicz P(zaliczenie), P(zaliczenie | stacjonarne), P(zaliczenie | niestacjonarne) i P(stacjonarne | zaliczenie). Czy zaliczenie jest niezależne od trybu studiów?
Rozwiązanie krok po kroku
Krok 1. Tabela z sumami brzegowymi.
| Tryb | Zaliczył | Nie zaliczył | Razem |
|---|---|---|---|
| Stacjonarne | 90 | 30 | 120 |
| Niestacjonarne | 48 | 32 | 80 |
| Razem | 138 | 62 | 200 |
Krok 2. Prawdopodobieństwo bezwarunkowe. P(Z) = 138/200 = 0.6900.
Krok 3. Prawdopodobieństwa warunkowe. Warunek zawęża „całość” do jednego wiersza albo jednej kolumny:
Krok 4. Sprawdzenie niezależności. Zdarzenia są niezależne, gdy P(S ∩ Z) = P(S) · P(Z). Tu P(S ∩ Z) = 90/200 = 0.4500, a P(S) · P(Z) = 0.60 × 0.69 = 0.4140. Wartości się różnią (to samo widać z P(Z | S) = 0.75 ≠ P(Z) = 0.69), więc zdarzenia są zależne.
Interpretacja
W tej grupie zaliczyło 75% studentów stacjonarnych i 60% niestacjonarnych. Wśród osób, które zaliczyły, 65.22% to studenci stacjonarni. Czy różnica 15 punktów procentowych jest istotna statystycznie, rozstrzyga test dla dwóch proporcji (zob. zadania z estymacji i testowania hipotez).
Typowy błąd
Pomylenie P(Z | S) = 0.7500 z P(S | Z) = 0.6522. „Ilu stacjonarnych zalicza” i „ilu zaliczających jest stacjonarnych” to dwa różne pytania – liczysz je w innym wierszu albo kolumnie tabeli.
Zadanie 3. Twierdzenie o prawdopodobieństwie warunkowym: test przesiewowy
Treść zadania
W szkole podstawowej 1000 uczniów wypełnia krótki test przesiewowy ryzyka dysleksji. Dysleksję ma 6% uczniów. Test daje wynik dodatni u 90% uczniów z dysleksją (czułość) i wynik ujemny u 85% uczniów bez niej (swoistość). Jakie jest prawdopodobieństwo, że uczeń z wynikiem dodatnim naprawdę ma dysleksję? A że uczeń z wynikiem ujemnym jej nie ma?
Rozwiązanie krok po kroku
Krok 1. Rozpisz 1000 uczniów na liczebności („drzewo”). Z dysleksją: 1000 × 0.06 = 60; bez dysleksji: 940. Wśród 60 z dysleksją wynik dodatni ma 60 × 0.90 = 54, ujemny – 6. Wśród 940 bez dysleksji wynik ujemny ma 940 × 0.85 = 799, a dodatni (fałszywie) – 141.
| Wynik testu | Dysleksja | Brak dysleksji | Razem |
|---|---|---|---|
| Dodatni | 54 | 141 | 195 |
| Ujemny | 6 | 799 | 805 |
| Razem | 60 | 940 | 1000 |
Krok 2. Prawdopodobieństwo całkowite wyniku dodatniego.
Krok 3. Odwrócenie warunku. Z definicji prawdopodobieństwa warunkowego P(D | +) = P(D ∩ +) / P(+):
Krok 4. Wynik ujemny. P(brak D | −) = 799 / 805 = 0.9925.
Interpretacja
Tylko ok. 28% uczniów z wynikiem dodatnim ma dysleksję – reszta to wyniki fałszywie dodatnie, bo uczniów bez dysleksji jest dużo więcej. Wynik ujemny prawie na pewno wyklucza dysleksję (99.25%). W języku diagnostyki to wartość predykcyjna dodatnia i ujemna, liczona z czułości i swoistości; więcej o samym przesiewie w haśle badanie przesiewowe. Gigerenzer i in. (2007) zalecają takie właśnie przedstawianie wyników w liczebnościach („54 ze 195”) zamiast prawdopodobieństw warunkowych, bo jest przejrzystsze.
Typowy błąd
Utożsamienie P(D | +) z czułością: „test wykrywa 90% przypadków, więc uczeń z wynikiem dodatnim ma dysleksję z prawdopodobieństwem 0.90”. W rzeczywistości 0.2769 – czułość to P(+ | D), a nie P(D | +).
Zadanie 4. Wartość oczekiwana i wariancja zmiennej dyskretnej
Treść zadania
Mały sklep internetowy dostaje dziennie od 0 do 4 reklamacji z prawdopodobieństwami: 0 – 0.35, 1 – 0.30, 2 – 0.20, 3 – 0.10, 4 – 0.05. Oblicz wartość oczekiwaną, wariancję i odchylenie standardowe liczby reklamacji. Obsługa reklamacji kosztuje 20 zł dziennie (stała opłata za system) plus 50 zł za każdą reklamację – podaj oczekiwany dzienny koszt i jego SD.
Rozwiązanie krok po kroku
Krok 1. Kontrola rozkładu. 0.35 + 0.30 + 0.20 + 0.10 + 0.05 = 1.00 – to poprawny rozkład prawdopodobieństwa.
Krok 2. Wartość oczekiwana. Iloczyny x · P(x): 0, 0.30, 0.40, 0.30, 0.20.
Krok 3. Wariancja wzorem skróconym. Iloczyny x² · P(x): 0, 0.30, 0.80, 0.90, 0.80, więc E(X²) = 2.80.
Krok 4. Przekształcenie liniowe. Koszt K = 20 + 50X. Stała przesuwa średnią, ale nie zmienia rozrzutu, a mnożnik zmienia jedno i drugie: E(K) = 20 + 50 × 1.20 = 80.00 zł; SD(K) = 50 × 1.1662 = 58.31 zł.
Interpretacja
Sklep dostaje średnio 1.2 reklamacji i wydaje na nie średnio 80 zł dziennie, z dużą zmiennością między dniami (SD = 58.31 zł). Dwie i więcej reklamacji zdarza się w 35% dni. Wartość oczekiwana to średnia „na dłuższą metę”, a nie wynik typowego dnia – 1.2 reklamacji w ogóle nie może się zdarzyć. Więcej o mierze rozrzutu w haśle wariancja.
Typowy błąd
Liczenie SD(K) jako 20 + 50 × 1.17 albo dodawanie stałej do wariancji. Stała 20 zł nie zmienia rozrzutu: Var(a + bX) = b² · Var(X).
Zadanie 5. Rozkład dwumianowy: zgadywanie w teście
Treść zadania
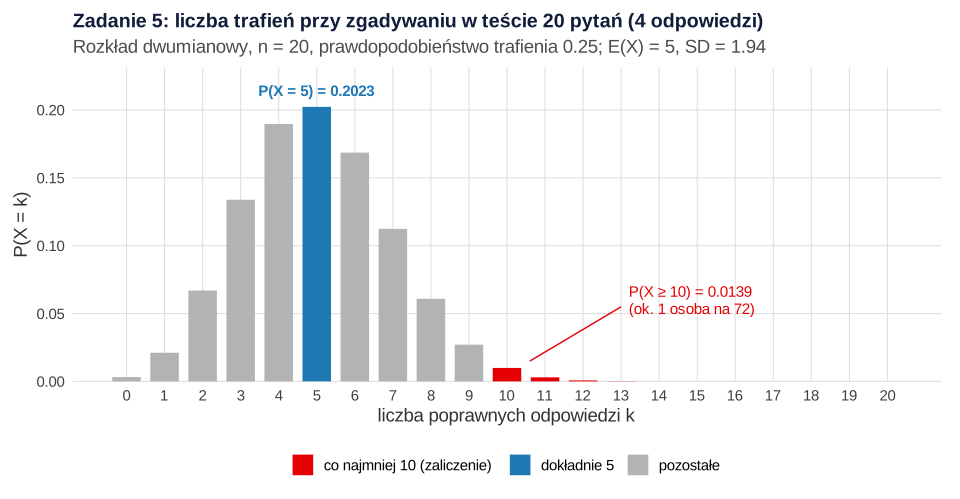
Test zaliczeniowy z pedagogiki ma 20 pytań jednokrotnego wyboru, każde z 4 odpowiedziami. Student nic nie umie i zgaduje losowo. Jakie jest prawdopodobieństwo, że odpowie dobrze na dokładnie 5 pytań? Że zaliczy, czyli odpowie dobrze na co najmniej 10? Że uzyska najwyżej 3 punkty? Podaj wartość oczekiwaną i SD liczby trafień.
Rozwiązanie krok po kroku
Krok 1. Sprawdź warunki. Stała liczba prób (n = 20), dwa wyniki (trafienie lub nie), stałe prawdopodobieństwo trafienia 1/4 = 0.25, niezależne pytania – X ma rozkład dwumianowy Bin(20; 0.25).
Krok 2. Dokładnie 5 trafień. Wzór P(X = k) = C(n, k) · pk · (1 − p)n − k, gdzie C(20, 5) = 15504:
Krok 3. Co najmniej 10. Sumowanie 11 składników ręcznie jest żmudne, więc użyj zdarzenia przeciwnego i dystrybuanty: P(X ≥ 10) = 1 − P(X ≤ 9) = 0.0139 (w R: 1 - pbinom(9, 20, 0.25)).
Krok 4. Najwyżej 3. P(X ≤ 3) = P(0) + P(1) + P(2) + P(3) = 0.0032 + 0.0211 + 0.0669 + 0.1339 = 0.2252.
Krok 5. Parametry. E(X) = np = 20 × 0.25 = 5; Var(X) = np(1 − p) = 3.75; SD = √3.75 = 1.94.
Interpretacja
Zgadując, student uzyskuje średnio 5 punktów (SD = 1.94), a najczęstszy wynik to właśnie 5 trafień (P(X = 5) = 0.2023). Zaliczenie przez czyste zgadywanie zdarza się z prawdopodobieństwem 0.0139, czyli mniej więcej u 1 osoby na 72.
Typowy błąd
Policzenie 1 − P(X ≤ 10) zamiast 1 − P(X ≤ 9). Daje to P(X > 10) = 0.0039, czyli gubi wynik równy 10. W rozkładach dyskretnych „co najmniej 10” i „więcej niż 10” to dwa różne zdarzenia.
Zadanie 6. Rozkład Poissona: zgłoszenia do helpdesku
Treść zadania
Do uczelnianego helpdesku IT wpływa średnio 4 zgłoszenia na godzinę; zgłoszenia przychodzą niezależnie od siebie. Jakie jest prawdopodobieństwo, że w ciągu godziny nie będzie żadnego zgłoszenia? Że będą najwyżej 2? Że będzie ich co najmniej 8 (wtedy trzeba wezwać drugą osobę)? Jakie jest prawdopodobieństwo, że przez pół godziny nikt się nie zgłosi?
Rozwiązanie krok po kroku
Krok 1. Model. Liczba zdarzeń w ustalonym czasie przy stałej średniej intensywności – rozkład Poissona z λ = 4: P(X = k) = λk e−λ / k!
Krok 2. Brak zgłoszeń. P(X = 0) = e−4 = 0.0183.
Krok 3. Najwyżej 2. P(1) = 4 × e−4 = 0.0733; P(2) = 4² × e−4 / 2 = 0.1465.
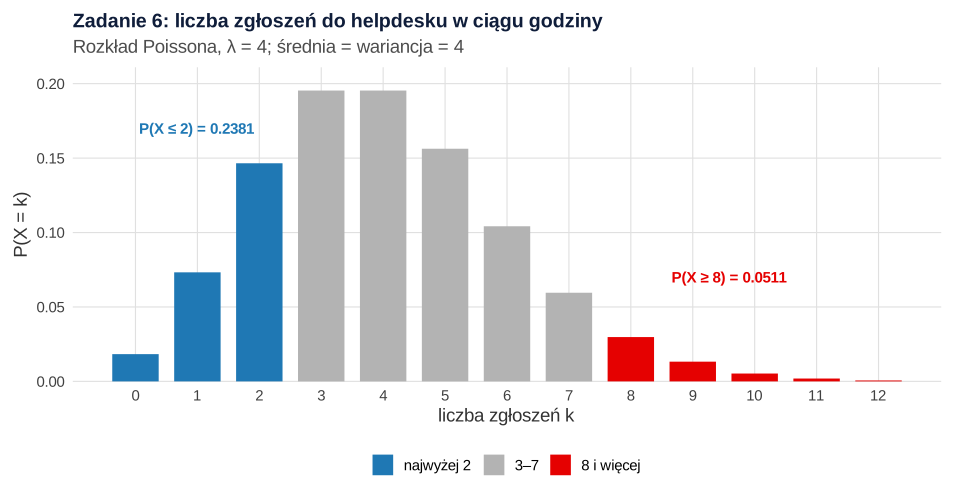
Krok 4. Co najmniej 8. P(X ≥ 8) = 1 − P(X ≤ 7) = 0.0511 (w R: 1 - ppois(7, 4)).
Krok 5. Zmiana okresu. Na pół godziny przypada średnio λ = 4 / 2 = 2 zgłoszenia, więc P(X = 0) = e−2 = 0.1353, a P(co najmniej jedno) = 0.8647.
Interpretacja
Godzina bez żadnego zgłoszenia zdarza się rzadko (1.83% godzin), a godzina z 8 i więcej zgłoszeniami – w ok. 5% godzin (5.11%). Dla wprawy: rozkład Poissona przybliża też dwumianowy przy dużym n i małym prawdopodobieństwie. Jeśli błąd zdarza się w 0.6% z 500 formularzy, P(brak błędów) = 0.0493 z rozkładu dwumianowego i 0.0498 z rozkładu Poissona z λ = 500 × 0.006 = 3.
Typowy błąd
Policzenie 1 − P(X ≤ 8) = 0.0214 zamiast 1 − P(X ≤ 7) oraz pozostawienie λ = 4 przy pytaniu o pół godziny. Parametr λ zawsze dopasuj do długości okresu z pytania.
Zadanie 7. Rozkład normalny: ilu kandydatów ma wynik powyżej
Treść zadania
Wyniki testu kompetencji w rekrutacji na studia podyplomowe mają rozkład normalny ze średnią 62 punkty i odchyleniem standardowym 10 punktów. Test napisało 250 kandydatów. Jaki odsetek ma wynik powyżej 80 punktów, między 50 a 70 i poniżej 45? Ilu to kandydatów?
Rozwiązanie krok po kroku
Krok 1. Standaryzacja. z = (x − μ) / σ: 80 → 1.80; 50 → −1.20; 70 → 0.80; 45 → −1.70.
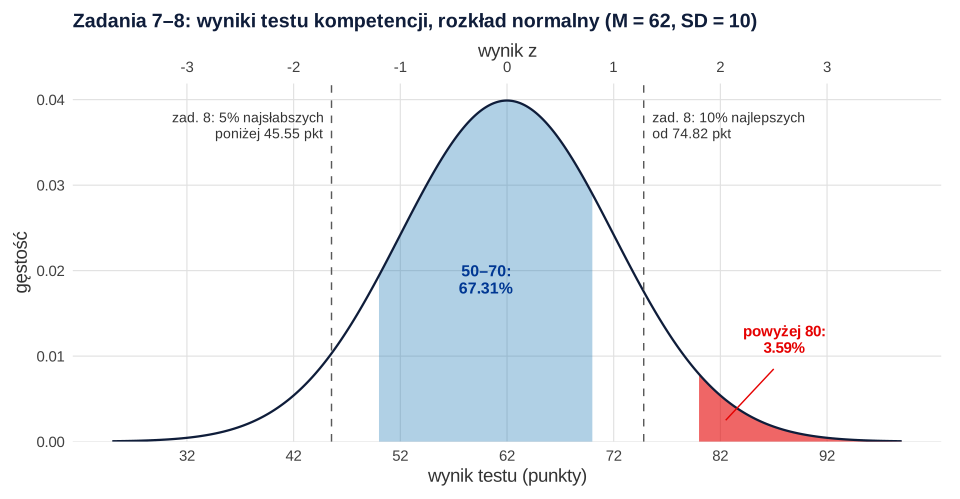
Krok 2. Powyżej 80. Tablica podaje pole na lewo: Φ(1.80) = 0.9641. Pole na prawo: 1 − 0.9641 = 0.0359. Na 250 osób: 250 × 0.0359 = 8.98, czyli ok. 9 kandydatów.
Krok 3. Między 50 a 70.
Z tablic wychodzi 0.6730; R podaje 0.6731 (różnica z zaokrąglenia wartości tablicowych). Na 250 osób: 168.27, czyli ok. 168 kandydatów.
Krok 4. Poniżej 45. Φ(−1.70) = 0.0446; na 250 osób: 11.14, czyli ok. 11 kandydatów.
Interpretacja
Powyżej 80 punktów spodziewasz się ok. 9 z 250 kandydatów (3.59%), w przedziale 50–70 – ok. 168 (67.31%), a poniżej 45 – ok. 11 (4.46%). To wyliczenia z modelu, a prawdziwe wyniki rzadko są dokładnie normalne: Micceri (1989) przeanalizował 440 dużych rozkładów wyników testów i miar psychometrycznych i wszystkie istotnie odbiegały od normalności. Jak to sprawdzić na własnych danych, opisujemy we wpisie jak sprawdzić normalność rozkładu.
Typowy błąd
Podanie Φ(1.80) = 0.9641 jako odsetka osób powyżej 80. Tablica daje pole na lewo od z – naszkicuj krzywą i zaznacz, którą część liczysz (pomaga hasło funkcja gęstości i dystrybuanta).
Zadanie 8. Kwantyle rozkładu normalnego: jaki próg?
Treść zadania
Ten sam test (średnia 62, SD = 10). Organizator chce przyznać stypendium 10% najlepszych kandydatów i skierować na zajęcia wyrównawcze 5% najsłabszych. Od ilu punktów zaczyna się stypendium, a poniżej ilu – zajęcia wyrównawcze? Podaj też kwartyle i rozstęp międzykwartylowy wyników.
Rozwiązanie krok po kroku
Krok 1. Zadanie odwrotne. Znasz pole, szukasz wyniku. 10% najlepszych to 90% osób poniżej progu, więc szukasz kwantyla rzędu 0.90: z0.90 = 1.2816.
Krok 2. Powrót do punktów. x = μ + z · σ:
Krok 3. Kwartyle. z0.25 = −0.6745, z0.75 = 0.6745, więc Q1 = 55.26, Q3 = 68.74, a IQR = 13.49 punktu. Środkowe 95% wyników mieści się między 42.40 a 81.60 punktu (62 ± 1.96 × 10).
Interpretacja
Stypendium otrzymują kandydaci z wynikiem co najmniej ok. 74.82 punktu (w praktyce 75), a zajęcia wyrównawcze – osoby poniżej 45.55 punktu. Próg stypendium to 90. percentyl rozkładu wyników.
Typowy błąd
Użycie z = 1.645 („bo to znana liczba”) dla 10% najlepszych. Daje to próg 78.45 punktu, czyli 5% najlepszych. Wartość 1.645 odcina 5% w jednym ogonie, a 1.2816 – 10%.
Zadanie 9. Przybliżenie rozkładu dwumianowego normalnym z poprawką na ciągłość
Treść zadania
Firma badawcza wysyła 400 zaproszeń do ankiety e-mailowej. Z doświadczenia wie, że odpowiada 30% adresatów, i przyjmuje, że adresaci odpowiadają niezależnie. Jakie jest prawdopodobieństwo, że odpowie co najmniej 135 osób? A że mniej niż 105 (wtedy trzeba wysłać dodatkowe zaproszenia)? Policz przybliżeniem normalnym z poprawką na ciągłość i porównaj z wynikiem dokładnym.
Rozwiązanie krok po kroku
Krok 1. Warunki przybliżenia. X ~ Bin(400; 0.30). np = 120 i n(1 − p) = 280 – obie liczby są dużo większe niż 5 (część podręczników wymaga 10), więc przybliżenie normalne jest uzasadnione. Średnia 120, SD = √(400 × 0.30 × 0.70) = 9.17.
Krok 2. Poprawka na ciągłość. Rozkład dwumianowy przyjmuje tylko liczby całkowite, a wynik 135 odpowiada przedziałowi 134.5–135.5, więc „co najmniej 135” zamieniasz na „powyżej 134.5”:
Z tablicy dla z = 1.58 wyjdzie 0.0571 – to skutek zaokrąglenia z; R liczy z niezaokrąglonym z.
Krok 3. Mniej niż 105. „Mniej niż 105” to „najwyżej 104”, czyli w przybliżeniu „poniżej 104.5”: z = (104.5 − 120) / 9.1652 = −1.69, P ≈ 0.0454.
Krok 4. Porównanie z wynikiem dokładnym.
| Zdarzenie | Dokładnie (pbinom) | Normalne z poprawką | Normalne bez poprawki |
|---|---|---|---|
| X ≥ 135 (n = 400) | 0.0580 | 0.0568 | 0.0509 |
| X < 105 (n = 400) | 0.0440 | 0.0454 | 0.0509 |
| X ≥ 9 (n = 20) | 0.1133 | 0.1113 | 0.0716 |
Interpretacja
Szansa na co najmniej 135 odpowiedzi wynosi ok. 6%, a ryzyko, że odpowie mniej niż 105 osób – ok. 4.5%. Poprawka na ciągłość zbliża przybliżenie do wyniku dokładnego. Przy małej próbie (ostatni wiersz: 20 zaproszeń, co najmniej 9 odpowiedzi) bez poprawki pomyłka jest już duża: 0.0716 zamiast 0.1133. Odsetek z próby opisuje przedział ufności dla proporcji.
Typowy błąd
Poprawka w złą stronę: dla „mniej niż 105” podstawienie 105.5 albo 105 zamiast 104.5. Zawsze zapisz najpierw zdarzenie na liczbach całkowitych („najwyżej 104”), a dopiero potem dodaj lub odejmij 0.5.
Zadanie 10. Rozkład średniej z próby i centralne twierdzenie graniczne
Treść zadania
Czas oczekiwania w kolejce do dziekanatu ma rozkład wykładniczy ze średnią 8 minut (w tym rozkładzie także SD = 8 minut). Jakie jest prawdopodobieństwo, że jedna osoba będzie czekać dłużej niż 10 minut? Dziekanat losuje 40 wizyt i liczy średni czas oczekiwania. Jakie jest prawdopodobieństwo, że średnia przekroczy 10 minut? Że wyniesie od 7 do 9 minut? Sprawdź odpowiedź symulacją.
Rozwiązanie krok po kroku
Krok 1. Jedna osoba. W rozkładzie wykładniczym P(X > x) = e−x/μ, więc P(X > 10) = e−10/8 = 0.2865. Rozkład jest silnie prawostronnie skośny: w symulacji 10 000 osób średni czas wyniósł 8.11 minuty, a mediana tylko 5.63 minuty.
Krok 2. Błąd standardowy średniej. Średnia z n = 40 niezależnych obserwacji ma średnią μ = 8 i błąd standardowy SE = σ / √n = 8 / √40 = 1.2649.
Krok 3. Przybliżenie z CTG. Według centralnego twierdzenia granicznego średnie z prób losowych o liczebności n mają w przybliżeniu rozkład normalny ze średnią μ i wariancją σ²/n (Kwak i Kim, 2017):
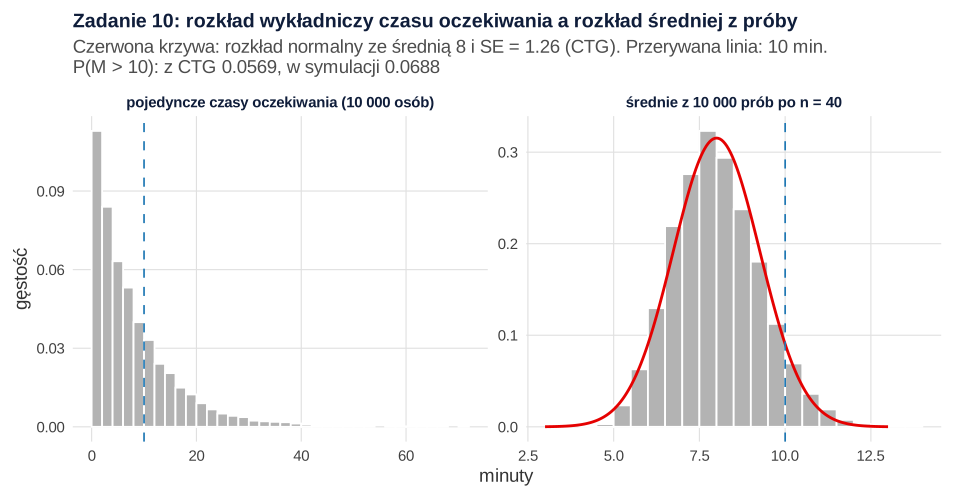
Krok 4. Symulacja. W 10 000 wylosowanych próbach po 40 czasów średnia średnich wyniosła 8.0184, a ich SD – 1.2728 (teoretyczne SE to 1.2649). Odsetek średnich powyżej 10 minut: 0.0688 (błąd Monte Carlo ok. 0.0025), od 7 do 9 minut: 0.5653. Dokładny wynik, policzony z rozkładu gamma, który ma średnia z wykładniczych, to 0.0646.
set.seed(379)).Interpretacja
Pojedyncza osoba czeka dłużej niż 10 minut dość często (28.65%), ale średnia z 40 wizyt przekracza 10 minut rzadko – ok. 6–7% prób. Przybliżenie z CTG (0.0569) lekko zaniża ten odsetek, bo przy tak skośnym rozkładzie 40 obserwacji nie usuwa skośności średnich całkowicie; symulacja i rachunek dokładny dają ok. 0.065–0.069. CTG mówi o rozkładzie średniej, a nie o rozkładzie samych czasów – więcej przykładów we wpisie centralne twierdzenie graniczne.
Typowy błąd
Użycie SD pojedynczej obserwacji zamiast SE: P(M > 10) wychodzi wtedy 0.4013, czyli tak, jakby średnia z 40 osób była tak samo zmienna jak czas jednej osoby.
Ściąga: który rozkład pasuje do zadania
Najpierw nazwij zmienną losową: dyskretna (liczba sukcesów, zdarzeń) czy ciągła (wynik, czas)? Potem dobierz rozkład.
| Sytuacja w treści zadania | Rozkład / reguła | Średnia i wariancja | Funkcja R |
|---|---|---|---|
| „lub”, „i”, „co najmniej jeden” | reguła dodawania, mnożenia, zdarzenie przeciwne | – | arytmetyka |
| „wśród osób, które…”, wynik testu a stan | prawdopodobieństwo warunkowe, prawdopodobieństwo całkowite | – | prop.table |
| Liczba sukcesów w n niezależnych próbach | dwumianowy | np; np(1 − p) | dbinom, pbinom |
| Liczba zdarzeń w okresie przy stałej średniej | Poissona | λ; λ | dpois, ppois |
| Wynik ciągły o kształcie dzwonu: pole | normalny | μ; σ² | pnorm |
| Wynik ciągły: próg dla zadanego odsetka | normalny – kwantyl | μ; σ² | qnorm |
| Średnia z próby n osób | normalny z CTG | μ; σ²/n | pnorm z SE |
Definicję i własności rozkładu, którego dotyczy zadanie, znajdziesz w haśle rozkład normalny i hasłach linkowanych przy zadaniach. Przy własnym badaniu do pracy dyplomowej pomożemy w ramach analiz statystycznych dla studentów.
Inne zbiory zadań
- Statystyka opisowa – zadania z rozwiązaniami.
- Estymacja i testowanie hipotez – zadania.
- Korelacja i regresja – zadania z rozwiązaniami.
- Testy nieparametryczne – zadania z rozwiązaniami.
- Statystyka medyczna – zadania dla pielęgniarstwa.
- Zadania ze statystyki na psychologii.
- Pytania na egzamin ze statystyki – z odpowiedziami.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na parametrach wpisanych w kod. Każde zadanie jest policzone wzorem, tak jak na kartce, i gotową funkcją R jako kontrola. Jedyne losowanie to symulacja w zadaniu 10 (ziarno set.seed(379)). Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje parametry z tych przepisów.
Zadania 1–5: reguły prawdopodobieństwa, tabela 2 × 2, wartość oczekiwana i rozkład dwumianowy
R
# B379 – zadania 1–5: reguła dodawania i mnożenia, prawdopodobieństwo warunkowe,
# twierdzenie o prawdopodobieństwie warunkowym (test przesiewowy), wartość oczekiwana, rozkład dwumianowy
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z4 <- function(x) formatC(x, format = "f", digits = 4)

# Zadanie 1a. Ankieta wśród 120 studentów: 45 pracuje, 30 mieszka w akademiku, 12 – jedno i drugie
N <- 120; pracuje <- 45; akademik <- 30; oba <- 12
pA <- pracuje / N; pB <- akademik / N; pAB <- oba / N
cat("Zadanie 1a\n")
cat("P(A) =", z4(pA), "; P(B) =", z4(pB), "; P(A i B) =", z4(pAB), "\n")
cat("P(A lub B) = P(A) + P(B) - P(A i B) =", z4(pA + pB - pAB), "; liczba osób =", pracuje + akademik - oba, "\n")
cat("P(ani A, ani B) =", z4(1 - (pA + pB - pAB)), "\n")
cat("Błąd: P(A) + P(B) bez odjęcia części wspólnej =", z4(pA + pB), "\n\n")

# Zadanie 1b. Trzy egzaminy w pierwszym terminie, zdarzenia założone jako niezależne
p <- c(mikroekonomia = 0.75, statystyka = 0.60, rachunkowosc = 0.80)
q <- 1 - p
dokl2 <- p[1] * p[2] * q[3] + p[1] * q[2] * p[3] + q[1] * p[2] * p[3]
cat("Zadanie 1b\n")
cat("P(zdaje wszystkie trzy) =", z4(prod(p)), "\n")
cat("P(nie zdaje żadnego) =", z4(prod(q)), "\n")
cat("P(co najmniej jedna poprawka) = 1 - P(wszystkie) =", z4(1 - prod(p)), "\n")
cat("Warianty dokładnie dwóch (bez R, bez S, bez M):", z2(c(p[1] * p[2] * q[3], p[1] * q[2] * p[3], q[1] * p[2] * p[3])), "\n")
cat("P(dokładnie dwa zdane) =", z4(dokl2), "\n")
# kontrola: wszystkie 8 kombinacji wyników
k <- expand.grid(m = 0:1, s = 0:1, r = 0:1)
pk <- apply(k, 1, function(w) prod(ifelse(w == 1, p, q)))
cat("Kontrola: suma 8 kombinacji =", z4(sum(pk)), "; rozkład liczby zdanych (0-3):",
    z4(tapply(pk, rowSums(k), sum)), "\n\n")

# Zadanie 2. 200 studentów: tryb studiów a zaliczenie statystyki w pierwszym terminie
tab <- matrix(c(90, 30, 48, 32), nrow = 2, byrow = TRUE,
              dimnames = list(tryb = c("stacjonarne", "niestacjonarne"), wynik = c("zaliczyl", "nie_zaliczyl")))
cat("Zadanie 2\n")
print(addmargins(tab))
n2 <- sum(tab)
cat("P(zaliczył) =", z4(sum(tab[, "zaliczyl"]) / n2), "\n")
cat("P(zaliczył | stacjonarne) =", z4(tab["stacjonarne", "zaliczyl"] / sum(tab["stacjonarne", ])), "\n")
cat("P(zaliczył | niestacjonarne) =", z4(tab["niestacjonarne", "zaliczyl"] / sum(tab["niestacjonarne", ])), "\n")
cat("P(stacjonarne | zaliczył) =", z4(tab["stacjonarne", "zaliczyl"] / sum(tab[, "zaliczyl"])), "\n")
cat("P(stacjonarne i zaliczył) =", z4(tab["stacjonarne", "zaliczyl"] / n2),
    "; P(stacjonarne) * P(zaliczył) =", z4(sum(tab["stacjonarne", ]) / n2 * sum(tab[, "zaliczyl"]) / n2), "\n")
cat("Kontrola prop.table (wiersze):\n"); print(round(prop.table(tab, 1), 4))
cat("\n")

# Zadanie 3. Przesiew ryzyka dysleksji: 1000 uczniów, częstość 6%, czułość 90%, swoistość 85%
Nu <- 1000; czestosc <- 0.06; czul <- 0.90; swoi <- 0.85
dys <- Nu * czestosc; bez <- Nu - dys
TP <- dys * czul; FN <- dys - TP; TN <- bez * swoi; FP <- bez - TN
cat("Zadanie 3\n")
cat("Uczniowie z dysleksją =", dys, "; bez dysleksji =", bez, "\n")
cat("Wynik dodatni: z dysleksją (TP) =", TP, "; bez dysleksji (FP) =", FP, "; razem =", TP + FP, "\n")
cat("Wynik ujemny: bez dysleksji (TN) =", TN, "; z dysleksją (FN) =", FN, "; razem =", TN + FN, "\n")
pPlus <- czul * czestosc + (1 - swoi) * (1 - czestosc)
cat("P(wynik dodatni) – prawdopodobieństwo całkowite =", z4(pPlus), "\n")
cat("P(dysleksja | wynik dodatni) = czułość * częstość / P(+) =", z4(czul * czestosc / pPlus),
    "; z liczebności =", z4(TP / (TP + FP)), "\n")
cat("P(brak dysleksji | wynik ujemny) =", z4(TN / (TN + FN)), "\n")
cat("Błąd: utożsamienie P(dysleksja | +) z czułością =", z4(czul), "\n\n")

# Zadanie 4. Liczba reklamacji dziennie w sklepie internetowym
x <- 0:4
px <- c(0.35, 0.30, 0.20, 0.10, 0.05)
EX <- sum(x * px); EX2 <- sum(x^2 * px); VX <- EX2 - EX^2
cat("Zadanie 4\n")
cat("Suma prawdopodobieństw =", z2(sum(px)), "\n")
cat("Iloczyny x * P(x):", z2(x * px), "; E(X) =", z2(EX), "\n")
cat("Iloczyny x^2 * P(x):", z2(x^2 * px), "; E(X^2) =", z2(EX2), "\n")
cat("Var(X) = E(X^2) - E(X)^2 =", z4(VX), "; SD =", z4(sqrt(VX)), "\n")
cat("Kontrola wzorem definicyjnym: sum((x - E)^2 * P) =", z4(sum((x - EX)^2 * px)), "\n")
cat("Koszt K = 20 + 50X: E(K) =", z2(20 + 50 * EX), "zł ; SD(K) =", z2(50 * sqrt(VX)), "zł\n")
cat("P(X >= 2) =", z2(sum(px[x >= 2])), "\n\n")

# Zadanie 5. Test 20 pytań, 4 odpowiedzi, zgadywanie: X ~ Bin(20; 0.25)
n5 <- 20; p5 <- 0.25
cat("Zadanie 5\n")
cat("Liczba kombinacji C(20, 5) =", choose(20, 5), "\n")
cat("P(X = 5) wzorem =", z4(choose(20, 5) * p5^5 * (1 - p5)^15), "; dbinom =", z4(dbinom(5, n5, p5)), "\n")
cat("P(X >= 10) = 1 - pbinom(9) =", z4(1 - pbinom(9, n5, p5)), "\n")
cat("P(X <= 3) = pbinom(3) =", z4(pbinom(3, n5, p5)), "\n")
cat("P(X = 0) =", z4(dbinom(0, n5, p5)), "\n")
cat("E(X) = np =", n5 * p5, "; Var(X) = np(1 - p) =", n5 * p5 * (1 - p5), "; SD =", z4(sqrt(n5 * p5 * (1 - p5))), "\n")
cat("Najbardziej prawdopodobna liczba poprawnych =", which.max(dbinom(0:n5, n5, p5)) - 1, "\n")
cat("Rozkład P(X = k), k = 0-10:\n"); print(round(setNames(dbinom(0:10, n5, p5), 0:10), 4))
cat("Błąd: P(X > 10) zamiast P(X >= 10) =", z4(1 - pbinom(10, n5, p5)), "\n")
Wynik w R
Zadanie 1a
P(A) = 0.3750 ; P(B) = 0.2500 ; P(A i B) = 0.1000
P(A lub B) = P(A) + P(B) - P(A i B) = 0.5250 ; liczba osób = 63
P(ani A, ani B) = 0.4750
Błąd: P(A) + P(B) bez odjęcia części wspólnej = 0.6250

Zadanie 1b
P(zdaje wszystkie trzy) = 0.3600
P(nie zdaje żadnego) = 0.0200
P(co najmniej jedna poprawka) = 1 - P(wszystkie) = 0.6400
Warianty dokładnie dwóch (bez R, bez S, bez M): 0.09 0.24 0.12
P(dokładnie dwa zdane) = 0.4500
Kontrola: suma 8 kombinacji = 1.0000 ; rozkład liczby zdanych (0-3): 0.0200 0.1700 0.4500 0.3600

Zadanie 2
                wynik
tryb             zaliczyl nie_zaliczyl Sum
  stacjonarne          90           30 120
  niestacjonarne       48           32  80
  Sum                 138           62 200
P(zaliczył) = 0.6900
P(zaliczył | stacjonarne) = 0.7500
P(zaliczył | niestacjonarne) = 0.6000
P(stacjonarne | zaliczył) = 0.6522
P(stacjonarne i zaliczył) = 0.4500 ; P(stacjonarne) * P(zaliczył) = 0.4140
Kontrola prop.table (wiersze):
                wynik
tryb             zaliczyl nie_zaliczyl
  stacjonarne        0.75         0.25
  niestacjonarne     0.60         0.40

Zadanie 3
Uczniowie z dysleksją = 60 ; bez dysleksji = 940
Wynik dodatni: z dysleksją (TP) = 54 ; bez dysleksji (FP) = 141 ; razem = 195
Wynik ujemny: bez dysleksji (TN) = 799 ; z dysleksją (FN) = 6 ; razem = 805
P(wynik dodatni) – prawdopodobieństwo całkowite = 0.1950
P(dysleksja | wynik dodatni) = czułość * częstość / P(+) = 0.2769 ; z liczebności = 0.2769
P(brak dysleksji | wynik ujemny) = 0.9925
Błąd: utożsamienie P(dysleksja | +) z czułością = 0.9000

Zadanie 4
Suma prawdopodobieństw = 1.00
Iloczyny x * P(x): 0.00 0.30 0.40 0.30 0.20 ; E(X) = 1.20
Iloczyny x^2 * P(x): 0.00 0.30 0.80 0.90 0.80 ; E(X^2) = 2.80
Var(X) = E(X^2) - E(X)^2 = 1.3600 ; SD = 1.1662
Kontrola wzorem definicyjnym: sum((x - E)^2 * P) = 1.3600
Koszt K = 20 + 50X: E(K) = 80.00 zł ; SD(K) = 58.31 zł
P(X >= 2) = 0.35

Zadanie 5
Liczba kombinacji C(20, 5) = 15504
P(X = 5) wzorem = 0.2023 ; dbinom = 0.2023
P(X >= 10) = 1 - pbinom(9) = 0.0139
P(X <= 3) = pbinom(3) = 0.2252
P(X = 0) = 0.0032
E(X) = np = 5 ; Var(X) = np(1 - p) = 3.75 ; SD = 1.9365
Najbardziej prawdopodobna liczba poprawnych = 5
Rozkład P(X = k), k = 0-10:
     0      1      2      3      4      5      6      7      8      9     10
0.0032 0.0211 0.0669 0.1339 0.1897 0.2023 0.1686 0.1124 0.0609 0.0271 0.0099
Błąd: P(X > 10) zamiast P(X >= 10) = 0.0039
Zadania 6–10: rozkład Poissona, rozkład normalny, przybliżenie normalne i symulacja CTG
R
# B379 – zadania 6–10: rozkład Poissona, rozkład normalny (pola i kwantyle),
# przybliżenie rozkładu dwumianowego normalnym, rozkład średniej z próby (CTG – symulacja)
# Parametry wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z4 <- function(x) formatC(x, format = "f", digits = 4)

# Zadanie 6. Zgłoszenia do uczelnianego helpdesku: średnio 4 na godzinę, X ~ Poisson(4)
lam <- 4
cat("Zadanie 6\n")
cat("P(X = 0) = e^-4 =", z4(exp(-lam)), "; dpois =", z4(dpois(0, lam)), "\n")
cat("P(X = k), k = 0-3 wzorem:", z4(lam^(0:3) * exp(-lam) / factorial(0:3)), "\n")
cat("P(X <= 2) = ppois(2) =", z4(ppois(2, lam)), "\n")
cat("P(X >= 8) = 1 - ppois(7) =", z4(1 - ppois(7, lam)), "\n")
cat("Pół godziny, lambda = 2: P(X = 0) =", z4(dpois(0, lam / 2)), "; P(X >= 1) =", z4(1 - dpois(0, lam / 2)), "\n")
cat("E(X) = Var(X) =", lam, "; SD =", z4(sqrt(lam)), "\n")
cat("Rozkład P(X = k), k = 0-12:\n"); print(round(setNames(dpois(0:12, lam), 0:12), 4))
cat("Dla wprawy – 500 formularzy, błąd w 0.6%: Bin P(X = 0) =", z4(dbinom(0, 500, 0.006)),
    "; Poisson(3) P(X = 0) =", z4(dpois(0, 3)), "\n")
cat("Błąd: P(X >= 8) jako 1 - ppois(8) =", z4(1 - ppois(8, lam)), "\n\n")

# Zadanie 7. Wyniki testu kompetencji: X ~ N(62, 10), 250 kandydatów
mu <- 62; s <- 10; N7 <- 250
cat("Zadanie 7\n")
z80 <- (80 - mu) / s; z50 <- (50 - mu) / s; z70 <- (70 - mu) / s; z45 <- (45 - mu) / s
cat("z dla 80, 50, 70, 45:", z2(c(z80, z50, z70, z45)), "\n")
cat("Phi(1.80) =", z4(pnorm(z80)), "; P(X > 80) =", z4(1 - pnorm(80, mu, s)), "; osób z 250 =", z2(N7 * (1 - pnorm(80, mu, s))), "\n")
cat("Phi(0.80) =", z4(pnorm(z70)), "; Phi(-1.20) =", z4(pnorm(z50)), "\n")
cat("P(50 < X < 70) =", z4(pnorm(70, mu, s) - pnorm(50, mu, s)), "; osób z 250 =", z2(N7 * (pnorm(70, mu, s) - pnorm(50, mu, s))), "\n")
cat("P(X < 45) =", z4(pnorm(45, mu, s)), "; osób z 250 =", z2(N7 * pnorm(45, mu, s)), "\n")
cat("Błąd: P(X > 80) odczytane jako Phi(1.80) =", z4(pnorm(z80)), "\n\n")

# Zadanie 8. Kwantyle tego samego rozkładu N(62, 10)
cat("Zadanie 8\n")
cat("z(0.90) =", z4(qnorm(0.90)), "; próg 10% najlepszych =", z2(mu + qnorm(0.90) * s), "; qnorm =", z2(qnorm(0.90, mu, s)), "\n")
cat("z(0.05) =", z4(qnorm(0.05)), "; próg 5% najsłabszych =", z2(qnorm(0.05, mu, s)), "\n")
cat("z(0.25), z(0.75) =", z4(qnorm(c(0.25, 0.75))), "; Q1 =", z2(qnorm(0.25, mu, s)), "; Q3 =", z2(qnorm(0.75, mu, s)),
    "; IQR =", z2(diff(qnorm(c(0.25, 0.75), mu, s))), "\n")
cat("Środkowe 95%:", z2(qnorm(c(0.025, 0.975), mu, s)), "\n")
cat("Kontrola: P(X > próg 10%) =", z2(1 - pnorm(qnorm(0.90, mu, s), mu, s)), "\n")
cat("Błąd: próg z z = 1.645 (5% najlepszych) =", z2(mu + qnorm(0.95) * s), "\n\n")

# Zadanie 9. Ankieta e-mailowa: 400 zaproszeń, odpowiada 30%; X ~ Bin(400; 0.30)
n9 <- 400; p9 <- 0.30
m9 <- n9 * p9; s9 <- sqrt(n9 * p9 * (1 - p9))
cat("Zadanie 9\n")
cat("np =", m9, "; n(1 - p) =", n9 * (1 - p9), "; SD = sqrt(np(1 - p)) =", z4(s9), "\n")
cat("P(X >= 135): dokładnie (pbinom) =", z4(1 - pbinom(134, n9, p9)), "\n")
cat("  z poprawką: z = (134.5 - 120) / SD =", z2((134.5 - m9) / s9), "; wynik =", z4(1 - pnorm(134.5, m9, s9)), "\n")
cat("  z tablicy (z zaokrąglone do 1.58): 1 - Phi(1.58) =", z4(1 - pnorm(1.58)), "\n")
cat("  bez poprawki: z = (135 - 120) / SD =", z2((135 - m9) / s9), "; wynik =", z4(1 - pnorm(135, m9, s9)), "\n")
cat("P(X < 105) = P(X <= 104): dokładnie =", z4(pbinom(104, n9, p9)), "\n")
cat("  z poprawką: z = (104.5 - 120) / SD =", z2((104.5 - m9) / s9), "; wynik =", z4(pnorm(104.5, m9, s9)), "\n")
cat("  bez poprawki (105): wynik =", z4(pnorm(105, m9, s9)), "\n")
cat("Mała próba n = 20: P(X >= 9) dokładnie =", z4(1 - pbinom(8, 20, p9)),
    "; z poprawką =", z4(1 - pnorm(8.5, 20 * p9, sqrt(20 * p9 * (1 - p9)))),
    "; bez poprawki =", z4(1 - pnorm(9, 20 * p9, sqrt(20 * p9 * (1 - p9)))), "\n\n")

# Zadanie 10. Czas oczekiwania w kolejce do dziekanatu: rozkład wykładniczy, średnia 8 min (SD = 8 min)
# Rozkład średniej z próby n = 40: przybliżenie z CTG i symulacja 10 000 prób
mu10 <- 8; sd10 <- 8; n10 <- 40
se10 <- sd10 / sqrt(n10)
cat("Zadanie 10\n")
cat("Pojedyncza osoba: P(X > 10) = exp(-10/8) =", z4(exp(-10 / mu10)), "; pexp =", z4(1 - pexp(10, 1 / mu10)), "\n")
cat("SE = 8 / sqrt(40) =", z4(se10), "\n")
cat("CTG: z = (10 - 8) / SE =", z2((10 - mu10) / se10), "; P(M > 10) =", z4(1 - pnorm(10, mu10, se10)), "\n")
cat("CTG: P(7 < M < 9) =", z4(pnorm(9, mu10, se10) - pnorm(7, mu10, se10)), "\n")
cat("Dokładnie (średnia z wykładniczych ma rozkład gamma): P(M > 10) =",
    z4(1 - pgamma(10, shape = n10, rate = n10 / mu10)), "\n")
set.seed(379)
M <- replicate(10000, mean(rexp(n10, rate = 1 / mu10)))
cat("Symulacja 10 000 prób: średnia średnich =", z4(mean(M)), "; SD średnich =", z4(sd(M)), "\n")
cat("Symulacja: P(M > 10) =", z4(mean(M > 10)), "; P(7 < M < 9) =", z4(mean(M > 7 & M < 9)), "\n")
cat("Błąd Monte Carlo dla P(M > 10): sqrt(P(1 - P) / 10000) =", z4(sqrt(mean(M > 10) * (1 - mean(M > 10)) / 10000)), "\n")
x1 <- rexp(10000, rate = 1 / mu10)
cat("Pojedyncze czasy (10 000 osób): mediana =", z2(median(x1)), "; średnia =", z2(mean(x1)), "\n")
cat("Błąd: SE pomylone z SD, P(M > 10) z SD = 8:", z4(1 - pnorm(10, mu10, sd10)), "\n")
Wynik w R
Zadanie 6
P(X = 0) = e^-4 = 0.0183 ; dpois = 0.0183
P(X = k), k = 0-3 wzorem: 0.0183 0.0733 0.1465 0.1954
P(X <= 2) = ppois(2) = 0.2381
P(X >= 8) = 1 - ppois(7) = 0.0511
Pół godziny, lambda = 2: P(X = 0) = 0.1353 ; P(X >= 1) = 0.8647
E(X) = Var(X) = 4 ; SD = 2.0000
Rozkład P(X = k), k = 0-12:
     0      1      2      3      4      5      6      7      8      9     10
0.0183 0.0733 0.1465 0.1954 0.1954 0.1563 0.1042 0.0595 0.0298 0.0132 0.0053
    11     12
0.0019 0.0006
Dla wprawy – 500 formularzy, błąd w 0.6%: Bin P(X = 0) = 0.0493 ; Poisson(3) P(X = 0) = 0.0498
Błąd: P(X >= 8) jako 1 - ppois(8) = 0.0214

Zadanie 7
z dla 80, 50, 70, 45: 1.80 -1.20 0.80 -1.70
Phi(1.80) = 0.9641 ; P(X > 80) = 0.0359 ; osób z 250 = 8.98
Phi(0.80) = 0.7881 ; Phi(-1.20) = 0.1151
P(50 < X < 70) = 0.6731 ; osób z 250 = 168.27
P(X < 45) = 0.0446 ; osób z 250 = 11.14
Błąd: P(X > 80) odczytane jako Phi(1.80) = 0.9641

Zadanie 8
z(0.90) = 1.2816 ; próg 10% najlepszych = 74.82 ; qnorm = 74.82
z(0.05) = -1.6449 ; próg 5% najsłabszych = 45.55
z(0.25), z(0.75) = -0.6745 0.6745 ; Q1 = 55.26 ; Q3 = 68.74 ; IQR = 13.49
Środkowe 95%: 42.40 81.60
Kontrola: P(X > próg 10%) = 0.10
Błąd: próg z z = 1.645 (5% najlepszych) = 78.45

Zadanie 9
np = 120 ; n(1 - p) = 280 ; SD = sqrt(np(1 - p)) = 9.1652
P(X >= 135): dokładnie (pbinom) = 0.0580
  z poprawką: z = (134.5 - 120) / SD = 1.58 ; wynik = 0.0568
  z tablicy (z zaokrąglone do 1.58): 1 - Phi(1.58) = 0.0571
  bez poprawki: z = (135 - 120) / SD = 1.64 ; wynik = 0.0509
P(X < 105) = P(X <= 104): dokładnie = 0.0440
  z poprawką: z = (104.5 - 120) / SD = -1.69 ; wynik = 0.0454
  bez poprawki (105): wynik = 0.0509
Mała próba n = 20: P(X >= 9) dokładnie = 0.1133 ; z poprawką = 0.1113 ; bez poprawki = 0.0716

Zadanie 10
Pojedyncza osoba: P(X > 10) = exp(-10/8) = 0.2865 ; pexp = 0.2865
SE = 8 / sqrt(40) = 1.2649
CTG: z = (10 - 8) / SE = 1.58 ; P(M > 10) = 0.0569
CTG: P(7 < M < 9) = 0.5708
Dokładnie (średnia z wykładniczych ma rozkład gamma): P(M > 10) = 0.0646
Symulacja 10 000 prób: średnia średnich = 8.0184 ; SD średnich = 1.2728
Symulacja: P(M > 10) = 0.0688 ; P(7 < M < 9) = 0.5653
Błąd Monte Carlo dla P(M > 10): sqrt(P(1 - P) / 10000) = 0.0025
Pojedyncze czasy (10 000 osób): mediana = 5.63 ; średnia = 8.11
Błąd: SE pomylone z SD, P(M > 10) z SD = 8: 0.4013
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jak rozpoznać w zadaniu, czy to rozkład dwumianowy, czy Poissona?
Rozkład dwumianowy liczy sukcesy w stałej, znanej liczbie prób (np. 20 pytań testu), więc wynik nie może przekroczyć n. Rozkład Poissona liczy zdarzenia w okresie lub obszarze, bez górnej granicy, przy znanej średniej liczbie zdarzeń λ (np. 4 zgłoszenia na godzinę). Gdy prób jest bardzo dużo, a sukces rzadki, oba rozkłady dają prawie to samo (w zadaniu 6: 0.0493 i 0.0498).
Kiedy w zadaniu z rozkładem dwumianowym stosować poprawkę na ciągłość?
Gdy przybliżasz rozkład dwumianowy normalnym, czyli liczysz pnorm lub z tablicy z zamiast sumować dokładne prawdopodobieństwa. Zamieniasz wtedy „co najmniej 135” na „powyżej 134.5”, a „najwyżej 104” na „poniżej 104.5”. Jeśli masz R albo kalkulator z rozkładem dwumianowym, policz wynik dokładnie (pbinom) – poprawka nie jest wtedy potrzebna.
Czym różni się P(A | B) od P(B | A) w zadaniach z prawdopodobieństwa?
P(A | B) liczysz tylko wśród przypadków B, a P(B | A) – tylko wśród przypadków A. W zadaniu z testem przesiewowym czułość P(+ | dysleksja) wynosi 0.90, a P(dysleksja | +) tylko 0.2769, bo uczniów bez dysleksji jest dużo więcej. Najprościej rozpisać 1000 osób na tabelę liczebności i odczytać właściwy wiersz lub kolumnę.
Czy na kolokwium mogę liczyć rozkład normalny w R zamiast z tablic?
To zależy od zasad przedmiotu – na wielu kolokwiach jest tylko kalkulator i tablice. Warto jednak sprawdzać rachunki w R: pnorm(80, 62, 10) daje pole na lewo od 80, a qnorm(0.90, 62, 10) – próg dla 10% najlepszych. Różnice na czwartym miejscu po kropce wynikają z zaokrąglenia z do dwóch miejsc w tablicy.
Od jakiej liczebności próby średnia ma rozkład normalny?
Nie ma jednej granicy: im bardziej skośny rozkład pojedynczych wyników, tym większej próby potrzeba. W zadaniu 10 z rozkładem wykładniczym przy n = 40 przybliżenie z CTG daje 0.0569, a dokładny wynik to 0.0646 – rozkład średnich jest już bliski normalnemu, ale nie idealnie. Przy rozkładach zbliżonych do symetrycznych wystarcza dużo mniejsze n.
Powiązane hasła
Przeczytaj też
Zadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →PoradnikTablice rozkładów t, χ², F i z
Wartości krytyczne t, χ², F i z policzone w R oraz kalkulator wartości krytycznej i p dla dowolnych df z wykresem obszaru odrzucenia.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →Masz własne dane do pracy i nie wiesz, jaki rozkład i test wybrać?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aczel, A. D., & Sounderpandian, J. (2018). Statystyka w zarządzaniu (Wyd. 2). Wydawnictwo Naukowe PWN.
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- Gigerenzer, G., Gaissmaier, W., Kurz-Milcke, E., Schwartz, L. M., & Woloshin, S. (2007). Helping doctors and patients make sense of health statistics. Psychological Science in the Public Interest, 8(2), 53–96. https://doi.org/10.1111/j.1539-6053.2008.00033.x ● Otwarty dostęp
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Kwak, S. G., & Kim, J. H. (2017). Central limit theorem: The cornerstone of modern statistics. Korean Journal of Anesthesiology, 70(2), 144–156. https://doi.org/10.4097/kjae.2017.70.2.144 ● Otwarty dostęp
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
Cytowania BibTeX
@book{aczel2018statystyka, author={Aczel, Amir D. and Sounderpandian, Jayavel}, title={{Statystyka w zarządzaniu}}, year={2018}, edition={Wyd. 2}, publisher={Wydawnictwo Naukowe PWN}}@book{field2018discovering, author={Field, Andy}, title={{Discovering statistics using IBM SPSS Statistics}}, year={2018}, edition={5th}, publisher={SAGE}}@article{gigerenzer2007helping, author={Gigerenzer, Gerd and Gaissmaier, Wolfgang and Kurz-Milcke, Elke and Schwartz, Lisa M. and Woloshin, Steven}, title={{Helping doctors and patients make sense of health statistics}}, journal={Psychological Science in the Public Interest}, year={2007}, volume={8}, number={2}, pages={53--96}, doi={10.1111/j.1539-6053.2008.00033.x}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{kwak2017central, author={Kwak, Sang Gyu and Kim, Jong Hae}, title={{Central limit theorem: The cornerstone of modern statistics}}, journal={Korean Journal of Anesthesiology}, year={2017}, volume={70}, number={2}, pages={144--156}, doi={10.4097/kjae.2017.70.2.144}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}