Co to jest rozkład wykładniczy?
Rozkład wykładniczy (ang. exponential distribution) to ciągły rozkład czasu oczekiwania na zdarzenie, gdy zdarzenia zachodzą niezależnie ze stałą intensywnością λ: czasu do nawrotu objawów, do rezygnacji z terapii albo między kolejnymi wizytami w poradni. Gęstość wynosi f(x) = λe−λx dla x ≥ 0, a prawdopodobieństwo, że zdarzenie nie nastąpi do czasu t, to S(t) = e−λt.
Własności
- Średnia 1/λ, wariancja 1/λ2. Odchylenie standardowe jest równe średniej, a mediana wynosi ln 2/λ, czyli mniej niż średnia – rozkład jest prawostronnie skośny. Ogólne pojęcie opisuje hasło wariancja.
- Brak pamięci. Szansa, że zdarzenie nastąpi w najbliższym miesiącu, nie zależy od tego, jak długo już czekamy. Hazard jest stały.
- Związek z rozkładem Poissona. Gdy odstępy między zdarzeniami mają rozkład wykładniczy z parametrem λ, liczba zdarzeń w jednostce czasu ma rozkład Poissona ze średnią λ.
- Szczególny przypadek. To rozkład Weibulla z parametrem kształtu równym 1.
Przykład w R
Przy λ = 0.5 zdarzenia na miesiąc średni czas oczekiwania wynosi 2 miesiące, wariancja 4, mediana 1.386, a prawdopodobieństwo zdarzenia w pierwszym miesiącu .393. Brak pamięci widać w liczbach: P(X > 3 | X > 1) = P(X > 2) = .368. W 10 000 symulowanych czasach średnia wyniosła 2.00, a wariancja 4.05. Gdy z wykładniczych odstępów policzono zdarzenia w 5000 kolejnych miesiącach, średnia wyniosła 0.50, a wariancja 0.51, jak w rozkładzie Poissona.
W analizie przeżycia rozkład wykładniczy jest najprostszym modelem parametrycznym. Bender, Augustin i Blettner (2005) pokazują, jak z rozkładów wykładniczego, Weibulla i Gompertza generować czasy przeżycia do symulacji modelu Coxa, i podkreślają, że sam rozkład wykładniczy nie wystarcza, by zbadać model w nietypowych sytuacjach. Carroll (2003) przypomina, że model parametryczny daje szersze wnioski niż model Coxa, jeśli dobrze opisuje dane.
Na rysunku
Rysunek 1 pokazuje trzy rozkłady wykładnicze, a rysunek 2 – brak pamięci na 10 000 czasach z przykładu wyżej (to samo ziarno 4831, λ = 0.5 zdarzenia na miesiąc).
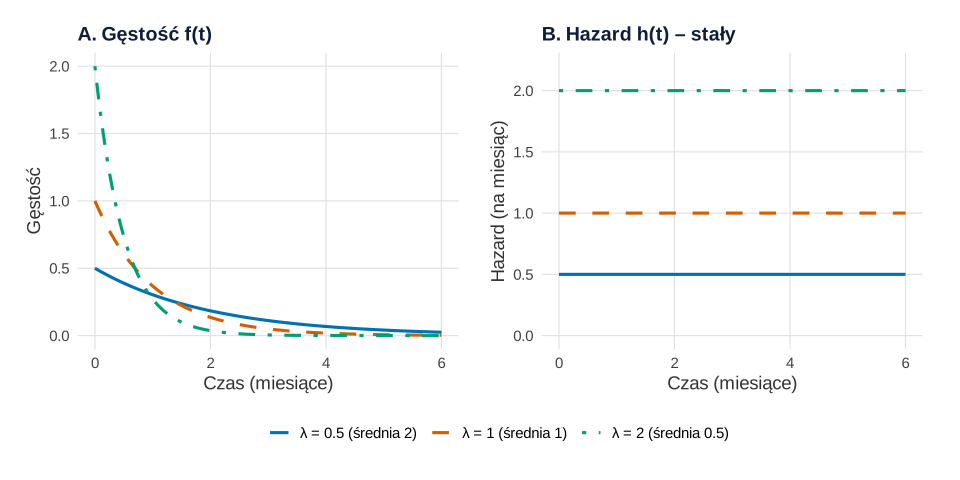
Co widać. Każda gęstość zaczyna się w punkcie λ i maleje, im większe λ, tym szybciej – średni czas 1/λ jest wtedy krótszy. Hazard, czyli chwilowe ryzyko zdarzenia u osób, które jeszcze na nie czekają, jest poziomą linią.
Na co uważać. Wykres gęstości nie pokazuje, czy hazard w Twoich danych jest stały – podobnie malejący kształt ma też rozkład Weibulla o kształcie mniejszym od 1, ale jego hazard maleje.
Podpis do pracy:
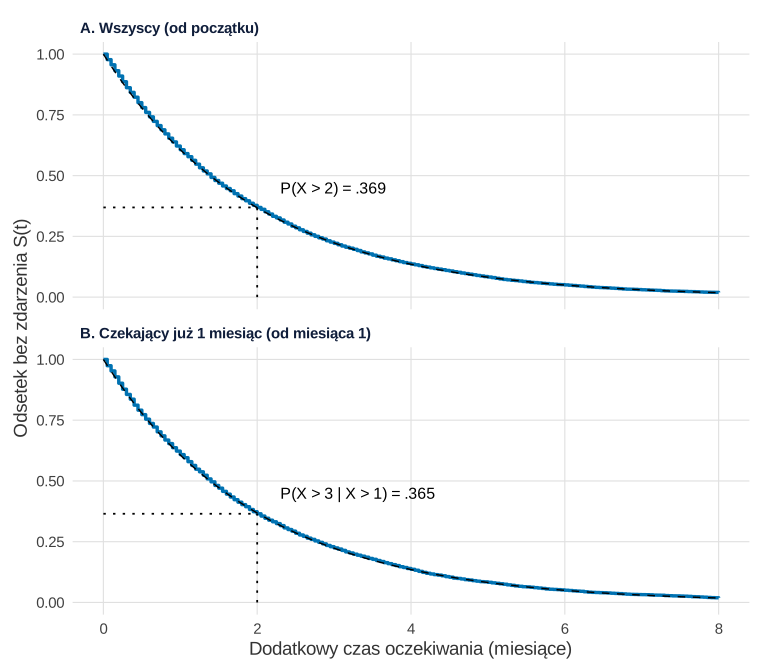
set.seed(4831)).Co widać. Panel B obejmuje 6066 z 10 000 osób, u których zdarzenie nie nastąpiło w pierwszym miesiącu; ich dalszy czas liczymy od nowa. Obie krzywe pokrywają się z krzywą teoretyczną e−0.5t: dalsze 2 miesiące bez zdarzenia przetrwało .369 wszystkich i .365 czekających (teoria: .368). Kto przeczekał miesiąc, nie jest „bliżej” zdarzenia.
Na co uważać. Ten obraz powstał z danych wygenerowanych z rozkładu wykładniczego, więc zgodność jest tu zagwarantowana. Na prawdziwych danych porównaj krzywą przeżycia z ostatniego okresu z krzywą od początku – jeśli się rozjeżdżają, założenie stałego hazardu nie pasuje (krzywe z cenzurowaniem opisuje krzywa Kaplana–Meiera).
Podpis do pracy:
Na stronie rysunki mają motyw serwisu (krój czcionki, siatka); dane, geometrie i skale są takie same jak w kodzie poniżej. Intensywności 0.5, 1 i 2 wybrano ręcznie dla czytelności; ziarna nie zmieniano.
Kod R rysunków 1 i 2
# Rysunki 1–2: rodzina rozkładów wykładniczych i brak pamięci
library(ggplot2)
library(patchwork)
kol <- c("#0072B2", "#D55E00", "#009E73")                 # paleta Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1. Gęstość i hazard dla trzech intensywności λ
siatka <- expand.grid(t = seq(0, 6, by = 0.02), lambda = c(0.5, 1, 2))
siatka$gestosc <- dexp(siatka$t, siatka$lambda)
siatka$hazard <- siatka$lambda                            # f(t) / S(t) = λ dla każdego t
siatka$krzywa <- factor(paste0("λ = ", siatka$lambda, " (średnia ", 1 / siatka$lambda, ")"),
                        levels = paste0("λ = ", c(0.5, 1, 2), " (średnia ", c(2, 1, 0.5), ")"))
skale <- list(scale_colour_manual(values = kol, name = NULL),
              scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL))
p1a <- ggplot(siatka, aes(t, gestosc, colour = krzywa, linetype = krzywa)) +
  geom_line(linewidth = 1.1) + skale +
  labs(title = "A. Gęstość f(t)", x = "Czas (miesiące)", y = "Gęstość") + motyw
p1b <- ggplot(siatka, aes(t, hazard, colour = krzywa, linetype = krzywa)) +
  geom_line(linewidth = 1.1) + skale + scale_y_continuous(limits = c(0, 2.2)) +
  labs(title = "B. Hazard h(t) – stały", x = "Czas (miesiące)", y = "Hazard (na miesiąc)") + motyw
p1 <- p1a + p1b + plot_layout(guides = "collect") & theme(legend.position = "bottom")

# Rysunek 2. Brak pamięci: 10 000 czasów z przykładu (to samo ziarno), λ = 0.5;
# linia schodkowa – dane, przerywana – teoria exp(−0.5 t)
set.seed(4831)
x <- rexp(10000, 0.5)
dalej <- x[x > 1] - 1                                     # czas pozostały u tych, którzy czekają już 1 miesiąc
c(wszyscy = length(x), czekajacy_ponad_1 = length(dalej))
round(c(P_X_pow_2 = mean(x > 2), P_X_pow_3_gdy_X_pow_1 = mean(dalej > 2),
        teoria = exp(-0.5 * 2)), 3)
przezycie <- function(v, nazwa) {                         # empiryczne S(t) na siatce 0–8 miesięcy
  t <- seq(0, 8, by = 0.05)
  data.frame(t = t, S = sapply(t, function(s) mean(v > s)), grupa = nazwa)
}
dane2 <- rbind(przezycie(x, "A. Wszyscy (od początku)"),
               przezycie(dalej, "B. Czekający już 1 miesiąc (od miesiąca 1)"))
odczyt <- data.frame(grupa = unique(dane2$grupa), S2 = c(mean(x > 2), mean(dalej > 2)),
                     etykieta = c(paste0("P(X > 2) = ", sub("^0", "", round(mean(x > 2), 3))),
                                  paste0("P(X > 3 | X > 1) = ", sub("^0", "", round(mean(dalej > 2), 3)))))
p2 <- ggplot(dane2, aes(t, S)) +
  geom_step(colour = kol[1], linewidth = 1.2) +
  stat_function(fun = function(t) exp(-0.5 * t), linetype = "dashed", colour = "black", linewidth = 0.5) +
  geom_segment(data = odczyt, aes(x = 2, xend = 2, y = 0, yend = S2), linetype = "dotted") +
  geom_segment(data = odczyt, aes(x = 0, xend = 2, y = S2, yend = S2), linetype = "dotted") +
  geom_text(data = odczyt, aes(x = 2.3, y = 0.45, label = etykieta), hjust = 0, size = 4.2) +
  facet_wrap(~ grupa, ncol = 1) +
  labs(x = "Dodatkowy czas oczekiwania (miesiące)", y = "Odsetek bez zdarzenia S(t)") + motyw
p1
p2
Wynik w R
          wszyscy czekajacy_ponad_1
            10000              6066
            P_X_pow_2 P_X_pow_3_gdy_X_pow_1                teoria
                0.369                 0.365                 0.368
Jak opisać w pracy
Na co uważać
- Stały hazard to mocne założenie. Ryzyko nawrotu jest często największe tuż po zakończeniu leczenia. Wtedy lepiej pasuje rozkład Weibulla.
- Cenzurowanie. Średnia z samych zaobserwowanych czasów zaniża średni czas, bo pomija obserwacje cenzurowane. Analizę z cenzurowaniem pokazuje poradnik Kaplan–Meier i model Coxa krok po kroku.
Rozkład wykładniczy w R
Kod liczy średnią, wariancję, medianę i prawdopodobieństwa rozkładu wykładniczego dla λ = 0.5, sprawdza brak pamięci, porównuje wyniki z symulacją i pokazuje, że wykładnicze odstępy dają liczby zdarzeń o rozkładzie Poissona.
Średnia, mediana, brak pamięci i związek z rozkładem Poissona
R
lambda <- 0.5                            # średnio 0.5 zdarzenia na miesiąc
round(c(srednia = 1 / lambda, wariancja = 1 / lambda^2,
        mediana = qexp(0.5, lambda), P_do_1 = pexp(1, lambda)), 3)
# brak pamięci: P(X > 3 | X > 1) = P(X > 2)
round(c(warunkowe = pexp(3, lambda, lower.tail = FALSE) /
          pexp(1, lambda, lower.tail = FALSE),
        P_powyzej_2 = pexp(2, lambda, lower.tail = FALSE)), 3)
set.seed(4831)
x <- rexp(10000, lambda)
round(c(srednia_sym = mean(x), wariancja_sym = var(x)), 2)
# odstępy wykładnicze -> liczby zdarzeń Poissona w kolejnych miesiącach
czasy <- cumsum(rexp(20000, lambda))
liczby <- table(factor(floor(czasy[czasy < 5000]), levels = 0:4999))
round(c(srednia_liczby = mean(liczby), wariancja_liczby = var(as.vector(liczby))), 2)
Wynik w R
  srednia wariancja   mediana    P_do_1
    2.000     4.000     1.386     0.393
  warunkowe P_powyzej_2
      0.368       0.368
  srednia_sym wariancja_sym
         2.00          4.05
  srednia_liczby wariancja_liczby
            0.50             0.51
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w przykładzie nie wymagają dodatkowych pakietów; rysunki 1 i 2 wykonano w pakiecie ggplot2, a panele złożono pakietem patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Co oznacza brak pamięci w rozkładzie wykładniczym?
Że dotychczasowe czekanie nic nie zmienia. Przy λ = 0.5 na miesiąc P(X > 3 | X > 1) = P(X > 2) = .368. Ryzyko zdarzenia, czyli hazard, jest w każdej chwili takie samo.
Jak parametr λ wiąże się ze średnim czasem oczekiwania?
Średni czas to 1/λ. Jeśli zdarzenie występuje średnio 0.5 raza na miesiąc, czeka się na nie średnio 2 miesiące. Mediana jest krótsza i wynosi ln 2/λ, czyli 1.39 miesiąca.
Kiedy zamiast rozkładu wykładniczego wybrać rozkład Weibulla?
Gdy ryzyko zdarzenia rośnie lub maleje z czasem, np. nawroty są najczęstsze tuż po leczeniu. Rozkład Weibulla ma dodatkowy parametr kształtu; przy kształcie 1 jest rozkładem wykładniczym.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikObsada infolinii – Erlang C i symulacja
Infolinia dostawcy energii: test Poissona, czas rozmowy, Erlang C ręcznie, symulacja kolejki z rozłączeniami i grafik w kwadransach – sześć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bender, R., Augustin, T., & Blettner, M. (2005). Generating survival times to simulate Cox proportional hazards models. Statistics in Medicine, 24(11), 1713–1723. https://doi.org/10.1002/sim.2059 ● Otwarty dostęp: pełny tekst
- Carroll, K. J. (2003). On the use and utility of the Weibull model in the analysis of survival data. Controlled Clinical Trials, 24(6), 682–701. https://doi.org/10.1016/s0197-2456(03)00072-2
Cytowania BibTeX
@article{bender2005generating, author={Bender, Ralf and Augustin, Thomas and Blettner, Maria}, title={{Generating survival times to simulate Cox proportional hazards models}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={11}, pages={1713--1723}, doi={10.1002/sim.2059}}@article{carroll2003use, author={Carroll, Kevin J.}, title={{On the use and utility of the Weibull model in the analysis of survival data}}, journal={Controlled Clinical Trials}, year={2003}, volume={24}, number={6}, pages={682--701}, doi={10.1016/s0197-2456(03)00072-2}}