Kiedy potrzebujesz analizy przeżycia
Analiza przeżycia jest potrzebna, gdy wynikiem nie jest samo „czy zdarzenie wystąpiło”, lecz po jakim czasie, a u części osób do końca obserwacji nic się nie wydarzyło. Clark i in. (2003) podkreślają dwie cechy takich danych: obserwacje są ucięte (cenzurowane), a czasy zwykle silnie skośne. Nazwa pochodzi z badań nad zgonami, ale zdarzeniem może być nawrót choroby, ponowna hospitalizacja, rezygnacja z terapii, powrót do pracy czy obrona doktoratu. Podstawowe pojęcia – funkcję przeżycia, hazard i rodzaje cenzurowania – opisują hasła analiza przeżycia i obserwacja cenzurowana.
Ten poradnik jest przeznaczony dla badaczy i doktorantów, którzy mają już dane z obserwacji kohorty albo badania klinicznego i muszą przygotować analizę do artykułu lub rozprawy. Prowadzi przez cały proces na jednym zbiorze danych: przygotowanie zmiennych, krzywe Kaplana–Meiera, test log-rank, model Coxa, sprawdzenie proporcjonalności hazardów, postępowanie przy jej naruszeniu, ryzyka konkurujące oraz tabelę i opis w stylu APA. Definicji z haseł nie powtarzam – skupiam się na decyzjach analitycznych i na tym, co recenzent sprawdzi w pierwszej kolejności.
Dlaczego nie wystarczy regresja logistyczna dla „hospitalizowany w ciągu roku: tak/nie”? Bo osoba obserwowana 200 dni bez zdarzenia nie jest tym samym co osoba obserwowana 365 dni bez zdarzenia. Usunięcie krótszych obserwacji obciąża wynik i marnuje dane, a zaliczenie ich do „bez zdarzenia” zaniża częstość zdarzeń. Analiza przeżycia wykorzystuje informację, że do danego dnia zdarzenie nie wystąpiło.
Przykład: telefoniczna opieka po wypisie a ponowna hospitalizacja
W przykładzie (dane symulowane) obserwowano kohortę 360 pacjentów wypisanych ze szpitala po hospitalizacji z powodu niewydolności serca. 165 z nich objęto programem telefonicznej opieki pielęgniarskiej, a 195 – opieką standardową. Przydział nie był losowy, więc to badanie kohortowe, a nie eksperyment. Zdarzeniem jest pierwsza ponowna hospitalizacja. Pacjentów włączano przez kilka miesięcy, dlatego okres obserwacji kończył się po 180–365 dniach, a część osób utracono z obserwacji wcześniej.
- Ponowna hospitalizacja: 174 osoby (48.3%).
- Zgon przed ponowną hospitalizacją: 28 osób (7.8%).
- Koniec obserwacji lub utrata bez zdarzenia: 158 osób (43.9%).
Mediana czasu obserwacji wyniosła 265 dni, 95% CI [252, 287]. Policzono ją metodą odwróconego Kaplana–Meiera, w której „zdarzeniem” jest cenzurowanie. Zwykła mediana czasów wszystkich osób byłaby zaniżona, bo u osób z hospitalizacją obserwacja kończy się wcześnie z powodu zdarzenia, a nie z braku danych.
Grupy różniły się nieco wyjściowo: w programie było mniej osób w klasie NYHA III–IV (35.8% wobec 43.6%), a nieco więcej chorych na cukrzycę (41.8% wobec 35.9%). Średni wiek był zbliżony (M = 71.1, SD = 9.6, wobec M = 71.7, SD = 8.2). W obserwacji takie różnice trzeba uwzględnić w modelu – to zadanie modelu Coxa w kroku 4.
Plik do pobrania: analiza-przezycia-dane-przyklad.csv – 360 wierszy, kolumny id, czas (dni od wypisu do zdarzenia lub końca obserwacji), status (0 = cenzurowanie, 1 = ponowna hospitalizacja, 2 = zgon), program (1 = tak), wiek, nyha34 (1 = klasa III–IV), cukrzyca (1 = tak). Wszystkie liczby w tekście pochodzą z kodu w sekcji Przykład w R.
Krok 1. Zdefiniuj początek, zdarzenie i cenzurowanie
Najwięcej błędów w analizie przeżycia powstaje, zanim padnie pierwsze polecenie w R. Zapisz w protokole (najlepiej w planie analizy) odpowiedzi na trzy pytania.
- Kiedy zaczyna się czas? Tu: dzień wypisu. Moment zero musi być taki sam dla wszystkich i poprzedzać ekspozycję albo z nią się pokrywać. Jeśli do programu włączano by pacjentów np. dopiero miesiąc po wypisie, a czas liczono od wypisu, grupa programu „z definicji” przeżyłaby pierwszy miesiąc bez hospitalizacji. To tzw. obciążenie czasem nieśmiertelności, które potrafi wytworzyć efekt z niczego.
- Co jest zdarzeniem? Pierwsza ponowna hospitalizacja z dowolnej przyczyny? Tylko z powodu niewydolności serca? Definicja wpływa na liczbę zdarzeń i na to, co staje się ryzykiem konkurującym.
- Kiedy i dlaczego obserwacja jest ucinana? Koniec badania, utrata z obserwacji, wycofanie zgody, zgon. Standardowe metody zakładają, że cenzurowanie nie niesie informacji o rokowaniu. Leung i in. (1997) przypominają, że w większości badań obserwacyjnych mechanizm cenzurowania jest nieznany, a wnioski zależą od przyjętych założeń. Opisz, ile osób i z jakich powodów ucięto w każdej grupie.
W danych potrzebujesz dwóch kolumn: czasu do zdarzenia lub cenzurowania i wskaźnika zdarzenia. W R łączy je obiekt Surv(czas, hosp). Zgon na razie traktujemy jako cenzurowanie (wrócimy do tego w kroku 6).
Krok 2. Krzywe Kaplana–Meiera, mediany i przeżycie w wybranych dniach
Estymator Kaplana–Meiera (Kaplan i Meier, 1958) szacuje odsetek osób bez zdarzenia po czasie t, wykorzystując także osoby ucięte – do chwili ucięcia są w zbiorze ryzyka. Jak go policzyć ręcznie, pokazuje hasło o krzywej Kaplana–Meiera. W artykule krzywe są zwykle pierwszym rysunkiem analizy, a recenzenci oczekują pod nimi liczby osób w ryzyku.
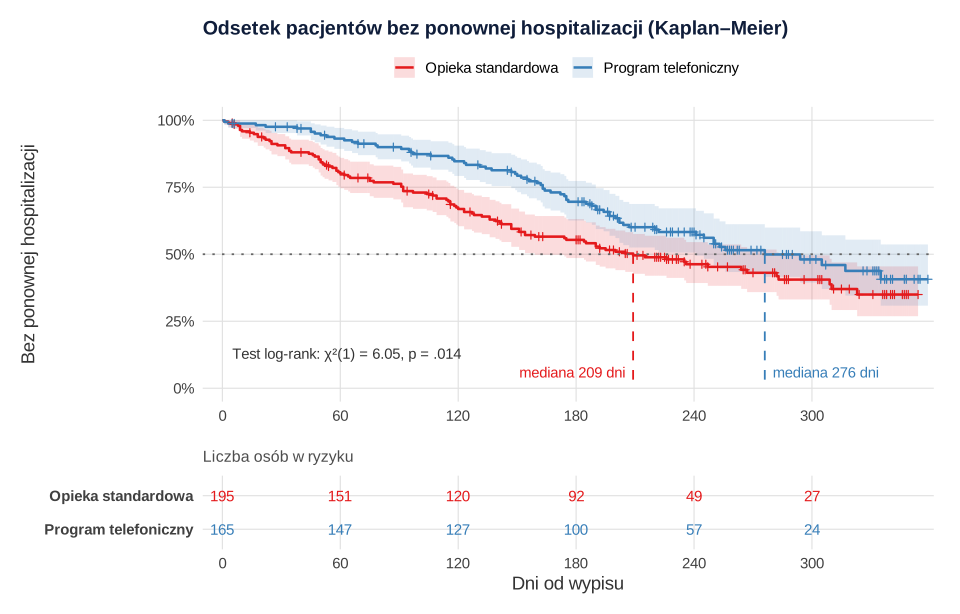
| Miara | Opieka standardowa (n = 195) | Program telefoniczny (n = 165) |
|---|---|---|
| Ponowne hospitalizacje | 103 | 71 |
| Bez hospitalizacji po 90 dniach [95% CI] | 76.3% [70.5, 82.6] | 90.0% [85.4, 94.8] |
| Bez hospitalizacji po 180 dniach [95% CI] | 55.4% [48.6, 63.1] | 69.6% [62.6, 77.4] |
| Bez hospitalizacji po 300 dniach [95% CI] | 40.5% [33.1, 49.6] | 48.1% [39.4, 58.6] |
| Mediana czasu do hospitalizacji [95% CI] | 209 dni [159, 283] | 276 dni [241, –] |
| RMST do 300. dnia | 191.7 dnia | 227.2 dnia |
Kilka zasad czytania i raportowania:
- Mediana to czas, w którym krzywa spada do 50%. Górnej granicy przedziału dla programu nie da się oszacować, bo górny pas ufności nie schodzi poniżej 50% przed końcem obserwacji – w tabeli zostaw kreskę i wyjaśnij ją w nocie. Gdy krzywa w ogóle nie schodzi do 50%, mediana „nie została osiągnięta” i nie wolno jej zastępować średnią czasów.
- Prawy koniec krzywej jest niepewny. W dniu 300 w ryzyku pozostawało tylko 27 i 24 osoby. Nie wyciągaj wniosków z „ogona” krzywej i nie rysuj jej daleko poza miejscem, w którym zostało kilka osób.
- Podawaj odsetki dla z góry wybranych punktów czasu (tu 90, 180 i 300 dni), a nie dla punktu, w którym różnica wygląda najlepiej.
Ostatni wiersz tabeli to ograniczony średni czas przeżycia (RMST, restricted mean survival time): pole pod krzywą Kaplana–Meiera od 0 do wybranego dnia. Royston i Parmar (2013) proponują go jako alternatywę dla ilorazu hazardów, bo nie wymaga założenia proporcjonalnych hazardów. W przykładzie w ciągu pierwszych 300 dni pacjenci z programu przeżyli bez hospitalizacji średnio o 35.5 dnia dłużej, 95% CI [14.3, 56.7]. Tę liczbę rozumie każdy klinicysta, a za chwilę okaże się, że w tych danych jest bardziej wiarygodna niż pojedynczy HR.
Krok 3. Test log-rank
Test log-rank porównuje całe krzywe. Bland i Altman (2004) opisują jego logikę: w każdym momencie zdarzenia porównuje się liczbę zdarzeń obserwowanych z oczekiwaną przy braku różnic między grupami. W przykładzie w opiece standardowej było 103 hospitalizacje przy 86.8 oczekiwanych, a w programie 71 przy 87.2 oczekiwanych: χ²(1) = 6.05, p = .014.
Ci sami autorzy zwracają uwagę na dwa ograniczenia. Test najłatwiej wykrywa różnicę, gdy ryzyko w jednej grupie jest stale wyższe, a może jej nie wykryć, gdy krzywe się przecinają – dlatego krzywe zawsze trzeba narysować. Jest też czystym testem istotności: nie daje wielkości różnicy ani przedziału ufności. Do tego w podstawowej postaci nie uwzględnia innych zmiennych. Dlatego w artykule log-rank zwykle towarzyszy krzywym, a wielkość efektu podaje się z modelu Coxa albo jako różnicę RMST lub odsetków w wybranych punktach czasu.
Krok 4. Model Coxa: jeden predyktor i model wielozmiennowy
Model proporcjonalnych hazardów Coxa (Cox, 1972) zakłada, że hazard osoby jest iloczynem nieznanego hazardu bazowego, zmiennego w czasie, i funkcji jej cech. Nie trzeba więc zakładać kształtu krzywej przeżycia, a wynik podaje się jako iloraz hazardów (HR) – stosunek chwilowego tempa zdarzeń w porównywanych grupach.
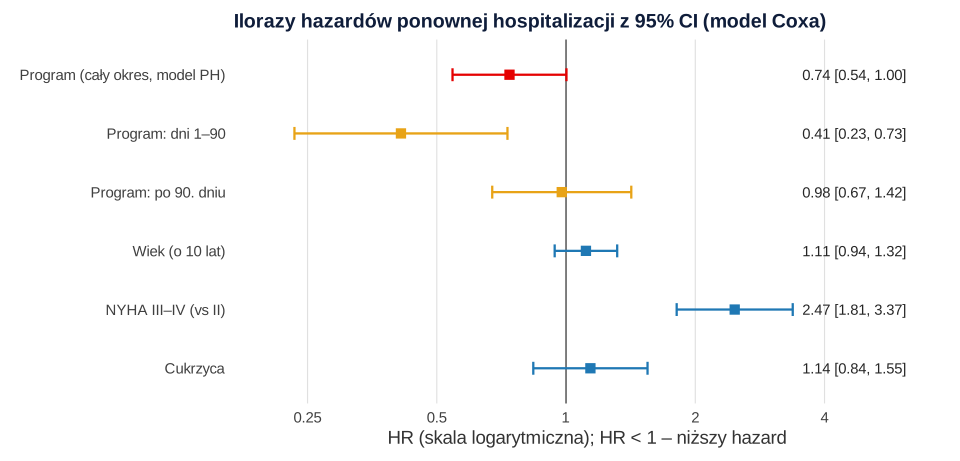
Model z samym programem daje HR = 0.69, 95% CI [0.51, 0.93], p = .015. Po uwzględnieniu wieku, klasy NYHA i cukrzycy (rysunek 2, tabela 1, model A) HR programu wynosi 0.74, 95% CI [0.54, 1.00], p = .052. Osłabienie efektu wynika z tego, że w programie było mniej pacjentów w zaawansowanej klasie NYHA, która silnie zwiększa hazard (HR = 2.47, 95% CI [1.81, 3.37], p < .001). To klasyczny przykład zmiennej zakłócającej w badaniu obserwacyjnym. Gdy zakłócaczy jest więcej, a grupy porównania mają różne profile, rozważ metody oparte na propensity score.
Jak czytać HR i czego nie pisać:
- HR = 2.47 dla NYHA III–IV oznacza, że w każdym momencie obserwacji tempo ponownych hospitalizacji u osób bez zdarzenia jest w tej grupie około 2.5 raza wyższe niż w klasie II, przy tym samym wieku, cukrzycy i udziale w programie.
- HR to nie ryzyko względne ani iloraz szans. Zdanie „ryzyko hospitalizacji było o 26% mniejsze” jest skrótem, który recenzenci coraz częściej kwestionują. Hernán (2010) pokazuje, że pojedynczy HR jest rodzajem średniej ważonej z kolejnych okresów, więc zależy od długości obserwacji, i ma wbudowane obciążenie selekcją, bo w późniejszym okresie porównuje osoby, które „przetrwały” bez zdarzenia. Bezwzględne miary – odsetki w punktach czasu, różnica RMST – warto podawać obok HR.
- Brak istotności to nie brak efektu. Przedział [0.54, 1.00] obejmuje zarówno znaczne zmniejszenie hazardu, jak i brak różnicy. Opisz go w całości, zamiast pisać „program nie miał wpływu”.
Model jako całość: test ilorazu wiarygodności χ²(4) = 44.25, p < .001; wskaźnik zgodności Harrella C = .65 (SE = 0.02), czyli w 65% par porównywalnych pacjentów model wskazał wyższe ryzyko osobie, która wcześniej trafiła do szpitala. Na 4 predyktory przypadają 174 zdarzenia (43.5 na predyktor). Peduzzi i in. (1995) pokazali w symulacji, że przy małej liczbie zdarzeń na zmienną współczynniki modelu Coxa stają się obciążone, a przedziały ufności tracą nominalne pokrycie, i za rozsądną granicę uznali 10 zdarzeń na zmienną. Jeśli model ma służyć predykcji, a nie tylko opisowi związków, Riley i in. (2019) proponują zamiast tej reguły kciuka obliczenie minimalnej liczebności z trzech kryteriów – zob. też dobór liczebności próby.
Inne elementy, które zwykle sprawdza się w modelu Coxa jak w każdej regresji: współliniowość predyktorów, kształt zależności dla zmiennych ciągłych (tu wiek liczony w dekadach, liniowo; przy wątpliwościach splajn), obserwacje wpływowe i braki danych w predyktorach.
Krok 5. Sprawdź założenie proporcjonalnych hazardów
Model Coxa zakłada, że HR jest stały w czasie: krzywe hazardu w grupach są do siebie proporcjonalne. Grambsch i Therneau (1994) pokazali, że naruszenie tego założenia da się opisać jako współczynnik zmienny w czasie β(t), np. efekt leczenia słabnący z czasem, i zobaczyć go, wygładzając wykres skalowanych reszt Schoenfelda. Na tej idei opiera się funkcja cox.zph() w pakiecie survival.
W przykładzie test wskazał wyraźne naruszenie dla programu: χ²(1) = 11.66, p < .001 (globalnie χ²(4) = 14.27, p = .006). Dla wieku, NYHA i cukrzycy p wynosiło od .352 do .539. Rysunek 3 pokazuje, co się dzieje.
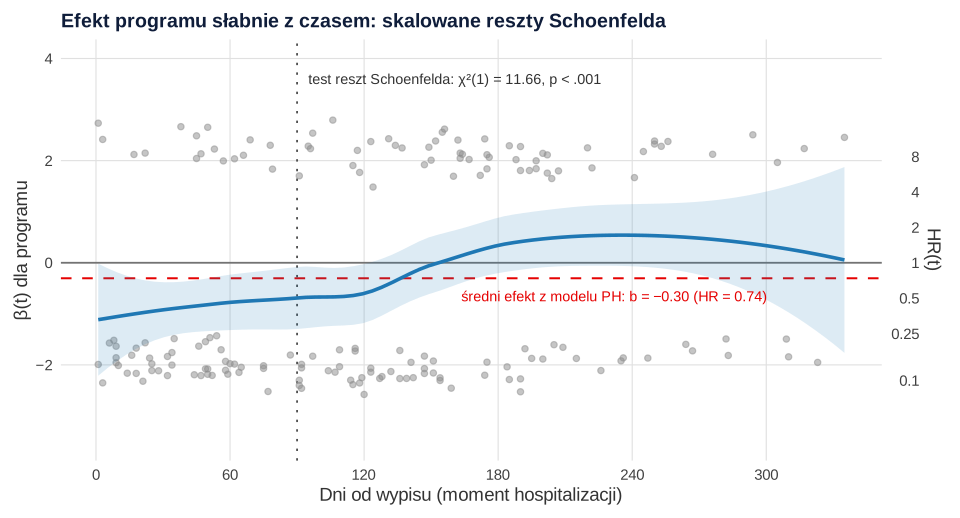
cox.zph()), wykres pokazuje dni. Obliczenia: R (dane symulowane).W pierwszych tygodniach po wypisie β(t) leży wyraźnie poniżej zera, a później zbliża się do zera. Program chroni przed wczesnymi hospitalizacjami, ale ochrona słabnie. Zauważ też, że już krzywe Kaplana–Meiera (rysunek 1) rozchodzą się szybko na początku, a potem biegną mniej więcej równolegle. Pojedynczy HR = 0.74 uśrednia więc dwa różne okresy i nie opisuje żadnego z nich.
Co zrobić? Najprostsze i najczęściej zrozumiałe dla czytelnika rozwiązanie to podzielić czas obserwacji na okresy i oszacować efekt osobno w każdym z nich. Punkt podziału trzeba uzasadnić merytorycznie (tu: 90 dni to typowy okres wczesnych powrotów do szpitala i czas trwania intensywnej fazy programu), a najlepiej ustalić go przed analizą – nie szukaj punktu, który daje najładniejszy wynik. Funkcja survSplit() zamienia każdą osobę na jeden lub dwa wiersze (przed i po 90. dniu), a w modelu program ma osobny współczynnik dla każdego okresu:
- dni 1–90: HR = 0.41, 95% CI [0.23, 0.73], p = .002 (16 hospitalizacji w programie wobec 45 w opiece standardowej);
- po 90. dniu: HR = 0.98, 95% CI [0.67, 1.42], p = .904 (55 wobec 58);
- różnica efektów między okresami (interakcja program × okres): z = 2.48, p = .013.
W modelu z podziałem test reszt nie wskazuje już wyraźnego naruszenia (dla programu χ²(2) = 5.43, p = .066; globalnie χ²(5) = 8.09, p = .152). Inne możliwości to interakcja predyktora z funkcją czasu (tt() w coxph()), stratyfikacja według zmiennej naruszającej założenie, gdy nie interesuje Cię jej efekt (strata()), albo raportowanie RMST zamiast HR. Którąkolwiek wybierzesz, opisz w artykule wynik sprawdzenia założenia i swoją decyzję – to jeden z typowych zarzutów recenzentów.
Krok 6. Ryzyka konkurujące: gdy zgon wyklucza hospitalizację
28 pacjentów zmarło, zanim mogło zostać ponownie hospitalizowanych. Do tej pory traktowaliśmy ich jak osoby ucięte. Austin i in. (2016) przypominają, że ryzyko konkurujące to zdarzenie, które uniemożliwia wystąpienie zdarzenia badanego, i że dopełnienie krzywej Kaplana–Meiera (1 − KM) zawyża wtedy częstość zdarzenia badanego – niezależnie od tego, czy oba zdarzenia są od siebie niezależne. Do oszacowania częstości służy funkcja skumulowanej częstości (estymator Aalena–Johansena).
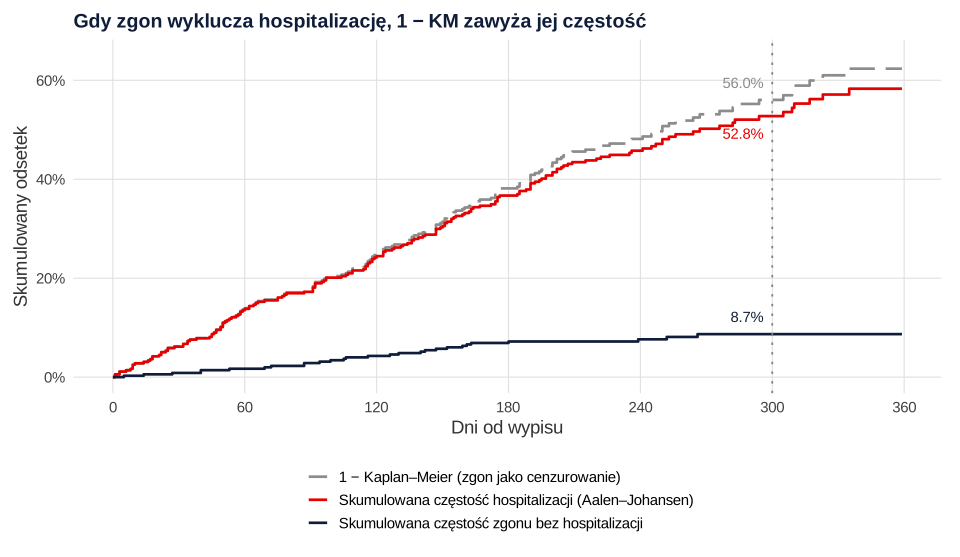
Po 300 dniach 1 − KM daje 56.0% hospitalizacji, a skumulowana częstość – 52.8%; zgonów bez hospitalizacji było 8.7%. Przy niewielkiej liczbie zgonów różnica jest umiarkowana, ale w populacjach o wysokiej śmiertelności (np. osoby bardzo stare, onkologia) może być duża.
W regresji masz do wyboru dwie rodziny modeli (Austin i in., 2016), które odpowiadają na różne pytania:
| Model | Pytanie | Wynik w przykładzie (program) |
|---|---|---|
| Cox dla hazardu przyczynowo-specyficznego (zgon = cenzurowanie) | Jak szybko dochodzi do hospitalizacji u osób, które żyją i jeszcze nie były hospitalizowane? Pytania etiologiczne. | HR = 0.74 [0.54, 1.00] (model A) |
| Fine–Gray dla podrozkładu (subdistribution hazard) | Jak program zmienia bezwzględne prawdopodobieństwo hospitalizacji w czasie? Rokowanie, planowanie opieki. | sHR = 0.74 [0.56, 0.99], p = .040 |
Model Fine’a i Graya (1999) pozwala ocenić wpływ zmiennych bezpośrednio na skumulowaną częstość. W pakiecie survival liczy się go przez finegray() i ważony coxph() (przepis 5). Dobrą praktyką jest pokazanie obu modeli oraz modelu dla zdarzenia konkurującego: tu program nie wiązał się wyraźnie z hazardem zgonu (HR = 0.79, 95% CI [0.37, 1.68]), co wyklucza najprostsze wyjaśnienie, że „mniej hospitalizacji” wynika z większej liczby zgonów. Zbliżone wartości sHR i HR w tym przykładzie wynikają z małej liczby zgonów – nie zakładaj tego w swoich danych.
Krok 7. Tabela i opis w stylu APA
W metodach opisz: moment zero, definicję zdarzenia i cenzurowania, sposób liczenia mediany obserwacji, użyte estymatory i testy, zmienne w modelu z uzasadnieniem ich wyboru, sposób sprawdzenia proporcjonalności hazardów i postępowanie przy ryzyku konkurującym. W wynikach podaj liczby zdarzeń i obserwacji uciętych w grupach, krzywe z liczbą osób w ryzyku, mediany lub odsetki w punktach czasu z 95% CI, test log-rank i HR z 95% CI. Ogólne zasady przygotowania tabel i rysunków do czasopisma opisuje poradnik tabele i rysunki do artykułu naukowego, a specyfikę publikacji klinicznych – statystyka w publikacji medycznej.
Tabela 1
Modele proporcjonalnych hazardów Coxa dla czasu do ponownej hospitalizacji po wypisie
| Predyktor | b | SE | z | p | HR | 95% CI dla HR |
|---|---|---|---|---|---|---|
| Model A: efekty stałe w czasie | ||||||
| Program telefoniczny (1 = tak) | −0.30 | 0.16 | −1.95 | .052 | 0.74 | [0.54, 1.00] |
| Wiek (o 10 lat) | 0.11 | 0.09 | 1.25 | .212 | 1.11 | [0.94, 1.32] |
| NYHA III–IV (wobec II) | 0.91 | 0.16 | 5.70 | < .001 | 2.47 | [1.81, 3.37] |
| Cukrzyca (1 = tak) | 0.13 | 0.16 | 0.84 | .403 | 1.14 | [0.84, 1.55] |
| Model B: efekt programu osobno w dwóch okresach | ||||||
| Program: dni 1–90 | −0.89 | 0.29 | −3.04 | .002 | 0.41 | [0.23, 0.73] |
| Program: po 90. dniu | −0.02 | 0.19 | −0.12 | .904 | 0.98 | [0.67, 1.42] |
| Wiek (o 10 lat) | 0.12 | 0.09 | 1.35 | .177 | 1.12 | [0.95, 1.33] |
| NYHA III–IV (wobec II) | 0.91 | 0.16 | 5.71 | < .001 | 2.48 | [1.82, 3.39] |
| Cukrzyca (1 = tak) | 0.12 | 0.16 | 0.77 | .442 | 1.13 | [0.83, 1.53] |
Uwaga. N = 360, 174 ponowne hospitalizacje (dane symulowane). Zgon przed hospitalizacją (n = 28) i koniec obserwacji traktowano jako cenzurowanie (hazard przyczynowo-specyficzny). Model A: χ2(4) = 44.25, p < .001, C = .65; test reszt Schoenfelda dla programu χ2(1) = 11.66, p < .001. Model B: różnica efektu programu między okresami z = 2.48, p = .013. HR = iloraz hazardów.
Zwróć uwagę na ostrożny język: dane są obserwacyjne, więc piszesz „wiązał się z niższym hazardem”, a nie „program zmniejszył ryzyko”, nawet po korekcie o zmienne. Jeśli przygotowujesz rozdział rozprawy albo artykuł i chcesz, żeby ktoś sprawdził definicje zdarzeń, założenia modelu lub odpowiedź na uwagi recenzenta, zajrzyj do oferty analiz statystycznych dla badaczy. Ogólniej o planowaniu analiz w pracy doktorskiej piszemy w tekście analiza statystyczna w doktoracie.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Pobierz plik analiza-przezycia-dane-przyklad.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – kolejne przepisy korzystają z obiektów dane, km i m_cox. Potrzebny jest tylko pakiet survival, dołączany do każdej instalacji R. Pakietu survminer (gotowe wykresy krzywych z tabelą osób w ryzyku) w naszym środowisku nie ma, dlatego rysunki przygotowano w ggplot2 z wyników survfit().
1. Dane, liczba zdarzeń i mediana obserwacji
R
# Analiza przeżycia: czas do ponownej hospitalizacji po wypisie z powodu niewydolności serca (dane symulowane)
options(width = 110)
library(survival)
dane <- read.csv("analiza-przezycia-dane-przyklad.csv")
dane$hosp   <- as.integer(dane$status == 1)          # zdarzenie główne; zgon i koniec obserwacji = cenzurowanie
dane$wiek10 <- dane$wiek / 10                        # wiek w dekadach

# 1. Liczba zdarzeń i obserwacji cenzurowanych
tab <- table(factor(dane$status, 0:2, c("cenzurowanie", "hospitalizacja", "zgon")))
print(rbind(n = tab, procent = round(100 * prop.table(tab), 1)))
# 2. Mediana czasu obserwacji metodą odwróconego Kaplana–Meiera (zdarzeniem jest cenzurowanie)
odwr <- survfit(Surv(czas, status == 0) ~ 1, data = dane)
print(summary(odwr)$table[c("median", "0.95LCL", "0.95UCL")])
# 3. Charakterystyka grup
grupy <- split(dane, dane$program)
print(round(sapply(grupy, function(g) c(n = nrow(g), wiek_M = mean(g$wiek), wiek_SD = sd(g$wiek),
  nyha34_proc = 100 * mean(g$nyha34), cukrzyca_proc = 100 * mean(g$cukrzyca),
  hosp_n = sum(g$hosp), zgon_n = sum(g$status == 2))), 1))
Wynik w R
        cenzurowanie hospitalizacja zgon
n              158.0          174.0 28.0
procent         43.9           48.3  7.8
 median 0.95LCL 0.95UCL
    265     252     287
                  0     1
n             195.0 165.0
wiek_M         71.7  71.1
wiek_SD         8.2   9.6
nyha34_proc    43.6  35.8
cukrzyca_proc  35.9  41.8
hosp_n        103.0  71.0
zgon_n         16.0  12.0
2. Kaplan–Meier, test log-rank i RMST
R
# Krzywe Kaplana–Meiera, mediany, przeżycie w wybranych dniach, test log-rank i RMST (kontynuacja: dane)
options(width = 110)
km <- survfit(Surv(czas, hosp) ~ program, data = dane)
print(km, rmean = 300)                                # mediany z 95% CI i średni czas do zdarzenia ograniczony do 300 dni
s <- summary(km, times = c(90, 180, 300))
print(data.frame(program = s$strata, dzien = s$time, w_ryzyku = s$n.risk, S = round(s$surv, 3),
                 dolna = round(s$lower, 3), gorna = round(s$upper, 3)))
lr <- survdiff(Surv(czas, hosp) ~ program, data = dane)
print(data.frame(N = as.vector(lr$n), obserwowane = lr$obs, oczekiwane = round(lr$exp, 1), row.names = names(lr$n)))
round(c(chi2 = lr$chisq, df = 1, p = pchisq(lr$chisq, 1, lower.tail = FALSE)), 3)
# Różnica RMST (300 dni) między grupami z 95% CI
rm <- summary(km, rmean = 300)$table[, c("rmean", "se(rmean)")]
roznica <- rm[2, 1] - rm[1, 1]; se_r <- sqrt(sum(rm[, 2]^2))
round(c(RMST_bez = rm[1, 1], RMST_program = rm[2, 1], roznica = roznica,
        dolna = roznica - 1.96 * se_r, gorna = roznica + 1.96 * se_r), 1)
Wynik w R
Call: survfit(formula = Surv(czas, hosp) ~ program, data = dane)

            n events rmean* se(rmean) median 0.95LCL 0.95UCL
program=0 195    103    192      8.06    209     159     283
program=1 165     71    227      7.24    276     241      NA
    * restricted mean with upper limit =  300
    program dzien w_ryzyku     S dolna gorna
1 program=0    90      140 0.763 0.705 0.826
2 program=0   180       92 0.554 0.486 0.631
3 program=0   300       27 0.405 0.331 0.496
4 program=1    90      138 0.900 0.854 0.948
5 program=1   180      100 0.696 0.626 0.774
6 program=1   300       24 0.481 0.394 0.586
            N obserwowane oczekiwane
program=0 195         103       86.8
program=1 165          71       87.2
 chi2    df     p
6.047 1.000 0.014
    RMST_bez RMST_program      roznica        dolna        gorna
       191.7        227.2         35.5         14.3         56.7
3. Model Coxa
R
# Model proporcjonalnych hazardów Coxa: jeden predyktor i model wielozmiennowy (kontynuacja: dane)
options(width = 110)
m_uni <- coxph(Surv(czas, hosp) ~ program, data = dane)
m_cox <- coxph(Surv(czas, hosp) ~ program + wiek10 + nyha34 + cukrzyca, data = dane)
hr_tab <- function(m) { s <- summary(m)
  data.frame(b = round(s$coefficients[, "coef"], 3), SE = round(s$coefficients[, "se(coef)"], 3),
             z = round(s$coefficients[, "z"], 2), p = round(s$coefficients[, "Pr(>|z|)"], 4),
             HR = round(s$conf.int[, "exp(coef)"], 2), dolna = round(s$conf.int[, "lower .95"], 2),
             gorna = round(s$conf.int[, "upper .95"], 2)) }
print(hr_tab(m_uni)); print(hr_tab(m_cox))
# Test ilorazu wiarygodności całego modelu, zgodność (C Harrella) i liczba zdarzeń na predyktor
s <- summary(m_cox)
round(c(LR_chi2 = unname(s$logtest["test"]), df = unname(s$logtest["df"]), p = unname(s$logtest["pvalue"]),
        C = unname(s$concordance[1]), C_SE = unname(s$concordance[2]), zdarzenia = m_cox$nevent,
        EPV = m_cox$nevent / length(coef(m_cox))), 4)
Wynik w R
       b    SE     z      p   HR dolna gorna
1 -0.378 0.154 -2.45 0.0145 0.69  0.51  0.93
              b    SE     z      p   HR dolna gorna
program  -0.303 0.156 -1.95 0.0517 0.74  0.54  1.00
wiek10    0.107 0.086  1.25 0.2122 1.11  0.94  1.32
nyha34    0.905 0.159  5.70 0.0000 2.47  1.81  3.37
cukrzyca  0.131 0.156  0.84 0.4031 1.14  0.84  1.55
  LR_chi2        df         p         C      C_SE zdarzenia       EPV
  44.2477    4.0000    0.0000    0.6531    0.0212  174.0000   43.5000
4. Proporcjonalność hazardów i efekt zależny od czasu
R
# Założenie proporcjonalnych hazardów: reszty Schoenfelda i model z efektem programu zależnym od czasu (kontynuacja)
options(width = 110)
zph <- cox.zph(m_cox)                                 # domyślnie czas przekształcony jak w estymatorze K–M
print(zph)
round(zph$table[, "p"], 3)
# Podział czasu obserwacji na dwa okresy: 1–90 dni i ponad 90 dni
dl <- survSplit(Surv(czas, hosp) ~ ., data = dane, cut = 90, episode = "okres")
m_okresy <- coxph(Surv(tstart, czas, hosp) ~ program:strata(okres) + wiek10 + nyha34 + cukrzyca, data = dl)
sk <- summary(m_okresy)
print(round(sk$conf.int[, c("exp(coef)", "lower .95", "upper .95")], 2))
print(round(sk$coefficients[, c("coef", "se(coef)", "z", "Pr(>|z|)")], 4))
# Czy efekt programu różni się między okresami? (interakcja program × okres)
m_int <- coxph(Surv(tstart, czas, hosp) ~ program * I(okres == 2) + wiek10 + nyha34 + cukrzyca, data = dl)
round(summary(m_int)$coefficients["program:I(okres == 2)TRUE", c("coef", "z", "Pr(>|z|)")], 4)
print(cox.zph(m_okresy))
# Liczba zdarzeń w okresach
table(okres = dl$okres, program = dl$program, hosp = dl$hosp)[, , "1"]
Wynik w R
          chisq df       p
program  11.660  1 0.00064
wiek10    0.704  1 0.40144
nyha34    0.866  1 0.35217
cukrzyca  0.377  1 0.53914
GLOBAL   14.265  4 0.00650
 program   wiek10   nyha34 cukrzyca   GLOBAL
   0.001    0.401    0.352    0.539    0.006
                             exp(coef) lower .95 upper .95
wiek10                            1.12      0.95      1.33
nyha34                            2.48      1.82      3.39
cukrzyca                          1.13      0.83      1.53
program:strata(okres)okres=1      0.41      0.23      0.73
program:strata(okres)okres=2      0.98      0.67      1.42
                                coef se(coef)       z Pr(>|z|)
wiek10                        0.1160   0.0859  1.3506   0.1768
nyha34                        0.9096   0.1594  5.7077   0.0000
cukrzyca                      0.1202   0.1563  0.7685   0.4422
program:strata(okres)okres=1 -0.8854   0.2915 -3.0377   0.0024
program:strata(okres)okres=2 -0.0230   0.1903 -0.1208   0.9038
    coef        z Pr(>|z|)
  0.8624   2.4834   0.0130
                      chisq df     p
wiek10                0.499  1 0.480
nyha34                1.393  1 0.238
cukrzyca              0.329  1 0.566
program:strata(okres) 5.426  2 0.066
GLOBAL                8.086  5 0.152
     program
okres  0  1
    1 45 16
    2 58 55
5. Ryzyka konkurujące: Aalen–Johansen i Fine–Gray
R
# Zgon jako ryzyko konkurujące: 1 − KM a skumulowana częstość (Aalen–Johansen) i model Fine’a–Graya (kontynuacja)
options(width = 110)
dane$zdarzenie <- factor(dane$status, 0:2, c("cenzurowanie", "hospitalizacja", "zgon"))
aj <- survfit(Surv(czas, zdarzenie) ~ 1, data = dane)          # estymator Aalena–Johansena
km1 <- survfit(Surv(czas, hosp) ~ 1, data = dane)
sa <- summary(aj, times = 300); sk <- summary(km1, times = 300)
round(100 * c(jeden_minus_KM = 1 - sk$surv, CIF_hospitalizacja = unname(sa$pstate[, which(aj$states == "hospitalizacja")]),
              CIF_zgon = unname(sa$pstate[, which(aj$states == "zgon")])), 1)
# Model Fine’a–Graya (podrozkład hazardu) dla hospitalizacji
fg <- finegray(Surv(czas, zdarzenie) ~ ., data = dane[, c("czas", "zdarzenie", "program", "wiek10", "nyha34", "cukrzyca")],
               etype = "hospitalizacja")
m_fg <- coxph(Surv(fgstart, fgstop, fgstatus) ~ program + wiek10 + nyha34 + cukrzyca, data = fg, weights = fgwt)
round(summary(m_fg)$conf.int[, c("exp(coef)", "lower .95", "upper .95")], 2)
round(summary(m_fg)$coefficients[, "Pr(>|z|)"], 3)
# Model Coxa dla przyczynowo-specyficznego hazardu zgonu
m_zgon <- coxph(Surv(czas, status == 2) ~ program + wiek10 + nyha34 + cukrzyca, data = dane)
round(summary(m_zgon)$conf.int[, c("exp(coef)", "lower .95", "upper .95")], 2)
Wynik w R
    jeden_minus_KM CIF_hospitalizacja           CIF_zgon
              56.0               52.8                8.7
         exp(coef) lower .95 upper .95
program       0.74      0.56      0.99
wiek10        1.15      0.98      1.34
nyha34        2.11      1.58      2.83
cukrzyca      1.18      0.88      1.57
 program   wiek10   nyha34 cukrzyca
   0.040    0.079    0.000    0.267
         exp(coef) lower .95 upper .95
program       0.79      0.37      1.68
wiek10        0.79      0.51      1.23
nyha34        4.05      1.83      8.98
cukrzyca      0.95      0.44      2.05
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizie przeżycia
- Niejasny moment zero i obciążenie czasem nieśmiertelności. Ekspozycja przypisana „z przyszłości” (np. leczenie rozpoczęte w trakcie obserwacji, a liczone od początku) sztucznie poprawia przeżycie grupy eksponowanej. Takie zmienne modeluj jako zmienne zależne od czasu.
- Usuwanie obserwacji uciętych albo liczenie średniego czasu tylko z osób, u których zdarzenie wystąpiło. Hasło o obserwacji cenzurowanej pokazuje na symulacji, jak bardzo zaniża to medianę.
- Mediana obserwacji policzona z wszystkich czasów zamiast metodą odwróconego Kaplana–Meiera.
- Krzywe bez liczby osób w ryzyku i interpretowanie ich prawego końca, gdy w ryzyku zostało kilka osób.
- Pominięcie sprawdzenia proporcjonalności hazardów albo raportowanie pojedynczego HR mimo przecinających się krzywych. Przy naruszeniu podaj efekty w okresach, RMST lub model z efektem zależnym od czasu.
- HR interpretowany jak ryzyko względne („o 26% mniej hospitalizacji”). HR opisuje tempo zdarzeń u osób jeszcze bez zdarzenia; obok podaj miary bezwzględne.
- 1 − KM przy ryzyku konkurującym. Zawyża częstość zdarzenia. Użyj skumulowanej częstości i jasno nazwij model regresji (przyczynowo-specyficzny czy Fine–Gray).
- Zbyt wiele predyktorów na zbyt mało zdarzeń. Licz zdarzenia, a nie osoby, i nie dobieraj zmiennych do modelu na podstawie istotności w analizach jednozmiennowych.
- Język przyczynowy w badaniu obserwacyjnym. Nawet duży model nie usuwa nieznanych zakłócaczy; dobrą praktyką jest analiza wrażliwości, np. z innym punktem podziału czasu lub innym zestawem zmiennych.
Jeśli zdarzenia rejestruje się tylko w odstępach (np. co miesiąc w ankiecie albo na kolejnych wizytach), czas jest w praktyce dyskretny. Willett i Singer (1993) pokazują, jak dyskretna analiza przeżycia odpowiada na pytania o początek, ustanie, nawrót i powrót do zdrowia – to dobra alternatywa dla modelu Coxa przy wielu jednoczesnych zdarzeniach w tym samym okresie.
Najczęstsze pytania
Jak policzyć medianę czasu obserwacji w analizie przeżycia?
Użyj metody odwróconego Kaplana–Meiera: oszacuj krzywą, w której „zdarzeniem” jest cenzurowanie, a prawdziwe zdarzenie traktujesz jako ucięcie. W R to survfit(Surv(czas, status == 0) ~ 1). Zwykła mediana czasów wszystkich osób jest zaniżona, bo u osób ze zdarzeniem obserwacja kończy się wcześniej z powodu zdarzenia, a nie z braku danych.
Co zrobić, gdy cox.zph wskazuje naruszenie proporcjonalności hazardów?
Obejrzyj wykres skalowanych reszt Schoenfelda, aby zobaczyć, jak efekt zmienia się w czasie. Najczęstsze rozwiązania to podział czasu obserwacji na merytorycznie uzasadnione okresy (survSplit()) z osobnym HR w każdym, interakcja z funkcją czasu (tt()), stratyfikacja albo raportowanie różnicy RMST. Opisz w artykule zarówno wynik testu, jak i wybrane rozwiązanie.
Czym jest RMST i kiedy podawać go zamiast ilorazu hazardów?
RMST (restricted mean survival time) to pole pod krzywą Kaplana–Meiera do wybranego punktu czasu, czyli średni czas bez zdarzenia w tym okresie. Różnica RMST między grupami nie wymaga założenia proporcjonalnych hazardów i jest łatwa do zrozumienia („średnio o 35 dni dłużej bez hospitalizacji w ciągu 300 dni”). Warto ją podawać obok HR, a zwłaszcza zamiast niego, gdy hazardy nie są proporcjonalne.
Czy zgon można traktować jako obserwację cenzurowaną?
W modelu hazardu przyczynowo-specyficznego tak, ale wtedy 1 − Kaplan–Meier zawyża częstość badanego zdarzenia, bo zakłada, że zmarli mogliby jeszcze go doświadczyć. Do szacowania częstości użyj skumulowanej częstości (estymator Aalena–Johansena), a gdy interesuje Cię wpływ zmiennych na bezwzględne prawdopodobieństwo zdarzenia – modelu Fine’a–Graya.
Ile zdarzeń potrzeba do modelu Coxa z kilkoma predyktorami?
Liczy się liczba zdarzeń, a nie osób. Klasyczna symulacja wskazuje około 10 zdarzeń na predyktor jako granicę, poniżej której współczynniki stają się obciążone, a przedziały ufności tracą pokrycie. Dla modeli predykcyjnych lepiej obliczyć minimalną liczebność z kryteriów opartych na oczekiwanym dopasowaniu modelu niż polegać na regule kciuka.
Powiązane hasła
Przeczytaj też
Statystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →PoradnikPropensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikAnaliza statystyczna w doktoracie
Seria badań z uzasadnioną liczebnością, harmonogram zgodny z IPB i oceną śródokresową, cykl publikacji bez salami slicing, dane, etyka i autorstwo.
Czytaj →Przygotowujesz analizę czasu do zdarzenia do artykułu lub rozprawy?
Sprawdzimy definicje zdarzeń i cenzurowania, założenia modelu Coxa i ryzyka konkurujące, a wyniki opiszemy tak, by spełniały oczekiwania recenzentów.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C., Lee, D. S., & Fine, J. P. (2016). Introduction to the analysis of survival data in the presence of competing risks. Circulation, 133(6), 601–609. https://doi.org/10.1161/circulationaha.115.017719 ● Otwarty dostęp: pełny tekst
- Bland, J. M., & Altman, D. G. (2004). The logrank test. BMJ, 328(7447), 1073. https://doi.org/10.1136/bmj.328.7447.1073 ● Otwarty dostęp
- Clark, T. G., Bradburn, M. J., Love, S. B., & Altman, D. G. (2003). Survival analysis part I: Basic concepts and first analyses. British Journal of Cancer, 89(2), 232–238. https://doi.org/10.1038/sj.bjc.6601118 ● Otwarty dostęp
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Fine, J. P., & Gray, R. J. (1999). A proportional hazards model for the subdistribution of a competing risk. Journal of the American Statistical Association, 94(446), 496–509. https://doi.org/10.1080/01621459.1999.10474144
- Grambsch, P. M., & Therneau, T. M. (1994). Proportional hazards tests and diagnostics based on weighted residuals. Biometrika, 81(3), 515–526. https://doi.org/10.1093/biomet/81.3.515
- Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. https://doi.org/10.1097/ede.0b013e3181c1ea43 ● Otwarty dostęp: pełny tekst
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Leung, K.-M., Elashoff, R. M., & Afifi, A. A. (1997). Censoring issues in survival analysis. Annual Review of Public Health, 18(1), 83–104. https://doi.org/10.1146/annurev.publhealth.18.1.83
- Peduzzi, P., Concato, J., Feinstein, A. R., & Holford, T. R. (1995). Importance of events per independent variable in proportional hazards regression analysis II. Accuracy and precision of regression estimates. Journal of Clinical Epidemiology, 48(12), 1503–1510. https://doi.org/10.1016/0895-4356(95)00048-8 ● Otwarty dostęp
- Riley, R. D., Snell, K. I. E., Ensor, J., Burke, D. L., Harrell, F. E., Jr., Moons, K. G. M., & Collins, G. S. (2019). Minimum sample size for developing a multivariable prediction model: PART II – Binary and time-to-event outcomes. Statistics in Medicine, 38(7), 1276–1296. https://doi.org/10.1002/sim.7992 ● Otwarty dostęp
- Royston, P., & Parmar, M. K. B. (2013). Restricted mean survival time: An alternative to the hazard ratio for the design and analysis of randomized trials with a time-to-event outcome. BMC Medical Research Methodology, 13(1), Article 152. https://doi.org/10.1186/1471-2288-13-152 ● Otwarty dostęp
- Willett, J. B., & Singer, J. D. (1993). Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence. Journal of Consulting and Clinical Psychology, 61(6), 952–965. https://doi.org/10.1037/0022-006X.61.6.952
Cytowania BibTeX
@article{austin2016introduction, author={Austin, Peter C. and Lee, Douglas S. and Fine, Jason P.}, title={{Introduction to the analysis of survival data in the presence of competing risks}}, journal={Circulation}, year={2016}, volume={133}, number={6}, pages={601--609}, doi={10.1161/circulationaha.115.017719}}@article{bland2004logrank, author={Bland, J. Martin and Altman, Douglas G.}, title={{The logrank test}}, journal={BMJ}, year={2004}, volume={328}, number={7447}, pages={1073}, doi={10.1136/bmj.328.7447.1073}}@article{clark2003survival, author={Clark, T. G. and Bradburn, M. J. and Love, S. B. and Altman, D. G.}, title={{Survival analysis part I: Basic concepts and first analyses}}, journal={British Journal of Cancer}, year={2003}, volume={89}, number={2}, pages={232--238}, doi={10.1038/sj.bjc.6601118}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{fine1999proportional, author={Fine, Jason P. and Gray, Robert J.}, title={{A proportional hazards model for the subdistribution of a competing risk}}, journal={Journal of the American Statistical Association}, year={1999}, volume={94}, number={446}, pages={496--509}, doi={10.1080/01621459.1999.10474144}}@article{grambsch1994proportional, author={Grambsch, Patricia M. and Therneau, Terry M.}, title={{Proportional hazards tests and diagnostics based on weighted residuals}}, journal={Biometrika}, year={1994}, volume={81}, number={3}, pages={515--526}, doi={10.1093/biomet/81.3.515}}@article{hernan2010hazards, author={Hernán, Miguel A.}, title={{The hazards of hazard ratios}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={13--15}, doi={10.1097/ede.0b013e3181c1ea43}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{leung1997censoring, author={Leung, Kwan-Moon and Elashoff, Robert M. and Afifi, Abdelmonem A.}, title={{Censoring issues in survival analysis}}, journal={Annual Review of Public Health}, year={1997}, volume={18}, number={1}, pages={83--104}, doi={10.1146/annurev.publhealth.18.1.83}}@article{peduzzi1995importance, author={Peduzzi, Peter and Concato, John and Feinstein, Alvan R. and Holford, Theodore R.}, title={{Importance of events per independent variable in proportional hazards regression analysis II. Accuracy and precision of regression estimates}}, journal={Journal of Clinical Epidemiology}, year={1995}, volume={48}, number={12}, pages={1503--1510}, doi={10.1016/0895-4356(95)00048-8}}@article{riley2019minimum, author={Riley, Richard D. and Snell, Kym I. E. and Ensor, Joie and Burke, Danielle L. and Harrell, Frank E., Jr. and Moons, Karel G. M. and Collins, Gary S.}, title={{Minimum sample size for developing a multivariable prediction model: PART II – Binary and time-to-event outcomes}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={7}, pages={1276--1296}, doi={10.1002/sim.7992}}@article{royston2013restricted, author={Royston, Patrick and Parmar, Mahesh K. B.}, title={{Restricted mean survival time: An alternative to the hazard ratio for the design and analysis of randomized trials with a time-to-event outcome}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={152}, doi={10.1186/1471-2288-13-152}}@article{willett1993investigating, author={Willett, John B. and Singer, Judith D.}, title={{Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence}}, journal={Journal of Consulting and Clinical Psychology}, year={1993}, volume={61}, number={6}, pages={952--965}, doi={10.1037/0022-006x.61.6.952}}