Tabele i rysunki w artykule to nie to samo co w pracy dyplomowej
W pracy magisterskiej tabel może być dwadzieścia, a promotor przeczyta każdą. W artykule masz zwykle kilka tabel i rysunków, limit słów, recenzenta, który zagląda najpierw do rysunków, i redakcję, która odeśle pliki w złym formacie, zanim ktokolwiek przeczyta tekst. Ten poradnik jest dla doktorantów i badaczy przygotowujących pierwszy (albo kolejny) manuskrypt do czasopisma. Skupiamy się na decyzjach typowych dla artykułu: co pokazać w tabeli, a co na rysunku, jak zrobić rysunek, który pokazuje dane, jak dobrać kolory czytelne dla osób z zaburzeniami widzenia barw, jak wyeksportować pliki z R i co przenieść do materiałów uzupełniających.
Wzory tabel APA dla konkretnych analiz (charakterystyka próby, test t, ANOVA, regresja, mediacja, CFA) zebraliśmy w osobnym poradniku tabele APA – wzory i przykłady. Tam też jest anatomia tabeli i przenoszenie wyników z SPSS do Worda. Tutaj do tych wzorów odsyłamy i nie powtarzamy ich.
Wszystkie liczby, tabele i rysunki na tej stronie pochodzą z jednego badania przykładowego (dane symulowane) policzonego w R. Kod jest na końcu strony. Dane w formacie CSV możesz pobrać i przećwiczyć na nich własne rysunki.
Najpierw wytyczne czasopisma, potem styl APA
Styl APA (American Psychological Association, 2020) wyznacza ogólną budowę tabeli i rysunku: numer, tytuł, treść i notę. O formacie plików, rozmiarze, czcionkach i miejscu podpisów decyduje jednak czasopismo, a jego wytyczne mają pierwszeństwo przed podręcznikiem. Przed przygotowaniem rysunków przeczytaj stronę „Instructions for authors” wybranego czasopisma (jak je wybrać, piszemy w tekście jak wybrać czasopismo i rozpoznać drapieżne).
Dla przykładu wytyczne PLOS ONE dla rysunków (PLOS ONE, b.d.; odczyt 25 października 2026 r.) wymagają m.in.:
- plików TIFF lub EPS, każdego rysunku jako osobnego pliku, a nie wklejonego do rękopisu;
- rozdzielczości co najmniej 300 ppi, szerokości 789–2250 pikseli i wysokości najwyżej 2625 pikseli przy 300 dpi;
- czcionek Arial, Times lub Symbol w rozmiarze 8–12 pt, trybu RGB lub skali szarości i kompresji LZW;
- wszystkich paneli rysunku wieloczęściowego w jednym pliku;
- podpisów w tekście rękopisu, po akapicie, w którym rysunek pojawia się po raz pierwszy, a nie w pliku rysunku.
Inne czasopisma mają inne liczby, a niektóre akceptują PDF lub pliki wektorowe. Ogólna zasada jest jednak wspólna: przygotuj rysunek od razu w docelowym rozmiarze, z czytelnym tekstem w tym rozmiarze, i zapisz go w formacie, którego wymaga redakcja. Przeliczenie wymagań PLOS ONE na centymetry (przepis 2 w kodzie) daje szerokość od 6.68 do 19.05 cm i wysokość do 22.23 cm.
Tabela czy rysunek: każda liczba w jednym miejscu
Tabela służy do pokazania dokładnych wartości, które czytelnik będzie porównywał albo przepisywał, np. do metaanalizy. Rysunek służy do pokazania wzoru: różnicy, trendu, interakcji, rozkładu. Jeśli wynik da się opisać jednym zdaniem z dwiema liczbami, nie potrzebuje ani tabeli, ani rysunku.
| Co chcesz pokazać | Najlepsza forma | Przykład |
|---|---|---|
| Jeden lub dwa wyniki | Tekst | Wynik testu t z wielkością efektu |
| Wiele dokładnych wartości | Tabela | Statystyki opisowe, współczynniki regresji, ładunki czynnikowe |
| Rozkład i różnice między grupami | Rysunek z danymi | Punkty, wykres pudełkowy lub skrzypcowy ze średnią i 95% CI |
| Zmiana w czasie, interakcja | Rysunek | Wykres interakcji, trajektorie |
| Pełne wyniki dodatkowe | Materiały uzupełniające | Macierz korelacji wszystkich pozycji, analizy wrażliwości |
Najczęstszy błąd w manuskryptach to potrójne raportowanie: te same średnie w tabeli, na rysunku i w tekście. Tekst ma prowadzić czytelnika („W obu warunkach ćwiczeń nastrój był wyższy niż w kontroli; Tabela 1”), a nie przepisywać tabelę. Jeśli rysunek pokazuje średnie z przedziałami ufności, tabela może podać tylko to, czego z rysunku nie odczytasz. Gotowe zdania do tekstu znajdziesz w poradniku jak opisać wyniki w stylu APA.
Tabele do artykułu: mniej kolumn, więcej informacji
Badanie przykładowe to eksperyment online: 120 osób losowo przydzielonych do trzech warunków (kontrola, ćwiczenie uważności, ćwiczenie wdzięczności), wynik to nastrój po zadaniu na skali 1–7. Pierwsza tabela zawiera statystyki opisowe, druga – porównania z grupą kontrolną. Obie powstały w R z tych samych obiektów, z których liczono analizę, więc nie ma ryzyka literówki przy przepisywaniu.
Tabela 1
Nastrój po zadaniu w trzech warunkach eksperymentalnych
| Warunek | n | M | SD | 95% CI | Me |
|---|---|---|---|---|---|
| Kontrola | 40 | 3.83 | 0.87 | [3.55, 4.11] | 3.80 |
| Uważność | 40 | 4.67 | 1.00 | [4.35, 4.99] | 4.63 |
| Wdzięczność | 40 | 4.97 | 1.31 | [4.55, 5.39] | 4.86 |
Uwaga. N = 120. Nastrój oceniano na skali 1–7. CI = przedział ufności dla średniej; Me = mediana. Dane symulowane.
Zwróć uwagę na trzy decyzje. Po pierwsze, liczba miejsc po przecinku wynika z precyzji pomiaru, a nie z przyzwyczajenia. Cole (2015) pokazuje, że liczby w artykułach często podaje się ze zbyt dużą precyzją, i proponuje m.in. podawanie średniej z taką liczbą miejsc po przecinku, by odchylenie standardowe miało dwie cyfry znaczące. Po drugie, przedział ufności dla średniej zastępuje kolumnę z błędem standardowym, bo czytelnik od razu widzi niepewność. Po trzecie, nota wyjaśnia skróty i skalę – tabela ma być zrozumiała bez czytania tekstu. Zasady zapisu liczb i statystyk w stylu APA (bez zera wiodącego dla p, kursywa symboli) zebrano w przewodniku APA Style (American Psychological Association, 2024).
Tabela 2
Porównanie warunków ćwiczeń z warunkiem kontrolnym
| Porównanie | Różnica | 95% CI | df | t | p | d | 95% CI dla d |
|---|---|---|---|---|---|---|---|
| Uważność − kontrola | 0.84 | [0.42, 1.26] | 76.6 | 4.02 | < .001 | 0.90 | [0.43, 1.36] |
| Wdzięczność − kontrola | 1.14 | [0.65, 1.64] | 67.7 | 4.59 | < .001 | 1.03 | [0.55, 1.49] |
Uwaga. Testy t Welcha względem warunku kontrolnego; wartości p skorygowane metodą Holma, 95% CI bez korekty. d = d Cohena liczone ze średniej wariancji obu grup. Dane symulowane.
Druga tabela łączy w jednym wierszu wszystko, czego recenzent potrzebuje do oceny porównania: różnicę z 95% CI, statystykę testu Welcha ze stopniami swobody, p po korekcie Holma i d Cohena z przedziałem. Ogólny test różnic opisujesz wtedy w tekście jednym zdaniem: ANOVA Welcha wykazała różnice między warunkami, F(2, 76.12) = 13.59, p < .001. Wybór metody korekty uzasadnij w części metodologicznej (zob. problem wielokrotnych porównań).
Obie tabele w wersji angielskiej, jako edytowalne tabele Worda z liniami tylko poziomymi, możesz pobrać jako plik Word (tabele-do-artykulu-wzor.docx). Redakcje proszą o tabele edytowalne, a nie o obrazki: tabela wklejona jako zrzut ekranu z SPSS zwykle wraca do autora.
Rysunek, który pokazuje dane, a nie tylko średnie
Przegląd 703 artykułów z czołowych czasopism fizjologicznych wykazał, że dane ciągłe przedstawiano głównie na wykresach słupkowych i liniowych, które przy bardzo różnych rozkładach mogą wyglądać identycznie (Weissgerber i in., 2015). Kilka lat później, w przeglądzie czasopism o chorobach naczyń, słupki dla danych ciągłych wciąż pojawiały się w 47.7% prac z rysunkami danych (Weissgerber i in., 2019). Rysunek 1 pokazuje, dlaczego to problem.
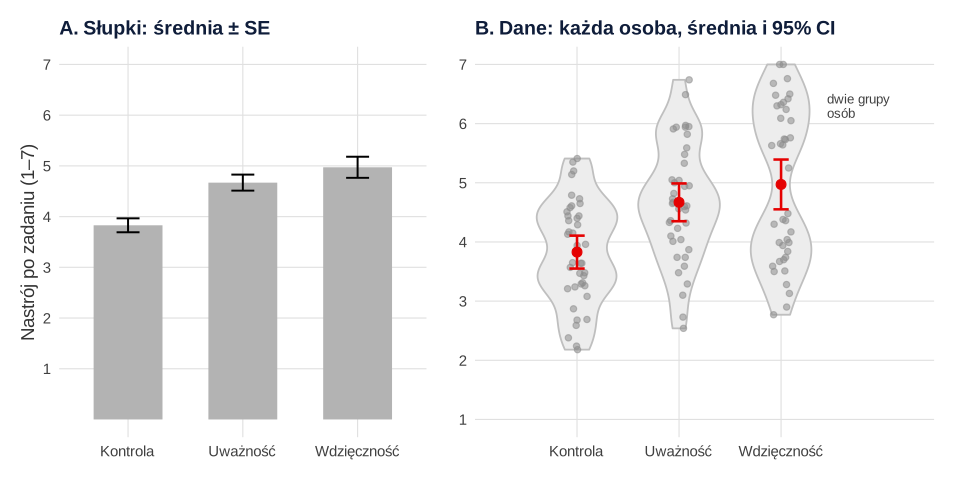
Panel A sugeruje, że ćwiczenie wdzięczności działa najlepiej i „trochę lepiej” niż uważność. Panel B mówi coś innego. W warunku wdzięczności połowa osób (50%) ma wynik co najmniej 5, a druga połowa – poniżej 4.5. Nikt nie ma wyniku bliskiego średniej 4.97. Ćwiczenie działa więc silnie u części osób, a u części wcale, i to jest najciekawszy wynik badania, którego słupek nie pokazuje. Takie obrazy zdarzają się w badaniach interwencyjnych częściej, niż sugerują tabele średnich.
Słupki mają też problem percepcyjny. Osoby oglądające słupek średniej uznają punkty wewnątrz słupka za bardziej prawdopodobne niż równie odległe punkty nad nim (Newman i Scholl, 2012). Cleveland i McGill (1984) uporządkowali zadania percepcyjne według dokładności odczytu i zalecili wykresy, w których odczytuje się położenie na wspólnej skali, np. wykresy punktowe. Wąsy ±1 błąd standardowy dodatkowo zawężają wrażenie niepewności: są mniej więcej dwa razy krótsze niż ramiona 95% przedziału ufności.
Co wybrać zamiast słupków?
- Do około 30 osób w grupie: wszystkie punkty ze średnią i 95% CI.
- Kilkadziesiąt do kilkuset: punkty z przezroczystością plus wykres pudełkowy albo skrzypcowy. Wykres pudełkowy pokazuje medianę i kwartyle, ale nie zawsze widać na nim, że rozkład ma dwa wierzchołki. W podpisie opisz, jak zbudowano pudełko i wąsy, oraz podaj liczebność (Krzywinski i Altman, 2014).
- Bardzo duże próby: wykres typu raincloud, czyli rozkład, punkty i statystyki podsumowujące w jednym rysunku (Allen i in., 2021), albo histogramy w panelach.
- Dwie zmienne ciągłe: wykres rozrzutu z linią modelu i pasmem ufności.
Wykres słupkowy zostaw dla liczebności i odsetków, gdzie długość słupka naprawdę coś znaczy. Weissgerber i in. (2019) zalecają też dopasowanie struktury rysunku do schematu badania i analizy. W praktyce oznacza to np., że gdy te same osoby mierzono dwa razy, łączysz ich punkty liniami, zamiast rysować dwa niezależne słupki.
Kolory czytelne dla osób z zaburzeniami widzenia barw
Mapy kolorów o nierównych gradientach, w tym tęczowe i czerwono-zielone, zniekształcają dane i są nieczytelne dla osób z zaburzeniami widzenia barw (Crameri i in., 2020). Problem dotyczy też zwykłych wykresów z trzema grupami. Na rysunku 2 trzy kolory z czterech palet przepuściliśmy przez symulację deuteranopii i protanopii (dwa częste typy zaburzeń widzenia czerwieni i zieleni) oraz przez konwersję do skali szarości. Pod każdą paletą jest najmniejsza odległość między jej kolorami (ΔE w przestrzeni CIELAB): im mniejsza, tym łatwiej dwa warunki pomylić.
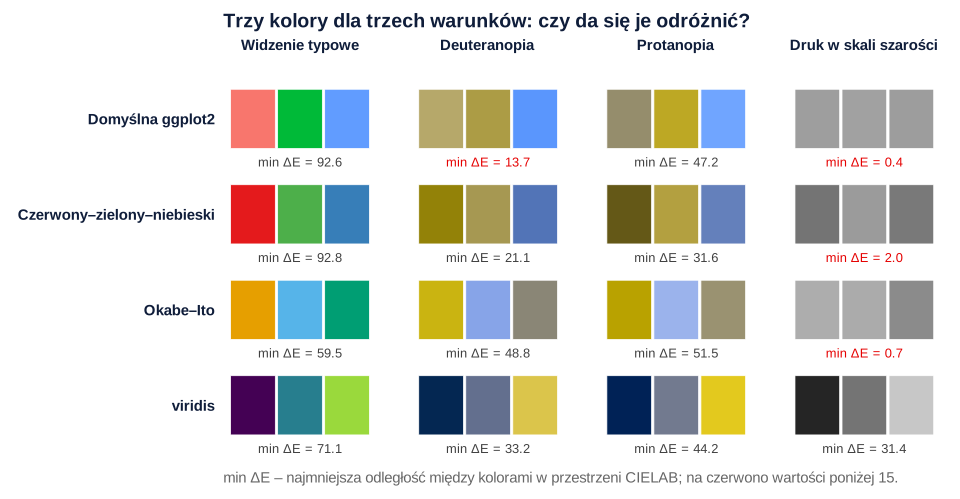
Wnioski z rysunku:
- Domyślna paleta ggplot2 przy deuteranopii traci większość kontrastu (ΔE spada z 92.6 do 13.7), a w skali szarości jej kolory są praktycznie identyczne (0.4).
- Zestaw czerwony–zielony–niebieski wypada podobnie: 21.1 przy deuteranopii i 2.0 w skali szarości.
- Paleta Okabe–Ito dobrze znosi zaburzenia widzenia barw (48.8 i 51.5), ale w druku czarno-białym jej kolory się zlewają (0.7).
- viridis zachowuje odstęp między kolorami we wszystkich czterech wariantach (co najmniej 31.4), bo zmienia się w niej jasność.
Praktyczna zasada: nie koduj grup samym kolorem. Dodaj kształt punktu, rodzaj linii albo podpis bezpośrednio przy danych i sprawdź rysunek w symulacji (w R służą do tego funkcje deutan(), protan() i desaturate() z pakietu colorspace). Przy trzech grupach często wystarczy szary, czarny i jeden kolor akcentu, a przy pomiarach przed i po – jeden kolor i dwa kształty.
Eksport z R: rozmiar, rozdzielczość, czcionki
Najwięcej poprawek technicznych bierze się z tego, że rysunek zrobiono „na ekran”, a potem zmniejszono lub powiększono. Rysunek o szerokości 12 cm zapisany przy 96 dpi ma 454 piksele szerokości. Ten sam rysunek przy 300 dpi ma 1417 pikseli – i tylko ta wersja będzie ostra w druku. Kolejność pracy jest prosta:
- Ustal docelowy rozmiar z wytycznych czasopisma (szerokość jednej lub dwóch kolumn).
- Ustaw w motywie rozmiar czcionki dla tego rozmiaru (np.
base_size = 9wtheme_classic()), a nie powiększaj tekstu „na oko”. - Zapisz rysunek funkcją
ggsave()z tymi samymiwidth,heightiunits = "cm". - Wybierz format: wektor (PDF, EPS, SVG) dla wykresów, raster (TIFF, PNG) przy 300 dpi lub więcej, gdy czasopismo wymaga rastra albo rysunek zawiera zdjęcie.
- Otwórz zapisany plik i sprawdź wymiary w pikselach, czcionki i znaki diakrytyczne.
W przepisie 2 rysunek 12 × 8 cm zapisany jako TIFF z kompresją LZW przy 300 dpi ma 1417 × 944 piksele i 83 KB, a jego wersje wektorowe – 15 KB (PDF) i 22 KB (SVG). Dwie pułapki zdarzają się w R szczególnie często. Domyślne urządzenie pdf() nie radzi sobie z polskimi literami i półpauzą: przy zapisie polskiej wersji rysunku R zgłosił 7 ostrzeżeń o nieudanej konwersji znaków (m.in. „ż” i „ś”). Urządzenie cairo_pdf rozwiązuje ten problem, a TIFF i PNG zapisuj urządzeniami z pakietu ragg. Druga pułapka: rysunek wieloczęściowy złożony z osobnych plików w edytorze grafiki łatwo przeskalować nierówno. Składaj panele w R (np. pakietem patchwork) i zapisuj jako jeden plik, tak jak rysunek 1 na tej stronie.
Rysunek wieloczęściowy
Panele oznacz wielkimi literami (A, B, C) w tym samym miejscu każdego panelu i odwołuj się do nich w podpisie i w tekście („Rysunek 1B”). Gdy panele pokazują tę samą zmienną, użyj wspólnej skali osi Y, bo inaczej czytelnik porówna wysokości, które nie są porównywalne. Na rysunku 1 oba panele mają skalę nastroju od 1 do 7, więc różnica między słupkiem a rozkładem jest widoczna od razu. Legendę umieść raz, dla całego rysunku, a jeśli grupy da się podpisać bezpośrednio przy danych, zrezygnuj z legendy. Kolejność paneli powinna odpowiadać kolejności, w jakiej omawiasz wyniki w tekście, a liczba paneli – temu, co naprawdę porównujesz. Sześć paneli z osobnymi testami dla każdej podgrupy to zwykle sygnał, że lepszy byłby jeden model z interakcją i jeden rysunek jego przewidywań.
Nie poprawiaj rysunku w programie graficznym w sposób, który zmienia dane. Wytyczne PLOS ONE (b.d.) wprost zabraniają modyfikacji obrazów, które mogą wpłynąć na przedstawioną informację naukową. Zmiana kolorów czy czcionek jest w porządku, ale usuwanie punktów czy „wygładzanie” linii już nie.
Podpis rysunku: co musi się w nim znaleźć
Podpis ma pozwolić zrozumieć rysunek bez czytania tekstu. W stylu APA nad rysunkiem jest numer i tytuł, a pod nim nota (American Psychological Association, 2020); wiele czasopism ma jednak własny układ, a PLOS ONE prosi o podpisy w rękopisie, a nie w pliku rysunku. Niezależnie od układu podpis powinien mówić:
- co jest na osiach i w jakich jednostkach (skala 1–7, punkty, milisekundy);
- co oznaczają punkty, linie, pudełka i wąsy – „95% CI” albo „±1 SE”, nigdy „błąd”;
- ile obserwacji jest w każdej grupie i czy punkty to osoby, czy średnie z klas;
- skróty i symbole użyte na rysunku;
- skąd pochodzą dane, jeśli nie z badania własnego.
Wiele platform prosi też o tekst alternatywny dla osób korzystających z czytników ekranu. Napisz w nim, co rysunek pokazuje i jaki jest główny wniosek, a nie tylko „wykres słupkowy”.
Materiały uzupełniające: co przenieść poza tekst
Materiały uzupełniające pozwalają zachować w artykule tylko to, co niesie główny argument, i nie stracić niczego, czego potrzebuje recenzent lub osoba replikująca badanie. Do materiałów przenieś zwykle:
- pełne macierze korelacji, tabele dla wszystkich pozycji kwestionariusza, statystyki opisowe w podgrupach;
- wyniki analiz wrażliwości i modeli alternatywnych, o których piszesz w tekście jednym zdaniem;
- dodatkowe rysunki diagnostyczne (reszty, wykresy Q-Q), schematy procedury, zrzuty ekranu bodźców;
- pełne brzmienie instrukcji i materiałów eksperymentalnych, o ile prawa autorskie na to pozwalają.
Numeruj je osobno, np. Tabela S1, Rysunek S1, i odwołuj się do nich w tekście tak samo jak do tabel głównych: „Wyniki bez wykluczeń przedstawiono w Tabeli S2”. Dane i kod lepiej umieścić w repozytorium z trwałym identyfikatorem niż w pliku materiałów uzupełniających wydawcy. Opisujemy to w poradniku o pakiecie replikacyjnym i w haśle otwarte dane. W artykułach medycznych część tabel ma ustalony układ (np. Tabela 1 z charakterystyką pacjentów) – zob. statystyka w publikacji medycznej.
Spójność liczb: tekst, tabele i rysunki z jednego źródła
Niespójne liczby to jeden z zarzutów, które recenzenci zgłaszają najczęściej (zob. zarzuty recenzentów do statystyki). Średnia w tabeli różni się od średniej w tekście, bo jedną policzono przed wykluczeniami, a drugą po nich; N w podpisie rysunku nie zgadza się z N w tabeli. Najpewniejszy sposób to generowanie tabel, rysunków i liczb do tekstu z tych samych obiektów w jednym skrypcie, tak jak w przepisie 1 poniżej. Gdy zmienisz regułę wykluczeń, wszystkie liczby zmienią się razem.
Przed wysłaniem manuskryptu zrób jeszcze ręczną kontrolę: N w każdej tabeli i podpisie, stopnie swobody zgodne z liczebnością, zaokrąglenia zgodne w tekście i tabelach. Szerszą listę kontrolną raportowania statystyki według APA znajdziesz w tekście wytyczne APA i JARS-Quant. Jeśli chcesz, żeby ktoś niezależny sprawdził tabele, rysunki i ich zgodność z analizą przed wysłaniem artykułu, zajrzyj do oferty dla badaczy.
Tabele i rysunki w R: od danych do plików dla redakcji
Kod odtwarza wszystkie liczby, tabele i rysunki z tej strony. Uruchom przepisy po kolei w jednej sesji R, bo przepis 2 korzysta z danych z przepisu 1. Przepis 1 zapisuje też plik CSV z danymi i plik Word z obiema tabelami, które możesz pobrać powyżej.
1. Dane, statystyki opisowe, porównania i tabele do Worda (Tabele 1–2, rysunek 1)
R
# B76 – przepis 1: dane przykładowe, liczby do tabel i tabele do Worda prosto z R
# Wpis: /blog/tabele-i-rysunki-do-artykulu-naukowego/ (Tabele 1–2 i rysunek 1)
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript uruchom.R
# Badanie przykładowe (dane symulowane, set.seed(7601)): eksperyment online z trzema warunkami
# (kontrola, ćwiczenie uważności, ćwiczenie wdzięczności), wynik: nastrój po zadaniu (skala 1–7).
# W warunku wdzięczności część osób reaguje silnie, a część wcale – rozkład jest dwuwierzchołkowy.
suppressPackageStartupMessages(library(effectsize))
set.seed(7601)
n <- 40
kontrola <- rnorm(n, 4.1, 1.0)
uwaznosc <- rnorm(n, 4.7, 1.0)
reaguje  <- rbinom(n, 1, .5)
wdziecznosc <- ifelse(reaguje == 1, rnorm(n, 6.1, 0.45), rnorm(n, 3.8, 0.45))
dane <- data.frame(id = 1:(3 * n),
                   warunek = factor(rep(c("Kontrola", "Uważność", "Wdzięczność"), each = n),
                                    levels = c("Kontrola", "Uważność", "Wdzięczność")),
                   nastroj = round(pmin(7, pmax(1, c(kontrola, uwaznosc, wdziecznosc))), 2))
write.csv(dane, "../tabele-rysunki-artykul-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Tabela 1: statystyki opisowe – jedno źródło liczb dla tekstu, tabeli i rysunku
opis <- do.call(rbind, lapply(split(dane$nastroj, dane$warunek), function(x) {
  h <- qt(.975, length(x) - 1) * sd(x) / sqrt(length(x))
  data.frame(n = length(x), M = mean(x), SD = sd(x), CI_dolna = mean(x) - h, CI_gorna = mean(x) + h,
             Me = median(x), Min = min(x), Max = max(x))
}))
print(round(opis, 2))

# Analiza: ANOVA Welcha (nierówne wariancje) i kontrasty względem kontroli
oneway.test(nastroj ~ warunek, data = dane)
round(tapply(dane$nastroj, dane$warunek, var), 2)
# Kontrasty względem kontroli: testy Welcha, p skorygowane metodą Holma, 95% CI bez korekty
welch <- lapply(c("Uważność", "Wdzięczność"), function(w)
  t.test(dane$nastroj[dane$warunek == w], dane$nastroj[dane$warunek == "Kontrola"]))
kontr <- data.frame(kontrast = c("Uważność − Kontrola", "Wdzięczność − Kontrola"),
                    estimate = sapply(welch, function(x) unname(diff(rev(x$estimate)))),
                    lower.CL = sapply(welch, function(x) x$conf.int[1]), upper.CL = sapply(welch, function(x) x$conf.int[2]),
                    df = sapply(welch, function(x) unname(x$parameter)), t.ratio = sapply(welch, function(x) unname(x$statistic)),
                    p = sapply(welch, function(x) x$p.value))
kontr$p.value <- p.adjust(kontr$p, method = "holm")
print(kontr, digits = 3, row.names = FALSE)
d_u <- cohens_d(nastroj ~ warunek, data = droplevels(subset(dane, warunek != "Wdzięczność")), pooled_sd = FALSE)
d_w <- cohens_d(nastroj ~ warunek, data = droplevels(subset(dane, warunek != "Uważność")), pooled_sd = FALSE)
round(rbind(uwaznosc = unlist(as.data.frame(d_u)[c(1, 3, 4)]), wdziecznosc = unlist(as.data.frame(d_w)[c(1, 3, 4)])), 2)
# Uwaga: cohens_d liczy Kontrola − warunek, stąd znak ujemny.

# Co ukrywa średnia: odsetek osób z wynikiem ≥ 5 i < 4.5 w każdym warunku
round(100 * sapply(split(dane$nastroj, dane$warunek), function(x) c(co_najmniej_5 = mean(x >= 5), ponizej_4.5 = mean(x < 4.5))), 1)

# Tabele do Worda (flextable) – liczby wstawiane z obiektów, bez przepisywania ręcznego
suppressPackageStartupMessages({ library(officer); library(flextable) })
f2 <- function(x) formatC(round(x, 2), format = "f", digits = 2)
pz <- function(p) ifelse(p < .001, "< .001", sub("^0", "", formatC(p, format = "f", digits = 3)))
t1 <- data.frame(Warunek = rownames(opis), n = opis$n, M = f2(opis$M), SD = f2(opis$SD),
                 `95% CI` = paste0("[", f2(opis$CI_dolna), ", ", f2(opis$CI_gorna), "]"), Me = f2(opis$Me), check.names = FALSE)
dd <- rbind(as.data.frame(d_u)[1, c(1, 3, 4)], as.data.frame(d_w)[1, c(1, 3, 4)])
t2 <- data.frame(Kontrast = c("Uważność − Kontrola", "Wdzięczność − Kontrola"), `Różnica` = f2(kontr$estimate),
                 `95% CI` = paste0("[", f2(kontr$lower.CL), ", ", f2(kontr$upper.CL), "]"),
                 df = formatC(kontr$df, format = "f", digits = 1), t = f2(kontr$t.ratio), p = pz(kontr$p.value),
                 d = f2(-dd[, 1]), `95% CI d` = paste0("[", f2(-dd[, 3]), ", ", f2(-dd[, 2]), "]"), check.names = FALSE)
print(t1, row.names = FALSE); print(t2, row.names = FALSE)

apa_ft <- function(d) {
  ft <- flextable(d); ft <- font(ft, fontname = "Times New Roman", part = "all"); ft <- fontsize(ft, size = 11, part = "all")
  ft <- border_remove(ft); ft <- hline_top(ft, border = fp_border(width = 1.5), part = "header")
  ft <- hline_bottom(ft, border = fp_border(width = 1), part = "header"); ft <- hline_bottom(ft, border = fp_border(width = 1.5), part = "body")
  ft <- align(ft, j = -1, align = "center", part = "all"); autofit(ft)
}
tyt <- function(doc, nr, tytul) {
  doc <- body_add_fpar(doc, fpar(ftext(nr, fp_text(bold = TRUE, font.family = "Times New Roman", font.size = 12))))
  body_add_fpar(doc, fpar(ftext(tytul, fp_text(italic = TRUE, font.family = "Times New Roman", font.size = 12))))
}
uwaga <- function(doc, t) body_add_fpar(doc, fpar(ftext("Note. ", fp_text(italic = TRUE, font.family = "Times New Roman", font.size = 10)),
                                                ftext(t, fp_text(font.family = "Times New Roman", font.size = 10))))
doc <- read_docx()
doc <- set_doc_properties(doc, title = "Tabele do artykułu – wzór z R", creator = "Metodolog.pl",
                          created = as.POSIXct("2026-10-26 09:00:00", tz = "UTC"))
doc <- tyt(doc, "Table 1", "Mood After the Task by Condition")
doc <- body_add_flextable(doc, apa_ft(t1))
doc <- uwaga(doc, "N = 120. Mood rated on a 1–7 scale. CI = confidence interval for the mean. Simulated data.")
doc <- body_add_par(doc, "")
doc <- tyt(doc, "Table 2", "Comparisons of Each Exercise Condition With the Control Condition")
doc <- body_add_flextable(doc, apa_ft(t2))
doc <- uwaga(doc, "Welch t tests against the control condition; p values adjusted with the Holm method, 95% CIs unadjusted. d = Cohen's d based on the average of the two group variances. Simulated data.")
PLIK <- "../tabele-do-artykulu-wzor.docx"
print(doc, target = PLIK)
# officer wpisuje do lastModifiedBy nazwę użytkownika komputera – zamieniamy ją na „Metodolog.pl”
tmp <- file.path(tempdir(), "docx-b76"); unlink(tmp, recursive = TRUE); unzip(PLIK, exdir = tmp)
core <- file.path(tmp, "docProps", "core.xml")
xml <- readLines(core, warn = FALSE, encoding = "UTF-8")
writeLines(gsub("<cp:lastModifiedBy>[^<]*</cp:lastModifiedBy>", "<cp:lastModifiedBy>Metodolog.pl</cp:lastModifiedBy>", xml), core, useBytes = TRUE)
docx <- normalizePath(PLIK); invisible(file.remove(docx))
stary <- setwd(tmp); utils::zip(docx, files = c("[Content_Types].xml", setdiff(list.files(".", recursive = TRUE, all.files = TRUE), "[Content_Types].xml")), flags = "-r9Xq"); setwd(stary)
chk <- read_docx(PLIK)
print(doc_properties(chk)[doc_properties(chk)$tag %in% c("title", "creator", "lastModifiedBy"), c("tag", "value")], row.names = FALSE)
length(docx_summary(chk)$text)
Wynik w R
             n    M   SD CI_dolna CI_gorna   Me  Min  Max
Kontrola    40 3.83 0.87     3.55     4.11 3.80 2.18 5.41
Uważność    40 4.67 1.00     4.35     4.99 4.63 2.54 6.74
Wdzięczność 40 4.97 1.31     4.55     5.39 4.86 2.77 7.00

	One-way analysis of means (not assuming equal variances)

data:  nastroj and warunek
F = 13.586, num df = 2.000, denom df = 76.121, p-value = 9.002e-06

   Kontrola    Uważność Wdzięczność
       0.76        1.00        1.73
               kontrast estimate lower.CL upper.CL   df t.ratio        p  p.value
    Uważność − Kontrola    0.841    0.424     1.26 76.6    4.02 0.000137 1.37e-04
 Wdzięczność − Kontrola    1.143    0.646     1.64 67.7    4.59 0.000020 4.01e-05
            Cohens_d CI_low CI_high
uwaznosc       -0.90  -1.36   -0.43
wdziecznosc    -1.03  -1.49   -0.55
              Kontrola Uważność Wdzięczność
co_najmniej_5       10       35          50
ponizej_4.5         75       40          50
     Warunek  n    M   SD       95% CI   Me
    Kontrola 40 3.83 0.87 [3.55, 4.11] 3.80
    Uważność 40 4.67 1.00 [4.35, 4.99] 4.63
 Wdzięczność 40 4.97 1.31 [4.55, 5.39] 4.86
               Kontrast Różnica       95% CI   df    t      p    d     95% CI d
    Uważność − Kontrola    0.84 [0.42, 1.26] 76.6 4.02 < .001 0.90 [0.43, 1.36]
 Wdzięczność − Kontrola    1.14 [0.65, 1.64] 67.7 4.59 < .001 1.03 [0.55, 1.49]
            tag                         value
          title Tabele do artykułu – wzór z R
        creator                  Metodolog.pl
 lastModifiedBy                  Metodolog.pl
[1] 55
2. Kolory w symulacji zaburzeń widzenia barw i eksport plików (rysunek 2)
R
# B76 – przepis 2: kolory czytelne dla osób z zaburzeniami widzenia barw i eksport rysunku dla czasopisma
# Wpis: /blog/tabele-i-rysunki-do-artykulu-naukowego/ (sekcje „Kolory” i „Eksport” oraz rysunek 2)
# Uruchomienie z folderu kod/ po przepisie 1 (obiekt dane): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript uruchom.R
suppressPackageStartupMessages({ library(colorspace); library(ggplot2) })

# 1. Trzy palety dla trzech warunków
palety <- list(
  domyslna_ggplot2 = scales::hue_pal()(3),
  czerwony_zielony_niebieski = c("#E41A1C", "#4DAF4A", "#377EB8"),
  okabe_ito = c("#E69F00", "#56B4E9", "#009E73"),
  viridis = viridisLite::viridis(3, end = .85))
# Najmniejsza odległość między kolorami palety (ΔE w przestrzeni CIELAB; im mniej, tym łatwiej je pomylić)
min_dE <- function(kol) {
  lab <- convertColor(t(col2rgb(kol)) / 255, from = "sRGB", to = "Lab")
  min(dist(lab))
}
wzrok <- list(typowe = identity, deuteranopia = function(k) deutan(k, 1), protanopia = function(k) protan(k, 1),
              skala_szarosci = function(k) desaturate(k, 1))
tab <- sapply(palety, function(p) sapply(wzrok, function(f) min_dE(f(p))))
print(round(t(tab), 1))
lapply(palety, function(p) deutan(p, 1))                        # jak widzi te kolory osoba z deuteranopią

# 2. Wymiary rysunku w granicach podanych przez PLOS ONE (szerokość 789–2250 px i wysokość ≤ 2625 px przy 300 dpi)
cm <- function(px, dpi = 300) px / dpi * 2.54
round(c(szer_min_cm = cm(789), szer_max_cm = cm(2250), wys_max_cm = cm(2625)), 2)

# 3. Eksport: TIFF 300 dpi z kompresją LZW (raster) i PDF/SVG (wektor) w docelowym rozmiarze, tekst 9 pt
dane_en <- transform(dane, warunek = factor(warunek, labels = c("Control", "Mindfulness", "Gratitude")))  # artykuł po angielsku
rys <- ggplot(dane_en, aes(warunek, nastroj, colour = warunek)) +
  geom_point(position = position_jitter(width = 0.12, height = 0, seed = 7603), alpha = 0.6, size = 1.2) +
  stat_summary(fun.data = mean_cl_normal, colour = "black", size = 0.4, linewidth = 0.6) +
  scale_colour_manual(values = palety$okabe_ito, guide = "none") +
  labs(x = NULL, y = "Mood after the task (1–7)") +
  theme_classic(base_size = 9, base_family = "sans")
katalog <- file.path(tempdir(), "eksport-b76"); dir.create(katalog, showWarnings = FALSE)
pliki <- file.path(katalog, c("Fig1.tif", "Fig1.pdf", "Fig1.svg"))
ggsave(pliki[1], rys, device = ragg::agg_tiff, width = 12, height = 8, units = "cm", dpi = 300, compression = "lzw")
ggsave(pliki[2], rys, device = cairo_pdf, width = 12, height = 8, units = "cm")   # cairo_pdf osadza czcionki i znaki spoza ASCII
ggsave(pliki[3], rys, width = 12, height = 8, units = "cm")
info <- magick::image_info(magick::image_read(pliki[1]))
c(szerokosc_px = info$width, wysokosc_px = info$height, gestosc = info$density)
round(file.size(pliki) / 1024)                                  # KB: TIFF, PDF, SVG
# Pułapka: domyślne urządzenie pdf() nie obsługuje polskich liter – zapisz polską wersję i zbierz ostrzeżenia
ostrz <- character()
withCallingHandlers(ggsave(file.path(katalog, "Rys1-pdf.pdf"), rys + labs(x = "Warunek (uważność, wdzięczność)"), device = pdf,
                           width = 12, height = 8, units = "cm"),
                    warning = function(w) { ostrz <<- c(ostrz, conditionMessage(w)); invokeRestart("muffleWarning") })
length(ostrz)
head(ostrz, 2)
# Ten sam rysunek zapisany „na ekran” (96 dpi) i powiększony do 12 cm w druku traci ostrość:
round(c(px_przy_96dpi = 12 / 2.54 * 96, px_przy_300dpi = 12 / 2.54 * 300))
Wynik w R
                           typowe deuteranopia protanopia skala_szarosci
domyslna_ggplot2             92.6         13.7       47.2            0.4
czerwony_zielony_niebieski   92.8         21.1       31.6            2.0
okabe_ito                    59.5         48.8       51.5            0.7
viridis                      71.1         33.2       44.2           31.4
$domyslna_ggplot2
[1] "#B6A86A" "#AC9C45" "#5A96FD"

$czerwony_zielony_niebieski
[1] "#938208" "#A69852" "#5274B7"

$okabe_ito
[1] "#CAB411" "#87A4E8" "#8A8676"

$viridis
[1] "#042752FF" "#636F8EFF" "#DBC54BFF"

szer_min_cm szer_max_cm  wys_max_cm
       6.68       19.05       22.23
szerokosc_px  wysokosc_px      gestosc
      "1417"        "944"    "300x300"
[1] 83 15 22
[1] 7
[1] "conversion failure on 'Warunek (uważność, wdzięczność)' in 'mbcsToSbcs': for ż (U+017C)"
[2] "conversion failure on 'Warunek (uważność, wdzięczność)' in 'mbcsToSbcs': for ś (U+015B)"
 px_przy_96dpi px_przy_300dpi
           454           1417
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje oneway.test(), t.test() i p.adjust() z pakietu stats); rysunki przygotowano w ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents (R package version 0.7.4) [Computer software]. https://doi.org/10.32614/CRAN.package.officer
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting (R package version 0.9.11) [Computer software]. https://doi.org/10.32614/CRAN.package.flextable
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization (R package version 1.4.0) [Computer software]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- ragg (wersja 1.5.2): Pedersen, T. L., & Shemanarev, M. (2026). ragg: Graphic devices based on AGG (R package version 1.5.2) [Computer software]. https://doi.org/10.32614/CRAN.package.ragg
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R (R package version 2.9.1) [Computer software]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze błędy w tabelach i rysunkach do artykułu
- Słupki średnich dla danych ciągłych. Ukrywają rozkład, liczebność i obserwacje odstające; pokaż dane.
- Wąsy bez opisu. Czytelnik nie wie, czy to SD, SE, czy 95% CI, a każda z tych wersji prowadzi do innego wniosku.
- Kolor jako jedyny kod grup. Rysunek przestaje działać przy zaburzeniach widzenia barw i w druku czarno-białym.
- Rysunek przeskalowany po zapisaniu. Tekst jest za mały albo rozmyty; zapisuj w docelowym rozmiarze.
- Tabela jako obrazek. Redakcja potrzebuje edytowalnej tabeli, a recenzent – możliwości skopiowania liczb.
- Te same liczby trzy razy. Tabela, rysunek i tekst powtarzają średnie, a brakuje miejsca na wielkość efektu.
- Zbyt wiele miejsc po przecinku. Korelacja z czterema miejscami po przecinku przy N = 120 sugeruje precyzję, której nie ma.
- Efekty 3D i ozdobniki. Cienie, perspektywa i gradienty utrudniają odczyt wartości i niczego nie dodają.
- Materiały uzupełniające bez odwołań. Tabela S3, o której tekst nie wspomina, zwykle nie zostanie przeczytana.
Lista kontrolna przed wysłaniem manuskryptu
- Przeczytano wytyczne czasopisma dla tabel i rysunków (format, rozmiar, czcionki, miejsce podpisów).
- Każda tabela i każdy rysunek mają odwołanie w tekście, w kolejności numerów.
- Tabele są edytowalne, mają tylko linie poziome i notę wyjaśniającą skróty.
- Liczba miejsc po przecinku jest spójna i dopasowana do precyzji pomiaru.
- Rysunki pokazują dane (punkty, rozkłady), a nie tylko średnie.
- Wąsy i pasma są opisane w podpisie; podano n w grupach.
- Grupy różnią się nie tylko kolorem; rysunek sprawdzono w symulacji zaburzeń widzenia barw i w skali szarości.
- Rysunki zapisano w docelowym rozmiarze i wymaganym formacie; sprawdzono piksele, czcionki i polskie znaki.
- Panele rysunku wieloczęściowego są w jednym pliku.
- N, średnie i statystyki są zgodne w tekście, tabelach, rysunkach i abstrakcie (zob. abstrakt strukturalny i IMRAD).
- Materiały uzupełniające są ponumerowane (S1, S2…) i przywołane w tekście.
Najczęstsze pytania
Jaką rozdzielczość powinien mieć rysunek do artykułu naukowego?
Taką, jakiej wymaga czasopismo – zwykle co najmniej 300 dpi w docelowym rozmiarze druku, np. PLOS ONE wymaga co najmniej 300 ppi i szerokości 789–2250 pikseli przy 300 dpi (PLOS ONE, b.d.). Rysunek 12 cm szerokości przy 300 dpi ma 1417 pikseli, a przy 96 dpi tylko 454. Wykresy najlepiej zapisywać jako pliki wektorowe (PDF, EPS, SVG), jeśli redakcja je przyjmuje.
Czy rysunki do artykułu wstawia się do pliku z tekstem?
To zależy od czasopisma. Wiele redakcji prosi o każdy rysunek w osobnym pliku i o podpisy w tekście rękopisu – tak jest np. w PLOS ONE. Inne przyjmują na etapie recenzji jeden plik z rysunkami w tekście. Sprawdź „Instructions for authors” przed eksportem rysunków.
Jak sprawdzić, czy wykres jest czytelny dla daltonistów?
Przepuść kolory rysunku przez symulację zaburzeń widzenia barw, np. funkcjami deutan() i protan() z pakietu colorspace w R, i zobacz rysunek w skali szarości (desaturate()). Bezpieczniej jest nie kodować grup samym kolorem: dodaj kształty punktów, rodzaje linii albo podpisy przy danych.
Co umieścić w materiałach uzupełniających do artykułu?
To, czego potrzebuje recenzent lub osoba replikująca badanie, ale co nie niesie głównego argumentu: pełne macierze korelacji, tabele dla wszystkich pozycji, analizy wrażliwości, modele alternatywne, dodatkowe rysunki diagnostyczne i materiały badania. Numeruj je (Tabela S1, Rysunek S1) i przywołuj w tekście, a dane i kod umieść w repozytorium.
Czy w artykule można pokazać te same wyniki w tabeli i na rysunku?
Lepiej nie powtarzać tych samych liczb. Rysunek pokazuje wzór (różnice, rozkład, trend), tabela – dokładne wartości, których z rysunku nie odczytasz, a tekst prowadzi czytelnika do najważniejszego wniosku. Jeśli rysunek pokazuje średnie z 95% CI, w tabeli zostaw miejsce np. na wielkości efektu i statystyki testów.
Powiązane hasła
Przeczytaj też
Tabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →Przygotowujesz tabele i rysunki do artykułu?
Sprawdzimy, czy tabele i rysunki zgadzają się z analizą i wymogami czasopisma, i przygotujemy w R rysunki, które pokazują Twoje dane, a Ty zachowasz pełną kontrolę nad tekstem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., van Langen, J., & Kievit, R. A. (2021). Raincloud plots: A multi-platform tool for robust data visualization. Wellcome Open Research, 4, Article 63. https://doi.org/10.12688/wellcomeopenres.15191.2 ● Otwarty dostęp
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cole, T. J. (2015). Too many digits: The presentation of numerical data. Archives of Disease in Childhood, 100(7), 608–609. https://doi.org/10.1136/archdischild-2014-307149 ● Otwarty dostęp
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), Article 5444. https://doi.org/10.1038/s41467-020-19160-7 ● Otwarty dostęp
- Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
- Newman, G. E., & Scholl, B. J. (2012). Bar graphs depicting averages are perceptually misinterpreted: The within-the-bar bias. Psychonomic Bulletin & Review, 19(4), 601–607. https://doi.org/10.3758/s13423-012-0247-5 ● Otwarty dostęp
- PLOS ONE. (b.d.). Figures. Public Library of Science. Pobrano 26 października 2026 z https://journals.plos.org/plosone/s/figures ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
- Weissgerber, T. L., Winham, S. J., Heinzen, E. P., Milin-Lazovic, J. S., Garcia-Valencia, O., Bukumiric, Z., Savic, M. D., Garovic, V. D., & Milic, N. M. (2019). Reveal, don’t conceal: Transforming data visualization to improve transparency. Circulation, 140(18), 1506–1518. https://doi.org/10.1161/circulationaha.118.037777 ● Otwarty dostęp
Cytowania BibTeX
@article{allen2021raincloud, author={Allen, Micah and Poggiali, Davide and Whitaker, Kirstie and Marshall, Tom Rhys and van Langen, Jordy and Kievit, Rogier A.}, title={{Raincloud plots: A multi-platform tool for robust data visualization}}, journal={Wellcome Open Research}, year={2021}, volume={4}, eid={63}, doi={10.12688/wellcomeopenres.15191.2}}@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{cole2015too, author={Cole, T. J.}, title={{Too many digits: The presentation of numerical data}}, journal={Archives of Disease in Childhood}, year={2015}, volume={100}, number={7}, pages={608--609}, doi={10.1136/archdischild-2014-307149}}@article{crameri2020misuse, author={Crameri, Fabio and Shephard, Grace E. and Heron, Philip J.}, title={{The misuse of colour in science communication}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5444}, doi={10.1038/s41467-020-19160-7}}@article{krzywinski2014visualizing, author={Krzywinski, Martin and Altman, Naomi}, title={{Visualizing samples with box plots}}, journal={Nature Methods}, year={2014}, volume={11}, number={2}, pages={119--120}, doi={10.1038/nmeth.2813}}@article{newman2012bar, author={Newman, George E. and Scholl, Brian J.}, title={{Bar graphs depicting averages are perceptually misinterpreted: The within-the-bar bias}}, journal={Psychonomic Bulletin \& Review}, year={2012}, volume={19}, number={4}, pages={601--607}, doi={10.3758/s13423-012-0247-5}}@misc{plosndfigures, author={{PLOS ONE}}, title={{Figures}}, publisher={Public Library of Science}, url={https://journals.plos.org/plosone/s/figures}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}@article{weissgerber2019reveal, author={Weissgerber, Tracey L. and Winham, Stacey J. and Heinzen, Ethan P. and Milin-Lazovic, Jelena S. and Garcia-Valencia, Oscar and Bukumiric, Zoran and Savic, Marko D. and Garovic, Vesna D. and Milic, Natasa M.}, title={{Reveal, don’t conceal: Transforming data visualization to improve transparency}}, journal={Circulation}, year={2019}, volume={140}, number={18}, pages={1506--1518}, doi={10.1161/circulationaha.118.037777}}