Po co pakiet replikacyjny i kto go wymaga
Pakiet replikacyjny to zestaw plików, który pozwala innej osobie odtworzyć liczby z Twojego artykułu: dane (albo ich bezpieczny odpowiednik), książka kodowa, skrypty, opis środowiska obliczeniowego, licencja i plik README, który mówi, co z tym zrobić. Chodzi o odtwarzalność obliczeniową – te same dane i ten sam kod mają dać te same tabele. To coś innego niż replikowalność, czyli uzyskanie zgodnego wniosku w nowym badaniu, ale bez pierwszej trudno mówić o drugiej.
„Dane dostępne na prośbę” to w praktyce za mało. Gabelica i in. (2022) przeanalizowali 3556 artykułów z czasopism otwartego dostępu. Najczęstsza deklaracja (42%) brzmiała „dostępne na uzasadnioną prośbę”. Spośród 1792 autorów, którzy zadeklarowali gotowość udostępnienia danych, 1669 (93%) nie odpowiedziało albo odmówiło, a dane przekazało tylko 123 (6.8%). Nawet udostępnione pliki często nie wystarczają:
- po wprowadzeniu obowiązku otwartych danych w czasopiśmie Cognition odsetek artykułów z deklaracją dostępności danych wzrósł z 25% do 78%, ale przy próbie odtworzenia wyników 35 artykułów w 11 z 22 w pełni odtworzonych potrzebna była pomoc autorów, a w 13 części wartości nie odtworzono mimo tej pomocy (Hardwicke i in., 2018);
- w 62 registered reports z psychologii dane i kod udostępniono w 36 (58%), a główne wyniki udało się odtworzyć w 21 z tych 36 artykułów (Obels i in., 2020);
- z ponad 9000 plików R z repozytorium Harvard Dataverse 74% zakończyło się błędem przy pierwszym uruchomieniu w czystym środowisku (Trisovic i in., 2022).
Coraz częściej udostępnienie danych jest obowiązkiem, a nie gestem. PLOS od 3 marca 2014 r. wymaga, by w chwili publikacji wszystkie dane potrzebne do odtworzenia wyników były publicznie dostępne, a każdy artykuł miał deklarację dostępności danych z nazwą repozytorium i identyfikatorem (PLOS, b.d.). Narodowe Centrum Nauki od 2019 r. wymaga we wnioskach planu zarządzania danymi, który oceniają eksperci. Po zmianie zasad z 26 czerwca 2025 r. publikowanie w otwartym dostępie przestało być obowiązkowe, ale zasady udostępniania danych badawczych zostały bez zmian (Narodowe Centrum Nauki, b.d.). Wytyczne NCN mówią, że dane należy udostępnić najpóźniej w momencie publikacji wyników i przechowywać co najmniej 10 lat (Narodowe Centrum Nauki, 2020). Wspólnym mianownikiem tych wymagań są zasady FAIR: dane mają być łatwe do znalezienia, dostępne, interoperacyjne i nadające się do ponownego użycia – także przez maszyny (Wilkinson i in., 2016). To jeden z filarów open science i odpowiedź na kryzys replikacyjny w psychologii.
Co wchodzi do pakietu – lista minimalna
| Element | Po co | Format |
|---|---|---|
| README | Mówi, co jest w pakiecie, jak go uruchomić i jak go cytować | Markdown lub zwykły tekst (README.md) |
| Dane surowe (po anonimizacji) | Punkt wyjścia wszystkich analiz; nigdy nie edytowane ręcznie | CSV w UTF-8 (otwarty format) |
| Książka kodowa | Nazwy zmiennych, etykiety, wartości, kody braków, pozycje odwrócone | CSV (codebook.csv) |
| Skrypty | Każdy krok od danych surowych do liczb w artykule | R, Python albo składnia SPSS |
| Opis środowiska | Wersje programu i pakietów, ziarno generatora liczb losowych | sessionInfo.txt, renv.lock |
| Licencja | Mówi, co inni mogą zrobić z danymi i kodem | LICENCJA.md + wybór licencji w repozytorium |
| Materiały | Procedura, instrukcje, bodźce, pytania własne | PDF, Markdown |
| Powiązania | Link do prerejestracji i DOI artykułu | W README |
Wszystkie te elementy znajdziesz w szablonie do pobrania: pakiet-replikacyjny-szablon.zip (13 KB). Zawiera README, książkę kodową, dwa skrypty R, opis licencji, projekt RStudio i przykładowe dane symulowane z fikcyjnego eksperymentu: czy ćwiczenie samowspółczucia obniża lęk przed oceną. Jego plan analizy omawiamy we wpisie o planie analizy statystycznej i prerejestracji. Skrypty działają na danych z paczki – sprawdziliśmy to, rozpakowując archiwum do pustego folderu i uruchamiając je od zera (wyniki w sekcji z kodem).
Struktura folderów
Wilson i in. (2017) w zestawie „wystarczająco dobrych” praktyk obliczeniowych radzą rozdzielić dokumenty, dane, wyniki i kod do osobnych katalogów, a w katalogu głównym trzymać pliki README, LICENSE i CITATION. Dane surowe zachowaj w niezmienionej postaci – najlepiej z prawem tylko do odczytu – i z kopią zapasową. Szablon stosuje tę logikę z polskimi nazwami katalogów i dwoma numerowanymi skryptami w katalogu głównym. Dzięki temu katalog roboczy R to po prostu folder pakietu, a numer pliku mówi, co uruchomić najpierw.
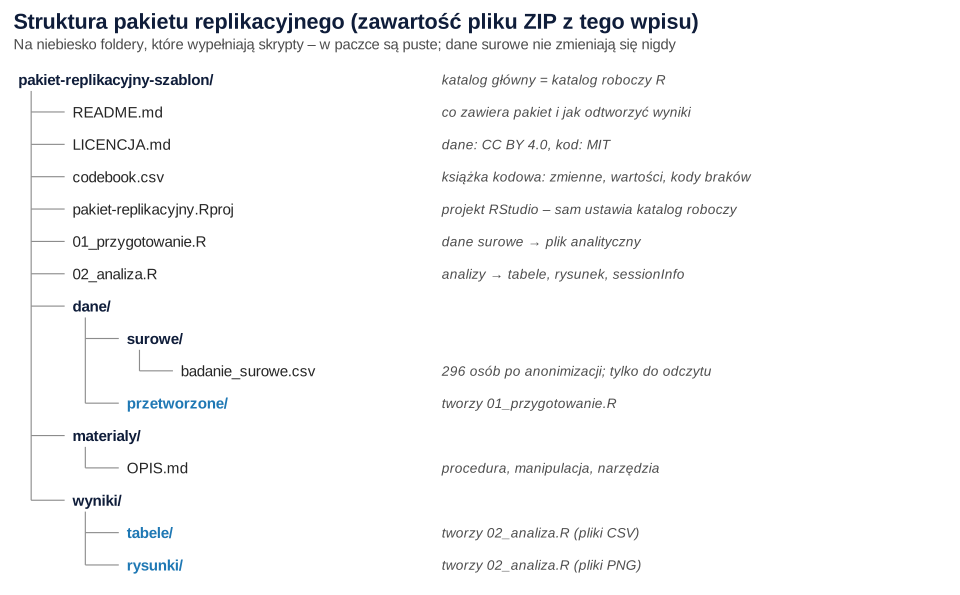
Trzy zasady, które oszczędzają najwięcej kłopotów:
- Dane surowe są nietykalne. Każdą zmianę – rekodowanie, wykluczenia, wyniki skal – robi skrypt, a jego wynik trafia do osobnego folderu.
- Wszystko, co powstaje z kodu, można usunąć. Folder
wyniki/i plik analityczny da się w każdej chwili skasować i odtworzyć jednym uruchomieniem. - Jedna wersja prawdy. Liczby w artykule pochodzą z plików w
wyniki/, a nie z ręcznie poprawianych tabel w edytorze tekstu.
README – wzór
README to pierwszy plik, który ktoś otworzy, więc ma odpowiedzieć na trzy pytania: co to jest, jak to uruchomić i jak to cytować. Wilson i in. (2017) wymieniają minimum: tytuł, krótki opis, aktualny kontakt i przykład, jak uruchomić analizy. Wytyczne NCN do planu zarządzania danymi wskazują pliki README i książkę kodową jako miejsca, w których utrwala się metadane – definicje zmiennych, jednostki, konwencje nazw, wersje i strukturę folderów (Narodowe Centrum Nauki, 2020). Poniżej skrócona wersja README z szablonu.
Autorzy: [imię i nazwisko, ORCID] · Kontakt: [instytucjonalny adres e-mail]
Artykuł: [odwołanie APA z DOI] · Prerejestracja: [DOI rejestracji] · Repozytorium: [DOI projektu OSF]
Wersja pakietu: 1.0 ([RRRR-MM-DD])
## Jak odtworzyć wyniki
1. Zainstaluj R w wersji 4.1 lub nowszej (skrypty używają tylko pakietów wbudowanych w R).
2. Rozpakuj archiwum i otwórz pakiet-replikacyjny.Rproj albo ustaw katalog roboczy na folder pakietu.
3. Uruchom kolejno: Rscript 01_przygotowanie.R, a potem Rscript 02_analiza.R.
4. Porównaj pliki w wyniki/tabele/ z tabelami w artykule (Tabela 1: statystyki opisowe, Tabela 2: test H1).
Kontrola: w analizie są 262 osoby, a wiersz „warunek” w tabeli 2 ma b = −0.277, 95% CI [−0.462, −0.092].
## Dane
dane/surowe/badanie_surowe.csv – [N] osób, jeden wiersz to jedna osoba, UTF-8, braki zapisane jako −99. Opis zmiennych: codebook.csv. Przed publikacją usunięto: [np. adresy IP, daty wypełnienia, dokładny wiek].
## Środowisko
Wyniki uzyskano w [R 4.5.3]; szczegóły: wyniki/sessionInfo.txt. Ziarno bootstrapu: set.seed(20261016).
## Licencja
Dane: CC BY 4.0. Kod: MIT. Szczegóły: LICENCJA.md.
## Jak cytować
[Autor, A. A. (RRRR). Tytuł pakietu [Zbiór danych i kod]. OSF. https://doi.org/...]
Wartości kontrolne w README to prosty trik: osoba odtwarzająca wyniki od razu widzi, czy dostała te same liczby, zanim zacznie porównywać całe tabele.
Książka kodowa: codebook.csv
Książka kodowa opisuje każdą zmienną w pliku danych. W szablonie ma kolumny: nazwa zmiennej, plik, w którym występuje, etykieta, typ, dozwolone wartości, kod braków i uwagi. Zapisanie jej jako CSV, a nie tylko jako tabeli w Wordzie, ma praktyczną zaletę: skrypt może ją wczytać i sprawdzić, czy dane się z nią zgadzają. W szablonie 01_przygotowanie.R zatrzymuje się błędem, jeśli w pliku danych jest zmienna nieopisana w książce kodowej albo odpowiedź spoza zakresu 1–5.
| zmienna | etykieta | wartości | braki | uwagi |
|---|---|---|---|---|
warunek | Warunek eksperymentalny | 0 = ćwiczenie kontrolne; 1 = ćwiczenie samowspółczucia | brak | Przydział losowy 1:1 |
wiek_kat | Wiek w przedziałach | 18-20; 21-23; 24-26; 27+ | −99 | Dokładny wiek usunięto (anonimizacja) |
lek_po_2 | Lęk po zadaniu – pozycja 2 | 1–5 | −99 | Pozycja odwrócona: 6 − odpowiedź |
lek_po | Lęk po zadaniu – wynik skali | 1–5 (średnia 6 pozycji) | brak | Tworzy 01_przygotowanie.R; co najmniej 5 odpowiedzi |
Zasady kodowania – jeden wiersz to jedna osoba, spójne kody braków danych, pozycje odwrócone opisane wprost – omawiamy szczegółowo w poradniku jak przygotować bazę danych do analizy, a eksport z formularzy online w tekście dane z Google Forms i LimeSurvey. Dla pakietu ważne jest jedno: każda zmienna wyliczona w skrypcie też powinna mieć wiersz w książce kodowej, z informacją, który skrypt ją tworzy i jak (rekodowanie, średnia, próg).
Skrypty, które działają od zera
Skrypt, który działa tylko na Twoim komputerze, nie jest częścią pakietu replikacyjnego. Trisovic i in. (2022) zauważają, że wielu błędów w udostępnionym kodzie R można uniknąć dzięki dobrym praktykom programistycznym. Oto te, które mają największe znaczenie:
- Ścieżki względne. Żadnego
setwd("C:/Users/..."). Skrypt zakłada, że katalogiem roboczym jest folder pakietu, i używa ścieżek w rodzajufile.path("dane", "surowe", "badanie_surowe.csv"). Plik projektu RStudio (.Rproj) ustawia katalog roboczy sam. - Numerowane kroki.
01_przygotowanie.Rtworzy plik analityczny,02_analiza.Rliczy wszystko, co jest w artykule. Każdy skrypt czyta pliki z dysku, więc nie zależy od tego, co zostało w pamięci po poprzedniej sesji. - Ziarno generatora liczb losowych. Bootstrap, imputacja wielokrotna czy symulacja dają przy każdym uruchomieniu trochę inne liczby.
set.seed()przed losowaniem sprawia, że wynik jest powtarzalny; wartość ziarna wpisz do README. - Zapis środowiska. Na końcu analizy zapisz
sessionInfo()do pliku – to wersja R, systemu i pakietów. Jeśli używasz pakietów spoza instalacji bazowej, zapisz ich wersje pakietem renv: według dokumentacjirenv::init()zakłada w projekcie osobną bibliotekę pakietów i tworzy plikrenv.lock,renv::snapshot()aktualizuje ten plik (działa też w projekcie bez renv), arenv::restore()instaluje zapisane w nim wersje. - Kontrole wbudowane w kod.
stopifnot()zatrzyma analizę, gdy dane nie zgadzają się z książką kodową, gdy identyfikatory się powtarzają albo gdy pojawi się odpowiedź spoza skali. - Wyniki do plików. Tabele zapisuj jako CSV, rysunki jako PNG lub SVG. Liczby w artykule przepisuj z tych plików, nie z konsoli.
Jeśli liczysz w SPSS, zasada jest ta sama: zamiast klikać, zapisz składnię (syntax) do pliku .sps i dołącz ją do pakietu razem z informacją o wersji programu. W R całą ścieżkę od danych do wyników zamykają dwa skrypty pokazane w sekcji z kodem.
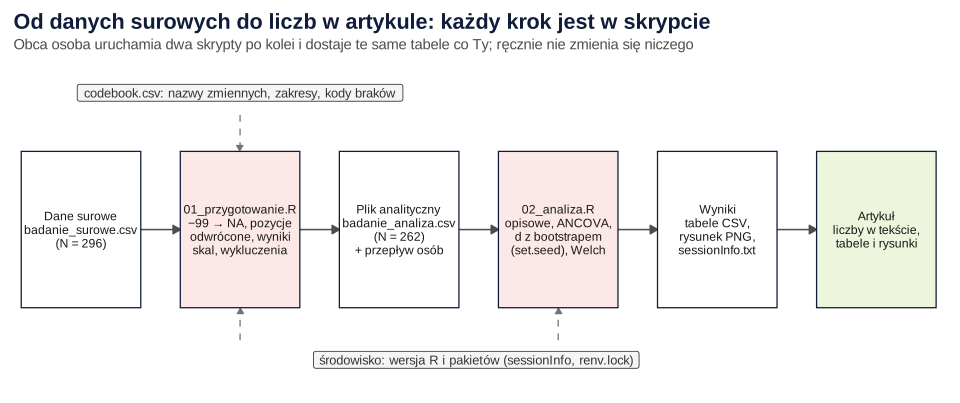
W przykładzie skrypt 01 wykluczył 22 osoby z powodu błędnej odpowiedzi na pytanie kontrolne, 7 z powodu zbyt krótkiego czasu wypełnienia, 3 z powodu braków w zmiennej zależnej i 2 z powodu braku kowarianty, zostawiając 262 osoby (134 w grupie kontrolnej, 128 w grupie ćwiczenia). Skrypt 02 policzył test hipotezy H1 – ANCOVA z lękiem wyjściowym jako kowariantą – wielkość efektu d z bootstrapowym przedziałem ufności i analizę wrażliwości testem Welcha. Gotowe zdania do opisu takich wyników znajdziesz w poradniku jak opisać wyniki w stylu APA. Jeśli chcesz, by kod pozwalający odtworzyć obliczenia przygotował lub sprawdził ktoś z zewnątrz, zajrzyj do oferty analiz statystycznych dla badaczy.
Anonimizacja i RODO: co wolno udostępnić
To nie jest porada prawna. Zanim udostępnisz dane osób badanych, skonsultuj plan z komisją etyczną i inspektorem ochrony danych swojej instytucji. Poniżej opisujemy pojęcia z RODO i praktyczne techniki, które pomagają w tej rozmowie.
RODO definiuje dane osobowe jako informacje o zidentyfikowanej lub możliwej do zidentyfikowania osobie fizycznej, czyli takiej, którą można zidentyfikować bezpośrednio lub pośrednio – m.in. na podstawie imienia i nazwiska, numeru identyfikacyjnego, danych o lokalizacji, identyfikatora internetowego albo czynników określających np. fizyczną, psychiczną, ekonomiczną, kulturową lub społeczną tożsamość (art. 4 pkt 1). Pseudonimizacja to przetworzenie danych tak, by bez dodatkowych informacji, przechowywanych osobno i chronionych, nie dało się ich przypisać konkretnej osobie (art. 4 pkt 5). Motyw 26 rozporządzenia wyjaśnia różnicę, która decyduje o wszystkim:
- dane spseudonimizowane, które przy użyciu dodatkowych informacji można przypisać osobie, nadal są danymi osobowymi;
- informacje anonimowe – takie, które nie pozwalają zidentyfikować osoby przy użyciu rozsądnie prawdopodobnych sposobów (z uwzględnieniem kosztu, czasu i dostępnej technologii) – nie podlegają RODO, także gdy są przetwarzane do celów naukowych lub statystycznych.
Art. 89 wymaga, by przetwarzanie do celów badań naukowych miało odpowiednie zabezpieczenia, zwłaszcza minimalizację danych, i – gdy pozwala to zrealizować cel – korzystało z danych, które nie pozwalają zidentyfikować osób (Parlament Europejski i Rada Unii Europejskiej, 2016). Zastąpienie nazwiska kodem to więc dopiero pseudonimizacja: dopóki gdzieś istnieje lista łącząca kody z osobami, dane są osobowe. Pamiętaj też, że dane dotyczące zdrowia należą do szczególnych kategorii danych (art. 9) – a odpowiedzi na część skal, np. objawów depresji czy lęku, mogą być właśnie takimi danymi. Szerzej o zgodzie i podstawach prawnych piszemy w haśle świadoma zgoda i RODO w badaniach.
Identyfikatory bezpośrednie i pośrednie
Identyfikatory bezpośrednie – imię i nazwisko, adres e-mail, numer telefonu, adres IP, identyfikator panelu – usuń zawsze. Trudniejsze są identyfikatory pośrednie: wiek, płeć, kierunek, rok studiów, miejscowość, dokładne daty. Każdy z osobna jest niewinny, ale razem tworzą unikatowe kombinacje. Rocher i in. (2019) oszacowali, że 99.98% Amerykanów zostałoby poprawnie zidentyfikowanych w zbiorze zawierającym 15 cech demograficznych. Ich zdaniem nawet mocno spróbkowane, „zanonimizowane” zbiory raczej nie spełniają standardów anonimizacji z RODO. PLOS wymienia wprost dane, których nie należy udostępniać – m.in. nazwiska, inicjały, adresy, adresy IP, dokładne daty (np. urodzenia), dane kontaktowe i dane o lokalizacji. Zaznacza też, że w małych grupach identyfikujące mogą być także kombinacje cech takich jak płeć czy miejsce (PLOS, b.d.).
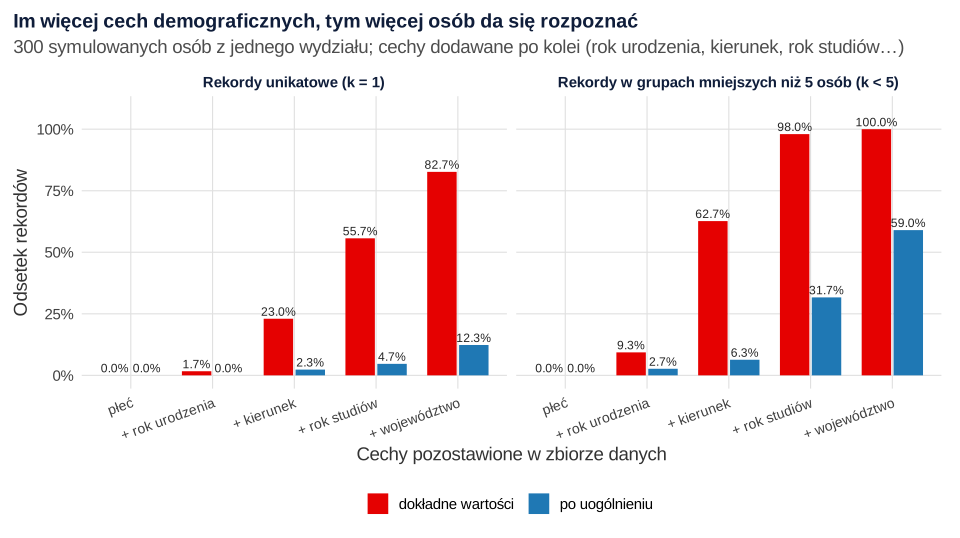
Rysunek 3 pokazuje to na symulacji 300 osób z jednego wydziału. Sama płeć nie wyróżnia nikogo, ale po dodaniu roku urodzenia, kierunku i roku studiów unikatowa jest kombinacja cech 55.7% osób, a po dodaniu województwa – 82.7%. Uogólnienie cech (przedziały wieku zamiast roku urodzenia, tylko duże kierunki, stopień studiów zamiast roku, „województwo uczelni albo inne”) obniża odsetek unikatowych rekordów do 12.3%, ale w grupach mniejszych niż 5 osób wciąż jest 59.0% rekordów. Wniosek praktyczny: publikuj tylko te cechy, których potrzebują analizy z artykułu, a resztę usuń albo uogólnij.
Zgoda uczestników i co zrobić, gdy surowych danych udostępnić nie wolno
O udostępnieniu danych decydujesz przed badaniem, nie po nim. Wytyczne NCN przypominają, że gdy w grę wchodzą dane osobowe, potrzebna jest świadoma zgoda uczestników na ich utrwalanie i udostępnianie, i każą rozważyć anonimizację lub pseudonimizację (Narodowe Centrum Nauki, 2020). Wpisz więc do informacji dla uczestników, że zanonimizowane dane trafią do publicznego repozytorium. Jeśli surowych danych udostępnić nie można, masz kilka możliwości:
- podzbiór zanonimizowany – tylko zmienne potrzebne do analiz z artykułu, z uogólnionymi cechami demograficznymi;
- dane zagregowane – macierze korelacji, średnie i odchylenia standardowe wystarczą do odtworzenia części analiz (np. regresji czy modeli SEM);
- dane syntetyczne – zbiór, który zachowuje właściwości statystyczne i związki między zmiennymi, ale żaden rekord nie odpowiada prawdziwej osobie; Quintana (2020) pokazuje, jak go wygenerować i ocenić pakietem R synthpop;
- dostęp kontrolowany – dane w repozytorium z kontrolą dostępu albo udostępniane przez komisję etyczną lub inną jednostkę instytucji, a nie wyłącznie przez autora (PLOS, b.d.).
Osobna sprawa to materiały: pełnej treści testów chronionych prawem autorskim nie umieszczaj w repozytorium bez zgody właściciela praw (zob. gdzie znaleźć kwestionariusze psychologiczne). Do pakietu wystarczą wtedy pełne odwołania i własne pytania z metryczki.
Licencje: CC0 i CC BY 4.0 dla danych, MIT i GPL dla kodu
Bez licencji inni nie wiedzą, co wolno im zrobić z Twoimi plikami. Wilson i in. (2017) przypominają, że brak licencji nie oznacza swobody: domyślnie autor zachowuje wszystkie prawa. Dla danych polecają CC0 albo CC BY, dla kodu – licencję permisywną, np. MIT.
| Licencja | Dla czego | Co wolno innym | Warunek |
|---|---|---|---|
| CC0 1.0 | Dane | Wszystko, także w celach komercyjnych, bez pytania o zgodę | Brak – to zrzeczenie się praw, nie licencja; cytowanie jest dobrym zwyczajem, a nie obowiązkiem |
| CC BY 4.0 | Dane, dokumentacja, materiały | Kopiować, rozpowszechniać i zmieniać w dowolnym celu | Uznanie autorstwa: autorzy, link do licencji, informacja o zmianach |
| MIT | Kod | Używać, kopiować, zmieniać, łączyć z innym kodem, rozpowszechniać | Zachowanie informacji o prawach autorskich i tekstu licencji w kopiach |
| GPL-3.0 | Kod | Używać, zmieniać i rozpowszechniać | Copyleft: rozpowszechniana zmieniona wersja musi być w całości udostępniona na tej samej licencji |
W szablonie wybraliśmy CC BY 4.0 dla danych i MIT dla kodu – to zestaw zgodny z tymi zaleceniami. FAQ Creative Commons dodaje kilka praktycznych uwag (Creative Commons, b.d.):
- licencje CC 4.0 obejmują także prawa sui generis do baz danych, a CC nie zaleca wariantów NC (bez użytku komercyjnego) i ND (bez utworów zależnych) dla baz danych przeznaczonych do użytku naukowego;
- CC odradza licencje CC dla oprogramowania i poleca licencje uznane przez Free Software Foundation i Open Source Initiative – dlatego dane i kod mają osobne licencje;
- licencje CC dotyczą praw autorskich, a nie prywatności, etyki badań ani ochrony danych osobowych – licencja nie zastępuje anonimizacji.
GPL wybierz, jeśli zależy Ci, by ulepszone wersje Twojego kodu też pozostały otwarte. Wilson i in. (2017) wolą licencje permisywne, bo taki kod łatwiej włączyć do innych projektów. Na OSF licencję wybiera się w metadanych projektu; komponenty mogą mieć różne licencje, więc dane i kod możesz trzymać w osobnych komponentach z osobnymi licencjami (Center for Open Science, b.d.).
OSF krok po kroku
OSF (Open Science Framework) to platforma Center for Open Science, w której projekt może mieć pliki, wiki, komponenty, licencję i DOI. Kroki poniżej opisują funkcje z oficjalnego przewodnika OSF Support (Center for Open Science, b.d.; stan na 16 października 2026 r.).
- Załóż projekt. Na pulpicie wybierz „Create new project”, wpisz tytuł i wybierz lokalizację przechowywania danych. Przewodnik wskazuje lokalizację w Niemczech jako opcję dla badaczy z UE ze względu na RODO. Lokalizację wybiera się tylko przy tworzeniu projektu – później nie da się jej zmienić.
- Podziel projekt na komponenty, np. „Dane”, „Kod”, „Materiały”. Każdy komponent ma własnych współpracowników, ustawienia prywatności, licencję i trwały identyfikator.
- Wgraj pliki w zakładce „Files” albo podłącz zewnętrzny magazyn (np. GitHub, Dropbox, Google Drive). Pliki w OSF Storage są wersjonowane. Limit to 5 GB dla projektu prywatnego i 50 GB dla publicznego (osobno dla każdego komponentu), a pojedynczy plik może mieć do 5 GB.
- Opisz projekt – w README w plikach i krótko w wiki (wiki ma historię zmian) oraz w metadanych: opis, słowa kluczowe, dziedzina, finansowanie.
- Wybierz licencję w sekcji „Metadata” (np. CC BY 4.0 dla danych i MIT dla kodu). Jeśli potrzebna licencja nie występuje na liście, wgraj plik
license.txti wybierz „Other”. - Na czas recenzji utwórz link tylko do odczytu z opcją „Anonymize” – ukrywa nazwiska autorów, a osoba z linkiem może przeglądać i pobierać pliki, choć projekt pozostaje prywatny.
- Po akceptacji artykułu upublicznij projekt (projekty są domyślnie prywatne) i utwórz DOI: „Metadata”, „Edit” przy polu DOI, „Create”. DOI można nadać tylko projektowi publicznemu.
- Wpisz DOI projektu do artykułu – do deklaracji dostępności danych i do README.
Dwie przestrogi: usunięcia pliku albo projektu nie da się cofnąć, a projekt OSF można edytować także po publikacji (Center for Open Science, b.d.). Jeśli chcesz zamrozić stan plików w chwili wysłania artykułu, utwórz rejestrację projektu – jej, w odróżnieniu od projektu, nie można już zmienić (mechanizm rejestracji opisujemy we wpisie o prerejestracji na OSF).
Deklaracja dostępności danych – wzory PL i EN
Deklaracja dostępności danych (ang. data availability statement) mówi czytelnikowi, gdzie są dane i kod, na jakich warunkach i pod jakim identyfikatorem. PLOS wymaga w niej nazwy repozytorium i trwałego identyfikatora, a przy ograniczonym dostępie – opisu ograniczeń i instytucjonalnego punktu kontaktu. Autor nie może być jedyną osobą odpowiedzialną za dostęp (PLOS, b.d.). Pamiętaj o wynikach Gabelicy i in. (2022): sama formuła „na uzasadnioną prośbę” w praktyce rzadko kończy się udostępnieniem danych. Wybierz wariant, który pasuje do Twojej sytuacji.
Wariant A – dane i kod w otwartym repozytorium:
Wariant B – dostęp kontrolowany przez instytucję:
Wariant C – dane syntetyczne zamiast surowych:
Test: czy obca osoba odtworzy wyniki w 30 minut?
Najlepszy sprawdzian pakietu to próba generalna, zanim zrobią ją recenzenci. Poproś osobę spoza zespołu – albo siebie na innym komputerze – o odtworzenie wyników z samym pakietem i README w ręku. Mierz czas.
- Pobierz pakiet z repozytorium (z linku z artykułu, nie z własnego dysku) i rozpakuj go do pustego folderu.
- Przeczytaj tylko README – bez pytania autorów.
- Zainstaluj potrzebne pakiety (
renv::restore(), jeśli jestrenv.lock). - Uruchom skrypty w kolejności z README, w nowej sesji R.
- Porównaj wartości kontrolne z README, a potem tabele i rysunki z artykułem.
- Zapisz każde miejsce, w którym trzeba było zgadywać: brakujący plik, nieopisaną zmienną, ścieżkę z Twojego komputera, niejasny krok.
Jeśli całość zajęła więcej niż 30 minut albo choć jedna liczba się nie zgadza, popraw pakiet i powtórz test. Szablon z tego wpisu przeszedł taką próbę automatycznie: skrypt budujący archiwum rozpakowuje je do nowego folderu i uruchamia oba skrypty poleceniem Rscript. Pakiet przyda się też przy recenzji – prośba o dane i kod należy do typowych uwag (zob. najczęstsze zarzuty recenzentów do statystyki i wzory odpowiedzi w tekście odpowiedź recenzentom w sprawach statystycznych). W doktoracie, gdzie jeden zbiór danych zasila kilka artykułów, warto zaplanować pakiet od pierwszego badania (zob. analiza statystyczna w doktoracie).
Przykład w R: skrypty pakietu i symulacja ryzyka identyfikacji
Przepisy 1 i 2 to pełne skrypty z pliku pakiet-replikacyjny-szablon.zip. Wyniki pochodzą z testu „od zera”: archiwum rozpakowano do nowego, pustego folderu i oba skrypty uruchomiono poleceniem Rscript z katalogu głównego pakietu. Przepis 3 odtwarza symulację z rysunku 3.
1. 01_przygotowanie.R – od danych surowych do pliku analitycznego
R
# 01_przygotowanie.R – od danych surowych do pliku analitycznego
# Pakiet replikacyjny: [tytuł artykułu]. Uruchamiaj z katalogu głównego pakietu
# (tam, gdzie leży README.md): Rscript 01_przygotowanie.R
# SPDX-License-Identifier: MIT

surowe  <- read.csv(file.path("dane", "surowe", "badanie_surowe.csv"),
                    stringsAsFactors = FALSE, encoding = "UTF-8")
ksiazka <- read.csv("codebook.csv", stringsAsFactors = FALSE, encoding = "UTF-8")

# 1. Zgodność z książką kodową: w pliku są dokładnie zmienne opisane jako „surowe”
opisane <- ksiazka$zmienna[grepl("surowe", ksiazka$plik)]
stopifnot(setequal(names(surowe), opisane), !anyDuplicated(surowe$id))

# 2. Kody braków (-99) zamieniamy na NA i sprawdzamy zakresy odpowiedzi
dane <- surowe
dane[dane == -99] <- NA
pozycje <- grep("^lek_(przed|po)_[0-9]$", names(dane), value = TRUE)
stopifnot(all(unlist(dane[c(pozycje, "kontrola")]) %in% c(1:5, NA)),
          all(dane$warunek %in% 0:1))

# 3. Pozycje odwrócone (książka kodowa): 6 - odpowiedź
odwrocone <- c("lek_po_2", "lek_po_5")
dane[odwrocone] <- 6 - dane[odwrocone]

# 4. Wyniki skal według planu analizy
przed <- paste0("lek_przed_", 1:3)
po    <- paste0("lek_po_", 1:6)
dane$lek_przed <- ifelse(rowSums(!is.na(dane[przed])) == 3, rowMeans(dane[przed]), NA)
dane$lek_po    <- ifelse(rowSums(!is.na(dane[po])) >= 5, rowMeans(dane[po], na.rm = TRUE), NA)

# 5. Reguły wykluczeń z planu, stosowane w tej kolejności
dane$powod <- NA_character_
dane$powod[is.na(dane$kontrola) | dane$kontrola != 2]           <- "błędne pytanie kontrolne"
dane$powod[is.na(dane$powod) & !is.na(dane$czas_s) & dane$czas_s < 120] <- "czas wypełnienia < 120 s"
dane$powod[is.na(dane$powod) & is.na(dane$lek_po)]               <- "braki w zmiennej zależnej"
dane$powod[is.na(dane$powod) & is.na(dane$lek_przed)]            <- "brak kowarianty"

# 6. Przepływ uczestników (do diagramu w artykule)
etapy <- c("błędne pytanie kontrolne", "czas wypełnienia < 120 s",
           "braki w zmiennej zależnej", "brak kowarianty")
przeplyw <- data.frame(etap = c("dane surowe", paste("wykluczeni:", etapy), "w analizie"),
                       n = c(nrow(dane), sapply(etapy, function(e) sum(dane$powod %in% e)),
                             sum(is.na(dane$powod))))
dir.create(file.path("wyniki", "tabele"), recursive = TRUE, showWarnings = FALSE)
write.csv(przeplyw, file.path("wyniki", "tabele", "przeplyw_uczestnikow.csv"), row.names = FALSE)

# 7. Plik analityczny
analiza <- dane[is.na(dane$powod), c("id", "warunek", "wiek_kat", "plec", "lek_przed", "lek_po")]
dir.create(file.path("dane", "przetworzone"), recursive = TRUE, showWarnings = FALSE)
write.csv(analiza, file.path("dane", "przetworzone", "badanie_analiza.csv"), row.names = FALSE)

print(przeplyw, row.names = FALSE)
cat("\nW analizie według warunku (0 = kontrola, 1 = ćwiczenie):\n")
print(table(analiza$warunek))
Wynik w R
                                  etap   n
                           dane surowe 296
  wykluczeni: błędne pytanie kontrolne  22
  wykluczeni: czas wypełnienia < 120 s   7
 wykluczeni: braki w zmiennej zależnej   3
           wykluczeni: brak kowarianty   2
                            w analizie 262

W analizie według warunku (0 = kontrola, 1 = ćwiczenie):

  0   1
134 128
2. 02_analiza.R – analizy z artykułu, tabele, rysunek i sessionInfo()
R
# 02_analiza.R – analizy z artykułu (hipoteza H1) na pliku analitycznym
# Wymaga wyniku 01_przygotowanie.R. Uruchamiaj z katalogu głównego pakietu:
# Rscript 02_analiza.R
# SPDX-License-Identifier: MIT

dane <- read.csv(file.path("dane", "przetworzone", "badanie_analiza.csv"), stringsAsFactors = FALSE)
dir.create(file.path("wyniki", "tabele"), recursive = TRUE, showWarnings = FALSE)
dir.create(file.path("wyniki", "rysunki"), recursive = TRUE, showWarnings = FALSE)

# Tabela 1: statystyki opisowe w grupach
opisz <- function(d) data.frame(warunek = d$warunek[1], n = nrow(d),
                                M_przed = mean(d$lek_przed), SD_przed = sd(d$lek_przed),
                                M_po = mean(d$lek_po), SD_po = sd(d$lek_po))
tab1 <- do.call(rbind, lapply(split(dane, dane$warunek), opisz))
write.csv(tab1, file.path("wyniki", "tabele", "tabela1_opisowe.csv"), row.names = FALSE)

# Tabela 2: H1 – ANCOVA (lęk po ~ warunek + lęk przed), test dwustronny, alfa = .05
model <- lm(lek_po ~ warunek + lek_przed, data = dane)
wsp <- summary(model)$coefficients
tab2 <- data.frame(parametr = rownames(wsp), b = wsp[, 1], SE = wsp[, 2], t = wsp[, 3],
                   df = model$df.residual, p = wsp[, 4], CI_dolna = confint(model)[, 1],
                   CI_gorna = confint(model)[, 2])
write.csv(tab2, file.path("wyniki", "tabele", "tabela2_ancova.csv"), row.names = FALSE)

# Wielkość efektu: d = skorygowana różnica / łączne SD zmiennej zależnej,
# 95% CI z bootstrapu percentylowego (2000 prób losowanych w obrębie grup)
d_efekt <- function(d) {
  b <- coef(lm(lek_po ~ warunek + lek_przed, data = d))[["warunek"]]
  s <- tapply(d$lek_po, d$warunek, sd); n <- tapply(d$lek_po, d$warunek, length)
  b / sqrt(sum((n - 1) * s^2) / (sum(n) - 2))
}
set.seed(20261016)
grupy <- split(seq_len(nrow(dane)), dane$warunek)
boot_d <- replicate(2000, d_efekt(dane[unlist(lapply(grupy, function(i) sample(i, replace = TRUE))), ]))
efekt <- data.frame(d = d_efekt(dane), CI_dolna = quantile(boot_d, .025), CI_gorna = quantile(boot_d, .975))
write.csv(efekt, file.path("wyniki", "tabele", "tabela2_wielkosc_efektu.csv"), row.names = FALSE)

# Tabela 3: analiza wrażliwości z planu – test Welcha bez kowarianty
welch <- t.test(lek_po ~ warunek, data = dane)        # domyślnie test Welcha; różnica: grupa 0 - grupa 1
tab3 <- data.frame(roznica = unname(diff(welch$estimate)), t = -unname(welch$statistic),  # ćwiczenie - kontrola
                   df = unname(welch$parameter), p = welch$p.value,
                   CI_dolna = -welch$conf.int[2], CI_gorna = -welch$conf.int[1])
write.csv(tab3, file.path("wyniki", "tabele", "tabela3_wrazliwosc.csv"), row.names = FALSE)

# Rysunek: wyniki osób i średnie z 95% CI w grupach
png(file.path("wyniki", "rysunki", "rysunek1_lek_po.png"), width = 1600, height = 1100, res = 200)
stripchart(lek_po ~ warunek, data = dane, vertical = TRUE, method = "jitter", pch = 16,
           col = adjustcolor("grey40", 0.4), group.names = c("Kontrola", "Ćwiczenie"),
           ylab = "Lęk przed oceną po zadaniu (1–5)", ylim = c(1, 5))
srednie <- tapply(dane$lek_po, dane$warunek, mean)
pol <- tapply(dane$lek_po, dane$warunek, function(x) qt(.975, length(x) - 1) * sd(x) / sqrt(length(x)))
arrows(1:2, srednie - pol, 1:2, srednie + pol, angle = 90, code = 3, length = 0.08, lwd = 2, col = "red3")
points(1:2, srednie, pch = 19, cex = 1.6, col = "red3")
invisible(dev.off())

# Środowisko obliczeniowe (wersje R i pakietów)
writeLines(capture.output(sessionInfo()), file.path("wyniki", "sessionInfo.txt"))

# Podsumowanie w konsoli
print(round(tab1, 2), row.names = FALSE)
cat("\nH1 (ANCOVA):\n")
print(round(tab2[, -1], 3), row.names = TRUE)
cat("\nWielkość efektu d [95% CI bootstrap]:\n")
print(round(efekt, 2), row.names = FALSE)
cat("\nAnaliza wrażliwości (test Welcha, różnica: ćwiczenie - kontrola):\n")
print(round(tab3, 3), row.names = FALSE)
Wynik w R
 warunek   n M_przed SD_przed M_po SD_po
       0 134    2.92     0.87 2.93  0.81
       1 128    3.00     0.86 2.69  0.87

H1 (ANCOVA):
                 b    SE      t  df     p CI_dolna CI_gorna
(Intercept)  1.728 0.172 10.058 259 0.000    1.389    2.066
warunek     -0.277 0.094 -2.954 259 0.003   -0.462   -0.092
lek_przed    0.412 0.054  7.581 259 0.000    0.305    0.519

Wielkość efektu d [95% CI bootstrap]:
     d CI_dolna CI_gorna
 -0.33    -0.56    -0.11

Analiza wrażliwości (test Welcha, różnica: ćwiczenie - kontrola):
 roznica      t      df    p CI_dolna CI_gorna
  -0.244 -2.349 256.353 0.02   -0.448   -0.039
3. Ryzyko identyfikacji: rekordy unikatowe po dodaniu kolejnych cech (rysunek 3)
R
# B41 – przepis 3: ile rekordów staje się unikatowych, gdy dokładamy cechy demograficzne?
# Wpis: /blog/pakiet-replikacyjny-dane-i-kod-osf/ (sekcja o anonimizacji, rysunek 3)
# Uruchomienie: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b41-reidentyfikacja.R
# Dane symulowane: 300 osób badanych z jednego wydziału, bez imion, adresów e-mail i numerów.

set.seed(4242)
N <- 300
dane <- data.frame(
  plec = sample(c("K", "M", "inna"), N, TRUE, c(.64, .34, .02)),
  rok_ur = 2026 - sample(19:32, N, TRUE, c(.10, .15, .17, .16, .13, .09, .06, .04, .03, .02, .02, .01, .01, .01)),
  kierunek = sample(paste0("kierunek_", 1:8), N, TRUE, c(.28, .20, .14, .12, .10, .07, .05, .04)),
  rok_st = sample(1:5, N, TRUE, c(.27, .24, .21, .16, .12)),
  woj = sample(paste0("woj_", 1:16), N, TRUE,
               c(.55, .12, .08, .06, .04, .03, .02, .02, .015, .015, .01, .01, .01, .01, .005, .005)))

# Wersja po uogólnieniu: przedziały wieku, duże kierunki, stopień studiów, województwo uczelni
duze <- names(which(prop.table(table(dane$kierunek)) >= .10))
uogolnione <- data.frame(
  plec = dane$plec,
  rok_ur = cut(2026 - dane$rok_ur, c(0, 21, 24, Inf), labels = c("do 21 lat", "22–24", "25+")),
  kierunek = ifelse(dane$kierunek %in% duze, dane$kierunek, "inny"),
  rok_st = ifelse(dane$rok_st <= 3, "I stopień", "II stopień"),
  woj = ifelse(dane$woj == "woj_1", "to samo co uczelnia", "inne"))

# k = liczba osób z tą samą kombinacją cech (k = 1: rekord unikatowy)
ryzyko <- function(d, cechy) {
  k <- ave(rep(1, nrow(d)), do.call(paste, c(d[cechy], sep = "|")), FUN = length)
  c(unikatowe = 100 * mean(k == 1), k_ponizej_5 = 100 * mean(k < 5))
}
zestawy <- list("płeć" = "plec", "+ rok urodzenia" = c("plec", "rok_ur"),
                "+ kierunek" = c("plec", "rok_ur", "kierunek"),
                "+ rok studiów" = c("plec", "rok_ur", "kierunek", "rok_st"),
                "+ województwo" = c("plec", "rok_ur", "kierunek", "rok_st", "woj"))
wynik <- do.call(rbind, lapply(names(zestawy), function(z)
  data.frame(cechy = z, rbind(dokladne = ryzyko(dane, zestawy[[z]]),
                              uogolnione = ryzyko(uogolnione, zestawy[[z]])),
             wersja = c("dokładne wartości", "po uogólnieniu"))))
rownames(wynik) <- NULL
print(transform(wynik, unikatowe = round(unikatowe, 1), k_ponizej_5 = round(k_ponizej_5, 1)), row.names = FALSE)
saveRDS(wynik, "b41-reidentyfikacja.rds")     # do rysunku 3
Wynik w R
           cechy unikatowe k_ponizej_5            wersja
            płeć       0.0         0.0 dokładne wartości
            płeć       0.0         0.0    po uogólnieniu
 + rok urodzenia       1.7         9.3 dokładne wartości
 + rok urodzenia       0.0         2.7    po uogólnieniu
      + kierunek      23.0        62.7 dokładne wartości
      + kierunek       2.3         6.3    po uogólnieniu
   + rok studiów      55.7        98.0 dokładne wartości
   + rok studiów       4.7        31.7    po uogólnieniu
   + województwo      82.7       100.0 dokładne wartości
   + województwo      12.3        59.0    po uogólnieniu
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Skrypty pakietu korzystają wyłącznie z pakietów wbudowanych w R; rysunki przygotowano w pakiecie ggplot2, a plik ZIP zbudowano pakietem zip. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- zip (wersja 2.3.3): Csárdi, G. (2025). zip: Cross-platform 'zip' compression [R package]. https://doi.org/10.32614/CRAN.package.zip
Najczęstsze błędy
- „Dane dostępne na prośbę” zamiast repozytorium. Bez trwałego identyfikatora i instytucjonalnego punktu kontaktu dane zwykle przepadają.
- Ścieżki bezwzględne i
setwd(). Kod działa tylko na komputerze autora. - Ręcznie poprawiony plik danych. Zmiany w Excelu bez śladu w kodzie uniemożliwiają odtworzenie przygotowania danych (do czego Excel się nadaje, a do czego nie, piszemy w poradniku analiza statystyczna w Excelu).
- Brak książki kodowej. Nikt nie wie, co znaczy
q17_rani jak zakodowano braki. - Brak ziarna i wersji pakietów. Bootstrap daje inne przedziały, a nowa wersja pakietu – inne domyślne ustawienia.
- Pseudonimizacja wzięta za anonimizację. Kod zamiast nazwiska nie wystarcza, jeśli w pliku zostały wiek, kierunek, rok studiów i miejscowość.
- Jedna licencja na wszystko – albo żadna.
- Pakiet przygotowany po przyjęciu artykułu. Odtworzenie decyzji sprzed roku jest trudniejsze niż zapisanie ich na bieżąco.
Lista kontrolna przed publikacją pakietu
- README odpowiada na pytania: co to jest, jak uruchomić, jak cytować; zawiera wartości kontrolne.
- Każda zmienna (także wyliczona) ma wiersz w książce kodowej.
- Dane są w otwartym formacie (CSV, UTF-8), a dane surowe nie zmieniły się od zebrania (poza anonimizacją).
- Usunięto identyfikatory bezpośrednie; identyfikatory pośrednie ograniczono do potrzebnych analiz.
- Uczestnicy zostali poinformowani o udostępnieniu danych, a plan zaakceptowała komisja etyczna.
- Skrypty używają ścieżek względnych, mają ziarno i zapisują
sessionInfo(); wersje pakietów są wrenv.lock. - Pakiet przeszedł test „od zera” w pustym folderze.
- Dane i kod mają licencje, wybrane także w metadanych repozytorium.
- Projekt jest publiczny i ma DOI; DOI jest w artykule i w README.
- Deklaracja dostępności danych wskazuje repozytorium, identyfikator i warunki dostępu.
Najczęstsze pytania
Jak napisać deklarację dostępności danych do artykułu?
Podaj, gdzie są dane i kod (nazwa repozytorium), ich trwały identyfikator (np. DOI), licencje i warunki dostępu. Jeśli danych nie wolno upublicznić, opisz powód i wskaż instytucjonalny punkt kontaktu, np. komisję etyczną – PLOS nie akceptuje autora jako jedynej osoby odpowiedzialnej za dostęp. Samo „dostępne na uzasadnioną prośbę” rzadko działa: w badaniu Gabelicy i in. (2022) dane przekazało 6.8% autorów, którzy to zadeklarowali.
Czy mogę udostępnić dane z ankiety, w której zbierałem dane osobowe?
Publicznie – tylko dane zanonimizowane, czyli takie, które nie pozwalają zidentyfikować osób przy użyciu rozsądnie prawdopodobnych sposobów; według motywu 26 RODO takie informacje nie podlegają rozporządzeniu, ale dane spseudonimizowane nadal są danymi osobowymi. Usuń identyfikatory bezpośrednie, ogranicz pośrednie (wiek, kierunek, miejscowość) i poinformuj uczestników o udostępnieniu danych przed badaniem. Plan skonsultuj z komisją etyczną i inspektorem ochrony danych; to nie jest porada prawna.
Jaką licencję wybrać dla danych badawczych i kodu?
Dla danych zwykle poleca się CC BY 4.0 (wymaga uznania autorstwa) albo CC0 (zrzeczenie się praw), dla kodu – licencję permisywną, np. MIT, albo GPL-3.0, jeśli zmienione wersje mają pozostać otwarte (Wilson i in., 2017). Creative Commons odradza swoje licencje dla oprogramowania i nie zaleca wariantów NC i ND dla naukowych baz danych. Pamiętaj, że licencja nie zastępuje anonimizacji.
Ile miejsca daje OSF na pliki projektu?
Według przewodnika OSF limit OSF Storage to 5 GB dla projektu prywatnego i 50 GB dla publicznego, liczony osobno dla każdego komponentu, a pojedynczy plik może mieć do 5 GB. Pliki w podłączonych magazynach zewnętrznych (np. GitHub, Dropbox) nie wliczają się do limitu. Lokalizację przechowywania, np. w Niemczech, wybiera się przy zakładaniu projektu i nie można jej później zmienić.
Co powinien zawierać plik README do pakietu replikacyjnego?
Tytuł i autorów z kontaktem, odwołanie do artykułu i prerejestracji, listę plików, instrukcję uruchomienia (kolejność skryptów, wersja programu), opis danych (liczebność, książka kodowa, kody braków, co usunięto przy anonimizacji), opis środowiska (sessionInfo, renv.lock, ziarno), licencje i sposób cytowania. Dobrym zwyczajem są wartości kontrolne, np. jeden współczynnik z tabeli, który osoba odtwarzająca wyniki powinna otrzymać.
Czy NCN wymaga udostępniania danych z projektów?
Tak – od 2019 r. wnioski do NCN zawierają plan zarządzania danymi oceniany przez ekspertów, a po zmianach z 26 czerwca 2025 r. zasady udostępniania danych badawczych pozostały bez zmian, mimo że publikowanie w otwartym dostępie nie jest już obowiązkowe. Według wytycznych NCN dane należy udostępnić najpóźniej w momencie publikacji wyników i przechowywać co najmniej 10 lat. Przed złożeniem wniosku sprawdź dokumenty swojego konkursu.
Powiązane hasła
Przeczytaj też
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikJak przygotować bazę danych do analizy
Układ bazy, nazwy zmiennych, kodowanie ankiety, braki, pułapki Excela, widok zmiennych w SPSS i kontrola jakości – z szablonem .xlsx, .sav i .csv do pobrania.
Czytaj →PoradnikOdpowiedź recenzentom – wzory PL i EN
Zasady i struktura odpowiedzi oraz wzory PL/EN na 12 sytuacji: moc post hoc, korekta porównań, model mieszany, braki danych, CMV i przyznanie się do błędu.
Czytaj →Potrzebujesz kodu, który odtworzy wyniki Twojego artykułu?
Przygotujemy albo sprawdzimy skrypty R, książkę kodową i README tak, by analizy z artykułu dało się uruchomić od zera na danych z repozytorium.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Center for Open Science. (b.d.). Welcome to OSF projects. OSF Support. Pobrano 16 października 2026 z https://help.osf.io/article/137-osf-storage-caps ● Otwarty dostęp
- Creative Commons. (b.d.). Frequently asked questions. Pobrano 16 października 2026 z https://creativecommons.org/faq/ ● Otwarty dostęp
- Gabelica, M., Bojčić, R., & Puljak, L. (2022). Many researchers were not compliant with their published data sharing statement: A mixed-methods study. Journal of Clinical Epidemiology, 150, 33–41. https://doi.org/10.1016/j.jclinepi.2022.05.019
- Hardwicke, T. E., Mathur, M. B., MacDonald, K., Nilsonne, G., Banks, G. C., Kidwell, M. C., Hofelich Mohr, A., Clayton, E., Yoon, E. J., Henry Tessler, M., Lenne, R. L., Altman, S., Long, B., & Frank, M. C. (2018). Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition. Royal Society Open Science, 5(8), Article 180448. https://doi.org/10.1098/rsos.180448 ● Otwarty dostęp
- Narodowe Centrum Nauki. (2020). Wytyczne dla wnioskodawców do uzupełnienia planu zarządzania danymi w projekcie badawczym. https://www.ncn.gov.pl/sites/default/files/pliki/regulaminy/wytyczne_zarzadzanie_danymi_06_2020.pdf ● Otwarty dostęp
- Narodowe Centrum Nauki. (b.d.). Otwarta nauka. Pobrano 16 października 2026 z https://www.ncn.gov.pl/finansowanie-nauki/otwarta-nauka ● Otwarty dostęp
- Obels, P., Lakens, D., Coles, N. A., Gottfried, J., & Green, S. A. (2020). Analysis of open data and computational reproducibility in registered reports in psychology. Advances in Methods and Practices in Psychological Science, 3(2), 229–237. https://doi.org/10.1177/2515245920918872 ● Otwarty dostęp
- Parlament Europejski i Rada Unii Europejskiej. (2016). Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2016/679 z dnia 27 kwietnia 2016 r. w sprawie ochrony osób fizycznych w związku z przetwarzaniem danych osobowych i w sprawie swobodnego przepływu takich danych oraz uchylenia dyrektywy 95/46/WE (ogólne rozporządzenie o ochronie danych). Dziennik Urzędowy Unii Europejskiej. https://eur-lex.europa.eu/eli/reg/2016/679/oj ● Otwarty dostęp: pełny tekst
- PLOS. (b.d.). Data availability. PLOS One. Pobrano 16 października 2026 z https://journals.plos.org/plosone/s/data-availability ● Otwarty dostęp
- Quintana, D. S. (2020). A synthetic dataset primer for the biobehavioural sciences to promote reproducibility and hypothesis generation. eLife, 9, Article e53275. https://doi.org/10.7554/elife.53275 ● Otwarty dostęp
- Rocher, L., Hendrickx, J. M., & de Montjoye, Y.-A. (2019). Estimating the success of re-identifications in incomplete datasets using generative models. Nature Communications, 10(1), Article 3069. https://doi.org/10.1038/s41467-019-10933-3 ● Otwarty dostęp
- Trisovic, A., Lau, M. K., Pasquier, T., & Crosas, M. (2022). A large-scale study on research code quality and execution. Scientific Data, 9(1), Article 60. https://doi.org/10.1038/s41597-022-01143-6 ● Otwarty dostęp
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., Blomberg, N., Boiten, J.-W., da Silva Santos, L. B., Bourne, P. E., Bouwman, J., Brookes, A. J., Clark, T., Crosas, M., Dillo, I., Dumon, O., Edmunds, S., Evelo, C. T., Finkers, R., . . . Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), Article 160018. https://doi.org/10.1038/sdata.2016.18 ● Otwarty dostęp
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), Article e1005510. https://doi.org/10.1371/journal.pcbi.1005510 ● Otwarty dostęp
Cytowania BibTeX
@misc{cosndprojekty, author={{Center for Open Science}}, title={{Welcome to OSF projects}}, howpublished={OSF Support}, url={https://help.osf.io/article/137-osf-storage-caps}}@misc{creativecommonsndfaq, author={{Creative Commons}}, title={{Frequently asked questions}}, url={https://creativecommons.org/faq/}}@article{gabelica2022many, author={Gabelica, Mirko and Bojčić, Ružica and Puljak, Livia}, title={{Many researchers were not compliant with their published data sharing statement: A mixed-methods study}}, journal={Journal of Clinical Epidemiology}, year={2022}, volume={150}, pages={33--41}, doi={10.1016/j.jclinepi.2022.05.019}}@article{hardwicke2018data, author={Hardwicke, Tom E. and Mathur, Maya B. and MacDonald, Kyle and Nilsonne, Gustav and Banks, George C. and Kidwell, Mallory C. and Hofelich Mohr, Alicia and Clayton, Elizabeth and Yoon, Erica J. and Henry Tessler, Michael and Lenne, Richie L. and Altman, Sara and Long, Bria and Frank, Michael C.}, title={{Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition}}, journal={Royal Society Open Science}, year={2018}, volume={5}, number={8}, eid={180448}, doi={10.1098/rsos.180448}}@techreport{ncn2020wytyczne, author={{Narodowe Centrum Nauki}}, title={{Wytyczne dla wnioskodawców do uzupełnienia planu zarządzania danymi w projekcie badawczym}}, year={2020}, url={https://www.ncn.gov.pl/sites/default/files/pliki/regulaminy/wytyczne_zarzadzanie_danymi_06_2020.pdf}}@misc{ncnndotwarta, author={{Narodowe Centrum Nauki}}, title={{Otwarta nauka}}, url={https://www.ncn.gov.pl/finansowanie-nauki/otwarta-nauka}}@article{obels2020analysis, author={Obels, Pepijn and Lakens, Daniël and Coles, Nicholas A. and Gottfried, Jaroslav and Green, Seth A.}, title={{Analysis of open data and computational reproducibility in registered reports in psychology}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={2}, pages={229--237}, doi={10.1177/2515245920918872}}@misc{eu2016regulation, author={{Parlament Europejski i Rada Unii Europejskiej}}, title={{Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2016/679 z dnia 27 kwietnia 2016 r. w sprawie ochrony osób fizycznych w związku z przetwarzaniem danych osobowych i w sprawie swobodnego przepływu takich danych oraz uchylenia dyrektywy 95/46/WE (ogólne rozporządzenie o ochronie danych)}}, howpublished={Dziennik Urzędowy Unii Europejskiej}, year={2016}, volume={L 119}, pages={1--88}, url={https://eur-lex.europa.eu/eli/reg/2016/679/oj}}@misc{plosndda, author={{PLOS}}, title={{Data availability}}, howpublished={PLOS One}, url={https://journals.plos.org/plosone/s/data-availability}}@article{quintana2020synthetic, author={Quintana, Daniel S}, title={{A synthetic dataset primer for the biobehavioural sciences to promote reproducibility and hypothesis generation}}, journal={eLife}, year={2020}, volume={9}, eid={e53275}, doi={10.7554/elife.53275}}@article{rocher2019estimating, author={Rocher, Luc and Hendrickx, Julien M. and de Montjoye, Yves-Alexandre}, title={{Estimating the success of re-identifications in incomplete datasets using generative models}}, journal={Nature Communications}, year={2019}, volume={10}, number={1}, eid={3069}, doi={10.1038/s41467-019-10933-3}}@article{trisovic2022large, author={Trisovic, Ana and Lau, Matthew K. and Pasquier, Thomas and Crosas, Mercè}, title={{A large-scale study on research code quality and execution}}, journal={Scientific Data}, year={2022}, volume={9}, number={1}, eid={60}, doi={10.1038/s41597-022-01143-6}}@article{wilkinson2016fair, author={Wilkinson, Mark D. and Dumontier, Michel and Aalbersberg, IJsbrand Jan and Appleton, Gabrielle and Axton, Myles and Baak, Arie and Blomberg, Niklas and Boiten, Jan-Willem and da Silva Santos, Luiz Bonino and Bourne, Philip E. and Bouwman, Jildau and Brookes, Anthony J. and Clark, Tim and Crosas, Mercè and Dillo, Ingrid and Dumon, Olivier and Edmunds, Scott and Evelo, Chris T. and Finkers, Richard and Gonzalez-Beltran, Alejandra and Gray, Alasdair J.G. and Groth, Paul and Goble, Carole and Grethe, Jeffrey S. and Heringa, Jaap and ’t Hoen, Peter A.C and Hooft, Rob and Kuhn, Tobias and Kok, Ruben and Kok, Joost and Lusher, Scott J. and Martone, Maryann E. and Mons, Albert and Packer, Abel L. and Persson, Bengt and Rocca-Serra, Philippe and Roos, Marco and van Schaik, Rene and Sansone, Susanna-Assunta and Schultes, Erik and Sengstag, Thierry and Slater, Ted and Strawn, George and Swertz, Morris A. and Thompson, Mark and van der Lei, Johan and van Mulligen, Erik and Velterop, Jan and Waagmeester, Andra and Wittenburg, Peter and Wolstencroft, Katherine and Zhao, Jun and Mons, Barend}, title={{The FAIR Guiding Principles for scientific data management and stewardship}}, journal={Scientific Data}, year={2016}, volume={3}, number={1}, eid={160018}, doi={10.1038/sdata.2016.18}}@article{wilson2017good, author={Wilson, Greg and Bryan, Jennifer and Cranston, Karen and Kitzes, Justin and Nederbragt, Lex and Teal, Tracy K.}, title={{Good enough practices in scientific computing}}, journal={PLOS Computational Biology}, year={2017}, volume={13}, number={6}, eid={e1005510}, doi={10.1371/journal.pcbi.1005510}}