Od czego zacząć: statystyka w doktoracie to część planu, nie ostatni etap
W pracy magisterskiej analiza statystyczna często zaczyna się wtedy, gdy dane są już w arkuszu. W doktoracie taka kolejność się mści. Część empiryczna rozprawy to zwykle kilka badań rozłożonych na cztery lata, a każde potrzebuje uzasadnionej liczebności, zgody komisji etycznej, planu analiz i miejsca w harmonogramie, który w połowie kształcenia ocenia komisja. Przy rozprawie z cyklu artykułów dochodzą recenzje w czasopismach i pytanie, jak z jednego projektu przygotować kilka publikacji bez dzielenia wyników na sztuczne kawałki.
Poniżej przechodzimy przez decyzje na pierwszy rok – od formy rozprawy po autorstwo. Liczby pokazujemy na jednym przykładzie: doktorat z psychologii z trzema badaniami – walidacją polskiej wersji skali, badaniem podłużnym z dwoma pomiarami i eksperymentem z interwencją. Liczebności policzyliśmy w R (kod na końcu wpisu). Przepisy cytujemy według tekstu ujednoliconego ustawy w ISAP, uwzględniającego zmiany do Dz.U. 2026 poz. 912 (sprawdzono 16 października 2026 r.). To nie jest porada prawna – szczegóły, które ustawa zostawia uczelniom, znajdziesz w regulaminie szkoły doktorskiej i uchwałach rady naukowej.
Monografia czy cykl publikacji – co mówi ustawa
Zgodnie z art. 187 ust. 3 ustawy z dnia 20 lipca 2018 r. – Prawo o szkolnictwie wyższym i nauce (tekst jednolity: Dz.U. 2024 poz. 1571 ze zm.; dalej: ustawa) rozprawę doktorską może stanowić praca pisemna, w tym monografia naukowa, zbiór opublikowanych i powiązanych tematycznie artykułów naukowych, praca projektowa, konstrukcyjna, technologiczna, wdrożeniowa lub artystyczna, a także samodzielna i wyodrębniona część pracy zbiorowej. Niezależnie od formy rozprawa prezentuje ogólną wiedzę teoretyczną kandydata i umiejętność samodzielnego prowadzenia pracy naukowej (art. 187 ust. 1), a rozprawę pisemną przed obroną sprawdza się w Jednolitym Systemie Antyplagiatowym (art. 188 ust. 4; zob. analiza statystyczna a system antyplagiatowy).
Stopień doktora wymaga też dorobku: co najmniej jednego artykułu w czasopiśmie naukowym lub w recenzowanych materiałach z konferencji międzynarodowej, ujętych w ministerialnym wykazie w roku publikacji artykułu w ostatecznej formie, albo monografii lub rozdziału w monografii wydawnictwa z wykazu (art. 186 ust. 1 pkt 3). Szczegóły ustawa zostawia uczelniom: senat albo rada naukowa określa m.in. tryb złożenia rozprawy i sposób sprawdzania wymagania publikacyjnego przy publikacjach wieloautorskich (art. 192 ust. 2 pkt 3 i 7). Ustawa mówi o artykułach „opublikowanych”, ale nie określa, ile ich ma być ani jakich oświadczeń współautorów wymaga się przy złożeniu rozprawy. Sprawdź to – i to, jak traktowane są artykuły przyjęte do druku – w zasadach swojej rady naukowej, zanim zaplanujesz badania.
| Kwestia | Monografia | Cykl artykułów |
|---|---|---|
| Kto ocenia analizy | Recenzenci rozprawy, na końcu | Recenzenci każdego czasopisma, potem recenzenci rozprawy |
| Spójność liczb | Jeden tekst – łatwiej ją zachować | Te same dane w kilku artykułach: N, wykluczenia i nazwy zmiennych muszą się zgadzać |
| Wyniki nieistotne | Mieszczą się w rozdziale wyników | Trudniej je opublikować – wybierz czasopismo i formę artykułu z wyprzedzeniem |
| Ryzyko w harmonogramie | Pisanie na końcu kształcenia | Czas recenzji niezależny od Ciebie |
W ankiecie wśród 246 osób, które niedawno uzyskały doktorat na podstawie rozprawy z publikacji na uczelniach australijskich, najczęściej wymieniano trudności ze spójnością rozprawy, presję czasu, przebieg procesu publikacyjnego i wsparcie promotora lub uczelni, a wśród zalet – m.in. efektywność, szersze rozpowszechnienie wyników, informację zwrotną z recenzji i rozwój umiejętności badawczych (Merga i in., 2020). Nethsinghe i Southcott (2015) dodają, że decyzję o takiej formie trzeba podjąć wcześnie, bo dane może być konieczne zebrać wcześnie.
Szkoła doktorska: indywidualny plan badawczy i ocena śródokresowa
Rozprawę przygotowuje się w szkole doktorskiej albo w trybie eksternistycznym (art. 197). W szkole doktorskiej kształcenie trwa od 6 do 8 semestrów, promotora wyznacza się w ciągu 3 miesięcy, a kształcenie prowadzi się na podstawie programu kształcenia i indywidualnego planu badawczego, w skrócie IPB (art. 201 ust. 1–3).
| Element | Co mówi ustawa | Co to znaczy dla analiz |
|---|---|---|
| Indywidualny plan badawczy | Doktorant w uzgodnieniu z promotorem opracowuje plan zawierający w szczególności harmonogram przygotowania rozprawy i przedstawia go w ciągu 12 miesięcy od rozpoczęcia kształcenia (art. 202 ust. 1) | Liczebność i plan badań policz przed złożeniem IPB, nie po |
| Ocena śródokresowa | W połowie okresu kształcenia (przy 6 semestrach – w czwartym semestrze); komisja trzech osób, w tym co najmniej jedna spoza podmiotu prowadzącego szkołę (z habilitacją lub tytułem profesora w dyscyplinie albo z zagranicznej uczelni lub instytucji naukowej), bez promotorów; wynik pozytywny albo negatywny, jawny wraz z uzasadnieniem (art. 202 ust. 2–4) | Komisja porównuje stan prac z harmonogramem – dobrze mieć dane z pierwszego badania i artykuł w recenzji |
| Skreślenie z listy doktorantów | M.in. po negatywnej ocenie śródokresowej i po niezłożeniu rozprawy w terminie z IPB; możliwe też przy niezadowalającym postępie (art. 203 ust. 1 pkt 1–2, ust. 2 pkt 1) | Harmonogram nie może zakładać, że każdy artykuł przejdzie recenzję za pierwszym razem |
| Termin złożenia rozprawy | Określa go IPB; przedłużenie najwyżej o 2 lata, na zasadach z regulaminu szkoły (art. 204 ust. 2), który określa też sposób przeprowadzania oceny śródokresowej (art. 205 ust. 1) | Zapas na recenzje planuj w IPB – przedłużenie to wyjście awaryjne |
Ustawa wymaga w IPB „w szczególności” harmonogramu, więc resztę zakresu ustala szkoła. Z punktu widzenia statystyki dobry IPB podaje dla każdego badania pytanie, schemat, liczebność z uzasadnieniem, główną analizę, planowany artykuł i plan B:
Harmonogram: [tabela lub wykres Gantta].
Część empiryczna jako seria badań
Częsty układ doktoratu w psychologii i naukach społecznych prowadzi od pomiaru, przez związki zmiennych w czasie, do sprawdzenia przyczynowości – razem badania tworzą jeden argument.
| Badanie | Pytanie | Schemat | Główna analiza | Liczebność |
|---|---|---|---|---|
| 1. Walidacyjne | Czy polska wersja skali ma zakładaną strukturę i jest rzetelna? | przekrojowy, jedna próba | CFA z testem RMSEA, ω, korelacje z miarami pokrewnymi | 312 |
| 2. Korelacyjne podłużne | Czy X przewiduje Y po 6 miesiącach przy kontroli wyjściowego Y? | podłużny, dwa pomiary | regresja Y(T2) na Y(T1) i X(T1) | 272 (zaproszonych 340) |
| 3. Eksperymentalne | Czy interwencja obniża Y w porównaniu z grupą kontrolną? | eksperymentalny, losowy przydział do dwóch grup | ANCOVA z pomiarem wyjściowym; moc liczona ostrożnie dla testu t | 2 × 133 (rekrutacja 2 × 157) |
Spójność narzędzi i decyzji między badaniami
- Ta sama wersja narzędzia – pozycje, instrukcja i skala odpowiedzi; każdą zmianę po badaniu 1 opisz i uzasadnij wynikami walidacji.
- Wspólna książka kodowa – te same nazwy zmiennych, kody braków i sposób liczenia wyników (zob. jak przygotować bazę danych do analizy).
- Rzetelność w każdej próbie – ω lub α liczone osobno w każdym badaniu (zob. omega McDonalda).
- Inwariancja pomiaru – zanim porównasz średnie grup albo pomiarów, sprawdź, czy skala mierzy to samo (inwariancja pomiaru; procedura: wielogrupowa CFA w lavaan).
- Te same reguły jakości danych – pytania kontrolne, kryteria wykluczeń i postępowanie z brakami ustalone raz dla całego projektu.
- Osobny plan analizy dla każdego badania, zapisany przed zebraniem danych. Prerejestracja pozwala odróżnić testowanie przewidywań od wyjaśniania wyników po fakcie (Nosek i in., 2018); wzór znajdziesz w poradniku plan analizy statystycznej i prerejestracja. Analizy dodane później opisuj jako eksploracyjne, bez HARKingu.
Przy więcej niż dwóch pomiarach rozważ modele CLPM i RI-CLPM albo model mieszany (ANOVA z powtarzanymi pomiarami czy model mieszany); standardy dla doktoratów medycznych omawiamy we wpisie statystyka w publikacji medycznej.
Moc i liczebność dla każdego badania – liczby z R
Uzasadnienie liczebności przyda się w IPB, we wniosku do komisji etycznej i grantodawcy oraz w każdym artykule. Lakens (2022) opisuje sześć sposobów takiego uzasadnienia – m.in. ograniczenia zasobów, analizę mocy a priori, planowanie dokładności i heurystyki – i zwraca uwagę na pytanie, jakie wielkości efektu zebrane dane pozwolą wykryć. W doktoracie najczęściej stosuje się analizę mocy a priori, osobno dla każdego badania, z efektem uzasadnionym wcześniejszymi badaniami albo najmniejszym efektem o praktycznym znaczeniu (więcej: dobór liczebności próby). W przykładzie przyjmujemy α = .05 i moc testu .90.
| Badanie | Hipoteza i założony efekt | Metoda obliczenia | Liczebność dla mocy .90 | Do zaproszenia |
|---|---|---|---|---|
| 1. Walidacja skali | Model z 12 pozycjami i dwoma skorelowanymi czynnikami (df = 53) jest dobrze dopasowany; H0: RMSEA ≥ .05, H1: RMSEA = .01 | Test braku bliskiego dopasowania (MacCallum i in., 1996), niecentralny rozkład χ² | N = 312 | 312 i zapas na wykluczenia |
| 2. Podłużne | X(T1) przewiduje Y(T2) przy kontroli Y(T1); r(X1, Y1) = .25, r(X1, Y2) = .30, r(Y1, Y2) = .60, czyli korelacja cząstkowa .19 i f² = 0.039 | Test F dla jednego współczynnika regresji; kontrola symulacją 5000 zbiorów danych | N = 272 w obu pomiarach | 340 (odpad 20%) |
| 3. Eksperyment | Interwencja a grupa kontrolna, d = 0.40 | Test t dla dwóch grup (power.t.test) | n = 133 w grupie | 157 w grupie (odpad 15%) |
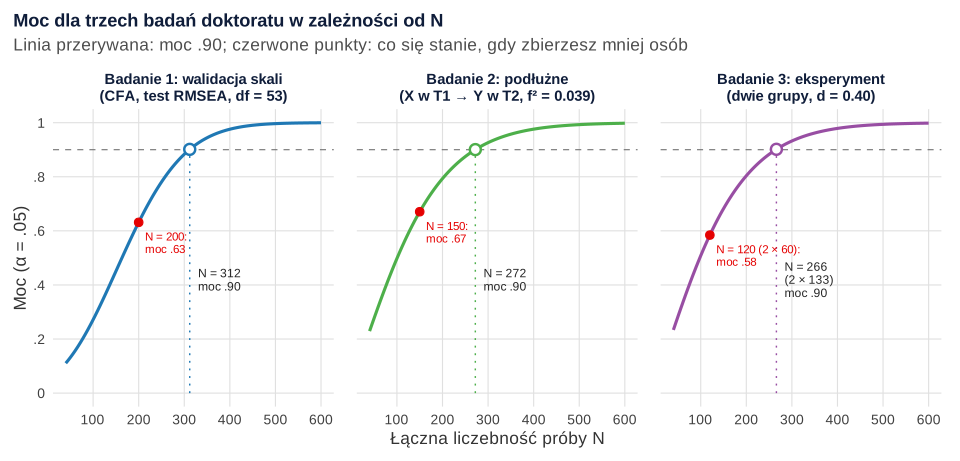
Badanie 1. W walidacji hipotezą jest dobre dopasowanie modelu, a zwykły test χ² sprawdza coś odwrotnego. MacCallum i in. (1996) zaproponowali test hipotezy zerowej o niedobrym dopasowaniu – wynik istotny mocno wspiera wtedy dobre dopasowanie – i pokazali, jak policzyć moc oraz minimalną liczebność, gdy efekt określa się wartościami RMSEA przy H0 i H1. Dla modelu z df = 53 moc .90 daje N = 312. Popularne „200 osób do CFA” dałoby w tym teście moc tylko .63.
Badanie 2. Efekt jest mały, bo kontrolujesz wyjściowy poziom Y: korelacja cząstkowa X z Y po pół roku wynosi .19 (f² = 0.039). Moc .90 wymaga 272 osób obecnych w obu pomiarach; symulacja dała moc .894, zgodną z obliczeniem analitycznym. Przy 20% odpadu do pierwszego pomiaru trzeba zaprosić 340 osób, a przy 150 osobach moc spadłaby do .67. Zaplanuj też analizę braków (zob. braki danych i imputacja wielokrotna w R).
Badanie 3. Do wykrycia efektu d = 0.40 (zob. d Cohena) z mocą .90 potrzeba 133 osób w grupie, a z mocą .80 – 100. Przy 15% rezygnacji rekrutujesz po 157 osób. Moc liczymy ostrożnie, dla testu t bez kowarianty – pomiar wyjściowy w ANCOVA zwykle ją zwiększa, a jej wartość dla takiego modelu policzysz symulacją. Przy 60 osobach w grupie moc dla d = 0.40 wyniesie .58, a najmniejszy efekt wykrywany z mocą .80 to d = 0.52 – taka analiza wrażliwości to gotowy element planu B.
Wzór uzasadnienia liczebności do części „Method” artykułu (dla trzech badań z przykładu):
Cała seria: ile wyników istotnych możesz realnie dostać
Jeśli wszystkie trzy efekty istnieją, a każde badanie ma moc około .90, prawdopodobieństwo, że wszystkie trzy dadzą wynik istotny, wynosi 73.2% (iloczyn mocy). W ponad jednej czwartej takich serii (26.8%) co najmniej jeden wynik będzie nieistotny, choć hipotezy są prawdziwe. Przy mocy .80 w każdym badaniu szansa na trzy wyniki istotne spada do 51.2%, a dwa istotne na trzy (38.4%) są niemal równie prawdopodobne. Lakens i Etz (2017) pokazują, że mieszane wyniki w serii badań są czymś oczekiwanym, a przy rozsądnej mocy i kontrolowanym poziomie błędu I rodzaju często świadczą na rzecz hipotezy alternatywnej; zachęcają, by takie serie publikować razem z metaanalizą wewnętrzną.
Dla doktoratu wniosek jest praktyczny: z góry zaplanuj, jak opiszesz wynik nieistotny (zob. hipoteza się nie potwierdziła), i nie zakładaj, że cykl musi się składać z samych „sukcesów” – od takiego założenia zaczyna się efekt szuflady. W omówieniu cyklu możesz połączyć wyniki badań w metaanalizie (zob. jak rzetelnie połączyć wyniki wielu badań).
Harmonogram na cztery lata – wykres Gantta
Rysunek 2 pokazuje przykładowy plan dla kształcenia trwającego 8 semestrów. Stałe punkty wynikają z ustawy: promotor w ciągu 3 miesięcy, IPB w ciągu 12 miesięcy i ocena śródokresowa w połowie okresu kształcenia – przy 8 semestrach około 24. miesiąca, a dokładny termin ustala szkoła (art. 201 ust. 2, art. 202 ust. 1–2). Pozostałe terminy to propozycja do uzgodnienia z promotorem.
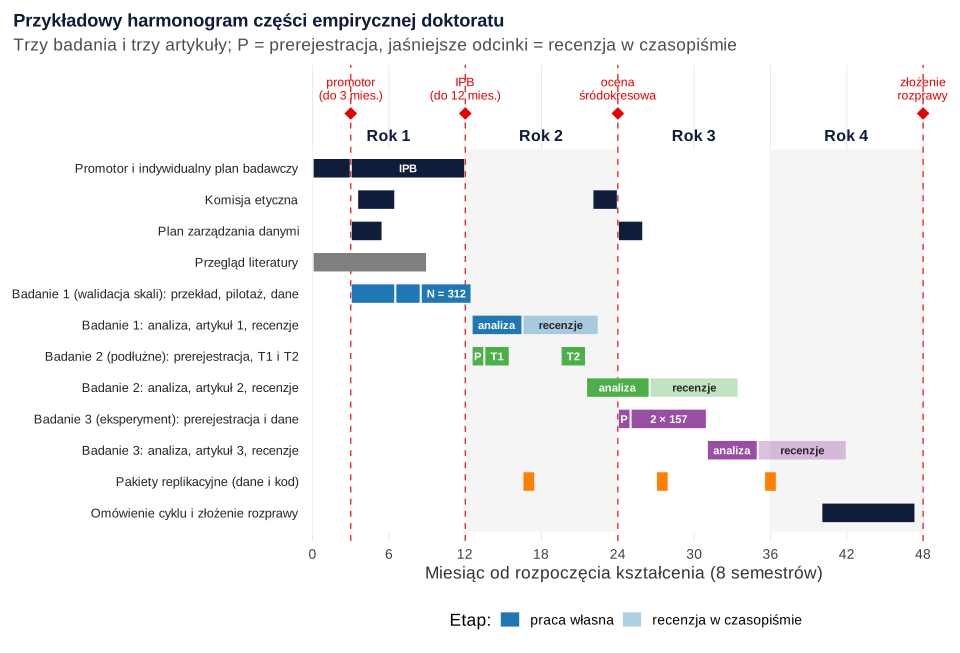
- Pierwsze dane w pierwszym roku. Bez nich trudno pokazać postęp na ocenie śródokresowej. Przekład narzędzia przygotuj, czekając na decyzję komisji etycznej; pilotaż i dane – dopiero po niej.
- Kolejne badanie zaczynaj, zanim poprzedni artykuł wróci z recenzji. W przykładzie na recenzje przewidziano 6–7 miesięcy na artykuł; sprawdź, co czasopismo podaje o czasie oceny.
- Prerejestracja przed każdym badaniem (litera P) i dane z kodem udostępniane przy każdym artykule, a nie na końcu doktoratu.
- Przygotowanie do recenzji. Przed wysłaniem artykułu sprawdź najczęstsze zarzuty recenzentów do statystyki, a odpowiedź na uwagi przygotuj według wzorów odpowiedzi recenzentom.
- Przegląd literatury w pierwszym roku. Jeśli w cyklu ma się znaleźć przegląd systematyczny lub metaanaliza, zaplanuj je od razu (zob. metaanaliza wielopoziomowa, umbrella review i PRISMA 2020); czy artykuł przeglądowy może wejść do cyklu, określają zasady uczelni.
- Ostatnie pół roku na omówienie cyklu – wstęp i dyskusję, które łączą artykuły w jedną rozprawę.
Jeden zbiór danych w kilku artykułach – jak uniknąć „salami slicing”
„Salami slicing” to dzielenie wyników jednego badania na możliwie najmniejsze części, z których każda trafia do osobnego artykułu. Nethsinghe i Southcott (2015) opisują rozprawę z publikacji jako żonglowanie między spójnością całości a wydzielaniem publikowalnych części – tę równowagę trzeba zaplanować przed zebraniem danych.
Zalecenia Międzynarodowego Komitetu Wydawców Czasopism Medycznych (ICMJE) nie zabraniają kilku artykułów z jednego zbioru danych, ale stawiają warunki: artykuły oparte na tych samych danych powinny istotnie uzupełniać się nawzajem i cytować wcześniejsze publikacje z tego zbioru. Zalecenia opisują też – na przykładzie dużych badań klinicznych – planowanie od początku kilku publikacji o odrębnych pytaniach z tej samej próby; najważniejsze jest wtedy, by było to oczywiste dla czytelnika. Artykuł blisko związany z innym, złożonym lub przyjętym gdzie indziej, zgłaszasz z informacją o tym w liście do redakcji i z powiązanym tekstem (International Committee of Medical Journal Editors, 2026). Sprawdź też zasady wybranego czasopisma.
| Kwestia | Uczciwy podział | Salami slicing |
|---|---|---|
| Pytania badawcze | Artykuł A: czy X przewiduje zmianę Y; artykuł B: czy Y wiąże się z późniejszym Z | Ten sam model w kilku artykułach, osobno dla każdej podskali Y |
| Moderatory i podgrupy | Moderator w głównym artykule albo w osobnym, z nowym uzasadnieniem teoretycznym i własną prerejestracją | „Efekt u kobiet” i „efekt u mężczyzn” w dwóch artykułach |
| Opis próby | Ta sama próba opisana spójnie, z odwołaniem do wcześniejszej publikacji | Ta sama próba przedstawiona jako nowe badanie |
| Zmienne | Pełna lista zmiennych zebranych w projekcie, np. w prerejestracji | Ukrycie, że zebrano inne miary |
Najprostsza ochrona to mapa publikacji przygotowana przed zebraniem danych: tabela, w której każda zmienna ma rolę (wynik główny, predyktor, kowarianta, zmienna eksploracyjna) w konkretnym artykule, a każdy wynik główny występuje tylko w jednym artykule. Mapę dołącz do IPB i prerejestracji, a powiązania opisz wprost:
Plan zarządzania danymi (NCN) i pakiet replikacyjny
Plan zarządzania danymi (ang. data management plan, DMP) jest częścią wniosków do Narodowego Centrum Nauki – w ogłoszeniu konkursu PRELUDIUM 25 wymieniono go obok informacji o kwestiach etycznych (Narodowe Centrum Nauki, 2026). Warto go napisać w pierwszym roku, nawet bez wniosku grantowego, bo porządkuje decyzje, które i tak zapadają przed zebraniem danych. Wytyczne NCN rozumieją przez „dane” dane surowe i przetworzone w każdym formacie, także niecyfrowym, np. wypełnione kwestionariusze czy nagrania. Plan ma sześć części (Narodowe Centrum Nauki, 2020):
| Część planu (wytyczne NCN) | Przykład dla doktoratu z trzema badaniami |
|---|---|
| 1. Opis danych oraz pozyskiwanie lub ponowne wykorzystanie dostępnych danych | Ankiety online w trzech badaniach, pliki CSV i skrypty R |
| 2. Dokumentacja i jakość danych | Wspólna książka kodowa, pliki README, pytania kontrolne i reguły wykluczeń |
| 3. Przechowywanie i kopie zapasowe podczas badań | Serwer lub dysk uczelni z automatyczną kopią; dostęp do danych z identyfikatorami tylko dla zespołu |
| 4. Wymogi prawne, kodeksy postępowania | RODO: świadoma zgoda, pseudonimizacja, klucz przechowywany osobno; zgoda autorów skali |
| 5. Udostępnianie i długotrwałe przechowywanie danych | Repozytorium z trwałym identyfikatorem (np. DOI), udostępnienie najpóźniej w dniu publikacji, licencja CC BY 4.0 lub CC0 |
| 6. Zadania związane z zarządzaniem danymi oraz zasoby | Kto odpowiada za dane, koszty repozytorium i czas na przygotowanie danych |
Według wytycznych dane należy udostępnić możliwie szybko – najpóźniej w momencie publikacji wyników – w repozytorium zgodnym z zasadami FAIR, z pierwszeństwem formatów otwartych; za uzasadniony okres przechowywania NCN uznaje minimum 10 lat (Narodowe Centrum Nauki, 2020). W PRELUDIUM dane będące podstawą publikacji – także tych w zamkniętym dostępie – powinny być udokumentowane zgodnie z FAIR i tam, gdzie to możliwe, udostępnione na licencji CC0 lub CC BY 4.0 (Narodowe Centrum Nauki, 2026). Strukturę folderów, README i skrypty, które działają od zera, opisujemy w poradniku pakiet replikacyjny – dane i kod do artykułu, a szerszy kontekst w haśle open science.
Komisja etyczna i zgoda uczestników
Wymogi wobec badań z udziałem ludzi określają uczelnie, czasopisma i grantodawcy, a w medycynie – także przepisy o komisjach bioetycznych. Punktem odniesienia są wytyczne NCN do formularza kwestii etycznych (Narodowe Centrum Nauki, 2023). Badania z udziałem ludzi obejmują w nich m.in. wywiady, obserwacje, użycie danych osobowych, interwencje psychologiczne i wykorzystanie wcześniej zebranych informacji. Udział musi być dobrowolny, a badacz musi uzyskać świadomą zgodę uczestników i zgodę właściwej komisji przed rozpoczęciem prac; w projektach NCN zgodę komisji dołącza się do pierwszego raportu rocznego. Celowa zmiana zachowania przez interwencje i treningi – jak w badaniu 3 – to aktywna interwencja psychologiczna, przy której opisuje się m.in. minimalizowanie ryzyka. Eksperyment medyczny wymaga pozytywnej opinii niezależnej komisji bioetycznej.
- Wniosek do komisji składaj przed pilotażem – pilotaż to też badanie z udziałem ludzi (zob. badanie pilotażowe).
- Zapytaj komisję o zakres zgody – czy wystarczy jeden wniosek dla projektu i czy np. dodanie interwencji wymaga nowej zgody.
- Zgoda uczestników musi obejmować udostępnienie danych. Formularz NCN pyta, czy zgoda zawiera informacje o przyszłym wykorzystaniu danych; bez nich plan otwartych danych może się nie udać (zob. świadoma zgoda i RODO w badaniach).
Granty dla doktorantów: PRELUDIUM
Dla osób bez stopnia doktora Narodowe Centrum Nauki prowadzi konkurs PRELUDIUM – na projekty badawcze realizowane przez osoby nieposiadające stopnia doktora (Narodowe Centrum Nauki, b.d.). Według ogłoszenia PRELUDIUM 25 z 16 marca 2026 r. (Narodowe Centrum Nauki, 2026):
- kierownikiem projektu może być osoba, która w dniu zamknięcia naboru nie ma stopnia doktora – i tylko raz;
- zespół liczy najwyżej trzy osoby, w tym kierownika projektu i opiekuna naukowego;
- projekt trwa 12, 24 lub 36 miesięcy i dotyczy badań podstawowych;
- temat może, ale nie musi być powiązany z tematem planowanej rozprawy;
- wniosek zawiera m.in. plan badań, informacje o kwestiach etycznych i plan zarządzania danymi;
- w projekcie nie można zaplanować stypendiów naukowych NCN ani stypendiów doktoranckich.
Kwoty, terminy naboru i szczegółowe warunki zmieniają się między edycjami – zawsze sprawdzaj bieżące ogłoszenie. Konkurs PRELUDIUM BIS dla doktorantów w szkołach doktorskich ma na liście konkursów krajowych NCN ostatnią edycję z 2023 r. – PRELUDIUM BIS 5, ogłoszony 15 czerwca 2023 r. (Narodowe Centrum Nauki, b.d.). Eksperci oceniają m.in. możliwość realizacji planowanych badań, więc uzasadniona liczebność i konkretny plan analiz wzmacniają wniosek. Zaplanuj jednak wersję badań możliwą bez grantu – wynik konkursu nie powinien decydować o doktoracie.
Współpraca ze statystykiem: rola i autorstwo
Współpraca ze statystykiem jest w nauce czymś zwyczajnym, ale w doktoracie granica pomocy jest ostrzejsza niż w artykule. Rozprawa ma prezentować umiejętność samodzielnego prowadzenia pracy naukowej (art. 187 ust. 1), a jeśli osoba ubiegająca się o stopień przypisała sobie autorstwo istotnego fragmentu lub innych elementów cudzego utworu lub ustalenia naukowego, podmiot doktoryzujący stwierdza nieważność decyzji o nadaniu stopnia (art. 195). Z konsultacji planu, sprawdzenia analiz czy obliczeń wykonanych z wyjaśnieniem korzystaj tak, by spełnić dwa warunki: rozumiesz każdą analizę i umiesz jej bronić oraz ujawniasz pomoc zgodnie z zasadami uczelni i czasopisma.
ICMJE zaleca, by autorstwo opierało się na czterech kryteriach spełnionych łącznie: (1) istotny wkład w koncepcję lub projekt pracy albo w pozyskanie, analizę lub interpretację danych; (2) przygotowanie tekstu lub jego krytyczna rewizja pod kątem ważnych treści merytorycznych; (3) akceptacja ostatecznej wersji do publikacji; (4) zgoda na odpowiedzialność za wszystkie aspekty pracy. Osoby, które nie spełniają wszystkich kryteriów, wymienia się w podziękowaniach z opisem wkładu; samo pozyskanie finansowania czy ogólny nadzór nad zespołem nie uzasadnia autorstwa. Każdy, kto spełnia pierwsze kryterium, powinien mieć możliwość udziału w przygotowaniu tekstu i akceptacji jego ostatecznej wersji, a o autorstwie zespół najlepiej decyduje już przy planowaniu pracy (International Committee of Medical Journal Editors, 2026).
Wiele czasopism prosi o opis wkładu w taksonomii CRediT (norma ANSI/NISO z 2022 r., 14 ról). Dla statystyka typowe są Formal analysis (techniki statystyczne, matematyczne lub obliczeniowe zastosowane do analizy danych), Methodology, Software, Data curation, Validation i Visualization. Role opisują wkład, a nie przesądzają o autorstwie; przy kilku osobach w tej samej roli można określić stopień wkładu: wiodący, równy albo wspierający (NISO CRediT Working Group, 2022).
| Zakres współpracy | Jak to opisać |
|---|---|
| Konsultacja planu analiz i obliczeń mocy | Podziękowania z opisem wkładu |
| Wykonanie analiz, udział w interpretacji, krytyczna rewizja tekstu i akceptacja wersji | Współautorstwo, jeśli spełnione są wszystkie 4 kryteria ICMJE; CRediT: Formal analysis, Methodology, Writing – review & editing |
| Kod i pakiet replikacyjny | CRediT: Software, Data curation |
Jakie dokumenty o wkładzie współautorów dołącza się do rozprawy, sprawdź w zasadach określonych przez senat albo radę naukową (art. 192 ust. 2). Jeśli chcesz zaplanować liczebność i analizy przed złożeniem IPB albo potrzebujesz obliczeń do kolejnych artykułów cyklu z wyjaśnieniem wyników, zobacz ofertę analiz statystycznych dla badaczy (analizy do publikacji naukowych i opracowanie części empirycznej).
Obliczenia mocy dla trzech badań w R
Kod liczy liczebność dla trzech badań z przykładu, sprawdza wynik badania 2 symulacją i oblicza prawdopodobieństwo, że cała seria da wyniki istotne. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Liczebność, analiza wrażliwości i moc całej serii
R
# Badanie 1: walidacja skali – test braku bliskiego dopasowania (H0: RMSEA >= .05, H1: RMSEA = .01)
moc_rmsea <- function(N, df, e0 = .05, e1 = .01, alfa = .05) {
  n  <- N - 1
  kr <- qchisq(alfa, df, ncp = n * df * e0^2)   # odrzucamy H0, gdy chi-kwadrat < kr
  pchisq(kr, df, ncp = n * df * e1^2)
}
df1 <- 12 * 13 / 2 - (12 + 12 + 1)             # 12 pozycji, 2 skorelowane czynniki
N1  <- which(sapply(1:3000, moc_rmsea, df = df1) >= .90)[1]
c(df = df1, N = N1, moc = round(moc_rmsea(N1, df1), 3), moc_N200 = round(moc_rmsea(200, df1), 3))

# Badanie 2: X(T1) -> Y(T2) przy kontroli Y(T1); założone korelacje
R2 <- matrix(c(1, .25, .30,  .25, 1, .60,  .30, .60, 1), 3,
             dimnames = rep(list(c("X1", "Y1", "Y2")), 2))
pr <- (R2["X1", "Y2"] - R2["X1", "Y1"] * R2["Y1", "Y2"]) /
      sqrt((1 - R2["X1", "Y1"]^2) * (1 - R2["Y1", "Y2"]^2))   # korelacja cząstkowa
f2 <- pr^2 / (1 - pr^2)
moc_f2 <- function(N, f2, k = 2, alfa = .05) {   # test jednego współczynnika, k predyktorów
  v <- N - k - 1
  1 - pf(qf(1 - alfa, 1, v), 1, v, ncp = f2 * N)
}
N2 <- which(sapply(10:3000, moc_f2, f2 = f2) >= .90)[1] + 9
c(r_czastkowe = round(pr, 3), f2 = round(f2, 4), N = N2, rekrutacja = ceiling(N2 / .80),
  moc_N150 = round(moc_f2(150, f2), 3))
set.seed(3602)                                    # sprawdzenie symulacją
istotne <- replicate(5000, {
  d <- as.data.frame(MASS::mvrnorm(N2, mu = rep(0, 3), Sigma = R2))
  summary(lm(Y2 ~ Y1 + X1, data = d))$coefficients["X1", 4] < .05
})
mean(istotne)

# Badanie 3: eksperyment, dwie grupy, d = 0.40
n3 <- ceiling(power.t.test(delta = 0.40, power = .90)$n)
c(n_w_grupie = n3, rekrutacja = ceiling(n3 / .85),
  n_moc_80 = ceiling(power.t.test(delta = 0.40, power = .80)$n),
  moc_n60 = round(power.t.test(n = 60, delta = 0.40)$power, 3),
  d_min_n60 = round(power.t.test(n = 60, power = .80)$delta, 3))

# Cała seria: prawdopodobieństwo, że wszystkie trzy wyniki będą istotne
moce <- c(moc_rmsea(N1, df1), moc_f2(N2, f2), power.t.test(n = n3, delta = 0.40)$power)
round(c(wszystkie_3 = prod(moce), co_najmniej_1_nieistotny = 1 - prod(moce)), 3)
round(dbinom(0:3, 3, .80), 3)   # liczba wyników istotnych (0–3) przy mocy .80 w każdym badaniu
Wynik w R
      df        N      moc moc_N200
  53.000  312.000    0.901    0.631
r_czastkowe          f2           N  rekrutacja    moc_N150
      0.194       0.039     272.000     340.000       0.671
[1] 0.8944
n_w_grupie rekrutacja   n_moc_80    moc_n60  d_min_n60
   133.000    157.000    100.000      0.584      0.516
             wszystkie_3 co_najmniej_1_nieistotny
                   0.732                    0.268
[1] 0.008 0.096 0.384 0.512
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w planowaniu części empirycznej
- Analizy planowane po zebraniu danych. Bez planu zapisanego wcześniej trudno uniknąć p-hackingu i dopisywania hipotez do wyników.
- „200 osób, bo tak się przyjmuje”. W przykładowej walidacji daje to moc .63 zamiast .90; liczebność wylicz dla konkretnej hipotezy i każdego badania osobno.
- Brak zapasu na odpad – w badaniu podłużnym zaproś 340 osób, a nie 272.
- Zmiana narzędzia między badaniami bez opisu i uzasadnienia.
- Założenie, że wszystkie badania „wyjdą”. Nawet przy mocy .90 seria trzech prawdziwych efektów da co najmniej jeden wynik nieistotny w 26.8% przypadków.
- Komisja etyczna po rozpoczęciu badań albo zgoda uczestników bez informacji o udostępnianiu danych.
- Salami slicing – osobne artykuły dla podskal, podgrup albo kolejnych pomiarów tej samej analizy.
- Autorstwo ustalane po fakcie zamiast przed rozpoczęciem pracy.
- Harmonogram bez czasu na recenzje – ryzyko przy ocenie śródokresowej i terminie złożenia rozprawy.
- Nieznajomość lokalnych zasad – liczby artykułów i dokumentów o wkładzie współautorów nie ma w ustawie.
Lista kontrolna na cztery lata
Rok 1
- Znam zasady rady naukowej dotyczące rozprawy z artykułów.
- Mam mapę publikacji: pytania, zmienne i wynik główny każdego artykułu.
- Dla każdego badania mam uzasadnienie liczebności z analizą wrażliwości i zapasem na odpad.
- IPB złożyłam/złożyłem w ciągu 12 miesięcy, a plan zarządzania danymi jest gotowy.
- Mam zgodę komisji etycznej przed pilotażem, a zgoda uczestników obejmuje udostępnianie danych.
- Plan analizy badania 1 zarejestrowałam/zarejestrowałem przed zebraniem danych.
Rok 2
- Artykuł 1 jest w recenzji, a dane i kod są gotowe do udostępnienia.
- Badanie 2 ma prerejestrację, a pierwszy pomiar odbył się zgodnie z planem.
- Na ocenę śródokresową mam porównanie stanu prac z harmonogramem z IPB.
Rok 3
- Wyniki badania 2 opisuję spójnie z wcześniejszymi artykułami (to samo N, te same wykluczenia).
- Eksperyment ma prerejestrację, zgodę komisji i zapas na rezygnacje.
- Autorstwo i role CRediT w kolejnych artykułach są uzgodnione przed analizami.
Rok 4
- Artykuły cyklu mają status wymagany przez zasady rady naukowej.
- Omówienie łączy artykuły, a wyniki nieistotne są opisane uczciwie.
- Umiem samodzielnie wyjaśnić każdą analizę w rozprawie.
Najczęstsze pytania
Czy rozprawa doktorska może być cyklem artykułów?
Tak. Według art. 187 ust. 3 ustawy – Prawo o szkolnictwie wyższym i nauce rozprawę doktorską może stanowić m.in. zbiór opublikowanych i powiązanych tematycznie artykułów naukowych. Liczbę artykułów, wymagania wobec czasopism i dokumenty o wkładzie współautorów określają zasady uczelni (senatu albo rady naukowej), więc sprawdź je, zanim zaplanujesz badania.
Co powinien zawierać indywidualny plan badawczy doktoranta?
Ustawa wymaga, by indywidualny plan badawczy zawierał w szczególności harmonogram przygotowania rozprawy; doktorant opracowuje go w uzgodnieniu z promotorem i przedstawia w ciągu 12 miesięcy od rozpoczęcia kształcenia (art. 202 ust. 1). Warto opisać w nim każde badanie: pytanie, schemat, liczebność z uzasadnieniem, główną analizę, planowaną publikację i plan B, bo realizację planu ocenia komisja w ocenie śródokresowej.
Kiedy jest ocena śródokresowa w szkole doktorskiej?
W połowie okresu kształcenia określonego w programie, a przy kształceniu trwającym 6 semestrów – w czwartym semestrze (art. 202 ust. 2). Ocenia ją komisja trzech osób, w tym co najmniej jednej spoza podmiotu prowadzącego szkołę doktorską; promotor nie może być jej członkiem. Wynik jest pozytywny albo negatywny, a negatywny oznacza skreślenie z listy doktorantów (art. 203 ust. 1 pkt 1).
Czy z jednego badania można opublikować kilka artykułów do doktoratu?
Można, jeśli każdy artykuł odpowiada na inne pytanie i istotnie uzupełnia pozostałe. Zalecenia ICMJE wymagają cytowania wcześniejszych publikacji z tego samego zbioru danych i poinformowania redakcji o powiązanych tekstach. Dzielenie jednego wyniku na kilka artykułów (salami slicing) wprowadza w błąd czytelników i recenzentów.
Czy statystyk powinien być współautorem artykułu doktoranta?
Według zaleceń ICMJE – tylko wtedy, gdy spełnia wszystkie cztery kryteria autorstwa: istotny wkład (np. w analizę i interpretację danych), udział w przygotowaniu lub krytycznej rewizji tekstu, akceptację ostatecznej wersji i zgodę na odpowiedzialność za pracę. W przeciwnym razie wymienia się go w podziękowaniach z opisem wkładu. Role obu osób można opisać taksonomią CRediT, np. Formal analysis.
Ile osób trzeba zbadać w doktoracie?
Uniwersalnej liczby nie ma: liczebność wylicza się osobno dla każdego badania, z analizy mocy albo planowanej dokładności. W naszym przykładzie przy mocy .90 walidacja skali wymaga 312 osób, badanie podłużne – 272 osób obecnych w obu pomiarach (340 zaproszonych przy 20% odpadu), a eksperyment – 133 osób w grupie.
Powiązane hasła
Przeczytaj też
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →Planujesz część empiryczną doktoratu?
Pomożemy policzyć liczebność i zaplanować analizy kolejnych badań, wykonać obliczenia do artykułów z cyklu i wyjaśnić wyniki przed obroną.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- International Committee of Medical Journal Editors. (2026). Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals (updated January 2026). ICMJE. https://www.icmje.org/recommendations/ ● Otwarty dostęp: pełny tekst
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lakens, D., & Etz, A. J. (2017). Too true to be bad: When sets of studies with significant and nonsignificant findings are probably true. Social Psychological and Personality Science, 8(8), 875–881. https://doi.org/10.1177/1948550617693058 ● Otwarty dostęp
- MacCallum, R. C., Browne, M. W., & Sugawara, H. M. (1996). Power analysis and determination of sample size for covariance structure modeling. Psychological Methods, 1(2), 130–149. https://doi.org/10.1037/1082-989X.1.2.130
- Merga, M. K., Mason, S., & Morris, J. E. (2020). ‘What do I even call this?’ Challenges and possibilities of undertaking a thesis by publication. Journal of Further and Higher Education, 44(9), 1245–1261. https://doi.org/10.1080/0309877X.2019.1671964
- Narodowe Centrum Nauki. (2020). Wytyczne dla wnioskodawców do uzupełnienia planu zarządzania danymi w projekcie badawczym. https://www.ncn.gov.pl/sites/default/files/pliki/regulaminy/wytyczne_zarzadzanie_danymi_06_2020.pdf ● Otwarty dostęp
- Narodowe Centrum Nauki. (2023). Wytyczne dla wnioskodawców do uzupełnienia formularza dotyczącego kwestii etycznych w projekcie badawczym (Załącznik nr 1 do zarządzenia nr 33/2023 Dyrektora Narodowego Centrum Nauki z dnia 30 maja 2023 r.). https://www.ncn.gov.pl/sites/default/files/pliki/regulaminy/2023_wytyczne_dla_wnioskodawcow_kwestie_etyczne.pdf ● Otwarty dostęp
- Narodowe Centrum Nauki. (2026, 16 marca). PRELUDIUM 25 [ogłoszenie konkursu]. https://www.ncn.gov.pl/ogloszenia/konkursy/preludium25 ● Otwarty dostęp
- Narodowe Centrum Nauki. (b.d.). Konkursy krajowe. Pobrano 16 października 2026 z https://www.ncn.gov.pl/konkursy-krajowe ● Otwarty dostęp
- Nethsinghe, R., & Southcott, J. (2015). A juggling act: Supervisor/candidate partnership in a doctoral thesis by publication. International Journal of Doctoral Studies, 10, 167–185. https://doi.org/10.28945/2256 ● Otwarty dostęp
- NISO CRediT Working Group. (2022). ANSI/NISO Z39.104-2022, CRediT, Contributor Roles Taxonomy. National Information Standards Organization. https://doi.org/10.3789/ansi.niso.z39.104-2022 ● Otwarty dostęp: pełny tekst
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114 ● Otwarty dostęp: pełny tekst
- Ustawa z dnia 20 lipca 2018 r. – Prawo o szkolnictwie wyższym i nauce. (2018). Tekst jednolity (Dz.U. 2024 poz. 1571 z późn. zm.). Internetowy System Aktów Prawnych. https://isap.sejm.gov.pl/isap.nsf/DocDetails.xsp?id=WDU20180001668 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@misc{icmje2026recommendations, author={{International Committee of Medical Journal Editors}}, title={{Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals (updated January 2026)}}, howpublished={ICMJE}, year={2026}, publisher={International Committee of Medical Journal Editors}, url={https://www.icmje.org/recommendations/}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lakens2017too, author={Lakens, Daniël and Etz, Alexander J.}, title={{Too true to be bad: When sets of studies with significant and nonsignificant findings are probably true}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={8}, pages={875--881}, doi={10.1177/1948550617693058}}@article{maccallum1996power, author={MacCallum, Robert C. and Browne, Michael W. and Sugawara, Hazuki M.}, title={{Power analysis and determination of sample size for covariance structure modeling}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={130--149}, doi={10.1037/1082-989x.1.2.130}}@article{merga2020what, author={Merga, Margaret K. and Mason, Shannon and Morris, Julia E.}, title={{‘What do I even call this?’ Challenges and possibilities of undertaking a thesis by publication}}, journal={Journal of Further and Higher Education}, year={2020}, volume={44}, number={9}, pages={1245--1261}, doi={10.1080/0309877x.2019.1671964}}@techreport{ncn2020plandanych, author={{Narodowe Centrum Nauki}}, title={{Wytyczne dla wnioskodawców do uzupełnienia planu zarządzania danymi w projekcie badawczym}}, year={2020}, institution={Narodowe Centrum Nauki}, url={https://www.ncn.gov.pl/sites/default/files/pliki/regulaminy/wytyczne_zarzadzanie_danymi_06_2020.pdf}}@techreport{ncn2023kwestieetyczne, author={{Narodowe Centrum Nauki}}, title={{Wytyczne dla wnioskodawców do uzupełnienia formularza dotyczącego kwestii etycznych w projekcie badawczym (Załącznik nr 1 do zarządzenia nr 33/2023 Dyrektora Narodowego Centrum Nauki z dnia 30 maja 2023 r.)}}, year={2023}, institution={Narodowe Centrum Nauki}, url={https://www.ncn.gov.pl/sites/default/files/pliki/regulaminy/2023_wytyczne_dla_wnioskodawcow_kwestie_etyczne.pdf}}@misc{ncn2026preludium25, author={{Narodowe Centrum Nauki}}, title={{PRELUDIUM 25 [ogłoszenie konkursu]}}, year={2026}, url={https://www.ncn.gov.pl/ogloszenia/konkursy/preludium25}}@misc{ncnndkonkursy, author={{Narodowe Centrum Nauki}}, title={{Konkursy krajowe}}, url={https://www.ncn.gov.pl/konkursy-krajowe}}@article{nethsinghe2015juggling, author={Nethsinghe, Rohan and Southcott, Jane}, title={{A juggling act: Supervisor/candidate partnership in a doctoral thesis by publication}}, journal={International Journal of Doctoral Studies}, year={2015}, volume={10}, pages={167--185}, doi={10.28945/2256}}@techreport{niso2022credit, author={{NISO CRediT Working Group}}, title={{ANSI/NISO Z39.104-2022, CRediT, Contributor Roles Taxonomy}}, year={2022}, institution={National Information Standards Organization}, doi={10.3789/ansi.niso.z39.104-2022}}@article{nosek2018preregistration, author={Nosek, Brian A. and Ebersole, Charles R. and DeHaven, Alexander C. and Mellor, David T.}, title={{The preregistration revolution}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2600--2606}, doi={10.1073/pnas.1708274114}}@misc{pswn2018ustawa, author={{Ustawa z dnia 20 lipca 2018 r. – Prawo o szkolnictwie wyższym i nauce}}, title={{Tekst jednolity (Dz.U. 2024 poz. 1571 z późn. zm.)}}, howpublished={Internetowy System Aktów Prawnych}, year={2018}, publisher={Kancelaria Sejmu RP}, url={https://isap.sejm.gov.pl/isap.nsf/DocDetails.xsp?id=WDU20180001668}}