Metaanaliza – co to jest i czym różni się od przeglądu
Metaanaliza to statystyczne połączenie wyników wielu badań odpowiadających na to samo pytanie w jedno oszacowanie efektu – z przedziałem ufności, oceną różnic między badaniami i oceną możliwego obciążenia. Jest zwykle częścią przeglądu systematycznego: przegląd odpowiada za to, które badania trafiają do syntezy, a metaanaliza – za to, jak je połączyć. Słaby przegląd (wybiórcze wyszukiwanie, brak oceny jakości) da precyzyjnie wyglądający, ale obciążony wynik, bo żadna statystyka nie naprawi złego doboru badań.
Ten poradnik prowadzi przez cały proces – od pytania badawczego do raportu zgodnego z PRISMA 2020 – na jednym przykładzie liczonym w pakiecie metafor. Podstawowe pojęcia (wielkość efektu, I², model efektów losowych) omawiamy krótko w haśle metaanaliza. Jeśli jedno badanie dostarcza kilku efektów (np. kilka miar wyniku albo kilka porównań), potrzebujesz modelu wielopoziomowego – opisujemy go we wpisie metaanaliza wielopoziomowa, umbrella review i PRISMA 2020. Tutaj każde badanie daje jeden niezależny efekt.
Metaanaliza krok po kroku: od pytania do raportu
Siddaway i in. (2019) w przewodniku dla psychologów podkreślają dwie rzeczy, które decydują o jakości całości: wyczerpujące wyszukiwanie, także prac niepublikowanych, i krytyczną ocenę jakości dowodów. Szczegółowe procedury dla przeglądów interwencji opisuje podręcznik Cochrane (Higgins i in., 2024). Cały proces można rozpisać na dziesięć etapów:
| Etap | Co ustalasz | Typowy błąd |
|---|---|---|
| 1. Pytanie | populacja, interwencja lub ekspozycja, porównanie, wynik (PICO), rodzaje badań | pytanie tak szerokie, że łączy się nieporównywalne badania |
| 2. Protokół i rejestracja | kryteria włączenia, źródła, miara efektu, model, analizy wrażliwości – przed wyszukiwaniem | decyzje podejmowane po obejrzeniu wyników (zob. prerejestracja) |
| 3. Wyszukiwanie | bazy, strategia, literatura szara, rejestry badań, kontakt z autorami | jedna baza, tylko artykuły anglojęzyczne i opublikowane |
| 4. Selekcja | dwie niezależne osoby na etapie tytułów i abstraktów oraz pełnych tekstów | brak zapisu, ile prac i dlaczego wykluczono |
| 5. Ekstrakcja danych | formularz: n, M, SD, schemat, moderatory; podwójna ekstrakcja | przepisywanie z abstraktów, pomylone SD i SE |
| 6. Ryzyko błędu | ocena każdego badania standardowym narzędziem | ocena „jakości” jedną sumą punktów |
| 7. Wielkości efektu | wspólna miara i kierunek, wariancja każdego efektu | mieszanie kierunków (wyższy wynik raz lepszy, raz gorszy) |
| 8. Synteza | model efektów losowych, estymator τ², metoda przedziału ufności | model wybrany po tym, jak „wyszło lepiej” |
| 9. Heterogeniczność, moderatory, błąd publikacji, wrażliwość | τ², I², przedział predykcji; moderatory zaplanowane w protokole; wykres lejkowy | testowanie dziesiątek moderatorów przy kilkunastu badaniach |
| 10. Raport | PRISMA 2020: lista kontrolna, diagram przepływu, dostępne dane i kod | brak danych z poszczególnych badań w suplemencie |
Jak zaplanować i opisać wyszukiwanie, pokazujemy w poradniku jak napisać przegląd literatury. Poniżej skupiamy się na etapach 7–10.
Przykład: internetowa terapia poznawczo-behawioralna a lęk społeczny
W przykładzie (dane symulowane) łączymy 18 badań z losowym przydziałem, które porównywały internetową terapię poznawczo-behawioralną (iCBT) z grupą kontrolną. Wynikiem są objawy lęku społecznego po interwencji (niższy wynik = mniej objawów). W 12 badaniach grupą kontrolną była lista oczekujących, w 6 – kontrola aktywna (np. internetowa edukacja o lęku). Badania liczyły od 30 do 189 osób, łącznie 2124 osoby. Z każdego badania mamy to, co zwykle podaje się w artykułach: liczebność, średnią i odchylenie standardowe w obu grupach.
Plik do pobrania: metaanaliza-dane-przyklad.csv – 18 wierszy (jedno badanie w wierszu) z kolumnami badanie, rok, kontrola, n_icbt, m_icbt, sd_icbt, n_kontr, m_kontr, sd_kontr. Wszystkie liczby w tekście pochodzą z kodu w sekcji Metaanaliza w R.
Dane symulowaliśmy celowo w sposób, który przypomina rzeczywistą literaturę: „przeprowadzono” 30 badań, ale do zbioru trafiły wszystkie badania z wynikiem istotnym na korzyść iCBT i tylko co piąte z pozostałych. Prawdziwy przeciętny efekt wynosił 0.60 przy liście oczekujących i 0.25 przy kontroli aktywnej. Dzięki temu na końcu sprawdzimy, czy standardowe narzędzia wykryją ten efekt szuflady.
Krok 7: wspólna miara efektu – g Hedgesa
Badania używały różnych kwestionariuszy, więc surowe różnice średnich są nieporównywalne. Wspólną miarą jest standaryzowana różnica średnich (SMD): różnica średnich podzielona przez łączne odchylenie standardowe. W małych próbach zwykłe d Cohena jest obciążone w górę; Hedges (1981) wyprowadził poprawkę na tę stronniczość i wagi do łączenia wyników wielu badań. Tak powstaje g Hedgesa – w metafor oblicza je funkcja escalc() z miarą "SMD", która od razu podaje wariancję każdego efektu.
Zanim policzysz cokolwiek, ustal kierunek. Tutaj od średniej w grupie kontrolnej odejmujemy średnią w grupie iCBT, więc dodatni g oznacza mniej objawów po iCBT. W przykładzie efekty wahały się od 0.00 do 1.03. Jeśli w części badań wyższy wynik oznacza poprawę, a w części pogorszenie, odwróć znak przed syntezą i zapisz to w protokole.
Inne typowe sytuacje:
- Korelacje łączy się po transformacji z Fishera i przelicza z powrotem na r.
- Wyniki dwuwartościowe – jako logarytm ilorazu szans lub ryzyka względnego.
- Badania podają tylko t, F lub p – SMD da się często z nich odtworzyć; przy schematach wewnątrzobiektowych potrzebna jest korelacja pomiarów, bo inaczej efekty nie są porównywalne z badaniami międzygrupowymi.
Jak interpretować same wielkości efektu i dlaczego progi Cohena nie są regułą, omawiamy w poradniku wielkość efektu – interpretacja.
Krok 8: model efektów losowych z poprawką Knappa–Hartunga
Borenstein i in. (2010) zwracają uwagę, że model efektu wspólnego (stałego) i model efektów losowych używają podobnych wzorów i bywają liczbowo zbliżone, ale opierają się na zasadniczo różnych założeniach. Model efektu wspólnego zakłada, że wszystkie badania szacują ten sam efekt, a różnice wynikają tylko z błędu losowania. Model efektów losowych zakłada, że prawdziwe efekty różnią się między badaniami (inna populacja, wersja interwencji, narzędzie) i szacuje ich średnią oraz rozproszenie τ. W psychologii założenie jednego wspólnego efektu rzadko jest wiarygodne, dlatego domyślnym wyborem jest model efektów losowych.
Ważny jest też sposób liczenia przedziału ufności. Klasyczna metoda DerSimoniana–Lairda daje zbyt wąskie przedziały, gdy badań jest niewiele. IntHout i in. (2014) pokazali w symulacjach, że metoda Hartunga–Knappa–Sidika–Jonkmana konsekwentnie lepiej kontroluje błąd I rodzaju, zwłaszcza przy małej liczbie badań, a w 689 metaanalizach z bazy Cochrane co czwarty wynik istotny metodą DerSimoniana–Lairda (25.1%) przestawał być istotny po tej poprawce. W metafor odpowiada jej opcja test = "knha"; τ² szacujemy metodą REML.
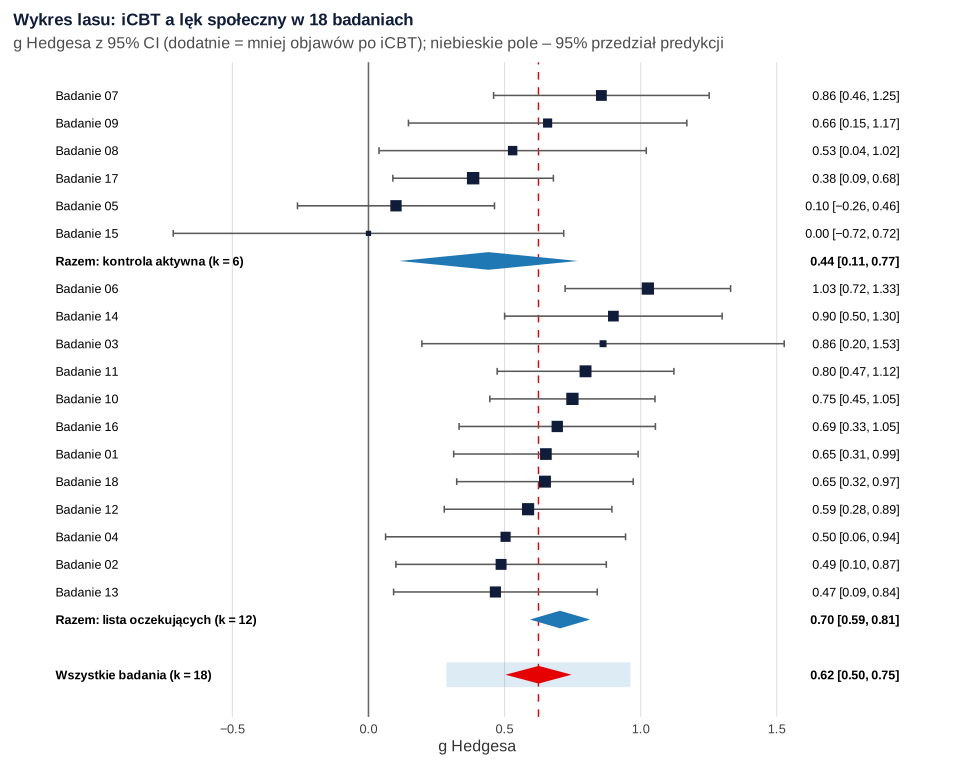
Wynik: średni efekt iCBT wyniósł g = 0.62, 95% CI [0.50, 0.75], t(17) = 10.86, p < .001. Dla porównania model efektu wspólnego dał 0.63 [0.54, 0.72], a model losowy bez poprawki – 0.62 [0.51, 0.74]. Przy umiarkowanej heterogeniczności różnice są niewielkie; poprawka poszerza przedział, a model wspólny go zawęża. Rysunek 1 pokazuje efekty wszystkich badań.
Krok 9a: heterogeniczność – Q, τ², I² i przedział predykcji
Średni efekt to połowa odpowiedzi. Druga połowa brzmi: jak bardzo prawdziwe efekty różnią się między badaniami? Do opisu służą cztery wielkości, które odpowiadają na różne pytania:
- Test Q – czy rozrzut efektów jest większy, niż wynikałoby z samego błędu losowania. Tu Q(17) = 27.42, p = .052. Higgins i in. (2003) przypominają, że przy niewielu badaniach test Q ma małą moc, więc wynik nieistotny nie dowodzi jednorodności.
- τ² i τ – wariancja i odchylenie standardowe prawdziwych efektów, w jednostkach g: τ² = 0.02, 95% CI [0.00, 0.10], τ = 0.15.
- I² – odsetek całkowitej zmienności efektów, który wynika z rzeczywistych różnic, a nie z przypadku: I² = 38.2%, 95% CI [0.0, 73.3]. Higgins i in. (2003) wstępnie nazwali wartości 25%, 50% i 75% heterogenicznością niską, umiarkowaną i wysoką, ale I² zależy od precyzji badań – przy bardzo dużych badaniach nawet małe różnice dają wysokie I². Zauważ też, jak szeroki jest przedział: przy 18 badaniach dane są zgodne zarówno z brakiem heterogeniczności, jak i z heterogenicznością wysoką.
- Przedział predykcji – w jakim zakresie spodziewamy się prawdziwego efektu w nowym, podobnym badaniu: od 0.29 do 0.96. IntHout i in. (2016) zalecają podawać go rutynowo, bo jest łatwiejszy w interpretacji niż τ² czy I². W ich analizie 479 istotnych metaanaliz z bazy Cochrane z heterogenicznością w 72.4% przedział predykcji wskazywał, że efekt w nowym badaniu może być zerowy lub przeciwny.
W przykładzie wniosek z przedziału predykcji jest praktyczny: nawet w mniej korzystnym otoczeniu efekt iCBT pozostaje dodatni, ale może być zarówno mały (około 0.3), jak i duży (około 1.0). To ważniejsza informacja dla klinicysty niż sama średnia 0.62.
Krok 9b: moderatory i analiza podgrup
Heterogeniczność warto spróbować wyjaśnić, ale tylko moderatorami zaplanowanymi w protokole. Najbardziej oczywistym moderatorem w badaniach psychoterapii jest rodzaj grupy kontrolnej: lista oczekujących nie daje uczestnikom żadnej pomocy ani oczekiwań poprawy, kontrola aktywna – tak (zob. efekt placebo i nocebo).
Metaregresja z moderatorem „rodzaj kontroli” wykazała różnicę: przy liście oczekujących efekt był o 0.26 większy, 95% CI [0.02, 0.50], F(1, 16) = 5.36, p = .034. Średni efekt wyniósł g = 0.70, 95% CI [0.59, 0.81], w 12 badaniach z listą oczekujących i g = 0.44, 95% CI [0.11, 0.77], w 6 badaniach z kontrolą aktywną. Moderator wyjaśnił około 57% heterogeniczności (R² = 56.6%), a resztowe I² spadło do 21.1%.
Trzy zastrzeżenia, które warto zapisać w raporcie:
- Porównanie podgrup jest obserwacyjne. Badania z kontrolą aktywną mogą różnić się też innymi cechami (rok, populacja, długość terapii), więc różnica nie musi wynikać z samego rodzaju kontroli. Wniosek o zależności na poziomie badań przenoszony na poziom osób to ryzyko błędu ekologicznego.
- Mała liczba badań w podgrupie. Przy 6 badaniach przedział dla kontroli aktywnej jest szeroki (od 0.11 do 0.77), a I² w tej podgrupie (50.5%) jest bardzo niepewne.
- Nie porównuj „istotności” podgrup. Pytanie brzmi, czy efekty w podgrupach się różnią – odpowiada na nie test moderatora, a nie to, że oba efekty są istotne.
Krok 9c: błąd publikacji i wykres lejkowy
Badania z wynikiem istotnym mają większą szansę na publikację. Franco i in. (2014) w znanej populacji 221 eksperymentów sondażowych stwierdzili, że badania z silnymi wynikami miały o 40 punktów procentowych większą szansę publikacji niż badania z wynikami zerowymi – głównie dlatego, że autorzy w ogóle nie spisywali i nie wysyłali wyników zerowych. W metaanalizie prowadzi to do zawyżenia średniego efektu.
Podstawowym narzędziem diagnostycznym jest wykres lejkowy: efekt każdego badania na tle jego błędu standardowego. Gdy nie ma obciążenia, punkty układają się symetrycznie wokół średniej, a małe badania (duży błąd standardowy) rozpraszają się szerzej. Wersja z konturami istotności (rysunek 2) pokazuje dodatkowo, które badania leżą w strefie wyników nieistotnych.
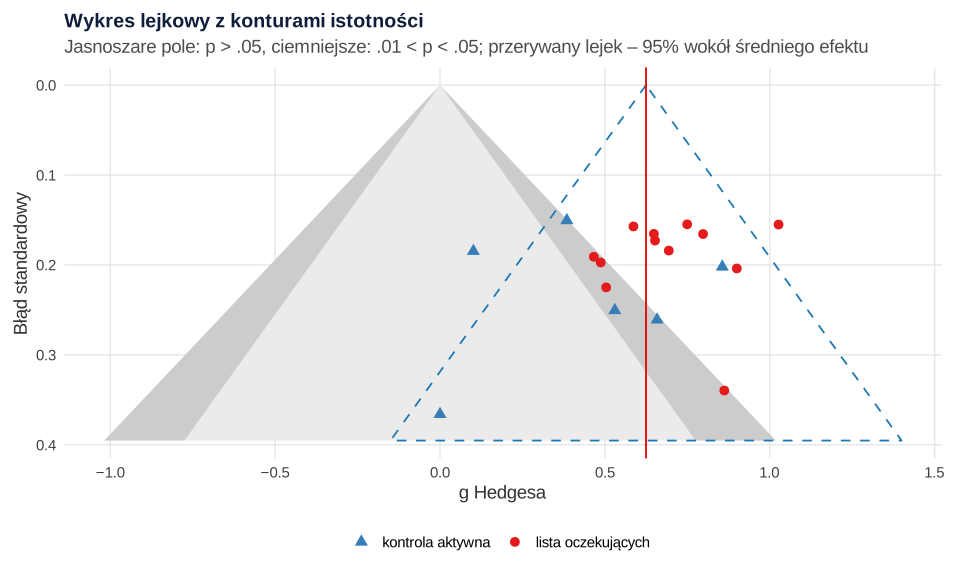
Formalne testy nie wykazały problemu. Test Eggera – regresja efektu na błąd standardowy – dał t(16) = −0.87, p = .399, a metoda trim-and-fill nie dodała żadnego „brakującego” badania (średni efekt bez zmian, 0.62). Tymczasem wiemy, że dane są obciążone: w symulacji opublikowano wszystkie badania istotne i co piąte nieistotne, a oszacowania w podgrupach (0.70 i 0.44) są wyższe od prawdziwych średnich efektów (0.60 i 0.25). Sygnałem ostrzegawczym jest natomiast to, że 16 z 18 badań miało wynik istotny, choć wiele z nich było małych.
Wniosek: brak istotnej asymetrii nie dowodzi braku błędu publikacji. Egger i in. (1997), autorzy testu, ostrzegali, że gdy metaanaliza obejmuje niewiele małych badań, zdolność testu do wykrycia obciążenia jest ograniczona. Asymetria może też wynikać z innych przyczyn niż selektywna publikacja, np. z tego, że małe badania testowały intensywniejsze wersje interwencji. Najlepszą ochroną jest wyszukiwanie w rejestrach badań i literaturze szarej, a w raporcie – kilka analiz wrażliwości zamiast jednego testu.
Krok 9d: analizy wrażliwości
Analiza wrażliwości sprawdza, czy wnioski zależą od pojedynczych decyzji lub badań. Minimum to:
- Pominięcie każdego badania po kolei (leave-one-out). W przykładzie średni efekt mieścił się wtedy między 0.59 a 0.66, a I² między 17.2% a 41.7% – żadne pojedyncze badanie nie zmienia wniosku.
- Diagnostyka wpływu. Funkcja
influence()wskazała jedno badanie wpływowe – Badanie 05 z kontrolą aktywną, z efektem g = 0.10. Sprawdź takie badanie w źródle (pomyłka w ekstrakcji? inna populacja?), ale nie usuwaj go tylko dlatego, że odstaje. - Ograniczenie do badań o niskim ryzyku błędu – zaplanowane w protokole.
- Inny estymator τ² lub inna metoda przedziału – np. porównanie z modelem bez poprawki Knappa–Hartunga, jak w kroku 8.
Krok 10: raport zgodny z PRISMA 2020
Page i in. (2021) opublikowali PRISMA 2020, która zastąpiła wersję z 2009 roku. Obejmuje 27-punktową listę kontrolną, jej rozszerzoną wersję, osobną listę dla streszczenia i zmienione diagramy przepływu dla przeglądów nowych i aktualizowanych. W części metodologicznej opisz: kryteria włączenia, źródła i datę wyszukiwania, proces selekcji i ekstrakcji, ocenę ryzyka błędu, miarę efektu, model i estymator τ², metodę przedziału ufności, analizy heterogeniczności, moderatory, błąd publikacji i analizy wrażliwości. Do raportu dołącz dane z poszczególnych badań i kod – najlepiej w repozytorium, jak opisujemy w poradniku pakiet replikacyjny: dane i kod do artykułu.
Jeśli przygotowujesz metaanalizę do publikacji i potrzebujesz pomocy w przeliczeniu danych z artykułów, wyborze modelu albo odpowiedzi na uwagi recenzentów, zajrzyj do oferty analiz statystycznych dla badaczy.
Metaanaliza w R
Kod odtwarza wszystkie liczby z tekstu i rysunków. Pobierz plik metaanaliza-dane-przyklad.csv do katalogu roboczego i uruchom przepisy 1–4 po kolei w jednej sesji – przepisy 2–4 korzystają z obiektów es i re. Przepis 0 pokazuje, jak powstały dane; nie musisz go uruchamiać. Pakiet metafor opisuje Viechtbauer (2010): obejmuje modele efektu wspólnego i efektów losowych, metaregresję, wykresy lasu i lejkowe, diagnostykę wpływu i testy błędu publikacji.
0. Skąd dane: symulacja 30 badań i selektywnej publikacji
R
# Tworzy plik z danymi symulowanymi do przykładu: badań (RCT) internetowej terapii poznawczo-behawioralnej (iCBT)
# lęku społecznego; wynik: objawy lęku społecznego po interwencji (niższy = lepiej). Do „literatury” trafiają
# wszystkie badania z wynikiem istotnym i tylko część pozostałych – tak powstaje efekt szuflady.
set.seed(1818)
K <- 30; wynik <- list()
for (i in 1:K) {
  kontrola <- sample(c("lista oczekujących", "kontrola aktywna"), 1, prob = c(.55, .45))
  delta <- rnorm(1, ifelse(kontrola == "lista oczekujących", 0.60, 0.25), 0.15)   # prawdziwy efekt w badaniu
  n1 <- round(runif(1, 12, 90)); n2 <- round(n1 * runif(1, 0.85, 1.15))
  sd <- runif(1, 10, 16)
  e <- rnorm(n1, 50 - delta * sd, sd); k <- rnorm(n2, 50, sd)
  p <- t.test(e, k)$p.value
  if (p < .05 && mean(e) < mean(k) || runif(1) < .20)
    wynik[[length(wynik) + 1]] <- data.frame(kontrola, n_icbt = n1, m_icbt = round(mean(e), 1), sd_icbt = round(sd(e), 1),
                                             n_kontr = n2, m_kontr = round(mean(k), 1), sd_kontr = round(sd(k), 1))
}
dane <- do.call(rbind, wynik)
dane <- cbind(badanie = paste0("Badanie ", sprintf("%02d", seq_len(nrow(dane)))), rok = sort(sample(2008:2025, nrow(dane), TRUE)), dane)
write.csv(dane, "metaanaliza-dane-przyklad.csv", row.names = FALSE)
nrow(dane)
Wynik w R
[1] 181. Wielkości efektu: g Hedgesa
R
# Krok 1: od średnich i SD z publikacji do wspólnej miary – g Hedgesa z wariancją (dane symulowane)
options(width = 110)
suppressPackageStartupMessages(library(metafor))   # escalc(), rma(), regtest(), trimfill()
dane <- read.csv("metaanaliza-dane-przyklad.csv")
nrow(dane); table(dane$kontrola)

# SMD z poprawką Hedgesa na małą próbę; znak ustalony tak, by wartość dodatnia = mniej objawów w grupie iCBT
es <- escalc(measure = "SMD", m1i = m_kontr, sd1i = sd_kontr, n1i = n_kontr,
             m2i = m_icbt, sd2i = sd_icbt, n2i = n_icbt, data = dane, slab = badanie)
es$se <- sqrt(es$vi)
print(data.frame(badanie = es$badanie, kontrola = es$kontrola, N = es$n_icbt + es$n_kontr,
                 g = round(as.numeric(es$yi), 2), SE = round(es$se, 3)), row.names = FALSE)
c(N_lacznie = sum(dane$n_icbt + dane$n_kontr), N_min = min(dane$n_icbt + dane$n_kontr),
  N_max = max(dane$n_icbt + dane$n_kontr))
Wynik w R
[1] 18

  kontrola aktywna lista oczekujących
                 6                 12
    badanie           kontrola   N    g    SE
 Badanie 01 lista oczekujących 141 0.65 0.173
 Badanie 02 lista oczekujących 106 0.49 0.197
 Badanie 03 lista oczekujących  38 0.86 0.340
 Badanie 04 lista oczekujących  82 0.50 0.225
 Badanie 05   kontrola aktywna 118 0.10 0.185
 Badanie 06 lista oczekujących 189 1.03 0.155
 Badanie 07   kontrola aktywna 107 0.86 0.202
 Badanie 08   kontrola aktywna  66 0.53 0.250
 Badanie 09   kontrola aktywna  62 0.66 0.261
 Badanie 10 lista oczekujących 179 0.75 0.155
 Badanie 11 lista oczekujących 158 0.80 0.166
 Badanie 12 lista oczekujących 169 0.59 0.157
 Badanie 13 lista oczekujących 113 0.47 0.191
 Badanie 14 lista oczekujących 106 0.90 0.204
 Badanie 15   kontrola aktywna  30 0.00 0.366
 Badanie 16 lista oczekujących 126 0.69 0.184
 Badanie 17   kontrola aktywna 180 0.38 0.150
 Badanie 18 lista oczekujących 154 0.65 0.165
N_lacznie     N_min     N_max
     2124        30       189
2. Model efektów losowych i heterogeniczność
R
# Krok 2: model efektów losowych (REML, Knapp–Hartung), heterogeniczność i przedział predykcji
options(width = 110)

re <- rma(yi, vi, data = es, method = "REML", test = "knha")
re
predict(re, digits = 2)                      # ci.lb/ci.ub – 95% CI średniego efektu; pi.lb/pi.ub – przedział predykcji
confint(re, digits = 2)                      # 95% CI dla τ², τ, I² i H²

# Porównanie: model efektu wspólnego i model losowy bez poprawki Knappa–Hartunga
we <- rma(yi, vi, data = es, method = "EE")
re_z <- rma(yi, vi, data = es, method = "REML")
round(rbind(efekt_wspolny = c(we$b, we$ci.lb, we$ci.ub), losowy_z = c(re_z$b, re_z$ci.lb, re_z$ci.ub),
            losowy_knha = c(re$b, re$ci.lb, re$ci.ub)), 3)
Wynik w R
Random-Effects Model (k = 18; tau^2 estimator: REML)

tau^2 (estimated amount of total heterogeneity): 0.0224 (SE = 0.0202)
tau (square root of estimated tau^2 value):      0.1496
I^2 (total heterogeneity / total variability):   38.17%
H^2 (total variability / sampling variability):  1.62

Test for Heterogeneity:
Q(df = 17) = 27.4192, p-val = 0.0522

Model Results:

estimate      se     tval  df    pval   ci.lb   ci.ub
  0.6246  0.0575  10.8552  17  <.0001  0.5032  0.7459  ***

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


 pred   se ci.lb ci.ub pi.lb pi.ub
 0.62 0.06  0.50  0.75  0.29  0.96


       estimate ci.lb ci.ub
tau^2      0.02  0.00  0.10
tau        0.15  0.00  0.32
I^2(%)    38.17  0.00 73.34
H^2        1.62  1.00  3.75

               [,1]  [,2]  [,3]
efekt_wspolny 0.630 0.543 0.718
losowy_z      0.625 0.511 0.738
losowy_knha   0.625 0.503 0.746
3. Moderator: rodzaj grupy kontrolnej
R
# Krok 3: czy rodzaj grupy kontrolnej wyjaśnia heterogeniczność? (metaregresja z moderatorem kategorialnym)
options(width = 110)

mod <- rma(yi, vi, mods = ~ kontrola, data = es, method = "REML", test = "knha")
mod
# Średni efekt w każdej podgrupie (osobne modele)
podgrupy <- t(sapply(split(es, es$kontrola), function(d) {
  m <- rma(yi, vi, data = d, method = "REML", test = "knha")
  c(k = m$k, g = m$b[1], dolna = m$ci.lb, gorna = m$ci.ub, I2 = m$I2)
}))
round(podgrupy, 2)
Wynik w R
Mixed-Effects Model (k = 18; tau^2 estimator: REML)

tau^2 (estimated amount of residual heterogeneity):     0.0097 (SE = 0.0159)
tau (square root of estimated tau^2 value):             0.0986
I^2 (residual heterogeneity / unaccounted variability): 21.06%
H^2 (unaccounted variability / sampling variability):   1.27
R^2 (amount of heterogeneity accounted for):            56.55%

Test for Residual Heterogeneity:
QE(df = 16) = 20.1895, p-val = 0.2118

Test of Moderators (coefficient 2):
F(df1 = 1, df2 = 16) = 5.3640, p-val = 0.0342

Model Results:

                            estimate      se    tval  df    pval   ci.lb   ci.ub
intrcpt                       0.4377  0.0964  4.5393  16  0.0003  0.2333  0.6421  ***
kontrolalista oczekujących    0.2630  0.1136  2.3160  16  0.0342  0.0223  0.5038    *

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

                    k    g dolna gorna    I2
kontrola aktywna    6 0.44  0.11  0.77 50.47
lista oczekujących 12 0.70  0.59  0.81  1.51
4. Błąd publikacji i wrażliwość
R
# Krok 4: asymetria wykresu lejkowego, trim-and-fill i wpływ pojedynczych badań
options(width = 110)

# Ile badań ma wynik istotny (test z dla pojedynczego g)?
c(istotne = sum(2 * pnorm(-abs(es$yi / es$se)) < .05), wszystkie = nrow(es))
eg <- regtest(re)                            # test Eggera (regresja efektu na błąd standardowy)
round(c(t = eg$zval, df = eg$dfs, p = eg$pval, efekt_przy_SE_0 = unname(eg$est[1]), dolna = eg$ci.lb, gorna = eg$ci.ub), 3)
tf <- trimfill(rma(yi, vi, data = es, method = "REML"))
round(c(dodane_badania = tf$k0, g_po_korekcie = tf$b[1], dolna = tf$ci.lb, gorna = tf$ci.ub), 2)

# Analiza „pomiń jedno badanie”: zakres średniego efektu i I²
l1 <- leave1out(re)
round(c(g_min = min(l1$estimate), g_max = max(l1$estimate), I2_min = min(l1$I2), I2_max = max(l1$I2)), 2)
inf <- influence(re)
es$badanie[inf$is.infl]                      # badania uznane za wpływowe (kryteria funkcji influence)
Wynik w R
  istotne wszystkie
       16        18
              t              df               p efekt_przy_SE_0           dolna           gorna
         -0.867          16.000           0.399           0.833           0.309           1.357
dodane_badania  g_po_korekcie          dolna          gorna
          0.00           0.62           0.51           0.74
 g_min  g_max I2_min I2_max
  0.59   0.66  17.20  41.69
[1] "Badanie 05"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
Najczęstsze błędy w metaanalizie
- Brak protokołu. Kryteria włączenia, miara efektu i moderatory ustalone po obejrzeniu danych to ta sama pułapka co p-hacking w pojedynczym badaniu.
- Wybór modelu według wyniku. Model efektu wspólnego daje węższy przedział; wybierz model na podstawie założeń, nie istotności.
- Raportowanie samego I² jako „miary heterogeniczności”. Podaj τ i przedział predykcji – one mówią, jak różne są efekty w jednostkach wyniku.
- Łączenie efektów zależnych (kilka wyników lub grup z jednego badania) tak, jakby były niezależne. Użyj modelu wielopoziomowego albo wybierz jeden efekt według reguły z protokołu.
- Pomylenie SD z SE przy ekstrakcji: SE pomnożone przez √n to SD; pomyłka zawyża efekt kilkukrotnie.
- „Test Eggera nieistotny, więc nie ma błędu publikacji”. Przy kilkunastu badaniach test ma małą moc, a przykład pokazuje obciążenie, którego test nie wykrył.
- Mnożenie analiz podgrup przy małej liczbie badań i interpretowanie ich jak efektów przyczynowych.
- Diagram PRISMA bez liczb wykluczeń i ich powodów oraz brak danych z poszczególnych badań w suplemencie.
Jeśli planujesz badanie pierwotne na podstawie wyników metaanalizy, przeczytaj też poradnik dobór liczebności próby – efekt z metaanalizy obciążonej selektywną publikacją prowadzi do zbyt małej próby.
Najczęstsze pytania
Ile badań potrzeba do metaanalizy?
Formalnie wystarczą dwa, ale przy niewielu badaniach wariancja między badaniami (τ²) jest szacowana bardzo nieprecyzyjnie, przedział ufności średniego efektu powinien być liczony z poprawką Knappa–Hartunga, a testy heterogeniczności i asymetrii mają małą moc. Analizy moderatorów i ocena błędu publikacji wymagają zwykle co najmniej kilkunastu badań. Mniejszą liczbę badań opisz ostrożnie i raportuj szerokie przedziały.
Czym różni się przedział predykcji od przedziału ufności w metaanalizie?
Przedział ufności mówi, jak precyzyjnie oszacowano średni efekt ze wszystkich badań. Przedział predykcji mówi, w jakim zakresie można się spodziewać prawdziwego efektu w nowym, podobnym badaniu – uwzględnia więc różnice między badaniami (τ). Przy heterogeniczności jest zawsze szerszy i bywa, że obejmuje zero, mimo że średni efekt jest istotny.
Jak przeliczyć średnie i odchylenia standardowe na wielkość efektu do metaanalizy?
Dla dwóch grup oblicz standaryzowaną różnicę średnich: różnicę średnich podziel przez łączne odchylenie standardowe i zastosuj poprawkę Hedgesa na małą próbę, otrzymując g z jego wariancją. W R zrobisz to funkcją escalc() z pakietu metafor (miara "SMD"). Ustal jeden kierunek efektu dla wszystkich badań i sprawdź, czy w artykule podano SD, a nie błąd standardowy.
Czy nieistotny test Eggera oznacza brak błędu publikacji?
Nie. Przy kilkunastu badaniach test ma małą moc, a asymetria wykresu lejkowego może też wynikać z innych przyczyn niż selektywna publikacja. W przykładzie na symulowanych danych, w których celowo opublikowano tylko część badań nieistotnych, test Eggera dał p = .399, mimo że efekty były zawyżone. Uzupełnij go wyszukiwaniem w rejestrach i literaturze szarej oraz analizami wrażliwości.
Jakie elementy metaanalizy wymaga PRISMA 2020?
PRISMA 2020 to 27-punktowa lista kontrolna z rozszerzoną wersją, listą dla streszczenia i diagramem przepływu badań. Wymaga m.in. opisu kryteriów włączenia, źródeł i daty wyszukiwania, procesu selekcji i ekstrakcji, oceny ryzyka błędu, miar efektu i metod syntezy, oceny heterogeniczności i błędu publikacji, analiz wrażliwości oraz informacji o rejestracji protokołu i dostępności danych.
Powiązane hasła
Przeczytaj też
Metaanaliza – wizualizacja na obrazkach
Wykres lasu w dwóch modelach, I² ≈ 0/50/80%, przedział predykcji, lejek z selekcją i 1000 metaanaliz z błędem publikacji – pięć rysunków z kodem R.
Czytaj →PoradnikMetaanaliza w jamovi (MAJOR) krok po kroku
Moduł MAJOR w jamovi: okno Mean Differences, ustawienia domyślne, tabele modelu losowego i heterogeniczności, przedział predykcji, test Eggera i fail-safe N, diagnostyka wpływu – z liczbami z metafor.
Czytaj →PoradnikMetaanaliza wielopoziomowa, umbrella review i PRISMA 2020
Wielkość efektu i przeliczanie danych, modele efektów losowych, metaanaliza trójpoziomowa, umbrella review z klasami dowodów, PRISMA 2020 i kod R.
Czytaj →PoradnikJak napisać przegląd literatury – z AI i bez
Rodzaje przeglądów, zapytania z operatorami Boole’a, selekcja, tabela ekstrakcji i macierz pojęć – oraz to, w czym AI pomaga, a w czym szkodzi.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →Przygotowujesz metaanalizę do publikacji?
Pomożemy przeliczyć dane z artykułów na wielkości efektu, dobrać model i analizy wrażliwości oraz przygotować wyniki i kod tak, by przeszły recenzję.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2010). A basic introduction to fixed-effect and random-effects models for meta-analysis. Research Synthesis Methods, 1(2), 97–111. https://doi.org/10.1002/jrsm.12
- Egger, M., Davey Smith, G., Schneider, M., & Minder, C. (1997). Bias in meta-analysis detected by a simple, graphical test. BMJ, 315(7109), 629–634. https://doi.org/10.1136/bmj.315.7109.629 ● Otwarty dostęp: pełny tekst
- Franco, A., Malhotra, N., & Simonovits, G. (2014). Publication bias in the social sciences: Unlocking the file drawer. Science, 345(6203), 1502–1505. https://doi.org/10.1126/science.1255484
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Higgins, J. P. T., Thomas, J., Chandler, J., Cumpston, M., Li, T., Page, M. J., & Welch, V. A. (Eds.). (2024). Cochrane handbook for systematic reviews of interventions (Version 6.5, updated August 2024). Cochrane. https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current ● Otwarty dostęp
- Higgins, J. P. T., Thompson, S. G., Deeks, J. J., & Altman, D. G. (2003). Measuring inconsistency in meta-analyses. BMJ, 327(7414), 557–560. https://doi.org/10.1136/bmj.327.7414.557 ● Otwarty dostęp: pełny tekst
- IntHout, J., Ioannidis, J. P. A., & Borm, G. F. (2014). The Hartung-Knapp-Sidik-Jonkman method for random effects meta-analysis is straightforward and considerably outperforms the standard DerSimonian-Laird method. BMC Medical Research Methodology, 14(1), Article 25. https://doi.org/10.1186/1471-2288-14-25 ● Otwarty dostęp
- IntHout, J., Ioannidis, J. P. A., Rovers, M. M., & Goeman, J. J. (2016). Plea for routinely presenting prediction intervals in meta-analysis. BMJ Open, 6(7), Article e010247. https://doi.org/10.1136/bmjopen-2015-010247 ● Otwarty dostęp
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., . . . Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, Article n71. https://doi.org/10.1136/bmj.n71 ● Otwarty dostęp
- Siddaway, A. P., Wood, A. M., & Hedges, L. V. (2019). How to do a systematic review: A best practice guide for conducting and reporting narrative reviews, meta-analyses, and meta-syntheses. Annual Review of Psychology, 70(1), 747–770. https://doi.org/10.1146/annurev-psych-010418-102803
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03 ● Otwarty dostęp
Cytowania BibTeX
@article{borenstein2010basic, author={Borenstein, Michael and Hedges, Larry V. and Higgins, Julian P. T. and Rothstein, Hannah R.}, title={{A basic introduction to fixed-effect and random-effects models for meta-analysis}}, journal={Research Synthesis Methods}, year={2010}, volume={1}, number={2}, pages={97--111}, doi={10.1002/jrsm.12}}@article{egger1997bias, author={Egger, Matthias and Davey Smith, George and Schneider, Martin and Minder, Christoph}, title={{Bias in meta-analysis detected by a simple, graphical test}}, journal={BMJ}, year={1997}, volume={315}, number={7109}, pages={629--634}, doi={10.1136/bmj.315.7109.629}}@article{franco2014publication, author={Franco, Annie and Malhotra, Neil and Simonovits, Gabor}, title={{Publication bias in the social sciences: Unlocking the file drawer}}, journal={Science}, year={2014}, volume={345}, number={6203}, pages={1502--1505}, doi={10.1126/science.1255484}}@article{hedges1981distribution, author={Hedges, Larry V.}, title={{Distribution theory for Glass’s estimator of effect size and related estimators}}, journal={Journal of Educational Statistics}, year={1981}, volume={6}, number={2}, pages={107--128}, doi={10.3102/10769986006002107}}@misc{higgins2024cochrane, author={Higgins, Julian P. T. and Thomas, James and Chandler, Jacqueline and Cumpston, Miranda and Li, Tianjing and Page, Matthew J. and Welch, Vivian A.}, title={{Cochrane handbook for systematic reviews of interventions (Version 6.5, updated August 2024)}}, year={2024}, publisher={Cochrane}, url={https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current}}@article{higgins2003measuring, author={Higgins, Julian P. T. and Thompson, Simon G. and Deeks, Jonathan J. and Altman, Douglas G.}, title={{Measuring inconsistency in meta-analyses}}, journal={BMJ}, year={2003}, volume={327}, number={7414}, pages={557--560}, doi={10.1136/bmj.327.7414.557}}@article{inthout2014hartung, author={IntHout, Joanna and Ioannidis, John P. A. and Borm, George F.}, title={{The Hartung-Knapp-Sidik-Jonkman method for random effects meta-analysis is straightforward and considerably outperforms the standard DerSimonian-Laird method}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={25}, doi={10.1186/1471-2288-14-25}}@article{inthout2016plea, author={IntHout, Joanna and Ioannidis, John P. A. and Rovers, Maroeska M. and Goeman, Jelle J.}, title={{Plea for routinely presenting prediction intervals in meta-analysis}}, journal={BMJ Open}, year={2016}, volume={6}, number={7}, eid={e010247}, doi={10.1136/bmjopen-2015-010247}}@article{page2021prisma, author={Page, Matthew J and McKenzie, Joanne E and Bossuyt, Patrick M and Boutron, Isabelle and Hoffmann, Tammy C and Mulrow, Cynthia D and Shamseer, Larissa and Tetzlaff, Jennifer M and Akl, Elie A and Brennan, Sue E and Chou, Roger and Glanville, Julie and Grimshaw, Jeremy M and Hróbjartsson, Asbjørn and Lalu, Manoj M and Li, Tianjing and Loder, Elizabeth W and Mayo-Wilson, Evan and McDonald, Steve and McGuinness, Luke A and Stewart, Lesley A and Thomas, James and Tricco, Andrea C and Welch, Vivian A and Whiting, Penny and Moher, David}, title={{The PRISMA 2020 statement: An updated guideline for reporting systematic reviews}}, journal={BMJ}, year={2021}, volume={372}, eid={n71}, doi={10.1136/bmj.n71}}@article{siddaway2019how, author={Siddaway, Andy P. and Wood, Alex M. and Hedges, Larry V.}, title={{How to do a systematic review: A best practice guide for conducting and reporting narrative reviews, meta-analyses, and meta-syntheses}}, journal={Annual Review of Psychology}, year={2019}, volume={70}, number={1}, pages={747--770}, doi={10.1146/annurev-psych-010418-102803}}@article{viechtbauer2010conducting, author={Viechtbauer, Wolfgang}, title={{Conducting meta-analyses in R with the metafor package}}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={3}, pages={1--48}, doi={10.18637/jss.v036.i03}}