Co to jest efekt szuflady?
Efekt szuflady (problem szuflady, ang. file drawer problem) to zjawisko polegające na tym, że badania z wynikami nieistotnymi albo niezgodnymi z hipotezą rzadziej trafiają do publikacji i zostają „w szufladzie” autorów. Opublikowana literatura nie jest wtedy reprezentatywną próbą przeprowadzonych badań, tylko próbą wybraną według wyniku. Efekt szuflady to najbardziej znana postać błędu publikacyjnego (ang. publication bias).
Nazwę spopularyzował Rosenthal (1979). W skrajnej wersji problemu czasopisma wypełnia 5% badań, które dały błąd I rodzaju, a w szufladach leży 95% badań z wynikami nieistotnymi. Rosenthal zaproponował też sposób oszacowania, ile nieopublikowanych wyników zerowych musiałoby istnieć, by podważyć wniosek z literatury. To tzw. fail-safe N, którego ograniczenia pokazujemy niżej.
Skąd się bierze i jak duży jest problem
Często zakłada się, że winne są czasopisma odrzucające wyniki zerowe. Franco i in. (2014) przeanalizowali znaną populację 221 eksperymentów sondażowych z jednego programu badawczego, dla których wiadomo było, co opublikowano. Badania z silnymi wynikami miały o 40 punktów procentowych większą szansę na publikację niż badania z wynikami zerowymi. Opisania ich szansa była większa aż o 60 punktów procentowych. Główną przyczyną było to, że autorzy nie spisywali i nie wysyłali wyników zerowych, a nie to, że recenzenci je odrzucali.
Skalę zjawiska w psychologii pokazuje porównanie Scheel i in. (2021). W losowej próbie 152 standardowych artykułów pierwsza testowana hipoteza była potwierdzona w 96% przypadków. W 71 artykułach w formacie registered report, w którym decyzja o publikacji zapada przed poznaniem wyników, odsetek ten wynosił 44%. Autorzy wiążą tę różnicę z mniejszym błędem publikacyjnym lub mniejszą inflacją błędu I rodzaju w registered reports.
Skutki efektu szuflady:
- Zawyżone wielkości efektu w literaturze i w metaanalizach – istotność w małych badaniach osiąga się głównie przy przeszacowanym efekcie.
- Fałszywe „ugruntowane” efekty – zjawisko bez realnej podstawy może wyglądać na wielokrotnie potwierdzone.
- Zła analiza mocy kolejnych badań – planowanie liczebności na podstawie zawyżonego efektu daje badania o zbyt małej mocy.
- Marnowanie zasobów – inni badacze powtarzają nieudane próby, bo nie wiedzą o nich.
- Zniekształcone wytyczne praktyczne – terapie, programy szkoleniowe czy interwencje edukacyjne wyglądają na skuteczniejsze, niż są, a decyzje o ich wdrażaniu opierają się na zawyżonych liczbach.
Przykład: 80 badań, 20 opublikowanych
Wyobraź sobie 80 badań tej samej interwencji, np. krótkiego treningu uważności zmniejszającego lęk (dane symulowane). Prawdziwy efekt jest mały, d = 0.15, a liczebności wynoszą od 20 do 80 osób na grupę. Wynik istotny i zgodny z hipotezą publikuje się zawsze, a pozostałe – z prawdopodobieństwem 15%. Opublikowano 20 badań: wszystkie 11 istotnych i 9 z 69 nieistotnych. Pozostałe 60 zostało w szufladzie.
- Metaanaliza wszystkich 80 badań (efekty losowe) daje d = 0.162, 95% CI [0.117, 0.207] – blisko prawdy.
- Metaanaliza 20 opublikowanych daje d = 0.276, 95% CI [0.180, 0.372]. Efekt jest o ok. 70% większy niż w metaanalizie wszystkich badań, a przedział nie obejmuje prawdziwej wartości.
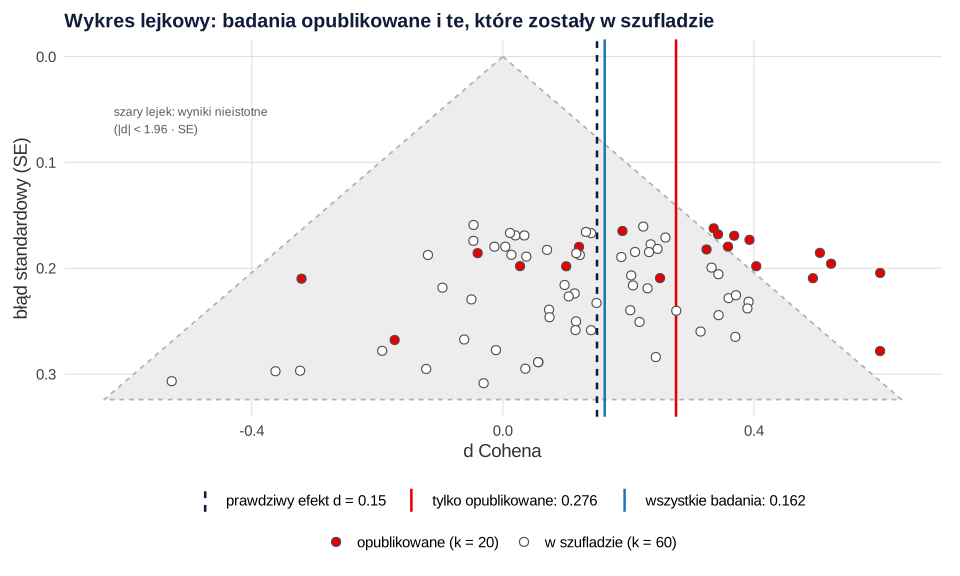
Czy standardowe narzędzia wykryłyby problem, gdyby widoczne było tylko 20 opublikowanych badań? W tym przykładzie – nie:
- Test asymetrii wykresu lejkowego (test Eggera): z = −0.54, p = .592. Egger i in. (1997) ostrzegali, że gdy metaanaliza obejmuje niewiele małych badań, test ma ograniczoną moc. Tutaj liczebności badań różniły się niewiele (20–80 osób na grupę), więc zależność efektu od błędu standardowego była słaba.
- Metoda trim and fill oszacowała 0 brakujących badań.
- Fail-safe N Rosenthala wyniósł 281. Formalnie trzeba by 281 ukrytych badań z efektem zerowym, by wynik łączny stał się nieistotny. To brzmi uspokajająco, a w szufladzie leżało „tylko” 60 badań. Fail-safe N odpowiada jednak na inne pytanie: czy efekt jest różny od zera, a nie, czy jego wielkość jest prawdziwa. Tu efekt istnieje, ale opublikowana literatura zawyża go o ok. 70%.
Istnieją też bardziej zaawansowane metody, np. modele selekcji, które wprost modelują prawdopodobieństwo publikacji w zależności od wartości p, czy regresje efektu na błąd standardowy (PET-PEESE). Wszystkie opierają się jednak na założeniach o mechanizmie selekcji, których nie da się sprawdzić na samych opublikowanych danych. Dlatego w metaanalizie podaje się zwykle kilka z nich jako analizę wrażliwości, zamiast wybierać jedną „właściwą” korektę. Jeśli różne metody dają wyraźnie różne oszacowania, sam ten fakt jest ważną informacją dla czytelnika: wynik łączny jest niepewny bardziej, niż sugeruje przedział ufności.
Brak sygnału w testach nie dowodzi braku efektu szuflady. Dlatego najlepszą ochroną jest nie korekta po fakcie, tylko dotarcie do niepublikowanych wyników i zmiana sposobu publikowania.
Jak przeciwdziałać efektowi szuflady
| Kto | Co może zrobić |
|---|---|
| Autor badania | Zarejestrować plan przed zbieraniem danych (prerejestracja), opublikować wynik niezależnie od istotności, udostępnić dane w repozytorium (pakiet replikacyjny) |
| Czasopismo | Przyjmować registered reports, publikować replikacje i wyniki zerowe |
| Autor metaanalizy | Przeszukiwać rejestry badań, prace dyplomowe, materiały konferencyjne i pytać autorów o niepublikowane dane; raportować wykres lejkowy i testy asymetrii jako analizę wrażliwości, a nie dowód braku problemu |
| Student piszący pracę | Rzetelnie opisać wynik nieistotny – zob. hipoteza się nie potwierdziła – i nie „poprawiać” analiz, by uzyskać p < .05 (p-hacking) |
Efekt szuflady to jeden z mechanizmów stojących za kryzysem replikacyjnym w psychologii. Jest też jednym z powodów, dla których rozwija się ruch open science.
Jak opisać ocenę błędu publikacyjnego w metaanalizie
Pełną procedurę metaanalizy, od wyszukiwania badań po wykres lasu i analizę wrażliwości, opisuje poradnik metaanaliza: jak rzetelnie połączyć wyniki wielu badań.
Symulacja efektu szuflady w R
Kod generuje 80 badań, „publikuje” je według istotności, porównuje metaanalizę wszystkich i opublikowanych badań oraz wykonuje test Eggera, trim and fill i fail-safe N w pakiecie metafor.
Publikacja selektywna i diagnostyka błędu publikacyjnego
R
suppressPackageStartupMessages(library(metafor))
# Dane symulowane: 80 przeprowadzonych badań tej samej interwencji (np. treningu uważności a lęk).
# Prawdziwy efekt d = 0.15; liczebności 20–80 osób na grupę.
# Publikacja: wynik istotny i zgodny z hipotezą – zawsze; pozostałe – z prawdopodobieństwem 0.15.
set.seed(208)
k <- 80
n_gr <- sample(20:80, k, replace = TRUE)
badania <- t(sapply(n_gr, function(n) {
  e <- rnorm(n, 0.15); c <- rnorm(n, 0)
  c(n = n, t = unname(t.test(e, c, var.equal = TRUE)$statistic))
}))
badania <- as.data.frame(badania)
badania$df <- 2 * badania$n - 2
badania$p <- 2 * pt(-abs(badania$t), badania$df)
badania$d <- badania$t * sqrt(2 / badania$n)                     # d Cohena z t
badania$vi <- 2 / badania$n + badania$d^2 / (4 * badania$n)    # wariancja d
badania$opublikowane <- (badania$p < .05 & badania$d > 0) | runif(k) < .15
table(opublikowane = badania$opublikowane, istotne = badania$p < .05 & badania$d > 0)

# Metaanaliza wszystkich przeprowadzonych badań i samych opublikowanych (efekty losowe, REML)
m_wszystkie <- rma(yi = d, vi = vi, data = badania)
m_publ <- rma(yi = d, vi = vi, data = subset(badania, opublikowane))
round(rbind(wszystkie = c(k = m_wszystkie$k, d = m_wszystkie$b[1], dolna = m_wszystkie$ci.lb, gorna = m_wszystkie$ci.ub),
            opublikowane = c(k = m_publ$k, d = m_publ$b[1], dolna = m_publ$ci.lb, gorna = m_publ$ci.ub)), 3)

# Diagnostyka na samych opublikowanych: test Eggera, trim and fill, fail-safe N Rosenthala
eg <- regtest(m_publ)
fp <- function(p) ifelse(p < .001, "< .001", paste("=", sub("^0", "", sprintf("%.3f", p))))
cat(sprintf("Test Eggera (asymetria wykresu lejkowego): z = %.2f, p %s\n", eg$zval, fp(eg$pval)))
trimfill(m_publ)
publ <- subset(badania, opublikowane)
fsn(publ$d, publ$vi)
Wynik w R
            istotne
opublikowane FALSE TRUE
       FALSE    60    0
       TRUE      9   11
              k     d dolna gorna
wszystkie    80 0.162 0.117 0.207
opublikowane 20 0.276 0.180 0.372
Test Eggera (asymetria wykresu lejkowego): z = -0.54, p = .592

Estimated number of missing studies on the right side: 0 (SE = 2.6122)

Random-Effects Model (k = 20; tau^2 estimator: REML)

tau^2 (estimated amount of total heterogeneity): 0.0113 (SE = 0.0154)
tau (square root of estimated tau^2 value):      0.1062
I^2 (total heterogeneity / total variability):   23.62%
H^2 (total variability / sampling variability):  1.31

Test for Heterogeneity:
Q(df = 19) = 27.0112, p-val = 0.1044

Model Results:

estimate      se    zval    pval   ci.lb   ci.ub
  0.2759  0.0491  5.6244  <.0001  0.1798  0.3721  ***

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


Fail-safe N Calculation Using the Rosenthal Approach

Observed Significance Level: <.0001
Target Significance Level:   0.05

Fail-safe N: 281
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 z pakietem metafor; rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Test Eggera był nieistotny, więc błędu publikacyjnego nie ma.” Przy kilkunastu–kilkudziesięciu badaniach test często nie ma mocy; w przykładzie nie wykrył zawyżenia efektu o ok. 70%.
- Fail-safe N jako dowód odporności wyniku. Mówi tylko, ile wyników zerowych obaliłoby istotność, a nie, czy efekt ma właściwą wielkość; zakłada też, że ukryte badania mają efekt dokładnie zerowy.
- Utożsamianie asymetrii wykresu lejkowego z efektem szuflady. Asymetrię mogą też powodować różnice jakości badań lub prawdziwa heterogeniczność efektów.
- Pomijanie niepublikowanych prac w przeglądzie systematycznym (zob. przegląd systematyczny i PRISMA).
- Planowanie liczebności próby na podstawie efektu z opublikowanej literatury bez korekty – efekt prawie na pewno jest zawyżony.
- Nieopisywanie wyników nieistotnych we własnej pracy. Pominięcie ich w rozdziale wyników to efekt szuflady w miniaturze.
Najczęstsze pytania
Co to jest efekt szuflady w nauce?
To sytuacja, w której wyniki nieistotne lub niezgodne z oczekiwaniami nie są publikowane i zostają w szufladzie, a do literatury trafiają głównie wyniki istotne. W efekcie opublikowane badania przeszacowują wielkość efektów, a czasem tworzą wrażenie efektu, którego nie ma.
Czym różni się efekt szuflady od błędu publikacyjnego?
Błąd publikacyjny to szersze pojęcie: każda zależność między wynikiem badania a szansą jego publikacji. Efekt szuflady to jego najczęstsza postać – autorzy nie publikują wyników zerowych. Franco i in. (2014) pokazali, że to głównie autorzy, a nie czasopisma, nie spisywali takich wyników.
Co oznacza fail-safe N Rosenthala?
To liczba nieopublikowanych badań z efektem zerowym, która sprawiłaby, że łączny wynik metaanalizy przestałby być istotny. Duża wartość nie oznacza, że wielkość efektu jest prawdziwa – w symulacji na tej stronie fail-safe N wyniósł 281, a opublikowane badania zawyżały efekt o ok. 70%.
Jak sprawdzić efekt szuflady w metaanalizie?
Przejrzyj wykres lejkowy, wykonaj test asymetrii (np. Eggera) i analizę wrażliwości (np. trim and fill), ale traktuj je jako sygnał, a nie dowód. Przy kilkunastu badaniach testy mają małą moc. Najważniejsze jest szukanie niepublikowanych badań w rejestrach, pracach dyplomowych i u autorów.
Czy w pracy magisterskiej trzeba opisywać nieistotne wyniki?
Tak. Pominięcie wyników nieistotnych to efekt szuflady w miniaturze i zniekształca obraz badania. Opisz je z wielkością efektu i przedziałem ufności oraz omów możliwe przyczyny w dyskusji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Egger, M., Davey Smith, G., Schneider, M., & Minder, C. (1997). Bias in meta-analysis detected by a simple, graphical test. BMJ, 315(7109), 629–634. https://doi.org/10.1136/bmj.315.7109.629 ● Otwarty dostęp: pełny tekst
- Franco, A., Malhotra, N., & Simonovits, G. (2014). Publication bias in the social sciences: Unlocking the file drawer. Science, 345(6203), 1502–1505. https://doi.org/10.1126/science.1255484
- Rosenthal, R. (1979). The file drawer problem and tolerance for null results. Psychological Bulletin, 86(3), 638–641. https://doi.org/10.1037/0033-2909.86.3.638
- Scheel, A. M., Schijen, M. R. M. J., & Lakens, D. (2021). An excess of positive results: Comparing the standard psychology literature with registered reports. Advances in Methods and Practices in Psychological Science, 4(2), Article 25152459211007467. https://doi.org/10.1177/25152459211007467 ● Otwarty dostęp
Cytowania BibTeX
@article{egger1997bias, author={Egger, Matthias and Davey Smith, George and Schneider, Martin and Minder, Christoph}, title={{Bias in meta-analysis detected by a simple, graphical test}}, journal={BMJ}, year={1997}, volume={315}, number={7109}, pages={629--634}, doi={10.1136/bmj.315.7109.629}}@article{franco2014publication, author={Franco, Annie and Malhotra, Neil and Simonovits, Gabor}, title={{Publication bias in the social sciences: Unlocking the file drawer}}, journal={Science}, year={2014}, volume={345}, number={6203}, pages={1502--1505}, doi={10.1126/science.1255484}}@article{rosenthal1979file, author={Rosenthal, Robert}, title={{The file drawer problem and tolerance for null results}}, journal={Psychological Bulletin}, year={1979}, volume={86}, number={3}, pages={638--641}, doi={10.1037/0033-2909.86.3.638}}@article{scheel2021excess, author={Scheel, Anne M. and Schijen, Mitchell R. M. J. and Lakens, Daniël}, title={{An excess of positive results: Comparing the standard psychology literature with registered reports}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={2}, eid={25152459211007467}, doi={10.1177/25152459211007467}}