Co to jest NHST?
NHST (ang. null hypothesis significance testing) to testowanie istotności hipotezy zerowej: procedura, w której zakładasz hipotezę zerową (zwykle „brak różnicy” albo „brak związku”), liczysz, jak nietypowe byłyby uzyskane dane, gdyby ta hipoteza była prawdziwa, i na tej podstawie decydujesz, czy ją odrzucić. Miarą tej nietypowości jest wartość p, a progiem decyzji – poziom istotności α, najczęściej .05.
NHST jest najpopularniejszą odmianą wnioskowania częstościowego (frekwentystycznego). Prawdopodobieństwo rozumie się tu jako częstość w długiej serii powtórzeń badania: p i α mówią, jak często procedura dawałaby określone wyniki, gdyby badanie powtarzać wiele razy przy tych samych założeniach. Prawie każdy test statystyczny w pracy z psychologii – test t, ANOVA, chi-kwadrat, test współczynnika regresji – jest stosowany właśnie w tej logice. Nickerson (2000) w obszernym przeglądzie sporu o NHST konkluduje, że procedura ta jest łatwa do błędnego zrozumienia i nadużycia, ale stosowana rozważnie pomaga interpretować dane.
Skąd się wzięło NHST: Fisher i Neyman–Pearson
Szkolne NHST to połączenie dwóch różnych koncepcji. Perezgonzalez (2015) pokazuje, że to połączenie jest niespójne, i radzi uczyć obu podejść osobno.
| Element | Testy istotności (Fisher) | Testy decyzyjne (Neyman–Pearson) | NHST w praktyce |
|---|---|---|---|
| Hipotezy | tylko zerowa | zerowa i alternatywna z konkretną wielkością efektu | zerowa i ogólna alternatywna („różnica istnieje”) |
| Rola p | stopniowalna miara dowodu przeciw H0 | nieistotna – liczy się tylko, czy wynik wpadł do obszaru odrzucenia | porównywana z .05, a potem i tak opisywana jako „siła dowodu” |
| α i moc | brak z góry ustalonej mocy | α i β ustalone przed badaniem, liczebność z analizy mocy | α = .05 z przyzwyczajenia, moc często pomijana |
| Wniosek | ocena danych w kontekście innych badań | decyzja z kontrolą błędów w długiej serii | „istotne – efekt jest”, „nieistotne – efektu nie ma” |
Z podejścia Neymana–Pearsona pochodzi rozróżnienie błędów I i II rodzaju: α to dopuszczalny odsetek fałszywych alarmów, gdy H0 jest prawdziwa, a β – odsetek przeoczonych efektów, gdy prawdziwa jest alternatywa o określonej wielkości. Kontrola tych błędów działa tylko wtedy, gdy α, test i liczebność ustalisz przed zobaczeniem danych.
Procedura NHST krok po kroku
- Sformułuj H0 i H1. Na przykład H0: średni lęk przed egzaminem jest taki sam w obu grupach; H1: średnie się różnią (test dwustronny – zob. test jednostronny i dwustronny).
- Ustal α i liczebność. Przyjmij α = .05 (albo uzasadnij inną wartość) i policz liczebność potrzebną do wykrycia najmniejszego interesującego efektu z mocą .80 lub .90.
- Wybierz test i sprawdź jego założenia – tu test t Welcha dla dwóch niezależnych grup.
- Policz statystykę testową i p: prawdopodobieństwo uzyskania statystyki co najmniej tak skrajnej jak obserwowana, gdyby H0 i wszystkie założenia modelu były prawdziwe.
- Podejmij decyzję: p ≤ α – odrzucasz H0; p > α – nie masz podstaw do jej odrzucenia. To nie to samo co „przyjęcie H0”.
- Uzupełnij decyzję estymacją: wielkością efektu i przedziałem ufności. Cumming (2014) przekonuje, że to estymacja, a nie sama dychotomia „istotne–nieistotne”, powinna być podstawą wniosków.
Przykład: trening oddechowy a lęk przed egzaminem
Osiemdziesięciu studentów (dane symulowane) losowo przydzielono do krótkiego treningu oddechowego albo do grupy kontrolnej, po 40 osób. Tydzień później wypełnili skalę lęku przed egzaminem (1–5, wyższy wynik – silniejszy lęk). Wyniki:
- trening: M = 2.91, SD = 0.78; kontrola: M = 3.21, SD = 0.74;
- test t Welcha: t(77.79) = −1.75, p = .084;
- różnica średnich −0.30, 95% CI [−0.63, 0.04]; d Cohena = −0.39, 95% CI [−0.83, 0.05].
Ponieważ p > .05, nie odrzucamy H0. Nie wolno jednak napisać, że trening „nie działa”. Przedział ufności obejmuje zarówno brak różnicy, jak i spadek lęku o ponad pół punktu skali. Dane są więc zgodne z efektem zerowym i z efektem praktycznie istotnym – badanie po prostu nie rozstrzyga sprawy. Gdyby autorzy chcieli wykazać brak efektu, potrzebowaliby testu równoważności albo czynnika Bayesa.
Przyczyna jest widoczna w planowaniu w duchu Neymana–Pearsona. Aby wykryć efekt d = 0.50 z mocą .80 przy α = .05, potrzeba 64 osób w grupie. Przy 40 osobach moc wynosi tylko .60: nawet jeśli efekt d = 0.50 naprawdę istnieje, 4 na 10 takich badań dadzą wynik nieistotny.
Jak zachowuje się wartość p w długiej serii badań
Rysunek 1 pokazuje częstościową logikę NHST. Przeprowadzono 10 000 symulowanych badań z takim samym planem jak w przykładzie (40 osób w grupie): raz przy prawdziwej H0, raz przy prawdziwym efekcie d = 0.50.
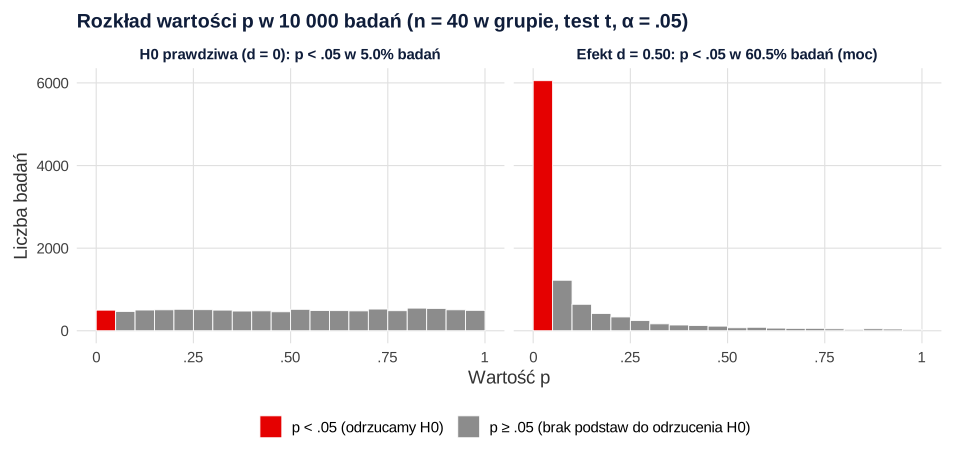
Z symulacji wynikają trzy wnioski:
- α działa jak obietnica długookresowa. Gdy H0 jest prawdziwa, p < .05 pojawiło się w 5.0% badań – dokładnie tyle, ile zakłada α. Obietnica przestaje obowiązywać, gdy analizę zmienia się po obejrzeniu danych (zob. p-hacking).
- Pojedyncze p jest bardzo zmienne. Nawet przy prawdziwym efekcie mediana p wyniosła .027, a połowa wyników mieściła się między .004 a .116. Wynik nieistotny w jednym badaniu i istotny w drugim nie musi więc oznaczać sprzecznych ustaleń.
- p tuż poniżej .05 to słaby dowód. Wartości od .04 do .05 wystąpiły w 0.98% badań bez efektu i w 3.99% badań z efektem – nieco częściej, ale ten sam wynik zdarza się w obu sytuacjach.
Krytyka NHST i co z niej wynika
Najczęstszy zarzut nie dotyczy matematyki, tylko interpretacji. Wasserstein i Lazar (2016) w oświadczeniu American Statistical Association przypominają, że p nie jest prawdopodobieństwem prawdziwości hipotezy ani miarą wielkości efektu, a wniosków nie powinno się opierać wyłącznie na przekroczeniu progu. Greenland i in. (2016) zebrali 25 typowych błędnych interpretacji wartości p, przedziałów ufności i mocy. Wskazują też, że wybieranie analiz do pokazania na podstawie wartości p może dawać małe p nawet wtedy, gdy testowana hipoteza jest prawdziwa.
W praktyce NHST nie musisz porzucać. Wystarczy, że uzupełnisz ją elementami, których brakuje w hybrydzie:
- planuj liczebność i najmniejszy interesujący efekt przed badaniem;
- zapisz hipotezy i plan analizy z góry (prerejestracja);
- raportuj efekty z przedziałami ufności, a wynik nieistotny opisuj jako nierozstrzygający, chyba że test równoważności pokaże coś więcej;
- przy wielu testach kontroluj błąd I rodzaju (problem wielokrotnych porównań).
Pełny mechanizm powstawania wartości p – od rozkładu z prób po pole pod krzywą – opisuje wpis P value krok po kroku, a interpretację pojedynczego wyniku – Wartość p: co naprawdę oznacza.
Jak opisać wynik testu w pracy (APA)
W metodzie podaj α, rodzaj testu (jedno- czy dwustronny) i uzasadnienie liczebności. W wynikach podaj statystykę ze stopniami swobody, dokładne p, wielkość efektu i przedział ufności. Wynik nieistotny opisz bez słów „brak wpływu” i „brak różnicy”.
NHST w R
Kod tworzy dane z przykładu, liczy test t Welcha i d Cohena, wykonuje analizę mocy w duchu Neymana–Pearsona i symuluje 10 000 badań, aby pokazać rozkład wartości p przy prawdziwej H0 i przy efekcie d = 0.50. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Test, decyzja, moc i symulacja wartości p
R
# Dane symulowane: lęk przed egzaminem (1–5), trening oddechowy vs kontrola
set.seed(210)
n <- 40                                                   # osób w grupie
dane <- data.frame(
  grupa = factor(rep(c("trening", "kontrola"), each = n), levels = c("trening", "kontrola")),
  lek   = round(c(rnorm(n, 2.85, 0.70), rnorm(n, 3.20, 0.70)), 2))
dane$lek <- pmin(pmax(dane$lek, 1), 5)

# 1. Statystyki opisowe
aggregate(lek ~ grupa, data = dane, function(x) c(M = mean(x), SD = sd(x), n = length(x)))

# 2. Test t (Welcha) dla H0: μ_trening = μ_kontrola, α = .05, test dwustronny
wynik <- t.test(lek ~ grupa, data = dane)
wynik

# 3. Wielkość efektu: d Cohena z 95% CI
effectsize::cohens_d(lek ~ grupa, data = dane)

# 4. Podejście Neymana–Pearsona: liczebność dla d = 0.50, α = .05, moc .80
power.t.test(delta = 0.5, sd = 1, sig.level = 0.05, power = 0.80)
power.t.test(n = 40, delta = 0.5, sd = 1, sig.level = 0.05)$power   # moc przy n = 40

# 5. Symulacja: 10 000 badań z n = 40 w grupie, gdy H0 jest prawdziwa i gdy d = 0.50
sym_p <- function(delta, R = 10000) replicate(R, t.test(rnorm(n, delta), rnorm(n, 0))$p.value)
p_h0 <- sym_p(0)
p_h1 <- sym_p(0.5)
round(c(odsetek_p_ponizej_05_H0 = mean(p_h0 < .05), odsetek_p_ponizej_05_H1 = mean(p_h1 < .05)), 3)
round(c(H0_p_od_.04_do_.05 = mean(p_h0 > .04 & p_h0 < .05), H1_p_od_.04_do_.05 = mean(p_h1 > .04 & p_h1 < .05)), 4)
round(quantile(p_h1, c(.25, .50, .75)), 3)
Wynik w R
     grupa      lek.M     lek.SD      lek.n
1  trening  2.9132500  0.7760597 40.0000000
2 kontrola  3.2092500  0.7367162 40.0000000

	Welch Two Sample t-test

data:  lek by grupa
t = -1.7495, df = 77.79, p-value = 0.08415
alternative hypothesis: true difference in means between group trening and group kontrola is not equal to 0
95 percent confidence interval:
 -0.63284709  0.04084709
sample estimates:
 mean in group trening mean in group kontrola
               2.91325                3.20925

Cohen's d |        95% CI
-------------------------
-0.39     | [-0.83, 0.05]

- Estimated using pooled SD.
     Two-sample t test power calculation

              n = 63.76576
          delta = 0.5
             sd = 1
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group

[1] 0.5981316
odsetek_p_ponizej_05_H0 odsetek_p_ponizej_05_H1
                  0.050                   0.605
H0_p_od_.04_do_.05 H1_p_od_.04_do_.05
            0.0098             0.0399
  25%   50%   75%
0.004 0.027 0.116
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „p = .03, więc H0 jest prawdziwa z prawdopodobieństwem 3%”. p liczy się przy założeniu, że H0 jest prawdziwa, więc nie może mówić, jak prawdopodobna ona jest.
- „Nieistotny, więc efektu nie ma”. W przykładzie p = .084 przy przedziale ufności sięgającym −0.83 SD.
- Porównywanie istotności zamiast efektów. To, że w jednej grupie wynik jest istotny, a w drugiej nie, nie dowodzi różnicy między grupami – trzeba ją przetestować bezpośrednio.
- α ustalone po fakcie – np. „wynik na granicy istotności” przy p = .08 albo zmiana testu na jednostronny po zobaczeniu kierunku różnicy.
- Brak analizy mocy. Bez niej wynik nieistotny jest prawie nieinterpretowalny, a wynik istotny z małej próby zwykle zawyża efekt.
- Utożsamianie istotności statystycznej z praktyczną. W dużej próbie istotna bywa różnica, której nikt nie zauważy w codziennym funkcjonowaniu.
Najczęstsze pytania
Co oznacza skrót NHST?
NHST to null hypothesis significance testing, czyli testowanie istotności hipotezy zerowej. Badacz zakłada hipotezę zerową, oblicza wartość p i porównuje ją z poziomem istotności α (zwykle .05). Gdy p ≤ α, odrzuca hipotezę zerową; w przeciwnym razie nie ma podstaw, by ją odrzucić.
Czym różni się podejście Fishera od podejścia Neymana–Pearsona?
Fisher traktował wartość p jako stopniowalną miarę dowodu przeciw jednej hipotezie, bez z góry ustalonej mocy. Neyman i Pearson zaproponowali procedurę decyzyjną z dwiema hipotezami, z góry ustalonymi α i β i liczebnością dobraną do wielkości efektu. Szkolne NHST łączy oba podejścia, co bywa źródłem nieporozumień.
Dlaczego NHST jest krytykowane?
Głównie z powodu błędnych interpretacji: traktowania p jako prawdopodobieństwa prawdziwości hipotezy, utożsamiania istotności z wielkością efektu i uznawania wyniku nieistotnego za dowód braku efektu. Do tego dochodzą mechaniczne stosowanie progu .05 i analizy zmieniane po obejrzeniu danych, które unieważniają kontrolę błędu I rodzaju.
Czy zamiast NHST można stosować przedziały ufności albo statystykę bayesowską?
Tak. Przedziały ufności i wielkości efektu pokazują, jak duży może być efekt, a czynnik Bayesa porównuje, na ile dane lepiej pasują do jednej hipotezy niż do drugiej. W pracach dyplomowych najczęściej łączy się NHST z estymacją: podaje się p, wielkość efektu i 95% przedział ufności.
Co znaczy, że wartość p „zachowuje się” różnie przy prawdziwej i fałszywej H0?
Gdy hipoteza zerowa jest prawdziwa, każda wartość p od 0 do 1 jest równie prawdopodobna, więc p < .05 wypada w 5% badań. Gdy istnieje efekt, wartości p skupiają się blisko zera, a odsetek wyników istotnych równa się mocy testu. Dlatego pojedyncze p mocno się waha między replikacjami.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
P value krok po kroku
Jak powstaje wartość p: rozkład z prób, centralne twierdzenie graniczne, błąd standardowy, statystyka Z i pole pod krzywą – z przykładem i tablicą Z.
Czytaj →PoradnikWartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Nickerson, R. S. (2000). Null hypothesis significance testing: A review of an old and continuing controversy. Psychological Methods, 5(2), 241–301. https://doi.org/10.1037/1082-989X.5.2.241
- Perezgonzalez, J. D. (2015). Fisher, Neyman-Pearson or NHST? A tutorial for teaching data testing. Frontiers in Psychology, 6, Article 223. https://doi.org/10.3389/fpsyg.2015.00223 ● Otwarty dostęp
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
Cytowania BibTeX
@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{nickerson2000null, author={Nickerson, Raymond S.}, title={{Null hypothesis significance testing: A review of an old and continuing controversy}}, journal={Psychological Methods}, year={2000}, volume={5}, number={2}, pages={241--301}, doi={10.1037/1082-989x.5.2.241}}@article{perezgonzalez2015fisher, author={Perezgonzalez, Jose D.}, title={{Fisher, Neyman-Pearson or NHST? A tutorial for teaching data testing}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={223}, doi={10.3389/fpsyg.2015.00223}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}