Wynik nieistotny to informacja, a nie porażka
Analiza skończona, a przy najważniejszej hipotezie stoi p = .235. Pierwsza myśl: badanie się nie udało, trzeba coś „poprawić”, może dobrać osoby albo zmienić test. Zatrzymaj się. Celem badania jest sprawdzenie hipotez, a nie ich potwierdzenie. Wynik nieistotny jest pełnoprawnym wynikiem, o ile uczciwie go przeanalizujesz i opiszesz. O ocenie pracy decydują kryteria Twojej uczelni i komisja – tego nie obiecamy.
Wartość p większa od .05 oznacza tylko tyle, że dane nie pozwoliły odrzucić hipotezy zerowej na przyjętym poziomie istotności. Nie oznacza, że efektu nie ma. Amrhein i in. (2019), wspierani przez ponad 800 sygnatariuszy, apelują, by nie wnioskować o braku różnicy tylko dlatego, że p > .05, a przedziały ufności traktować jako „przedziały zgodności” i omawiać praktyczne konsekwencje wszystkich wartości, które się w nich mieszczą.
Nieistotny wynik może znaczyć dwie zupełnie różne rzeczy: że dane przemawiają przeciw hipotezie albo że badanie było zbyt mało czułe, by cokolwiek rozstrzygnąć. Dienes (2014) przypomina, że żaden wniosek nie wynika z wyniku nieistotnego automatycznie. Żeby odróżnić te dwie sytuacje, trzeba sięgnąć po moc testu, przedziały ufności albo czynnik Bayesa. Tak też zbudowaliśmy ten poradnik:
- Czego nie robić – sześć pokus po nieistotnym wyniku.
- Diagnoza – wielkość efektu, przedział ufności i analiza wrażliwości.
- Brak efektu czy „nie wiadomo”? – test równoważności TOST i czynnik Bayesa.
- Opis – wzory do rozdziału wyników, analizy eksploracyjne i rozmowa z promotorem.
Jak pisać o wynikach nieistotnych w dyskusji, opisujemy osobno w poradniku jak napisać dyskusję wyników. Tutaj zajmujemy się tym, co dzieje się wcześniej: analizą i decyzjami.
| Stwierdzenie | Czy wynika z p > .05? | Co zrobić zamiast tego |
|---|---|---|
| „Nie wykazano różnicy na poziomie α = .05” | Tak | Napisz to wprost, z wielkością efektu i przedziałem ufności |
| „Efektu nie ma”, „grupy są takie same” | Nie | Policz test równoważności albo czynnik Bayesa |
| „Badanie było źle zaplanowane” | Nie | Sprawdź analizą wrażliwości, jaki efekt badanie mogło wykryć |
| „Wynik był prawie istotny” | Nie | Podaj dokładne p i przedział ufności, bez etykiet |
Przykład: dwa badania, oba z wynikiem nieistotnym
Przez cały poradnik pracujemy na dwóch badaniach z tym samym pytaniem (dane symulowane, analizy w R). Czy 15-minutowe ćwiczenie oddechowe wykonane przed kolokwium obniża lęk egzaminacyjny? Lęk mierzono skalą od 1 do 5 (średnia z 10 pozycji). Osoby losowo przydzielano do grupy ćwiczenia albo do grupy kontrolnej, która w tym czasie czytała neutralny tekst. Hipoteza brzmiała: po ćwiczeniu lęk będzie niższy niż w grupie kontrolnej.
- Badanie A to typowa praca magisterska: po 30 osób w grupie.
- Badanie B ma po 250 osób w grupie, np. jako duże badanie internetowe.
Przed badaniem ustalono też, że ćwiczenie ma sens praktyczny, jeśli obniża lęk co najmniej o 0.25 punktu. To mniej więcej 0.3 odchylenia standardowego, czyli d ≈ 0.31. Mniejszej różnicy nie warto by polecać jako rady przed egzaminem. Ta wartość wróci w kroku 4 jako granica równoważności.
| Wynik | Badanie A (2 × 30 osób) | Badanie B (2 × 250 osób) |
|---|---|---|
| Grupa kontrolna: M (SD) | 3.05 (0.84) | 3.22 (0.79) |
| Grupa ćwiczenia: M (SD) | 2.79 (0.79) | 3.16 (0.78) |
| Różnica średnich, 95% CI | 0.25 [−0.17, 0.68] | 0.06 [−0.08, 0.20] |
| Test t Welcha | t(57.74) = 1.20, p = .235 | t(497.92) = 0.89, p = .372 |
| d Cohena, 95% CI | 0.31 [−0.20, 0.82] | 0.08 [−0.10, 0.26] |
Oba wyniki są nieistotne i w wielu pracach zostałyby opisane tym samym zdaniem: „hipoteza się nie potwierdziła”. Za chwilę zobaczysz, że znaczą coś zupełnie innego.
Czego nie robić: sześć pokus po nieistotnym wyniku
Każda z tych decyzji wygląda niewinnie, gdy podejmujesz ją jeden raz. Problem w tym, że podejmujesz ją po zobaczeniu wyniku i tylko w jedną stronę – dopóki nie wyjdzie p < .05. Simmons i in. (2011) pokazali w symulacjach i dwóch eksperymentach, że taka nieujawniona elastyczność w zbieraniu, analizie i raportowaniu danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Zbiorczo nazywa się to p-hackingiem.
- Zmiana testu „do skutku”. Najpierw test Welcha, potem test Manna–Whitneya, potem test jednostronny. Test wybierasz przed analizą, na podstawie hipotezy i rodzaju danych. Przejście po fakcie na test jednostronny to po prostu podwojenie α w wygodnym kierunku.
- Usuwanie osób bez reguły ustalonej wcześniej. „Ta osoba odpowiadała dziwnie”, „te wyniki odstają”. Wykluczenia są w porządku, jeśli kryteria opisałeś przed analizą (np. błędne odpowiedzi na pytania kontrolne). Jak postępować z obserwacjami odstającymi, opisujemy w poradniku wartości odstające.
- Dobieranie zmiennych i podgrup. Inna zmienna zależna, inny wskaźnik, dodanie albo usunięcie zmiennej kontrolnej, analiza „tylko dla kobiet”. Każdy nowy wariant to kolejny los na loterii.
- Dobieranie osób, aż wynik będzie istotny. Dopuszczalne tylko wtedy, gdy plan badania przewidywał to przed zebraniem danych, razem ze sposobem kontroli błędu I rodzaju.
- Zmiana hipotezy po fakcie. Kerr (1998) nazywa przedstawianie hipotezy sformułowanej po poznaniu wyników tak, jakby powstała przed badaniem, HARKingiem. Rubin (2017) zalicza do jego form także pomijanie niepotwierdzonych hipotez, ustalonych przed badaniem. Hipotezy zostają więc w brzmieniu z rozdziału metodologicznego.
- „Trend w kierunku istotności”. Wood i in. (2014) pokazali w analizie ilościowej, że opisywanie wyników nieistotnych jako „trendu” albo sugerowanie, że do istotności zabrakło danych, daje mylące wrażenie i podważa zasadę rzetelnego raportowania. Podaj dokładne p – zob. część „Czego nie pisać” poradnika o wynikach w stylu APA.
Ile kosztuje taka elastyczność? Sprawdziliśmy to symulacją: 20 000 razy wylosowaliśmy dwie grupy po 30 osób z populacji, w której różnicy nie ma. Dla każdego zbioru „badacz” po kolei dokładał kolejne próby: test Manna–Whitneya, usunięcie wyników powyżej 2 SD, drugą zmienną zależną, a na końcu dobranie 10 osób do każdej grupy. Rysunek 1 pokazuje, jak rósł odsetek badań z co najmniej jednym wynikiem p < .05.
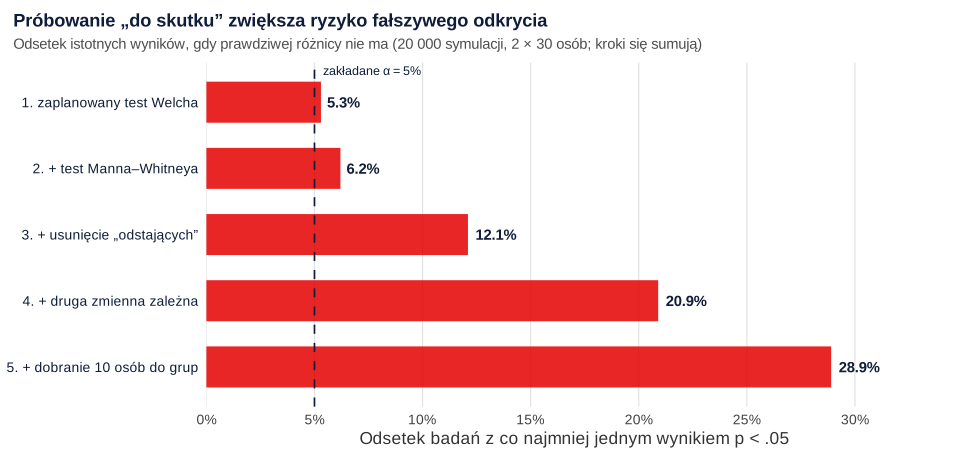
Zaplanowany test myli się zgodnie z umową, w 5.3% symulacji (to 5% z dokładnością do losowania). Po pięciu „niewinnych” próbach fałszywy alarm pojawia się już w 28.9% badań, czyli ponad pięć razy częściej. Zwróć uwagę na krok 3: samo usunięcie wyników powyżej 2 SD w każdej grupie i powtórzenie testu podwaja ryzyko. Odchylenie standardowe liczone po takim „czyszczeniu” jest zaniżone, więc test staje się zbyt liberalny. Wynik uzyskany „do skutku” nie jest więc „trochę gorszy” – w dużej części przypadków jest po prostu fałszywy.
Nie znaczy to, że poza planem nie wolno policzyć niczego – wolno, ale jako wyraźnie oznaczone analizy eksploracyjne (piszemy o nich niżej).
Krok 1 i 2: wielkość efektu i przedział ufności
Krok 1. Popatrz na efekt, a nie tylko na p
Wielkość efektu mówi, jak duża była różnica, niezależnie od liczebności próby. W badaniu A średni lęk w grupie ćwiczenia był niższy o 0.25 punktu, czyli d = 0.31. Takiego efektu wcale nie trzeba lekceważyć, bo jest praktycznie równy najmniejszemu efektowi uznanemu wcześniej za ważny. W badaniu B różnica wyniosła 0.06 punktu (d = 0.08), czyli niewiele ponad jedną dwudziestą punktu na skali od 1 do 5. Jak czytać d, wyjaśniamy w haśle d Cohena – interpretacja.
Krok 2. Sprawdź, co wyklucza przedział ufności
Przedział ufności pokazuje zakres wartości efektu zgodnych z danymi. Lakens (2022) radzi przy ocenie badania zadać sobie m.in. pytania, jakie wielkości efektu wyklucza przedział ufności i jakie efekty badanie mogło wykryć. To drugie pytanie to krok 3.
- Badanie A: 95% CI [−0.17, 0.68] punktu, czyli dla d od −0.20 do 0.82. Z danymi zgodny jest brak efektu, efekt niewielki, ale też efekt duży, prawie trzykrotnie większy od tego, który uznano za ważny. Dane niczego nie wykluczają, więc wynik jest nierozstrzygnięty.
- Badanie B: 95% CI [−0.08, 0.20]. Wszystkie wartości zgodne z danymi są mniejsze niż 0.25 punktu. To już mocna wskazówka, że efektu o praktycznym znaczeniu nie ma. Formalnie sprawdzisz to testem równoważności w kroku 4.
Krok 3: analiza wrażliwości – jaki efekt badanie mogło wykryć?
Analiza wrażliwości (ang. sensitivity power analysis) odwraca zwykłą analizę mocy. Nie pytasz, ile osób potrzeba, tylko: przy mojej liczebności, α = .05 i mocy 80% – jaki najmniejszy efekt mogłem wykryć? Lakens (2022) wymienia ją wśród pytań, które pozwalają ocenić, czego dane mogą nas nauczyć. Policzysz ją w G*Power (typ analizy Sensitivity: Compute required effect size – given α, power, and sample size; zob. hasło analiza mocy a priori w G*Power) albo jedną funkcją w R.
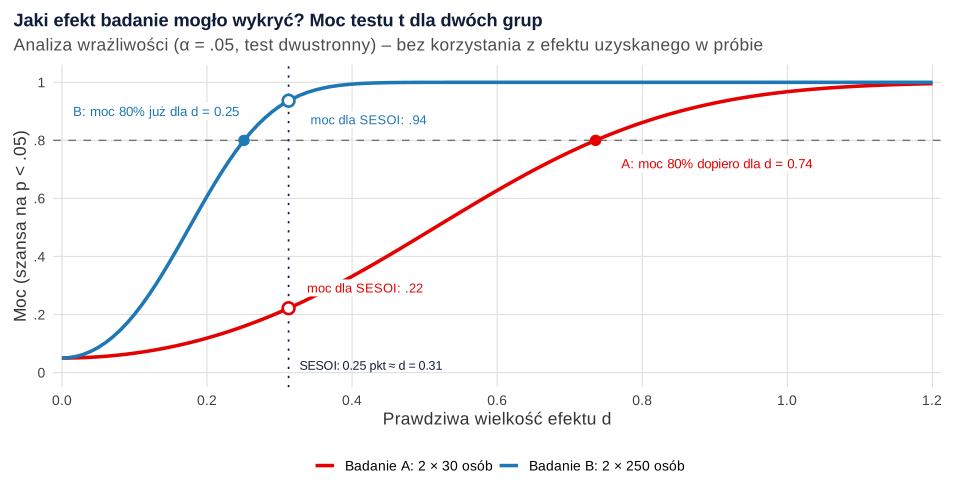
power.t.test (α = .05, test dwustronny).| Pytanie | Badanie A (2 × 30) | Badanie B (2 × 250) |
|---|---|---|
| Efekt wykrywany z mocą 80% | d = 0.74 | d = 0.25 |
| Efekt wykrywany z mocą 50% | d = 0.52 | d = 0.18 |
| Najmniejszy efekt w próbie, który dałby p < .05 | d = 0.52 | d = 0.18 |
| Moc dla efektu uznanego za ważny (0.25 pkt, d ≈ 0.31) | .22 | .94 |
Badanie A miało tylko 22% szans na wykrycie efektu, który z góry uznano za ważny, a istotny byłby w nim dopiero efekt d ≥ 0.52 w próbie. Nieistotność była więc najbardziej prawdopodobnym wynikiem, nawet gdyby ćwiczenie działało dokładnie tak, jak zakładano. Do wykrycia różnicy 0.25 punktu z mocą 80% potrzeba 162 osób w każdej grupie. Badanie B miało dla tego efektu moc .94, więc brak istotności znaczy w nim znacznie więcej.
Dlaczego nie „moc post hoc”?
Kusi, by policzyć moc z efektu uzyskanego w próbie (tzw. moc obserwowaną) i dopisać ją do wyniku. Hoenig i Heisey (2001) nazywają takie obliczanie mocy po badaniu, w celu interpretacji wyniku nieistotnego, podejściem z gruntu błędnym. Moc obserwowana jest prostą funkcją wartości p: przy wyniku nieistotnym zawsze wyjdzie niska (poniżej mniej więcej 50%) i nie powie nic nowego. Szerzej piszemy o tym w haśle moc testu. Jarmakowska-Kostrzanowska (2021) przypomina z kolei, że moc i istotność statystyczna pochodzą z dwóch różnych szkół statystyki, co utrudnia interpretację wyniku nieistotnego nawet przy dużej mocy. Dlatego analiza wrażliwości opiera się na efektach ustalonych niezależnie od wyniku: na krzywej mocy albo na najmniejszym efekcie, który ma znaczenie. Jak zaplanować liczebność w następnym badaniu, piszemy w poradniku dobór liczebności próby.
Krok 4: test równoważności TOST
Zwykły test sprawdza, czy efekt różni się od zera. Test równoważności odwraca pytanie: czy efekt jest mniejszy od najmniejszej wielkości, która ma dla nas znaczenie? Lakens i in. (2018) opisują go jako procedurę dwóch testów jednostronnych (ang. two one-sided tests, TOST). Pozwala ona odrzucić obecność efektu co najmniej tak dużego jak najmniejsza interesująca wielkość efektu (SESOI) i w ten sposób stwierdzić brak efektu o praktycznym znaczeniu.
Jak działa TOST
- Ustal granice równoważności −Δ i +Δ, najlepiej przed badaniem i na podstawie merytorycznej: najmniejsza różnica ważna w praktyce, wyniki wcześniejszych badań albo zasoby. Lakens i in. (2018) omawiają kilka sposobów ustalania SESOI. W przykładzie Δ = 0.25 punktu.
- Wykonaj dwa testy jednostronne. Pierwszy sprawdza, czy różnica jest większa niż −Δ, drugi – czy jest mniejsza niż +Δ.
- Odczytaj wynik. Równoważność wykazujesz, gdy oba testy są istotne. Za p testu TOST przyjmuje się większą z dwóch wartości. To samo oznacza, że cały 90% przedział ufności leży między −Δ a +Δ (90%, bo każdy z dwóch testów jest jednostronny na poziomie .05).
W R wystarczy dwa razy wywołać funkcję t.test() z argumentami mu i alternative (kod w sekcji Przykład w R):
- Badanie A: względem dolnej granicy t(57.74) = 2.39, p = .010, ale względem górnej t(57.74) = 0.02, p = .506. Zatem pTOST = .506, a 90% CI [−0.10, 0.61] wychodzi daleko poza +0.25. Równoważności nie wykazano.
- Badanie B: t(497.92) = 4.45, p < .001 i t(497.92) = −2.66, p = .004. Zatem pTOST = .004, a 90% CI [−0.05, 0.18] mieści się w granicach. Różnica jest mniejsza niż 0.25 punktu – ćwiczenie nie obniża lęku w stopniu, który ma praktyczne znaczenie.
W badaniu A wykazanie równoważności było z góry niemożliwe. Przy 30 osobach w grupie połowa szerokości 90% przedziału wynosi około 0.35 punktu, czyli więcej niż cała granica 0.25. Nawet zerowa różnica w próbie nie zmieściłaby się więc w granicach. Aby przy braku prawdziwej różnicy mieć 80% szans na wykazanie równoważności, potrzeba około 176 osób w grupie. Wykazanie „braku efektu” wymaga więc próby co najmniej tak dużej jak wykrycie efektu o wielkości SESOI (tu 176 wobec 162 osób w grupie).
Rysunek 3 zestawia cztery typowe położenia przedziału ufności względem granic równoważności. Do badań A i B dodaliśmy dwa kolejne symulowane badania: C (2 × 60 osób) i D (2 × 1500 osób).
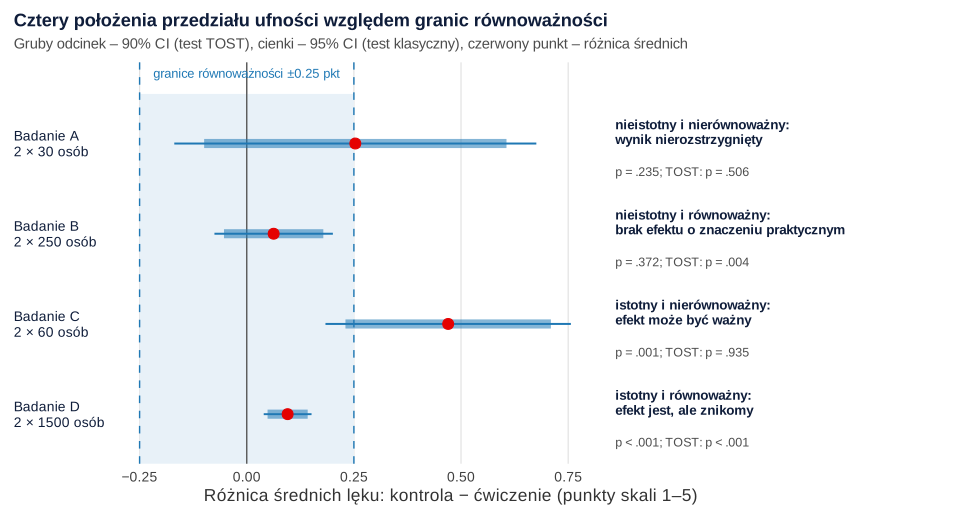
- A – nieistotny i nierównoważny: przedział obejmuje zero i wychodzi poza granicę; nic nie rozstrzygnięto.
- B – nieistotny i równoważny: przedział obejmuje zero i mieści się w granicach; efektu ważnego w praktyce nie ma.
- C – istotny i nierównoważny (różnica 0.47, 95% CI [0.18, 0.76], p = .001, pTOST = .935): efekt jest i może być ważny w praktyce.
- D – istotny i równoważny (różnica 0.10, 95% CI [0.04, 0.15], p < .001, pTOST < .001): efekt istnieje, ale jest mniejszy niż granica ważności. Bardzo duża próba wykrywa nawet różnice bez znaczenia praktycznego.
Uczciwość granic. Jeśli nie ustaliłeś SESOI przed badaniem, możesz policzyć TOST teraz. Napisz wtedy otwarcie, kiedy i na jakiej podstawie wybrałeś granice, i nie dobieraj ich do wyniku: granica „0.40, bo przy 0.25 nie wyszło” to ten sam problem co zmiana testu do skutku. Więcej o tym, jak test równoważności pozwala obalać hipotezy, piszemy w haśle falsyfikowalność.
Krok 5: czynnik Bayesa – „brak efektu” czy „nie wiadomo”?
Czynnik Bayesa porównuje, jak dobrze dane pasują do dwóch hipotez: zerowej (brak efektu) i alternatywnej (efekt, którego możliwe wielkości opisuje rozkład a priori). BF01 = 5 znaczy, że dane są pięć razy bardziej prawdopodobne przy hipotezie zerowej niż przy alternatywnej. Według Dienesa (2014) czynnik Bayesa pozwala ocenić, czy wynik nieistotny wspiera hipotezę zerową, czy dane są po prostu niewrażliwe.
Jak opisują Wagenmakers, Love i in. (2018), pakiet BayesFactor i program JASP przyjmują domyślnie dla wielkości efektu w teście t rozkład a priori Cauchy’ego o skali √2/2 ≈ 0.707. Wyniki:
| Skala rozkładu a priori | Badanie A: BF01 | Badanie B: BF01 |
|---|---|---|
| 0.707 (domyślna, „medium”) | 2.08 | 6.83 |
| 1 („wide”) | 2.68 | 9.53 |
| 1.414 („ultrawide”) | 3.58 | 13.39 |
W badaniu A dane są tylko około dwóch razy bardziej zgodne z brakiem efektu. W skali opisowej, którą Wagenmakers, Love i in. (2018) przedstawiają jako przybliżoną (szczegóły w haśle czynnik Bayesa), to dowody anegdotyczne. Przy szerszych rozkładach a priori BF01 rośnie do 3.58, bo szeroki rozkład przypisuje dużą wagę efektom, których dane wyraźnie nie popierają. Wniosek zależy więc od założeń, a to kolejny sygnał, że dane są niewrażliwe. W badaniu B BF01 = 6.83 to dowody umiarkowane na rzecz braku różnicy i przy każdym rozkładzie a priori przekracza 3. Wniosek jest odporny.
TOST i czynnik Bayesa odpowiadają na nieco inne pytania, więc czasem się różnią. Jeśli podajesz oba, opisz założenia każdego z nich i nie wybieraj tego, który „lepiej wyszedł”.
Co wolno napisać: trzy możliwe wnioski
Po pięciu krokach Twój wynik trafi do jednej z trzech szuflad. Każda ma inne zdanie w pracy:
| Sytuacja | Co pokazują dane | Co możesz napisać |
|---|---|---|
| p > .05; TOST nieistotny; BF01 < 3 (badanie A) | Dane są zgodne zarówno z brakiem efektu, jak i z efektem ważnym w praktyce | „Hipotezy nie potwierdzono; wynik jest nierozstrzygnięty – nie wykazano efektu, ale nie można go też wykluczyć” |
| p > .05; TOST istotny; BF01 > 3 (badanie B) | Efekty co najmniej tak duże jak SESOI są mało zgodne z danymi | „Hipotezy nie potwierdzono; efekt, jeśli istnieje, jest mniejszy niż 0.25 punktu, czyli bez znaczenia praktycznego” |
| p < .05; TOST istotny (badanie D) | Efekt istnieje, ale jest mniejszy od granicy ważności | „Różnica była istotna statystycznie, ale zbyt mała, by miała znaczenie praktyczne” |
Jeśli nie policzysz ani testu równoważności, ani czynnika Bayesa, zostaje Ci zawsze pierwsza szuflada. Przy wyniku nieistotnym możesz wtedy napisać tylko tyle, że efektu nie wykazano – nigdy, że go nie ma.
Analizy eksploracyjne: tak, ale z etykietą
Po nieistotnym wyniku naturalne jest pytanie: „a może efekt jest tylko u części osób?”. Takie analizy są wartościowe, o ile nie udajesz, że je planowałeś. Standardy raportowania JARS-Quant dzielą hipotezy, analizy i wnioski na pierwszorzędowe, drugorzędowe i eksploracyjne (Appelbaum i in., 2018). Nosek i in. (2018) pokazują, że wyraźne oddzielenie testowania przewidywań od generowania hipotez po fakcie zwiększa wiarygodność wyników. W praktyce:
- opisz je w osobnym podrozdziale „Analizy eksploracyjne”, po weryfikacji hipotez;
- podaj, ile takich analiz wykonałeś – także tych bez istotnych wyników;
- przy wielu porównaniach zastosuj korektę na wielokrotne porównania albo przynajmniej zaznacz, że wyniki mogą być fałszywie dodatnie;
- wynik eksploracyjny traktuj jako hipotezę do sprawdzenia w kolejnym badaniu, a nie jako „potwierdzenie” czegokolwiek.
Czym innym jest sprawdzenie odporności wyniku (też nazywane analizą wrażliwości): główną analizę liczysz zgodnie z planem, a obok pokazujesz wariant alternatywny, np. bez wykluczeń. Gdy oba są podobne, wniosek jest mocniejszy – ale pokazujesz oba, zamiast wybierać jeden.
Jak opisać wynik nieistotny w rozdziale wyników – wzory
W rozdziale wyników opisz każdą hipotezę, także niepotwierdzoną. Wynik nieistotny dostaje te same informacje co istotny: statystyki opisowe, test, stopnie swobody, dokładne p i wielkość efektu z przedziałem ufności. Jeśli wykonałeś analizę wrażliwości, test równoważności albo czynnik Bayesa, dodaj je tutaj, a nie dopiero w dyskusji. Ogólne zasady zapisu znajdziesz w części „Jak opisać wynik nieistotny” poradnika o wynikach w stylu APA.
Badanie A – wynik nierozstrzygnięty:
Badanie B – wykazana równoważność:
Wzór ogólny (uzupełnij nawiasy; zdanie o teście równoważności i czynniku Bayesa usuń, jeśli ich nie liczysz):
Liczby obu badań możesz też zebrać w tabeli:
Tabela 1
Różnica w lęku egzaminacyjnym między grupą kontrolną a grupą ćwiczenia: test klasyczny, test równoważności i czynnik Bayesa
| Badanie | n | Różnica [95% CI] | t | df | p | d [95% CI] | pTOST | BF01 |
|---|---|---|---|---|---|---|---|---|
| A | 30 | 0.25 [−0.17, 0.68] | 1.20 | 57.74 | .235 | 0.31 [−0.20, 0.82] | .506 | 2.08 |
| B | 250 | 0.06 [−0.08, 0.20] | 0.89 | 497.92 | .372 | 0.08 [−0.10, 0.26] | .004 | 6.83 |
Uwaga. n – liczba osób w każdej grupie. Różnica – średnia w grupie kontrolnej minus średnia w grupie ćwiczenia (punkty skali 1–5). t, df i p – test t Welcha; d – d Cohena z połączonym odchyleniem standardowym. pTOST – większa z dwóch wartości p w teście równoważności z granicami ±0.25 punktu. BF01 – czynnik Bayesa na rzecz braku różnicy (rozkład a priori Cauchy’ego o skali 0.707). Dane symulowane.
Na końcu rozdziału warto zebrać hipotezy w tabeli z kolumną „potwierdzona / niepotwierdzona”. Przykład takiej tabeli i cały rozdział wyników jednego badania pokazujemy we wpisie wyniki badań własnych – przykład. Jeśli promotor odesłał Ci już rozdział z uwagami, zajrzyj do poradnika o poprawkach promotora w rozdziale wyników.
A dyskusja? Krótko i bez powtarzania
W dyskusji nie przepisuj statystyk z wyników. Zamiast tego wykorzystaj wniosek z jednej z trzech szuflad:
- Wynik nierozstrzygnięty (badanie A): hipotezy nie potwierdzono, ale nie wykazano też braku efektu; wskaż, jakiej próby potrzebowałoby kolejne badanie.
- Brak efektu ważnego w praktyce (badanie B): to merytoryczny wynik, który porównasz z literaturą.
- Wyniki eksploracyjne: tylko jako hipotezy do dalszych badań.
Strukturę dyskusji, gotowe zdania o wynikach nieistotnych i sposób opisu ograniczeń znajdziesz w części „Wyniki nieistotne i nieoczekiwane” poradnika o dyskusji.
Rozmowa z promotorem: co przygotować
Na rozmowę o wynikach nieistotnych przyjdź z faktami, a nie z przeprosinami. Przygotuj:
- Tabelę hipotez – dla każdej: test, wynik, wielkość efektu z 95% CI, decyzja.
- Analizę wrażliwości – jaki efekt badanie mogło wykryć z mocą 80% i ile osób byłoby potrzebnych do wykrycia efektu ważnego w praktyce.
- Propozycję testu równoważności lub czynnika Bayesa – z uzasadnieniem granic równoważności i informacją, czy ustalono je przed badaniem.
- Listę wszystkich wykonanych analiz – zaplanowanych i dodatkowych.
- Pytania – np. czy wynik eksploracyjny ma trafić do pracy, czy granice równoważności są do zaakceptowania, jak opisać wynik w dyskusji.
Jeśli w rozmowie padnie propozycja „usuńmy kilka osób” albo „spróbujmy innego testu”, zapytaj o uzasadnienie merytoryczne i zaproponuj pokazanie obu wersji w pracy. Krótka wiadomość przed spotkaniem może wyglądać tak:
Pytania, które mogą paść o wynik nieistotny podczas obrony, i przykładowe odpowiedzi zebraliśmy we wpisie pytania na obronie z metodologii i statystyki.
Kiedy skonsultować wyniki ze statystykiem
Większość kroków z tego poradnika wykonasz samodzielnie. Konsultacja ma sens, gdy:
- nie masz pewności, czy test pasuje do danych (np. pomiary powtarzane, dane zagnieżdżone, mediacja);
- chcesz policzyć test równoważności albo czynnik Bayesa, ale nie wiesz, jak uzasadnić granice lub rozkład a priori;
- w danych są braki, obserwacje odstające albo wykluczenia, których nie przewidział plan analiz;
- promotor prosi o „moc post hoc” i chcesz rzeczowo wyjaśnić, co z niej wynika, a co nie;
- wykonałeś wiele analiz eksploracyjnych i nie wiesz, jak je uczciwie opisać.
Rzetelna konsultacja nie polega na szukaniu istotnego wyniku na siłę. Chodzi o sprawdzenie analizy i wyjaśnienie, co wynik znaczy. Jeśli potrzebujesz takiego wsparcia, zobacz analizy statystyczne dla studentów. Wyniki musisz rozumieć i umieć obronić samodzielnie, a z pomocy możesz korzystać tylko zgodnie z zasadami uczelni i w razie potrzeby ją ujawnić. Zakres dozwolonej pomocy omawiamy we wpisie czy można zlecić analizę statystyczną.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R: przepisy 3 i 4 korzystają z danych z przepisu 1. Symulacja w przepisie 5 trwa około pół minuty.
1. Dane i test t Welcha z wielkością efektu
R
# Dane symulowane: lęk przed egzaminem (średnia z 10 pozycji, skala 1–5) w grupie kontrolnej
# i w grupie, która przed kolokwium wykonała 15-minutowe ćwiczenie oddechowe.
# Badanie A: 2 × 30 osób (typowa praca magisterska), badanie B: 2 × 250 osób.
# Badania C (2 × 60) i D (2 × 1500) służą tylko do rysunku z czterema położeniami przedziału ufności.
library(effectsize)   # cohens_d()

badanie <- function(n, roznica, ziarno, m_kontrola = 3.20, sd = 0.80) {
  set.seed(ziarno)
  wynik <- function(n, m) pmin(pmax(round(rnorm(n, m, sd) * 10) / 10, 1), 5)   # krok 0.1, zakres 1–5
  kontrola  <- wynik(n, m_kontrola)
  cwiczenie <- wynik(n, m_kontrola - roznica)       # roznica = prawdziwy spadek lęku po ćwiczeniu
  data.frame(grupa = factor(rep(c("kontrola", "ćwiczenie"), each = n), levels = c("kontrola", "ćwiczenie")),
             lek = c(kontrola, cwiczenie))
}
A <- badanie(n = 30,   roznica = 0.20, ziarno = 25)
B <- badanie(n = 250,  roznica = 0.00, ziarno = 111)
C <- badanie(n = 60,   roznica = 0.50, ziarno = 203)
D <- badanie(n = 1500, roznica = 0.10, ziarno = 303)

# Statystyki opisowe, test t Welcha (domyślny w R) i d Cohena z 95% CI
opis <- function(dane) {
  aggregate(lek ~ grupa, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
}
for (nazwa in c("A", "B")) {
  dane <- get(nazwa)
  cat("\n==== Badanie", nazwa, "====\n")
  print(opis(dane))
  print(t.test(lek ~ grupa, data = dane))            # różnica = kontrola − ćwiczenie
  print(cohens_d(lek ~ grupa, data = dane))          # d z połączonym odchyleniem standardowym
}
# Badania C i D w skrócie (do rysunku 1)
for (nazwa in c("C", "D")) {
  dane <- get(nazwa); tt <- t.test(lek ~ grupa, data = dane)
  cat("\nBadanie", nazwa, ": różnica =", round(unname(diff(rev(tt$estimate))), 3),
      " 95% CI:", round(tt$conf.int, 3), " t =", round(unname(tt$statistic), 2), " df =", round(unname(tt$parameter), 1),
      " p-value:", format.pval(tt$p.value, digits = 3, eps = .001), "\n")
}
Wynik w R
==== Badanie A ====
      grupa lek.M lek.SD lek.n
1  kontrola  3.05   0.84 30.00
2 ćwiczenie  2.79   0.79 30.00

	Welch Two Sample t-test

data:  lek by grupa
t = 1.2006, df = 57.737, p-value = 0.2348
alternative hypothesis: true difference in means between group kontrola and group ćwiczenie is not equal to 0
95 percent confidence interval:
 -0.1690704  0.6757371
sample estimates:
 mean in group kontrola mean in group ćwiczenie
               3.046667                2.793333

Cohen's d |        95% CI
-------------------------
0.31      | [-0.20, 0.82]

- Estimated using pooled SD.
==== Badanie B ====
      grupa  lek.M lek.SD  lek.n
1  kontrola   3.22   0.79 250.00
2 ćwiczenie   3.16   0.78 250.00

	Welch Two Sample t-test

data:  lek by grupa
t = 0.89304, df = 497.92, p-value = 0.3723
alternative hypothesis: true difference in means between group kontrola and group ćwiczenie is not equal to 0
95 percent confidence interval:
 -0.07536316  0.20096316
sample estimates:
 mean in group kontrola mean in group ćwiczenie
                 3.2200                  3.1572

Cohen's d |        95% CI
-------------------------
0.08      | [-0.10, 0.26]

- Estimated using pooled SD.
Badanie C : różnica = 0.47  95% CI: 0.184 0.756  t = 3.25  df = 118  p-value: 0.0015

Badanie D : różnica = 0.095  95% CI: 0.04 0.151  t = 3.35  df = 2996.7  p-value: <0.001
2. Analiza wrażliwości
R
# Analiza wrażliwości: jaki efekt badanie mogło wykryć? (test t dla dwóch grup, α = .05, dwustronnie)
# To NIE jest „moc post hoc” – nie korzystamy z efektu uzyskanego w próbie.
# strict = TRUE: moc liczona dla obu ogonów testu dwustronnego (przy d = 0 równa α)
wrazliwosc <- function(n) {
  c(n_w_grupie   = n,
    d_moc_80     = power.t.test(n = n, sd = 1, sig.level = .05, power = .80, strict = TRUE)$delta,   # efekt wykrywany z mocą 80%
    d_moc_50     = power.t.test(n = n, sd = 1, sig.level = .05, power = .50, strict = TRUE)$delta,
    d_krytyczne  = qt(.975, df = 2 * n - 2) * sqrt(2 / n),                           # najmniejsze d, które da p < .05
    moc_dla_SESOI = power.t.test(n = n, delta = 0.25, sd = 0.80, sig.level = .05, strict = TRUE)$power)   # SESOI = 0.25 pkt
}
round(rbind(badanie_A = wrazliwosc(30), badanie_B = wrazliwosc(250)), 3)

# Ile osób w grupie trzeba, by wykryć różnicę 0.25 punktu (SD = 0.80) z mocą 80%?
ceiling(power.t.test(delta = 0.25, sd = 0.80, sig.level = .05, power = .80, strict = TRUE)$n)

# Ile osób w grupie trzeba, by przy braku prawdziwej różnicy wykazać równoważność (TOST, granice ±0.25) z mocą 80%?
# Przybliżenie: różnica średnich ~ N(0, SE), SE = SD × √(2/n)
moc_tost <- function(n, granica = 0.25, sd = 0.80, alfa = .05) {
  se <- sd * sqrt(2 / n)
  max(0, 2 * pnorm((granica - qt(1 - alfa, 2 * n - 2) * se) / se) - 1)
}
n_tost <- 10:400
min(n_tost[sapply(n_tost, moc_tost) >= .80])
round(sapply(c(30, 250), moc_tost), 3)          # szansa wykazania równoważności przy n = 30 i n = 250 w grupie
Wynik w R
          n_w_grupie d_moc_80 d_moc_50 d_krytyczne moc_dla_SESOI
badanie_A         30    0.736    0.515       0.517         0.222
badanie_B        250    0.251    0.176       0.176         0.937
[1] 162
[1] 176
[1] 0.000 0.935
3. Test równoważności TOST bez dodatkowych pakietów
R
# Test równoważności TOST „ręcznie”: dwa jednostronne testy t Welcha względem granic ±0.25 punktu
# (pakiet TOSTER robi to samo; tutaj wystarczy funkcja t.test() z argumentami mu i alternative)
tost <- function(dane, granica = 0.25) {
  k <- dane$lek[dane$grupa == "kontrola"]
  c <- dane$lek[dane$grupa == "ćwiczenie"]
  dolny <- t.test(k, c, mu = -granica, alternative = "greater")   # H0: różnica ≤ −0.25
  gorny <- t.test(k, c, mu =  granica, alternative = "less")      # H0: różnica ≥ +0.25
  ci90  <- t.test(k, c, conf.level = .90)$conf.int                # TOST na poziomie .05 = 90% CI
  c(roznica = mean(k) - mean(c),
    t_dolny = unname(dolny$statistic), p_dolny = dolny$p.value,
    t_gorny = unname(gorny$statistic), p_gorny = gorny$p.value,
    df = unname(dolny$parameter),
    p_TOST = max(dolny$p.value, gorny$p.value),
    CI90_dolna = ci90[1], CI90_gorna = ci90[2])
}
wyniki_tost <- t(sapply(list(A = A, B = B, C = C, D = D), tost))
print(round(wyniki_tost, 4))
# Równoważność wykazana, gdy p_TOST < .05, czyli gdy cały 90% CI leży między −0.25 a 0.25
wyniki_tost[, "p_TOST"] < .05
Wynik w R
  roznica t_dolny p_dolny t_gorny p_gorny        df p_TOST CI90_dolna CI90_gorna
A  0.2533  2.3855  0.0102  0.0158  0.5063   57.7366 0.5063    -0.0994     0.6061
B  0.0628  4.4482  0.0000 -2.6621  0.0040  497.9189 0.0040    -0.0531     0.1787
C  0.4700  4.9802  0.0000  1.5217  0.9346  117.9985 0.9346     0.2303     0.7097
D  0.0954 12.1360  0.0000 -5.4320  0.0000 2996.6638 0.0000     0.0486     0.1422
    A     B     C     D
FALSE  TRUE FALSE  TRUE
4. Czynnik Bayesa i odporność na wybór rozkładu a priori
R
# Czynnik Bayesa dla dwóch grup (bayesowski test t, rozkład a priori Cauchy’ego dla δ)
suppressPackageStartupMessages(library(BayesFactor))   # ttestBF(), extractBF()
bf01 <- function(dane, skala) {
  k <- dane$lek[dane$grupa == "kontrola"]
  c <- dane$lek[dane$grupa == "ćwiczenie"]
  1 / extractBF(ttestBF(x = k, y = c, rscale = skala))$bf   # BF01 = 1 / BF10
}
# "medium" = √2/2 ≈ 0.707 (domyślna), "wide" = 1, "ultrawide" = √2 – analiza odporności na wybór rozkładu a priori
skale <- c(medium = "medium", wide = "wide", ultrawide = "ultrawide")
round(sapply(list(A = A, B = B), function(d) sapply(skale, function(s) bf01(d, s))), 2)
Wynik w R
             A     B
medium    2.08  6.83
wide      2.68  9.53
ultrawide 3.58 13.39
5. Symulacja: jak „próbowanie do skutku” zwiększa ryzyko fałszywego wyniku
R
# Symulacja: jak „próbowanie do skutku” zwiększa odsetek wyników fałszywie istotnych.
# Prawdziwej różnicy między grupami NIE MA (H0 prawdziwa); 2 × 30 osób, dwie zmienne zależne skorelowane r = .5.
set.seed(2026)
generuj <- function(n) {
  z1 <- rnorm(n); z2 <- 0.5 * z1 + sqrt(1 - 0.5^2) * rnorm(n)
  cbind(lek   = pmin(pmax(round((3.2 + 0.8 * z1) * 10) / 10, 1), 5),
        stres = pmin(pmax(round((3.0 + 0.7 * z2) * 10) / 10, 1), 5))
}
p_welch <- function(x, y) t.test(x, y)$p.value
p_mw    <- function(x, y) suppressWarnings(wilcox.test(x, y, exact = FALSE)$p.value)
bez_odstajacych <- function(x) x[abs(as.numeric(scale(x))) <= 2]     # „usuwam wyniki powyżej 2 SD”
trzy_proby <- function(a, b, j) c(p_welch(a[, j], b[, j]), p_mw(a[, j], b[, j]),
                                  p_welch(bez_odstajacych(a[, j]), bez_odstajacych(b[, j])))
jedno_badanie <- function() {
  a <- generuj(30); b <- generuj(30)
  p_lek <- trzy_proby(a, b, 1); p_stres <- trzy_proby(a, b, 2)
  a2 <- rbind(a, generuj(10)); b2 <- rbind(b, generuj(10))          # dobranie po 10 osób do grup
  p_po_dobraniu <- c(trzy_proby(a2, b2, 1), trzy_proby(a2, b2, 2))
  c("1. zaplanowany test Welcha"        = p_lek[1] < .05,
    "2. + test Manna–Whitneya"           = any(p_lek[1:2] < .05),
    "3. + usunięcie „odstających”"       = any(p_lek < .05),
    "4. + druga zmienna zależna"         = any(c(p_lek, p_stres) < .05),
    "5. + dobranie 10 osób do grup"      = any(c(p_lek, p_stres, p_po_dobraniu) < .05))
}
wyniki_ph <- replicate(20000, jedno_badanie())
odsetek_falszywie_istotnych <- round(rowMeans(wyniki_ph) * 100, 1)
data.frame(procent = odsetek_falszywie_istotnych)
Wynik w R
                              procent
1. zaplanowany test Welcha        5.3
2. + test Manna–Whitneya          6.2
3. + usunięcie „odstających”     12.1
4. + druga zmienna zależna       20.9
5. + dobranie 10 osób do grup    28.9
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- BayesFactor (wersja 0.9.12-4.8): Morey, R. D., & Rouder, J. N. (2026). BayesFactor: Computation of Bayes factors for common designs (R package version 0.9.12-4.8) [Computer software]. https://doi.org/10.32614/CRAN.package.BayesFactor
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy wynikach nieistotnych
- „Brak istotności, więc brak efektu”. Bez testu równoważności albo czynnika Bayesa możesz napisać tylko, że efektu nie wykazano (Amrhein i in., 2019).
- Moc obserwowana jako argument. Moc liczona z efektu w próbie powtarza informację zawartą w p. Zamiast niej pokaż analizę wrażliwości.
- Porównywanie istotności zamiast porównania efektów. „U kobiet efekt był istotny, u mężczyzn nie” nie dowodzi, że kobiety i mężczyźni się różnią. Do tego potrzebny jest test interakcji.
- Granice równoważności dobrane do wyniku albo test TOST bez informacji, skąd wzięła się wartość Δ.
- Czynnik Bayesa bez rozkładu a priori. Podaj skalę rozkładu i sprawdź, czy wniosek zmienia się przy innych ustawieniach.
- Pominięcie niepotwierdzonej hipotezy albo ukrycie wyniku w aneksie. W skali nauki takie decyzje tworzą efekt szuflady.
- Mylenie błędów. Wynik nieistotny może być błędem II rodzaju, a wynik istotny uzyskany „do skutku” – błędem I rodzaju. Analiza wrażliwości pokazuje, jak duże było ryzyko błędu II rodzaju.
Lista kontrolna: wynik nieistotny w pracy
- Hipotezy, test i kryteria wykluczeń są takie same jak w rozdziale metodologicznym (zob. plan analizy danych).
- Każda hipoteza – także niepotwierdzona – ma w wynikach statystyki opisowe, test, dokładne p i wielkość efektu z 95% CI.
- Nigdzie nie ma sformułowań „prawie istotny”, „trend”, „wynik zbliżony do istotności”.
- Jest analiza wrażliwości: dla jakiego efektu badanie miało 80% mocy.
- Nie liczono mocy obserwowanej („post hoc”) z efektu w próbie.
- Jeśli piszesz o braku efektu, masz test równoważności z uzasadnionymi granicami albo czynnik Bayesa z podanym rozkładem a priori.
- Analizy dodatkowe są w osobnym podrozdziale, oznaczone jako eksploracyjne, z informacją, ile ich wykonano.
- Decyzje podjęte po zobaczeniu danych (wykluczenia, transformacje) są opisane, a wynik pokazano w obu wariantach.
- Dyskusja nie powtarza statystyk i nie twierdzi więcej, niż pozwalają dane.
Najczęstsze pytania
Co zrobić, gdy hipoteza się nie potwierdziła?
Nie zmieniaj hipotezy ani testu. Sprawdź wielkość efektu z 95% przedziałem ufności i wykonaj analizę wrażliwości, czyli policz, dla jakiego efektu badanie miało 80% mocy. Jeśli chcesz stwierdzić brak efektu o praktycznym znaczeniu, policz test równoważności TOST albo czynnik Bayesa, a w wynikach napisz wprost, że hipotezy nie potwierdzono.
Czy można obronić pracę, w której hipotezy się nie potwierdziły?
Wynik nieistotny sam w sobie nie przekreśla pracy: celem badania jest sprawdzenie hipotez, a nie ich potwierdzenie. O ocenie decydują kryteria uczelni i komisja, dlatego zadbaj, by plan, analizy i wnioski były spójne, a opis uczciwy – z wielkością efektu, przedziałem ufności i informacją, jaki efekt badanie mogło wykryć. Przygotuj się też do pytań o moc i liczebność próby.
Czy nieistotne wyniki trzeba opisać w pracy?
Tak. Każdą hipotezę i każdą zaplanowaną analizę opisz w wynikach z tymi samymi informacjami co wyniki istotne: statystykami opisowymi, testem, dokładnym p i wielkością efektu z przedziałem ufności. Pomijanie niepotwierdzonych hipotez Rubin (2017) zalicza do form HARKingu, a w skali nauki prowadzi ono do efektu szuflady.
Jak wykazać, że między grupami nie ma różnicy?
Zwykły test istotności tego nie potrafi, bo p > .05 oznacza tylko brak dowodu różnicy. Ustal najmniejszą różnicę, która ma praktyczne znaczenie, i wykonaj test równoważności TOST, czyli dwa testy jednostronne względem tych granic. Równoważność wykazujesz, gdy oba są istotne, czyli gdy 90% przedział ufności leży w całości między granicami. Uzupełnieniem może być czynnik Bayesa BF01.
Czy mogę dobrać więcej osób, żeby wynik stał się istotny?
Nie, jeśli decyzję podejmujesz po zobaczeniu wyniku. Każde ponowne sprawdzanie wyniku po dobraniu osób zwiększa ryzyko wyniku fałszywie istotnego. W naszej symulacji pięć takich „prób” razem (m.in. zmiana testu, usunięcie odstających, druga zmienna zależna i dobranie po 10 osób) podniosło ten odsetek z 5.3% do 28.9%. Dobieranie osób jest dopuszczalne tylko wtedy, gdy przewidziano je w planie badania wraz ze sposobem kontroli błędu I rodzaju.
Czym test równoważności różni się od czynnika Bayesa?
Test równoważności TOST sprawdza, czy efekt jest mniejszy od ustalonej wcześniej najmniejszej interesującej wielkości efektu, i daje decyzję na poziomie α. Czynnik Bayesa porównuje, jak dobrze dane pasują do hipotezy zerowej i do hipotezy o efekcie opisanej rozkładem a priori. TOST wymaga uzasadnienia granic równoważności, czynnik Bayesa – wyboru rozkładu a priori; oba pozwalają odróżnić „brak efektu” od „nie wiadomo”.
Powiązane hasła
Przeczytaj też
Jak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWyniki badań własnych – przykładowy rozdział
Cały rozdział wyników jednego badania – od przygotowania danych po tabelę hipotez – z komentarzem, tabelami APA, rysunkami i wzorem w Wordzie.
Czytaj →Wynik nieistotny i nie wiesz, co dalej?
Sprawdzimy analizę, policzymy przedziały ufności, analizę wrażliwości i test równoważności, a potem omówimy z Tobą wyniki, żebyś rozumiał(a), co z nich wynika i jak je opisać.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. https://doi.org/10.1038/d41586-019-00857-9 ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Dienes, Z. (2014). Using Bayes to get the most out of non-significant results. Frontiers in Psychology, 5, Article 781. https://doi.org/10.3389/fpsyg.2014.00781 ● Otwarty dostęp
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Jarmakowska-Kostrzanowska, L. (2021). Istotnie statystyczna moc testu – analiza mocy i jej miejsce w przyborniku badacza oraz interpretacja (nie)istotności statystycznej przy małej (dużej) mocy testu. Przegląd Psychologiczny, 64(4), 83–99. https://doi.org/10.31648/pp.7359 ● Otwarty dostęp
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. https://doi.org/10.1207/s15327957pspr0203_4
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114 ● Otwarty dostęp: pełny tekst
- Rubin, M. (2017). When does HARKing hurt? Identifying when different types of undisclosed post hoc hypothesizing harm scientific progress. Review of General Psychology, 21(4), 308–320. https://doi.org/10.1037/gpr0000128 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Wagenmakers, E.-J., Love, J., Marsman, M., Jamil, T., Ly, A., Verhagen, J., Selker, R., Gronau, Q. F., Dropmann, D., Boutin, B., Meerhoff, F., Knight, P., Raj, A., van Kesteren, E.-J., van Doorn, J., Šmíra, M., Epskamp, S., Etz, A., Matzke, D., . . . Morey, R. D. (2018). Bayesian inference for psychology. Part II: Example applications with JASP. Psychonomic Bulletin & Review, 25(1), 58–76. https://doi.org/10.3758/s13423-017-1323-7 ● Otwarty dostęp
- Wood, J., Freemantle, N., King, M., & Nazareth, I. (2014). Trap of trends to statistical significance: Likelihood of near significant P value becoming more significant with extra data. BMJ, 348, Article g2215. https://doi.org/10.1136/bmj.g2215 ● Otwarty dostęp
Cytowania BibTeX
@article{amrhein2019scientists, author={Amrhein, Valentin and Greenland, Sander and McShane, Blake}, title={{Scientists rise up against statistical significance}}, journal={Nature}, year={2019}, volume={567}, number={7748}, pages={305--307}, doi={10.1038/d41586-019-00857-9}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{dienes2014using, author={Dienes, Zoltan}, title={{Using Bayes to get the most out of non-significant results}}, journal={Frontiers in Psychology}, year={2014}, volume={5}, eid={781}, doi={10.3389/fpsyg.2014.00781}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{jarmakowska2021istotnie, author={Jarmakowska-Kostrzanowska, Lilianna}, title={{Istotnie statystyczna moc testu – analiza mocy i jej miejsce w przyborniku badacza oraz interpretacja (nie)istotności statystycznej przy małej (dużej) mocy testu}}, journal={Przegląd Psychologiczny}, year={2021}, volume={64}, number={4}, pages={83--99}, doi={10.31648/pp.7359}}@article{kerr1998harking, author={Kerr, Norbert L.}, title={{HARKing: Hypothesizing after the results are known}}, journal={Personality and Social Psychology Review}, year={1998}, volume={2}, number={3}, pages={196--217}, doi={10.1207/s15327957pspr0203_4}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{nosek2018preregistration, author={Nosek, Brian A. and Ebersole, Charles R. and DeHaven, Alexander C. and Mellor, David T.}, title={{The preregistration revolution}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2600--2606}, doi={10.1073/pnas.1708274114}}@article{rubin2017when, author={Rubin, Mark}, title={{When does HARKing hurt? Identifying when different types of undisclosed post hoc hypothesizing harm scientific progress}}, journal={Review of General Psychology}, year={2017}, volume={21}, number={4}, pages={308--320}, doi={10.1037/gpr0000128}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{wagenmakers2018bayesianii, author={Wagenmakers, Eric-Jan and Love, Jonathon and Marsman, Maarten and Jamil, Tahira and Ly, Alexander and Verhagen, Josine and Selker, Ravi and Gronau, Quentin F. and Dropmann, Damian and Boutin, Bruno and Meerhoff, Frans and Knight, Patrick and Raj, Akash and van Kesteren, Erik-Jan and van Doorn, Johnny and Šmíra, Martin and Epskamp, Sacha and Etz, Alexander and Matzke, Dora and de Jong, Tim and van den Bergh, Don and Sarafoglou, Alexandra and Steingroever, Helen and Derks, Koen and Rouder, Jeffrey N. and Morey, Richard D.}, title={{Bayesian inference for psychology. Part II: Example applications with JASP}}, journal={Psychonomic Bulletin \& Review}, year={2018}, volume={25}, number={1}, pages={58--76}, doi={10.3758/s13423-017-1323-7}}@article{wood2014trap, author={Wood, John and Freemantle, Nick and King, Michael and Nazareth, Irwin}, title={{Trap of trends to statistical significance: Likelihood of near significant P value becoming more significant with extra data}}, journal={BMJ}, year={2014}, volume={348}, eid={g2215}, doi={10.1136/bmj.g2215}}