„Proszę dopisać moc post hoc” – skąd ta prośba
Scenariusz z prac magisterskich: hipoteza się nie potwierdziła, p = .502, a promotor albo recenzent dopisuje na marginesie: „Proszę policzyć moc post hoc – może próba była za mała”. Prośba brzmi rozsądnie. Skoro wynik nieistotny może wynikać z małej próby, to policzenie mocy powinno pokazać, czy tak było. Kłopot w tym, że moc liczona z efektu uzyskanego w próbie nie odpowiada na to pytanie. Jest tylko inaczej zapisaną wartością p. Taką prośbę zgłaszają recenzenci także w czasopismach. Zhang i in. (2019) zaczynają od tego, że część czasopism biomedycznych i psychologicznych wymaga analizy mocy dla danych już zebranych. Dziak, Dierker i Abar (2020) zauważają, że recenzenci proszą o nią, chcąc zachęcić do staranniejszego planowania badań – a mimo to nie powinno się jej ani wymagać, ani raportować.
Ten wpis to praktyczny przewodnik dla osoby, która właśnie dostała taką uwagę. Pokazuje symulacją w R, dlaczego moc obserwowana jest funkcją p, i podpowiada, co podać zamiast niej. Na koniec znajdziesz gotowe zdania do pracy i odpowiedź dla promotora. Definicję i jeden prosty przykład znajdziesz w haśle analiza mocy post hoc, a ćwiczenie z symulacją jednego planu – w zadaniu 10 wpisu moc testu i liczebność próby – zadania. Tutaj idziemy dalej: kilka testów naraz, kolumna mocy w SPSS, analiza wrażliwości dla t, korelacji i odsetków oraz rozmowa z promotorem.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa porównuje poczucie własnej skuteczności przed pierwszą praktyką (skala 10–40) u osób po zajęciach w centrum symulacji medycznej (n = 31) i po zajęciach tradycyjnych (n = 33). Ma też dwie dodatkowe hipotezy: związek skuteczności z liczbą godzin praktyk i różnicę w odsetku osób, które zdały egzamin praktyczny za pierwszym razem. Wszystkie trzy wyniki są nieistotne.
Czym jest „moc post hoc”, a czym nie jest
Moc testu to prawdopodobieństwo, że test da wynik istotny, jeśli prawdziwy efekt ma określoną wielkość. Zależy od czterech rzeczy: tej wielkości efektu, liczebności, poziomu α i rodzaju testu. Przed badaniem wstawiasz efekt, którego się spodziewasz albo który uważasz za ważny – to analiza mocy a priori. „Moc post hoc” (moc obserwowana, ang. observed power) powstaje inaczej. Po badaniu do tego samego wzoru wstawiasz efekt z próby, czyli zakładasz, że prawdziwy efekt jest dokładnie taki, jak w Twoich danych.
Nie każda moc liczona po badaniu jest więc „mocą post hoc”. Rozróżnienie jest proste:
| Obliczenie po badaniu | Skąd wielkość efektu | Czy ma sens |
|---|---|---|
| Moc obserwowana (moc post hoc) | z Twojej próby | Nie – to inny zapis p |
| Moc dla efektu ustalonego z góry | najmniejszy ważny efekt (SESOI) albo efekt z literatury | Tak – mówi, czy badanie było czułe na efekt, który się liczy |
| Analiza wrażliwości | szukana: jaki efekt badanie wykrywa z mocą 80% | Tak – opisuje czułość planu |
| Najmniejszy efekt istotny | szukany: od jakiego efektu w próbie p < .05 | Tak – pomocniczo |
Dwa ostatnie pytania wymienia Lakens (2022) wśród pytań, które warto zadać przy uzasadnianiu liczebności próby. Obok nich stawia pytanie, jakie wielkości efektu wyklucza przedział ufności. Te trzy liczby razem dają pełny obraz badania z wynikiem nieistotnym.
Dlaczego moc obserwowana jest funkcją p
Przy danym teście i liczebności wartość p wyznacza statystykę testu, a ta – efekt w próbie. Jeśli ten efekt wstawisz do wzoru na moc, wynik zależy tylko od p. W przybliżeniu normalnym:
W tym wzorze nie ma liczebności ani rodzaju testu, są tylko p i α = .05. Przepis 1 liczy moc obserwowaną dokładnie dla pięciu wariantów: testu t przy 15 i 150 osobach w grupie, korelacji przy 60 osobach i testu χ² dla tabeli 2 × 2 przy 400 osobach. Wyniki różnią się najwyżej w drugim miejscu po przecinku:
| p | Przybliżenie normalne | Test t, 2 × 15 | Test t, 2 × 150 | Korelacja, n = 60 | χ² 2 × 2, N = 400 |
|---|---|---|---|---|---|
| .01 | .731 | .760 | .734 | .742 | .731 |
| .05 | .500 | .507 | .501 | .507 | .500 |
| .10 | .376 | .376 | .376 | .381 | .376 |
| .20 | .249 | .244 | .248 | .251 | .249 |
| .50 | .104 | .097 | .099 | .104 | .104 |
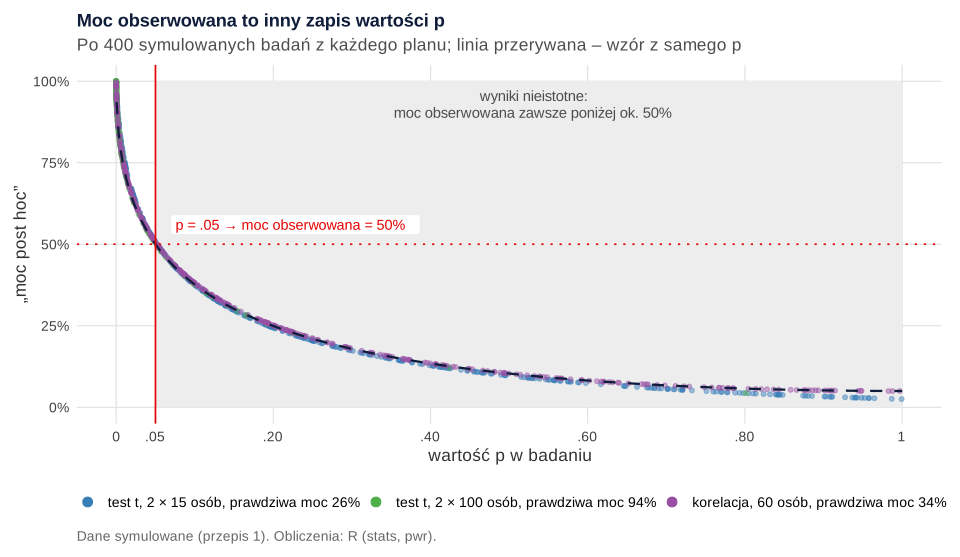
Przy p = .05 moc obserwowana wynosi około 50% – w każdym teście i przy każdej liczebności. Przy wyniku nieistotnym zawsze wychodzi poniżej mniej więcej 50%, a przy p = .50 – około 10%. Studentka z przykładu nie musi niczego liczyć, żeby wiedzieć, że przy p = .502 dostanie „moc” około 10% (dokładnie: 10.2%).
Symulacja to potwierdza. Przepis 1 losuje po 2000 badań w trzech różnych planach: test t przy 2 × 15 osobach (prawdziwa moc 26.2%), test t przy 2 × 100 osobach (prawdziwa moc 94.0%) i korelację przy 60 osobach (prawdziwa moc 33.8%). W każdym badaniu liczy p i moc obserwowaną. Korelacja rang Spearmana między nimi wyniosła −1.000 we wszystkich trzech planach. Wszystkie 6000 punktów leży na jednej krzywej: największe odchylenie od wzoru z samego p wyniosło .037 (rysunek 1). Dziak, Dierker i Abar (2020) opisują to tak: moc obserwowana jest monotoniczną funkcją wartości p, więc nie zawiera żadnej dodatkowej informacji.
Dlaczego „moc była niska, więc efekt może istnieć” nie działa
Najczęstsze zdanie z moc post hoc brzmi: „Moc wyniosła tylko 10%, dlatego nie wykryto różnicy”. Ma ono dwie wady.
Po pierwsze, to tautologia. Niska moc obserwowana nie jest przyczyną wyniku nieistotnego. Wynika z niego, bo została policzona z tego samego p. Zdanie mówi tyle, co „wynik był nieistotny, bo był nieistotny”.
Po drugie, nie odróżnia badań słabych od mocnych. W symulacji plan 2 × 100 osób miał prawdziwą moc 94.0%. Tylko 5.6% badań dało w nim wynik nieistotny – a w każdym z nich moc obserwowana wyszła poniżej 50% (najwyżej .499). Gdyby autor takiego badania napisał „moc była niska”, myliłby się: badanie było bardzo czułe, a wynik nieistotny jest w nim poważną wskazówką, że duży efekt nie istnieje. Moc obserwowana daje ten sam niski wynik w badaniu na 30 osobach i w badaniu na 200 osobach. Nie da się więc nią ocenić, czy próba była za mała. Yuan i Maxwell (2005) pokazali analitycznie i symulacyjnie, że moc post hoc jest prawie zawsze obciążonym estymatorem prawdziwej mocy. Gdy prawdziwa moc wynosi .5, jej rozkład jest jednostajny, więc może wyjść niemal dowolna wartość.
Paradoks z dwoma wynikami. Weź dwa badania po 30 osób w grupie. W pierwszym p = .06 (d = 0.50), w drugim p = .60 (d = 0.14). Moc obserwowana wynosi 47.1% i 7.5%. Ktoś, kto uważa, że „wysoka moc przy wyniku nieistotnym przemawia za brakiem efektu”, musiałby uznać pierwsze badanie za mocniejszy dowód braku efektu. Tymczasem to w nim efekt w próbie był ponad trzy razy większy, a p – bliższe istotności. Logika „mocy po fakcie” prowadzi tu do wniosku odwrotnego do danych. Hoenig i Heisey (2001) nazywają interpretowanie wyników nieistotnych mocą liczoną po badaniu podejściem z gruntu błędnym. Goodman i Berlin (1994) podsumowują to tak: moc nie powinna odgrywać żadnej roli po zebraniu danych, a do interpretacji służą przedziały ufności. Błędne interpretacje mocy są też na liście 25 typowych błędów, którą przygotowali Greenland i in. (2016).
Kolumna „Observed Power” w SPSS
Wielu studentów trafia na moc post hoc przypadkiem. W SPSS w oknie opcji procedur GLM (np. Analyze → General Linear Model → Univariate → Options) jest pole Observed power. Według dokumentacji IBM daje ono moc testu przy hipotezie alternatywnej ustalonej na poziomie wartości zaobserwowanej. To dokładnie moc post hoc. Po zaznaczeniu tego pola w tabeli testów efektów pojawia się kolumna z mocą przy każdym efekcie, a obok często partial eta squared.
Co z tym zrobić? Najprościej – nie zaznaczać pola i nie przepisywać tej kolumny do pracy. Jeśli już jest w tabeli, usuń ją. Wielkość efektu (eta kwadrat cząstkowe) zostaw i uzupełnij przedziałem ufności – zob. wielkość efektu – interpretacja. Jeśli promotor zobaczył kolumnę w wydruku i pyta, dlaczego jej nie ma w pracy, odpowiedź znajdziesz w sekcji „Odpowiedź dla promotora”.
Co podać zamiast: trzy liczby
Wróćmy do studentki. Średnie poczucie skuteczności wyniosło 26.97 (SD = 5.24) w grupie po symulacji i 27.76 (SD = 4.07) w grupie tradycyjnej. Różnica była nieistotna, t(62) = −0.68, p = .502. Przepis 2 liczy trzy rzeczy, które mówią o tym wyniku więcej niż moc obserwowana (10.2%).
1. Przedział ufności i najmniejszy efekt, który wykluczył
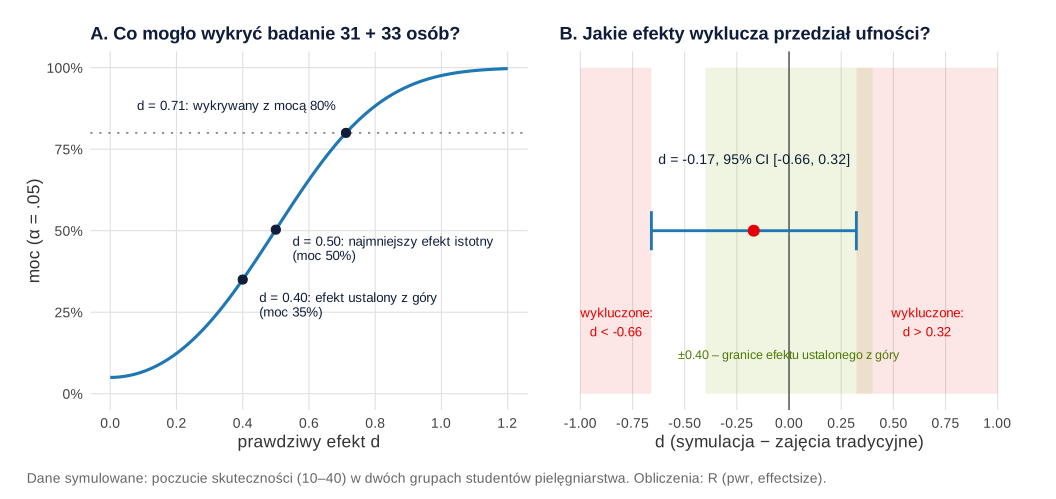
Różnica średnich wyniosła −0.79 punktu, 95% CI [−3.13, 1.55], czyli d = −0.17, 95% CI [−0.66, 0.32]. Przedział ufności czytaj od końców. Dane są niezgodne (na poziomie 95%) z korzyścią z zajęć w centrum symulacji większą niż 1.55 punktu (d = 0.32) i ze stratą większą niż 3.13 punktu (d = −0.66). Wszystko pomiędzy jest z danymi zgodne – od małej straty po małą korzyść.
Studentka przed badaniem uznała, że zajęcia są warte wdrożenia, jeśli podnoszą skuteczność co najmniej o 2 punkty (przy zakładanym SD = 5 to d = 0.40). Górna granica przedziału (0.32) jest niższa niż 0.40. Korzyść tej wielkości jest więc z danymi niezgodna, choć mniejszej korzyści i małej straty wykluczyć nie można (rysunek 2B). Formalnie brak efektu sprawdza test równoważności TOST (Lakens i in., 2018). Tutaj by go nie wykazał, bo dolna granica −0.66 wychodzi poza −0.40. Krok po kroku TOST pokazujemy w poradniku hipoteza się nie potwierdziła – co dalej. Szerzej o czytaniu i raportowaniu przedziałów piszemy we wpisie przedziały ufności w pracy.
2. Analiza wrażliwości: co badanie mogło wykryć
Analiza wrażliwości pyta: przy 31 i 33 osobach i α = .05, jaki efekt test wykrywa z mocą 80%? Odpowiedź to d = 0.71, czyli około 3.33 punktu (przy mocy 90% – d = 0.82). Druga liczba pomocnicza: wynik byłby istotny dopiero przy |d| ≥ 0.50 w próbie (2.34 punktu). Obie liczby nie korzystają z wyniku badania, tylko z jego planu. Dlatego – inaczej niż moc obserwowana – naprawdę opisują czułość badania.
Do tego dochodzi moc dla efektu ustalonego z góry. Dla d = 0.40 wynosi 35.0%. To uprawnione obliczenie po badaniu, bo efekt nie pochodzi z danych. Mówi ono wprost: nawet gdyby zajęcia dawały korzyść 2 punktów, takie badanie wykryłoby ją mniej więcej w jednym przypadku na trzy. Do mocy 80% przy tym efekcie potrzeba 100 osób w każdej grupie. Jak przygotować taką liczbę przed kolejnym badaniem, opisujemy we wpisie dobór liczebności próby.
3. To samo dla korelacji i odsetków
Analizę wrażliwości liczysz dla każdego głównego testu w pracy, nie tylko dla testu t. W pakiecie pwr robi to jedna funkcja: podajesz liczebność i moc, a pomijasz wielkość efektu. Dla dwóch pozostałych hipotez studentki:
| Hipoteza | Wynik i 95% CI | Najmniejszy efekt istotny | Efekt wykrywany z mocą 80% | Funkcja w R |
|---|---|---|---|---|
| H1: skuteczność w dwóch grupach (31 i 33) | d = −0.17 [−0.66, 0.32] | |d| = 0.50 | d = 0.71 | pwr.t2n.test() |
| H2: skuteczność a godziny praktyk (n = 64) | r = .07 [−.18, .31] | |r| = .25 | r = .34 | pwr.r.test() |
| H3: zdany egzamin (83.9% i 75.8%) | różnica 8.1 pp [−11.4, 27.6] | – | h = 0.70 (np. 97.3% wobec 75.8%) | pwr.2p2n.test() |
Przy H3 tabela mówi najwięcej. Badanie wykrywałoby z mocą 80% dopiero różnicę około 21.6 punktu procentowego, a przedział ufności obejmuje wszystko od −11.4 do 27.6 punktu. Wynik jest więc nierozstrzygający, a nie „dowodem, że zajęcia nie poprawiają zdawalności”. Przedział dla różnicy odsetków liczy tu prop.test() metodą Walda. W pracy lepiej podać przedział Newcombe’a. Moc dla ANOVA, regresji i χ² z większą liczbą kategorii policzysz w kalkulatorze mocy. W G*Power ten sam typ obliczenia nazywa się sensitivity.
Gotowe zdania do pracy
Do części o metodzie (uzasadnienie liczebności po fakcie, gdy próba wynikała z dostępności):
Do rozdziału wyników (wzór zdania dla wyniku nieistotnego – szerzej w poradniku jak opisać wynik nieistotny):
Do ograniczeń badania (zob. też ograniczenia badania – jak je opisać; jak wrócić do tego w dyskusji, pokazujemy we wpisie jak napisać dyskusję wyników):
Odpowiedź dla promotora lub recenzenta pracy
Uwagę promotora traktuj poważnie. Pod prośbą o „moc post hoc” zwykle kryje się słuszne pytanie: czy badanie mogło cokolwiek wykazać? Odpowiedz na to pytanie, a nie odrzucaj prośby. W rozmowie lub w odpowiedzi na uwagi wystarczy kilka zdań:
Ta odpowiedź daje promotorowi to, o co naprawdę pytał – ocenę, czy próba była za mała – i to w lepszej formie. Jeśli promotor mimo to chce zobaczyć liczbę, możesz podać ją w przypisie razem ze zdaniem, że moc obserwowana wynika z p i nie zmienia interpretacji. Nie buduj jednak na niej wniosków („moc była niska, więc efekt prawdopodobnie istnieje”). Wzory odpowiedzi recenzentom czasopism, także po angielsku, są we wpisie odpowiedź recenzentom – wzory. Inne typowe uwagi do rozdziału wyników zebraliśmy w tekstach poprawki promotora w rozdziale wyników i zarzuty recenzentów do statystyki.
Najczęstsze błędy
- „Moc post hoc wyniosła 10%, więc próba była za mała”. Tę samą moc obserwowaną dostałoby badanie z 1000 osób i tym samym p. O wielkości próby mówi analiza wrażliwości.
- „Moc wyniosła 85%, więc wynik istotny jest wiarygodny”. Przy p < .05 moc obserwowana zawsze przekracza około 50%. Wysoka liczba nic nie potwierdza.
- Przepisanie kolumny Observed Power z SPSS do tabeli. To moc post hoc dla każdego efektu. Usuń ją, zostaw wielkość efektu z przedziałem.
- Analiza wrażliwości z efektem z próby. Jeśli do
pwr.t2n.test()wpiszesz d z własnych danych, znów dostaniesz moc obserwowaną. W analizie wrażliwości wielkość efektu jest wynikiem, nie danymi wejściowymi. - Wniosek „efektu nie ma” z samego p > .05. Przedział [−0.66, 0.32] obejmuje także małą korzyść i umiarkowaną stratę. Brak efektu wykazuje test równoważności, a dla prostszych pytań wystarczy opis przedziału.
- Moc dla „średniego efektu” bez uzasadnienia. Efekt ustalony z góry ma sens, jeśli wynika z literatury albo z tego, jaka zmiana jest praktycznie ważna – zob. najmniejszy interesujący efekt.
Jeśli chcesz, żeby ktoś sprawdził z Tobą analizę wrażliwości, przedziały ufności i odpowiedź na uwagi promotora, zobacz pomoc w analizie dla studentów.
Moc post hoc i analiza wrażliwości w R
Dwa przepisy liczą wszystkie liczby z tekstu. Pierwszy pokazuje, że moc obserwowana zależy tylko od p (wzory i symulacja trzech planów), drugi liczy przykład studentki: test t, przedziały ufności, najmniejszy efekt istotny, analizę wrażliwości dla trzech hipotez i – dla porównania – moc obserwowaną. Drugi przepis zapisuje dane w pliku CSV w folderze nadrzędnym (../). Rysunki powstały w osobnym skrypcie z wyników obu przepisów. Dane przykładu możesz pobrać: moc-post-hoc-przyklad.csv (64 osoby: grupa, poczucie skuteczności 10–40, godziny praktyk, zdany egzamin 0/1).
Moc obserwowana jako funkcja p: wzory i symulacja
R
# B442 – moc obserwowana („moc post hoc”) jako funkcja wartości p
suppressPackageStartupMessages(library(pwr))

# Moc obserwowana: do wzoru na moc wstawiamy efekt z próby, który wynika wprost z p
moc_t <- function(p, n) {                      # test t, dwie grupy po n osób
  d <- qt(1 - p / 2, df = 2 * n - 2) * sqrt(2 / n)
  power.t.test(n = n, delta = d)$power
}
moc_r <- function(p, n) {                      # korelacja Pearsona, n osób
  t <- qt(1 - p / 2, df = n - 2)
  pwr.r.test(n = n, r = t / sqrt(n - 2 + t^2))$power
}
moc_chi <- function(p, N) {                    # chi-kwadrat 2 × 2 (df = 1), N osób
  pwr.chisq.test(w = sqrt(qchisq(1 - p, df = 1) / N), N = N, df = 1)$power
}
moc_z <- function(p) {                         # przybliżenie normalne
  z <- qnorm(1 - p / 2)
  pnorm(z - 1.96) + pnorm(-z - 1.96)
}

p <- c(.001, .01, .05, .10, .20, .30, .50, .80)
tab <- data.frame(p = p,
                  z = sapply(p, moc_z),
                  t_2x15 = sapply(p, moc_t, n = 15),
                  t_2x150 = sapply(p, moc_t, n = 150),
                  r_n60 = sapply(p, moc_r, n = 60),
                  chi_N400 = sapply(p, moc_chi, N = 400))
cat("Moc obserwowana dla danego p w pięciu wariantach testu:\n")
print(round(tab, 3), row.names = FALSE)

# Symulacja: trzy różne badania, w każdym 2000 powtórzeń
set.seed(4421)
R <- 2000
sym_t <- function(n, d) {
  t(replicate(R, {
    x <- rnorm(n); y <- rnorm(n, d)
    p <- t.test(y, x, var.equal = TRUE)$p.value
    c(p = p, moc_obs = moc_t(p, n))
  }))
}
s1 <- data.frame(badanie = "t, 2 × 15, d = 0.5", sym_t(15, 0.5))
s2 <- data.frame(badanie = "t, 2 × 100, d = 0.5", sym_t(100, 0.5))
s3 <- data.frame(badanie = "r, n = 60, rho = .2", t(replicate(R, {
  x <- rnorm(60); y <- .2 * x + sqrt(1 - .2^2) * rnorm(60)
  p <- cor.test(x, y)$p.value
  c(p = p, moc_obs = moc_r(p, 60))
})))
sym <- rbind(s1, s2, s3)

cat("\nPrawdziwa moc: 2 × 15:", round(power.t.test(n = 15, delta = 0.5)$power, 3),
    "| 2 × 100:", round(power.t.test(n = 100, delta = 0.5)$power, 3),
    "| r, n = 60:", round(pwr.r.test(n = 60, r = .2)$power, 3), "\n")
cat("\nPodsumowanie symulacji:\n")
for (b in unique(sym$badanie)) {
  s <- sym[sym$badanie == b, ]
  ni <- s$p >= .05
  cat(sprintf("%-20s istotne: %.3f | mediana mocy obs.: %.3f | max mocy obs. przy p >= .05: %.3f | rho Spearmana (p, moc obs.): %.3f\n",
              b, mean(!ni), median(s$moc_obs), max(s$moc_obs[ni]),
              cor(s$p, s$moc_obs, method = "spearman")))
}
cat(sprintf("Największa różnica mocy obs. od przybliżenia normalnego (wszystkie %d badań): %.3f\n",
            nrow(sym), max(abs(sym$moc_obs - sapply(sym$p, moc_z)))))

# Paradoks: dwa wyniki nieistotne, ta sama liczebność (2 × 30)
cat("\nDwa wyniki nieistotne przy 2 × 30 osobach:\n")
for (pp in c(.06, .60)) {
  d <- qt(1 - pp / 2, 58) * sqrt(2 / 30)
  cat(sprintf("p = %s: d w próbie = %.2f, moc obserwowana = %.3f\n", sub("^0", "", formatC(pp, format = "f", digits = 2)), d, moc_t(pp, 30)))
}

write.csv(tab, "b442-moc-od-p.csv", row.names = FALSE)
write.csv(sym, "b442-symulacja.csv", row.names = FALSE)
Wynik w R
Moc obserwowana dla danego p w pięciu wariantach testu:
     p     z t_2x15 t_2x150 r_n60 chi_N400
 0.001 0.908  0.944   0.912 0.918    0.908
 0.010 0.731  0.760   0.734 0.742    0.731
 0.050 0.500  0.507   0.501 0.507    0.500
 0.100 0.376  0.376   0.376 0.381    0.376
 0.200 0.249  0.244   0.248 0.251    0.249
 0.300 0.179  0.174   0.177 0.180    0.179
 0.500 0.104  0.097   0.099 0.104    0.104
 0.800 0.057  0.043   0.044 0.057    0.057

Prawdziwa moc: 2 × 15: 0.262 | 2 × 100: 0.94 | r, n = 60: 0.338

Podsumowanie symulacji:
t, 2 × 15, d = 0.5  istotne: 0.258 | mediana mocy obs.: 0.255 | max mocy obs. przy p >= .05: 0.507 | rho Spearmana (p, moc obs.): -1.000
t, 2 × 100, d = 0.5 istotne: 0.944 | mediana mocy obs.: 0.946 | max mocy obs. przy p >= .05: 0.499 | rho Spearmana (p, moc obs.): -1.000
r, n = 60, rho = .2  istotne: 0.344 | mediana mocy obs.: 0.345 | max mocy obs. przy p >= .05: 0.506 | rho Spearmana (p, moc obs.): -1.000
Największa różnica mocy obs. od przybliżenia normalnego (wszystkie 6000 badań): 0.037

Dwa wyniki nieistotne przy 2 × 30 osobach:
p = .06: d w próbie = 0.50, moc obserwowana = 0.471
p = .60: d w próbie = 0.14, moc obserwowana = 0.075
Co zamiast: przedział ufności, najmniejszy efekt istotny i analiza wrażliwości
R
# B442 – co podać zamiast mocy post hoc: CI, najmniejszy efekt istotny, analiza wrażliwości
suppressPackageStartupMessages({ library(pwr); library(effectsize) })
bz <- function(x, k = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = k))   # zapis APA bez zera

# Dane symulowane: 64 studentki i studenci pielęgniarstwa przed pierwszą praktyką
set.seed(4422)
n1 <- 31; n2 <- 33
dane <- data.frame(
  grupa = rep(c("symulacja", "tradycyjne"), c(n1, n2)),
  skutecznosc = round(c(rnorm(n1, 27.5, 5), rnorm(n2, 26, 5))),      # skala 10–40
  godziny_praktyk = round(runif(n1 + n2, 20, 120)),
  egzamin_zdany = c(rbinom(n1, 1, .80), rbinom(n2, 1, .70))
)
dane$skutecznosc <- dane$skutecznosc + round(0.02 * (dane$godziny_praktyk - 70))
dane$skutecznosc <- pmin(pmax(dane$skutecznosc, 10), 40)
write.csv(dane, "../moc-post-hoc-przyklad.csv", row.names = FALSE)
dane$grupa <- factor(dane$grupa, levels = c("symulacja", "tradycyjne"))

# H1: skuteczność w dwóch grupach – test t, różnica średnich i d z 95% CI
cat("Średnie (SD):\n")
print(round(sapply(split(dane$skutecznosc, dane$grupa), function(x) c(M = mean(x), SD = sd(x), n = length(x))), 2))
tt <- t.test(skutecznosc ~ grupa, data = dane, var.equal = TRUE)
d <- cohens_d(skutecznosc ~ grupa, data = dane)
sp <- sqrt(((n1 - 1) * var(dane$skutecznosc[dane$grupa == "symulacja"]) +
            (n2 - 1) * var(dane$skutecznosc[dane$grupa == "tradycyjne"])) / (n1 + n2 - 2))
cat(sprintf("\nH1: t(%d) = %.2f, p = %s; różnica = %.2f pkt, 95%% CI [%.2f, %.2f]\n",
            tt$parameter, tt$statistic, bz(tt$p.value), diff(rev(tt$estimate)), tt$conf.int[1], tt$conf.int[2]))
cat(sprintf("    d = %.2f, 95%% CI [%.2f, %.2f]; SD łączne = %.2f pkt\n", d$Cohens_d, d$CI_low, d$CI_high, sp))

# 1. Najmniejszy efekt, który dałby p < .05 przy tej liczebności
d_kryt <- qt(.975, n1 + n2 - 2) * sqrt(1 / n1 + 1 / n2)
cat(sprintf("\nNajmniejsze |d| istotne przy 31 i 33 osobach: %.2f (%.2f pkt)\n", d_kryt, d_kryt * sp))

# 2. Analiza wrażliwości: efekt wykrywany z mocą 80% i 90%
d80 <- pwr.t2n.test(n1 = n1, n2 = n2, power = .80)$d
d90 <- pwr.t2n.test(n1 = n1, n2 = n2, power = .90)$d
cat(sprintf("Efekt wykrywany z mocą 80%%: d = %.2f (%.2f pkt); z mocą 90%%: d = %.2f\n", d80, d80 * sp, d90))

# 3. Moc dla efektu ustalonego przed badaniem (SESOI = 2 pkt, d = 0.40) – to nie jest moc post hoc
cat(sprintf("Moc dla d = 0.40 ustalonego z góry: %.3f\n", pwr.t2n.test(n1 = n1, n2 = n2, d = 0.40)$power))
cat(sprintf("Osób na grupę dla mocy 80%% przy d = 0.40: %d\n", ceiling(pwr.t.test(d = 0.40, power = .80)$n)))

# Dla porównania: „moc post hoc”, o którą prosi promotor
cat(sprintf("Moc obserwowana (z d z próby): %.3f\n", pwr.t2n.test(n1 = n1, n2 = n2, d = d$Cohens_d)$power))

# H2: korelacja skuteczności z liczbą godzin praktyk
ct <- cor.test(dane$skutecznosc, dane$godziny_praktyk)
cat(sprintf("\nH2: r(%d) = %s, p = %s, 95%% CI [%s, %s]\n",
            ct$parameter, bz(ct$estimate, 2), bz(ct$p.value), bz(ct$conf.int[1], 2), bz(ct$conf.int[2], 2)))
cat(sprintf("    najmniejsze |r| istotne: %s; r wykrywane z mocą 80%%: %s\n",
            bz(qt(.975, 62) / sqrt(62 + qt(.975, 62)^2), 2), bz(pwr.r.test(n = 64, power = .80)$r, 2)))

# H3: odsetek zdających egzamin praktyczny za pierwszym razem
tab <- table(dane$grupa, dane$egzamin_zdany)[, c("1", "0")]
pt <- prop.test(tab, correct = FALSE)
cat(sprintf("\nH3: zdało %d/%d (%.1f%%) i %d/%d (%.1f%%); chi2(1) = %.2f, p = %s\n",
            tab[1, 1], n1, 100 * pt$estimate[1], tab[2, 1], n2, 100 * pt$estimate[2], pt$statistic, bz(pt$p.value)))
cat(sprintf("    różnica = %.1f pp, 95%% CI [%.1f, %.1f] (przedział Walda z prop.test)\n",
            100 * diff(rev(pt$estimate)), 100 * pt$conf.int[1], 100 * pt$conf.int[2]))
h80 <- pwr.2p2n.test(n1 = n1, n2 = n2, power = .80)$h
p_kontr <- pt$estimate[2]
p_wykr <- sin(asin(sqrt(p_kontr)) + h80 / 2)^2      # odsetek w grupie symulacji odpowiadający h80
cat(sprintf("    h wykrywane z mocą 80%%: %.2f, czyli np. %.1f%% wobec %.1f%% (różnica %.1f pp)\n",
            h80, 100 * p_wykr, 100 * p_kontr, 100 * (p_wykr - p_kontr)))

# Krzywa mocy planu 31 + 33 (do rysunku 2)
krzywa <- data.frame(d = seq(0, 1.2, by = .01))
krzywa$moc <- sapply(krzywa$d, function(x) if (x == 0) .05 else pwr.t2n.test(n1 = n1, n2 = n2, d = x)$power)
write.csv(krzywa, "b442-krzywa-mocy.csv", row.names = FALSE)
write.csv(data.frame(d = d$Cohens_d, lo = d$CI_low, hi = d$CI_high, d_kryt = d_kryt, d80 = d80, sesoi = 0.40),
          "b442-wynik-h1.csv", row.names = FALSE)
Wynik w R
Średnie (SD):
   symulacja tradycyjne
M      26.97      27.76
SD      5.24       4.07
n      31.00      33.00

H1: t(62) = -0.68, p = .502; różnica = -0.79 pkt, 95% CI [-3.13, 1.55]
    d = -0.17, 95% CI [-0.66, 0.32]; SD łączne = 4.67 pkt

Najmniejsze |d| istotne przy 31 i 33 osobach: 0.50 (2.34 pkt)
Efekt wykrywany z mocą 80%: d = 0.71 (3.33 pkt); z mocą 90%: d = 0.82
Moc dla d = 0.40 ustalonego z góry: 0.350
Osób na grupę dla mocy 80% przy d = 0.40: 100
Moc obserwowana (z d z próby): 0.102

H2: r(62) = .07, p = .574, 95% CI [-.18, .31]
    najmniejsze |r| istotne: .25; r wykrywane z mocą 80%: .34

H3: zdało 26/31 (83.9%) i 25/33 (75.8%); chi2(1) = 0.65, p = .420
    różnica = 8.1 pp, 95% CI [-11.4, 27.6] (przedział Walda z prop.test)
    h wykrywane z mocą 80%: 0.70, czyli np. 97.3% wobec 75.8% (różnica 21.6 pp)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami pwr i effectsize; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim oddasz rozdział z wynikiem nieistotnym, sprawdź…
- Czy w pracy nie ma mocy obserwowanej ani kolumny Observed Power z SPSS?
- Czy każdy główny wynik ma wielkość efektu z 95% przedziałem ufności?
- Czy w metodzie jest uzasadnienie liczebności: analiza mocy a priori albo analiza wrażliwości?
- Czy efekt, dla którego podajesz moc po badaniu, ustalono niezależnie od danych (SESOI, literatura)?
- Czy w opisie wyniku piszesz, jakie efekty przedział wyklucza, a jakich nie?
- Czy nie piszesz „efektu nie ma”, jeśli nie wykonano testu równoważności?
- Czy ograniczenia mówią, jaki efekt badanie mogło przeoczyć i ile osób byłoby potrzebnych?
- Czy masz krótką odpowiedź dla promotora, gdyby poprosił o moc post hoc?
Najczęstsze pytania
Czy kolumna Observed Power w tabeli ANOVA z SPSS to moc post hoc?
Tak. Według dokumentacji IBM SPSS liczy ją przy hipotezie alternatywnej równej wartości zaobserwowanej, czyli dokładnie tak jak moc post hoc. Kolumny nie przepisuj do pracy. Zostaw wielkość efektu (np. eta kwadrat cząstkowe) z przedziałem ufności, a czułość badania opisz analizą wrażliwości.
Czy moc policzona po badaniu dla efektu z literatury to też moc post hoc?
Nie. Problemem mocy post hoc jest efekt wzięty z własnej próby. Moc dla efektu ustalonego niezależnie od danych – z literatury albo jako najmniejszy efekt ważny w praktyce – mówi, czy badanie było czułe na efekt, który się liczy. W przykładzie z tego wpisu dla d = 0.40 wynosiła 35%.
Promotor nalega na moc post hoc mimo wyjaśnień – co zrobić?
Pokaż, że odpowiadasz na jego właściwe pytanie, czyli czy próba była za mała: dodaj analizę wrażliwości, przedziały ufności i zdanie w ograniczeniach. Jeśli nadal chce liczby, podaj moc obserwowaną w przypisie ze zdaniem, że wynika ona z wartości p i nie zmienia interpretacji. Nie wyciągaj z niej wniosku, że efekt „prawdopodobnie istnieje”.
Czy wysoka moc obserwowana potwierdza wynik istotny?
Nie. Przy p < .05 moc obserwowana zawsze przekracza mniej więcej 50%, a przy p = .01 wynosi około 73%. Liczba ta niczego nie dodaje do samego p. Wiarygodność wyniku istotnego lepiej ocenić po szerokości przedziału ufności i po tym, czy hipotezę i analizę zaplanowano przed badaniem.
Czy analizę wrażliwości trzeba policzyć dla każdej hipotezy w pracy?
Wystarczy dla głównych testów, zwłaszcza tych z wynikiem nieistotnym. Dla testu t, korelacji i różnicy odsetków w pakiecie pwr robi to jedna funkcja (pwr.t2n.test, pwr.r.test, pwr.2p2n.test): podajesz liczebność i moc 80%, a pomijasz wielkość efektu. Wynik w pracy zapisz jednym zdaniem w części o metodzie.
Powiązane hasła
Przeczytaj też
Zebrano mniej osób, niż planowano
Dobierać dalej czy analizować? Drzewo decyzji, symulacja dobierania w R, analiza wrażliwości i gotowe zdania do Metody i Ograniczeń.
Czytaj →PoradnikPromotor prosi o analizę, która nie działa
Dziesięć typowych próśb, potrzeba promotora, propozycja i gotowa uprzejma wiadomość. Co rozstrzyga statystyka, co zwyczaj, a czego nie zrobisz.
Czytaj →PoradnikJak opisać wynik nieistotny
Co podać przy p > .05, jak odróżnić brak efektu od wyniku nierozstrzygającego, sformułowania źle i dobrze oraz gotowy wzór opisu w stylu APA.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →PoradnikMoc testu i liczebność próby – zadania
Dziesięć zadań: liczebność dla testu t, proporcji i korelacji, moc przy danym n, minimalny efekt, ubytek, efekt schematu, α i moc po fakcie.
Czytaj →PoradnikPrzedziały ufności w pracy dyplomowej
Zapis APA, wybór przedziału dla średniej, odsetka, różnicy, korelacji i OR, poprawne i błędne zdania, nakładanie się przedziałów i słupki błędów – z tabelą wyników w R.
Czytaj →PoradnikKalkulator mocy: ANOVA, χ², regresja
Moc dla N albo N dla mocy w jednoczynnikowej ANOVA, teście chi-kwadrat, regresji (R² i ΔR²) i interakcji 2 × 2. Wzory, kod R i opis APA.
Czytaj →Promotor prosi o moc post hoc?
Pomożemy przygotować analizę wrażliwości, przedziały ufności i rzeczową odpowiedź na uwagi – w R lub SPSS, z wyjaśnieniem, które pozwoli Ci samodzielnie obronić wyniki nieistotne.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Dziak, J. J., Dierker, L. C., & Abar, B. (2020). The interpretation of statistical power after the data have been gathered. Current Psychology, 39(3), 870–877. https://doi.org/10.1007/s12144-018-0018-1 ● Otwarty dostęp: pełny tekst
- Goodman, S. N., & Berlin, J. A. (1994). The use of predicted confidence intervals when planning experiments and the misuse of power when interpreting results. Annals of Internal Medicine, 121(3), 200–206. https://doi.org/10.7326/0003-4819-121-3-199408010-00008
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Yuan, K.-H., & Maxwell, S. (2005). On the post hoc power in testing mean differences. Journal of Educational and Behavioral Statistics, 30(2), 141–167. https://doi.org/10.3102/10769986030002141
- Zhang, Y., Hedo, R., Rivera, A., Rull, R., Richardson, S., & Tu, X. M. (2019). Post hoc power analysis: Is it an informative and meaningful analysis? General Psychiatry, 32(4), Article e100069. https://doi.org/10.1136/gpsych-2019-100069 ● Otwarty dostęp
Cytowania BibTeX
@article{dziak2020interpretation, author={Dziak, John J. and Dierker, Lisa C. and Abar, Beau}, title={{The interpretation of statistical power after the data have been gathered}}, journal={Current Psychology}, year={2020}, volume={39}, number={3}, pages={870--877}, doi={10.1007/s12144-018-0018-1}}@article{goodman1994use, author={Goodman, Steven N. and Berlin, Jesse A.}, title={{The use of predicted confidence intervals when planning experiments and the misuse of power when interpreting results}}, journal={Annals of Internal Medicine}, year={1994}, volume={121}, number={3}, pages={200--206}, doi={10.7326/0003-4819-121-3-199408010-00008}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{yuan2005post, author={Yuan, Ke-Hai and Maxwell, Scott}, title={{On the post hoc power in testing mean differences}}, journal={Journal of Educational and Behavioral Statistics}, year={2005}, volume={30}, number={2}, pages={141--167}, doi={10.3102/10769986030002141}}@article{zhang2019post, author={Zhang, Yiran and Hedo, Rita and Rivera, Anna and Rull, Rudolph and Richardson, Sabrina and Tu, Xin M.}, title={{Post hoc power analysis: Is it an informative and meaningful analysis?}}, journal={General Psychiatry}, year={2019}, volume={32}, number={4}, eid={e100069}, doi={10.1136/gpsych-2019-100069}}