Uwagi promotora do wyników: od czego zacząć
Rozdział wrócił z kilkunastoma komentarzami na marginesie: „N?”, „p = .000??”, „to jest dyskusja”, „brak H3”. To normalny etap pracy. Większość uwag do rozdziału z wynikami powtarza się w kolejnych pracach i da się je poprawić według prostych reguł. Zanim jednak zaczniesz zmieniać tekst, zrób trzy rzeczy:
- Przeczytaj wszystkie uwagi do końca. Część z nich wynika z jednego problemu. Gdy zmienia się liczebność próby, zmieniają się też tabele, stopnie swobody i wartości p.
- Podziel uwagi na trzy grupy: zapis (format liczb, tabele), analizy (test, założenia, brakujące wyniki) i interpretację (język, miejsce wniosków). Najpierw poprawiaj analizy, bo od nich zależy cała reszta.
- Załóż tabelę poprawek – jedna uwaga to jeden wiersz (wzór do pobrania znajdziesz niżej).
Poniżej omawiamy 15 najczęstszych uwag. Przy każdej wyjaśniamy, dlaczego promotor jej wymaga, jak ją poprawić, i pokazujemy przykład „przed → po”. Wszystkie liczby pochodzą z jednego badania (dane symulowane, analizy w R). W badaniu ankietowym osób studiujących sprawdzano trzy hipotezy: H1 – prokrastynacja wiąże się dodatnio ze stresem akademickim; H2 – wsparcie społeczne wiąże się z niższym stresem niezależnie od prokrastynacji; H3 – osoby pracujące zarobkowo odczuwają wyższy stres niż niepracujące. To schemat korelacyjny z jednym pomiarem, co będzie ważne przy uwadze 15.
Wzorcowy rozdział wyników od początku do końca pokazujemy we wpisie wyniki badań własnych – przykład, a gotowe zdania do opisu poszczególnych testów – w poradniku jak opisać wyniki w stylu APA. Ten tekst dotyczy sytuacji, w której rozdział już istnieje i trzeba go poprawić.
Próba i liczby
Uwaga 1. „Ile osób w końcu zbadano?” – niespójne N i brak opisu wykluczeń
Dlaczego promotor tego wymaga. Gdy w metodzie jest 241 osób, w tabelach 208, a w stopniach swobody jeszcze inna liczba, czytelnik nie wie, które wyniki dotyczą której próby. Standardy raportowania APA (JARS–Quant) zalecają podanie liczby uczestników na każdym etapie badania, najlepiej z rysunkiem przepływu, oraz kryteriów wykluczeń po zebraniu danych (American Psychological Association, b.d.).
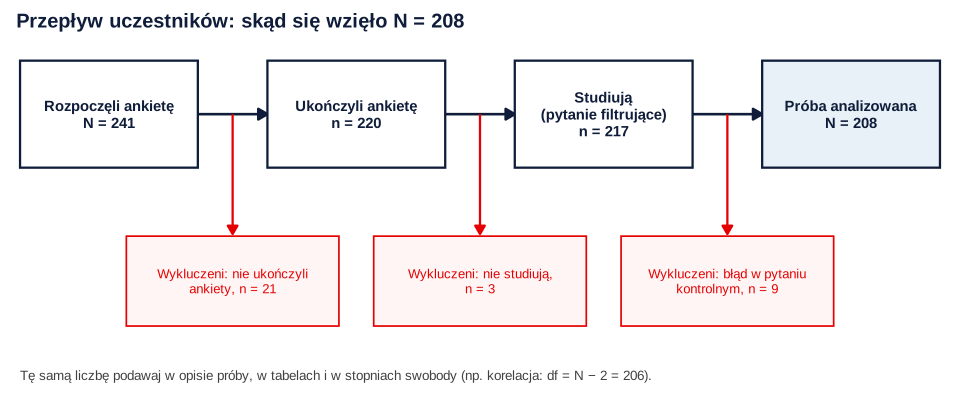
Jak poprawić. Opisz drogę od liczby osób, które rozpoczęły badanie, do próby analizowanej: ile osób wykluczono na każdym etapie i dlaczego (rysunek 1). Potem sprawdź, czy wszędzie widnieje ta sama liczba, także w stopniach swobody. Dla korelacji df = N − 2, więc przy 208 osobach to 206, a nie 239. Jeśli w części analiz są braki danych, podaj n przy każdej analizie i wyjaśnij różnice.
| Przed poprawką | Po poprawce |
|---|---|
| „W badaniu wzięło udział 241 osób.” W tabelach N = 208, a w tekście r(239) = .45. | Przepływ 241 → 208 opisany w tekście i na rysunku; wszędzie N = 208 i r(206) = .45 |
Uwaga 2. „Procent z czego?” – odsetki bez liczebności
Dlaczego promotor tego wymaga. Ten sam licznik daje różne odsetki przy różnych mianownikach. W przykładzie 45 osób korzystających z pomocy psychologicznej to 18.7% z 241 osób, które rozpoczęły ankietę, ale 21.6% z 208 osób analizowanych. Sam odsetek ukrywa też precyzję: 12.8% mężczyzn to tylko 12 osób.
Jak poprawić. Przy każdym odsetku podaj licznik i mianownik („33 ze 114 kobiet, 28.9%”), a odsetki licz od próby analizowanej albo od osób, które odpowiedziały na dane pytanie. Gdy porównujesz odsetki w grupach, dołącz test i miarę siły związku, np. test chi-kwadrat z φ albo V Craméra.
| Przed poprawką | Po poprawce |
|---|---|
| „Z pomocy psychologicznej korzystało 18.7% badanych, przy czym kobiety ponad dwa razy częściej niż mężczyźni (29% wobec 13%).” | „Z pomocy psychologicznej w ostatnim roku korzystało 45 z 208 osób (21.6%): 33 ze 114 kobiet (28.9%) i 12 z 94 mężczyzn (12.8%), χ²(1, N = 208) = 7.96, p = .005, φ = .20.” |
Zapis statystyk
Uwaga 3. „Gdzie są wielkości efektu?” – sama wartość p
Dlaczego promotor tego wymaga. Wartość p nie mówi, jak silny jest związek czy jak duża jest różnica. JARS–Quant zaleca, by przy każdym teście podać oszacowanie wielkości efektu z przedziałem ufności, gdy tylko to możliwe (American Psychological Association, b.d.). Lakens (2013) pokazuje, jak obliczać i raportować wielkości efektu dla testów t i ANOVA tak, by inni mogli ich użyć w analizie mocy i metaanalizie.
Jak poprawić. Dodaj do każdego testu miarę efektu (r, d, η², φ, β) z 95% CI i jedno zdanie o jej wielkości. Wynik bardzo istotny nie musi być silny: w przykładzie p = .002 dotyczy związku, który odpowiada około 4% wspólnej wariancji. Szerzej o tym, czego APA oczekuje w raportowaniu statystyki, piszemy we wpisie wytyczne APA dla metodologii i statystyki.
| Przed poprawką | Po poprawce |
|---|---|
| „Wsparcie społeczne istotnie wiązało się ze stresem (p = .002).” | „Wyższe wsparcie społeczne wiązało się z niższym stresem, r = −.21, 95% CI [−.34, −.08], p = .002. Związek był niewielki: odpowiadał około 4% wspólnej wariancji obu zmiennych.” |
Uwaga 4. „p nie może być równe zero” – p = .000 i zbyt wiele miejsc po przecinku
Dlaczego promotor tego wymaga. Program pokazuje „.000”, gdy p jest mniejsze niż .0005, bo zaokrągla do trzech miejsc. Wartość p nie jest jednak równa zeru. Przewodnik APA po liczbach i statystykach zaleca podawanie dokładnych wartości p z dwoma lub trzema miejscami po przecinku, zapis p < .001 dla wartości mniejszych i pomijanie zera przed przecinkiem w statystykach, które nie mogą przekroczyć 1 (American Psychological Association, 2024). Siedem cyfr współczynnika korelacji to z kolei fałszywa precyzja, bo żadne badanie nie mierzy tak dokładnie.
Jak poprawić. Zaokrąglaj zwykle do dwóch miejsc (p do trzech), zapisuj p < .001 i sprawdź zera przed przecinkiem. Pełne zasady zapisu, zgodne z rozdziałem 6 podręcznika APA (American Psychological Association, 2020), zebraliśmy w części „Zasady zapisu wyników w stylu APA”.
| Przed poprawką | Po poprawce |
|---|---|
| „Korelacja prokrastynacji ze stresem wyniosła 0,4473907 (p = .000).” | „Prokrastynacja korelowała dodatnio ze stresem, r = .45, 95% CI [.33, .55], p < .001.” |
Uwaga 5. „Przecinek czy kropka?” – mieszane konwencje dziesiętne
Dlaczego promotor tego wymaga. W polskich tekstach separatorem dziesiętnym jest zwyczajowo przecinek i wiele wydziałów wymaga go także w pracach dyplomowych. Styl APA – a za nim metodolog.pl – stosuje kropkę. Obie konwencje są do przyjęcia. Błędem jest dopiero ich mieszanie: „3,18” w tekście, „0.75” w tabeli i „,561” skopiowane z programu.
Jak poprawić. Sprawdź wytyczne swojego wydziału i stosuj jedną konwencję konsekwentnie w tekście, tabelach i na rysunkach. Przy przecinku dziesiętnym oddzielaj liczby średnikiem, żeby uniknąć niejednoznaczności (np. granice przedziału [3,07; 3,28]). Sprawdź też, czy wydział oczekuje zera przed przecinkiem w wartościach p i r. Nie zamieniaj kropek na przecinki automatycznie w całym pliku, bo kropki występują też w skrótach, datach, numerach DOI i bibliografii.
| Przed poprawką (mieszane) | Po poprawce: kropka (APA) | Po poprawce: przecinek (wytyczne wydziału) |
|---|---|---|
| „Średni stres wynosił 3,18 (SD = 0.75), 95% CI [3.07, 3.28].” | „Średni stres wynosił M = 3.18 (SD = 0.75), 95% CI [3.07, 3.28].” | „Średni stres wynosił M = 3,18 (SD = 0,75), 95% CI [3,07; 3,28].” |
Tabele i rysunki
Uwaga 6. „Tabela bez numeru, tytułu i noty”
Dlaczego promotor tego wymaga. Tabela musi być zrozumiała bez czytania tekstu: z numerem, do którego odwołuje się tekst, tytułem mówiącym, co pokazuje, i notą wyjaśniającą skróty, liczebność i oznaczenia. Zasady i wzory tabel w stylu APA zbiera m.in. praktyczny przewodnik Nicol i Pexman (2010).
Jak poprawić. Nad tabelą umieść pogrubiony numer i tytuł kursywą, w tabeli zostaw tylko linie poziome, a pod nią dodaj notę „Uwaga.” z N, objaśnieniem skrótów i gwiazdek. Liczby wyrównaj do tej samej liczby miejsc po przecinku. Tak wygląda poprawiona tabela z przykładu:
Tabela 1
Statystyki opisowe, rzetelność i korelacje Pearsona między prokrastynacją, wsparciem społecznym i stresem akademickim
| Zmienna | M | SD | 1 | 2 | 3 |
|---|---|---|---|---|---|
| 1. Prokrastynacja (1–5) | 2.95 | 0.80 | (.88) | ||
| 2. Wsparcie społeczne (1–7) | 4.99 | 0.72 | −.08 | (.89) | |
| 3. Stres akademicki (1–5) | 3.18 | 0.75 | .45*** | −.21** | (.89) |
Uwaga. N = 208. Na przekątnej w nawiasach podano alfę Cronbacha. Dane symulowane.
**p < .01. ***p < .001.
Szesnaście wzorów tabel dla różnych analiz znajdziesz we wpisie tabele APA – wzory i przykłady, a tabelę korelacji z plikiem do pobrania w haśle tabela korelacji w APA.
Uwaga 7. „To samo jest w tabeli i w tekście”
Dlaczego promotor tego wymaga. Tekst, który wylicza wszystkie średnie i korelacje z tabeli, wydłuża rozdział i niczego nie wyjaśnia. Tabela ma przechowywać komplet liczb, a tekst – wskazywać najważniejsze z nich.
Jak poprawić. Odeślij do tabeli i opisz w tekście tylko to, co odpowiada na pytanie badawcze albo jest nieoczekiwane.
| Przed poprawką | Po poprawce |
|---|---|
| „Średnia prokrastynacji wyniosła 2.95, a odchylenie standardowe 0.80, alfa Cronbacha .88. Średnia wsparcia wyniosła 4.99, odchylenie 0.72, alfa .89. Średnia stresu wyniosła 3.18…” (i tak dalej dla całej tabeli) | „Statystyki opisowe, rzetelność skal i korelacje przedstawiono w tabeli 1. Wszystkie skale miały dobrą spójność wewnętrzną (α od .88 do .89).” |
Uwaga 8. „To jest wydruk z programu, nie wynik” – kopiowanie tabel SPSS
Dlaczego promotor tego wymaga. Zrzut ekranu albo przepisany wydruk zawiera etykiety programu („Sig.”), zbędne kolumny i oba warianty testu naraz. Czytelnik musi sam zgadywać, który wiersz jest ważny. Rozdział wyników to tekst naukowy, a nie załącznik z wydrukami.
Jak poprawić. Z wydruku przepisz tylko to, co potrzebne do zapisu APA, i zamień etykiety na symbole. W porównaniu dwóch grup stosuj domyślnie test t Welcha. Delacre i in. (2017) pokazują, że lepiej kontroluje on błąd I rodzaju przy nierównych wariancjach, niewiele traci, gdy wariancje są równe, a wybór testu na podstawie wstępnego testu Levene’a często zawodzi. Jak czytać poszczególne tabele wydruku, wyjaśniamy we wpisie jak czytać wyniki z SPSS.
| Fragment przepisany z wydruku | Co z nim zrobić |
|---|---|
| „Test Levene’a: F = 0,589; Sig. = ,444. Założono równość wariancji.” | Usuń z tekstu. Test Welcha nie wymaga równości wariancji, więc wystarczy w metodzie zdanie, że go zastosowano. |
| „t = 0,582; df = 206; Sig. = ,561” (wiersz dla równych wariancji) | Podaj wynik testu Welcha: t(153.80) = 0.57, p = .568 |
| Brak średnich i wielkości efektu | Dodaj M i SD grup oraz d = 0.08, 95% CI [−0.20, 0.36] |
Uwaga 9. „Ten wykres nic nie mówi” – wykresy kołowe i 3D
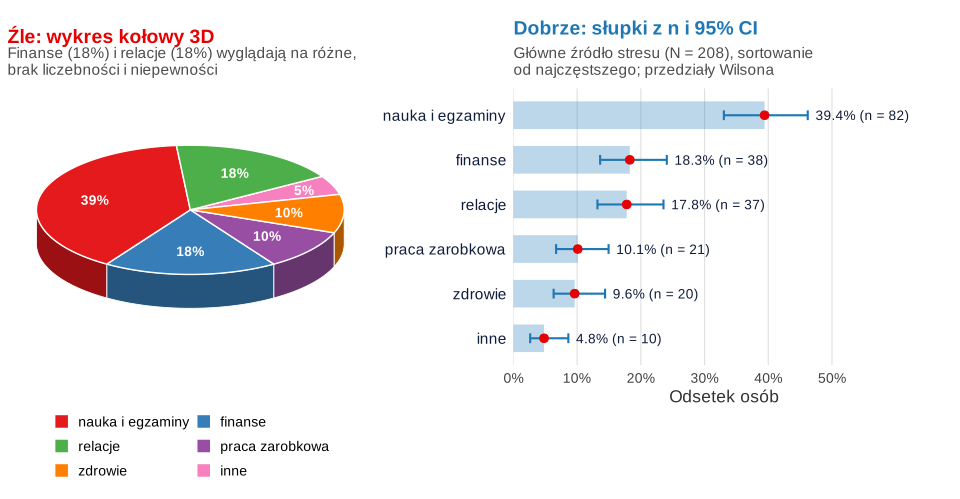
Dlaczego promotor tego wymaga. Cleveland i McGill (1984) uporządkowali elementarne zadania percepcyjne według tego, jak dokładnie ludzie odczytują dzięki nim liczby z wykresów. Zalecili, by wykres korzystał z zadań z najwyższych miejsc tego porządku, uznali, że popularne wykresy – także kołowe – wymagają „radykalnej chirurgii”, i zaproponowali w zamian m.in. wykresy punktowe. W eksperymencie Siegrista (1996) osoby badane trafniej szacowały wielkości z płaskich wykresów kołowych niż z trójwymiarowych. Efekt 3D zniekształca proporcje: wycinek z przodu wygląda na większy, bo widać jego boczną ściankę.
Jak poprawić. Odsetki pokaż na wykresie punktowym albo słupkowym, posortowanym od największej kategorii, z liczebnościami i przedziałami ufności (rysunek 2). Dla zmiennych ilościowych lepsze od słupków ze średnimi są wykresy pokazujące rozkład, np. wykres pudełkowy albo punkty osób. Weissgerber i in. (2015) przypominają, że słupki ze średnimi mogą wyglądać identycznie przy bardzo różnych rozkładach danych.
Analizy
Uwaga 10. „Jak to się ma do hipotez?” – analiza niezgodna z hipotezą
Dlaczego promotor tego wymaga. Hipoteza określa, jaką analizę trzeba wykonać. H2 mówi o związku wsparcia ze stresem niezależnie od prokrastynacji, więc sama korelacja na nią nie odpowiada. Potrzebny jest model, w którym prokrastynacja jest kontrolowana. Podobne niezgodności to hipoteza o różnicy sprawdzana korelacją albo hipoteza kierunkowa opisana bez kierunku.
Jak poprawić. Ułóż rozdział według hipotez, w tej samej kolejności i z tym samym brzmieniem co w rozdziale metodologicznym. Przy każdej sprawdź, czy analiza odpowiada na jej pytanie (pomocna jest tabela w poradniku jak dobrać test statystyczny do hipotezy).
| Przed poprawką | Po poprawce |
|---|---|
| „Hipoteza H2 została potwierdzona: wsparcie społeczne korelowało ze stresem, r = −.21, p = .002.” | Regresja wieloraka stresu na prokrastynację i wsparcie (opis poniżej) |
Uwaga 11. „A założenia?” – brak sprawdzenia założeń albo sprawdzenie niewłaściwych
Dlaczego promotor tego wymaga. Wynik testu jest wiarygodny tylko wtedy, gdy jego założenia są w przybliżeniu spełnione. JARS–Quant zaleca opisanie problemów z założeniami i rozkładami, które mogą wpływać na trafność wyników (American Psychological Association, b.d.). Ernst i Albers (2017) przejrzeli artykuły z 12 czasopism psychologii klinicznej. W 92% prac stosujących regresję liniową nie opisano jasno sprawdzenia założeń, a w 4% za konieczne założenie błędnie uznano normalność samych zmiennych zamiast reszt.
Jak poprawić. W regresji oceniaj reszty: wykres reszt względem wartości przewidywanych (liniowość i stała wariancja), wykres Q-Q reszt (normalność), VIF (współliniowość) i odległość Cooka (obserwacje wpływowe). Testom normalności w dużych próbach nie ufaj bezkrytycznie – piszemy o tym w poradniku jak sprawdzić normalność rozkładu.
| Przed poprawką | Po poprawce |
|---|---|
| „Normalność rozkładu zmiennych sprawdzono testem Shapiro–Wilka (stres: p = .062), więc założenia regresji uznano za spełnione.” | Opis diagnostyki reszt modelu (poniżej) |
Uwaga 12. „Dlaczego trzy testy t?” – niewłaściwy test przy kilku grupach
Dlaczego promotor tego wymaga. Porównanie trzech lat studiów trzema osobnymi testami t zwiększa ryzyko fałszywego wyniku. Przy trzech niezależnych testach na poziomie .05 szansa na co najmniej jeden fałszywy alarm wynosi już 14.3%. Właściwa jest jedna analiza dla wszystkich grup i porównania post hoc z korektą. Delacre i in. (2019) rekomendują domyślnie test F Welcha, bo przy realistycznie zróżnicowanych wariancjach klasyczny test F daje obciążone wyniki.
Jak poprawić. Wykonaj analizę wariancji (w wersji Welcha), a różnice między parami grup sprawdź testem post hoc z kontrolą błędu, np. Gamesa–Howella. Opis krok po kroku znajdziesz w poradniku ANOVA krok po kroku. W przykładzie poprawka zmienia wniosek:
| Przed poprawką | Po poprawce |
|---|---|
| „Osoby z I roku miały istotnie wyższy stres niż osoby z IV–V roku, t(115.15) = 2.13, p = .035; pozostałe porównania były nieistotne.” | „Średni stres nie różnił się istotnie między latami studiów, F(2, 125.18) = 2.36, p = .099, η² = .02 (ANOVA Welcha). Największa różnica, między I a IV–V rokiem, wyniosła 0.29 punktu, 95% CI [−0.03, 0.62], p = .087 (test Gamesa–Howella).” |
Uwaga 13. „Gdzie jest wynik dla H3?” – pominięte wyniki nieistotne
Dlaczego promotor tego wymaga. JARS–Quant zaleca podanie wyników wszystkich wykonanych testów, a w dyskusji – stwierdzenia, czy każda hipoteza się potwierdziła (American Psychological Association, b.d.). Hipoteza bez wyniku albo z jednym zdaniem „nie potwierdziła się (p > .05)” wygląda tak, jakby coś ukrywano.
Jak poprawić. Opisz wynik nieistotny z tymi samymi informacjami co istotny, dodaj wielkość efektu z przedziałem ufności i informację, jaki efekt badanie mogło wykryć. Jak przeanalizować taki wynik, łącznie z testem równoważności, pokazujemy w poradniku hipoteza się nie potwierdziła.
Interpretacja i język
Uwaga 14. „To już dyskusja” – interpretacja w rozdziale wyników
Dlaczego promotor tego wymaga. Rozdział wyników odpowiada na pytanie, co wyszło. Odniesienia do teorii, porównania z innymi badaniami i zalecenia praktyczne należą do dyskusji. Jeśli pojawią się w wynikach, dyskusja zacznie je powtarzać albo zabraknie w niej materiału.
Jak poprawić. W wynikach zostaw kierunek i siłę efektu oraz decyzję o hipotezie. Resztę przenieś do dyskusji (zob. poradnik jak napisać dyskusję wyników).
| Przed poprawką | Po poprawce |
|---|---|
| „Prokrastynacja korelowała ze stresem (r = .45), co potwierdza teorię X i pokazuje, że uczelnie powinny uczyć studentów zarządzania czasem.” | Wyniki: „Zgodnie z hipotezą H1 wyższa prokrastynacja wiązała się z wyższym stresem, r = .45, 95% CI [.33, .55], p < .001.” Teoria i zalecenia – w dyskusji. |
Uwaga 15. „Badanie korelacyjne nie pokazuje wpływu” – język przyczynowy
Dlaczego promotor tego wymaga. W badaniu z jednym pomiarem i bez manipulacji nie wiadomo, co jest przyczyną, a co skutkiem. Stres może sprzyjać odkładaniu pracy, a obie zmienne mogą zależeć od trzeciej (zob. korelacja pozorna). Problem nie dotyczy tylko prac dyplomowych. W przeglądzie Habera i in. (2018) 34% najczęściej udostępnianych w mediach społecznościowych artykułów naukowych o związkach różnych czynników ze zdrowiem używało języka, który recenzenci uznali za zbyt mocny w stosunku do siły wnioskowania przyczynowego.
Jak poprawić. Zamień „wpływa”, „zwiększa”, „obniża”, „powoduje” na „wiąże się z”, „współwystępuje”, „osoby z wyższym X miały wyższy Y”. Uwaga dotyczy też słowa „predyktor”: w regresji oznacza ono zmienną, na podstawie której przewidujemy, a nie przyczynę.
| Przed poprawką | Po poprawce |
|---|---|
| „Prokrastynacja zwiększa stres (β = 0.43), a wsparcie społeczne go obniża (β = −0.18).” | „Wyższa prokrastynacja wiązała się z wyższym stresem, β = 0.43, 95% CI [0.31, 0.55], a wyższe wsparcie społeczne – z niższym stresem, β = −0.18, 95% CI [−0.30, −0.05], przy kontroli drugiej zmiennej.” |
Jak wprowadzać poprawki: tabela zmian, wersje i ponowne przeliczenie
Poprawianie rozdziału z wynikami to nie tylko edycja tekstu. Każda zmiana w danych albo w analizie przenosi się na tabele, rysunki i dyskusję. Pomaga stały porządek pracy:
- Zachowaj wersję z komentarzami promotora bez zmian, a poprawki wprowadzaj w kopii z nowym numerem i datą, np.
Nowak_praca_v3_2026-10-16.docx. Zmiany zaznaczaj w trybie śledzenia zmian albo kolorem, jeśli promotor tak woli. - Prowadź tabelę poprawek: numer uwagi, jej treść, co zmieniono, gdzie (strona, podrozdział) i status. Wzór w Wordzie z trzema przykładowymi wierszami możesz pobrać: tabela-poprawek-promotora.docx.
- Gdy zmieniają się dane albo analiza, przelicz wszystko od nowa ze składni SPSS albo ze skryptu R, zamiast poprawiać pojedyncze liczby ręcznie. Zapisz plik składni lub skryptu obok danych.
- Popraw wszystkie podobne miejsca, nie tylko to zaznaczone. Promotor zwykle oznacza pierwsze „p = .000”, a nie wszystkie dwanaście.
- Sprawdź spójność liczb: czy N w tekście i tabelach się zgadza, czy stopnie swobody pasują do liczebności i czy wartość p pasuje do statystyki testu.
Ostatni punkt nie jest formalnością. Nuijten i in. (2016) przeanalizowali ponad 250 tysięcy wartości p z ośmiu czasopism psychologicznych za pomocą pakietu R statcheck. W połowie artykułów, w których testowano istotność, co najmniej jedna wartość p nie zgadzała się ze statystyką testu i stopniami swobody, a w co ósmym niezgodność mogła zmienić wniosek statystyczny. Spójność sprawdzisz w R jedną funkcją (przepis 2 w sekcji Przykład w R). Na przykład dla zapisu t(206) = 0.58 poprawna wartość p mieści się między .559 a .566, więc „p = .056” zdradza literówkę. Z kolei r = −.21 przy 241 osobach dałoby p = .001, a nie .002 – to sygnał, że w tekście pomylono liczebność.
Wiadomość do promotora z listą zmian
Do poprawionej wersji dołącz krótką wiadomość. Promotor nie musi wtedy szukać zmian w całym rozdziale, a Ty masz okazję zadać pytania. Wymień najważniejsze zmiany i uwagi, których nie wprowadziłeś, z krótkim uzasadnieniem:
Gdy nie zgadzasz się z uwagą
Zdarza się, że uwaga promotora rozmija się z aktualnymi zaleceniami metodologicznymi. Nie ignoruj jej i nie wdawaj się w spór w komentarzach. Zaproponuj rozwiązanie, które spełnia oba oczekiwania, i podaj źródło. Ostateczna decyzja w pracy dyplomowej należy do promotora, a Twoim zadaniem jest umieć ją uzasadnić na obronie. Trzy częste sytuacje:
| Uwaga | Problem | Co zaproponować |
|---|---|---|
| „Proszę dodać moc post hoc” | Moc obliczona z uzyskanego efektu powtarza informację z wartości p | Analizę wrażliwości: dla jakiego efektu badanie miało 80% mocy (zob. moc testu) |
| „Proszę sprawdzić normalność każdej zmiennej” | W regresji założenie dotyczy reszt, nie zmiennych (Ernst i Albers, 2017) | Diagnostykę reszt, a testy zmiennych – w aneksie, jeśli promotor ich oczekuje |
| „Test Levene’a nieistotny, więc test t Studenta” | Dobór testu na podstawie wstępnego testu równości wariancji często zawodzi (Delacre i in., 2017) | Test Welcha jako analizę główną i test Studenta w przypisie – wnioski zwykle się nie różnią |
Pytania o takie decyzje mogą wrócić na obronie, dlatego warto przygotować na nie odpowiedź – przykłady zebraliśmy we wpisie pytania na obronie z metodologii i statystyki.
Kiedy poprosić o pomoc statystyka
Uwagi dotyczące zapisu poprawisz samodzielnie. Pomoc statystyka przydaje się, gdy uwaga wymaga zmiany analizy: innego testu, modelu z kowariantami, sprawdzenia założeń, ponownego przeliczenia po zmianie próby albo odpowiedzi na pytanie, którego nie rozumiesz. Jeśli potrzebujesz takiego wsparcia, zajrzyj do oferty analiz statystycznych dla studentów: obejmuje ona konsultację i sprawdzenie analiz, a przy projektach przygotowanych z nami także poprawki i odpowiedzi na uwagi promotora – z wyjaśnieniem, co się zmieniło i dlaczego. Pamiętaj, że to Ty odpowiadasz za pracę: musisz rozumieć każdą liczbę w rozdziale, umieć ją obronić i ujawnić pomoc zgodnie z zasadami uczelni.
Przykład w R
Kod odtwarza wszystkie liczby z przykładów „przed → po”, tabeli 1 i rysunków. Przepis 2 to niezależna funkcja do sprawdzania spójności p, której możesz użyć na własnym rozdziale.
1. Dane i liczby do przykładów
R
# Dane symulowane do przykładów „przed → po”: badanie ankietowe (schemat korelacyjny, jeden pomiar)
# „Prokrastynacja, wsparcie społeczne i stres akademicki u osób studiujących”.
# H1: prokrastynacja wiąże się dodatnio ze stresem.
# H2: wsparcie społeczne wiąże się z niższym stresem niezależnie od prokrastynacji.
# H3: osoby pracujące zarobkowo odczuwają wyższy stres niż niepracujące.
suppressPackageStartupMessages({
  library(psych)        # alpha(), describe()
  library(effectsize)   # cohens_d(), standardize_parameters(), eta_squared()
  library(car)          # leveneTest(), vif()
})
set.seed(2806)

# ---- Przepływ uczestników: kto rozpoczął ankietę, kto został w analizie
N_start <- 241
surowe <- data.frame(id = 1:N_start,
                     ukonczyl    = rbinom(N_start, 1, .93) == 1,   # doszedł do końca ankiety
                     studiuje    = rbinom(N_start, 1, .98) == 1,   # pytanie filtrujące: status studenta
                     kontrola_ok = rbinom(N_start, 1, .96) == 1)   # poprawna odpowiedź na pytanie kontrolne
przeplyw <- c(rozpoczelo   = N_start,
              nieukonczone = sum(!surowe$ukonczyl),
              nie_student  = sum(surowe$ukonczyl & !surowe$studiuje),
              kontrola_zle = sum(surowe$ukonczyl & surowe$studiuje & !surowe$kontrola_ok),
              w_analizie   = sum(surowe$ukonczyl & surowe$studiuje & surowe$kontrola_ok))
przeplyw

# ---- Zmienne w próbie analizowanej
n <- przeplyw[["w_analizie"]]
plec  <- factor(sample(c("kobieta", "mężczyzna"), n, TRUE, c(.63, .37)), levels = c("kobieta", "mężczyzna"))
wiek  <- pmin(pmax(round(rnorm(n, 22.3, 2.1)), 19), 30)
rok   <- factor(sample(c("I rok", "II–III rok", "IV–V rok"), n, TRUE, c(.34, .38, .28)),
                levels = c("I rok", "II–III rok", "IV–V rok"))
praca <- factor(rbinom(n, 1, .45), levels = 0:1, labels = c("nie pracuje", "pracuje"))
prok_l  <- rnorm(n)                                                   # prokrastynacja (zmienna ukryta)
wsp_l   <- -0.15 * prok_l + rnorm(n, sd = 0.99)                       # wsparcie społeczne
stres_l <- 0.38 * prok_l - 0.28 * wsp_l + 0.30 * (plec == "kobieta") +
           0.06 * (praca == "pracuje") + 0.25 * (rok == "I rok") + rnorm(n, sd = 0.80)
pozycje <- function(l, k, srodek, min, max) {                         # k pozycji skali o zakresie min–max
  sapply(1:k, function(j) pmin(pmax(round(srodek + 0.75 * l + rnorm(n, sd = 0.75)), min), max))
}
P <- pozycje(prok_l, 8, 3, 1, 5); W <- pozycje(wsp_l, 12, 5, 1, 7); S <- pozycje(stres_l, 10, 3, 1, 5)
dane <- data.frame(plec, wiek, rok, praca,
                   prokrastynacja = rowMeans(P), wsparcie = rowMeans(W), stres = rowMeans(S))
# korzystanie z pomocy psychologicznej w ostatnim roku i główne źródło stresu (pytanie jednokrotnego wyboru)
dane$pomoc <- factor(rbinom(n, 1, plogis(-1.9 + 0.75 * (plec == "kobieta") + 0.45 * as.numeric(scale(dane$stres)))),
                     levels = 0:1, labels = c("nie", "tak"))
zrodla <- c("nauka i egzaminy", "finanse", "relacje", "praca zarobkowa", "zdrowie", "inne")
dane$zrodlo <- factor(sample(zrodla, n, TRUE, c(.41, .19, .15, .12, .08, .05)), levels = zrodla)

# ---- Opis próby i przepływ (uwagi 1 i 2)
table(dane$plec); round(100 * prop.table(table(dane$plec)), 1)
round(c(M = mean(dane$wiek), SD = sd(dane$wiek), min = min(dane$wiek), max = max(dane$wiek)), 2)
tab_pomoc <- table(dane$plec, dane$pomoc)
tab_pomoc
round(100 * prop.table(tab_pomoc, 1), 1)
chi_pomoc <- chisq.test(tab_pomoc, correct = FALSE)
chi_pomoc
unname(sqrt(chi_pomoc$statistic / n))                                   # φ
k_pomoc <- sum(dane$pomoc == "tak")                                    # ten sam licznik, dwa różne mianowniki:
c(k = k_pomoc, proc_z_241 = round(100 * k_pomoc / N_start, 1), proc_z_analizy = round(100 * k_pomoc / n, 1))

# ---- Statystyki opisowe, rzetelność i korelacje (uwagi 3, 4, 6, 7)
round(sapply(list(prokrastynacja = P, wsparcie = W, stres = S), function(x) alpha(as.data.frame(x))$total$raw_alpha), 2)
round(describe(dane[, c("prokrastynacja", "wsparcie", "stres")])[, c("n", "mean", "sd", "skew", "kurtosis")], 2)
r_h1 <- cor.test(dane$prokrastynacja, dane$stres)
r_h1
r_ws <- cor.test(dane$wsparcie, dane$stres); r_pw <- cor.test(dane$prokrastynacja, dane$wsparcie)
round(rbind(prok_stres = c(r_h1$estimate, r_h1$conf.int), wsp_stres = c(r_ws$estimate, r_ws$conf.int),
            prok_wsp = c(r_pw$estimate, r_pw$conf.int)), 3)
format.pval(c(r_h1$p.value, r_ws$p.value, r_pw$p.value), digits = 3, eps = .001)
round(unname(r_ws$estimate)^2, 3)                                       # r² – wspólna wariancja wsparcia i stresu
round(t.test(dane$stres)$conf.int, 2)                                   # 95% CI dla średniego stresu
r_h1$estimate; r_h1$p.value                                             # „surowe” wartości z programu

# ---- H2: regresja wieloraka (uwagi 10, 11, 15)
model_h2 <- lm(stres ~ prokrastynacja + wsparcie, data = dane)
summary(model_h2)
round(confint(model_h2), 3)
standardize_parameters(model_h2)
round(vif(model_h2), 2)
lmtest::bptest(model_h2)                                                # stałość wariancji reszt
round(c(max_rstudent = max(abs(rstudent(model_h2))), max_Cook = max(cooks.distance(model_h2))), 3)
shapiro.test(residuals(model_h2))
shapiro.test(dane$stres)                                                # test normalności samej zmiennej
cor.test(dane$prokrastynacja, dane$stres, method = "spearman", exact = FALSE)

# ---- H3: stres a praca zarobkowa (uwagi 8 i 13)
aggregate(stres ~ praca, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
leveneTest(stres ~ praca, data = dane, center = mean)                  # tak liczy test Levene’a SPSS
t.test(stres ~ praca, data = dane, var.equal = TRUE)                   # wiersz „równe wariancje”
t.test(stres ~ praca, data = dane)                                     # test Welcha
print(cohens_d(stres ~ praca, data = dane)); cat("\n")
ng <- table(dane$praca); n_h <- 2 / sum(1 / ng)                      # średnia harmoniczna liczebności grup
round(power.t.test(n = n_h, sd = 1, sig.level = .05, power = .80, strict = TRUE)$delta, 2)   # d wykrywane z mocą 80%

# ---- Rok studiów: trzy testy t czy jedna analiza? (uwaga 12)
aggregate(stres ~ rok, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
pary <- combn(levels(dane$rok), 2, simplify = FALSE)
sapply(pary, function(p) { d <- droplevels(subset(dane, rok %in% p)); round(t.test(stres ~ rok, data = d)$p.value, 4) })
t.test(stres ~ rok, data = droplevels(subset(dane, rok %in% c("I rok", "IV–V rok"))))   # jedyna „istotna” para
round(1 - (1 - .05)^3, 3)                                               # ryzyko ≥ 1 fałszywego wyniku przy 3 niezależnych testach
oneway.test(stres ~ rok, data = dane)                                   # ANOVA Welcha
round(eta_squared(aov(stres ~ rok, data = dane), ci = NULL)$Eta2, 3)
rstatix::games_howell_test(dane, stres ~ rok)[, c("group1", "group2", "estimate", "conf.low", "conf.high", "p.adj")]

# ---- Główne źródło stresu: liczebności, odsetki i 95% CI (Wilsona) – dane do rysunku (uwaga 9)
liczn <- table(dane$zrodlo)
ci_w <- t(sapply(liczn, function(k) prop.test(k, n, correct = FALSE)$conf.int))
data.frame(n = as.vector(liczn), procent = round(100 * as.vector(liczn) / n, 1),
           CI_dolna = round(100 * ci_w[, 1], 1), CI_gorna = round(100 * ci_w[, 2], 1), row.names = names(liczn))
Wynik w R
  rozpoczelo nieukonczone  nie_student kontrola_zle   w_analizie
         241           21            3            9          208

  kobieta mężczyzna
      114        94

  kobieta mężczyzna
     54.8      45.2
    M    SD   min   max
22.16  2.05 19.00 27.00

            nie tak
  kobieta    81  33
  mężczyzna  82  12

             nie  tak
  kobieta   71.1 28.9
  mężczyzna 87.2 12.8

	Pearson's Chi-squared test

data:  tab_pomoc
X-squared = 7.9566, df = 1, p-value = 0.004791

[1] 0.1955837
             k     proc_z_241 proc_z_analizy
          45.0           18.7           21.6
prokrastynacja       wsparcie          stres
          0.88           0.89           0.89
                 n mean   sd  skew kurtosis
prokrastynacja 208 2.95 0.80  0.06    -0.58
wsparcie       208 4.99 0.72  0.31    -0.52
stres          208 3.18 0.75 -0.16    -0.64

	Pearson's product-moment correlation

data:  dane$prokrastynacja and dane$stres
t = 7.1799, df = 206, p-value = 1.245e-11
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.3315275 0.5499594
sample estimates:
      cor
0.4473907

              cor
prok_stres  0.447  0.332  0.550
wsp_stres  -0.209 -0.336 -0.075
prok_wsp   -0.077 -0.211  0.060
[1] "< 0.001" "0.00241" "0.26840"
[1] 0.044
[1] 3.07 3.28
attr(,"conf.level")
[1] 0.95
      cor
0.4473907
[1] 1.245144e-11

Call:
lm(formula = stres ~ prokrastynacja + wsparcie, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-1.93329 -0.45325  0.02978  0.46707  1.53831

Coefficients:
               Estimate Std. Error t value Pr(>|t|)
(Intercept)     2.88617    0.37791   7.637 8.31e-13 ***
prokrastynacja  0.40997    0.05805   7.062 2.51e-11 ***
wsparcie       -0.18424    0.06436  -2.863  0.00464 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.6635 on 205 degrees of freedom
Multiple R-squared:  0.2309,	Adjusted R-squared:  0.2234
F-statistic: 30.77 on 2 and 205 DF,  p-value: 2.056e-12

                2.5 % 97.5 %
(Intercept)     2.141  3.631
prokrastynacja  0.296  0.524
wsparcie       -0.311 -0.057
# Standardization method: refit

Parameter      | Std. Coef. |         95% CI
--------------------------------------------
(Intercept)    |  -1.71e-16 | [-0.12,  0.12]
prokrastynacja |       0.43 | [ 0.31,  0.55]
wsparcie       |      -0.18 | [-0.30, -0.05]
prokrastynacja       wsparcie
          1.01           1.01

	studentized Breusch-Pagan test

data:  model_h2
BP = 0.087445, df = 2, p-value = 0.9572

max_rstudent     max_Cook
       3.001        0.061

	Shapiro-Wilk normality test

data:  residuals(model_h2)
W = 0.98814, p-value = 0.08167


	Shapiro-Wilk normality test

data:  dane$stres
W = 0.98737, p-value = 0.06187


	Spearman's rank correlation rho

data:  dane$prokrastynacja and dane$stres
S = 827710, p-value = 1.144e-11
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.4481138

        praca stres.M stres.SD stres.n
1 nie pracuje    3.20     0.73  130.00
2     pracuje    3.14     0.79   78.00
Levene's Test for Homogeneity of Variance (center = mean)
       Df F value Pr(>F)
group   1  0.5894 0.4435
      206

	Two Sample t-test

data:  stres by praca
t = 0.58161, df = 206, p-value = 0.5615
alternative hypothesis: true difference in means between group nie pracuje and group pracuje is not equal to 0
95 percent confidence interval:
 -0.1501306  0.2757716
sample estimates:
mean in group nie pracuje     mean in group pracuje
                 3.200000                  3.137179


	Welch Two Sample t-test

data:  stres by praca
t = 0.57197, df = 153.8, p-value = 0.5682
alternative hypothesis: true difference in means between group nie pracuje and group pracuje is not equal to 0
95 percent confidence interval:
 -0.1541526  0.2797937
sample estimates:
mean in group nie pracuje     mean in group pracuje
                 3.200000                  3.137179

Cohen's d |        95% CI
-------------------------
0.08      | [-0.20, 0.36]

- Estimated using pooled SD.
[1] 0.4
         rok stres.M stres.SD stres.n
1      I rok    3.34     0.73   60.00
2 II–III rok    3.16     0.75   90.00
3   IV–V rok    3.04     0.77   58.00
[1] 0.1426 0.0349 0.3811

	Welch Two Sample t-test

data:  stres by rok
t = 2.1347, df = 115.15, p-value = 0.0349
alternative hypothesis: true difference in means between group I rok and group IV–V rok is not equal to 0
95 percent confidence interval:
 0.02117007 0.56595637
sample estimates:
   mean in group I rok mean in group IV–V rok
              3.336667               3.043103

[1] 0.143

	One-way analysis of means (not assuming equal variances)

data:  stres and rok
F = 2.3558, num df = 2.00, denom df = 125.18, p-value = 0.09901

For one-way between subjects designs, partial eta squared is equivalent to eta squared. Returning
  eta squared.
[1] 0.022
# A tibble: 3 × 6
  group1     group2     estimate conf.low conf.high p.adj
  <chr>      <chr>         <dbl>    <dbl>     <dbl> <dbl>
1 I rok      II–III rok   -0.181   -0.472    0.110  0.306
2 I rok      IV–V rok     -0.294   -0.620    0.0330 0.087
3 II–III rok IV–V rok     -0.112   -0.416    0.191  0.655
                  n procent CI_dolna CI_gorna
nauka i egzaminy 82    39.4     33.0     46.2
finanse          38    18.3     13.6     24.1
relacje          37    17.8     13.2     23.6
praca zarobkowa  21    10.1      6.7     14.9
zdrowie          20     9.6      6.3     14.4
inne             10     4.8      2.6      8.6
2. Czy wartość p zgadza się ze statystyką testu?
R
# Kontrola spójności: czy wartość p zgadza się ze statystyką testu i stopniami swobody?
# (ten sam pomysł wykorzystuje pakiet statcheck, który sprawdza wyniki zapisane w stylu APA)
# Statystyka w tekście jest zaokrąglona, więc liczymy zakres p dla wartości, które dają to samo zaokrąglenie.
sprawdz_t <- function(opis, t, df, p_podane, dokl = 0.005) {
  p_min <- 2 * pt(-(abs(t) + dokl), df)
  p_max <- 2 * pt(-(abs(t) - dokl), df)
  data.frame(wynik = opis, p_podane = p_podane, p_od = round(p_min, 3), p_do = round(p_max, 3),
             zgodne = p_podane >= round(p_min, 3) & p_podane <= round(p_max, 3))
}
sprawdz_r <- function(opis, r, n, p_podane, dokl = 0.005) {      # korelacja Pearsona: t = r√(n − 2) / √(1 − r²)
  t_z_r <- function(r) r * sqrt((n - 2) / (1 - r^2))
  p_min <- 2 * pt(-t_z_r(abs(r) + dokl), n - 2)
  p_max <- 2 * pt(-t_z_r(abs(r) - dokl), n - 2)
  data.frame(wynik = opis, p_podane = p_podane, p_od = round(p_min, 3), p_do = round(p_max, 3),
             zgodne = p_podane >= round(p_min, 3) & p_podane <= round(p_max, 3))
}
rbind(
  sprawdz_t("t(206) = 0.58",             0.58, 206,    .561),   # wynik z rozdziału – zgodny
  sprawdz_t("t(206) = 0.58 (literówka)", 0.58, 206,    .056),   # p przepisane z błędem
  sprawdz_t("t(153.80) = 0.57",          0.57, 153.80, .568),   # test Welcha
  sprawdz_r("r(206) = −.21",            -0.21, 208,    .002),   # korelacja: df = N − 2
  sprawdz_r("r(239) = −.21 (złe N)",    -0.21, 241,    .002)    # te same liczby, ale N = 241 zamiast 208
)
Wynik w R
                      wynik p_podane  p_od  p_do zgodne
1             t(206) = 0.58    0.561 0.559 0.566   TRUE
2 t(206) = 0.58 (literówka)    0.056 0.559 0.566  FALSE
3          t(153.80) = 0.57    0.568 0.566 0.573   TRUE
4             r(206) = −.21    0.002 0.002 0.003   TRUE
5     r(239) = −.21 (złe N)    0.002 0.001 0.001  FALSE
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork, a wzór tabeli poprawek – w pakietach officer i flextable. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- lmtest (wersja 0.9-40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.3) [Computer software]. https://doi.org/10.32614/CRAN.package.rstatix
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents (R package version 0.7.4) [Computer software]. https://doi.org/10.32614/CRAN.package.officer
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting (R package version 0.9.11) [Computer software]. https://doi.org/10.32614/CRAN.package.flextable
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy wprowadzaniu poprawek
- Poprawianie tylko zaznaczonego miejsca. Ta sama usterka zwykle powtarza się w całym rozdziale i w tabelach.
- Ręczna zmiana liczb zamiast ponownego uruchomienia analizy. Po zmianie próby trzeba przeliczyć wszystkie wyniki, a nie tylko N.
- Zmiana analizy bez informacji w metodzie, w tabeli poprawek i w wiadomości do promotora.
- Usunięcie komentarzy promotora albo nadpisanie pliku, na którym je zapisano.
- Nowe błędy przy przepisywaniu – literówki w wartościach p i stopniach swobody, które wychwyci kontrola spójności.
- Usuwanie niewygodnych wyników zamiast ich poprawnego opisu. Uwaga „brak H3” oznacza dopisanie wyniku, a nie usunięcie hipotezy.
- Przenoszenie interpretacji do dyskusji bez jej przepisania – dyskusja ma wyjaśniać wyniki, a nie powtarzać ich opis.
Lista kontrolna przed odesłaniem rozdziału
- Opis przepływu uczestników prowadzi do jednej liczby N, takiej samej w tekście, tabelach i stopniach swobody.
- Każdy odsetek ma licznik i mianownik.
- Każdy test ma statystykę, stopnie swobody, dokładne p (lub p < .001) i wielkość efektu z 95% CI.
- W całej pracy obowiązuje jedna konwencja dziesiętna i jeden sposób zapisu zer przed przecinkiem.
- Tabele mają numer, tytuł, notę i tylko linie poziome; tekst nie powtarza ich zawartości.
- W rozdziale nie ma zrzutów ekranu ani etykiet programu („Sig.”).
- Nie ma wykresów kołowych 3D; odsetki pokazano na słupkach z liczebnościami.
- Kolejność i brzmienie hipotez są takie jak w rozdziale metodologicznym, a każda analiza odpowiada na swoją hipotezę.
- Opisano sprawdzenie założeń właściwe dla każdej analizy.
- Każda hipoteza – także niepotwierdzona – ma swój wynik.
- Wyniki nie zawierają interpretacji teoretycznej ani zaleceń, a język odpowiada schematowi badania.
- Wartości p sprawdzono pod kątem zgodności ze statystykami testów.
- Tabela poprawek i wiadomość do promotora są gotowe, a plik ma nowy numer wersji.
Najczęstsze pytania
Jak poprawić rozdział wyników po uwagach promotora?
Przeczytaj wszystkie uwagi, zanim cokolwiek zmienisz, i podziel je na dotyczące analiz, zapisu i interpretacji. Najpierw popraw analizy, bo od nich zależą tabele i liczby w tekście, a potem przelicz wyniki ze składni lub skryptu zamiast poprawiać liczby ręcznie. Każdą zmianę zapisz w tabeli poprawek i na końcu sprawdź spójność N, stopni swobody i wartości p.
Jak napisać maila do promotora z poprawkami?
Dołącz nową wersję pliku z zaznaczonymi zmianami i tabelę poprawek, a w treści wymień kilka najważniejszych zmian, np. ujednolicenie liczebności próby albo dodanie wielkości efektu. Napisz też, których uwag nie wprowadziłeś, z krótkim uzasadnieniem i pytaniem, czy takie rozwiązanie jest do przyjęcia. Wiadomość ma być krótka – szczegóły są w tabeli.
Co zrobić, gdy nie zgadzam się z uwagą promotora?
Nie ignoruj jej i nie spieraj się w komentarzach. Zaproponuj rozwiązanie z uzasadnieniem i źródłem, np. test Welcha jako analizę główną i test Studenta w przypisie albo analizę wrażliwości zamiast mocy post hoc. Ostateczna decyzja w pracy dyplomowej należy do promotora, a Ty powinieneś umieć ją uzasadnić na obronie.
Czy w pracy magisterskiej pisać przecinek czy kropkę dziesiętną?
To zależy od wytycznych wydziału: w polskich tekstach zwyczajowo stosuje się przecinek, a styl APA – kropkę. Obie konwencje są do przyjęcia, jeśli stosujesz jedną w całej pracy: w tekście, tabelach i na rysunkach. Przy przecinku oddzielaj liczby średnikiem, np. 95% CI [3,07; 3,28], i sprawdź, czy wydział oczekuje zera przed przecinkiem w wartościach p i r.
Czy można wkleić do pracy tabelę skopiowaną z SPSS?
Lepiej nie. Wydruk zawiera etykiety programu, zbędne kolumny i często oba warianty testu naraz, a zrzut ekranu jest nieczytelny i nie spełnia zasad APA. Przepisz potrzebne liczby do tabeli z numerem, tytułem i notą, a w tekście podaj wynik w zapisie APA z wielkością efektu.
Czy wykres kołowy nadaje się do pracy magisterskiej?
Odsetki czytelniej pokazuje wykres słupkowy lub punktowy, posortowany od największej kategorii, z liczebnościami i przedziałami ufności. Wykresów kołowych 3D unikaj zawsze: w eksperymencie Siegrista (1996) osoby badane trafniej odczytywały proporcje z płaskich wykresów kołowych niż z trójwymiarowych, a perspektywa powiększa wycinki z przodu.
Powiązane hasła
Przeczytaj też
Jak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWyniki badań własnych – przykładowy rozdział
Cały rozdział wyników jednego badania – od przygotowania danych po tabelę hipotez – z komentarzem, tabelami APA, rysunkami i wzorem w Wordzie.
Czytaj →PoradnikJak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →Uwagi promotora dotyczą analiz statystycznych?
Sprawdzimy analizy, przeliczymy to, czego dotyczą uwagi, i wyjaśnimy każdą zmianę tak, żebyś rozumiał(a) wszystkie liczby w rozdziale i umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- American Psychological Association. (b.d.). APA Style Journal Article Reporting Standards (APA Style JARS). APA Style. Pobrano 15 października 2026 z https://apastyle.apa.org/jars ● Otwarty dostęp
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Ernst, A. F., & Albers, C. J. (2017). Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions. PeerJ, 5, Article e3323. https://doi.org/10.7717/peerj.3323 ● Otwarty dostęp
- Haber, N., Smith, E. R., Moscoe, E., Andrews, K., Audy, R., Bell, W., Brennan, A. T., Breskin, A., Kane, J. C., Karra, M., McClure, E. S., Suarez, E. A., & CLAIMS Research Team. (2018). Causal language and strength of inference in academic and media articles shared in social media (CLAIMS): A systematic review. PLOS ONE, 13(5), Article e0196346. https://doi.org/10.1371/journal.pone.0196346 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Nicol, A. A. M., & Pexman, P. M. (2010). Presenting your findings: A practical guide for creating tables (6th ed.). American Psychological Association.
- Nuijten, M. B., Hartgerink, C. H. J., van Assen, M. A. L. M., Epskamp, S., & Wicherts, J. M. (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods, 48(4), 1205–1226. https://doi.org/10.3758/s13428-015-0664-2 ● Otwarty dostęp
- Siegrist, M. (1996). The use or misuse of three-dimensional graphs to represent lower-dimensional data. Behaviour & Information Technology, 15(2), 96–100. https://doi.org/10.1080/014492996120300
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@misc{apandjars, author={{American Psychological Association}}, title={{APA Style Journal Article Reporting Standards (APA Style JARS)}}, howpublished={APA Style}, publisher={American Psychological Association}, url={https://apastyle.apa.org/jars}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{ernst2017regression, author={Ernst, Anja F. and Albers, Casper J.}, title={{Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions}}, journal={PeerJ}, year={2017}, volume={5}, eid={e3323}, doi={10.7717/peerj.3323}}@article{haber2018causal, author={Haber, Noah and Smith, Emily R. and Moscoe, Ellen and Andrews, Kathryn and Audy, Robin and Bell, Winnie and Brennan, Alana T. and Breskin, Alexander and Kane, Jeremy C. and Karra, Mahesh and McClure, Elizabeth S. and Suarez, Elizabeth A. and {CLAIMS Research Team}}, title={{Causal language and strength of inference in academic and media articles shared in social media (CLAIMS): A systematic review}}, journal={PLOS ONE}, year={2018}, volume={13}, number={5}, eid={e0196346}, doi={10.1371/journal.pone.0196346}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@book{nicol2010presenting, author={Nicol, Adelheid A. M. and Pexman, Penny M.}, title={{Presenting your findings: A practical guide for creating tables}}, year={2010}, edition={6th ed.}, publisher={American Psychological Association}}@article{nuijten2016prevalence, author={Nuijten, Michèle B. and Hartgerink, Chris H. J. and van Assen, Marcel A. L. M. and Epskamp, Sacha and Wicherts, Jelte M.}, title={{The prevalence of statistical reporting errors in psychology (1985–2013)}}, journal={Behavior Research Methods}, year={2016}, volume={48}, number={4}, pages={1205--1226}, doi={10.3758/s13428-015-0664-2}}@article{siegrist1996use, author={Siegrist, Michael}, title={{The use or misuse of three-dimensional graphs to represent lower-dimensional data}}, journal={Behaviour \& Information Technology}, year={1996}, volume={15}, number={2}, pages={96--100}, doi={10.1080/014492996120300}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}