Pobierz komplet 16 wzorów tabel (.docx)
APA jako wspólny język psychologów
Psychologia jest nauką kumulatywną: pojedyncze badanie nabiera znaczenia dopiero wtedy, gdy inni mogą je zrozumieć, sprawdzić, porównać z własnymi wynikami i włączyć do metaanalizy. Dlatego psychologowie od dziesięcioleci korzystają ze wspólnego standardu zapisu — stylu Amerykańskiego Towarzystwa Psychologicznego (APA). Obecnie obowiązuje 7. wydanie podręcznika publikacyjnego (American Psychological Association, 2020), a jego zasady stosują czasopisma psychologiczne na całym świecie i większość polskich wydziałów psychologii.
Wspólny standard działa jak wspólny język. Zapis „t(251.9) = 5.50, p < .001, d = 0.65” zrozumie badaczka w Warszawie i recenzent w Melbourne — bez dodatkowych objaśnień, co oznacza każdy symbol. Tabela przygotowana według tych samych reguł pozwala czytelnikowi od razu znaleźć liczebność próby, średnie, wielkość efektu i niepewność oszacowania. Dla autora pracy dyplomowej to także praktyczna korzyść: promotor i recenzent oceniają rozdział „Wyniki” szybciej i życzliwiej, gdy wygląda on tak, jak w artykułach, które sami czytają.
Styl APA nie jest zbiorem arbitralnych reguł estetycznych. Każdy element — kursywa przy symbolach statystycznych, brak linii pionowych, nota pod tabelą — służy temu, żeby wynik dało się odczytać jednoznacznie. Zasady opisuje też hasło styl APA, a wymagania dotyczące sekcji „Metoda” i „Wyniki” — poradnik wytyczne APA w metodologii i statystyce.
Jak psychologia komunikuje wyniki badań
Sposób raportowania wyników w psychologii zmienił się w ostatnich dekadach. Już raport grupy zadaniowej APA (Wilkinson i Task Force on Statistical Inference, 1999) zalecał podawanie wielkości efektu i przedziałów ufności zamiast samego „p < .05”. Ten kierunek wzmocniła tzw. nowa statystyka (Cumming, 2014) i kryzys replikacji. Obecne standardy raportowania badań ilościowych JARS (Appelbaum i in., 2018) wymagają m.in.:
- pełnych statystyk opisowych dla wszystkich analizowanych zmiennych;
- dokładnych wartości p (a nie tylko „ns” czy gwiazdek), wielkości efektu i przedziałów ufności;
- informacji o brakach danych, wykluczeniach i rzetelności narzędzi w badanej próbie;
- wyników wszystkich zaplanowanych analiz — również nieistotnych.
Tabele są najwygodniejszym miejscem na te informacje: zbierają w jednym miejscu dziesiątki liczb, które w tekście byłyby nieczytelne. Tekst pracy przywołuje tabelę i interpretuje najważniejsze wyniki, a tabela podaje pełne dane.
Tekst, tabela czy rysunek?
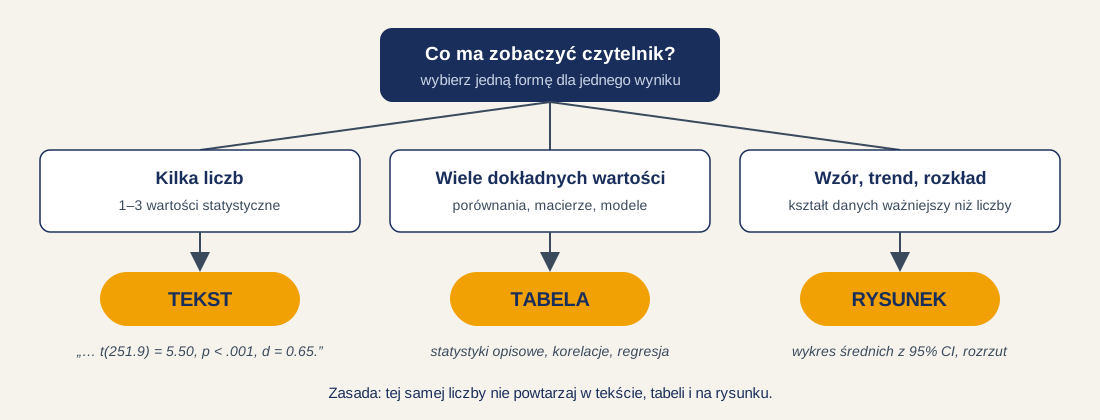
Zanim przygotujesz tabelę, zdecyduj, czy w ogóle jest potrzebna. Jeden lub dwa wyniki lepiej opisać w zdaniu. Tabela sprawdza się, gdy czytelnik ma odczytać wiele dokładnych wartości (np. statystyki kilku zmiennych lub współczynniki modelu). Rysunek wybierz, gdy ważniejszy od samych liczb jest wzór: trend, interakcja albo kształt rozkładu.
Anatomia tabeli APA
Każda tabela w stylu APA 7 składa się z tych samych elementów (American Psychological Association, b.d.):
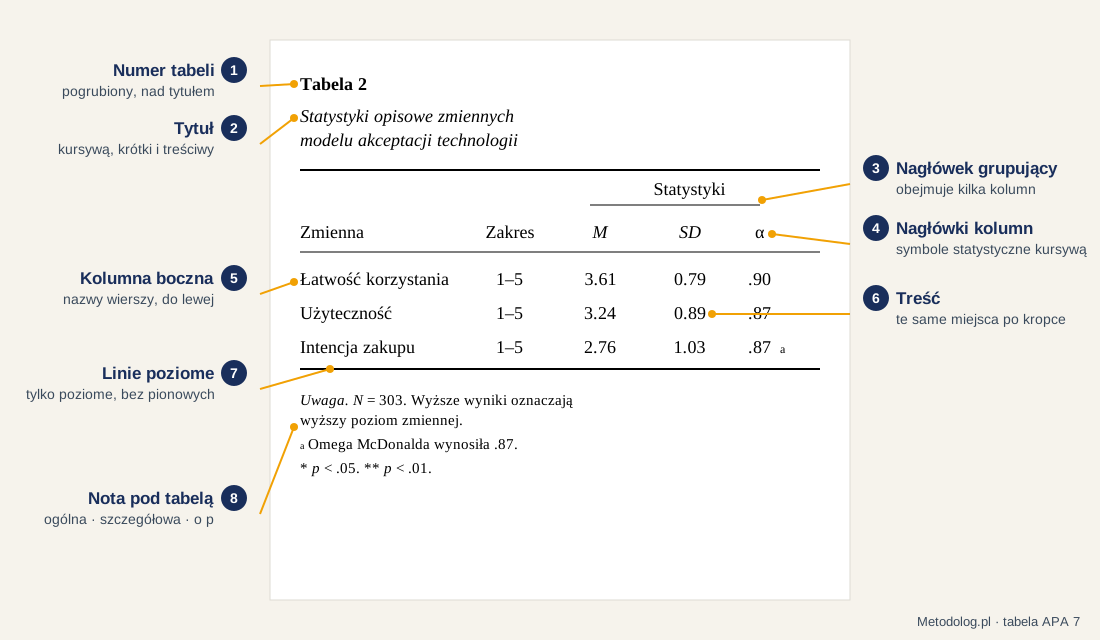
- Numer tabeli — pogrubiony, nad tabelą: Tabela 1. Tabele numeruje się w kolejności przywoływania w tekście.
- Tytuł — w nowej linii, kursywą; krótki, ale mówiący, czego dotyczy tabela („Porównanie kobiet i mężczyzn…”, a nie „Wyniki testu t”).
- Nagłówek grupujący — obejmuje kilka kolumn (np. „Kobiety” nad kolumnami M i SD); pod nim krótka linia.
- Nagłówki kolumn — zwięzłe; symbole statystyczne kursywą (M, SD, t, p), litery greckie bez kursywy (α, β, η²).
- Kolumna boczna — nazwy wierszy wyrównane do lewej; podkategorie wcięte.
- Treść — liczby wyrównane, ta sama liczba miejsc po kropce w kolumnie; puste komórki zostawia się puste, kreska oznacza „nie dotyczy”.
- Linie — tylko poziome: nad nagłówkiem, pod nagłówkiem i pod ostatnim wierszem. Bez linii pionowych, bez cieniowania.
- Nota — pod tabelą, w trzech możliwych rodzajach i tej kolejności: ogólna (Uwaga. N = …, objaśnienia skrótów), szczegółowa (indeksy literowe przy konkretnych komórkach) i o prawdopodobieństwie (*p < .05).
APA w polskiej pracy: decyzje przed startem
- Kropka czy przecinek dziesiętny? W tym poradniku stosujemy oryginalną konwencję APA: kropkę dziesiętną. Wiele polskich wydziałów wymaga jednak przecinka (0,45). Obie wersje są poprawne, jeśli stosujesz je konsekwentnie — sprawdź wytyczne swojej uczelni.
- Zero przed kropką. W APA pomija się je przy wartościach, które nie mogą przekroczyć 1: p = .023, r = .45, α = .87, R² = .59, CFI = .962. Zero zostaje przy wartościach, które mogą przekroczyć 1: M = 2.76, d = 0.65, β = 0.50, t = 5.50.
- Wartości p. Podawaj dokładnie (.023), a bardzo małe jako p < .001 — nigdy „p = .000”.
- Nazewnictwo. W polskiej pracy piszemy „Tabela 1”, „Rysunek 1” i „Uwaga.”, ale zostawiamy międzynarodowe symbole statystyczne (M, SD, df, CI).
- Najpierw wytyczne promotora. Jeśli wydział ma własny wzór (np. numerację w rozdziałach, tytuł pod tabelą), ma on pierwszeństwo przed APA.
Przykładowe badanie i kolejność tabel
Wszystkie tabele przygotowano na jednym zbiorze danych z badania ankietowego akceptacji samochodów autonomicznych (N = 303), opartego na modelu akceptacji technologii (TAM). Badani ocenili łatwość korzystania, użyteczność i intencję zakupu (po cztery pozycje, skala 1–5) oraz obawy i cele (wyniki ogólne). Dzięki temu liczby w tabelach są ze sobą spójne — tak jak w prawdziwym rozdziale „Wyniki”. Kolejność tabel odpowiada typowej kolejności tego rozdziału: opis próby, statystyki opisowe i rzetelność, związki między zmiennymi, porównania grup, modele regresji, a na końcu analizy struktury narzędzia. Wszystkie wartości policzono w R; kod znajdziesz w hasłach słownika podlinkowanych pod tabelami.
Pod każdą tabelą jest przycisk „Kopiuj tabelę do Worda” (kopiuje tabelę ze sformatowaniem APA) i link do wzoru .docx.
16 wzorów tabel APA z przykładami
Tabela 1. Charakterystyka próby
Kiedy: Otwiera opis osób badanych: liczebności i odsetki w kategoriach oraz średni wiek.
Tabela 1
Charakterystyka socjodemograficzna osób badanych
| Zmienna | n | % |
|---|---|---|
| Płeć | ||
| Kobiety | 173 | 57.1 |
| Mężczyźni | 130 | 42.9 |
| Wiek (lata) | ||
| 20–24 | 109 | 36.0 |
| 25–29 | 116 | 38.3 |
| 30+ | 78 | 25.7 |
| Wykształcenie | ||
| Podstawowe | 2 | 0.7 |
| Średnie | 130 | 42.9 |
| Wyższe | 171 | 56.4 |
Uwaga. N = 303. Wiek: M = 27.52, SD = 5.87, zakres 20–51 lat.
W tekście: W badaniu wzięły udział 303 osoby, w tym 173 kobiet (57.1%), w wieku od 20 do 51 lat (M = 27.52, SD = 5.87; Tabela 1).
Jak dobrać cechy do opisu i jak napisać akapit o próbie: wzór przedstawienia charakterystyki próby.
Tabela 2. Statystyki opisowe zmiennych
Kiedy: Najważniejsza tabela przed testowaniem hipotez: średnie, odchylenia, rozkład i rzetelność.
Tabela 2
Statystyki opisowe zmiennych modelu akceptacji technologii
| Zmienna | Możliwy zakres | Min–Maks | M | SD | Mdn | Skośność | Kurtoza | α |
|---|---|---|---|---|---|---|---|---|
| Łatwość korzystania | 1–5 | 1.00–5.00 | 3.61 | 0.79 | 3.75 | −0.52 | 0.51 | .90 |
| Użyteczność | 1–5 | 1.00–5.00 | 3.24 | 0.89 | 3.25 | −0.32 | −0.05 | .87 |
| Intencja zakupu | 1–5 | 1.00–5.00 | 2.76 | 1.03 | 2.75 | 0.03 | −0.68 | .87 |
| Obawy | 1–4 | 1.00–4.00 | 2.79 | 0.71 | 2.80 | −0.31 | −0.57 | — |
| Cele | 1–4 | 1.00–4.00 | 2.15 | 0.74 | 2.00 | 0.45 | −0.21 | — |
| Wiek (lata) | — | 20–51 | 27.52 | 5.87 | 26.00 | 1.47 | 1.86 | — |
Uwaga. N = 303. Wyniki skal to średnie z odpowiedzi na pozycje; wyższe wartości oznaczają wyższy poziom zmiennej. Skośność i kurtozę (kurtoza nadwyżkowa) obliczono tak jak w SPSS; SE skośności = 0.14, SE kurtozy = 0.28. α = alfa Cronbacha; dla obaw i celów dostępne były wyłącznie wyniki ogólne, dlatego nie podano rzetelności.
W tekście: Badani wysoko oceniali łatwość korzystania (M = 3.61, SD = 0.79), a intencja zakupu była umiarkowana (M = 2.76, SD = 1.03; Tabela 2).
Szczegóły, warianty, kod R i wzór do pobrania: tabela statystyk opisowych w APA.
Tabela 3. Rzetelność skal
Kiedy: Do rozdziału „Narzędzia badawcze”: alfa z przedziałem ufności i omega McDonalda.
Tabela 3
Rzetelność skal kwestionariusza
| Skala | Liczba pozycji | α | 95% CI dla α | ω | rśr | rit |
|---|---|---|---|---|---|---|
| Łatwość korzystania | 4 | .90 | [.86, .92] | .90 | .68 | .68–.82 |
| Użyteczność | 4 | .87 | [.84, .90] | .87 | .63 | .71–.75 |
| Intencja zakupu | 4 | .87 | [.84, .89] | .87 | .62 | .62–.77 |
Uwaga. N = 303. α = alfa Cronbacha (przedział ufności metodą bootstrap, 2000 prób); ω = omega McDonalda z jednoczynnikowej konfirmacyjnej analizy czynnikowej; rśr = średnia korelacja między pozycjami; rit = zakres skorygowanych korelacji pozycja–skala.
W tekście: Wszystkie skale miały wysoką rzetelność, od α = .87 (intencja zakupu) do α = .90 (łatwość korzystania; Tabela 3).
Szczegóły, warianty, kod R i wzór do pobrania: tabela rzetelności w APA.
Tabela 4. Średnie, odchylenia standardowe i korelacje
Kiedy: Najczęstsza tabela w pracach korelacyjnych: macierz r w dolnym trójkącie z M i SD.
Tabela 4
Średnie, odchylenia standardowe i korelacje Pearsona między zmiennymi
| Zmienna | M | SD | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|---|
| 1. Łatwość korzystania | 3.61 | 0.79 | (.90) | |||||
| 2. Użyteczność | 3.24 | 0.89 | .48*** | (.87) | ||||
| 3. Intencja zakupu | 2.76 | 1.03 | .35*** | .72*** | (.87) | |||
| 4. Obawy | 2.79 | 0.71 | −.29*** | −.45*** | −.41*** | — | ||
| 5. Cele | 2.15 | 0.74 | .25*** | .60*** | .64*** | −.39*** | — | |
| 6. Wiek | 27.52 | 5.87 | −.05 | −.02 | .02 | .03 | −.05 | — |
Uwaga. N = 303. Na przekątnej w nawiasach podano alfę Cronbacha. Wiek wyrażono w latach.
*p < .05. **p < .01. ***p < .001.
W tekście: Intencja zakupu korelowała najsilniej z użytecznością, r = .72, p < .001, i ujemnie z obawami, r = −.41, p < .001 (Tabela 4).
Szczegóły, warianty, kod R i wzór do pobrania: tabela korelacji w APA (także wariant z przedziałami ufności).
Tabela 5. Porównanie dwóch grup (test t)
Kiedy: Kilka zmiennych zależnych w jednej tabeli; grupy jako nagłówki grupujące.
Tabela 5
Porównanie kobiet i mężczyzn w zakresie zmiennych modelu akceptacji technologii
| Zmienna | Kobiety (n = 173) | Mężczyźni (n = 130) | t | df | p | d Cohena | 95% CI dla d | ||
|---|---|---|---|---|---|---|---|---|---|
| M | SD | M | SD | ||||||
| Intencja zakupu | 2.73 | 0.95 | 2.81 | 1.13 | −0.63 | 250.0 | .527 | −0.08 | [−0.30, 0.15] |
| Użyteczność | 3.18 | 0.82 | 3.33 | 0.98 | −1.42 | 247.8 | .156 | −0.17 | [−0.40, 0.06] |
| Łatwość korzystania | 3.52 | 0.75 | 3.73 | 0.84 | −2.24 | 260.4 | .026 | −0.26 | [−0.49, −0.04] |
| Obawy | 2.98 | 0.63 | 2.53 | 0.74 | 5.50 | 251.9 | < .001 | 0.65 | [0.42, 0.89] |
Uwaga. N = 303. Zastosowano test t Welcha (bez założenia równości wariancji), stąd ułamkowe stopnie swobody. Dodatnie wartości t i d oznaczają wyższe wyniki kobiet; d obliczono z łączonego odchylenia standardowego.
W tekście: Kobiety zgłaszały więcej obaw niż mężczyźni, t(251.9) = 5.50, p < .001, d = 0.65, 95% CI [0.42, 0.89] (Tabela 5).
Szczegóły, warianty, kod R i wzór do pobrania: tabela testu t w APA.
Tabela 6. Dwa pomiary tych samych osób
Kiedy: Test t dla prób zależnych: różnica średnich z przedziałem ufności i dz.
Tabela 6
Porównanie ocen łatwości korzystania i użyteczności (pomiary zależne)
| Zmienna | M | SD | Różnica | t(302) | p | dz | |
|---|---|---|---|---|---|---|---|
| Mdiff | 95% CI | ||||||
| Łatwość korzystania | 3.61 | 0.79 | 0.37 | [0.27, 0.47] | 7.46 | < .001 | 0.43 |
| Użyteczność | 3.24 | 0.89 | |||||
Uwaga. N = 303. Obie skale mierzono na skali 1–5 u tych samych osób; korelacja między pomiarami r = .48. Mdiff = różnica średnich (łatwość − użyteczność); dz = średnia różnica podzielona przez odchylenie standardowe różnic, 95% CI [0.31, 0.55].
W tekście: Łatwość korzystania oceniano wyżej niż użyteczność, t(302) = 7.46, p < .001, dz = 0.43 (Tabela 6).
Tabela 7. ANOVA jednoczynnikowa (wyniki nieistotne)
Kiedy: Trzy lub więcej grup; pełne statystyki także wtedy, gdy różnic brak.
Tabela 7
Porównanie zmiennych modelu akceptacji technologii w grupach wieku
| Zmienna | 20–24 (n = 109) | 25–29 (n = 116) | 30+ (n = 78) | F(2, 300) | p | η2 | |||
|---|---|---|---|---|---|---|---|---|---|
| M | SD | M | SD | M | SD | ||||
| Intencja zakupu | 2.77 | 1.04 | 2.71 | 1.06 | 2.83 | 0.98 | 0.35 | .702 | .00 |
| Użyteczność | 3.27 | 0.85 | 3.25 | 0.90 | 3.20 | 0.94 | 0.15 | .863 | .00 |
| Łatwość korzystania | 3.66 | 0.74 | 3.59 | 0.82 | 3.58 | 0.83 | 0.29 | .749 | .00 |
| Obawy | 2.75 | 0.72 | 2.80 | 0.72 | 2.82 | 0.70 | 0.26 | .769 | .00 |
Uwaga. N = 303. Wiek w latach podzielono na trzy przedziały. η2 = eta kwadrat. Ponieważ żaden test F nie był istotny, nie przeprowadzano porównań post hoc.
W tekście: Grupy wieku nie różniły się intencją zakupu, F(2, 300) = 0.35, p = .702, η² = .002 (Tabela 7).
Szczegóły, warianty, kod R i wzór do pobrania: tabela ANOVA w APA.
Tabela 8. ANOVA z testami post hoc
Kiedy: Litery przy średnich pokazują, które grupy różnią się istotnie.
Tabela 8
Zmienne modelu akceptacji technologii w grupach o różnym poziomie postrzeganej użyteczności
| Zmienna | Niska (n = 133) | Średnia (n = 91) | Wysoka (n = 79) | F(2, 300) | p | η2 | |||
|---|---|---|---|---|---|---|---|---|---|
| M | SD | M | SD | M | SD | ||||
| Intencja zakupu | 2.12a | 0.84 | 2.91b | 0.74 | 3.68c | 0.86 | 93.60 | < .001 | .38 |
| Cele | 1.73a | 0.54 | 2.27b | 0.59 | 2.73c | 0.77 | 66.66 | < .001 | .31 |
| Łatwość korzystania | 3.28a | 0.81 | 3.75b | 0.56 | 4.02c | 0.76 | 27.53 | < .001 | .16 |
| Obawy | 3.13a | 0.60 | 2.67b | 0.59 | 2.34c | 0.73 | 40.34 | < .001 | .21 |
Uwaga. N = 303. Grupy utworzono przez podział wyników skali użyteczności na tercyle (niska: ≤ 3.00, średnia: 3.25–3.75, wysoka: ≥ 4.00); podział służy wyłącznie ilustracji formatu tabeli — przy zmiennej ilościowej lepszą analizą jest regresja.
Średnie w tym samym wierszu oznaczone różnymi literami w indeksie dolnym różnią się istotnie (p < .05, test HSD Tukeya). η2 = eta kwadrat (odsetek wariancji wyjaśnianej przez grupę).
W tekście: Intencja zakupu rosła wraz z poziomem użyteczności, F(2, 300) = 93.60, p < .001, η² = .38, a wszystkie grupy różniły się parami (Tabela 8).
Tabela 9. ANOVA dwuczynnikowa
Kiedy: Układ „źródło zmienności”: efekty główne, interakcja i cząstkowe η².
Tabela 9
Dwuczynnikowa analiza wariancji obaw: płeć i grupa wieku
| Źródło zmienności | df | F | p | η2p | 95% CI dla η2p |
|---|---|---|---|---|---|
| Płeć | 1 | 31.84 | < .001 | .097 | [.042, .165] |
| Grupa wieku | 2 | 0.52 | .598 | .003 | [.000, .023] |
| Płeć × grupa wieku | 2 | 0.14 | .872 | .001 | [.000, .012] |
| Błąd | 297 |
Uwaga. N = 303. Sumy kwadratów typu III. η2p = cząstkowe eta kwadrat. Kobiety (M = 2.98, SD = 0.63) zgłaszały więcej obaw niż mężczyźni (M = 2.53, SD = 0.74).
W tekście: Istotny był tylko efekt główny płci, F(1, 297) = 31.84, p < .001, η²p = .10 (Tabela 9).
Tabela 10. Tabela krzyżowa z testem chi-kwadrat
Kiedy: Dwie zmienne jakościowe: liczebności i procenty w wierszach, wynik testu w nocie.
Tabela 10
Odsetek osób z co najmniej umiarkowaną intencją zakupu wśród kobiet i mężczyzn
| Płeć | Intencja ≥ 3 | Intencja < 3 | ||
|---|---|---|---|---|
| n | % | n | % | |
| Kobiety | 82 | 47.4 | 91 | 52.6 |
| Mężczyźni | 66 | 50.8 | 64 | 49.2 |
Uwaga. N = 303. Procenty obliczono w wierszach. χ2(1, N = 303) = 0.34, p = .561, φ = −.03; OR = 0.87, 95% CI [0.55, 1.38].
W tekście: Odsetek osób z co najmniej umiarkowaną intencją zakupu nie różnił się między kobietami a mężczyznami, χ2(1, N = 303) = 0.34, p = .561 (Tabela 10).
Test chi-kwadrat krok po kroku i kalkulator: tabela krzyżowa.
Tabela 11. Regresja liniowa wieloraka
Kiedy: b, SE, przedział ufności, β, t i p dla każdego predyktora; R² i F w nocie.
Tabela 11
Wyniki regresji liniowej wielokrotnej dla intencji zakupu
| Predyktor | b | SE | 95% CI dla b | β | t | p | |
|---|---|---|---|---|---|---|---|
| LL | UL | ||||||
| Stała | 0.13 | 0.33 | −0.51 | 0.78 | 0.41 | .682 | |
| Łatwość korzystania | 0.02 | 0.06 | −0.09 | 0.13 | 0.02 | 0.36 | .723 |
| Użyteczność | 0.58 | 0.06 | 0.46 | 0.70 | 0.50 | 9.48 | < .001 |
| Obawy | −0.09 | 0.06 | −0.21 | 0.03 | −0.06 | −1.45 | .149 |
| Cele | 0.43 | 0.07 | 0.30 | 0.56 | 0.31 | 6.60 | < .001 |
Uwaga. N = 303. R2 = .59, skorygowane R2 = .58, F(4, 298) = 106.68, p < .001. b = współczynnik niestandaryzowany; β = współczynnik standaryzowany; LL i UL = dolna i górna granica przedziału ufności. Współczynniki VIF mieściły się w zakresie 1.30–2.01.
W tekście: Model wyjaśniał 59% wariancji intencji zakupu; najsilniejszym predyktorem była użyteczność, β = 0.50, p < .001 (Tabela 11).
Szczegóły, warianty, kod R i wzór do pobrania: tabela regresji w APA.
Tabela 12. Regresja hierarchiczna
Kiedy: Kroki modelu, R² i ΔR² z testem F zmiany.
Tabela 12
Hierarchiczna regresja liniowa: predyktory intencji zakupu
| Krok i predyktor | b | SE | β | p | R2 | ΔR2 |
|---|---|---|---|---|---|---|
| Krok 1 | .00 | .00 | ||||
| Płeć (mężczyzna) | 0.08 | 0.12 | 0.04 | .529 | ||
| Wiek | 0.00 | 0.01 | 0.02 | .700 | ||
| Krok 2 | .52 | .52*** | ||||
| Płeć (mężczyzna) | −0.05 | 0.08 | −0.03 | .516 | ||
| Wiek | 0.01 | 0.01 | 0.04 | .297 | ||
| Łatwość korzystania | 0.02 | 0.06 | 0.01 | .780 | ||
| Użyteczność | 0.83 | 0.05 | 0.72 | < .001 | ||
| Krok 3 | .59 | .07*** | ||||
| Płeć (mężczyzna) | −0.06 | 0.08 | −0.03 | .504 | ||
| Wiek | 0.01 | 0.01 | 0.05 | .147 | ||
| Łatwość korzystania | 0.03 | 0.06 | 0.02 | .637 | ||
| Użyteczność | 0.57 | 0.06 | 0.50 | < .001 | ||
| Obawy | −0.10 | 0.06 | −0.07 | .110 | ||
| Cele | 0.43 | 0.07 | 0.31 | < .001 |
Uwaga. N = 303. Płeć zakodowano: 0 = kobieta, 1 = mężczyzna. Zmiana R2 w kroku 2: F(2, 298) = 161.71; w kroku 3: F(2, 296) = 25.71.
*p < .05. **p < .01. ***p < .001.
W tekście: Zmienne modelu TAM zwiększyły odsetek wyjaśnionej wariancji o 52 punktów procentowych ponad płeć i wiek (Tabela 12).
Tabela 13. Regresja logistyczna
Kiedy: Wynik dwuwartościowy: B, Wald, iloraz szans z przedziałem ufności.
Tabela 13
Regresja logistyczna: predyktory co najmniej umiarkowanej intencji zakupu
| Predyktor | B | SE | Wald | p | OR | 95% CI dla OR | |
|---|---|---|---|---|---|---|---|
| LL | UL | ||||||
| Stała | −6.59 | 1.49 | 19.44 | < .001 | 0.001 | ||
| Łatwość korzystania | −0.12 | 0.24 | 0.26 | .608 | 0.89 | 0.56 | 1.41 |
| Użyteczność | 1.68 | 0.28 | 35.24 | < .001 | 5.37 | 3.08 | 9.36 |
| Obawy | −0.20 | 0.25 | 0.63 | .426 | 0.82 | 0.51 | 1.33 |
| Cele | 0.94 | 0.27 | 11.98 | < .001 | 2.55 | 1.50 | 4.34 |
Uwaga. N = 303. Zmienna zależna: intencja zakupu ≥ 3 (1; n = 148) wobec < 3 (0; n = 155). Model: χ2(4) = 141.22, p < .001; R2 Nagelkerkego = .50; poprawnie sklasyfikowano 75.9% osób (próg .50). OR = iloraz szans; Wald = statystyka Walda z 1 stopniem swobody.
W tekście: Wyższa użyteczność zwiększała szanse co najmniej umiarkowanej intencji zakupu, OR = 5.37, 95% CI [3.08, 9.36] (Tabela 13).
Szczegóły, warianty, kod R i wzór do pobrania: tabela regresji logistycznej w APA.
Tabela 14. Mediacja
Kiedy: Ścieżki a, b, c′, efekt całkowity i pośredni z bootstrapowym przedziałem ufności.
Tabela 14
Mediacyjna rola użyteczności w związku łatwości korzystania z intencją zakupu
| Efekt | b | SE | 95% CI | β | p | |
|---|---|---|---|---|---|---|
| LL | UL | |||||
| a: łatwość korzystania → użyteczność | 0.54 | 0.06 | 0.42 | 0.65 | 0.48 | < .001 |
| b: użyteczność → intencja zakupu | 0.83 | 0.05 | 0.73 | 0.93 | 0.72 | < .001 |
| c′: efekt bezpośredni (łatwość → intencja) | 0.01 | 0.06 | −0.11 | 0.13 | 0.01 | .872 |
| c: efekt całkowity | 0.46 | 0.07 | 0.31 | 0.60 | 0.35 | < .001 |
| ab: efekt pośredni | 0.45 | 0.05 | 0.34 | 0.55 | 0.35 | — |
Uwaga. N = 303. Przedziały ufności wyznaczono metodą bootstrap percentylową (5000 prób); dla efektu pośredniego o istotności świadczy przedział ufności niezawierający zera. β = efekt standaryzowany. Model wyjaśniał 23.2% wariancji użyteczności i 51.9% wariancji intencji zakupu.
W tekście: Efekt pośredni łatwości korzystania przez użyteczność był istotny, ab = 0.45, 95% CI [0.34, 0.55] (Tabela 14).
Szczegóły, warianty, kod R i wzór do pobrania: tabela mediacji w APA.
Tabela 15. Eksploracyjna analiza czynnikowa
Kiedy: Ładunki po rotacji, komunalności, % wariancji; korelacje czynników w nocie.
Tabela 15
Ładunki czynnikowe pozycji kwestionariusza w eksploracyjnej analizie czynnikowej
| Pozycja | Czynnik 1: łatwość | Czynnik 2: użyteczność | Czynnik 3: intencja | h2 |
|---|---|---|---|---|
| ŁK1 | .83 | −.02 | .01 | .68 |
| ŁK2 | .89 | .00 | .00 | .80 |
| ŁK3 | .68 | .02 | .07 | .52 |
| ŁK4 | .88 | .01 | −.03 | .77 |
| UŻ1 | .03 | .83 | .04 | .75 |
| UŻ2 | .04 | .90 | −.08 | .75 |
| UŻ3 | −.06 | .52 | .32 | .55 |
| UŻ4 | .10 | .46 | .29 | .56 |
| IZ1 | .03 | .40 | .37 | .51 |
| IZ2 | .02 | −.07 | .89 | .72 |
| IZ3 | .03 | .01 | .82 | .70 |
| IZ4 | −.02 | .16 | .70 | .65 |
| Suma kwadratów ładunków | 2.83 | 2.52 | 2.61 | |
| % wyjaśnianej wariancji | 23.5 | 21.0 | 21.8 |
Uwaga. N = 303. Metoda największej wiarygodności, rotacja oblimin. Pogrubiono ładunki ≥ .30. h2 = komunalność. ŁK = łatwość korzystania, UŻ = użyteczność, IZ = intencja zakupu. KMO = .90; test Bartletta χ2(66) = 2327.33, p < .001. Korelacje czynników: 1–2 r = .52, 1–3 r = .32, 2–3 r = .68.
W tekście: Trzy czynniki wyjaśniały łącznie 66.3% wariancji pozycji (Tabela 15).
Szczegóły, warianty, kod R i wzór do pobrania: tabela analizy czynnikowej w APA.
Tabela 16. Dopasowanie modeli CFA
Kiedy: Porównanie modeli konkurencyjnych: χ², CFI, TLI, RMSEA, SRMR i test różnicy χ².
Tabela 16
Wskaźniki dopasowania konkurencyjnych modeli konfirmacyjnej analizy czynnikowej
| Model | χ2 | df | p | CFI | TLI | RMSEA | 90% CI RMSEA | SRMR | AIC | Δχ2 (Δdf) |
|---|---|---|---|---|---|---|---|---|---|---|
| Jednoczynnikowy | 615.58 | 54 | < .001 | .671 | .598 | .214 | [.199, .230] | .139 | 9172.2 | 213.93 (3)*** |
| Dwuczynnikowy | 215.52 | 53 | < .001 | .911 | .889 | .112 | [.097, .128] | .063 | 8620.0 | 69.10 (2)*** |
| Trzyczynnikowy | 121.83 | 51 | < .001 | .962 | .951 | .075 | [.058, .092] | .048 | 8504.5 | — |
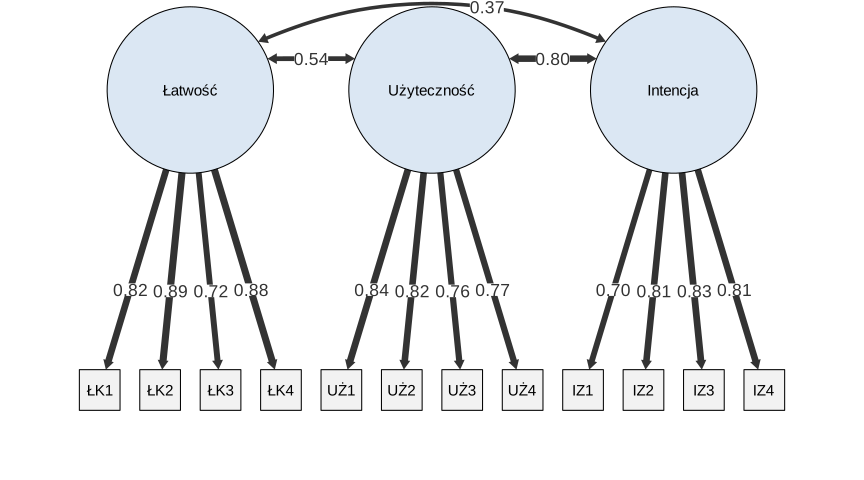
Uwaga. N = 303. Estymator MLR; podano skalowane χ2 oraz odporne CFI, TLI i RMSEA. Model dwuczynnikowy łączy użyteczność i intencję zakupu w jeden czynnik. Δχ2 = skalowany test różnicy względem modelu trzyczynnikowego. W modelu trzyczynnikowym standaryzowane ładunki wynosiły od .70 do .89.
***p < .001.
W tekście: Model trzyczynnikowy był dopasowany najlepiej, CFI = .962, RMSEA = .075, SRMR = .048 (Tabela 16).
Szczegóły, warianty, kod R i wzór do pobrania: tabela dopasowania modelu w APA.
Rysunki w stylu APA
Rysunek w APA ma taką samą „ramę” jak tabela: numer pogrubiony (Rysunek 1), tytuł kursywą nad rysunkiem i notę pod nim. Sam wykres powinien być czytelny w druku czarno-białym, mieć opisane osie z jednostkami i nie zawierać zbędnych ozdobników (cieni, efektów 3D, tła). Zamiast słupków ze średnimi na skali, która nie zaczyna się od zera, lepiej pokazać średnie z przedziałami ufności i rozkład danych (Weissgerber i in., 2015).
Rysunek 1
Intencja zakupu w grupach o różnym poziomie postrzeganej użyteczności
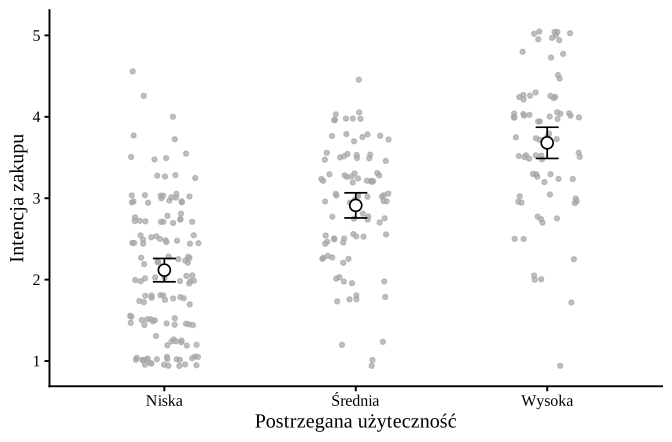
Uwaga. N = 303. Białe punkty to średnie, odcinki — 95% przedziały ufności, szare punkty — wyniki poszczególnych osób.
Poza APA: złożone rysunki z innych dziedzin nauki
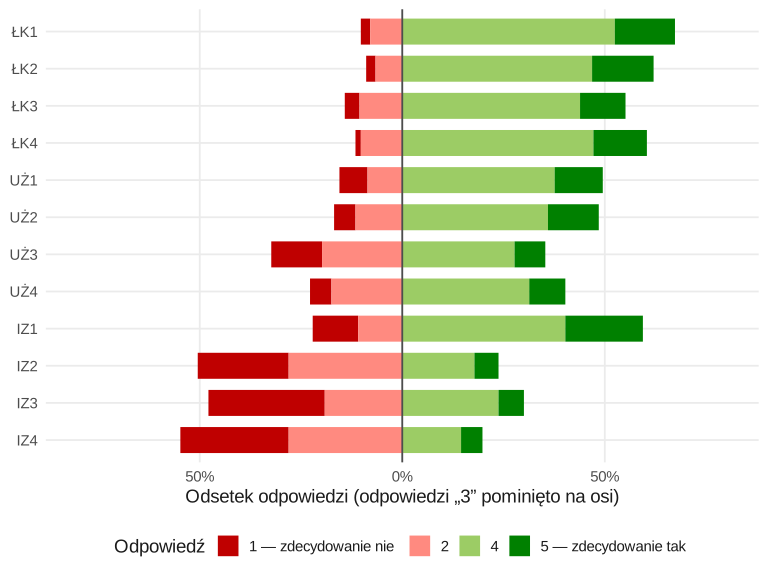
APA to standard psychologii i nauk społecznych, ale w innych dziedzinach wyniki pokazuje się inaczej — często za pomocą bogatszych rysunków. W biologii i medycynie standardem stają się wykresy pokazujące wszystkie obserwacje, w epidemiologii — wykresy lasu, w psychometrii sieciowej — grafy korelacji, a w modelowaniu strukturalnym — diagramy ścieżek. Poniższe rysunki wygenerowano na tych samych danych pakietami i paletami kolorów używanymi w procedurach aplikacji analitycznej SZTOS (qgraph, semPlot, ggdist, ggplot2). W pracy z psychologii możesz je umieścić obok tabeli lub w aneksie — zawsze z numerem, tytułem i notą.
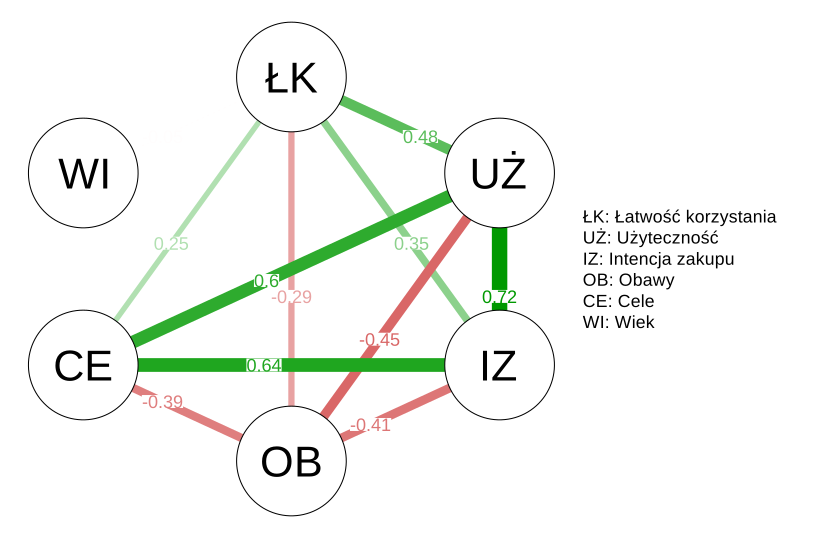
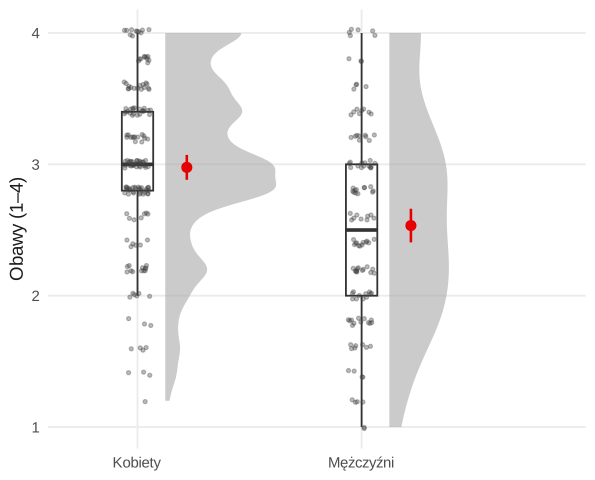
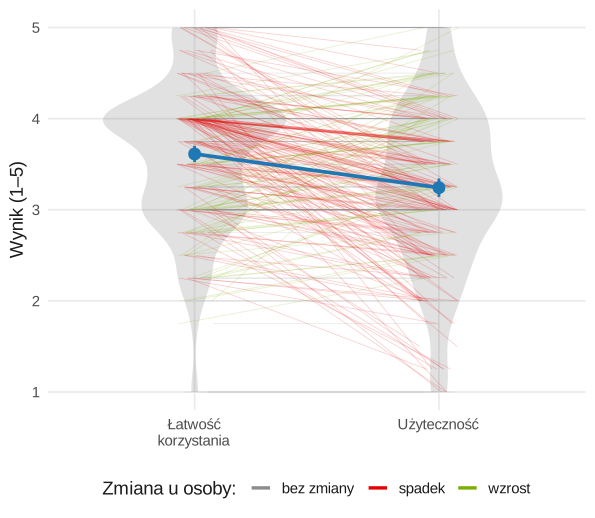
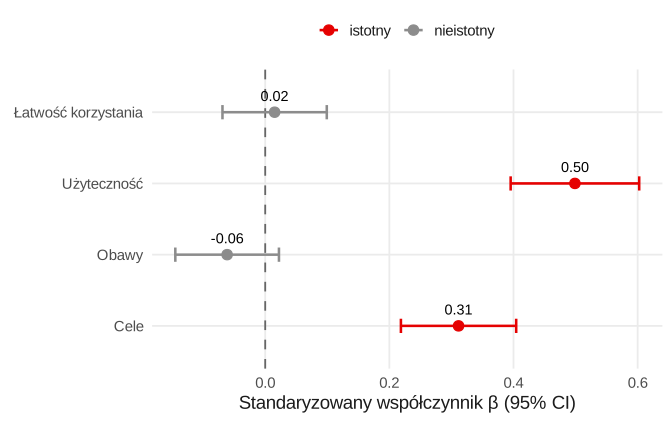
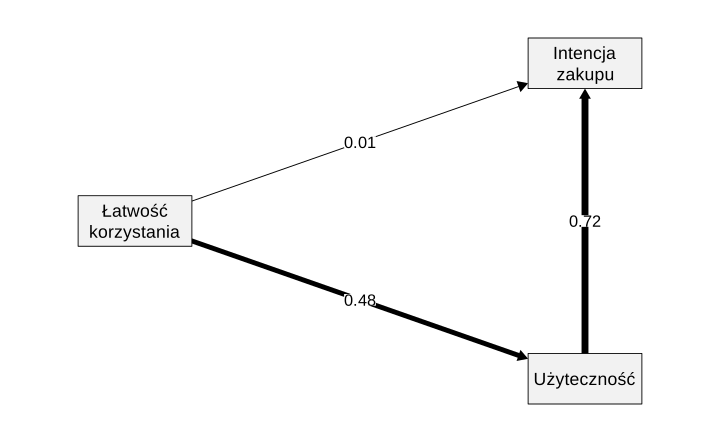
Więcej o każdym z tych rysunków — wraz z tabelą, której mogą towarzyszyć — znajdziesz w hasłach słownika: korelacje, test t, regresja, mediacja, CFA i rzetelność.
Najczęstsze błędy w tabelach
- Zrzut ekranu z SPSS lub JASP zamiast tabeli w formacie APA.
- Linie pionowe, siatka i kolorowe tło.
- „p = .000” — zapisuj p < .001.
- Różna liczba miejsc po kropce w jednej kolumnie.
- Brak liczebności próby (N w nocie lub n w nagłówkach).
- Skróty niewyjaśnione w nocie (ŁK, IZ, LL, UL…).
- Powtarzanie całej tabeli w tekście zamiast interpretacji najważniejszych wyników.
- Same gwiazdki bez wielkości efektu i przedziałów ufności.
- Tytuł opisujący analizę, a nie treść („Wyniki ANOVA” zamiast „Obawy w grupach wieku”).
- Mieszanie konwencji — kropki i przecinki dziesiętne lub różny zapis zer w jednej pracy.
- Tabela bez odwołania w tekście albo umieszczona przed pierwszym odwołaniem.
- Ukrywanie wyników nieistotnych.
Z SPSS, JASP i R do Worda
- SPSS: eksportuj wyniki (Plik → Eksportuj → Word) i przepisz potrzebne liczby do pustego wzoru tabeli — nie formatuj tabel SPSS „na siłę”.
- JASP: włącz Settings → Results → APA format; tabele kopiuje się do Worda jednym kliknięciem, ale zwykle wymagają poprawienia tytułu i noty.
- R: wartości z kodu w hasłach słownika wklejasz do wzoru .docx; zaawansowani mogą generować tabele pakietami takimi jak flextable lub papaja.
- Wzory .docx: komplet 16 tabel albo wzory pojedynczych tabel w hasłach słownika — zastąp liczby swoimi wynikami.
- Generator online: w serwisie Ankieta za ankietę (zakładka „Tabele APA”, za darmo z kontem) wstawisz własne wyniki, a narzędzie złoży z nich tabelę APA gotową do wklejenia.
Lista kontrolna przed oddaniem pracy
☐ Każda tabela jest przywołana w tekście przed swoim miejscem.
☐ Tylko linie poziome; brak siatki i kolorów.
☐ Ta sama liczba miejsc po przecinku/kropce w kolumnie; jedna konwencja w całej pracy.
☐ Symbole statystyczne kursywą; p podane dokładnie lub jako p < .001.
☐ W nocie: N, objaśnienia skrótów, sposób liczenia wyników, znaczenie gwiazdek.
☐ Podano wielkości efektu i (gdzie to możliwe) przedziały ufności.
☐ Tekst interpretuje tabelę, ale jej nie powtarza.
☐ Rysunki mają numer, tytuł i notę oraz są czytelne w czerni i bieli.
Najczęstsze pytania
Jak zrobić tabelę w stylu APA?
Nad tabelą wpisz numer pogrubiony (Tabela 1), pod nim tytuł kursywą. W tabeli użyj tylko linii poziomych (nad nagłówkiem, pod nagłówkiem i na dole), wyrównaj liczby i zachowaj tę samą liczbę miejsc po kropce. Pod tabelą dodaj notę zaczynającą się od słowa „Uwaga.” zapisanego kursywą.
Co pisze się w nocie pod tabelą APA?
Notę ogólną (liczebność próby, objaśnienia skrótów, sposób liczenia wyników), notę szczegółową (objaśnienia oznaczone literami w indeksie przy konkretnych komórkach) i notę o prawdopodobieństwie (znaczenie gwiazdek, np. *p < .05).
Czy w polskiej pracy używać kropki czy przecinka dziesiętnego?
Oryginalny styl APA używa kropki i pomija zero przed kropką przy wartościach, które nie mogą przekroczyć 1 (p = .023, r = .45). Wiele polskich uczelni wymaga przecinka — sprawdź wytyczne wydziału i stosuj jedną konwencję w całej pracy.
Czy można wkleić tabelę z SPSS do pracy?
Nie jako zrzut ekranu. Tabele z SPSS zawierają zbędne informacje i nie spełniają wymogów APA. Przepisz potrzebne wartości do tabeli w Wordzie albo skorzystaj z wzorów .docx z tego artykułu.
Gdzie umieścić tabele: w tekście czy w aneksie?
Najważniejsze tabele umieszcza się w tekście, zaraz po akapicie, w którym po raz pierwszy się do nich odwołujesz. Bardzo obszerne lub pomocnicze tabele (np. pełne macierze, wyniki dodatkowych analiz) można przenieść do aneksu.
Czy tabela może zawierać wyniki nieistotne?
Tak i powinna. Pełne statystyki wyników nieistotnych są potrzebne do oceny badania i do metaanaliz; ukrywanie ich zniekształca obraz wyników.
Jak numerować tabele w pracy dyplomowej?
Kolejnymi liczbami arabskimi w porządku pojawiania się w tekście (Tabela 1, Tabela 2…). Niektóre uczelnie wymagają numeracji w rozdziałach (Tabela 3.1) — wtedy stosuj ją konsekwentnie.
Czy rysunki też mają format APA?
Tak: rysunek ma numer pogrubiony (Rysunek 1), tytuł kursywą nad rysunkiem i notę pod spodem. Sam wykres powinien być czytelny w czerni i bieli, z opisanymi osiami i jednostkami.
Potrzebujesz pomocy z rozdziałem „Wyniki”?
Przeprowadzimy analizy i przygotujemy komplet tabel oraz rysunków w stylu APA — z opisem wyników gotowym do pracy dyplomowej.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (b.d.). Table setup. APA Style. Pobrano 8 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables ● Otwarty dostęp
- American Psychological Association. (b.d.). Sample tables. APA Style. Pobrano 9 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879 ● Otwarty dostęp
- Costello, A. B., & Osborne, J. (2005). Best practices in exploratory factor analysis: Four recommendations for getting the most from your analysis. Practical Assessment, Research, and Evaluation, 10, Article 7. https://doi.org/10.7275/jyj1-4868 ● Otwarty dostęp
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
Cytowania BibTeX
@book{apa2020manual, author={{American Psychological Association}}, title={Publication Manual of the American Psychological Association}, edition={7}, publisher={American Psychological Association}, address={Washington, DC}, year={2020}, doi={10.1037/0000165-000}}@misc{apa_table_setup, author={{American Psychological Association}}, title={Table setup}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables}, note={Pobrano 8 października 2026}}@misc{apa_sample_tables, author={{American Psychological Association}}, title={Sample tables}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables}, note={Pobrano 9 października 2026}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{wilkinson1999statistical, author={Wilkinson, Leland and {Task Force on Statistical Inference}}, title={Statistical methods in psychology journals: Guidelines and explanations}, journal={American Psychologist}, year={1999}, volume={54}, number={8}, pages={594--604}, doi={10.1037/0003-066X.54.8.594}}@article{cumming2014the, author={Cumming, Geoff}, title={The new statistics: Why and how}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={Beyond bar and line graphs: Time for a new data presentation paradigm}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}@article{lakens2013calculating, author={Lakens, Dani{\"e}l}, title={Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{preacher2008asymptotic, author={Preacher, Kristopher J. and Hayes, Andrew F.}, title={Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models}, journal={Behavior Research Methods}, year={2008}, volume={40}, number={3}, pages={879--891}, doi={10.3758/BRM.40.3.879}}@article{costello2005best, author={Costello, Anna B. and Osborne, Jason}, title={Best practices in exploratory factor analysis: Four recommendations for getting the most from your analysis}, journal={Practical Assessment, Research, and Evaluation}, year={2005}, volume={10}, eid={7}, doi={10.7275/jyj1-4868}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}, journal={Structural Equation Modeling}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}