Kiedy używać tabeli ANOVA?
Gdy porównujesz trzy lub więcej grup (np. grupy wieku, warunki eksperymentalne) albo badasz wpływ dwóch czynników i ich interakcji. Pamiętaj, że testy post hoc wykonuje się tylko po istotnym teście F — w wariancie A żaden test nie był istotny, więc ich nie liczono.
Wzory tabel ANOVA w APA
Trzy warianty na tych samych danych.
Wariant A: ANOVA jednoczynnikowa bez istotnych różnic
Raportowanie wyników nieistotnych jest równie ważne jak istotnych — podaj pełne statystyki.
Tabela 1
Porównanie zmiennych modelu akceptacji technologii w grupach wieku
| Zmienna | 20–24 (n = 109) | 25–29 (n = 116) | 30+ (n = 78) | F(2, 300) | p | η2 | |||
|---|---|---|---|---|---|---|---|---|---|
| M | SD | M | SD | M | SD | ||||
| Intencja zakupu | 2.77 | 1.04 | 2.71 | 1.06 | 2.83 | 0.98 | 0.35 | .702 | .00 |
| Użyteczność | 3.27 | 0.85 | 3.25 | 0.90 | 3.20 | 0.94 | 0.15 | .863 | .00 |
| Łatwość korzystania | 3.66 | 0.74 | 3.59 | 0.82 | 3.58 | 0.83 | 0.29 | .749 | .00 |
| Obawy | 2.75 | 0.72 | 2.80 | 0.72 | 2.82 | 0.70 | 0.26 | .769 | .00 |
Uwaga. N = 303. Wiek w latach podzielono na trzy przedziały. η2 = eta kwadrat. Ponieważ żaden test F nie był istotny, nie przeprowadzano porównań post hoc.
Wariant B: ANOVA jednoczynnikowa z testami post hoc
Ilustracja zapisu liter post hoc na grupach o niskiej, średniej i wysokiej użyteczności.
Tabela 2
Zmienne modelu akceptacji technologii w grupach o różnym poziomie postrzeganej użyteczności
| Zmienna | Niska (n = 133) | Średnia (n = 91) | Wysoka (n = 79) | F(2, 300) | p | η2 | |||
|---|---|---|---|---|---|---|---|---|---|
| M | SD | M | SD | M | SD | ||||
| Intencja zakupu | 2.12a | 0.84 | 2.91b | 0.74 | 3.68c | 0.86 | 93.60 | < .001 | .38 |
| Cele | 1.73a | 0.54 | 2.27b | 0.59 | 2.73c | 0.77 | 66.66 | < .001 | .31 |
| Łatwość korzystania | 3.28a | 0.81 | 3.75b | 0.56 | 4.02c | 0.76 | 27.53 | < .001 | .16 |
| Obawy | 3.13a | 0.60 | 2.67b | 0.59 | 2.34c | 0.73 | 40.34 | < .001 | .21 |
Uwaga. N = 303. Grupy utworzono przez podział wyników skali użyteczności na tercyle (niska: ≤ 3.00, średnia: 3.25–3.75, wysoka: ≥ 4.00); podział służy wyłącznie ilustracji formatu tabeli — przy zmiennej ilościowej lepszą analizą jest regresja.
Średnie w tym samym wierszu oznaczone różnymi literami w indeksie dolnym różnią się istotnie (p < .05, test HSD Tukeya). η2 = eta kwadrat (odsetek wariancji wyjaśnianej przez grupę).
Wariant C: ANOVA dwuczynnikowa
Układ „źródło zmienności” dla płci, grupy wieku i ich interakcji.
Tabela 3
Dwuczynnikowa analiza wariancji obaw: płeć i grupa wieku
| Źródło zmienności | df | F | p | η2p | 95% CI dla η2p |
|---|---|---|---|---|---|
| Płeć | 1 | 31.84 | < .001 | .097 | [.042, .165] |
| Grupa wieku | 2 | 0.52 | .598 | .003 | [.000, .023] |
| Płeć × grupa wieku | 2 | 0.14 | .872 | .001 | [.000, .012] |
| Błąd | 297 |
Uwaga. N = 303. Sumy kwadratów typu III. η2p = cząstkowe eta kwadrat. Kobiety (M = 2.98, SD = 0.63) zgłaszały więcej obaw niż mężczyźni (M = 2.53, SD = 0.74).
Co jest w tabeli i jak ją czytać
- Stopnie swobody w nagłówku — F(2, 300) oznacza 2 stopnie swobody efektu i 300 błędu.
- η² i η²p — w ANOVA jednoczynnikowej obie miary są równe; w wieloczynnikowej podaje się cząstkowe η² (Lakens, 2013). Bez zera wiodącego, bo nie przekraczają 1.
- Litery post hoc — średnie z tą samą literą nie różnią się istotnie. W wariancie B wszystkie trzy grupy różnią się parami, więc mają różne litery.
- Typ sum kwadratów — w nierównolicznych schematach wieloczynnikowych podaj w nocie, że użyto typu III (jak w SPSS).
Jak opisać tabelę w tekście pracy
W tekście nie powtarzaj wszystkich liczb z tabeli — przywołaj ją i opisz najważniejsze wyniki. Przykład dla danych z tej strony:
Rysunek: wykres średnich i wykres interakcji
Dla ANOVA dwuczynnikowej najczytelniejszy jest wykres interakcji: średnie z przedziałami ufności dla kombinacji poziomów czynników. Równoległe linie oznaczają brak interakcji. Drugi rysunek pokazuje prosty rysunek w stylu APA (czarno-biały) z danymi w tle.
Rysunek 1
Średni poziom obaw w zależności od płci i grupy wieku
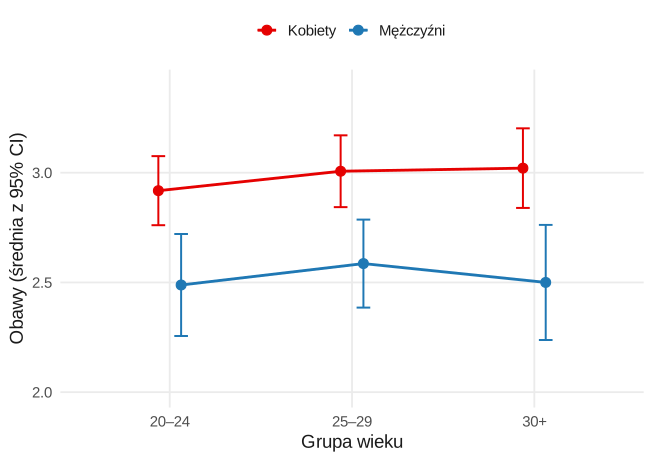
Uwaga. Odcinki oznaczają 95% przedziały ufności. Linie są niemal równoległe, co odpowiada nieistotnej interakcji.
Rysunek 2
Intencja zakupu w grupach o różnym poziomie postrzeganej użyteczności
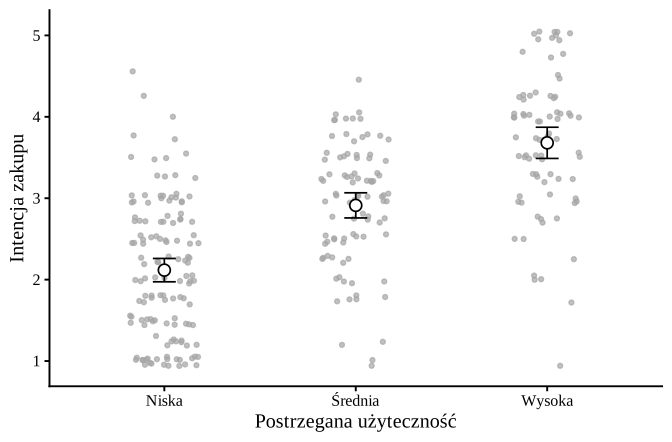
Uwaga. Białe punkty to średnie, odcinki — 95% przedziały ufności, szare punkty — wyniki osób.
Jak przygotować tabelę: SPSS, JASP, R i Word
SPSS: Analiza → Ogólny model liniowy → Jednej zmiennej; w Opcjach zaznacz statystyki opisowe i oceny wielkości efektu, w Post hoc — test Tukeya (lub Gamesa-Howella przy nierównych wariancjach). JASP: ANOVA z opcjami Descriptive statistics, Estimates of effect size (η², ω²) i Post Hoc Tests.
Jak sformatować tabelę w Wordzie
- Wstaw tabelę, a następnie w Projekt tabeli → Obramowania wybierz Bez obramowania.
- Dodaj tylko trzy linie poziome: nad wierszem nagłówka, pod nagłówkiem i pod ostatnim wierszem (oraz krótkie linie pod nagłówkami grupującymi).
- Nazwy wierszy wyrównaj do lewej, liczby do środka (lub do kropki dziesiętnej); w całej kolumnie zachowaj tę samą liczbę miejsc po kropce.
- Nad tabelą wpisz numer (pogrubiony) i w nowym wierszu tytuł kursywą; pod tabelą notę zaczynającą się od Uwaga.
- Przy długiej tabeli zaznacz wiersz nagłówka i włącz Powtórz jako wiersz nagłówka, aby pojawiał się na każdej stronie.
Przykład w R
Kod liczy ANOVA jednoczynnikową z η², testy post hoc Tukeya i ANOVA dwuczynnikową z sumami kwadratów typu III.
ANOVA, post hoc i ANOVA dwuczynnikowa
R
library(readxl); library(psych)
dane <- as.data.frame(read_excel("dane_ankieta_tam.xlsx"))
dane$LAT <- rowMeans(dane[, paste0("Łatwość_korzystania", 1:4)])   # łatwość korzystania
dane$UZY <- rowMeans(dane[, paste0("Użyteczność", 1:4)])           # użyteczność
dane$INT <- rowMeans(dane[, paste0("Intencja_kupna", 1:4)])        # intencja zakupu
library(effectsize); library(car)
dane$wiek_gr <- cut(dane$Wiek, c(0, 24, 29, 99), labels = c("20–24", "25–29", "30+"))
m <- aov(INT ~ wiek_gr, data = dane)
summary(m)
eta_squared(m, partial = FALSE, alternative = "two.sided")
# wariant z testami post hoc (grupy użyteczności) i ANOVA dwuczynnikowa
q <- quantile(dane$UZY, c(1/3, 2/3))
dane$uzy_gr <- cut(dane$UZY, c(-Inf, q, Inf), labels = c("niska", "średnia", "wysoka"))
TukeyHSD(aov(INT ~ uzy_gr, data = dane))
dane$plec <- factor(dane$Płeć)
options(contrasts = c("contr.sum", "contr.poly"))
m2 <- lm(Obawy ~ plec * wiek_gr, data = dane)
Anova(m2, type = 3)
eta_squared(Anova(m2, type = 3), partial = TRUE, alternative = "two.sided")
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://CRAN.R-project.org/package=readxl
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
Najczęstsze błędy
- Zrzut ekranu z SPSS zamiast tabeli przepisanej w formacie APA.
- Linie pionowe i kolorowe tło — tabela APA ma wyłącznie linie poziome.
- Testy post hoc po nieistotnym F — szukanie różnic, których test ogólny nie potwierdził.
- Brak stopni swobody przy F.
- Cząstkowe η² opisane jako „procent wariancji wyjaśnionej przez czynnik” w schematach wieloczynnikowych.
- Litery post hoc bez objaśnienia w nocie.
Najczęstsze pytania
Jak przedstawić wyniki ANOVA w tabeli APA?
Podaj M i SD każdej grupy, F ze stopniami swobody, p i wielkość efektu (η² lub ω²). Wyniki post hoc oznacz literami przy średnich i opisz w nocie, jakiego testu użyto.
Jak zapisać testy post hoc w tabeli?
Najczęściej literami w indeksie przy średnich: średnie oznaczone różnymi literami różnią się istotnie. Alternatywnie można dodać osobną tabelę porównań parami z różnicą średnich, CI i skorygowanym p.
η² czy ω²?
ω² jest mniej obciążona i lepiej szacuje efekt w populacji, zwłaszcza w małych próbach; η² jest częściej stosowana. Napisz, którą miarę podajesz.
Czy raportować nieistotną ANOVA w tabeli?
Tak. Pełne statystyki wyników nieistotnych są potrzebne do oceny badania i do metaanaliz.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (b.d.). Table setup. APA Style. Pobrano 8 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables ● Otwarty dostęp
- American Psychological Association. (b.d.). Sample tables. APA Style. Pobrano 9 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020manual, author={{American Psychological Association}}, title={Publication Manual of the American Psychological Association}, edition={7}, publisher={American Psychological Association}, address={Washington, DC}, year={2020}, doi={10.1037/0000165-000}}@misc{apa_table_setup, author={{American Psychological Association}}, title={Table setup}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables}, note={Pobrano 8 października 2026}}@misc{apa_sample_tables, author={{American Psychological Association}}, title={Sample tables}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables}, note={Pobrano 9 października 2026}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{lakens2013calculating, author={Lakens, Dani{\"e}l}, title={Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={Beyond bar and line graphs: Time for a new data presentation paradigm}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}