Kiedy używać tabeli dopasowania modeli?
W konfirmacyjnej analizie czynnikowej i modelach SEM, zwłaszcza gdy porównujesz model teoretyczny z alternatywnymi (np. jednoczynnikowym). Wytyczne raportowania CFA zalecają podawanie kilku wskaźników dopasowania naraz i porównań modeli (Jackson i in., 2009).
Wzór tabeli dopasowania modeli w APA
Model jedno-, dwu- i trzyczynnikowy dla 12 pozycji (estymator MLR).
Tabela 1
Wskaźniki dopasowania konkurencyjnych modeli konfirmacyjnej analizy czynnikowej
| Model | χ2 | df | p | CFI | TLI | RMSEA | 90% CI RMSEA | SRMR | AIC | Δχ2 (Δdf) |
|---|---|---|---|---|---|---|---|---|---|---|
| Jednoczynnikowy | 615.58 | 54 | < .001 | .671 | .598 | .214 | [.199, .230] | .139 | 9172.2 | 213.93 (3)*** |
| Dwuczynnikowy | 215.52 | 53 | < .001 | .911 | .889 | .112 | [.097, .128] | .063 | 8620.0 | 69.10 (2)*** |
| Trzyczynnikowy | 121.83 | 51 | < .001 | .962 | .951 | .075 | [.058, .092] | .048 | 8504.5 | — |
Uwaga. N = 303. Estymator MLR; podano skalowane χ2 oraz odporne CFI, TLI i RMSEA. Model dwuczynnikowy łączy użyteczność i intencję zakupu w jeden czynnik. Δχ2 = skalowany test różnicy względem modelu trzyczynnikowego. W modelu trzyczynnikowym standaryzowane ładunki wynosiły od .70 do .89.
***p < .001.
Co jest w tabeli i jak ją czytać
- Kilka wskaźników naraz — χ² zależy od liczebności próby, dlatego uzupełnia się go wskaźnikami przybliżonego dopasowania. Często cytowane progi (CFI i TLI ≥ .95, RMSEA ≤ .06, SRMR ≤ .08; Hu i Bentler, 1999) traktuj orientacyjnie.
- Wersje odporne — przy estymatorze MLR podaj skalowane χ² i odporne CFI, TLI, RMSEA; zaznacz to w nocie.
- Test różnicy χ² — przy MLR stosuje się skalowany test różnicy (Satorra–Bentler), a nie zwykłe odejmowanie χ².
- Bez zera wiodącego przy CFI, TLI, RMSEA i SRMR — nie przekraczają 1.
Jak opisać tabelę w tekście pracy
W tekście nie powtarzaj wszystkich liczb z tabeli — przywołaj ją i opisz najważniejsze wyniki. Przykład dla danych z tej strony:
Diagram modelu konfirmacyjnej analizy czynnikowej
Diagram ścieżek z ładunkami to standardowy sposób prezentacji CFA w psychologii i naukach społecznych. Wygenerowano go pakietem semPlot, tak jak w procedurach SEM aplikacji SZTOS.
Rysunek 1
Model trzyczynnikowy konfirmacyjnej analizy czynnikowej
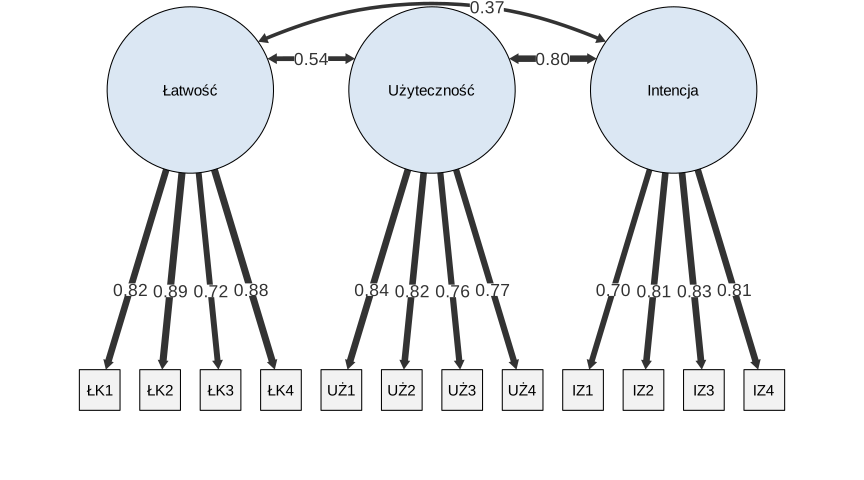
Uwaga. N = 303. Na strzałkach podano standaryzowane ładunki, na łukach — korelacje czynników. Estymator MLR.
Jak przygotować tabelę: SPSS, JASP, R i Word
JASP: moduł Factor → Confirmatory Factor Analysis lub SEM (lavaan) z dodatkowymi wskaźnikami dopasowania. AMOS i Mplus podają wskaźniki w sekcji „Model fit”. R: lavaan (kod niżej). SPSS bez dodatku AMOS nie wykonuje CFA.
Jak sformatować tabelę w Wordzie
- Wstaw tabelę, a następnie w Projekt tabeli → Obramowania wybierz Bez obramowania.
- Dodaj tylko trzy linie poziome: nad wierszem nagłówka, pod nagłówkiem i pod ostatnim wierszem (oraz krótkie linie pod nagłówkami grupującymi).
- Nazwy wierszy wyrównaj do lewej, liczby do środka (lub do kropki dziesiętnej); w całej kolumnie zachowaj tę samą liczbę miejsc po kropce.
- Nad tabelą wpisz numer (pogrubiony) i w nowym wierszu tytuł kursywą; pod tabelą notę zaczynającą się od Uwaga.
- Przy długiej tabeli zaznacz wiersz nagłówka i włącz Powtórz jako wiersz nagłówka, aby pojawiał się na każdej stronie.
Przykład w R
Kod szacuje trzy konkurencyjne modele, wypisuje wskaźniki dopasowania i skalowane testy różnicy χ².
Porównanie modeli CFA w lavaan (MLR)
R
library(readxl); library(psych)
dane <- as.data.frame(read_excel("dane_ankieta_tam.xlsx"))
dane$LAT <- rowMeans(dane[, paste0("Łatwość_korzystania", 1:4)])   # łatwość korzystania
dane$UZY <- rowMeans(dane[, paste0("Użyteczność", 1:4)])           # użyteczność
dane$INT <- rowMeans(dane[, paste0("Intencja_kupna", 1:4)])        # intencja zakupu
library(lavaan)
pozycje <- dane[, c(paste0("Łatwość_korzystania", 1:4), paste0("Użyteczność", 1:4), paste0("Intencja_kupna", 1:4))]
names(pozycje) <- c(paste0("LAT", 1:4), paste0("UZY", 1:4), paste0("INT", 1:4))
m1 <- 'F =~ LAT1+LAT2+LAT3+LAT4+UZY1+UZY2+UZY3+UZY4+INT1+INT2+INT3+INT4'
m2 <- 'LAT =~ LAT1+LAT2+LAT3+LAT4
       UI  =~ UZY1+UZY2+UZY3+UZY4+INT1+INT2+INT3+INT4'
m3 <- 'LAT =~ LAT1+LAT2+LAT3+LAT4
       UZY =~ UZY1+UZY2+UZY3+UZY4
       INT =~ INT1+INT2+INT3+INT4'
fity <- lapply(list(m1, m2, m3), cfa, data = pozycje, estimator = "MLR")
sapply(fity, fitMeasures, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
                            "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr", "aic"))
lavTestLRT(fity[[1]], fity[[3]]); lavTestLRT(fity[[2]], fity[[3]])   # skalowany test różnicy χ²
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://CRAN.R-project.org/package=readxl
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Najczęstsze błędy
- Zrzut ekranu z SPSS zamiast tabeli przepisanej w formacie APA.
- Linie pionowe i kolorowe tło — tabela APA ma wyłącznie linie poziome.
- Tylko χ² albo tylko jeden wskaźnik dopasowania.
- Niepodanie estymatora i wersji wskaźników (zwykłe czy odporne).
- Odejmowanie skalowanych χ² zamiast skalowanego testu różnicy.
- Brak ładunków — samo dopasowanie nie mówi, jak dobrze pozycje mierzą czynniki.
Najczęstsze pytania
Jakie wskaźniki dopasowania podać w tabeli?
Najczęściej χ² z df i p, CFI, TLI, RMSEA z 90% CI i SRMR; przy porównaniu modeli niezagnieżdżonych — także AIC lub BIC.
Jakie wartości oznaczają dobre dopasowanie?
Często cytuje się CFI i TLI ≥ .95, RMSEA ≤ .06 i SRMR ≤ .08 (Hu i Bentler, 1999), ale są to orientacyjne punkty odcięcia, a nie sztywne reguły.
Jak porównać modele?
Dla modeli zagnieżdżonych — testem różnicy χ² (przy MLR skalowanym); dla niezagnieżdżonych — kryteriami informacyjnymi AIC i BIC.
Gdzie podać ładunki?
W osobnej tabeli lub na diagramie modelu; w nocie tabeli dopasowania można podać ich zakres.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Tabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (b.d.). Table setup. APA Style. Pobrano 8 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables ● Otwarty dostęp
- American Psychological Association. (b.d.). Sample tables. APA Style. Pobrano 9 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Jackson, D. L., Gillaspy, J. A., Jr., & Purc-Stephenson, R. (2009). Reporting practices in confirmatory factor analysis: An overview and some recommendations. Psychological Methods, 14(1), 6–23. https://doi.org/10.1037/a0014694
Cytowania BibTeX
@book{apa2020manual, author={{American Psychological Association}}, title={Publication Manual of the American Psychological Association}, edition={7}, publisher={American Psychological Association}, address={Washington, DC}, year={2020}, doi={10.1037/0000165-000}}@misc{apa_table_setup, author={{American Psychological Association}}, title={Table setup}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables}, note={Pobrano 8 października 2026}}@misc{apa_sample_tables, author={{American Psychological Association}}, title={Sample tables}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables}, note={Pobrano 9 października 2026}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}, journal={Structural Equation Modeling}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{jackson2009reporting, author={Jackson, Dennis L. and Gillaspy, J. Arthur, Jr. and Purc-Stephenson, Rebecca}, title={Reporting practices in confirmatory factor analysis: An overview and some recommendations}, journal={Psychological Methods}, year={2009}, volume={14}, number={1}, pages={6--23}, doi={10.1037/a0014694}}