Co to jest RMSEA?
RMSEA (ang. root mean square error of approximation, pierwiastek średniego kwadratu błędu aproksymacji) to indeks dopasowania modelu w SEM i CFA, który szacuje, jak bardzo model odbiega od populacji w przeliczeniu na jeden stopień swobody. Wartość 0 oznacza, że niedopasowanie nie przekracza tego, czego można się spodziewać po samym błędzie losowym; im wyższa wartość, tym gorsze przybliżenie.
Pomysł stojący za RMSEA opisali Browne i Cudeck (1992): model nigdy nie jest dokładnie prawdziwy, więc zamiast pytać „czy pasuje idealnie?” (to robi test χ²), lepiej oszacować błąd aproksymacji – niedopasowanie modelu do populacyjnej macierzy kowariancji – i podać dla niego przedział ufności. RMSEA należy do indeksów bezwzględnych: w odróżnieniu od CFI czy TLI nie porównuje modelu z modelem niezależności, a w odróżnieniu od SRMR nie jest prostą średnią reszt korelacji.
Wzór i sposób liczenia
Licznik, χ² − df, to szacunek parametru niecentralności, czyli „nadwyżki” niedopasowania ponad poziom oczekiwany przy prawdziwym modelu (wartość oczekiwana χ² dla prawdziwego modelu wynosi df). Dzielenie przez df sprawia, że model oszczędny – z wieloma stopniami swobody – nie jest karany za to, że ma więcej ograniczeń. Dzielenie przez N − 1 usuwa zależność od liczebności próby, którą ma sam χ².
- Gdy χ² ≤ df, RMSEA = 0. Dlatego wiele dobrze dopasowanych modeli ma RMSEA równe dokładnie zero.
- Programy różnią się mianownikiem. Klasyczny wzór używa N − 1; lavaan (wersja 0.7-2, użyta w przykładzie) – N. Przy setkach osób różnica pojawia się dopiero na trzecim miejscu po przecinku.
- Przedział ufności 90% wyznacza się z niecentralnego rozkładu χ². Na jego podstawie testuje się hipotezę „bliskiego dopasowania” (H0: RMSEA ≤ .05) – w lavaan to
rmsea.pvalue, w AMOS – PCLOSE.
Ta sama proporcja χ²/df daje różne RMSEA przy różnych N. W kodzie poniżej dla χ²/df = 1.6 i df = 19 RMSEA wynosi .077 przy N = 100, .049 przy N = 250 i .024 przy N = 1000 – dlatego samo „χ²/df < 2” nie zastąpi RMSEA.
Przykład: jeden czy dwa wymiary perfekcjonizmu?
Osiem pozycji kwestionariusza perfekcjonizmu (skala 1–6) wypełniło 250 osób (dane symulowane). Teoria zakłada dwa skorelowane wymiary: dążenia perfekcjonistyczne (4 pozycje) i obawy perfekcjonistyczne (4 pozycje). Porównujemy model jednoczynnikowy z dwuczynnikowym.
| Model | χ²(df) | RMSEA | 90% CI | p (RMSEA ≤ .05) | CFI | SRMR |
|---|---|---|---|---|---|---|
| Jeden czynnik | 174.26 (20) | .176 | [.152, .200] | < .001 | .692 | .125 |
| Dwa czynniki | 25.87 (19) | .038 | [.000, .072] | .683 | .986 | .049 |
Jak to czytać krok po kroku:
- Wartość punktowa. Dla modelu jednoczynnikowego: √[(174.26 − 20) / (20 × 250)] = .176 – bardzo duże niedopasowanie. Dla dwuczynnikowego: √[(25.87 − 19) / (19 × 250)] = .038.
- Przedział ufności. W modelu dwuczynnikowym przedział [.000, .072] obejmuje zero, ale jego górna granica przekracza .06. Dane są zgodne zarówno z dopasowaniem bardzo dobrym, jak i przeciętnym – przy 250 osobach precyzja jest ograniczona.
- Test bliskiego dopasowania. p = .683 oznacza, że nie odrzucamy hipotezy RMSEA ≤ .05. To nie jest dowód dobrego dopasowania – przy małej próbie test ma niską moc.
- Inne indeksy. CFI = .986 i SRMR = .049 prowadzą do tego samego wniosku: dwa wymiary opisują dane znacznie lepiej niż jeden.
Moc. MacCallum i in. (1996) pokazali, jak liczyć moc testów opartych na RMSEA, definiując wielkość efektu jako parę wartości: zerową i alternatywną. Dla df = 19 i N = 250 moc testu bliskiego dopasowania (RMSEA = .05 wobec .08) wynosi tylko .533; moc .80 osiąga się przy N = 453. Planując badanie z CFA, policz to przed zebraniem danych (zob. moc testu).
Pułapka: małe df i mała próba
Kenny i in. (2015) wykazali, że w poprawnie określonych modelach z małą liczbą stopni swobody i małą próbą RMSEA zbyt często wskazuje złe dopasowanie, i zalecili, by w takich modelach w ogóle go nie liczyć. Rysunek 1 pokazuje to w symulacji: w każdej z 500 prób model jest dokładnie prawdziwy, a mimo to przy df = 2 i N = 100 aż 19.0% prób daje RMSEA > .08.
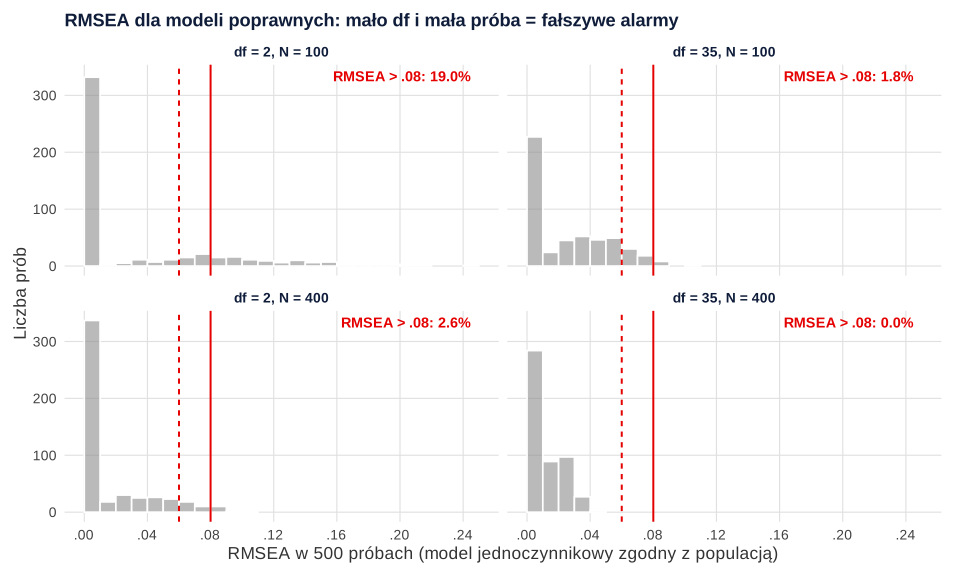
Z tego samego powodu nie ma uniwersalnego progu. Chen i in. (2008) w symulacji znaleźli niewiele empirycznego wsparcia dla .05 czy jakiejkolwiek stałej wartości odcięcia – właściwy punkt zależy od specyfikacji modelu, df i N. Hu i Bentler (1999) proponowali dla estymacji ML wartość bliską .06 w połączeniu z innymi indeksami, a zarazem zauważyli, że przy małych próbach RMSEA zbyt często odrzuca prawdziwe modele. Traktuj więc .05, .06 i .08 jako punkty orientacyjne, a o modelu wnioskuj z przedziału ufności, kilku indeksów i lokalnych niedopasowań w resztach standaryzowanych.
Jak opisać RMSEA w pracy (APA)
Podaj zawsze wartość punktową z 90% przedziałem ufności, razem z χ², CFI/TLI i SRMR; przy porównaniu modeli – także test różnicy χ². Wzór dla przykładu:
Pełną procedurę oceny modelu pomiarowego, z wyborem estymatora i opisem wyników, znajdziesz we wpisach CB-SEM krok po kroku oraz analiza czynnikowa EFA i CFA. Przy porównywaniu grup RMSEA wykorzystuje się też do oceny inwariancji pomiaru.
RMSEA w R (lavaan)
Kod tworzy dane z przykładu, szacuje oba modele, liczy RMSEA ręcznie, pokazuje wpływ N przy stałym χ²/df oraz moc testu bliskiego dopasowania. Liczby w tabeli i tekście pochodzą z tego kodu; rysunek 1 – z osobnej symulacji (500 prób w każdym z czterech wariantów).
RMSEA, przedział ufności, test bliskiego dopasowania i moc
R
# Dane symulowane: 250 osób, 8 pozycji kwestionariusza perfekcjonizmu (skala 1–6):
# dążenia perfekcjonistyczne (d1–d4) i obawy perfekcjonistyczne (o1–o4), korelacja czynników .45
suppressPackageStartupMessages(library(lavaan))
set.seed(134)
n <- 250
F <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, .45, .45, 1), 2))
lam <- c(.75, .70, .65, .60)
poz <- function(f, l) round(pmin(pmax(3.5 + 1.1 * (l * f + rnorm(n, sd = sqrt(1 - l^2))), 1), 6))
dane <- data.frame(sapply(lam, function(l) poz(F[, 1], l)), sapply(lam, function(l) poz(F[, 2], l)))
names(dane) <- c(paste0("d", 1:4), paste0("o", 1:4))

m1 <- cfa('PERF =~ d1 + d2 + d3 + d4 + o1 + o2 + o3 + o4', data = dane)          # model jednoczynnikowy
m2 <- cfa('DAZ =~ d1 + d2 + d3 + d4
           OBA =~ o1 + o2 + o3 + o4', data = dane)                              # model dwuczynnikowy
miary <- c("chisq", "df", "pvalue", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper", "rmsea.pvalue", "cfi", "srmr")
round(rbind(jednoczynnikowy = fitMeasures(m1, miary), dwuczynnikowy = fitMeasures(m2, miary)), 3)

# RMSEA „ręcznie”: pierwiastek z nadwyżki chi-kwadrat ponad df, w przeliczeniu na stopień swobody i osobę
rmsea_recznie <- function(chi2, df, N) sqrt(max(chi2 - df, 0) / (df * N))
c(m1 = rmsea_recznie(fitMeasures(m1, "chisq"), fitMeasures(m1, "df"), n),
  m2 = rmsea_recznie(fitMeasures(m2, "chisq"), fitMeasures(m2, "df"), n))

# Ten sam stosunek chi-kwadrat do df przy innej liczebności próby daje inne RMSEA
sapply(c(100, 250, 1000), function(N) round(rmsea_recznie(1.6 * 19, 19, N), 3))

# Moc testu bliskiego dopasowania (H0: RMSEA <= .05 vs H1: RMSEA = .08) dla df = 19 i N = 250
# oraz liczebność potrzebna do mocy .80 (MacCallum i in., 1996)
ncp <- function(e, df, N) (N - 1) * df * e^2
kryt <- qchisq(.95, 19, ncp = ncp(.05, 19, 250))
round(c(moc = pchisq(kryt, 19, ncp = ncp(.08, 19, 250), lower.tail = FALSE)), 3)
moc_N <- function(N) pchisq(qchisq(.95, 19, ncp = ncp(.05, 19, N)), 19, ncp = ncp(.08, 19, N), lower.tail = FALSE)
c(N_dla_mocy_80 = min(which(sapply(50:2000, moc_N) >= .80)) + 49)
Wynik w R
                  chisq df pvalue rmsea rmsea.ci.lower rmsea.ci.upper
jednoczynnikowy 174.258 20  0.000 0.176          0.152          0.200
dwuczynnikowy    25.874 19  0.134 0.038          0.000          0.072
                rmsea.pvalue   cfi  srmr
jednoczynnikowy        0.000 0.692 0.125
dwuczynnikowy          0.683 0.986 0.049
     m1.df      m2.df
0.17564601 0.03804239
[1] 0.077 0.049 0.024
  moc
0.533
N_dla_mocy_80
          453
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Podawanie RMSEA bez przedziału ufności. Wartość .038 z przedziałem [.000, .072] mówi coś innego niż .038 z przedziałem [.020, .052].
- Traktowanie .06 lub .08 jak progu istotności. To orientacyjne wartości z symulacji o określonych warunkach, a nie kryterium „model przyjęty / odrzucony”.
- Ocenianie modeli z bardzo małym df (np. model ścieżkowy z df = 1–3) na podstawie RMSEA. W takich modelach patrz na reszty i oszacowania parametrów.
- Odczytywanie nieistotnego testu bliskiego dopasowania jako dowodu dobrego dopasowania przy małej próbie i niskiej mocy.
- Porównywanie RMSEA z różnych estymatorów bez zastrzeżeń. Wartości z MLR (wersja odporna) czy z estymatorów dla danych porządkowych nie są wprost porównywalne z RMSEA z ML.
- Dopisywanie parametrów, aż RMSEA spadnie poniżej .06. Każda modyfikacja według indeksów modyfikacji musi mieć uzasadnienie treściowe.
Najczęstsze pytania
Jaka wartość RMSEA oznacza dobre dopasowanie modelu?
Najczęściej przyjmuje się, że wartości do około .05–.06 świadczą o dobrym, a do .08 o akceptowalnym dopasowaniu. To jednak punkty orientacyjne – Chen i in. (2008) nie znaleźli empirycznego wsparcia dla jednej uniwersalnej wartości odcięcia. Oceniaj RMSEA razem z przedziałem ufności i innymi indeksami.
Dlaczego RMSEA wynosi 0?
RMSEA jest równe zero zawsze, gdy χ² nie przekracza liczby stopni swobody, bo wtedy szacowana nadwyżka niedopasowania jest ujemna i wzór obcina ją do zera. To częste przy dobrze dopasowanych modelach i małych próbach; sprawdź wtedy górną granicę 90% przedziału ufności.
Co to jest PCLOSE przy RMSEA?
PCLOSE (w lavaan rmsea.pvalue) to wartość p testu hipotezy, że RMSEA w populacji nie przekracza .05. Wynik nieistotny oznacza brak podstaw do odrzucenia bliskiego dopasowania, ale przy małej próbie test ma niską moc, więc nie jest dowodem dobrego modelu.
Czy RMSEA zależy od liczebności próby?
Wzór dzieli niedopasowanie przez N − 1, więc RMSEA nie rośnie z próbą tak jak χ². Zależy jednak od N pośrednio: w małych próbach jego rozkład jest szeroki, a przedział ufności długi. Przy małej próbie i małym df poprawne modele często mają wysokie RMSEA.
Dlaczego RMSEA i CFI dają sprzeczne oceny modelu?
Mierzą różne rzeczy: RMSEA – bezwzględne niedopasowanie na stopień swobody, CFI – poprawę względem modelu niezależności. Przy słabych korelacjach między zmiennymi CFI bywa niski mimo niskiego RMSEA, a przy małym df RMSEA bywa wysoki mimo dobrego CFI. Opisz oba i poszukaj przyczyny w resztach.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Browne, M. W., & Cudeck, R. (1992). Alternative ways of assessing model fit. Sociological Methods & Research, 21(2), 230–258. https://doi.org/10.1177/0049124192021002005
- Chen, F., Curran, P. J., Bollen, K. A., Kirby, J., & Paxton, P. (2008). An empirical evaluation of the use of fixed cutoff points in RMSEA test statistic in structural equation models. Sociological Methods & Research, 36(4), 462–494. https://doi.org/10.1177/0049124108314720 ● Otwarty dostęp: pełny tekst
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Kenny, D. A., Kaniskan, B., & McCoach, D. B. (2015). The performance of RMSEA in models with small degrees of freedom. Sociological Methods & Research, 44(3), 486–507. https://doi.org/10.1177/0049124114543236
- MacCallum, R. C., Browne, M. W., & Sugawara, H. M. (1996). Power analysis and determination of sample size for covariance structure modeling. Psychological Methods, 1(2), 130–149. https://doi.org/10.1037/1082-989x.1.2.130
Cytowania BibTeX
@article{browne1992alternative, author={Browne, Michael W. and Cudeck, Robert}, title={{Alternative ways of assessing model fit}}, journal={Sociological Methods \& Research}, year={1992}, volume={21}, number={2}, pages={230--258}, doi={10.1177/0049124192021002005}}@article{chen2008empirical, author={Chen, Feinian and Curran, Patrick J. and Bollen, Kenneth A. and Kirby, James and Paxton, Pamela}, title={{An empirical evaluation of the use of fixed cutoff points in RMSEA test statistic in structural equation models}}, journal={Sociological Methods \& Research}, year={2008}, volume={36}, number={4}, pages={462--494}, doi={10.1177/0049124108314720}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{kenny2015performance, author={Kenny, David A. and Kaniskan, Burcu and McCoach, D. Betsy}, title={{The performance of RMSEA in models with small degrees of freedom}}, journal={Sociological Methods \& Research}, year={2015}, volume={44}, number={3}, pages={486--507}, doi={10.1177/0049124114543236}}@article{maccallum1996power, author={MacCallum, Robert C. and Browne, Michael W. and Sugawara, Hazuki M.}, title={{Power analysis and determination of sample size for covariance structure modeling}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={130--149}, doi={10.1037/1082-989x.1.2.130}}