Co to jest TLI?
TLI (ang. Tucker–Lewis index, indeks Tuckera–Lewisa), nazywany też NNFI (non-normed fit index), to przyrostowy wskaźnik dopasowania modelu w SEM i CFA. Pokazuje, jaką część „niedopasowania” modelu bazowego usuwa Twój model, przy czym niedopasowanie mierzy stosunkiem χ² do stopni swobody. Model bazowy (zerowy, niezależności) zakłada, że zmienne obserwowane w ogóle ze sobą nie korelują. TLI bliskie 1 oznacza, że model jest prawie tak dobry, jak można oczekiwać od modelu poprawnego.
Tucker i Lewis (1973) zaproponowali ten współczynnik w analizie czynnikowej metodą największej wiarygodności. Chodziło o sytuację, w której test ilorazu wiarygodności odrzuca model w dużej próbie, choć model bardzo dobrze przybliża dane. Bentler i Bonett (1980) opisali go potem jako nienormowany wskaźnik dopasowania (NNFI) – obok normowanego NFI – w ramach porównywania modelu z modelem zerowym.
Wzór TLI
Indeks 0 oznacza model bazowy, a M – Twój model. Licznik mówi, o ile Twój model zmniejsza stosunek χ²/df w porównaniu z modelem bazowym. Mianownik to największa możliwa poprawa: do wartości 1, czyli takiej, jakiej oczekuje się od modelu poprawnego (wartość oczekiwana χ² równa się df). Z tego wzoru wynikają trzy własności TLI:
- Kara za złożoność. Każdy dodatkowy parametr zmniejsza dfM. Jeśli χ² spada przy tym nieznacznie, stosunek χ²M/dfM rośnie i TLI maleje.
- TLI nie jest ograniczone do przedziału 0–1. Gdy χ²M < dfM, TLI przekracza 1. Gdy model jest gorszy od bazowego w przeliczeniu na stopień swobody, TLI bywa ujemne. Stąd nazwa „nienormowany”.
- Zależy od modelu bazowego. Jeśli zmienne słabo ze sobą korelują, χ²0/df0 jest małe i nawet przyzwoity model ma niskie TLI. Przy silnych korelacjach jest odwrotnie.
Siostrzany CFI liczy niedopasowanie jako różnicę χ² − df i jest obcięty do przedziału 0–1. Dlatego w tym samym modelu TLI jest zwykle nieco niższe od CFI. Silniej karze też za dodatkowe parametry.
Jak interpretować TLI
Najczęściej przyjmuje się, za Hu i Bentlerem (1999), że TLI bliskie .95 lub wyższe wskazuje na dobre dopasowanie przy estymacji ML. Starsza, łagodniejsza reguła to .90. Hu i Bentler zwrócili jednak uwagę, że przy małych próbach TLI zbyt często odrzuca modele prawdziwe. Marsh i in. (2004) przestrzegają przed traktowaniem tych progów jak sztywnych „złotych reguł”. Na wartość TLI wpływa też wielkość modelu: według Shi i in. (2019) w skończonych próbach CFI, TLI i RMSEA sugerują gorsze dopasowanie niż w populacji. Efekt jest silniejszy przy małej próbie, wielu zmiennych i niskich ładunkach.
Przykład: TLI dla modelu jedno- i trójczynnikowego
Dwieście pięćdziesiąt osób (dane symulowane) wypełniło 9 pozycji skali wsparcia społecznego (1–7). Po trzy pozycje opisują wsparcie od rodziny, od przyjaciół i od osoby bliskiej. Porównujemy model jednoczynnikowy („ogólne wsparcie”) z trójczynnikowym.
| Model | χ² | df | χ²/df | TLI | CFI |
|---|---|---|---|---|---|
| Bazowy (brak korelacji) | 660.71 | 36 | 18.35 | – | – |
| Jeden czynnik | 196.74 | 27 | 7.29 | .638 | .728 |
| Trzy czynniki | 26.50 | 24 | 1.10 | .994 | .996 |
| Trzy czynniki + 3 zbędne kowariancje reszt | 25.37 | 21 | 1.21 | .988 | .993 |
Dla modelu trójczynnikowego obliczenie wygląda tak: TLI = (18.35 − 1.10) / (18.35 − 1) = 17.25 / 17.35 = .994. Model jednoczynnikowy ma χ²/df = 7.29, więc usuwa tylko około dwóch trzecich niedopasowania (TLI = .638). Trzy rodzaje wsparcia trzeba zatem modelować osobno.
Ostatni wiersz pokazuje karę za złożoność. Do dobrego modelu dodaliśmy trzy kowariancje reszt, których w populacji nie ma (oszacowania 0.04, −0.00 i 0.05; wszystkie p > .40). χ² spadło tylko o 1.13 przy utracie 3 stopni swobody, więc TLI spadło z .994 do .988. CFI też spadło, ale o połowę mniej (z .996 do .993). Wzrost TLI po dodaniu parametru oznacza, że parametr „zarobił” na swój stopień swobody. Nie znaczy to jeszcze, że model jest trafny. Formalne porównanie modeli zagnieżdżonych daje test różnicy chi-kwadrat.
TLI w małej i dużej próbie
Rysunek 1 pokazuje, jak zmienia się TLI poprawnego modelu trójczynnikowego w 300 losowych próbach.
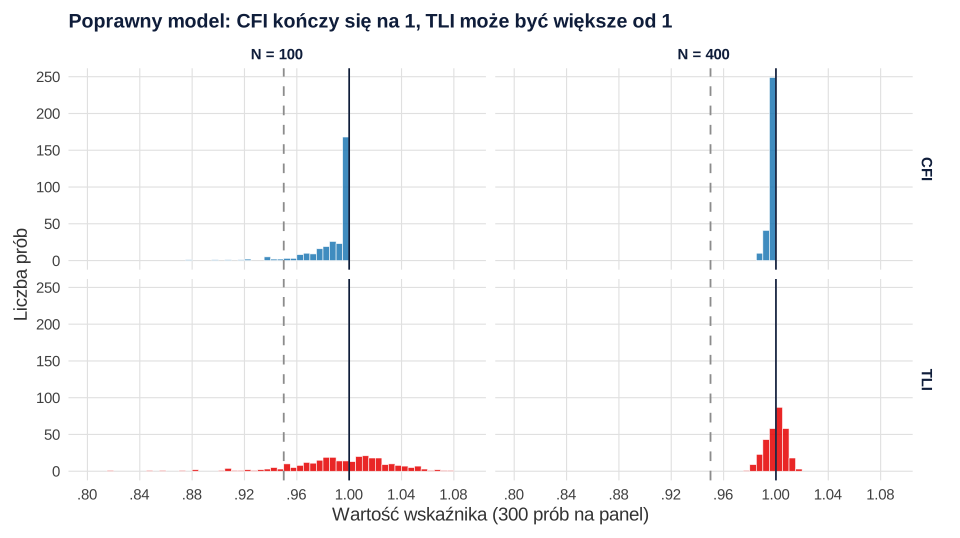
Przy N = 100 CFI w 48% prób wynosiło dokładnie 1, a TLI w tych samych 48% prób przekraczało 1 (maksimum 1.08). W 5% prób TLI było jednak niższe niż .927, choć model był poprawny. Przy N = 400 TLI mieściło się między .980 a 1.02. Wartości TLI powyżej 1 nie są więc błędem programu. To znak, że χ² wyszło mniejsze od liczby stopni swobody. Raportuj je bez obcinania, np. TLI = 1.01. Pojedyncza wartość TLI z małej próby jest mało precyzyjna.
Jak opisać TLI w pracy (APA)
Podaj TLI z dokładnością do trzech miejsc po przecinku, bez zera przed kropką, razem z χ², df, p, CFI, RMSEA z 90% CI i SRMR. Gdy porównujesz modele, pokaż je w jednej tabeli dopasowania. Przy estymatorze WLSMV lub MLR zaznacz, że to wersja skalowana albo odporna wskaźnika.
TLI w R (lavaan)
Kod tworzy dane z przykładu, dopasowuje model jedno- i trójczynnikowy, liczy TLI ze wzoru z χ² modelu bazowego i pokazuje karę za zbędne parametry. Rysunek 1 pochodzi z osobnej symulacji (ten sam model populacyjny, 300 prób dla każdej liczebności).
TLI z wyniku lavaan i ze wzoru
R
suppressPackageStartupMessages(library(lavaan))   # CFA, wskaźniki dopasowania

# Dane symulowane: 250 osób, 9 pozycji skali wsparcia społecznego (1–7)
# trzy źródła wsparcia: rodzina (r1–r3), przyjaciele (p1–p3), osoba bliska (o1–o3)
set.seed(139)
populacja <- '
  rodzina     =~ 0.80*r1 + 0.75*r2 + 0.70*r3
  przyjaciele =~ 0.80*p1 + 0.70*p2 + 0.75*p3
  bliska      =~ 0.75*o1 + 0.80*o2 + 0.65*o3
  rodzina ~~ 0.45*przyjaciele + 0.50*bliska
  przyjaciele ~~ 0.55*bliska
'
z <- simulateData(populacja, sample.nobs = 250, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(5 + 1.2 * x), 1), 7)))

m1 <- 'wsparcie =~ r1 + r2 + r3 + p1 + p2 + p3 + o1 + o2 + o3'
m3 <- 'rodzina =~ r1 + r2 + r3
       przyjaciele =~ p1 + p2 + p3
       bliska =~ o1 + o2 + o3'
fit1 <- cfa(m1, data = dane)
fit3 <- cfa(m3, data = dane)

# 1. Model bazowy (niezależności) i oba modele
miary <- c("baseline.chisq", "baseline.df", "chisq", "df", "pvalue", "tli", "cfi", "rmsea")
round(rbind(jeden_czynnik = fitMeasures(fit1, miary), trzy_czynniki = fitMeasures(fit3, miary)), 3)

# 2. TLI „ręcznie”: (χ²0/df0 − χ²M/dfM) / (χ²0/df0 − 1)
tli_recznie <- function(fit) {
  f <- fitMeasures(fit, c("baseline.chisq", "baseline.df", "chisq", "df"))
  q0 <- f[["baseline.chisq"]] / f[["baseline.df"]]; qm <- f[["chisq"]] / f[["df"]]
  c(chi2_df_bazowy = q0, chi2_df_model = qm, TLI = (q0 - qm) / (q0 - 1))
}
round(rbind(jeden_czynnik = tli_recznie(fit1), trzy_czynniki = tli_recznie(fit3)), 3)

# 3. Kara za złożoność: dodajemy do modelu trójczynnikowego trzy zbędne kowariancje reszt
m3_plus <- paste(m3, '\n r1 ~~ p1 \n r2 ~~ o2 \n p3 ~~ o3')
fit3p <- cfa(m3_plus, data = dane)
round(rbind(trzy_czynniki = fitMeasures(fit3, c("chisq", "df", "tli", "cfi")),
            plus_3_parametry = fitMeasures(fit3p, c("chisq", "df", "tli", "cfi"))), 3)
pe <- parameterEstimates(fit3p)
pe[pe$op == "~~" & pe$lhs %in% c("r1", "r2", "p3") & pe$lhs != pe$rhs, c("lhs", "op", "rhs", "est", "pvalue")]
Wynik w R
              baseline.chisq baseline.df   chisq df pvalue   tli   cfi rmsea
jeden_czynnik        660.709          36 196.735 27  0.000 0.638 0.728 0.159
trzy_czynniki        660.709          36  26.501 24  0.328 0.994 0.996 0.020
              chi2_df_bazowy chi2_df_model   TLI
jeden_czynnik         18.353         7.286 0.638
trzy_czynniki         18.353         1.104 0.994
                  chisq df   tli   cfi
trzy_czynniki    26.501 24 0.994 0.996
plus_3_parametry 25.371 21 0.988 0.993
   lhs op rhs    est pvalue
10  r1 ~~  p1  0.036  0.499
11  r2 ~~  o2 -0.002  0.967
12  p3 ~~  o3  0.050  0.407
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Obcinanie TLI do 1.000 albo uznawanie wartości powyżej 1 za błąd. To prawidłowy wynik, gdy χ² < df.
- Porównywanie TLI między badaniami o różnej sile korelacji. Wskaźnik zależy od modelu bazowego, więc ta sama „jakość” modelu daje różne TLI przy słabo i silnie skorelowanych pozycjach.
- Traktowanie TLI i CFI jako dwóch niezależnych dowodów. Oba porównują model z tym samym modelem bazowym i zwykle idą w parze. Uzupełnij je o RMSEA i SRMR.
- Dokładanie parametrów, dopóki TLI nie przekroczy .95. Każda zmiana wymaga uzasadnienia treściowego, a w CFA łatwo w ten sposób dopasować model do przypadkowych cech próby.
- Stosowanie progów z ML do wyników WLSMV. Przy danych porządkowych skalowane TLI zachowuje się inaczej niż przy ML. Napisz w pracy, której wersji użyłeś.
- Mylenie TLI z PNFI czy PCFI. Wskaźniki „oszczędnościowe” mnożą NFI lub CFI przez stosunek df modelu do df bazowego i mają inne, znacznie niższe wartości typowe.
Kolejność oceny dopasowania i rolę TLI w porównaniu modeli pokazuje poradnik CB-SEM krok po kroku. Zmiany TLI i CFI w testowaniu inwariancji opisuje inwariancja pomiaru krok po kroku.
Najczęstsze pytania
Czy TLI może być większe od 1?
Tak. TLI przekracza 1, gdy statystyka χ² modelu jest mniejsza od liczby stopni swobody, co często zdarza się w małych próbach przy poprawnym modelu. To nie błąd programu – podaj wartość bez obcinania, np. TLI = 1.01, i pamiętaj, że jest ona mało precyzyjna.
Jaka wartość TLI jest dobra?
Najczęściej za dobre uznaje się TLI bliskie .95 lub wyższe, a za minimalnie akceptowalne – około .90. To reguły kciuka z badań symulacyjnych: ocenę opieraj na kilku wskaźnikach jednocześnie (χ², CFI, RMSEA, SRMR) i na przeglądzie reszt, a nie na jednym progu.
Czym TLI różni się od CFI?
Oba porównują model z modelem bazowym, ale TLI mierzy niedopasowanie stosunkiem χ²/df, a CFI różnicą χ² − df obciętą do zera. Dlatego TLI jest zwykle nieco niższe, silniej karze dodatkowe parametry i może wyjść poza przedział 0–1, a CFI – nie.
Dlaczego TLI spadło po dodaniu parametru do modelu?
Dodatkowy parametr zabiera jeden stopień swobody. Jeśli χ² spadnie przy tym mniej, niż wynosi „koszt” tego stopnia swobody, stosunek χ²/df rośnie, a TLI maleje. To sygnał, że parametr jest prawdopodobnie zbędny.
Czy NNFI to to samo co TLI?
Tak. Nienormowany wskaźnik dopasowania (NNFI) Bentlera i Boneta to ten sam współczynnik, który wcześniej zaproponowali Tucker i Lewis; programy podają go pod jedną z tych nazw. Nie myl go z normowanym NFI, który nie zawiera kary za złożoność.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bentler, P. M., & Bonett, D. G. (1980). Significance tests and goodness of fit in the analysis of covariance structures. Psychological Bulletin, 88(3), 588–606. https://doi.org/10.1037/0033-2909.88.3.588
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
- Shi, D., Lee, T., & Maydeu-Olivares, A. (2019). Understanding the model size effect on SEM fit indices. Educational and Psychological Measurement, 79(2), 310–334. https://doi.org/10.1177/0013164418783530 ● Otwarty dostęp
- Tucker, L. R., & Lewis, C. (1973). A reliability coefficient for maximum likelihood factor analysis. Psychometrika, 38(1), 1–10. https://doi.org/10.1007/bf02291170
Cytowania BibTeX
@article{bentler1980significance, author={Bentler, Peter M. and Bonett, Douglas G.}, title={{Significance tests and goodness of fit in the analysis of covariance structures}}, journal={Psychological Bulletin}, year={1980}, volume={88}, number={3}, pages={588--606}, doi={10.1037/0033-2909.88.3.588}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{marsh2004search, author={Marsh, Herbert W. and Hau, Kit-Tai and Wen, Zhonglin}, title={{In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2004}, volume={11}, number={3}, pages={320--341}, doi={10.1207/s15328007sem1103_2}}@article{shi2019understanding, author={Shi, Dexin and Lee, Taehun and Maydeu-Olivares, Alberto}, title={{Understanding the model size effect on SEM fit indices}}, journal={Educational and Psychological Measurement}, year={2019}, volume={79}, number={2}, pages={310--334}, doi={10.1177/0013164418783530}}@article{tucker1973reliability, author={Tucker, Ledyard R. and Lewis, Charles}, title={{A reliability coefficient for maximum likelihood factor analysis}}, journal={Psychometrika}, year={1973}, volume={38}, number={1}, pages={1--10}, doi={10.1007/bf02291170}}