Co to jest CMIN?
CMIN to nazwa, pod którą program AMOS podaje statystykę chi-kwadrat dopasowania modelu (ang. minimum discrepancy, minimalna rozbieżność). Ta sama wartość w lavaan, Mplus czy JASP nazywa się po prostu χ² (chisq). Mierzy, jak bardzo macierz kowariancji odtworzona przez model różni się od macierzy z próby. Pochodzi z testu ilorazu wiarygodności, który Jöreskog (1969) opisał dla konfirmacyjnej analizy czynnikowej estymowanej metodą największej wiarygodności.
W tabeli wyników AMOS obok CMIN stoją trzy kolumny: DF (stopnie swobody), P (wartość p testu) i CMIN/DF (iloraz chi-kwadrat do stopni swobody). Program pokazuje je dla modelu badanego (Default model), nasyconego (Saturated, CMIN = 0) i niezależności (Independence), który jest punktem odniesienia dla indeksów takich jak CFI i NFI.
Z CMIN wywodzi się większość pozostałych miar dopasowania. RMSEA przelicza go na niedopasowanie na jeden stopień swobody, CFI i NFI porównują go z CMIN modelu niezależności, a AIC w wersji AMOS to CMIN plus kara za liczbę parametrów (zob. AIC i BIC w SEM). Dobrze rozumiany CMIN ułatwia więc czytanie całego wydruku.
Jak powstaje CMIN
Estymacja szuka parametrów, przy których funkcja rozbieżności między macierzą z próby a macierzą modelu jest najmniejsza. Jej minimum to FMIN, a CMIN to FMIN przemnożone przez liczebność:
Jeśli model jest poprawny, a założenia spełnione (wielowymiarowa normalność, duża próba), CMIN ma rozkład chi-kwadrat z df = liczba wariancji i kowariancji − liczba parametrów. Hipoteza zerowa testu brzmi: model odtwarza populacyjną macierz kowariancji dokładnie. Dlatego interpretacja jest odwrócona względem większości testów: p > .05 to wynik pożądany, a p < .05 oznacza odrzucenie modelu.
CMIN/DF to próba uniezależnienia oceny od liczby stopni swobody. W praktyce spotyka się różne progi (2, 3, a nawet 5), ale nie mają one mocnego uzasadnienia. Iloraz rośnie z liczebnością próby z tego samego powodu co CMIN.
Przykład: CMIN dla skali lęku przed oceną
Pięćset osób (dane symulowane) wypełniło 7-pozycyjną skalę lęku przed oceną (odpowiedzi 1–5). W populacji pozycje lo6 i lo7 dzielą niewielką dodatkową wariancję, której model jednoczynnikowy nie uwzględnia. Siedem pozycji daje 7 × 8/2 = 28 wariancji i kowariancji, a model ma 14 parametrów, więc df = 14.
| Wariant | CMIN (χ²) | DF | P | CMIN/DF |
|---|---|---|---|---|
| lavaan, mnożnik N | 28.48 | 14 | .012 | 2.03 |
| konwencja AMOS, mnożnik N − 1 | 28.42 | 14 | .012 | 2.03 |
| Satorra–Bentler (MLM) | 27.82 | 14 | .015 | – |
Test odrzuca model dokładnie pasujący: χ²(14) = 28.48, p = .012. Indeksy przybliżonego dopasowania są przy tym bardzo dobre: RMSEA = .045, CFI = .987, SRMR = .025. Różnica między konwencjami N i N − 1 przy 500 osobach jest pomijalna (28.48 wobec 28.42). Korekta Satorry–Bentlera dla danych nienormalnych prawie nic nie zmienia, bo współczynnik skalowania wynosi 1.02.
Źródło niedopasowania pokazuje indeks modyfikacji: największy (MI = 7.97) dotyczy kowariancji błędów lo6–lo7, których reszta korelacyjna wynosi .07. Obie pozycje dotyczą sytuacji towarzyskich. Po dodaniu tej kowariancji χ²(13) = 20.66, p = .080. Takiej zmiany dokonaj tylko wtedy, gdy masz uzasadnienie treściowe – inaczej istotny CMIN po prostu odnotuj i omów.
Dlaczego CMIN prawie zawsze odrzuca model w dużych próbach
Żaden model nie jest dokładnie prawdziwy, więc w populacji zawsze istnieje jakaś rozbieżność. CMIN przemnaża ją przez N i rośnie wraz z liczebnością próby, a stopnie swobody pozostają bez zmian. Bentler i Bonett (1980) zwracali uwagę, że w dużych próbach test odrzuca praktycznie każdy model, a w małych wiele konkurencyjnych modeli wydaje się akceptowalnych. Dlatego zaproponowali indeksy porównujące model z modelem niezależności. Rysunek 1 pokazuje to dla df = 14 jak w przykładzie.
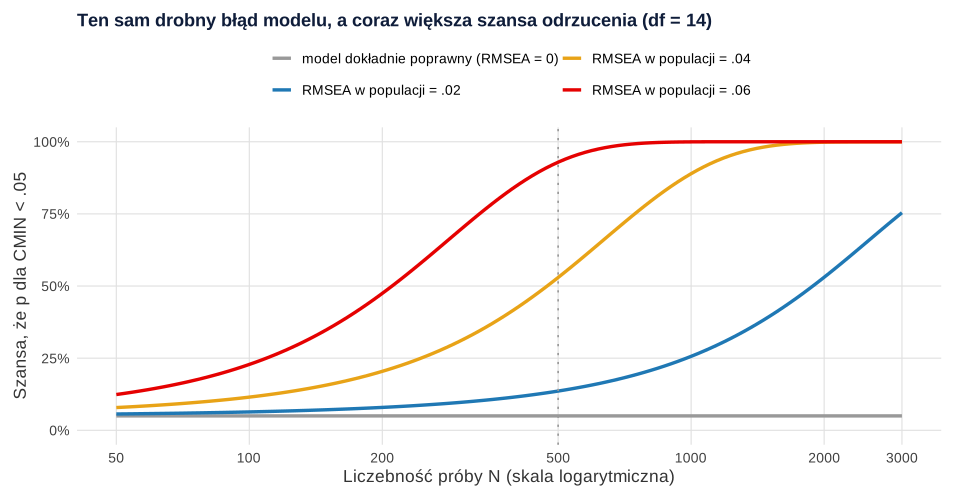
Model o niewielkim niedopasowaniu (RMSEA = .04, czyli według typowych reguł dobrym) zostanie odrzucony w 20.4% badań z udziałem 200 osób, w 53.0% przy 500 osobach i w 88.9% przy 1000 osobach. Przy RMSEA = .02 szansa odrzucenia rośnie z 7.9% przy 200 osobach do 53.0% przy 2000. Fornell i Larcker (1981) dodają drugą wadę: test może wskazywać lepsze dopasowanie, gdy jakość pomiaru i związki między konstruktami słabną, bo słabe korelacje łatwo „odtworzyć”.
Nie oznacza to, że CMIN można pomijać. To jedyna miara z formalnym testem, istotny wynik jest sygnałem do sprawdzenia reszt, a różnica CMIN dwóch modeli zagnieżdżonych to test różnicy chi-kwadrat. Przy danych nienormalnych różnicy dwóch skalowanych statystyk nie wolno jednak po prostu odjąć. Satorra i Bentler (2001) podali sposób obliczenia poprawnej skalowanej statystyki różnicy.
Co jeszcze wpływa na CMIN
Poza błędem modelu i liczebnością próby wartość CMIN zależy od kilku cech danych i analizy:
- Rozkład zmiennych. Test zakłada wielowymiarową normalność. Przy dużej kurtozie i skośności zwykły χ² jest zawyżony, dlatego stosuje się korektę Satorry–Bentlera (MLM, MLR) albo bootstrap Bollena–Stine’a.
- Estymator. CMIN z metody największej wiarygodności nie jest porównywalny ze statystyką z GLS, ULS czy WLSMV, bo każda metoda minimalizuje inną funkcję rozbieżności.
- Wielkość modelu. Przy wielu zmiennych i małej próbie statystyka bywa zawyżona nawet dla modelu poprawnego.
- Braki danych. Przy estymacji FIML statystyka porównuje model z modelem nasyconym oszacowanym z niepełnych danych. Liczba osób w obliczeniach jest wtedy inna niż liczba kompletnych wierszy (zob. braki danych).
Jak opisać CMIN w pracy (APA)
Raportuj χ² ze stopniami swobody i dokładnym p zawsze, także gdy wynik jest niekorzystny, a obok indeksy przybliżonego dopasowania. Nazwę „CMIN” możesz pominąć – w tekście wystarczy symbol χ². Przy estymatorze odpornym napisz, którą korektę zastosowano.
CMIN w R (lavaan)
Kod tworzy dane z przykładu i liczy statystykę chi-kwadrat w konwencji lavaan (N) i AMOS (N − 1, likelihood = "wishart"), CMIN/DF, wersję Satorry–Bentlera, reszty i indeksy modyfikacji, model z kowariancją błędów oraz prawdopodobieństwo odrzucenia modelu przy różnych N (rozkład chi-kwadrat niecentralny). Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
CMIN, CMIN/DF i wpływ liczebności próby
R
suppressPackageStartupMessages(library(lavaan))

# Dane symulowane: 500 osób wypełniło 7-pozycyjną skalę lęku przed oceną (odpowiedzi 1–5).
# W populacji pozycja lo7 ma niewielki ładunek krzyżowy od czynnika pomocniczego (np. wstydliwości),
# którego model jednoczynnikowy nie uwzględnia – błąd specyfikacji jest mały.
set.seed(104)
pop <- '
  lek  =~ 0.75*lo1 + 0.72*lo2 + 0.70*lo3 + 0.68*lo4 + 0.66*lo5 + 0.62*lo6 + 0.60*lo7
  wstyd =~ 0.35*lo6 + 0.35*lo7
  lek ~~ 0*wstyd
'
z <- simulateData(pop, sample.nobs = 500, standardized = TRUE, skewness = 0.8, kurtosis = 1)
prog <- c(-Inf, -1.3, -0.45, 0.4, 1.25, Inf)
dane <- as.data.frame(lapply(z, function(x) as.numeric(cut(x, prog, labels = FALSE))))
model <- 'lek =~ lo1 + lo2 + lo3 + lo4 + lo5 + lo6 + lo7'

# 1. CMIN w lavaan (domyślnie mnożnik N) i w konwencji AMOS/LISREL (mnożnik N − 1, likelihood = "wishart")
fit_n <- cfa(model, data = dane)
fit_w <- cfa(model, data = dane, likelihood = "wishart")
cmin <- rbind(lavaan_N = fitMeasures(fit_n, c("chisq", "df", "pvalue")),
              wishart_N1 = fitMeasures(fit_w, c("chisq", "df", "pvalue")))
cbind(round(cmin, 3), CMIN_DF = round(cmin[, "chisq"] / cmin[, "df"], 3))
c(p = 7 * 8 / 2, parametry = lavInspect(fit_n, "npar"))     # 28 momentów − 14 parametrów = 14 df
round(fitMeasures(fit_n, c("rmsea", "cfi", "srmr")), 3)

# 2. Wersja skorygowana na nienormalność (Satorra–Bentler, estymator MLM)
fit_sb <- cfa(model, data = dane, estimator = "MLM")
round(fitMeasures(fit_sb, c("chisq", "chisq.scaled", "chisq.scaling.factor", "df", "pvalue.scaled")), 3)

# 3. Gdzie jest niedopasowanie? Reszty korelacyjne i indeks modyfikacji
res <- residuals(fit_n, type = "cor")$cov
round(res["lo7", "lo6"], 3)
head(modindices(fit_n, sort. = TRUE)[, c("lhs", "op", "rhs", "mi", "sepc.all")], 3)

# 4. Model z kowariancją reszt lo6–lo7 (obie pozycje dotyczą sytuacji towarzyskich)
fit_b <- cfa(paste(model, "lo6 ~~ lo7", sep = "\n"), data = dane)
round(fitMeasures(fit_b, c("chisq", "df", "pvalue", "rmsea", "cfi")), 3)

# 5. Prawdopodobieństwo odrzucenia modelu przez test CMIN (α = .05, df = 14) przy populacyjnym RMSEA
#    .02, .04 i .06: parametr niecentralności = (N − 1) × df × RMSEA²
moc <- function(N, rmsea, df = 14) 1 - pchisq(qchisq(0.95, df), df, ncp = (N - 1) * df * rmsea^2)
tab_moc <- outer(c(100, 200, 500, 1000, 2000), c(0.02, 0.04, 0.06), Vectorize(moc))
dimnames(tab_moc) <- list(N = c(100, 200, 500, 1000, 2000), RMSEA = c(".02", ".04", ".06"))
round(tab_moc, 3)
Wynik w R
            chisq df pvalue CMIN_DF
lavaan_N   28.480 14  0.012   2.034
wishart_N1 28.423 14  0.012   2.030
        p parametry
       28        14
rmsea   cfi  srmr
0.045 0.987 0.025
               chisq         chisq.scaled chisq.scaling.factor
              28.480               27.818                1.024
                  df        pvalue.scaled
              14.000                0.015
[1] 0.07
   lhs op rhs    mi sepc.all
36 lo6 ~~ lo7 7.974    0.145
24 lo2 ~~ lo5 4.917   -0.125
19 lo1 ~~ lo5 4.705    0.125
 chisq     df pvalue  rmsea    cfi
20.663 13.000  0.080  0.034  0.993
      RMSEA
N        .02   .04   .06
  100  0.064 0.115 0.228
  200  0.079 0.204 0.475
  500  0.136 0.530 0.929
  1000 0.256 0.889 1.000
  2000 0.530 0.998 1.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Odwrócona interpretacja p. Istotny CMIN oznacza niedopasowanie, a nie „istotny model”.
- Pomijanie χ² w raporcie, gdy jest niekorzystny. Raportuj go zawsze, z df i p.
- CMIN/DF jako główne kryterium z dowolnie wybranym progiem (2, 3 lub 5) bez źródła.
- Odejmowanie skalowanych χ² (MLM, MLR) przy porównaniu modeli zamiast skalowanej różnicy.
- Uznanie nieistotnego CMIN w małej próbie za dowód poprawności modelu. Przy 100 osobach test ma małą moc i nie wykrywa nawet wyraźnych błędów.
Na tle innych indeksów CMIN omawia poradnik CB-SEM krok po kroku; ten sam przebieg w R pokazuje wpis CB-SEM w R: kompletny przykład w lavaan. Indeks oparty na tej samej niecentralności, ale znacznie słabiej zależny od N, to RMSEA.
Najczęstsze pytania
Co oznacza istotny CMIN w AMOS?
Istotny CMIN (P < .05) oznacza, że macierz odtworzona przez model różni się od macierzy z próby bardziej, niż wynikałoby z przypadku – model nie pasuje dokładnie. W dużych próbach zdarza się to nawet przy drobnych rozbieżnościach, dlatego sprawdź indeksy przybliżonego dopasowania i reszty.
Jaka wartość CMIN/DF jest dobra?
W literaturze krążą progi 2, 3, a nawet 5, ale żaden nie ma mocnego uzasadnienia, a iloraz rośnie z liczebnością próby tak samo jak CMIN. Podawaj go najwyżej jako informację pomocniczą, obok χ² z df i p oraz RMSEA, CFI i SRMR.
Czy CMIN z AMOS i chi-kwadrat z lavaan to to samo?
Tak, to ta sama statystyka; różni się tylko mnożnik: AMOS (i LISREL) używa N − 1, a lavaan domyślnie N. Przy kilkuset osobach różnica jest pomijalna (w przykładzie 28.42 wobec 28.48), a w lavaan konwencję AMOS włącza opcja likelihood = "wishart".
Co zrobić, gdy CMIN odrzuca model, a CFI i RMSEA są dobre?
Raportuj wszystkie wartości i sprawdź, skąd bierze się rozbieżność: reszty korelacyjne i indeksy modyfikacji. Jeśli niedopasowanie jest drobne i rozproszone, opisz je jako ograniczenie; jeśli dotyczy jednej pary pozycji z oczywistym uzasadnieniem, rozważ jedną modyfikację i ją opisz.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM)
Model pomiarowy i strukturalny, rodzaje modeli SEM, CB-SEM czy PLS-SEM, symulacja w R i etapy analizy od teorii do raportu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bentler, P. M., & Bonett, D. G. (1980). Significance tests and goodness of fit in the analysis of covariance structures. Psychological Bulletin, 88(3), 588–606. https://doi.org/10.1037/0033-2909.88.3.588
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Jöreskog, K. G. (1969). A general approach to confirmatory maximum likelihood factor analysis. Psychometrika, 34(2), 183–202. https://doi.org/10.1007/bf02289343
- Satorra, A., & Bentler, P. M. (2001). A scaled difference chi-square test statistic for moment structure analysis. Psychometrika, 66(4), 507–514. https://doi.org/10.1007/bf02296192
Cytowania BibTeX
@article{bentler1980significance, author={Bentler, P. M. and Bonett, Douglas G.}, title={{Significance tests and goodness of fit in the analysis of covariance structures}}, journal={Psychological Bulletin}, year={1980}, volume={88}, number={3}, pages={588--606}, doi={10.1037/0033-2909.88.3.588}}@article{fornell1981evaluating, author={Fornell, Claes and Larcker, David F.}, title={{Evaluating structural equation models with unobservable variables and measurement error}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={1}, pages={39--50}, doi={10.1177/002224378101800104}}@article{joreskog1969general, author={Jöreskog, K. G.}, title={{A general approach to confirmatory maximum likelihood factor analysis}}, journal={Psychometrika}, year={1969}, volume={34}, number={2}, pages={183--202}, doi={10.1007/bf02289343}}@article{satorra2001scaled, author={Satorra, Albert and Bentler, Peter M.}, title={{A scaled difference chi-square test statistic for moment structure analysis}}, journal={Psychometrika}, year={2001}, volume={66}, number={4}, pages={507--514}, doi={10.1007/bf02296192}}