Co to są braki danych MCAR, MAR i MNAR?
MCAR, MAR i MNAR to trzy mechanizmy braków danych (ang. missing data mechanisms), czyli trzy odpowiedzi na pytanie, dlaczego w zbiorze brakuje części wartości. Klasyfikację wprowadził Rubin (1976). Opisuje ona związek między tym, czy wartość jest brakująca, a wartościami zmiennych – zarówno tymi, które zaobserwowaliśmy, jak i tymi, których nie znamy.
W badaniach psychologicznych braki pojawiają się niemal zawsze: respondenci pomijają pytania, przerywają ankietę albo nie przychodzą na drugi pomiar w badaniu podłużnym. Braki mogą obciążać oszacowania, obniżać moc testów i zawyżać błędy standardowe (Dong i Peng, 2013). To, czy tak się stanie, zależy właśnie od mechanizmu braków – dlatego rozpoznanie go jest pierwszym krokiem analizy. Pełny poradnik z diagnozą i imputacją w R znajdziesz we wpisie braki danych i imputacja wielokrotna w R.
Trzy mechanizmy – definicje i przykłady
Oznaczmy przez R wskaźnik braku (czy wartość jest brakująca), przez Yobs wartości zaobserwowane, a przez Ymis – brakujące. Mechanizmy różnią się tym, od czego zależy prawdopodobieństwo braku:
- MCAR – braki całkowicie losowe (missing completely at random). Brak nie zależy od żadnej zmiennej w badaniu. Przykład: przy przepisywaniu danych z papierowych arkuszy zaginęła losowa paczka ankiet ze skalą depresji.
- MAR – braki losowe pod warunkiem zmiennych obserwowanych (missing at random). Brak zależy od zmiennych, które znamy, ale nie od samej brakującej wartości. Przykład: osoby o wyższym lęku częściej przerywają ankietę przed skalą depresji, a lęk zmierzono wcześniej u wszystkich.
- MNAR – braki nielosowe (missing not at random). Brak zależy od nieznanej wartości – nawet po uwzględnieniu zmiennych obserwowanych. Przykład: pytania o objawy depresji pomijają właśnie osoby z najsilniejszymi objawami.
Nazwa „MAR” bywa myląca. Braki MAR nie są losowe w potocznym sensie, bo zależą od innych zmiennych – stają się losowe dopiero po uwzględnieniu tych zmiennych. Rubin (1976) wykazał, że przy MAR proces powodujący braki można pominąć we wnioskowaniu, a we wnioskowaniu opartym na wiarygodności lub bayesowskim – gdy dodatkowo parametry mechanizmu braków są odrębne od parametrów modelu. Dlatego MAR jest założeniem nowoczesnych metod: estymacji metodą największej wiarygodności z pełną informacją (FIML) i imputacji wielokrotnej, które rekomendują Schafer i Graham (2002).
MCAR, MAR i MNAR – porównanie
| Mechanizm | Co oznacza | Jak sprawdzić | Co robić |
|---|---|---|---|
| MCAR | Brak nie zależy od niczego, co mierzy badanie | Test Little’a (nieistotny wynik nie dowodzi MCAR); brak różnic między osobami z brakami i bez nich | Usuwanie przypadków nie obciąża wyników, ale obniża moc; imputacja wielokrotna lub FIML odzyskują informację |
| MAR | Brak zależy od zmiennych obserwowanych | Porównaj osoby z brakami i bez w zmiennych obserwowanych (test t, regresja logistyczna wskaźnika braku); samego MAR nie da się potwierdzić | Imputacja wielokrotna lub FIML z modelem, który zawiera zmienne związane z brakami |
| MNAR | Brak zależy od samej brakującej wartości | Nie da się tego sprawdzić na podstawie danych | Zmienne pomocnicze i analiza wrażliwości: jak zmieniają się wnioski przy różnych założeniach o brakujących wartościach |
Przykład: ten sam zbiór, trzy mechanizmy
Wylosowaliśmy wyniki lęku (0–60) i objawów depresji (BDI-II, 0–63) dla 200 studentów (dane symulowane; korelacja obu skal r = .53). Średnia depresji w całej próbie wynosi 14.13. Następnie usunęliśmy około jednej czwartej wyników depresji na trzy sposoby: losowo (MCAR – 27% braków), tym częściej, im wyższy lęk (MAR – 26%), i tym częściej, im wyższa depresja (MNAR – 29%).
Średnia z wyników, które zostały, wynosi odpowiednio 14.53, 13.72 i 12.12. Przy MCAR różnica względem 14.13 to losowa fluktuacja. Przy MAR i MNAR średnia z obserwowanych wyników jest zaniżona, bo brakuje głównie wysokich wyników – najbardziej przy MNAR. W prawdziwym badaniu nie znamy jednak średniej wszystkich osób. Co da się zobaczyć w danych? Rysunek 1 porównuje lęk, zmierzony u wszystkich, u osób z wynikiem depresji i bez niego.
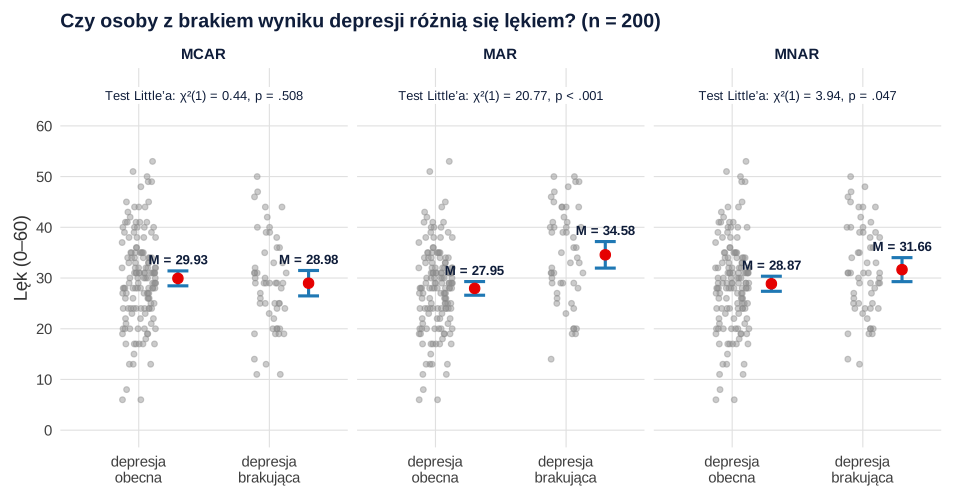
Przy MCAR obie grupy mają podobny lęk (M = 29.93 i 28.98). Przy MAR osoby bez wyniku depresji mają wyraźnie wyższy lęk (M = 34.58 wobec 27.95; test Welcha t(80.45) = −4.50, p < .001). Przy MNAR różnica też istnieje (31.66 wobec 28.87), ale jest mniejsza – lęk tylko częściowo zdradza mechanizm, który zależy od samej depresji. Z danych nie odróżnisz MAR od MNAR: oba mechanizmy mogą dawać podobny obraz, a do ich rozróżnienia potrzebne byłyby właśnie brakujące wartości.
Test MCAR Little’a
Little (1988) zaproponował jeden globalny test hipotezy zerowej, że braki są MCAR. Zamiast wielu skorelowanych porównań średnich między grupami z brakami i bez braków test wykorzystuje naraz wszystkie dostępne dane, a jego statystyka ma przy hipotezie zerowej rozkład χ². W R wykonasz go funkcją mcar_test() z pakietu naniar. Wyniki dla naszych trzech zbiorów:
| Mechanizm | χ² | df | p | Decyzja |
|---|---|---|---|---|
| MCAR | 0.44 | 1 | .508 | Brak podstaw do odrzucenia MCAR |
| MAR | 20.77 | 1 | < .001 | Odrzucamy MCAR |
| MNAR | 3.94 | 1 | .047 | Odrzucamy MCAR (wynik na granicy istotności) |
Odczytuj ten test ostrożnie. Istotny wynik oznacza, że braki nie są MCAR, ale nie mówi, czy są MAR, czy MNAR. Nieistotny wynik nie dowodzi MCAR (Jakobsen i in., 2017): test może mieć za małą moc, a przy MNAR wykrywa nielosowość tylko wtedy, gdy braki wiążą się ze zmiennymi obserwowanymi. W naszym przykładzie MNAR dał wynik ledwie istotny (p = .047), choć to właśnie tu obciążenie średniej depresji było największe.
Dlatego oprócz testu Little’a porównaj osoby z brakami i bez braków w ważnych zmiennych – testem t, wykresem pudełkowym albo regresją logistyczną wskaźnika braku. Takie porównania pokazują nie tylko to, czy braki są nielosowe, ale też od czego zależą – a to wskazuje zmienne, które trzeba włączyć do modelu imputacji.
Co robić z brakami przy każdym mechanizmie?
- Przy MCAR analiza przypadków kompletnych nie obciąża wyników, ale marnuje informację i obniża moc. Imputacja wielokrotna albo FIML pozwalają wykorzystać wszystkie dane.
- Przy MAR usuwanie przypadków zwykle daje obciążone wyniki. Użyj imputacji wielokrotnej albo FIML i uwzględnij w modelu zmienne, od których zależą braki (u nas lęk). Schafer i Graham (2002) odradzają – poza nielicznymi wyjątkami – metody doraźne, takie jak wpisywanie w miejsce braku średniej.
- Przy podejrzeniu MNAR żadna standardowa metoda nie gwarantuje trafnych wyników. Zbierz zmienne pomocnicze, które przybliżają mechanizm do MAR, i wykonaj analizę wrażliwości – sprawdź, jak zmieniają się wnioski, gdy założysz, że brakujące wartości są np. wyższe od przewidywanych.
Pamiętaj, że MAR to założenie, które uzasadnia analizę, a nie właściwość danych (Sterne i in., 2009). W pracy uzasadnij je merytorycznie: dlaczego sądzisz, że zmienne, którymi dysponujesz, wyjaśniają, kto ma braki? Braki tworzysz też sam, gdy usuwasz obserwacje odstające albo odpowiedzi osób wypełniających ankietę nieuważnie (nieuważne odpowiedzi w ankietach online) – takie braki rzadko są MCAR.
Jak opisać braki danych w pracy (APA)
W rozdziale metodologicznym (zob. jak napisać rozdział metodologiczny) podaj liczbę braków w każdej zmiennej, wynik diagnozy i przyjęte założenie. Przykład dla zbioru z mechanizmem MAR:
Test Little’a w R
Kod tworzy zbiór z przykładu (dane symulowane), usuwa wyniki depresji według trzech mechanizmów i dla każdego zbioru wykonuje test MCAR Little’a. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Trzy mechanizmy braków i test MCAR Little’a
R
library(naniar)

# Dane symulowane: lęk (0–60) i objawy depresji (BDI-II, 0–63) u 200 studentów
set.seed(49)
n <- 200
lek <- rnorm(n, mean = 30, sd = 9)
depresja <- 14 + 0.55 * (lek - 30) + rnorm(n, sd = 7.5)
pelne <- data.frame(lek = round(pmin(pmax(lek, 0), 60)), depresja = round(pmin(pmax(depresja, 0), 63)))

# Ten sam zbiór, około 25% braków w depresji – trzy mechanizmy
u <- runif(n)
z_lek <- as.numeric(scale(pelne$lek)); z_dep <- as.numeric(scale(pelne$depresja))
zbiory <- list(
  MCAR = within(pelne, depresja[u < .25] <- NA),                             # zupełnie losowo
  MAR  = within(pelne, depresja[u < plogis(-1.3 + 1.2 * z_lek)] <- NA),      # zależy od lęku (obserwowany)
  MNAR = within(pelne, depresja[u < plogis(-1.3 + 1.2 * z_dep)] <- NA))      # zależy od samej depresji

sapply(zbiory, function(d) round(100 * mean(is.na(d$depresja)), 1))   # % braków
round(c(wszyscy = mean(pelne$depresja),                                  # średnia znana tylko w symulacji
        sapply(zbiory, function(d) mean(d$depresja, na.rm = TRUE))), 2)  # średnia z obserwowanych

# Test MCAR Little'a dla każdego mechanizmu
lapply(zbiory, mcar_test)

# Czy osoby bez wyniku depresji różnią się lękiem? (przykład: MAR)
t.test(lek ~ is.na(depresja), data = zbiory$MAR)
Wynik w R
MCAR  MAR MNAR
  27   26   29
wszyscy    MCAR     MAR    MNAR
  14.13   14.53   13.72   12.12
$MCAR
# A tibble: 1 × 4
  statistic    df p.value missing.patterns
      <dbl> <dbl>   <dbl>            <int>
1     0.438     1   0.508                2

$MAR
# A tibble: 1 × 4
  statistic    df    p.value missing.patterns
      <dbl> <dbl>      <dbl>            <int>
1      20.8     1 0.00000517                2

$MNAR
# A tibble: 1 × 4
  statistic    df p.value missing.patterns
      <dbl> <dbl>   <dbl>            <int>
1      3.94     1  0.0471                2


	Welch Two Sample t-test

data:  lek by is.na(depresja)
t = -4.5047, df = 80.446, p-value = 2.226e-05
alternative hypothesis: true difference in means between group FALSE and group TRUE is not equal to 0
95 percent confidence interval:
 -9.550414 -3.698027
sample estimates:
mean in group FALSE  mean in group TRUE
           27.95270            34.57692
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- naniar (wersja 1.1.0): Tierney, N., & Cook, D. (2023). Expanding tidy data principles to facilitate missing data exploration, visualization and assessment of imputations. Journal of Statistical Software, 105(7), 1–31. https://doi.org/10.18637/jss.v105.i07
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Utożsamianie MAR z brakami „losowymi” w potocznym sensie – MAR oznacza, że braki zależą od zmiennych obserwowanych, a więc nie są przypadkowe.
- Nieistotny test Little’a jako dowód MCAR – test może co najwyżej MCAR odrzucić (Jakobsen i in., 2017).
- „Test Little’a potwierdził MAR” – test sprawdza wyłącznie hipotezę MCAR; MAR i MNAR są dla niego nieodróżnialne.
- Ocena samego odsetka braków – o skutkach decyduje mechanizm, a nie tylko procent pustych pól.
- Brak opisu braków w pracy – podaj liczbę braków w każdej zmiennej i wyjaśnij, co z nimi zrobiono (Sterne i in., 2009).
Najczęstsze pytania
Co to jest MCAR?
MCAR (missing completely at random) oznacza braki całkowicie losowe: szansa braku nie zależy od żadnej zmiennej w badaniu, ani obserwowanej, ani brakującej. Przykład: zaginęła losowa paczka ankiet. Przy MCAR usuwanie osób z brakami nie obciąża wyników, ale zmniejsza moc.
Czym różni się MAR od MNAR?
Przy MAR szansa braku zależy od zmiennych, które zmierzyłeś (np. osoby z wyższym lękiem częściej pomijają skalę depresji). Przy MNAR zależy od samej brakującej wartości (pomijają ją osoby z najsilniejszą depresją). MAR da się uwzględnić imputacją wielokrotną lub FIML, MNAR wymaga analiz wrażliwości. Na podstawie danych nie da się tych mechanizmów odróżnić.
Jak sprawdzić, czy braki danych są MCAR?
Wykonaj test MCAR Little’a (w R: naniar::mcar_test()) i porównaj osoby z brakami i bez braków w zmiennych obserwowanych. Istotny wynik testu, np. χ²(1) = 20.77, p < .001, oznacza, że braki nie są MCAR. Wynik nieistotny nie dowodzi jednak MCAR.
Czy przy brakach MAR można usunąć osoby z brakami?
Zwykle nie, bo usuwanie przypadków przy MAR daje obciążone wyniki. W przykładzie średnia depresji z obserwowanych wyników spadła z 14.13 do 13.72. Lepiej użyć imputacji wielokrotnej lub estymacji FIML z modelem zawierającym zmienne, od których zależą braki.
Czy test Little’a może potwierdzić MAR?
Nie. Test Little’a sprawdza tylko hipotezę MCAR. Istotny wynik mówi, że braki nie są całkowicie losowe, ale nie rozstrzyga, czy są MAR, czy MNAR. Założenie MAR trzeba uzasadnić merytorycznie i uzupełnić analizą wrażliwości.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Braki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dong, Y., & Peng, C.-Y. J. (2013). Principled missing data methods for researchers. SpringerPlus, 2(1), Article 222. https://doi.org/10.1186/2193-1801-2-222 ● Otwarty dostęp
- Jakobsen, J. C., Gluud, C., Wetterslev, J., & Winkel, P. (2017). When and how should multiple imputation be used for handling missing data in randomised clinical trials – A practical guide with flowcharts. BMC Medical Research Methodology, 17(1), Article 162. https://doi.org/10.1186/s12874-017-0442-1 ● Otwarty dostęp
- Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Sterne, J. A. C., White, I. R., Carlin, J. B., Spratt, M., Royston, P., Kenward, M. G., Wood, A. M., & Carpenter, J. R. (2009). Multiple imputation for missing data in epidemiological and clinical research: Potential and pitfalls. BMJ, 338, Article b2393. https://doi.org/10.1136/bmj.b2393 ● Otwarty dostęp
Cytowania BibTeX
@article{dong2013principled, author={Dong, Yiran and Peng, Chao-Ying Joanne}, title={{Principled missing data methods for researchers}}, journal={SpringerPlus}, year={2013}, volume={2}, number={1}, eid={222}, doi={10.1186/2193-1801-2-222}}@article{jakobsen2017when, author={Jakobsen, Janus Christian and Gluud, Christian and Wetterslev, Jørn and Winkel, Per}, title={{When and how should multiple imputation be used for handling missing data in randomised clinical trials – A practical guide with flowcharts}}, journal={BMC Medical Research Methodology}, year={2017}, volume={17}, number={1}, eid={162}, doi={10.1186/s12874-017-0442-1}}@article{little1988test, author={Little, Roderick J. A.}, title={{A test of missing completely at random for multivariate data with missing values}}, journal={Journal of the American Statistical Association}, year={1988}, volume={83}, number={404}, pages={1198--1202}, doi={10.1080/01621459.1988.10478722}}@article{rubin1976inference, author={Rubin, Donald B.}, title={{Inference and missing data}}, journal={Biometrika}, year={1976}, volume={63}, number={3}, pages={581--592}, doi={10.1093/biomet/63.3.581}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{sterne2009multiple, author={Sterne, Jonathan A. C. and White, Ian R. and Carlin, John B. and Spratt, Michael and Royston, Patrick and Kenward, Michael G. and Wood, Angela M. and Carpenter, James R.}, title={{Multiple imputation for missing data in epidemiological and clinical research: Potential and pitfalls}}, journal={BMJ}, year={2009}, volume={338}, eid={b2393}, doi={10.1136/bmj.b2393}}