Co to jest usuwanie przypadków?
Usuwanie przypadków to najprostszy sposób postępowania z brakami danych. W wersji listwise (analiza pełnych przypadków, ang. listwise deletion) z analizy wypada każda osoba, której brakuje choćby jednej wartości z używanych zmiennych. W wersji pairwise (ang. pairwise deletion) każdą korelację lub kowariancję liczy się na osobach, które mają obie wartości danej pary.
Listwise – prosto, ale kosztownie
Wszystkie wyniki opierają się na tej samej próbie, co ułatwia raport. Straty szybko się jednak sumują: w przykładzie z R przy 15% braków w każdej z pięciu zmiennych z 300 osób zostaje 128. Spada moc testu, a gdy braki nie są MCAR (zob. MCAR, MAR i MNAR), oszacowania mogą być obciążone. Schafer i Graham (2002) podsumowują dowody przeciw starszym metodom i z nielicznymi wyjątkami odradzają ich stosowanie. Funkcja lm() w R i procedura regresji w SPSS domyślnie usuwają przypadki listwise.
Pairwise – więcej danych, inne problemy
Usuwanie parami wykorzystuje więcej obserwacji: w przykładzie pary mają od 200 do 229 osób. Każdy element macierzy korelacji pochodzi jednak z innej podpróby, więc macierz może nie być dodatnio określona, a liczba N do testów jest niejednoznaczna. Marsh (1998) pokazał w symulacji przy brakach MCAR, że oszacowania parametrów SEM z macierzy pairwise były nieobciążone, ale statystyka χ² i oparte na niej wskaźniki dopasowania były wyraźnie obciążone, a korekty N tylko częściowo to usuwały.
Na rysunku
Rysunek pokazuje koszt każdej z dwóch wersji. Panel A liczy wzorem, ile pełnych przypadków zostaje przy brakach MCAR niezależnych między zmiennymi. Panel B to symulacja: 10 zmiennych o korelacji .3, braki MCAR w każdej zmiennej i 1000 prób na każdy układ. Te parametry ustawiono ręcznie, a ziarno (55402) ustalono raz i nie zmieniano.
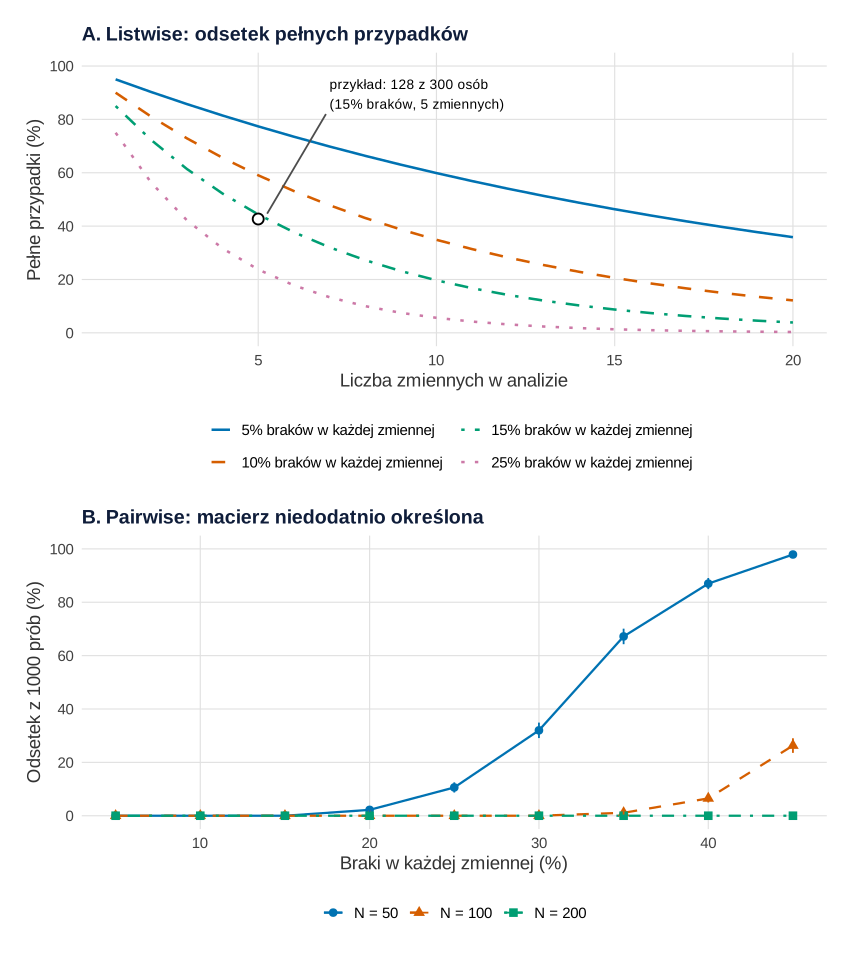
set.seed(55402)).Co widać. Przy 5 zmiennych i 15% braków w każdej pełne dane ma średnio 44.4% osób. W przykładzie z R zostało 128 z 300 osób, czyli 42.7%. Każda kolejna zmienna w modelu obcina próbę dalej. Panel B pokazuje cenę drugiej drogi. Przy N = 50 macierz pairwise była niedodatnio określona w 2.2% prób przy 20% braków, w 32.0% przy 30% i w 87.0% przy 40%. Przy N = 100 problem pojawił się dopiero od 35% braków (1.1%), a przy N = 200 nie wystąpił ani razu. Taka macierz nie może pochodzić z żadnego zbioru pełnych danych, więc analiza czynnikowa czy SEM może się na niej zatrzymać z błędem.
Na co uważać. Przy 10 zmiennych i 40% braków usuwanie listwise zostawia średnio 0.6% osób, więc w tym układzie żadna z dwóch metod nie działa. Krzywe w panelu A zakładają braki niezależne między zmiennymi. Gdy braki chodzą parami (np. porzucenie ankiety w połowie), pełnych przypadków jest więcej. Rysunek nie pokazuje obciążenia: dodatnio określona macierz z usuwania pairwise nadal ma niejasne N, a przy brakach MAR oba rodzaje usuwania mogą zniekształcić wynik. Wzorce braków przed wyborem metody warto obejrzeć, jak we wpisie Braki danych na wykresie.
Podpis do pracy:
Kod rysunku liczy też tabelę odsetków z błędem Monte Carlo (wykonanie trwa kilka sekund). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Listwise: ile osób zostaje; pairwise: jak często macierz korelacji nie jest dodatnio określona
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("#0072B2", "#D55E00", "#009E73", "#CC79A7")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# A. Listwise: przy brakach MCAR niezależnych między zmiennymi pełny przypadek ma szansę (1 − p)^k
lw <- expand.grid(k = 1:20, p = c(0.05, 0.10, 0.15, 0.25))
lw$pelne <- 100 * (1 - lw$p)^lw$k
lw$braki <- factor(paste0(100 * lw$p, "% braków w każdej zmiennej"), levels = paste0(c(5, 10, 15, 25), "% braków w każdej zmiennej"))
round(100 * (1 - c(0.05, 0.10, 0.15, 0.25))^5, 1)    # % pełnych przypadków przy 5 zmiennych
round(100 * 128 / 300, 1)                             # przykład z hasła: 128 z 300 osób przy 15% i 5 zmiennych
round(100 * (1 - 0.40)^10, 1)                         # % pełnych przypadków przy 10 zmiennych i 40% braków (panel B)

pA <- ggplot(lw, aes(k, pelne, colour = braki, linetype = braki)) +
  geom_line(linewidth = 0.9) +
  annotate("point", x = 5, y = 100 * 128 / 300, shape = 21, size = 3.2, fill = "white", colour = "black", stroke = 1) +
  annotate("segment", x = 6.9, y = 82, xend = 5.25, yend = 100 * 128 / 300 + 2, colour = "grey30") +
  annotate("text", x = 7, y = 84, label = "przykład: 128 z 300 osób\n(15% braków, 5 zmiennych)", hjust = 0, vjust = 0, size = 3.6) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "dashed", "dotdash", "dotted"), name = NULL) +
  scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 20)) +
  guides(colour = guide_legend(ncol = 2), linetype = guide_legend(ncol = 2)) +
  labs(title = "A. Listwise: odsetek pełnych przypadków", x = "Liczba zmiennych w analizie", y = "Pełne przypadki (%)") +
  motyw

# B. Pairwise: 10 zmiennych o korelacji .3, braki MCAR; czy najmniejsza wartość własna macierzy pairwise < 0?
k <- 10; rho <- 0.3; R <- 1000                         # parametry ustawione ręcznie
S <- matrix(rho, k, k); diag(S) <- 1; C <- chol(S)
niedodatnia <- function(n, p) {
  x <- matrix(rnorm(n * k), n) %*% C
  x[matrix(runif(n * k) < p, n)] <- NA
  r <- cor(x, use = "pairwise.complete.obs")
  min(eigen(r, symmetric = TRUE, only.values = TRUE)$values) < 0
}
set.seed(55402)                                        # ziarno ustalone raz
pw <- expand.grid(p = seq(0.05, 0.45, by = 0.05), n = c(50, 100, 200))
pw$proc <- mapply(function(n, p) 100 * mean(replicate(R, niedodatnia(n, p))), pw$n, pw$p)
pw$bladMC <- sqrt(pw$proc * (100 - pw$proc) / R)       # błąd Monte Carlo odsetka (pp)
pw$N <- factor(paste("N =", pw$n), levels = paste("N =", c(50, 100, 200)))
print(transform(pw[, c("n", "p", "proc", "bladMC")], bladMC = round(bladMC, 1)), row.names = FALSE)

pB <- ggplot(pw, aes(100 * p, proc, colour = N, shape = N, linetype = N)) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.6) +
  geom_errorbar(aes(ymin = pmax(proc - 1.96 * bladMC, 0), ymax = pmin(proc + 1.96 * bladMC, 100)), width = 0, linetype = 1) +
  scale_colour_manual(values = kol[c(1, 2, 3)], name = NULL) + scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 20)) +
  labs(title = "B. Pairwise: macierz niedodatnio określona", x = "Braki w każdej zmiennej (%)",
       y = "Odsetek z 1000 prób (%)") +
  motyw

p <- pA / pB
p
Wynik w R
[1] 77.4 59.0 44.4 23.7
[1] 42.7
[1] 0.6
   n    p proc bladMC
  50 0.05  0.0    0.0
  50 0.10  0.0    0.0
  50 0.15  0.0    0.0
  50 0.20  2.2    0.5
  50 0.25 10.6    1.0
  50 0.30 32.0    1.5
  50 0.35 67.2    1.5
  50 0.40 87.0    1.1
  50 0.45 97.9    0.5
 100 0.05  0.0    0.0
 100 0.10  0.0    0.0
 100 0.15  0.0    0.0
 100 0.20  0.0    0.0
 100 0.25  0.0    0.0
 100 0.30  0.0    0.0
 100 0.35  1.1    0.3
 100 0.40  6.5    0.8
 100 0.45 26.3    1.4
 200 0.05  0.0    0.0
 200 0.10  0.0    0.0
 200 0.15  0.0    0.0
 200 0.20  0.0    0.0
 200 0.25  0.0    0.0
 200 0.30  0.0    0.0
 200 0.35  0.0    0.0
 200 0.40  0.0    0.0
 200 0.45  0.0    0.0
Co zamiast
Enders i Bandalos (2001) porównali w modelach SEM estymację FIML, usuwanie listwise i pairwise oraz imputację podobnym wzorcem odpowiedzi. FIML wypadł najlepiej we wszystkich warunkach. Przy brakach MCAR i MAR dawał nieobciążone i bardziej efektywne oszacowania. Drugą zalecaną drogą jest imputacja wielokrotna, a do opisowych średnich i kowariancji wystarcza algorytm EM. Usuwanie listwise da się bronić przy bardzo małym odsetku braków i mechanizmie bliskim MCAR. Proste wstawianie wartości opisuje hasło LOCF i proste imputacje.
Jak opisać w pracy
Listwise i pairwise w R
Kod pokazuje, ile osób zostaje po usunięciu listwise, ile obserwacji mają pary przy usuwaniu pairwise (cor(use = …)) i jak zmienia się przykładowa korelacja.
Liczebności i korelacje
R
# Usuwanie przypadków: listwise a pairwise przy 15% braków MCAR w każdej z 5 zmiennych
set.seed(55401)
n <- 300
R <- matrix(0.4, 5, 5); diag(R) <- 1
dane <- as.data.frame(matrix(rnorm(n * 5), n) %*% chol(R))
names(dane) <- paste0("z", 1:5)
pelne <- dane
for (j in 1:5) dane[runif(n) < 0.15, j] <- NA
n_par <- crossprod(!is.na(dane))                       # liczba obserwacji dla każdej pary
r_lw <- cor(dane, use = "complete.obs")
r_pw <- cor(dane, use = "pairwise.complete.obs")
round(c(N_listwise = sum(complete.cases(dane)),
        n_pary_min = min(n_par[upper.tri(n_par)]),
        n_pary_max = max(n_par[upper.tri(n_par)]),
        r12_pelne = cor(pelne$z1, pelne$z2),
        r12_listwise = r_lw[1, 2], r12_pairwise = r_pw[1, 2]), 3)
# lm() domyślnie usuwa przypadki listwise (na.action = na.omit)
nobs(lm(z1 ~ z2 + z3 + z4 + z5, data = dane))
Wynik w R
  N_listwise   n_pary_min   n_pary_max    r12_pelne r12_listwise r12_pairwise
     128.000      200.000      229.000        0.398        0.464        0.383
[1] 128
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy usuwanie przypadków listwise jest dopuszczalne?
Gdy braków jest bardzo mało, a ich mechanizm jest bliski MCAR – wtedy strata mocy jest niewielka, a obciążenie mało prawdopodobne. Przy brakach zależnych od innych zmiennych lepsze są FIML lub imputacja wielokrotna.
Dlaczego macierz pairwise może być niedodatnio określona?
Każda korelacja pochodzi z innej podpróby, więc razem mogą tworzyć układ niemożliwy dla jednego zbioru danych. Taka macierz uniemożliwia lub psuje np. analizę czynnikową i SEM.
Jakie N podać przy korelacjach pairwise?
Podaj zakres liczebności par (np. 200–229) albo N przy każdej korelacji. Jedno N dla całej tabeli wprowadza czytelnika w błąd.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Braki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Enders, C. K., & Bandalos, D. L. (2001). The relative performance of full information maximum likelihood estimation for missing data in structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 430–457. https://doi.org/10.1207/s15328007sem0803_5
- Marsh, H. W. (1998). Pairwise deletion for missing data in structural equation models: Nonpositive definite matrices, parameter estimates, goodness of fit, and adjusted sample sizes. Structural Equation Modeling: A Multidisciplinary Journal, 5(1), 22–36. https://doi.org/10.1080/10705519809540087
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
Cytowania BibTeX
@article{enders2001relative, author={Enders, Craig K. and Bandalos, Deborah L.}, title={{The relative performance of full information maximum likelihood estimation for missing data in structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={430--457}, doi={10.1207/s15328007sem0803_5}}@article{marsh1998pairwise, author={Marsh, Herbert W.}, title={{Pairwise deletion for missing data in structural equation models: Nonpositive definite matrices, parameter estimates, goodness of fit, and adjusted sample sizes}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1998}, volume={5}, number={1}, pages={22--36}, doi={10.1080/10705519809540087}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}