Co to jest imputacja wielokrotna?
Imputacja wielokrotna (ang. multiple imputation, MI) to metoda postępowania z brakami danych, w której każdą brakującą wartość zastępuje się kilkoma (m) wiarygodnymi wartościami wylosowanymi z rozkładu przewidywanego przez model imputacji. Powstaje m kompletnych zbiorów danych. W każdym wykonuje się tę samą analizę, a wyniki łączy regułami Rubina. Klasyczną monografią metody jest książka Rubina (1987), który przedstawił ją jako sposób radzenia sobie z brakami odpowiedzi w badaniach sondażowych – razem z bayesowskimi podstawami i porównaniem z imputacją pojedynczą.
Kluczowa idea: wartość imputowana nie jest pomiarem, tylko odgadnięciem obarczonym niepewnością. Imputacja pojedyncza – np. wpisanie średniej albo wartości przewidzianej z regresji – traktuje odgadnięcie jak pewnik i zaniża błędy standardowe. Imputacja wielokrotna pokazuje tę niepewność wprost, jako różnice między wynikami z kolejnych zbiorów. Schafer i Graham (2002) rekomendują ją – obok estymacji metodą największej wiarygodności – jako jedno z dwóch nowoczesnych podejść do braków. Daje poprawne wyniki, gdy braki są MCAR lub MAR (zob. braki danych MCAR, MAR i MNAR), a model imputacji zawiera zmienne, od których braki zależą.
Trzy kroki imputacji wielokrotnej
- Imputacja. Program tworzy m kopii zbioru i w każdej losuje brakujące wartości z modelu imputacji, uwzględniając niepewność parametrów tego modelu. Do modelu włącz wszystkie zmienne z analizy – także zmienną zależną – oraz zmienne pomocnicze związane z brakami. Sterne i in. (2009) ostrzegają, że pominięcie wyniku w modelu imputacji fałszywie osłabia badane związki.
- Analiza. W każdym z m zbiorów wykonujesz dokładnie tę samą analizę (np. regresję) i zapisujesz oszacowanie oraz jego błąd standardowy.
- Łączenie. Oszacowania i błędy standardowe łączysz regułami Rubina w jeden wynik z jednym przedziałem ufności i jedną wartością p.
Nie uśredniaj danych z m zbiorów, by potem wykonać jedną analizę – to imputacja pojedyncza w przebraniu. Łączy się wyniki, nie dane.
Reguły Rubina – wzory
Niech Q̂i oznacza oszacowanie parametru (np. współczynnika regresji) w i-tym zbiorze, a Ui = SEi² – jego wariancję, czyli kwadrat błędu standardowego. Wtedy:
- Q̄ – połączone oszacowanie, czyli średnia z m oszacowań;
- W – wariancja wewnątrz imputacji: niepewność, jaką mielibyśmy, gdyby danych nie brakowało;
- B – wariancja między imputacjami: dodatkowa niepewność wynikająca z braków;
- T – wariancja całkowita; składnik 1/m uwzględnia to, że imputacji jest skończenie wiele.
Udział braków w wariancji całkowitej opisuje λ = (1 + 1/m) × B / T. Z tej wielkości wynikają stopnie swobody testu t; klasyczny wzór Rubina ma postać ν = (m − 1) / λ². W małych próbach daje on jednak zbyt wiele stopni swobody – czasem więcej niż przy pełnych danych – dlatego programy stosują zwykle poprawkę Barnarda–Rubina. Pokrewną miarą jest frakcja brakującej informacji (FMI): część informacji o parametrze utracona z powodu braków.
Przykład liczbowy krok po kroku
120 studentów wypełniło skale optymizmu (LOT-R, 0–24), samooceny (RSES, 10–40) i zadowolenia z życia (SWLS, 5–35) (dane symulowane). Wyniku zadowolenia brakuje u 44 osób (36.7%), częściej u osób o niskiej samoocenie – braki są więc MAR. Pytanie badawcze: jak silnie optymizm przewiduje zadowolenie z życia? Model analizy to regresja zadowolenia na optymizm, a samoocena jest w modelu imputacji zmienną pomocniczą. Dla przejrzystości wzorów najpierw wykonaliśmy tylko 5 imputacji.
| Zbiór | Q̂i = b | SEi | Ui = SEi² |
|---|---|---|---|
| 1 | 1.009 | 0.099 | 0.00975 |
| 2 | 1.100 | 0.098 | 0.00958 |
| 3 | 0.998 | 0.105 | 0.01096 |
| 4 | 1.143 | 0.101 | 0.01015 |
| 5 | 1.061 | 0.096 | 0.00915 |
Teraz reguły Rubina:
- Q̄ = (1.009 + 1.100 + 0.998 + 1.143 + 1.061) / 5 = 1.062;
- W = średnia z Ui = 0.00992;
- B = wariancja pięciu oszacowań = 0.00368;
- T = 0.00992 + (1 + 1/5) × 0.00368 = 0.01434, więc SE = √0.01434 = 0.120;
- λ = 0.00442 / 0.01434 = .308 – prawie jedna trzecia niepewności wynika z braków;
- ν według klasycznego wzoru Rubina = 4 / .308² = 42.1, a z poprawką Barnarda–Rubina 27.6;
- wynik: b = 1.062, 95% CI [0.817, 1.308], t(27.6) = 8.87, p < .001, FMI = .35.
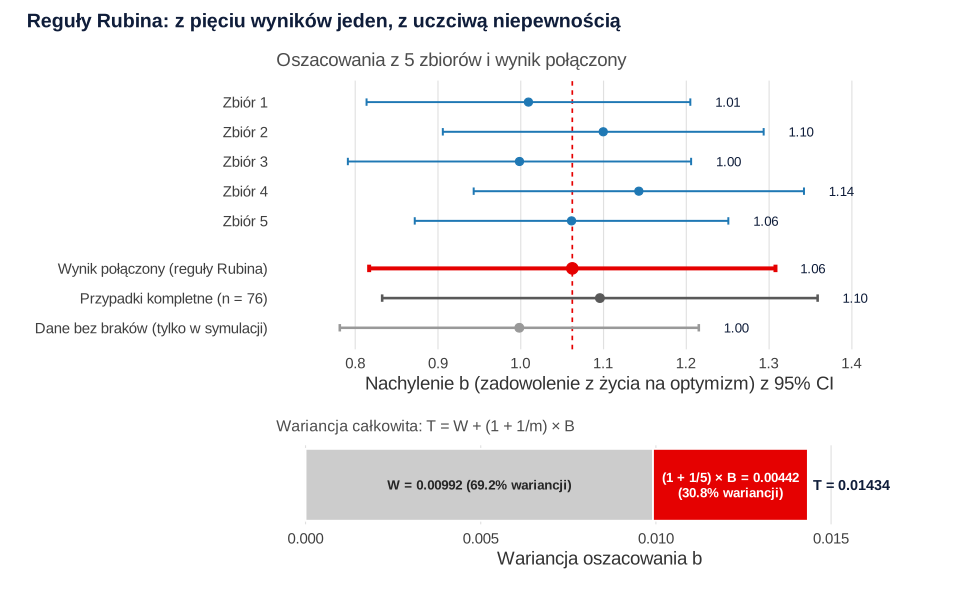
Pięć oszacowań różni się między sobą (od 0.998 do 1.143), bo w każdym zbiorze brakujące wyniki wylosowano inaczej. Wynik połączony leży pośrodku, a jego przedział ufności jest szerszy niż w każdym pojedynczym zbiorze – właśnie o niepewność z powodu braków. Analiza przypadków kompletnych (n = 76) dała b = 1.10, 95% CI [0.83, 1.36]. W symulacji znamy też wynik dla danych sprzed usunięcia braków: b = 1.00, 95% CI [0.78, 1.22]. W tym przykładzie imputacja wielokrotna znalazła się bliżej tej wartości i dała węższy przedział niż analiza samych przypadków kompletnych.
Ile imputacji wykonać?
Pięć imputacji to dawny standard. Van Buuren (2018) przypomina, że klasyczna rada mówiła o 3–5 zbiorach, ale często warto użyć 20–100, a za standard de facto uznaje regułę, by liczba imputacji była zbliżona do odsetka niepełnych przypadków. Na etapie budowania modelu wystarczy m = 5, a w analizie końcowej liczbę imputacji się zwiększa. Sterne i in. (2009) piszą, że choć pięć zbiorów uznawano za wystarczające ze względów teoretycznych, co najmniej 20 może być lepsze, bo zmniejsza losową zmienność samego procesu imputacji.
W naszym przykładzie braki ma 36.7% osób, więc w analizie końcowej użyliśmy 40 imputacji. Wynik: b = 1.08, SE = 0.11, 95% CI [0.86, 1.31], t(72.9) = 9.45, p < .001, FMI = .29. Przy 5 imputacjach FMI wyniosła .35 – tak mała liczba zbiorów daje niestabilne oszacowanie wariancji między imputacjami. Widać też, po co poprawka Barnarda–Rubina: klasyczny wzór Rubina dał przy 40 imputacjach aż 529.7 stopni swobody, czyli więcej niż 118 stopni swobody regresji na pełnych danych.
Odsetek braków nie powinien sam decydować o tym, czy stosować imputację. Madley-Dowd i in. (2019) pokazali w symulacjach, że przy dostępnych zmiennych pomocniczych imputacja wielokrotna zmniejsza obciążenie i nie pogarsza efektywności nawet przy dużym odsetku braków MAR, a lepszym przewodnikiem jest frakcja brakującej informacji. U nas braki ma 36.7% osób, ale FMI wynosi .29 – optymizm i samoocena odzyskują część utraconej informacji.
Jak opisać imputację wielokrotną w pracy (APA)
Sterne i in. (2009) zalecają m.in., by podać program i najważniejsze ustawienia imputacji, liczbę utworzonych zbiorów, zmienne w modelu imputacji oraz – w miarę możliwości – wyniki analizy przypadków kompletnych. Opis braków umieść w rozdziale metodologicznym (zob. jak napisać rozdział metodologiczny), a wyniki – w rozdziale z wynikami. Przykład:
Pełny przykład z diagnozą braków, tabelą wyników, porównaniem wartości obserwowanych i imputowanych oraz analizą wrażliwości znajdziesz we wpisie braki danych i imputacja wielokrotna w R.
Imputacja wielokrotna i reguły Rubina w R
Kod tworzy zbiór z przykładu (dane symulowane), wykonuje imputację wielokrotną funkcją aregImpute() z pakietu Hmisc, w każdym zbiorze dopasowuje regresję i łączy wyniki regułami Rubina zapisanymi wprost, krok po kroku. Połączony wynik dla 5 imputacji jest identyczny z wynikiem funkcji fit.mult.impute() z tego samego pakietu. W pakiecie mice te same kroki wykonują funkcje mice(), with() i pool() (van Buuren i Groothuis-Oudshoorn, 2011).
Od pięciu zbiorów do jednego wyniku
R
library(Hmisc, warn.conflicts = FALSE)   # aregImpute: imputacja wielokrotna

# Dane symulowane: optymizm (LOT-R, 0–24), samoocena (RSES, 10–40), zadowolenie z życia (SWLS, 5–35)
set.seed(50)
n <- 120
optymizm    <- rnorm(n, 15, 4)
samoocena   <- 28 + 0.5 * (optymizm - 15) + rnorm(n, 0, 4)
zadowolenie <- 21 + 0.6 * (optymizm - 15) + 0.35 * (samoocena - 28) + rnorm(n, 0, 4.5)
dane <- data.frame(optymizm    = round(pmin(pmax(optymizm, 0), 24)),
                   samoocena   = round(pmin(pmax(samoocena, 10), 40)),
                   zadowolenie = round(pmin(pmax(zadowolenie, 5), 35)))
# Braki w zadowoleniu – częstsze przy niskiej samoocenie (MAR)
brak <- runif(n) < plogis(-0.9 - 1.0 * as.numeric(scale(dane$samoocena)))
dane$zadowolenie[brak] <- NA
round(100 * mean(brak), 1)                      # % braków

# Kroki 1–2. Imputacja (m zbiorów, samoocena jako zmienna pomocnicza) i ta sama regresja w każdym zbiorze
analiza_mi <- function(m) {
  imp <- aregImpute(~ zadowolenie + optymizm + samoocena, data = dane,
                    n.impute = m, type = "regression", nk = 0, pr = FALSE)
  t(sapply(1:m, function(i) {
    d <- dane
    d$zadowolenie[is.na(d$zadowolenie)] <- imp$imputed$zadowolenie[, i]
    f <- lm(zadowolenie ~ optymizm, data = d)
    c(b = coef(f)[["optymizm"]], SE = sqrt(vcov(f)["optymizm", "optymizm"]))
  }))
}

# Krok 3. Reguły Rubina
rubin <- function(b, se, df_com) {
  m <- length(b)
  Qbar <- mean(b)                          # średnia oszacowań
  W <- mean(se^2)                          # wariancja wewnątrz imputacji
  B <- var(b)                              # wariancja między imputacjami
  Tv <- W + (1 + 1 / m) * B                # wariancja całkowita
  lambda <- (1 + 1 / m) * B / Tv           # udział braków w wariancji
  df_rubin <- (m - 1) / lambda^2           # stopnie swobody Rubina (1987)
  df_obs <- (df_com + 1) / (df_com + 3) * df_com * (1 - lambda)
  df_br <- df_rubin * df_obs / (df_rubin + df_obs)   # poprawka Barnarda–Rubina
  r <- (1 + 1 / m) * B / W
  c(Qbar = Qbar, W = W, B = B, T = Tv, SE = sqrt(Tv), lambda = lambda,
    df_Rubin = df_rubin, df_BR = df_br, FMI = (r + 2 / (df_br + 3)) / (r + 1),
    dolna = Qbar - qt(.975, df_br) * sqrt(Tv), gorna = Qbar + qt(.975, df_br) * sqrt(Tv),
    t = Qbar / sqrt(Tv), p = 2 * pt(-abs(Qbar / sqrt(Tv)), df_br))
}

# Ilustracja: m = 5
w5 <- analiza_mi(5)
round(cbind(w5, SE2 = w5[, "SE"]^2), 5)
round(rubin(w5[, "b"], w5[, "SE"], df_com = n - 2), 5)

# Analiza końcowa: m = 40 (mniej więcej tyle, ile procent przypadków ma braki)
w40 <- analiza_mi(40)
round(rubin(w40[, "b"], w40[, "SE"], df_com = n - 2), 4)

# Dla porównania: analiza przypadków kompletnych
round(summary(lm(zadowolenie ~ optymizm, data = dane))$coefficients, 4)
Wynik w R
[1] 36.7
           b      SE     SE2
[1,] 1.00927 0.09876 0.00975
[2,] 1.09964 0.09786 0.00958
[3,] 0.99846 0.10470 0.01096
[4,] 1.14262 0.10074 0.01015
[5,] 1.06134 0.09564 0.00915
    Qbar        W        B        T       SE   lambda df_Rubin    df_BR
 1.06227  0.00992  0.00368  0.01434  0.11974  0.30830 42.08241 27.60852
     FMI    dolna    gorna        t        p
 0.35350  0.81683  1.30770  8.87135  0.00000
    Qbar        W        B        T       SE   lambda df_Rubin    df_BR
  1.0843   0.0096   0.0035   0.0132   0.1148   0.2713 529.7318  72.9210
     FMI    dolna    gorna        t        p
  0.2905   0.8555   1.3131   9.4453   0.0000
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   5.3618     1.9995  2.6816    0.009
optymizm      1.0956     0.1320  8.2996    0.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- Hmisc (wersja 5.2.5): Harrell, F. E., Jr. (2026). Hmisc: Harrell miscellaneous (R package version 5.2-5) [Computer software]. https://doi.org/10.32614/CRAN.package.Hmisc
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Uśrednianie danych zamiast wyników – jeden „uśredniony” zbiór to imputacja pojedyncza, która zaniża błędy standardowe.
- Analiza tylko jednego z m zbiorów – pomija wariancję między imputacjami (B), więc przedziały ufności są za wąskie.
- Model imputacji bez zmiennej zależnej – osłabia badane związki (Sterne i in., 2009).
- Za mało imputacji przy dużych brakach – wyniki, a zwłaszcza FMI, zmieniają się przy ponownym uruchomieniu; kieruj się odsetkiem niepełnych przypadków (van Buuren, 2018).
- Wiara, że imputacja usuwa każde obciążenie – przy MNAR albo bez zmiennych związanych z brakami imputacja wielokrotna także może dać obciążone wyniki.
- Brak opisu procedury – podaj program, liczbę imputacji, zmienne w modelu imputacji i sposób łączenia wyników.
Najczęstsze pytania
Co to jest imputacja wielokrotna?
To metoda uzupełniania braków danych, w której każdy brak zastępuje się kilkoma wartościami wylosowanymi z modelu imputacji. Powstaje m kompletnych zbiorów; w każdym wykonuje się tę samą analizę, a wyniki łączy regułami Rubina. Dzięki temu przedziały ufności uwzględniają niepewność wynikającą z braków.
Czym imputacja wielokrotna różni się od imputacji średnią?
Imputacja średnią wpisuje jedną wartość i traktuje ją jak prawdziwy pomiar, przez co zaniża zmienność i błędy standardowe. Imputacja wielokrotna losuje kilka wartości z modelu, który wykorzystuje związki między zmiennymi, i włącza różnice między zbiorami do niepewności wyniku.
Jak połączyć wyniki imputacji wielokrotnej?
Regułami Rubina: oszacowanie końcowe to średnia z m oszacowań, W to średnia kwadratów błędów standardowych, B – wariancja oszacowań między zbiorami, a wariancja całkowita T = W + (1 + 1/m) × B. Błąd standardowy wyniku to √T. W przykładzie z 5 imputacjami: T = 0.00992 + 1.2 × 0.00368 = 0.01434, SE = 0.120.
Ile imputacji wykonać?
Van Buuren (2018) za standard de facto uznaje liczbę imputacji zbliżoną do odsetka niepełnych przypadków; na etapie budowania modelu wystarczy 5. Sterne i in. (2009) wskazują, że co najmniej 20 może być lepsze niż 5. Przy 36.7% braków użyliśmy 40 imputacji.
Czy imputacja wielokrotna działa przy brakach MNAR?
Standardowa imputacja wielokrotna zakłada, że braki są MCAR lub MAR. Przy brakach zależnych od samej brakującej wartości (MNAR) może dawać obciążone wyniki, dlatego warto dodać zmienne pomocnicze i analizę wrażliwości, np. przesunąć imputowane wartości i sprawdzić, czy wnioski się utrzymują.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Braki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Madley-Dowd, P., Hughes, R., Tilling, K., & Heron, J. (2019). The proportion of missing data should not be used to guide decisions on multiple imputation. Journal of Clinical Epidemiology, 110, 63–73. https://doi.org/10.1016/j.jclinepi.2019.02.016 ● Otwarty dostęp
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. Wiley. https://doi.org/10.1002/9780470316696
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Sterne, J. A. C., White, I. R., Carlin, J. B., Spratt, M., Royston, P., Kenward, M. G., Wood, A. M., & Carpenter, J. R. (2009). Multiple imputation for missing data in epidemiological and clinical research: Potential and pitfalls. BMJ, 338, Article b2393. https://doi.org/10.1136/bmj.b2393 ● Otwarty dostęp
- van Buuren, S. (2018). Flexible imputation of missing data (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429492259 ● Otwarty dostęp: pełny tekst
- van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03 ● Otwarty dostęp
Cytowania BibTeX
@article{madleydowd2019proportion, author={Madley-Dowd, Paul and Hughes, Rachael and Tilling, Kate and Heron, Jon}, title={{The proportion of missing data should not be used to guide decisions on multiple imputation}}, journal={Journal of Clinical Epidemiology}, year={2019}, volume={110}, pages={63--73}, doi={10.1016/j.jclinepi.2019.02.016}}@book{rubin1987multiple, author={Rubin, Donald B.}, title={{Multiple imputation for nonresponse in surveys}}, year={1987}, publisher={Wiley}, doi={10.1002/9780470316696}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{sterne2009multiple, author={Sterne, Jonathan A. C. and White, Ian R. and Carlin, John B. and Spratt, Michael and Royston, Patrick and Kenward, Michael G. and Wood, Angela M. and Carpenter, James R.}, title={{Multiple imputation for missing data in epidemiological and clinical research: Potential and pitfalls}}, journal={BMJ}, year={2009}, volume={338}, eid={b2393}, doi={10.1136/bmj.b2393}}@book{vanbuuren2018flexible, author={van Buuren, Stef}, title={{Flexible imputation of missing data (2nd ed.)}}, year={2018}, publisher={Chapman \& Hall/CRC}, doi={10.1201/9780429492259}}@article{vanbuuren2011mice, author={van Buuren, Stef and Groothuis-Oudshoorn, Karin}, title={{mice: Multivariate imputation by chained equations in R}}, journal={Journal of Statistical Software}, year={2011}, volume={45}, number={3}, pages={1--67}, doi={10.18637/jss.v045.i03}}