Kim jest Donald B. Rubin?
Donald Bruce Rubin (ur. 1943) to amerykański statystyk z Uniwersytetu Harvarda. Urodził się w Waszyngtonie. W 1961 r. zaczął studia w Princeton z zamiarem zostania fizykiem, ale w 1965 r. ukończył psychologię. Na Harvardzie zaczynał doktorat z psychologii, potem przeszedł do informatyki (magisterium w 1966 r.), a doktorat ze statystyki obronił w 1970 r. pod kierunkiem Williama G. Cochrana (Li i Mealli, 2014).
Po roku pracy jako instruktor na Harvardzie przeszedł w 1971 r. do Educational Testing Service (ETS) w Princeton. W latach 1981–1983 był profesorem Uniwersytetu Chicagowskiego, a w 1984 r. wrócił na Harvard, gdzie kierował wydziałem statystyki w latach 1985–1994 i 2000–2004. Wypromował lub współpromował ponad 50 doktorów i jest członkiem m.in. National Academy of Sciences (Li i Mealli, 2014).
Najważniejsze pomysły
- Potencjalne wyniki także poza eksperymentem (1974). W artykule w „Journal of Educational Psychology” Rubin (1974) porównał randomizację i dopasowanie i uznał, że losować trzeba, gdy to możliwe, ale staranne wnioskowanie przyczynowe z danych nierandomizowanych bywa rozsądne i konieczne. Opis efektu jako porównania dwóch potencjalnych wyników stosowano wcześniej w eksperymentach (Jerzy Neyman); Rubin przeniósł go na badania obserwacyjne i dodał pojęcie mechanizmu przydziału (Li i Mealli, 2014). Holland (1986) nazwał to ujęcie modelem przyczynowym Rubina.
- Mechanizmy braków danych (1976). W „Biometrice” Rubin (1976) podał najsłabsze ogólne warunki, przy których proces powstawania braków można pominąć – kluczowe jest pojęcie braków losowych (missing at random). Stąd wywodzi się podział MCAR, MAR i MNAR.
- Algorytm EM (1977). Wspólnie z Arthurem Dempsterem i Nan Laird uogólnił iteracyjną metodę największej wiarygodności przy niepełnych danych (Li i Mealli, 2014) – zob. algorytm EM i hasło o Rebecce DerSimonian i Nan Laird.
- Propensity score (1983). Z doktorantem Paulem Rosenbaumem pokazał, że korekta o jedno prawdopodobieństwo przydziału wystarcza, by usunąć obciążenie wynikające ze wszystkich zmierzonych cech (Rosenbaum i Rubin, 1983).
- Imputacja wielokrotna (1987). Pomysł opisał po raz pierwszy w 1978 r., a w książce z 1987 r. przedstawił ją jako sposób postępowania z brakami odpowiedzi w badaniach sondażowych (Rubin, 1987; Li i Mealli, 2014). Wyniki z kilku uzupełnionych zbiorów łączy się regułami Rubina.
Ciekawostka
Twórca nowoczesnej teorii braków danych na studiach doktoranckich zmieniał wydziały. Jak opowiadał w wywiadzie (Li i Mealli, 2014), po przyjeździe na Harvard w 1965 r. kierownik wydziału psychologii uznał jego wykształcenie za naukowo niepełne, bo brakowało w nim kursów z metod i statystyki, i kazał mu je nadrobić. Rubin, który w Princeton miał za sobą sporo matematyki i fizyki, poczuł się urażony i przeniósł się do informatyki. Latem 1966 r. programował dla Johna Tukeya, a po rozmowie z Frederickiem Mostellerem zaczął zdawać kursy statystyki. Statystyka była – jak sam to ujął – „my third department in four years”.
Ironia losu: zaraz po doktoracie, w roku pracy jako instruktor, prowadził razem z Robertem Rosenthalem kurs statystyki dla psychologów – ten sam rodzaj zajęć, których brak wytknięto mu pięć lat wcześniej.
Przykład: co mechanizm braków robi ze średnią
Dane są fikcyjne (symulacja z ziarnem 946). W każdym z 2000 symulowanych badań 400 studentów ma wynik kolokwium X i egzaminu Y (średnia 60, SD 10, korelacja 0.6). Wynik egzaminu nie jest znany u około 30% osób (MCAR) albo 34% (MAR, MNAR). Przy MCAR brak jest czysto losowy, przy MAR zależy od kolokwium, a przy MNAR – od samego wyniku egzaminu; w obu ostatnich częściej brakuje słabszych. Siłę zależności ustawiliśmy ręcznie.
Średnia z kompletnych przypadków przy MCAR wychodzi średnio 60.00, czyli trafia w prawdę. Przy MAR wynosi 61.90, a przy MNAR 63.22 – zawyżenie o 1.90 i 3.22 punktu, przy rozrzucie oszacowań między badaniami (SD) około 0.58. Zwykły 95% przedział ufności obejmuje prawdziwą średnią w 96.1% badań przy MCAR, w 10.4% przy MAR i w żadnym przy MNAR.
Gdy braki uzupełnimy przewidywaniem z regresji Y od X, obciążenie przy MAR znika (średnio 59.98), ale przy MNAR spada tylko do 2.21 punktu (62.21). To sedno pracy Rubina z 1976 r.: o tym, czy brak można „pominąć”, decyduje mechanizm braków, a nie sam ich odsetek.
Na rysunku
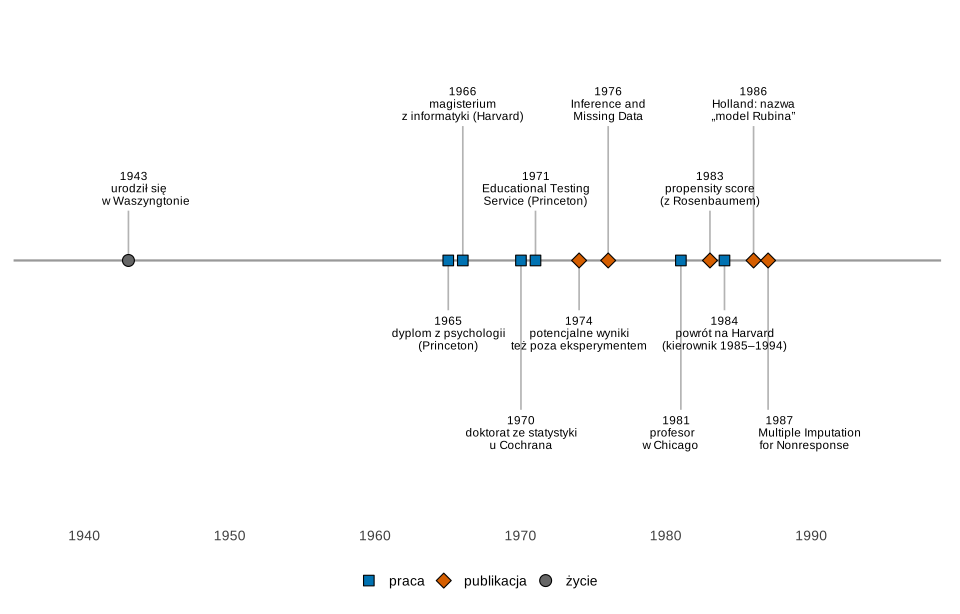
Co widać. Trzy prace, z których korzysta dziś niemal każdy analityk – o potencjalnych wynikach, brakach danych i algorytmie EM – powstały w ciągu czterech lat pracy w ETS, poza uczelnią.
Na co uważać. Oś kończy się na 1987 r., bo późniejsze lata źródło opisuje tylko ogólnie (m.in. drugie kierowanie wydziałem w latach 2000–2004). Rok 1986 to nazwa nadana przez Hollanda, a nie praca samego Rubina.
Podpis do pracy:
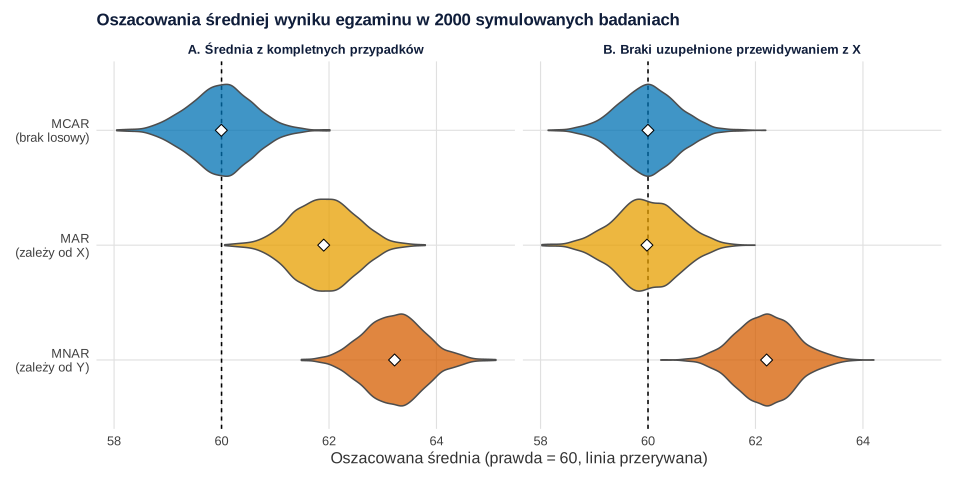
set.seed(946), 2000 powtórzeń po 400 osób). Obliczenia i rysunek: R, pakiety ggplot2 i patchwork.Co widać. W panelu A tylko niebieska skrzypce (MCAR) obejmują prawdziwą średnią; żółte i pomarańczowe leżą w całości na prawo od linii. W panelu B informacja z kolokwium przesuwa żółte (MAR) na miejsce, ale pomarańczowe (MNAR) zostają przesunięte.
Na co uważać. Panel B to imputacja pojedyncza: daje dobre oszacowanie średniej przy MAR, ale traktuje przewidywane wartości jak pomiary, więc błędy standardowe byłyby za małe – właśnie dlatego Rubin zaproponował imputację wielokrotną. Z samych danych nie odróżnisz też MAR od MNAR; to założenie, które trzeba uzasadnić.
Podpis do pracy:
Gdzie spotkasz Rubina w swojej pracy
- W rozdziale o brakach danych: opisz odsetek braków i ich prawdopodobny mechanizm, zanim wybierzesz metodę. Usuwanie przypadków z brakami jest bezpieczne praktycznie tylko przy MCAR.
- Przy imputacji wielokrotnej łączysz wyniki regułami Rubina – krok po kroku pokazuje to wpis braki danych i imputacja wielokrotna w R.
- W badaniu obserwacyjnym pytanie o efekt formułujesz w języku potencjalnych wyników (ATE, ATT), a grupy wyrównujesz propensity score; pomaga to odróżnić korelację od przyczynowości.
- Gdy część osób nie stosuje się do przydziału, sięgnij po LATE – efekt także definiowany w języku potencjalnych wyników.
Spory, mity i trudne strony
- Czy to Rubin wymyślił potencjalne wyniki? Nie w całości. Notację potencjalnych wyników dla eksperymentów wprowadził Neyman w pracy doktorskiej; Rubin poznał ją dopiero w 1990 r., po przekładzie na angielski. Nazwę „model Rubina” uzasadnia tym, że przeniósł potencjalne wyniki na badania obserwacyjne i dodał mechanizm przydziału (Li i Mealli, 2014).
- MAR nie znaczy „losowo”. Braki losowe w sensie Rubina mogą silnie zależeć od innych zmiennych – rysunek 2 pokazuje, że wtedy średnia z kompletnych przypadków jest obciążona.
Mechanizmy braków danych Rubina w R
Kod symuluje 2000 badań po 400 studentów z brakami w wyniku egzaminu przy trzech mechanizmach (MCAR, MAR, MNAR), liczy średnią z kompletnych przypadków i średnią po uzupełnieniu braków przewidywaniem z wyniku kolokwium, sprawdza pokrycie zwykłego 95% przedziału ufności i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne.
1. Średnia przy brakach MCAR, MAR i MNAR: rysunek 2
Kod R rysunku 2
# Donald Rubin: mechanizm braków danych (MCAR, MAR, MNAR) a średnia z kompletnych przypadków – symulacja
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(MCAR = "#0072B2", MAR = "#E69F00", MNAR = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Dane fikcyjne: X – wynik kolokwium w połowie semestru, Y – wynik egzaminu (obie skale: średnia 60, SD 10, korelacja 0.6).
# Wynik egzaminu Y jest nieznany u ok. 30% studentów. Parametry ustawione ręcznie, żeby różnice były wyraźne.
n <- 400; R <- 2000; mu_y <- 60
generuj <- function(mechanizm) {
  x <- rnorm(n, 60, 10)
  y <- 60 + 0.6 * (x - 60) + rnorm(n, 0, 8)
  z <- switch(mechanizm,
              MCAR = rep(0, n),          # brak nie zależy od niczego
              MAR  = (x - 60) / 10,      # brak zależy od obserwowanego X
              MNAR = (y - 60) / 10)      # brak zależy od nieobserwowanego Y
  brak <- runif(n) < plogis(-0.85 - 1.2 * z)   # niższy wynik → częściej brak
  data.frame(x, y, y_obs = ifelse(brak, NA, y))
}
estymuj <- function(d) {
  ok <- !is.na(d$y_obs)
  m <- lm(y_obs ~ x, data = d)                 # model Y od X na kompletnych przypadkach
  c(braki = mean(!ok),
    kompletne = mean(d$y_obs, na.rm = TRUE),   # średnia tylko z osób z wynikiem
    z_modelem_x = mean(ifelse(ok, d$y_obs, predict(m, newdata = d))))   # braki uzupełnione przewidywaniem z X
}
set.seed(946)
wyniki <- do.call(rbind, lapply(c("MCAR", "MAR", "MNAR"), function(mech)
  data.frame(mechanizm = mech, t(replicate(R, estymuj(generuj(mech)))))))
wyniki$mechanizm <- factor(wyniki$mechanizm, levels = c("MCAR", "MAR", "MNAR"))

# Obciążenie (średnia oszacowań minus prawdziwa średnia 60) i rozrzut oszacowań w 2000 powtórzeniach
podsum <- aggregate(cbind(braki, kompletne, z_modelem_x) ~ mechanizm, data = wyniki, FUN = mean)
podsum$obc_kompletne <- podsum$kompletne - mu_y
podsum$obc_z_modelem_x <- podsum$z_modelem_x - mu_y
podsum$sd_kompletne <- aggregate(kompletne ~ mechanizm, data = wyniki, FUN = sd)$kompletne
podsum$sd_z_modelem_x <- aggregate(z_modelem_x ~ mechanizm, data = wyniki, FUN = sd)$z_modelem_x
round(data.frame(podsum[, 2:8], row.names = podsum$mechanizm), 3)

# Jak często zwykły 95% przedział ufności ze średniej kompletnych przypadków obejmuje prawdziwą średnią 60 (1000 powtórzeń)
set.seed(9461)
pokrycie <- sapply(c("MCAR", "MAR", "MNAR"), function(mech) mean(replicate(1000, {
  y <- na.omit(generuj(mech)$y_obs)
  abs(mean(y) - mu_y) <= qt(0.975, length(y) - 1) * sd(y) / sqrt(length(y))
})))
round(pokrycie, 3)

# Rysunek: rozkład oszacowań średniej w 2000 powtórzeniach
dl <- rbind(data.frame(mechanizm = wyniki$mechanizm, metoda = "A. Średnia z kompletnych przypadków", est = wyniki$kompletne),
            data.frame(mechanizm = wyniki$mechanizm, metoda = "B. Braki uzupełnione przewidywaniem z X", est = wyniki$z_modelem_x))
p2 <- ggplot(dl, aes(est, mechanizm, fill = mechanizm)) +
  geom_vline(xintercept = mu_y, linetype = "22", colour = "black") +
  geom_violin(scale = "width", width = 0.8, colour = "grey30", alpha = 0.75) +
  stat_summary(fun = mean, geom = "point", shape = 23, size = 3, fill = "white", colour = "black") +
  facet_wrap(~ metoda, ncol = 2) +
  scale_fill_manual(values = kol, guide = "none") +
  scale_y_discrete(limits = rev(c("MCAR", "MAR", "MNAR")),
                   labels = c(MCAR = "MCAR\n(brak losowy)", MAR = "MAR\n(zależy od X)", MNAR = "MNAR\n(zależy od Y)")) +
  labs(title = "Oszacowania średniej wyniku egzaminu w 2000 symulowanych badaniach",
       x = "Oszacowana średnia (prawda = 60, linia przerywana)", y = NULL) +
  motyw
p2
Wynik w R
     braki kompletne z_modelem_x obc_kompletne obc_z_modelem_x sd_kompletne
MCAR 0.299    59.996      59.999        -0.004          -0.001        0.584
MAR  0.340    61.901      59.980         1.901          -0.020        0.578
MNAR 0.340    63.220      62.207         3.220           2.207        0.558
     sd_z_modelem_x
MCAR          0.547
MAR           0.591
MNAR          0.537
 MCAR   MAR  MNAR
0.961 0.104 0.000
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Donald B. Rubin (ur. 1943) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1943, 1965, 1966, 1970, 1971, 1974, 1976, 1981, 1983, 1984, 1986, 1987),
  opis = c("urodził się\nw Waszyngtonie", "dyplom z psychologii\n(Princeton)", "magisterium\nz informatyki (Harvard)",
           "doktorat ze statystyki\nu Cochrana", "Educational Testing\nService (Princeton)", "potencjalne wyniki\nteż poza eksperymentem",
           "Inference and\nMissing Data", "profesor\nw Chicago", "propensity score\n(z Rosenbaumem)",
           "powrót na Harvard\n(kierownik 1985–1994)", "Holland: nazwa\n„model Rubina”", "Multiple Imputation\nfor Nonresponse"),
  rodzaj = c("życie", "praca", "praca", "praca", "praca", "publikacja", "publikacja", "praca", "publikacja",
             "praca", "publikacja", "publikacja"),
  poziom = c(0.5, -0.5, 1.35, -1.5, 0.5, -0.5, 1.35, -1.5, 0.5, -0.5, 1.35, -1.5),   # wysokość etykiety
  wyrownanie = c(0.3, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.7, 0.5, 0.5, 0.5, 0.1))   # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1938, 1996), breaks = seq(1940, 1990, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.25)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (symulacja i regresja – funkcje rnorm(), runif(), lm() i predict() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Donald Rubin?
Amerykańskim statystykiem (ur. 1943) z Uniwersytetu Harvarda. Studiował fizykę i psychologię w Princeton, informatykę i statystykę na Harvardzie, gdzie w 1970 r. obronił doktorat u Williama Cochrana. Pracował w Educational Testing Service i na Uniwersytecie Chicagowskim, a od 1984 r. jest na Harvardzie (Li i Mealli, 2014).
Co to jest model przyczynowy Rubina?
To ujęcie, w którym efekt interwencji to różnica dwóch potencjalnych wyników tej samej osoby – z interwencją i bez niej – a sposób przydziału do grup opisuje mechanizm przydziału. Rubin (1974) zastosował je także do badań obserwacyjnych, a nazwę „model Rubina” nadał mu Holland (1986).
Skąd pochodzą nazwy MCAR, MAR i MNAR?
Z teorii braków danych, którą Rubin przedstawił w „Biometrice” w 1976 r. Kluczowe pojęcie to braki losowe (missing at random): przy nich proces powstawania braków można pominąć przy wnioskowaniu. W symulacji na tej stronie średnia z kompletnych przypadków przy MAR była zawyżona o 1.90 punktu, a przy MNAR o 3.22.
Czy uzupełnienie braków przewidywaniem z regresji wystarczy?
Przy brakach MAR usuwa obciążenie średniej – w naszej symulacji z 61.90 do 59.98 przy prawdziwej wartości 60 – ale zaniża błędy standardowe, bo traktuje przewidywania jak pomiary. Przy MNAR nie pomaga w pełni (62.21). Rubin zaproponował dlatego imputację wielokrotną i reguły łączenia wyników.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Holland, P. W. (1986). Statistics and causal inference. Journal of the American Statistical Association, 81(396), 945–960. https://doi.org/10.1080/01621459.1986.10478354
- Li, F., & Mealli, F. (2014). A conversation with Donald B. Rubin. Statistical Science, 29(3), 439–457. https://doi.org/10.1214/14-sts489 ● Otwarty dostęp
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41 ● Otwarty dostęp
- Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350 ● Otwarty dostęp: pełny tekst
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. Wiley. https://doi.org/10.1002/9780470316696
Cytowania BibTeX
@article{holland1986statistics, author={Holland, Paul W.}, title={{Statistics and causal inference}}, journal={Journal of the American Statistical Association}, year={1986}, volume={81}, number={396}, pages={945--960}, doi={10.1080/01621459.1986.10478354}}@article{li2014conversation, author={Li, Fan and Mealli, Fabrizia}, title={{A conversation with Donald B. Rubin}}, journal={Statistical Science}, year={2014}, volume={29}, number={3}, pages={439--457}, doi={10.1214/14-sts489}}@article{rosenbaum1983central, author={Rosenbaum, Paul R. and Rubin, Donald B.}, title={{The central role of the propensity score in observational studies for causal effects}}, journal={Biometrika}, year={1983}, volume={70}, number={1}, pages={41--55}, doi={10.1093/biomet/70.1.41}}@article{rubin1974estimating, author={Rubin, Donald B.}, title={{Estimating causal effects of treatments in randomized and nonrandomized studies}}, journal={Journal of Educational Psychology}, year={1974}, volume={66}, number={5}, pages={688--701}, doi={10.1037/h0037350}}@article{rubin1976inference, author={Rubin, Donald B.}, title={{Inference and missing data}}, journal={Biometrika}, year={1976}, volume={63}, number={3}, pages={581--592}, doi={10.1093/biomet/63.3.581}}@book{rubin1987multiple, author={Rubin, Donald B.}, title={{Multiple imputation for nonresponse in surveys}}, year={1987}, publisher={Wiley}, doi={10.1002/9780470316696}}