Kim był Jerzy Spława-Neyman?
Jerzy Spława-Neyman (1894–1981), w publikacjach J. Neyman, był statystykiem i matematykiem, współtwórcą teorii testowania hipotez, przedziałów ufności i losowania warstwowego. Urodził się 16 kwietnia 1894 r. w Benderach, wówczas w Rosji, w rodzinie polskiego pochodzenia. Pełne nazwisko Spława-Neyman wskazywało na przynależność do polskiej szlachty, a pierwszy człon Neyman porzucił około trzydziestki (Lehmann, 1994). Od 1912 r. studiował w Charkowie, najpierw fizykę, potem matematykę.
Do Polski przyjechał po raz pierwszy w 1921 r., w ramach wymiany jeńców, mając 27 lat. Pracował jako statystyk w Instytucie Rolniczym w Bydgoszczy, gdzie pisał o zastosowaniu rachunku prawdopodobieństwa w doświadczeniach rolniczych. Od grudnia 1922 r. był w Państwowym Instytucie Meteorologicznym w Warszawie, a zarazem asystentem Uniwersytetu Warszawskiego; wykładał też w Szkole Głównej Gospodarstwa Wiejskiego i w Krakowie. Doktorat uzyskał w Warszawie w 1924 r., habilitację w 1928 r. Rok akademicki 1925–1926 spędził w pracowni Karla Pearsona w Londynie, następny – w Paryżu. W Warszawie założył też pracownię statystyczną w Instytucie Biologii Doświadczalnej im. Nenckiego (Lehmann, 1994). Dla warszawskiego Instytutu Spraw Społecznych opracował w 1933 r. monografię o metodzie reprezentacyjnej, od której liczy się początek badań na próbach losowych w polskiej statystyce publicznej (Kordos, 2012).
Wiosną 1934 r. Egon Pearson zaproponował mu pracę w University College London, gdzie Neyman pozostał do 1938 r. W kwietniu 1938 r. przyjął ofertę Uniwersytetu Kalifornijskiego w Berkeley. Zbudował tam pracownię statystyczną, od 1945 r. co pięć lat organizował Sympozja Berkeley, a w 1955 r. stanął na czele nowego wydziału statystyki. W 1969 r. otrzymał amerykański National Medal of Science. Zmarł 5 sierpnia 1981 r. w wieku 87 lat (Lehmann, 1994). W 1950 i 1958 r. odwiedzał Polskę i konsultował badania reprezentacyjne GUS (Kordos, 2012).
Najważniejsze pomysły
- Teoria testowania hipotez (z Egonem Pearsonem). W pracy z 1928 r. pojawiły się moc testu i dwa rodzaje błędów, a w pracy z 1933 r. – teoria najmocniejszych testów (Neyman i Pearson, 1933) z tzw. lematem podstawowym (lematem Neymana–Pearsona) (Lehmann, 1994). Stąd pochodzą hipoteza zerowa i alternatywna jako para, błąd I i II rodzaju oraz moc testu.
- Przedziały ufności. Krótkie zapowiedzi ukazały się w 1934 i 1935 r., a pełna teoria w 1937 r. (Neyman, 1937), po tym jak Pearson odrzucił tekst w Biometrice jako zbyt długi i zbyt matematyczny (Lehmann, 1994). Dzisiejszy przedział ufności i cała estymacja przedziałowa opierają się na jego ujęciu.
- Losowanie warstwowe. W artykule z 1934 r. (Neyman, 1934), którego główne myśli ukazały się rok wcześniej po polsku, oparł wnioskowanie z próby na losowaniu, wprowadził optymalny rozdział próby między warstwy i krytycznie ocenił dobór celowy. Pokazał też, że próba warstwowa jest reprezentatywna nawet wtedy, gdy frakcje losowania w warstwach są różne (Kordos, 2012).
Przykład: alokacja Neymana
Historycznych danych Neymana nie ma w pakietach R, dlatego pokazujemy jego metodę na prawdziwej populacji. Zbiór apipop z pakietu survey obejmuje według pliku pomocy wszystkie szkoły w Kalifornii z co najmniej 100 uczniami, opisane wskaźnikiem wyników testów (Academic Performance Index). Szukamy średniej liczby uczniów w szkole na podstawie próby 200 szkół. Warstwy to typy szkół: podstawowe (E, 4397 szkół, średnio 427 uczniów, SD = 176), średnie niższego stopnia (M, 1009 szkół, 912 uczniów, SD = 439) i średnie wyższego stopnia (H, 751 szkół, 1350 uczniów, SD = 688).
Alokacja proporcjonalna rozdziela próbę według liczby szkół: 143 + 33 + 24. Alokacja Neymana bierze z każdej warstwy liczbę jednostek proporcjonalną do iloczynu jej wielkości i odchylenia standardowego (nh ∝ NhSh): 89 + 51 + 60, czyli więcej dużych, zróżnicowanych szkół. Średnia populacji wynosi 619.0 ucznia. Błąd standardowy średniej z wzoru to 32.4 w losowaniu prostym, 23.3 przy alokacji proporcjonalnej i 19.4 przy alokacji Neymana. W 2000 symulowanych prób na schemat (ziarno 797) odchylenie standardowe oszacowań wyniosło 33.3, 23.4 i 19.6, a 95% przedział ufności objął prawdziwą średnią w 93.7%, 94.8% i 94.6% prób.
Na rysunku
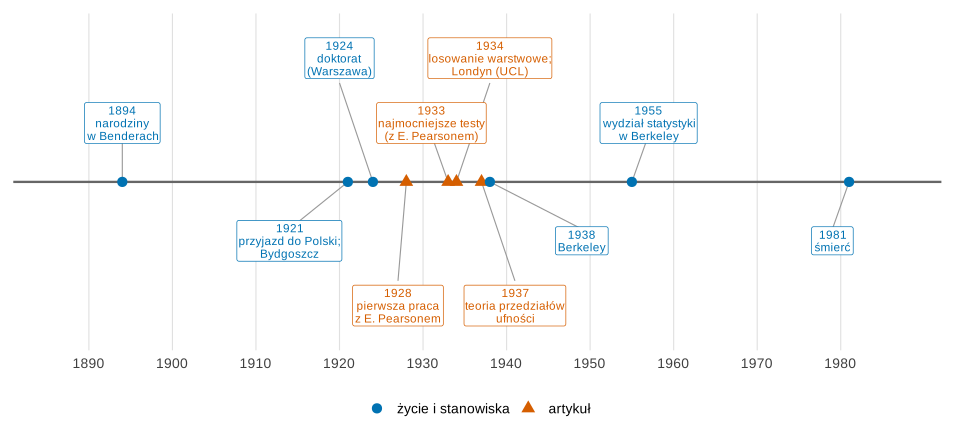
Co widać. Trzy prace, z których korzysta dziś każdy student – o testach, o losowaniu warstwowym i o przedziałach ufności – powstały w ciągu dziesięciu lat, między Warszawą a Londynem.
Na co uważać. Daty na osi to daty publikacji; Lehmann (1994) zaznacza, że lemat podstawowy Neyman znał już około 1930 r., a pierwsze zapowiedzi przedziałów ufności ukazały się w 1934 i 1935 r.
Podpis do pracy:
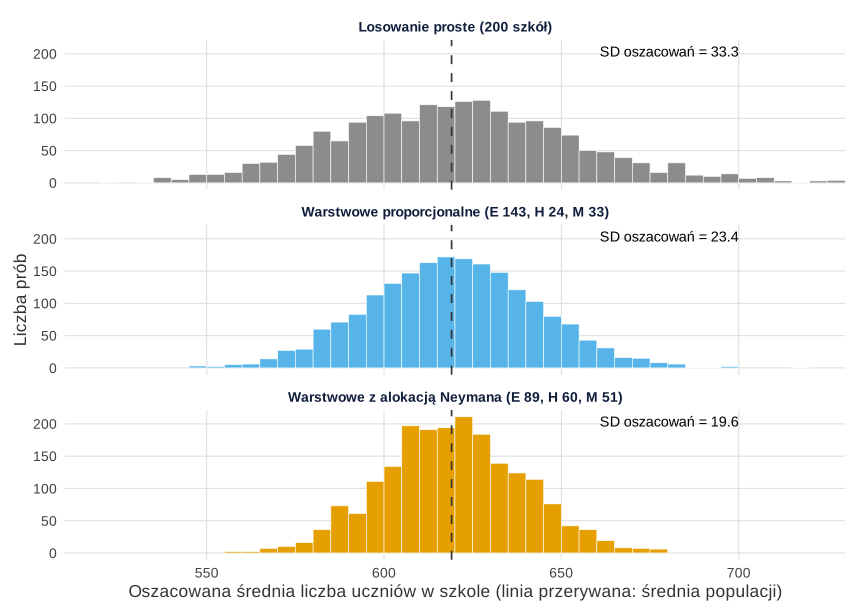
apipop) i ggplot2 (symulacja, set.seed(797)).Co widać. Wszystkie trzy rozkłady są wyśrodkowane na prawdziwej średniej, ale różnią się szerokością. Warstwy usuwają z błędu różnice między typami szkół, a alokacja Neymana dodatkowo przesuwa próbę tam, gdzie zmienność jest największa – w szkołach średnich obu stopni. Przy tej samej liczbie 200 szkół błąd standardowy spada z 33.3 do 19.6.
Na co uważać. Odchylenia standardowe w warstwach wzięliśmy z całej populacji; w prawdziwym badaniu trzeba je oszacować z badania pilotażowego lub wcześniejszych danych. Alokacja optymalna dla jednej zmiennej może być słaba dla innej, a próba nieproporcjonalna wymaga wag w analizie.
Podpis do pracy:
Gdzie spotkasz Neymana w swojej pracy
- Podajesz 95% przedział ufności przy średniej, różnicy czy korelacji – to jego interpretacja: procedura, która w 95% powtórzeń obejmuje prawdziwą wartość, a nie 95% szansy dla jednego przedziału. Zobacz przedział ufności w obrazkach.
- Planujesz liczebność próby – ustalasz z góry poziom istotności α i moc, czyli ryzyko obu rodzajów błędów.
- Losujesz próbę z warstwami (np. wydziały, regiony) – porównanie schematów pokazuje wpis Schematy losowania w obrazkach.
- W analizie moderacji wyznaczasz przedział Johnsona–Neymana – metoda nosi także jego nazwisko.
Spory, mity i trudne strony
Spór z Fisherem. Zaczął się w 1935 r., gdy Neyman w referacie dla Royal Statistical Society zakwestionował pewne własności planu kwadratu łacińskiego Ronalda Fishera, i trwał do końca życia obu uczonych (Lehmann, 1994). Dotyczył interpretacji wyniku testu, roli mocy, warunkowania i stałych poziomów istotności. Lehmann (1993) uważa jednak, że w praktyce oba podejścia się uzupełniają; o tym, jak mieszanka obu szkół trafiła do podręczników, piszemy przy wartości p.
Przedział ufności to nie prawdopodobieństwo dla jednego przedziału. W ujęciu Neymana 95% opisuje metodę: w długiej serii prób tyle przedziałów obejmie prawdziwą wartość, co widać w symulacji powyżej (94.6–94.8% przy losowaniu warstwowym). O konkretnym, już policzonym przedziale nie mówi się, że zawiera parametr z prawdopodobieństwem 95%.
Nazwisko i pochodzenie. W literaturze funkcjonują obie formy, „Neyman” i „Spława-Neyman”. Kordos (2012) nazywa go polskim statystykiem, a Lehmann (1994) pisze, że urodził się w Rosji w rodzinie polskiego pochodzenia. Oba opisy są zgodne z faktami: dzieciństwo i studia w Rosji, kilkanaście lat pracy w Polsce, potem Londyn i Berkeley.
Alokacja Neymana w R
Pierwszy kod liczy alokację proporcjonalną i alokację Neymana, błędy standardowe z wzoru oraz – w 2000 powtórzeniach – rozrzut oszacowań i pokrycie 95% przedziału ufności. Drugi rysuje oba rysunki. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Losowanie warstwowe 200 szkół z populacji apipop
R
# Neyman (1934): losowanie warstwowe i alokacja optymalna – populacja szkół w Kalifornii
suppressPackageStartupMessages(library(survey))   # pakiet z danymi api
data(api, package = "survey")      # apipop: wszystkie szkoły Kalifornii z co najmniej 100 uczniami
pop <- subset(apipop, !is.na(enroll))              # enroll – liczba uczniów w szkole
N_h <- c(table(pop$stype))                          # warstwy: E – podstawowe, M – gimnazja, H – licea
S_h <- tapply(pop$enroll, pop$stype, sd)
n <- 200
alokacja <- rbind(N_h = N_h, srednia = round(tapply(pop$enroll, pop$stype, mean)), S_h = round(S_h),
                  proporcjonalna = round(n * N_h / sum(N_h)),
                  Neymana = round(n * N_h * S_h / sum(N_h * S_h)))    # n_h proporcjonalne do N_h * S_h
alokacja

# Błąd standardowy średniej z próby 200 szkół (wzór z poprawką na skończoną populację)
W_h <- N_h / sum(N_h)
se_warstwowe <- function(n_h) sqrt(sum(W_h^2 * S_h^2 / n_h * (1 - n_h / N_h)))
se_proste <- sd(pop$enroll) / sqrt(n) * sqrt(1 - n / nrow(pop))
round(c(srednia_populacji = mean(pop$enroll), SE_proste = se_proste,
        SE_proporcjonalna = se_warstwowe(alokacja["proporcjonalna", ]),
        SE_Neymana = se_warstwowe(alokacja["Neymana", ])), 1)

# 2000 powtórzeń każdego schematu: rozrzut oszacowań i pokrycie 95% przedziału ufności
losuj <- function(n_h) {
  idx <- unlist(lapply(names(n_h), function(h) sample(which(pop$stype == h), n_h[[h]])))
  y <- pop$enroll[idx]; g <- as.character(pop$stype[idx])
  sr <- tapply(y, g, mean)[names(n_h)]; s2 <- tapply(y, g, var)[names(n_h)]
  est <- sum(W_h * sr); se <- sqrt(sum(W_h^2 * s2 / n_h * (1 - n_h / N_h)))
  c(est = est, pokryte = abs(est - mean(pop$enroll)) <= 1.96 * se)
}
set.seed(797)
sym <- list(proste = t(replicate(2000, {
              y <- sample(pop$enroll, n); se <- sd(y) / sqrt(n) * sqrt(1 - n / nrow(pop))
              c(est = mean(y), pokryte = abs(mean(y) - mean(pop$enroll)) <= 1.96 * se)})),
            proporcjonalna = t(replicate(2000, losuj(alokacja["proporcjonalna", ]))),
            Neymana = t(replicate(2000, losuj(alokacja["Neymana", ]))))
round(sapply(sym, function(m) c(SD_oszacowan = sd(m[, "est"]), pokrycie_proc = 100 * mean(m[, "pokryte"]))), 1)
Wynik w R
                  E    H    M
N_h            4397  751 1009
srednia         427 1350  912
S_h             176  688  439
proporcjonalna  143   24   33
Neymana          89   60   51
srednia_populacji         SE_proste SE_proporcjonalna        SE_Neymana
            619.0              32.4              23.3              19.4
              proste proporcjonalna Neymana
SD_oszacowan    33.3           23.4    19.6
pokrycie_proc   93.7           94.8    94.6
Rysunki 1 i 2: oś czasu i trzy schematy losowania
Kod R rysunków
# Rysunki 1–2: oś czasu Jerzego Spławy-Neymana i trzy schematy losowania 200 szkół z populacji api
suppressPackageStartupMessages({library(ggplot2); library(survey)})
# Okabe–Ito (czytelne przy deuteranopii); kolor zawsze z kształtem albo etykietą
kol <- c(stanowisko = "#0072B2", praca = "#D55E00", proste = "grey55", proporcjonalna = "#56B4E9", Neymana = "#E69F00")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: oś czasu (Lehmann, 1994; Kordos, 2012)
os <- data.frame(
  rok = c(1894, 1921, 1924, 1928, 1933, 1934, 1937, 1938, 1955, 1981),
  opis = c("narodziny\nw Benderach", "przyjazd do Polski;\nBydgoszcz", "doktorat\n(Warszawa)",
           "pierwsza praca\nz E. Pearsonem", "najmocniejsze testy\n(z E. Pearsonem)", "losowanie warstwowe;\nLondyn (UCL)",
           "teoria przedziałów\nufności", "Berkeley", "wydział statystyki\nw Berkeley", "śmierć"),
  rodzaj = c("stanowisko", "stanowisko", "stanowisko", "praca", "praca", "praca", "praca",
             "stanowisko", "stanowisko", "stanowisko"),
  lx = c(1894, 1914, 1920, 1927, 1931, 1938, 1941, 1949, 1957, 1979),   # położenie etykiet
  y = c(1, -1, 2.1, -2.1, 1, 2.1, -2.1, -1, 1, -1))
os$rodzaj <- factor(os$rodzaj, levels = c("stanowisko", "praca"),
                    labels = c("życie i stanowiska", "artykuł"))
p1 <- ggplot(os, aes(rok)) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.8) +
  geom_segment(aes(xend = lx, y = 0, yend = y * 0.8), colour = "grey60", linewidth = 0.4) +
  geom_point(aes(y = 0, colour = rodzaj, shape = rodzaj), size = 3.2) +
  geom_label(aes(x = lx, y = y, label = paste0(rok, "\n", opis), colour = rodzaj), size = 3.1,
             lineheight = 0.9, linewidth = 0.25, fill = "white", show.legend = FALSE) +
  scale_colour_manual(values = unname(kol[c("stanowisko", "praca")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = seq(1890, 1980, 10), limits = c(1886, 1987)) +
  scale_y_continuous(limits = c(-2.6, 2.6)) +
  labs(x = NULL, y = NULL) + motyw +
  theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# Rysunek 2: 2000 prób po 200 szkół w każdym schemacie – rozkład oszacowanej średniej liczby uczniów
data(api, package = "survey")
pop <- subset(apipop, !is.na(enroll))
N_h <- c(table(pop$stype)); S_h <- tapply(pop$enroll, pop$stype, sd); W_h <- N_h / sum(N_h); n <- 200
n_prop <- round(n * N_h / sum(N_h)); n_ney <- round(n * N_h * S_h / sum(N_h * S_h))
warstwowa <- function(n_h) {
  idx <- unlist(lapply(names(n_h), function(h) sample(which(pop$stype == h), n_h[[h]])))
  sum(W_h * tapply(pop$enroll[idx], as.character(pop$stype[idx]), mean)[names(n_h)])
}
set.seed(797)
est <- data.frame(
  schemat = rep(c("proste", "proporcjonalna", "Neymana"), each = 2000),
  srednia = c(replicate(2000, mean(sample(pop$enroll, n))),
              replicate(2000, warstwowa(n_prop)), replicate(2000, warstwowa(n_ney))))
podpisy <- c(proste = "Losowanie proste (200 szkół)",
             proporcjonalna = sprintf("Warstwowe proporcjonalne (E %d, H %d, M %d)", n_prop[["E"]], n_prop[["H"]], n_prop[["M"]]),
             Neymana = sprintf("Warstwowe z alokacją Neymana (E %d, H %d, M %d)", n_ney[["E"]], n_ney[["H"]], n_ney[["M"]]))
est$schemat <- factor(est$schemat, levels = names(podpisy), labels = podpisy)
sd_tab <- aggregate(srednia ~ schemat, est, sd)
sd_tab$etykieta <- sprintf("SD oszacowań = %.1f", sd_tab$srednia)
sd_tab[, c("schemat", "etykieta")]
p2 <- ggplot(est, aes(srednia, fill = schemat)) +
  geom_histogram(binwidth = 5, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = mean(pop$enroll), linetype = "dashed", colour = "grey20") +
  geom_text(data = sd_tab, aes(x = 700, y = Inf, label = etykieta), inherit.aes = FALSE,
            hjust = 1, vjust = 1.6, size = 3.8) +
  facet_wrap(~ schemat, ncol = 1) +
  scale_fill_manual(values = unname(kol[c("proste", "proporcjonalna", "Neymana")]), guide = "none") +
  coord_cartesian(xlim = c(520, 720)) +
  labs(x = "Oszacowana średnia liczba uczniów w szkole (linia przerywana: średnia populacji)",
       y = "Liczba prób") + motyw

p1   # zapis: ggsave("jerzy-neyman-os-czasu.svg", p1, width = 10, height = 4.6)
p2   # zapis: ggsave("jerzy-neyman-alokacja.svg", p2, width = 9, height = 6.4)
Wynik w R
                                          schemat            etykieta
1                    Losowanie proste (200 szkół) SD oszacowań = 33.3
2    Warstwowe proporcjonalne (E 143, H 24, M 33) SD oszacowań = 23.4
3 Warstwowe z alokacją Neymana (E 89, H 60, M 51) SD oszacowań = 19.6
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (alokacja, błędy standardowe i symulacja – funkcje bazowe, sample(); dane – pakiet survey; rysunki – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Kim był Jerzy Neyman?
Statystykiem i matematykiem (1894–1981), współtwórcą teorii testowania hipotez z Egonem Pearsonem i twórcą teorii przedziałów ufności. Pracował w Bydgoszczy i Warszawie, w latach 1934–1938 w University College London, a od 1938 r. w Berkeley, gdzie zbudował jeden z najważniejszych ośrodków statystyki.
Czy Jerzy Neyman był Polakiem?
Urodził się w 1894 r. w Benderach, wówczas w Rosji, w rodzinie polskiego pochodzenia, a pełne nazwisko Spława-Neyman wiązało się z polską szlachtą. Od 1921 r. pracował w Polsce, później w Londynie i Berkeley, a w 1950 i 1958 r. konsultował badania GUS.
Co to jest alokacja Neymana?
Sposób rozdziału próby w losowaniu warstwowym: liczba jednostek z warstwy jest proporcjonalna do iloczynu jej wielkości i odchylenia standardowego badanej cechy. Przy tej samej liczebności daje najmniejszy błąd oszacowania średniej; w naszym przykładzie SE spadł z 23.3 (alokacja proporcjonalna) do 19.4.
Czym podejście Neymana różni się od podejścia Fishera?
Neyman i Pearson traktowali test jako regułę decyzji między dwiema hipotezami z ustalonymi z góry α i mocą, Fisher – wartość p jako miarę dowodów przeciw hipotezie zerowej. Spór trwał od 1935 r. do końca ich życia, choć w praktyce oba podejścia się uzupełniają (Lehmann, 1993).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Schematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →PoradnikPrzedział ufności w obrazkach
Sto przedziałów na jednym wykresie, szerokość a liczebność, poziom ufności, skośne dane, SD i przedział predykcji – sześć symulacji z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kordos, J. (2012). Współzależność pomiędzy rozwojem teorii i praktyki badań reprezentacyjnych w Polsce. Przegląd Statystyczny, 2012(SI1), 61–86. https://doi.org/10.59139/ps.2012.si1.4 ● Otwarty dostęp
- Lehmann, E. L. (1993). The Fisher, Neyman-Pearson theories of testing hypotheses: One theory or two? Journal of the American Statistical Association, 88(424), 1242–1249. https://doi.org/10.1080/01621459.1993.10476404
- Lehmann, E. L. (1994). Jerzy Neyman, April 16, 1894–August 5, 1981. In Biographical memoirs (Vol. 63) (pp. 394–421). National Academy Press. https://www.nationalacademies.org/read/4560/chapter/19 ● Otwarty dostęp
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694–706), 289–337. https://doi.org/10.1098/rsta.1933.0009 ● Otwarty dostęp
Cytowania BibTeX
@article{kordos2012wspolzaleznosc, author={Kordos, Jan}, title={{Współzależność pomiędzy rozwojem teorii i praktyki badań reprezentacyjnych w Polsce}}, journal={Przegląd Statystyczny}, year={2012}, volume={2012}, number={SI1}, pages={61--86}, doi={10.59139/ps.2012.si1.4}}@article{lehmann1993fisher, author={Lehmann, E. L.}, title={{The Fisher, Neyman-Pearson theories of testing hypotheses: One theory or two?}}, journal={Journal of the American Statistical Association}, year={1993}, volume={88}, number={424}, pages={1242--1249}, doi={10.1080/01621459.1993.10476404}}@incollection{lehmann1994jerzy, author={Lehmann, E. L.}, title={{Jerzy Neyman, April 16, 1894–August 5, 1981}}, booktitle={Biographical memoirs (Vol. 63)}, year={1994}, pages={394--421}, publisher={National Academy Press}, url={https://www.nationalacademies.org/read/4560/chapter/19}}@article{neyman1934two, author={Neyman, Jerzy}, title={{On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection}}, journal={Journal of the Royal Statistical Society}, year={1934}, volume={97}, number={4}, pages={558--625}, doi={10.2307/2342192}}@article{neyman1937outline, author={Neyman, Jerzy}, title={{Outline of a theory of statistical estimation based on the classical theory of probability}}, journal={Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences}, year={1937}, volume={236}, number={767}, pages={333--380}, doi={10.1098/rsta.1937.0005}}@article{neyman1933problem, author={Neyman, Jerzy and Pearson, Egon S.}, title={{On the problem of the most efficient tests of statistical hypotheses}}, journal={Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character}, year={1933}, volume={231}, number={694–706}, pages={289--337}, doi={10.1098/rsta.1933.0009}}