Co naprawdę znaczy „95%”
Definicję, wzór i zapis APA znajdziesz w haśle przedział ufności, a ogólny przepis na przedziały dla różnych parametrów – w haśle estymacja przedziałowa. Tu pokazujemy to samo na rysunkach: setki przedziałów z badań, które mogłyby się odbyć. Dopiero wtedy widać, że „95%” dotyczy metody, a nie konkretnego przedziału z Twojej pracy.
Punktem wyjścia jest fikcyjna populacja wyników w skali T o znanej średniej μ = 50 i odchyleniu standardowym σ = 10. W prawdziwym badaniu tej wiedzy nie masz. Każde „badanie” to losowa próba 30 osób. Z każdej liczymy średnią i 95% przedział ufności: średnia ± t × SE, gdzie SE to błąd standardowy, a t pochodzi z rozkładu t-Studenta.
Odsetki z symulacji opieramy na 10 000 powtórzeń i podajemy z błędem Monte Carlo √(p(1 − p)/10 000) – przy 95% to około 0.2 punktu procentowego (pp). Ziarno (566) ustaliliśmy raz, bez dobierania pod ładny obraz. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy. Ogólne zasady rysowania są we wpisie wykresy w pracy dyplomowej.
Rysunek 1: 100 badań, około 95 trafień
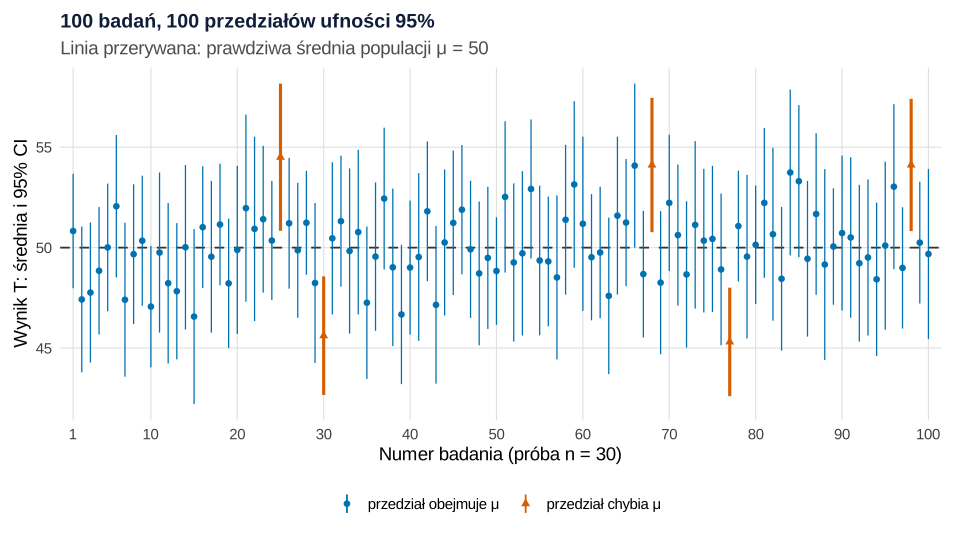
set.seed(566)).Co widać. Każdy odcinek to jedno badanie. 95 przedziałów przecina linię μ = 50, a 5 jej nie przecina: trzy leżą w całości powyżej (badania 25, 68 i 98), dwa poniżej (30 i 77). Szerokość waha się od 5.17 do 9.49 punktu, bo w każdej próbie wypada inne odchylenie standardowe. W 10 000 powtórzeń przedział objął μ w 95.62% badań (błąd Monte Carlo 0.20 pp), a chybienia rozłożyły się po równo: 2.32% w dół i 2.06% w górę. Wynik 95.62% leży około trzech błędów Monte Carlo nad 95% – to przypadek: w kolejnych 100 000 powtórzeń pokrycie wyniosło 94.98% (błąd 0.07 pp).
Czego ten wykres nie pokazuje. Tego, który przedział jest Twój. W badaniu masz jeden odcinek bez koloru – kolor nadałby mu tylko ktoś, kto zna μ. Pięć chybień na sto to też przypadek. Rysunek pokazuje idealne warunki: losowanie z populacji o rozkładzie normalnym. Przy próbie wygodnej przedział może stale chybiać w tę samą stronę.
Podpis do pracy (np. w aneksie albo prezentacji na obronę):
Zdanie do Wyników (w pracy, w której sam prowadzisz symulację):
Kod rysunku 1: sto przedziałów i pokrycie z 10 000 powtórzeń
Kod uruchamiaj po kolei w jednej sesji R – kolejne bloki korzystają z obiektów z bloku 1 (motyw motyw, paleta kol, funkcja ci_t()). Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG (w kodzie – zakomentowane wywołanie ggsave()). Każdy blok zaczyna od set.seed(566), więc da się go powtórzyć niezależnie od pozostałych. Sto przedziałów z rysunku 1 pobierzesz też jako plik przedzial-ufnosci-100-badan.csv (dane symulowane).
1. Motyw, paleta, funkcja przedziału t i 100 badań
R
# Rysunek 1. 100 prób z jednej populacji, 100 przedziałów ufności 95% (populacja fikcyjna: wynik T, μ = 50, σ = 10)
library(ggplot2)

# Motyw i paleta (Okabe–Ito: niebieski i cynober są rozróżnialne także przy deuteranopii)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.caption = element_text(colour = "grey30", hjust = 0),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
kol <- c(obejmuje = "#0072B2", chybia = "#D55E00", jasny = "#56B4E9", ciemny = "grey25")

mu <- 50; sigma <- 10; n <- 30; R <- 10000      # populacja fikcyjna i liczba powtórzeń symulacji
ci_t <- function(x, poziom = .95) {             # przedział t dla średniej
  m <- mean(x); se <- sd(x) / sqrt(length(x)); q <- qt(1 - (1 - poziom) / 2, length(x) - 1)
  c(srednia = m, dolna = m - q * se, gorna = m + q * se)
}

set.seed(566)                                   # ziarno ustalone raz, bez dobierania pod wynik
d1 <- data.frame(proba = 1:100, t(replicate(100, ci_t(rnorm(n, mu, sigma)))))
d1$wynik <- ifelse(d1$dolna > mu | d1$gorna < mu, "chybia", "obejmuje")
table(d1$wynik)
d1[d1$wynik == "chybia", ] |> transform(srednia = round(srednia, 2), dolna = round(dolna, 2), gorna = round(gorna, 2))
round(range(d1$gorna - d1$dolna), 2)            # najwęższy i najszerszy przedział

# Pokrycie w 10 000 powtórzeń i błąd Monte Carlo
X <- matrix(rnorm(R * n, mu, sigma), nrow = R)  # każdy wiersz to jedno badanie
m <- rowMeans(X); se <- sqrt((rowSums(X^2) - n * m^2) / (n - 1)) / sqrt(n)
q <- qt(.975, n - 1)
pokrycie <- mean(abs(m - mu) <= q * se)
round(c(pokrycie_proc = 100 * pokrycie, blad_MC_pp = 100 * sqrt(pokrycie * (1 - pokrycie) / R),
        za_nisko_proc = 100 * mean(m + q * se < mu), za_wysoko_proc = 100 * mean(m - q * se > mu)), 2)
# kontrola: 100 000 kolejnych powtórzeń (ten sam strumień losowań, bez nowego ziarna)
X2 <- matrix(rnorm(10 * R * n, mu, sigma), nrow = 10 * R)
m2 <- rowMeans(X2); se2 <- sqrt((rowSums(X2^2) - n * m2^2) / (n - 1)) / sqrt(n)
pokrycie2 <- mean(abs(m2 - mu) <= q * se2)
round(c(pokrycie_100k_proc = 100 * pokrycie2, blad_MC_pp = 100 * sqrt(pokrycie2 * (1 - pokrycie2) / (10 * R))), 2)

p1 <- ggplot(d1, aes(proba, srednia, colour = wynik, shape = wynik)) +
  geom_hline(yintercept = mu, linetype = "dashed", colour = "grey20") +
  geom_linerange(aes(ymin = dolna, ymax = gorna, linewidth = wynik)) +
  geom_point(size = 1.9) +
  scale_colour_manual(values = kol, breaks = c("obejmuje", "chybia"),
                      labels = c("przedział obejmuje μ", "przedział chybia μ"), name = NULL) +
  scale_shape_manual(values = c(obejmuje = 16, chybia = 17), breaks = c("obejmuje", "chybia"),
                     labels = c("przedział obejmuje μ", "przedział chybia μ"), name = NULL) +
  scale_linewidth_manual(values = c(obejmuje = 0.45, chybia = 1.1), guide = "none") +
  scale_x_continuous(breaks = c(1, seq(10, 100, 10)), expand = expansion(add = 1.5)) +
  labs(x = "Numer badania (próba n = 30)", y = "Wynik T: średnia i 95% CI",
       title = "100 badań, 100 przedziałów ufności 95%",
       subtitle = "Linia przerywana: prawdziwa średnia populacji μ = 50") + motyw
# p1   # wyświetl; zapis: ggsave("przedzial-ufnosci-100-badan.svg", p1, width = 10, height = 5.6)
Wynik w R
  chybia obejmuje
       5       95
   proba srednia dolna gorna  wynik
25    25   54.50 50.84 58.16 chybia
30    30   45.62 42.67 48.57 chybia
68    68   54.11 50.77 57.45 chybia
77    77   45.31 42.61 48.01 chybia
98    98   54.11 50.82 57.40 chybia
[1] 5.17 9.49
 pokrycie_proc     blad_MC_pp  za_nisko_proc za_wysoko_proc
         95.62           0.20           2.32           2.06
pokrycie_100k_proc         blad_MC_pp
             94.98               0.07
„95% szans, że μ jest w przedziale” – dlaczego to błąd
Zanim wylosujesz próbę, prawdopodobieństwo, że metoda da przedział obejmujący μ, wynosi .95 – to 95 niebieskich odcinków na sto. Po obliczeniu masz jeden przedział, np. z badania 1: [47.98, 53.67]. Średnia populacji leży w nim albo nie leży, a Twoja niewiedza nie zamienia się w „95% prawdopodobieństwa”. Morey i in. (2016) pokazują, że poziom ufności nie wyraża prawdopodobieństwa, że parametr leży w konkretnym przedziale. Błąd jest powszechny: w badaniu, które opisali Hoekstra i in. (2014), 120 badaczy i 442 studentów psychologii akceptowało średnio ponad trzy z sześciu fałszywych stwierdzeń o przedziale ufności. Greenland i in. (2016) zebrali typowe błędne interpretacje przedziałów, wartości p i mocy w jednym przewodniku.
- Źle: „Z prawdopodobieństwem 95% średnia populacji leży między 47.98 a 53.67”. Dobrze: „95% CI [47.98, 53.67] obliczono metodą, która w 95% prób obejmuje średnią populacji”.
- Źle: „95% osób ma wynik w tym przedziale”. Dobrze: przedział dotyczy średniej, a nie osób – wyniki osób opisuje SD albo przedział predykcji (rysunek 5).
W pracy wystarczy: „dane są zgodne ze średnią populacji od 47.98 do 53.67 punktu”. Więcej sformułowań jest we wpisie przedziały ufności w pracy dyplomowej, a związek przedziału z testem – w tekście wartość p – interpretacja.
Rysunek 2: n = 20, 100 i 500
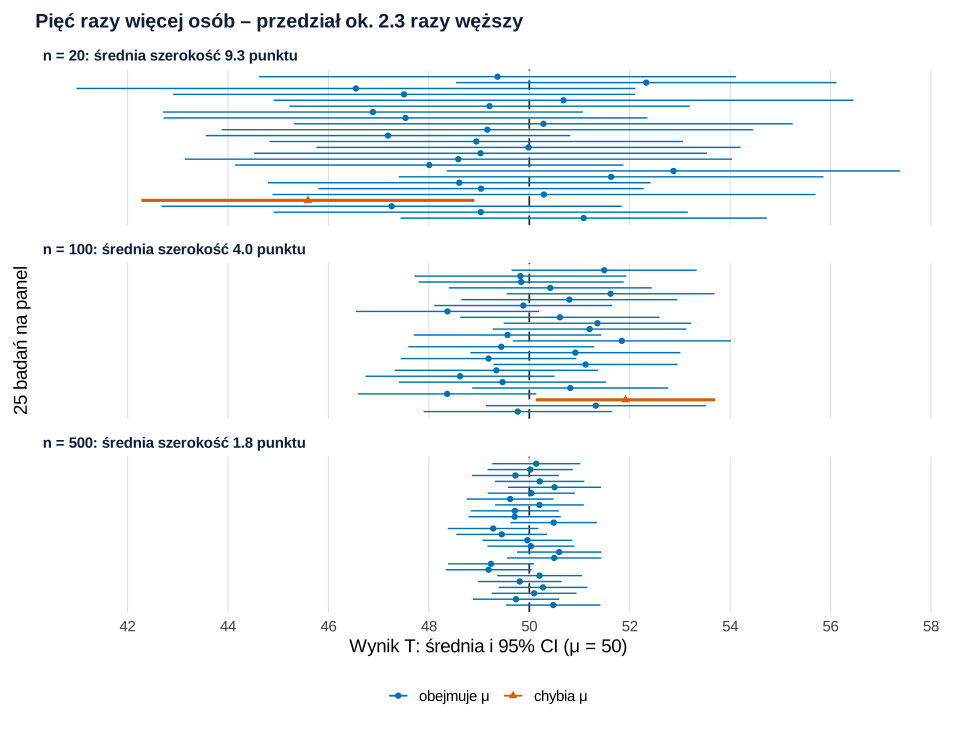
Co widać. Średnia szerokość wynosi 9.26 punktu przy n = 20, 3.96 przy n = 100 i 1.76 przy n = 500. Pięć razy więcej osób daje przedział węższy 2.34 raza (z 20 do 100) i 2.26 raza (ze 100 do 500), czyli mniej więcej √5 = 2.24 raza. Przy małych próbach zysk jest nieco większy, bo maleje też wartość krytyczna t. Połowę szerokości „kupujesz” za cztery razy więcej osób. Pokrycie się nie zmienia (95.38%, 95.34% i 94.72%) – liczebność decyduje o szerokości przedziału, a nie o odsetku trafień.
Czego ten wykres nie pokazuje. Błędów niezależnych od n. Przy nielosowej próbie albo błędzie systematycznym pomiaru 500 osób da wąski przedział wokół złej wartości. Przy większym σ wszystkie przedziały będą proporcjonalnie szersze. Liczebność z wymaganej szerokości przedziału policzysz według wpisu liczebność próby z precyzji (AIPE), a przedział dla gotowego wyniku – w kalkulatorze przedziału ufności. Dla odsetków reguła pierwiastka działa podobnie, ale metoda liczenia jest inna (przedział ufności dla proporcji).
Podpis do pracy:
Zdanie do pracy (uzasadnienie liczebności w Metodzie):
Kod rysunku 2: szerokość przy n = 20, 100 i 500
2. Ta sama populacja, trzy liczebności
R
# Rysunek 2. Szerokość przedziału przy n = 20, 100 i 500 (kontynuacja: mu, sigma, R, ci_t, kol, motyw)
set.seed(566)                                   # to samo ziarno co w bloku 1
ns <- c(20, 100, 500)
d2 <- do.call(rbind, lapply(ns, function(k)
  data.frame(n = k, proba = 1:25, t(replicate(25, ci_t(rnorm(k, mu, sigma)))))))
d2$wynik <- ifelse(d2$dolna > mu | d2$gorna < mu, "chybia", "obejmuje")

# średnia szerokość z 10 000 powtórzeń dla każdego n i szerokość ze wzoru 2 × t × σ / √n
szer <- sapply(ns, function(k) {
  X <- matrix(rnorm(R * k, mu, sigma), nrow = R)
  m <- rowMeans(X); s <- sqrt((rowSums(X^2) - k * m^2) / (k - 1))
  c(n = k, srednia_szerokosc = mean(2 * qt(.975, k - 1) * s / sqrt(k)),
    wzor_sigma = 2 * qt(.975, k - 1) * sigma / sqrt(k), pokrycie_proc = 100 * mean(abs(m - mu) <= qt(.975, k - 1) * s / sqrt(k)))
})
round(t(szer), 2)
round(c(stosunek_20_do_100 = unname(szer[2, 1] / szer[2, 2]), stosunek_100_do_500 = unname(szer[2, 2] / szer[2, 3]),
        pierwiastek_z_5 = sqrt(5)), 2)

etykiety <- setNames(sprintf("n = %d: średnia szerokość %.1f punktu", ns, szer[2, ]), ns)
p2 <- ggplot(d2, aes(srednia, proba, colour = wynik, shape = wynik)) +
  geom_vline(xintercept = mu, linetype = "dashed", colour = "grey20") +
  geom_linerange(aes(xmin = dolna, xmax = gorna, linewidth = wynik)) +
  geom_point(size = 1.8) +
  facet_wrap(~ n, ncol = 1, labeller = as_labeller(etykiety)) +
  scale_colour_manual(values = kol, breaks = c("obejmuje", "chybia"),
                      labels = c("obejmuje μ", "chybia μ"), name = NULL) +
  scale_shape_manual(values = c(obejmuje = 16, chybia = 17), breaks = c("obejmuje", "chybia"),
                     labels = c("obejmuje μ", "chybia μ"), name = NULL) +
  scale_linewidth_manual(values = c(obejmuje = 0.5, chybia = 1.1), guide = "none") +
  scale_x_continuous(breaks = seq(40, 60, 2)) +
  scale_y_continuous(breaks = NULL) +
  labs(x = "Wynik T: średnia i 95% CI (μ = 50)", y = "25 badań na panel",
       title = "Pięć razy więcej osób – przedział ok. 2.3 razy węższy") + motyw +
  theme(strip.text = element_text(hjust = 0))
# p2   # zapis: ggsave("przedzial-ufnosci-szerokosc-a-n.svg", p2, width = 10, height = 7.6)
Wynik w R
       n srednia_szerokosc wzor_sigma pokrycie_proc
[1,]  20              9.26       9.36         95.38
[2,] 100              3.96       3.97         95.34
[3,] 500              1.76       1.76         94.72
 stosunek_20_do_100 stosunek_100_do_500     pierwiastek_z_5
               2.34                2.26                2.24
Rysunek 3: poziom ufności 90%, 95% i 99%
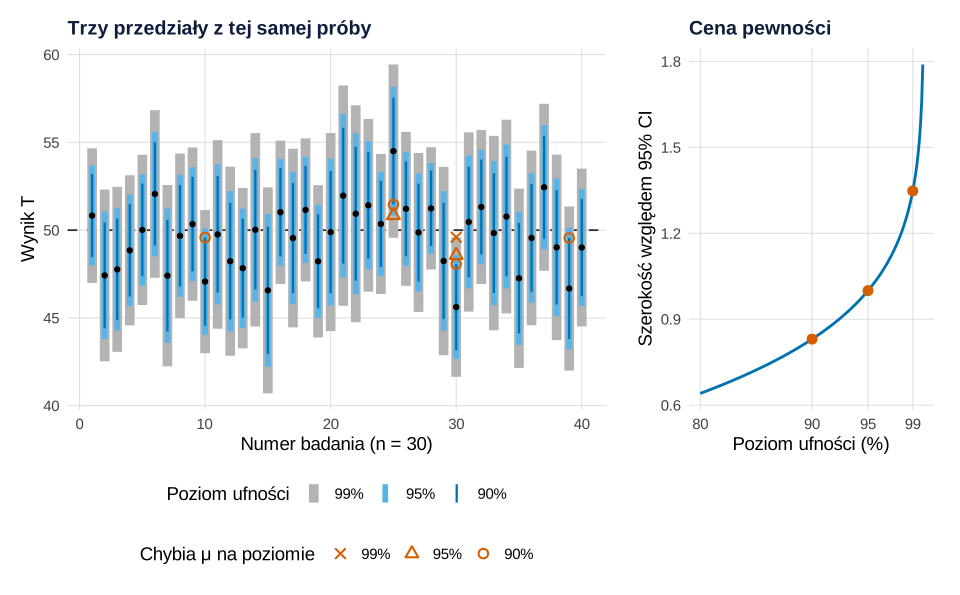
Co widać. Trzy przedziały z jednej próby mają wspólny środek i różnią się tylko mnożnikiem t. Wśród 40 prób przedział 90% chybia μ czterokrotnie, 95% – dwukrotnie (badania 25 i 30, te same co na rysunku 1), a 99% – raz. W 10 000 powtórzeń pokrycie wyniosło 90.55%, 95.57% i 99.15% (błędy Monte Carlo 0.29, 0.21 i 0.09 pp), czyli tyle, ile obiecuje nazwa. Ceną jest szerokość: przy n = 30 przedział 99% jest 1.35 raza szerszy od 95%, a 90% stanowi 0.83 jego szerokości. Koszt rośnie coraz szybciej (prawy panel).
Czego ten wykres nie pokazuje. Który poziom wybrać. W psychologii standardem jest 95%, spójne z poziomem istotności α = .05: przedział 95% wyklucza dokładnie te wartości, które dwustronny test na tym poziomie by odrzucił. Poziom ustal przed analizą i nie zmieniaj go po obejrzeniu wyników, np. na 90%, żeby przedział „nie obejmował zera”.
Podpis do pracy:
Zdanie do pracy (Metoda, opis analiz):
Kod rysunku 3: poziomy 90%, 95% i 99%
3. Trzy przedziały z każdej próby i cena pewności
R
# Rysunek 3. Te same próby, trzy poziomy ufności: 90%, 95% i 99% (kontynuacja: mu, sigma, n, R, ci_t, kol, motyw)
library(patchwork)
set.seed(566)                                   # to samo ziarno: pierwsze 40 prób to te same próby co na rysunku 1
poziomy <- c(.90, .95, .99)
proby3 <- replicate(40, rnorm(n, mu, sigma), simplify = FALSE)
d3 <- do.call(rbind, lapply(poziomy, function(pz) data.frame(proba = 1:40, poziom = sprintf("%d%%", 100 * pz),
                                                             t(sapply(proby3, ci_t, poziom = pz)))))
d3$chybia <- d3$dolna > mu | d3$gorna < mu
tapply(d3$chybia, d3$poziom, sum)               # ile z 40 przedziałów chybia na każdym poziomie

# pokrycie z 10 000 powtórzeń (błąd MC) i szerokość względem 95%
X <- matrix(rnorm(R * n, mu, sigma), nrow = R)
m <- rowMeans(X); se <- sqrt((rowSums(X^2) - n * m^2) / (n - 1)) / sqrt(n)
pokr <- sapply(poziomy, function(pz) mean(abs(m - mu) <= qt(1 - (1 - pz) / 2, n - 1) * se))
round(rbind(pokrycie_proc = 100 * pokr, blad_MC_pp = 100 * sqrt(pokr * (1 - pokr) / R),
            szerokosc_wzgledem_95 = qt(1 - (1 - poziomy) / 2, n - 1) / qt(.975, n - 1)), 2)

d3$poziom <- factor(d3$poziom, levels = c("99%", "95%", "90%"))
d3 <- d3[order(d3$poziom), ]                    # najszerszy rysowany pierwszy, najwęższy na wierzchu
p3a <- ggplot(d3, aes(proba)) +
  geom_hline(yintercept = mu, linetype = "dashed", colour = "grey20") +
  geom_linerange(aes(ymin = dolna, ymax = gorna, colour = poziom, linewidth = poziom)) +
  geom_point(data = subset(d3, poziom == "95%"), aes(y = srednia), size = 1.4, colour = "black") +
  geom_point(data = subset(d3, chybia), aes(y = ifelse(dolna > mu, dolna, gorna), shape = poziom),
             size = 2.6, colour = kol[["chybia"]], stroke = 1.1) +
  scale_colour_manual(values = c(`99%` = "grey70", `95%` = kol[["jasny"]], `90%` = kol[["obejmuje"]]), name = "Poziom ufności") +
  scale_linewidth_manual(values = c(`99%` = 3.4, `95%` = 2, `90%` = 0.8), name = "Poziom ufności") +
  scale_shape_manual(values = c(`99%` = 4, `95%` = 2, `90%` = 1), name = "Chybia μ na poziomie", drop = TRUE) +
  labs(x = "Numer badania (n = 30)", y = "Wynik T", title = "Trzy przedziały z tej samej próby") + motyw +
  theme(legend.box = "vertical")
pz_siatka <- seq(.80, .999, by = .001)
d3b <- data.frame(poziom = 100 * pz_siatka, wzgledna = qt(1 - (1 - pz_siatka) / 2, n - 1) / qt(.975, n - 1))
p3b <- ggplot(d3b, aes(poziom, wzgledna)) +
  geom_line(colour = kol[["obejmuje"]], linewidth = 1) +
  geom_point(data = data.frame(poziom = 100 * poziomy, wzgledna = qt(1 - (1 - poziomy) / 2, n - 1) / qt(.975, n - 1)),
             size = 3, colour = kol[["chybia"]]) +
  scale_x_continuous(breaks = c(80, 90, 95, 99)) +
  labs(x = "Poziom ufności (%)", y = "Szerokość względem 95% CI", title = "Cena pewności") + motyw
p3 <- p3a + p3b + plot_layout(widths = c(2.2, 1))
# p3   # zapis: ggsave("przedzial-ufnosci-poziom-90-95-99.svg", p3, width = 10, height = 6.2)
Wynik w R
90% 95% 99%
  4   2   1
                       [,1]  [,2]  [,3]
pokrycie_proc         90.55 95.57 99.15
blad_MC_pp             0.29  0.21  0.09
szerokosc_wzgledem_95  0.83  1.00  1.35
Rysunek 4: skośna populacja i mała próba
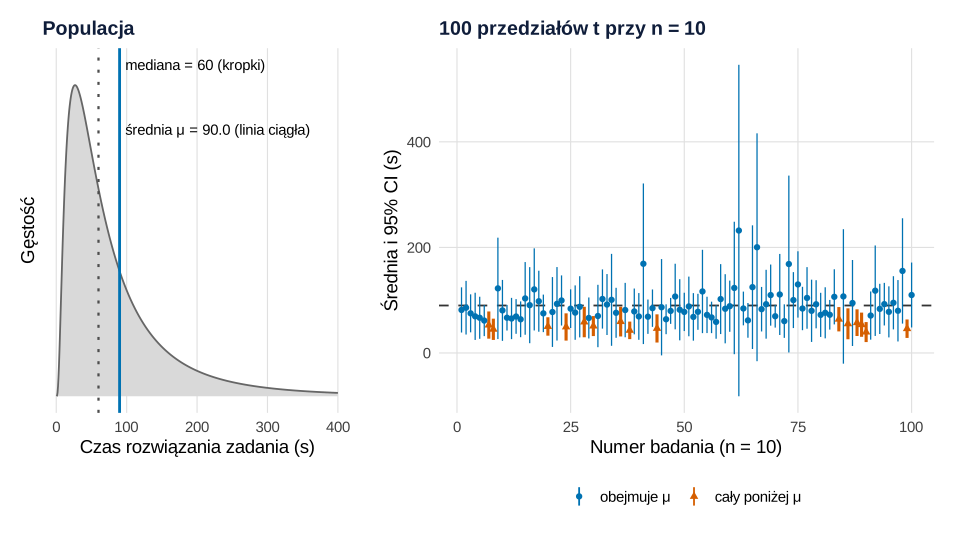
Co widać. Fikcyjny czas rozwiązania zadania ma medianę 60 s, średnią μ = 89.96 s i skośność 4.75. Przy 10 osobach 85 ze 100 przedziałów obejmuje μ, a wszystkie 15 chybień leży poniżej. W 10 000 powtórzeń pokrycie wyniosło 85.55% (błąd Monte Carlo 0.35 pp): 14.26% przedziałów było za nisko i tylko 0.19% za wysoko. Przy 30 osobach pokrycie wzrosło do 89.80%, przy 100 – do 92.79%, ale chybienia w dół wciąż przeważały (6.61% wobec 0.60%). Mała próba z długim prawym ogonem zwykle nie zawiera rzadkich, bardzo dużych wartości, więc zaniża średnią i SD jednocześnie – przedział jest za krótki i przesunięty w dół.
Czego ten wykres nie pokazuje. To jeden, celowo skrajny rozkład; przy umiarkowanej skośności przedział t radzi sobie dużo lepiej. Szerzej – z symulacją dla kilku populacji – piszemy o tym we wpisie o centralnym twierdzeniu granicznym. Alternatywy, np. bootstrap albo przedział dla mediany, odpowiadają na nieco inne pytanie albo też słabną przy 10 osobach – nie traktuj ich jak automatycznej naprawy.
Podpis do pracy:
Zdanie do pracy (ograniczenia, gdy masz małą próbę i skośne dane):
Kod rysunku 4: skośna populacja i mała próba
4. Rozkład log-normalny, n = 10, 30 i 100
R
# Rysunek 4. Skośna populacja i mała próba: przedział t chybia częściej i w jedną stronę (kontynuacja: R, ci_t, kol, motyw)
library(patchwork)
set.seed(566)
ml <- log(60); sl <- 0.9                         # fikcyjny czas rozwiązania zadania (s): rozkład log-normalny
mu_s <- exp(ml + sl^2 / 2)                       # prawdziwa średnia populacji
round(c(srednia_mu = mu_s, mediana = exp(ml), skosnosc = (exp(sl^2) + 2) * sqrt(exp(sl^2) - 1)), 2)

d4 <- data.frame(proba = 1:100, t(replicate(100, ci_t(rlnorm(10, ml, sl)))))
d4$wynik <- ifelse(d4$gorna < mu_s, "za nisko", ifelse(d4$dolna > mu_s, "za wysoko", "obejmuje"))
table(d4$wynik)

# pokrycie przedziału t przy n = 10, 30 i 100 (10 000 powtórzeń dla każdego n) i kierunek chybień
pokr4 <- sapply(c(10, 30, 100), function(k) {
  X <- matrix(rlnorm(R * k, ml, sl), nrow = R)
  m <- rowMeans(X); se <- sqrt((rowSums(X^2) - k * m^2) / (k - 1)) / sqrt(k); q <- qt(.975, k - 1)
  p <- mean(abs(m - mu_s) <= q * se)
  c(n = k, pokrycie_proc = 100 * p, blad_MC_pp = 100 * sqrt(p * (1 - p) / R),
    za_nisko_proc = 100 * mean(m + q * se < mu_s), za_wysoko_proc = 100 * mean(m - q * se > mu_s))
})
round(t(pokr4), 2)

x <- seq(0.5, 400, length.out = 600)
p4a <- ggplot(data.frame(x, g = dlnorm(x, ml, sl)), aes(x, g)) +
  geom_area(fill = "grey85", colour = "grey40") +
  geom_vline(xintercept = mu_s, colour = kol[["obejmuje"]], linewidth = 1) +
  geom_vline(xintercept = exp(ml), colour = "grey30", linetype = "dotted", linewidth = 0.8) +
  annotate("text", x = mu_s + 8, y = 0.0095, label = sprintf("średnia μ = %.1f (linia ciągła)", mu_s), hjust = 0, size = 3.9) +
  annotate("text", x = mu_s + 8, y = 0.0118, label = sprintf("mediana = %.0f (kropki)", exp(ml)), hjust = 0, size = 3.9) +
  scale_y_continuous(breaks = NULL) +
  labs(x = "Czas rozwiązania zadania (s)", y = "Gęstość", title = "Populacja") + motyw
p4b <- ggplot(d4, aes(proba, srednia, colour = wynik, shape = wynik)) +
  geom_hline(yintercept = mu_s, linetype = "dashed", colour = "grey20") +
  geom_linerange(aes(ymin = dolna, ymax = gorna, linewidth = wynik)) +
  geom_point(size = 1.8) +
  scale_colour_manual(values = c(obejmuje = kol[["obejmuje"]], `za nisko` = kol[["chybia"]], `za wysoko` = "black"),
                      breaks = c("obejmuje", "za nisko", "za wysoko"), name = NULL,
                     labels = c("obejmuje μ", "cały poniżej μ", "cały powyżej μ")) +
  scale_shape_manual(values = c(obejmuje = 16, `za nisko` = 17, `za wysoko` = 15),
                     breaks = c("obejmuje", "za nisko", "za wysoko"), name = NULL,
                     labels = c("obejmuje μ", "cały poniżej μ", "cały powyżej μ")) +
  scale_linewidth_manual(values = c(obejmuje = 0.45, `za nisko` = 1.1, `za wysoko` = 1.1), guide = "none") +
  labs(x = "Numer badania (n = 10)", y = "Średnia i 95% CI (s)", title = "100 przedziałów t przy n = 10") + motyw
p4 <- p4a + p4b + plot_layout(widths = c(1, 1.6))
# p4   # zapis: ggsave("przedzial-ufnosci-skosna-populacja.svg", p4, width = 10, height = 5.6)
Wynik w R
srednia_mu    mediana   skosnosc
     89.96      60.00       4.75

obejmuje za nisko
      85       15
       n pokrycie_proc blad_MC_pp za_nisko_proc za_wysoko_proc
[1,]  10         85.55       0.35         14.26           0.19
[2,]  30         89.80       0.30          9.99           0.21
[3,] 100         92.79       0.26          6.61           0.60
Rysunek 5: trzy różne „wąsy” wokół jednej średniej
Cumming, Fidler i Vaux (2007) podkreślają, że słupki błędów mogą pokazywać przedziały ufności, błędy standardowe albo odchylenia standardowe, a każdy typ niesie inną informację. Na rysunku 5 obok przedziału ufności i ±1 SD stoi trzeci wąs – 95% przedział predykcji dla wyniku jednej nowej osoby:
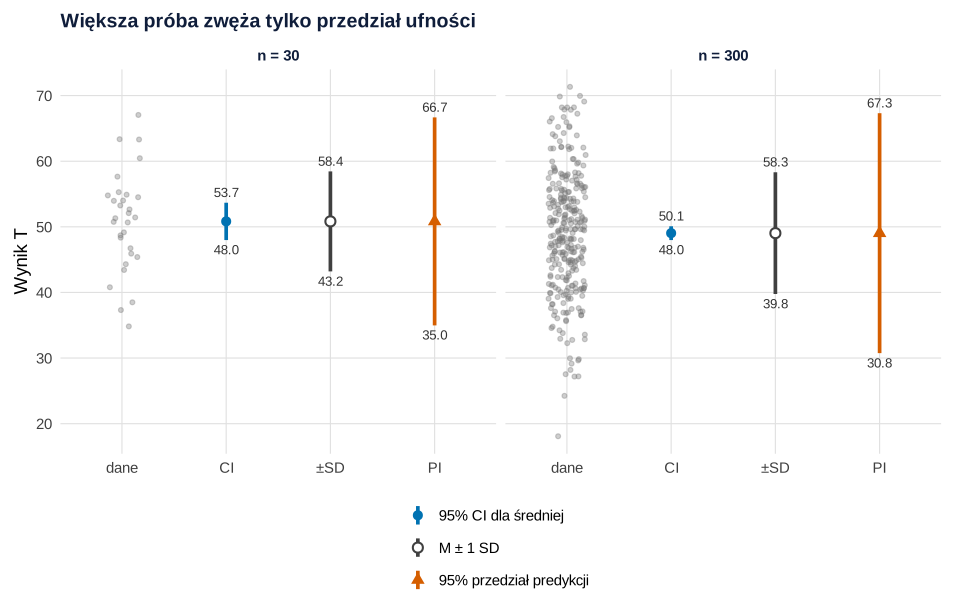
Co widać. Przy 30 osobach (M = 50.83, SD = 7.62) przedział ufności ma 5.69 punktu szerokości, ±1 SD – 15.24, a przedział predykcji – 31.69. Przy 300 osobach (M = 49.04, SD = 9.27) przedział ufności skurczył się do 2.11 punktu, ale ±1 SD (18.55) i przedział predykcji (36.57) wcale się nie zwęziły (w mniejszej próbie SD wypadło akurat niższe niż σ = 10). Większa próba dokładniej szacuje średnią, ale ludzie nie stają się przez to podobniejsi. W 10 000 badań po 30 osób, każde z jedną dodatkową osobą z populacji: przedział ufności objął μ w 95.52%, a wynik nowej osoby – tylko w 28.53%; przedział predykcji objął wynik nowej osoby w 95.57%, a ±1 SD – w 66.69% (błędy Monte Carlo 0.21–0.47 pp).
Czego ten wykres nie pokazuje. Przedział predykcji z tego wzoru zakłada rozkład normalny wyników – przy danych z rysunku 4 byłby błędny. W regresji odpowiednikiem jest pasmo predykcji wokół linii; porównanie z pasmem ufności znajdziesz we wpisie wynik regresji na wykresie. Słupki ±SE omawiamy we wpisie od słupka do raincloud, a odchylenie standardowe – w słowniku.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 5: przedział ufności, SD i przedział predykcji
5. Trzy „wąsy” i to, co każdy z nich obejmuje
R
# Rysunek 5. Trzy różne „wąsy” wokół tej samej średniej: 95% CI, ±1 SD i 95% przedział predykcji
# (kontynuacja: mu, sigma, R, kol, motyw)
set.seed(566)
wasy <- function(x) {
  k <- length(x); m <- mean(x); s <- sd(x); q <- qt(.975, k - 1)
  data.frame(n = k, rodzaj = c("95% CI dla średniej", "M ± 1 SD", "95% przedział predykcji"),
             srednia = m, dolna = c(m - q * s / sqrt(k), m - s, m - q * s * sqrt(1 + 1 / k)),
             gorna = c(m + q * s / sqrt(k), m + s, m + q * s * sqrt(1 + 1 / k)))
}
x30 <- rnorm(30, mu, sigma); x300 <- rnorm(300, mu, sigma)
d5 <- rbind(wasy(x30), wasy(x300))
round(c(SD_n30 = sd(x30), SD_n300 = sd(x300)), 2)
transform(d5, srednia = round(srednia, 2), dolna = round(dolna, 2), gorna = round(gorna, 2),
          szerokosc = round(gorna - dolna, 2))

# Co „łapie” każdy wąs? 10 000 badań po 30 osób, w każdym jedna nowa osoba z tej samej populacji
X <- matrix(rnorm(R * 30, mu, sigma), nrow = R); nowa <- rnorm(R, mu, sigma)
m <- rowMeans(X); s <- sqrt((rowSums(X^2) - 30 * m^2) / 29); q <- qt(.975, 29)
traf <- c(CI_obejmuje_mu = mean(abs(m - mu) <= q * s / sqrt(30)),
          SD_obejmuje_nowa_osobe = mean(abs(nowa - m) <= s),
          PI_obejmuje_nowa_osobe = mean(abs(nowa - m) <= q * s * sqrt(1 + 1 / 30)),
          CI_obejmuje_nowa_osobe = mean(abs(nowa - m) <= q * s / sqrt(30)))
round(rbind(proc = 100 * traf, blad_MC_pp = 100 * sqrt(traf * (1 - traf) / R)), 2)

d5$rodzaj <- factor(d5$rodzaj, levels = c("95% CI dla średniej", "M ± 1 SD", "95% przedział predykcji"))
d5$panel <- factor(sprintf("n = %d", d5$n), levels = c("n = 30", "n = 300"))
dane5 <- data.frame(panel = factor(rep(c("n = 30", "n = 300"), c(30, 300)), levels = levels(d5$panel)), y = c(x30, x300))
p5 <- ggplot(d5, aes(x = as.numeric(rodzaj) + 1)) +
  geom_point(data = dane5, aes(x = 1, y = y), position = position_jitter(width = 0.18, height = 0, seed = 566),
             alpha = 0.35, size = 1.3,
             colour = "grey45", inherit.aes = FALSE) +
  geom_linerange(aes(ymin = dolna, ymax = gorna, colour = rodzaj, linetype = rodzaj), linewidth = 1.3) +
  geom_point(aes(y = srednia, shape = rodzaj, colour = rodzaj), size = 2.8, fill = "white", stroke = 1.1) +
  geom_text(aes(y = gorna, label = sprintf("%.1f", gorna)), vjust = -0.6, size = 3.5, colour = "grey20") +
  geom_text(aes(y = dolna, label = sprintf("%.1f", dolna)), vjust = 1.5, size = 3.5, colour = "grey20") +
  facet_wrap(~ panel, ncol = 2) +
  scale_x_continuous(breaks = 1:4, labels = c("dane", "CI", "±SD", "PI"), limits = c(0.6, 4.4)) +
  scale_colour_manual(values = c(kol[["obejmuje"]], "grey25", kol[["chybia"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "solid"), name = NULL) +
  scale_shape_manual(values = c(16, 21, 17), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = NULL, y = "Wynik T", title = "Większa próba zwęża tylko przedział ufności") + motyw
# p5   # zapis: ggsave("przedzial-ufnosci-sd-i-przedzial-predykcji.svg", p5, width = 10, height = 6.4)
Wynik w R
 SD_n30 SD_n300
   7.62    9.27
    n                  rodzaj srednia dolna gorna szerokosc
1  30     95% CI dla średniej   50.83 47.98 53.67      5.69
2  30                M ± 1 SD   50.83 43.21 58.45     15.24
3  30 95% przedział predykcji   50.83 34.98 66.67     31.69
4 300     95% CI dla średniej   49.04 47.98 50.09      2.11
5 300                M ± 1 SD   49.04 39.76 58.31     18.55
6 300 95% przedział predykcji   49.04 30.75 67.32     36.57
           CI_obejmuje_mu SD_obejmuje_nowa_osobe PI_obejmuje_nowa_osobe
proc                95.52                  66.69                  95.57
blad_MC_pp           0.21                   0.47                   0.21
           CI_obejmuje_nowa_osobe
proc                        28.53
blad_MC_pp                   0.45
Rysunek 6: nakładanie się przedziałów to nie test
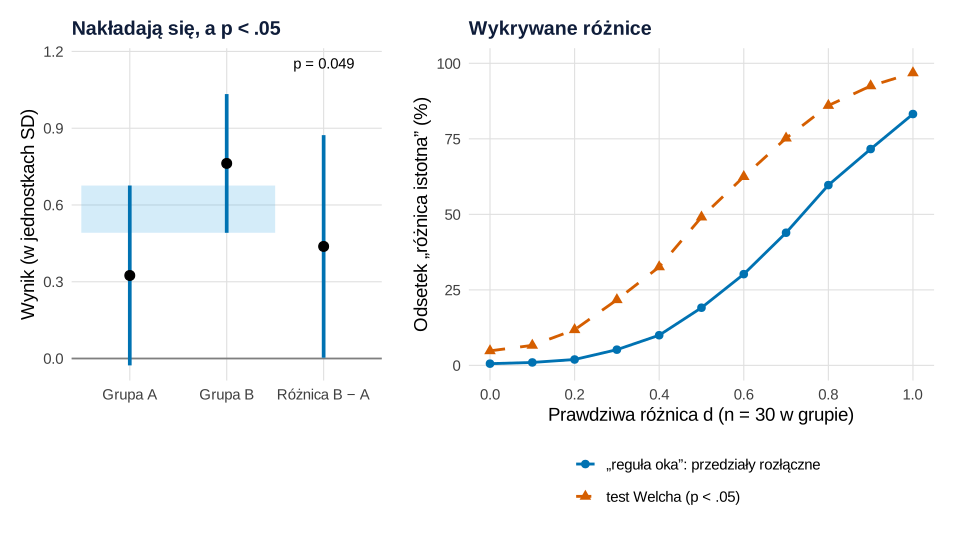
Co widać. Lewy panel to pierwsze wylosowane badanie (prawdziwa różnica d = 0.6), w którym przedziały grup nachodzą na siebie, a test Welcha daje p < .05. Przedziały nakładają się o 0.185 SD, a mimo to przedział różnicy [0.003, 0.873] nie obejmuje zera, t(54.49) = 2.02, p = .049. To nie wyjątek (prawy panel). Reguła „różnica jest, gdy przedziały się nie stykają” przy braku różnicy myli się rzadko (0.58% badań wobec 4.82% dla testu), ale prawdziwe różnice przeocza znacznie częściej. Przy d = 0.5 test wykrył różnicę w 49.08% badań, a reguła oka – w 19.10%. Przy d = 0.6 w 32.27% wszystkich badań przedziały się nakładały, a test i tak dawał p < .05. Schenker i Gentleman (2001) pokazali, że rozłączność przedziałów oznacza istotną różnicę, ale nakładanie się nie oznacza jej braku – metoda jest zbyt zachowawcza. Z kolei Belia i in. (2005) stwierdzili, że wielu autorów artykułów ma błędne przekonania o związku słupków błędów z istotnością.
Czego ten wykres nie pokazuje. Ile nakładania się jeszcze „wolno”. Reguły oka dla grup niezależnych zaproponowali Cumming i Finch (2005); przykład liczbowy jest w haśle przedział ufności, a symulację zależności między zachodzeniem przedziałów i p – we wpisie o przedziałach w pracy. Rysunek dotyczy grup niezależnych; przy pomiarach powtarzanych osobne przedziały pomiarów nie mówią o różnicy. Jak często test wykrywa efekt danej wielkości, pokazuje wpis moc testu w obrazkach.
Podpis do pracy (wersja z samym przykładem):
Zdanie do Wyników:
Kod rysunku 6: nakładanie się przedziałów a test różnicy
6. Reguła „przedziały rozłączne” a test Welcha
R
# Rysunek 6. Nakładanie się dwóch 95% CI to nie test różnicy (kontynuacja: R, kol, motyw)
library(patchwork)
set.seed(566)
n6 <- 30; d_siatka <- seq(0, 1, by = 0.1)       # dwie niezależne grupy po 30 osób, prawdziwa różnica d (w SD)
symuluj <- function(d) {
  A <- matrix(rnorm(R * n6, 0, 1), nrow = R); B <- matrix(rnorm(R * n6, d, 1), nrow = R)
  mA <- rowMeans(A); mB <- rowMeans(B)
  seA <- sqrt((rowSums(A^2) - n6 * mA^2) / (n6 - 1) / n6); seB <- sqrt((rowSums(B^2) - n6 * mB^2) / (n6 - 1) / n6)
  q <- qt(.975, n6 - 1)
  rozlaczne <- (mB - q * seB > mA + q * seA) | (mA - q * seA > mB + q * seB)   # przedziały grup się nie stykają
  se_r <- sqrt(seA^2 + seB^2)                                                   # test Welcha
  df <- se_r^4 / (seA^4 / (n6 - 1) + seB^4 / (n6 - 1))
  p <- 2 * pt(-abs(mB - mA) / se_r, df)
  data.frame(d = d, test_Welcha = mean(p < .05), regula_oka = mean(rozlaczne),
             nakladaja_sie_a_p_ponizej_05 = mean(!rozlaczne & p < .05))
}
d6 <- do.call(rbind, lapply(d_siatka, symuluj))
round(transform(d6, test_Welcha = 100 * test_Welcha, regula_oka = 100 * regula_oka,
                nakladaja_sie_a_p_ponizej_05 = 100 * nakladaja_sie_a_p_ponizej_05), 2)

# Przykład: pierwsze z kolejnych losowań przy d = 0.6, w którym przedziały się nakładają, a p < .05
repeat {
  a <- rnorm(n6, 0, 1); b <- rnorm(n6, 0.6, 1); tt <- t.test(b, a)
  ciA <- t.test(a)$conf.int; ciB <- t.test(b)$conf.int
  if (tt$p.value < .05 && mean(b) > mean(a) && ciB[1] < ciA[2]) break
}
przyklad <- data.frame(co = c("Grupa A", "Grupa B", "Różnica B − A"), srednia = c(mean(a), mean(b), mean(b) - mean(a)),
                       dolna = c(ciA[1], ciB[1], tt$conf.int[1]), gorna = c(ciA[2], ciB[2], tt$conf.int[2]))
cbind(przyklad[1], round(przyklad[-1], 3))
round(c(t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value, zachodzenie = ciA[2] - ciB[1]), 3)

przyklad$co <- factor(przyklad$co, levels = przyklad$co)
p6a <- ggplot(przyklad, aes(co, srednia)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  annotate("rect", xmin = 0.5, xmax = 2.5, ymin = ciB[1], ymax = ciA[2], fill = kol[["jasny"]], alpha = 0.25) +
  geom_linerange(aes(ymin = dolna, ymax = gorna), colour = kol[["obejmuje"]], linewidth = 1.3) +
  geom_point(size = 3, colour = "black") +
  annotate("text", x = 3, y = max(przyklad$gorna) + 0.12, label = sprintf("p = %.3f", tt$p.value), size = 3.9) +
  labs(x = NULL, y = "Wynik (w jednostkach SD)", title = "Nakładają się, a p < .05") + motyw
d6l <- rbind(data.frame(d = d6$d, metoda = "test Welcha (p < .05)", proc = 100 * d6$test_Welcha),
             data.frame(d = d6$d, metoda = "„reguła oka”: przedziały rozłączne", proc = 100 * d6[["regula_oka"]]))
p6b <- ggplot(d6l, aes(d, proc, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["obejmuje"]], kol[["chybia"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  scale_x_continuous(breaks = seq(0, 1, 0.2)) + scale_y_continuous(limits = c(0, 100)) +
  labs(x = "Prawdziwa różnica d (n = 30 w grupie)", y = "Odsetek „różnica istotna” (%)",
       title = "Wykrywane różnice") + motyw
p6 <- p6a + p6b + plot_layout(widths = c(1, 1.5))
# p6   # zapis: ggsave("przedzial-ufnosci-nakladanie.svg", p6, width = 10, height = 5.6)
Wynik w R
     d test_Welcha regula_oka nakladaja_sie_a_p_ponizej_05
1  0.0        4.82       0.58                         4.24
2  0.1        6.63       0.98                         5.65
3  0.2       11.80       1.95                         9.85
4  0.3       21.72       5.21                        16.51
5  0.4       32.60       9.99                        22.61
6  0.5       49.08      19.10                        29.98
7  0.6       62.48      30.21                        32.27
8  0.7       75.22      43.92                        31.30
9  0.8       86.03      59.69                        26.34
10 0.9       92.52      71.63                        20.89
11 1.0       96.83      83.22                        13.61
             co srednia  dolna gorna
1       Grupa A   0.324 -0.027 0.676
2       Grupa B   0.762  0.491 1.034
3 Różnica B − A   0.438  0.003 0.873
          t          df           p zachodzenie
      2.018      54.490       0.049       0.185
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, przedziały i test Welcha – pakiet stats). Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „95% prawdopodobieństwa, że μ jest w przedziale”. To odsetek trafień metody (rysunek 1).
- Przedział ufności jako zakres wyników osób. Do tego służą SD i przedział predykcji (rysunek 5).
- Wiara, że duża próba „naprawia” wszystko. Nie usuwa błędu doboru próby ani pomiaru (rysunek 2).
- Zmiana poziomu ufności po obejrzeniu wyników. Poziom ustal przed analizą (rysunek 3).
- Przedział t przy małej próbie i silnie skośnych danych bez komentarza (rysunek 4).
- Wnioskowanie z nakładania się przedziałów grup. Pokaż przedział dla różnicy (rysunek 6).
- Wynik symulacji bez liczby powtórzeń i błędu Monte Carlo.
- Wąsy bez opisu. Napisz w podpisie, czy to CI, SE, SD czy przedział predykcji – także przy przedziałach korelacji (zob. korelacje na wykresie).
Najczęstsze pytania
Co oznacza 95% przedział ufności?
Że przedział policzono metodą, która w długiej serii prób obejmuje prawdziwą wartość parametru w 95% przypadków. W symulacji 100 badań z populacji o średniej 50 przedział objął ją w 95 badaniach, a w 10 000 powtórzeń – w 95.62% (błąd Monte Carlo 0.20 pp). O jednym, już policzonym przedziale wiadomo tylko tyle, że pochodzi z takiej metody.
Czy przedział ufności 95% oznacza 95% prawdopodobieństwa, że średnia w nim leży?
Nie. Średnia populacji jest stała, więc konkretny przedział albo ją obejmuje, albo nie. Prawdopodobieństwo .95 dotyczy procedury przed wylosowaniem próby (Morey i in., 2016). Bezpieczniej napisać: „dane są zgodne ze średnią populacji od … do …”.
Jak liczebność próby wpływa na szerokość przedziału ufności?
Szerokość maleje z pierwiastkiem z n: pięć razy więcej osób daje przedział węższy mniej więcej √5 ≈ 2.24 raza, a połowę szerokości uzyskasz przy czterokrotnie większej próbie. W symulacji średnia szerokość 95% CI wynosiła 9.26 punktu przy n = 20, 3.96 przy n = 100 i 1.76 przy n = 500. Odsetek trafień pozostał bliski 95%.
Czym różni się przedział ufności od przedziału predykcji?
Przedział ufności dotyczy parametru, np. średniej populacji, i zwęża się wraz z liczebnością próby. Przedział predykcji dotyczy wyniku jednej nowej osoby, ma wzór M ± t × SD × √(1 + 1/n) i nie kurczy się do zera. W symulacji 95% CI obejmował wynik nowej osoby tylko w 28.53% badań, a 95% przedział predykcji – w 95.57%.
Czy nakładające się przedziały ufności oznaczają brak istotnej różnicy?
Nie. Rozłączne 95% przedziały dwóch grup niezależnych oznaczają istotną różnicę, ale nakładające się nie oznaczają jej braku (Schenker i Gentleman, 2001). W symulacji z prawdziwą różnicą d = 0.5 test Welcha wykrył ją w 49.08% badań, a reguła „przedziały się nie stykają” – w 19.10%. Oceniaj różnicę po przedziale ufności dla różnicy.
Powiązane hasła
Przeczytaj też
Przedziały ufności w pracy dyplomowej
Zapis APA, wybór przedziału dla średniej, odsetka, różnicy, korelacji i OR, poprawne i błędne zdania, nakładanie się przedziałów i słupki błędów – z tabelą wyników w R.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →PoradnikMoc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →Nie wiesz, jak opisać przedziały ufności w swojej pracy?
Pomożemy policzyć przedziały odpowiednią metodą, przygotować czytelne rysunki i opisać wyniki tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Belia, S., Fidler, F., Williams, J., & Cumming, G. (2005). Researchers misunderstand confidence intervals and standard error bars. Psychological Methods, 10(4), 389–396. https://doi.org/10.1037/1082-989x.10.4.389
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200611141 ● Otwarty dostęp
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3 ● Otwarty dostęp: pełny tekst
- Morey, R. D., Hoekstra, R., Rouder, J. N., Lee, M. D., & Wagenmakers, E.-J. (2016). The fallacy of placing confidence in confidence intervals. Psychonomic Bulletin & Review, 23(1), 103–123. https://doi.org/10.3758/s13423-015-0947-8 ● Otwarty dostęp
- Schenker, N., & Gentleman, J. F. (2001). On judging the significance of differences by examining the overlap between confidence intervals. The American Statistician, 55(3), 182–186. https://doi.org/10.1198/000313001317097960
Cytowania BibTeX
@article{belia2005researchers, author={Belia, Sarah and Fidler, Fiona and Williams, Jennifer and Cumming, Geoff}, title={{Researchers misunderstand confidence intervals and standard error bars}}, journal={Psychological Methods}, year={2005}, volume={10}, number={4}, pages={389--396}, doi={10.1037/1082-989x.10.4.389}}@article{cumming2005inference, author={Cumming, Geoff and Finch, Sue}, title={{Inference by eye: Confidence intervals and how to read pictures of data}}, journal={American Psychologist}, year={2005}, volume={60}, number={2}, pages={170--180}, doi={10.1037/0003-066x.60.2.170}}@article{cumming2007error, author={Cumming, Geoff and Fidler, Fiona and Vaux, David L.}, title={{Error bars in experimental biology}}, journal={Journal of Cell Biology}, year={2007}, volume={177}, number={1}, pages={7--11}, doi={10.1083/jcb.200611141}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{hoekstra2014robust, author={Hoekstra, Rink and Morey, Richard D. and Rouder, Jeffrey N. and Wagenmakers, Eric-Jan}, title={{Robust misinterpretation of confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2014}, volume={21}, number={5}, pages={1157--1164}, doi={10.3758/s13423-013-0572-3}}@article{morey2016fallacy, author={Morey, Richard D. and Hoekstra, Rink and Rouder, Jeffrey N. and Lee, Michael D. and Wagenmakers, Eric-Jan}, title={{The fallacy of placing confidence in confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2016}, volume={23}, number={1}, pages={103--123}, doi={10.3758/s13423-015-0947-8}}@article{schenker2001judging, author={Schenker, Nathaniel and Gentleman, Jane F.}, title={{On judging the significance of differences by examining the overlap between confidence intervals}}, journal={The American Statistician}, year={2001}, volume={55}, number={3}, pages={182--186}, doi={10.1198/000313001317097960}}