Moc odpowiada na inne pytanie niż precyzja
Analiza mocy mówi, ile osób trzeba, żeby test z dużym prawdopodobieństwem odrzucił hipotezę zerową. Nie mówi nic o tym, jak dokładnie oszacujesz efekt. Badanie z mocą .80 dla d = 0.5 (64 osoby w grupie) przy wyniku d = 0.50 daje 95% CI [0.147, 0.851]. Wynik jest istotny, ale zgodny zarówno z efektem ledwo zauważalnym, jak i z bardzo dużym.
Planowanie dokładności oszacowania (ang. accuracy in parameter estimation, AIPE) odwraca pytanie i stawia w centrum estymację przedziałową: ile osób potrzeba, żeby przedział ufności był nie szerszy niż zadana wartość? Kelley i Maxwell (2003) opisali to podejście dla współczynników regresji, Kelley i Rausch (2006) dla standaryzowanej różnicy średnich, a Maxwell, Kelley i Rausch (2008) zebrali jego logikę w przeglądzie dla psychologii. Lakens (2022) wymienia planowanie dokładności jako jeden z sześciu sposobów uzasadnienia liczebności.
Podstawy – połowę szerokości CI dla d z przybliżonego błędu standardowego i pierwszy przykład pewności dla różnicy średnich – omawia wpis dobór liczebności próby. Tutaj idziemy dalej: dokładne przedziały dla proporcji i d, pewność osiągnięcia celu dla trzech parametrów i porównanie z mocą. Szybkie obliczenia z mocy i marginesu błędu daje kalkulator liczebności próby, a przedział dla gotowego wyniku – kalkulator przedziału ufności.
Trzy decyzje przed obliczeniem
- Parametr i metoda przedziału. Liczebność zależy od tego, jak liczysz przedział: Wilson czy Clopper–Pearson dla proporcji, niecentralny rozkład t dla d, transformacja Fishera z dla korelacji. Planuj na tę samą metodę, której użyjesz w analizie.
- Cel ω, czyli pełna szerokość przedziału. W literaturze AIPE ω oznacza różnicę między górną a dolną granicą. „Dokładność ±0.05” to ω = 0.10. Pomylenie pełnej szerokości z połową daje czterokrotnie zbyt małą albo zbyt dużą próbę.
- Oczekiwana szerokość czy pewność. Szerokość przedziału jest zmienną losową, bo zależy od wyniku z próby. Kelley i Rausch (2006) proponują dwa kryteria: liczebność, przy której oczekiwana szerokość wynosi ω, oraz liczebność, przy której szerokość nie przekroczy ω z zadanym prawdopodobieństwem γ, np. .90 lub .99. To drugie prawdopodobieństwo nazywamy tu pewnością (ang. assurance). Przy samym kryterium oczekiwanej szerokości cel osiąga mniej więcej co drugie badanie.
Proporcja: Wilson i Clopper–Pearson
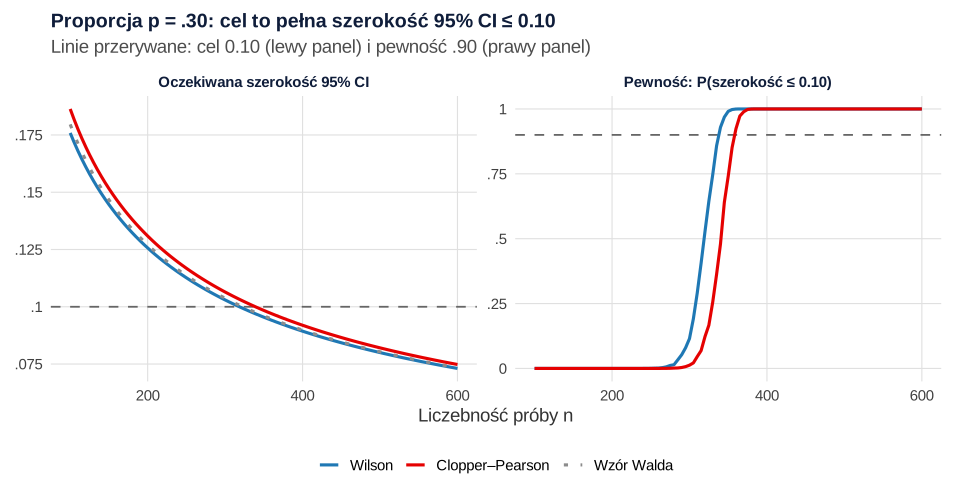
Planujesz badanie opisowe częstości objawów lęku. Spodziewasz się około 30% i chcesz pełnej szerokości 95% CI najwyżej 0.10. Wzór Walda z hasła liczebność próby w ankiecie daje n = 323. W analizie użyjesz jednak przedziału Wilsona albo Cloppera–Pearsona. Brown, Cai i DasGupta (2001) pokazali, że przedział Walda ma chaotyczne pokrycie, i zalecają przy małych n przedział Wilsona (więcej w haśle przedział ufności dla proporcji).
Dla proporcji nie trzeba symulacji. Liczba „przypadków” x ma rozkład dwumianowy, więc oczekiwaną szerokość i pewność można policzyć dokładnie: dla każdego x od 0 do n liczysz szerokość przedziału i ważysz ją prawdopodobieństwem tego x.
| Przedział | n: oczekiwana szerokość ≤ 0.10 | Pewność przy tym n | n: pewność .90 | Pewność przy n = 323 (Wald) |
|---|---|---|---|---|
| Wilson | 319 | .494 | 338 | .580 |
| Clopper–Pearson | 340 | .480 | 359 | .154 |
Wzór Walda wystarcza, jeśli analizujesz wynik przedziałem Wilsona i zadowala Cię oczekiwana szerokość. Jeśli raportujesz przedział „dokładny” Cloppera–Pearsona, przy 323 osobach cel osiągasz tylko w 15.4% badań. Pewność .90 wymaga 359 osób. Szerokość rośnie, gdy odsetek w próbie zbliża się do 50%, dlatego zawodzą badania z wynikiem wyższym od zakładanego. Gdy nie wiesz nic o odsetku, plan „najgorszego przypadku” (50%, n = 385) daje pewność 1 zarówno przy 30%, jak i przy 50%. Podobną logikę dla sondaży opisuje hasło margines błędu w sondażu. Pamiętaj tylko, że margines ma sens przy losowym doborze próby.
d Cohena: dokładny przedział z niecentralnego t
Dla d Cohena przybliżony błąd standardowy wystarcza do orientacji, ale w artykule raportujesz zwykle przedział dokładny. Statystyka t ma niecentralny rozkład t (hasło parametr niecentralności). Szukasz dwóch wartości parametru niecentralności, przy których obserwowane t leży na 97.5. i 2.5. centylu, a potem przeliczasz je na skalę d. W R robi to uniroot. Kelley i Rausch (2006) opisują to podejście wraz z tabelami liczebności.
Cel: dwie równe grupy, oczekiwane d = 0.5, ω = 0.50, czyli mniej więcej ±0.25.
| Planowane d | Moc .80 | Szerokość ≤ 0.50 przy d = δ | Pewność przy tym n | Pewność .90 | Pewność .99 |
|---|---|---|---|---|---|
| 0.2 | 394 | 124 | .689 | 125 | 127 |
| 0.5 | 64 | 127 | .539 | 130 | 133 |
| 0.8 | 26 | 133 | .519 | 138 | 142 |
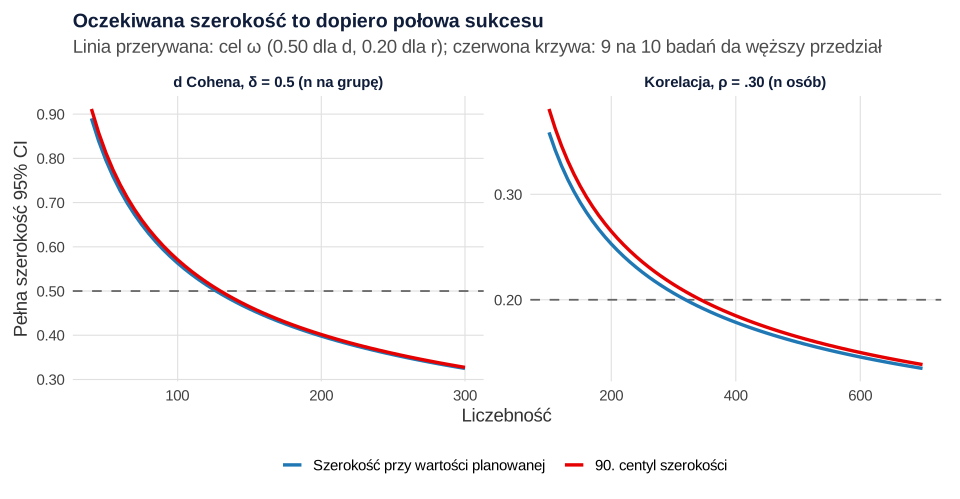
Pewność policzyliśmy dokładnie. Szerokość przedziału rośnie z |t|, więc wystarczy znaleźć graniczne t* i policzyć, jak często |t| ≤ t*. Symulacja 2000 badań przy δ = 0.5 to potwierdziła. Przy 127 osobach w grupie średnia szerokość wyniosła 0.500, a cel osiągnęło 54.1% badań. Przy 130 osobach odsetek wyniósł 90.9% (błąd Monte Carlo 0.007).
Dopłata za pewność jest tu niewielka: trzy osoby na grupę. Szerokość CI dla d zależy od wyniku z próby słabo, tylko przez d². Inaczej jest przy różnicy średnich w surowych punktach. Tam szerokość zależy od odchylenia standardowego z próby i we wpisie o doborze liczebności pewność .90 wymagała 98 zamiast 87 osób na grupę. Gotowe funkcje do tych obliczeń ma pakiet MBESS opisany przez Kelleya i Rauscha (2006). Wszystko da się jednak policzyć w bazowym R, jak w przepisie 2 niżej.
Korelacja: transformacja Fishera i pewność
Przy korelacji szerokość przedziału zależy od wyniku silnie. Przedział z transformacji Fishera ma stałą szerokość na skali z, ale po powrocie na skalę r zwęża się, gdy |r| rośnie. Badanie, w którym korelacja wyjdzie niższa od zakładanej, da więc szerszy przedział. Bonett i Wright (2000) opisali liczebność potrzebną do przedziału o zadanej szerokości dla korelacji Pearsona, Kendalla i Spearmana.
Cel: ρ = .30 i ω = 0.20 (około ±0.10). Szerokość przy r = .30 spada do 0.20 przy 320 osobach, ale pewność wynosi wtedy tylko .514. Pewność .90 wymaga 344 osób. W symulacji 4000 prób przy 320 osobach cel osiągnęło 50.0% badań, a przy 344 – 91.1% (błąd Monte Carlo 0.005). Dla ρ = .10 potrzeba 378 i 384 osób, a dla ρ = .50 – 219 i 254. Im silniejsza korelacja, tym mniejsza próba, ale tym większa dopłata za pewność.
Moc a precyzja: kiedy która daje większą próbę
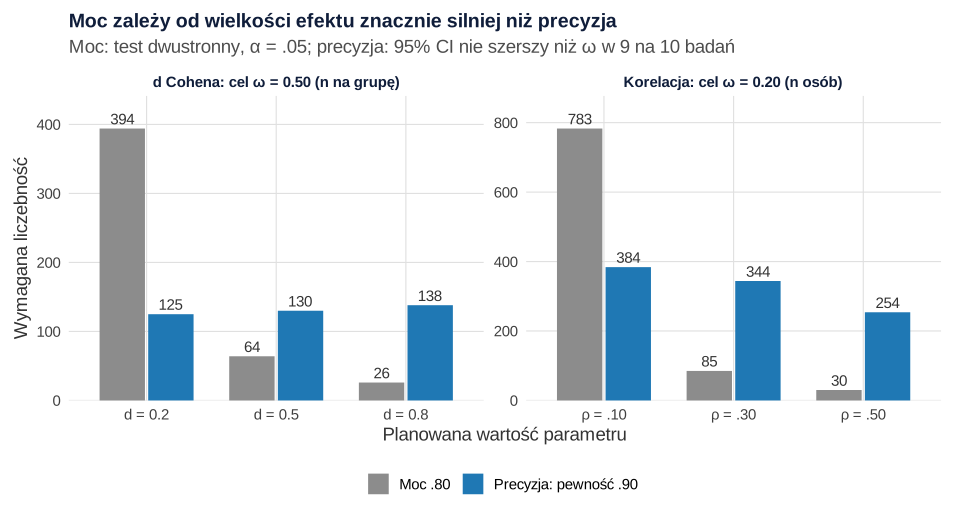
Zestawienie obu podejść pokazuje ważną asymetrię (rysunek 3). Liczebność z mocy zależy od wielkości efektu bardzo silnie: dla d = 0.2 potrzeba 394 osób na grupę, dla d = 0.8 – 26. Liczebność z precyzji dla d prawie od niej nie zależy: 125–138 osób przy ω = 0.50. Przy korelacjach zależy umiarkowanie: od 384 przy ρ = .10 do 254 przy ρ = .50.
Wynikają z tego dwie praktyczne rady. Przy małych efektach AIPE z rozsądnym ω bywa tańsze niż moc .80 i daje użyteczny wynik niezależnie od istotności. Przy dużych efektach precyzja wymaga kilkukrotnie większej próby niż test. Jeśli chcesz zarówno wykryć efekt, jak i dobrze go oszacować, policz obie liczebności i weź większą. Druga zaleta AIPE to mniejsza wrażliwość na zgadywanie wielkości efektu. Zawyżone oszacowanie z literatury zaniża liczebność z mocy dramatycznie, a z precyzji – znacznie mniej.
Kiedy planować na precyzję
- Badania opisowe. Gdy celem jest częstość, średnia albo korelacja w populacji, nie ma hipotezy zerowej, którą warto odrzucać. Liczy się dokładność oszacowania.
- Pilotaże. Badanie pilotażowe dostarcza parametrów do planu badania głównego: odchylenia standardowego wyniku, odsetka rekrutacji i ukończenia. Przy 20 osobach górna granica 95% CI dla SD to 1.46 × s, a przy 70 osobach – 1.20 × s. Jeśli prawdziwe SD leży na tej granicy, badanie główne zaplanowane na 64 osoby w grupie (różnica 5 punktów przy SD = 10, moc .80) wymagałoby 135 osób (pilotaż z 20 osobami) albo 92 (z 70 osobami). Odsetek ukończenia 80% przy 20 osobach ma połowę szerokości CI 0.168, a przy 70 osobach – 0.093. Teare i in. (2014) zalecają w zewnętrznym pilotażu co najmniej 70 osób do oszacowania SD. Więcej o celach pilotażu we wpisie pilotaż wykonalności.
- Oszacowanie efektu do metaanalizy. Waga badania w metaanalizie zależy od wariancji oszacowania, a nie od istotności. Cumming (2014) proponuje przejście od testowania istotności do estymacji i metaanalizy. Planowanie na szerokość przedziału jest naturalnym odpowiednikiem tego podejścia na etapie projektu.
- Badania zgodności i rzetelności. W ocenie ICC albo granic zgodności z metody Blanda–Altmana test „czy zgodność jest większa od zera” nie ma sensu. Liczy się, jak wąski jest przedział. Bonett (2002) podał przybliżoną liczebność potrzebną do dokładnego przedziału ICC o zadanej szerokości.
AIPE nie zastąpi analizy mocy, gdy celem jest decyzja. Dotyczy to badań równoważności, nie-gorszości albo testów hipotez z ustalonym błędem II rodzaju.
Jak opisać plan liczebności oparty na precyzji
Podaj parametr, metodę przedziału, poziom ufności, cel ω (pełna szerokość), wartość planowaną i jej źródło, kryterium (oczekiwana szerokość czy pewność γ) oraz sposób obliczenia. Wzór dla przykładu z korelacją:
Przy proporcji dopisz wprost, że plan dotyczy przedziału Wilsona albo Cloppera–Pearsona. Ten sam cel dla różnych metod daje inne liczebności.
Przykład w R
Cztery przepisy są niezależne i odtwarzają wszystkie liczby z tekstu w kilka sekund. Przepisy 1–3 zapisują też pliki CSV, z których powstały rysunki. Potrzebne pakiety: DescTools (przepisy 1 i 4) i MASS (przepis 3).
1. Proporcja: oczekiwana szerokość i pewność (Wilson, Clopper–Pearson)
R
# Krok 1. AIPE dla proporcji: oczekiwana szerokość i pewność (assurance) dla przedziałów Wilsona i Cloppera–Pearsona
# Scenariusz: badanie opisowe, oczekiwany odsetek osób z objawami lęku p = .30,
# cel: pełna szerokość 95% CI najwyżej 0.10 (czyli mniej więcej ±5 punktów procentowych).
# Szerokość zależy od wylosowanej liczby „sukcesów” x, więc liczymy ją dokładnie po rozkładzie dwumianowym.
library(DescTools)
options(width = 110)

szer <- function(n, metoda) {                                  # szerokość CI dla każdego x = 0, …, n
  ci <- BinomCI(0:n, n, conf.level = .95, method = metoda)
  ci[, "upr.ci"] - ci[, "lwr.ci"]
}
oczekiwana <- function(n, p, metoda) sum(dbinom(0:n, n, p) * szer(n, metoda))
pewnosc    <- function(n, p, metoda, cel = .10) sum(dbinom(0:n, n, p)[szer(n, metoda) <= cel])
najmniejsze_n <- function(f, od = 50, do = 1500) { for (n in od:do) if (f(n)) return(n); NA }

p <- .30; cel <- .10
# Wzór „podręcznikowy” (Wald): n = z² p(1 − p) / (cel/2)²
n_wald <- ceiling(qnorm(.975)^2 * p * (1 - p) / (cel / 2)^2)
wyniki <- t(sapply(c(wilson = "wilson", clopper_pearson = "clopper-pearson"), function(m) {
  n_ocz <- najmniejsze_n(function(n) oczekiwana(n, p, m) <= cel)
  n_90  <- najmniejsze_n(function(n) pewnosc(n, p, m) >= .90)
  c(n_oczekiwana = n_ocz, pewnosc_przy_n_oczek = round(pewnosc(n_ocz, p, m), 3), n_pewnosc_90 = n_90)
}))
n_wald
wyniki

# Ile wynosi pewność przy n z wzoru Walda i jaki odsetek x daje szerokość > 0.10?
round(c(wilson = pewnosc(n_wald, p, "wilson"), clopper_pearson = pewnosc(n_wald, p, "clopper-pearson")), 3)

# Gdy nic nie wiadomo o p: plan „najgorszego przypadku” p = .50 (Wald) i pewność Wilsona przy tym n
n_p50 <- ceiling(qnorm(.975)^2 * .25 / (cel / 2)^2)
round(c(n_p50 = n_p50, pewnosc_gdy_p_30 = pewnosc(n_p50, .30, "wilson"),
        pewnosc_gdy_p_50 = pewnosc(n_p50, .50, "wilson")), 3)

# Dane do rysunku 1: oczekiwana szerokość i pewność dla n = 100, 105, …, 600
siatka <- expand.grid(n = seq(100, 600, 5), metoda = c("wilson", "clopper-pearson"), stringsAsFactors = FALSE)
siatka$oczekiwana <- mapply(oczekiwana, siatka$n, p, siatka$metoda)
siatka$pewnosc    <- mapply(pewnosc, siatka$n, p, siatka$metoda)
siatka$wald       <- 2 * qnorm(.975) * sqrt(p * (1 - p) / siatka$n)
write.csv(siatka, "aipe-proporcja.csv", row.names = FALSE)
Wynik w R
[1] 323
                n_oczekiwana pewnosc_przy_n_oczek n_pewnosc_90
wilson                   319                0.494          338
clopper_pearson          340                0.480          359
         wilson clopper_pearson
          0.580           0.154
           n_p50 pewnosc_gdy_p_30 pewnosc_gdy_p_50
             385                1                1
2. d Cohena: dokładny przedział z niecentralnego t
R
# Krok 2. AIPE dla d Cohena: dokładny przedział z niecentralnego rozkładu t (uniroot), oczekiwana szerokość i pewność
# Scenariusz: dwie równe grupy, oczekiwane d = 0.5, cel: pełna szerokość 95% CI najwyżej ω = 0.50.
options(width = 110)

# Dokładny 95% CI dla d: szukamy parametrów niecentralności, dla których obserwowane t leży na 97.5 i 2.5 centylu
ci_d <- function(t, n) {
  df <- 2 * n - 2; k <- sqrt(2 / n)                            # d = t · √(1/n1 + 1/n2)
  dol <- uniroot(function(ncp) pt(t, df, ncp) - .975, c(t - 6, t + 6))$root
  gor <- uniroot(function(ncp) pt(t, df, ncp) - .025, c(t - 6, t + 6))$root
  c(dolna = dol * k, gorna = gor * k)
}
szer_d <- function(d_obs, n) diff(ci_d(d_obs / sqrt(2 / n), n))

# Przykład: d = 0.50 przy 64 osobach na grupę (moc .80 dla d = 0.5)
round(ci_d(0.50 / sqrt(2 / 64), 64), 3)

# Pewność: szerokość rośnie z |d|, więc P(szerokość ≤ ω) = P(|t| ≤ t*), gdzie szerokość(t*) = ω
pewnosc_d <- function(n, delta, omega = .50) {
  df <- 2 * n - 2; ncp <- delta / sqrt(2 / n)
  if (szer_d(0, n) > omega) return(0)
  t_gw <- uniroot(function(t) diff(ci_d(t, n)) - omega, c(0, 30))$root
  pt(t_gw, df, ncp) - pt(-t_gw, df, ncp)
}
najmniejsze_n <- function(f, od = 20, do = 2000) { for (n in od:do) if (f(n)) return(n); NA }

plan <- t(sapply(c(0.2, 0.5, 0.8), function(delta) {
  n_ocz <- najmniejsze_n(function(n) szer_d(delta, n) <= .50)   # szerokość przy d = δ (≈ oczekiwana)
  n_90  <- najmniejsze_n(function(n) pewnosc_d(n, delta) >= .90, od = n_ocz)
  n_99  <- najmniejsze_n(function(n) pewnosc_d(n, delta) >= .99, od = n_90)
  n_moc <- ceiling(power.t.test(delta = delta, power = .80)$n)
  c(d = delta, n_moc_80 = n_moc, n_szer_przy_delta = n_ocz,
    pewnosc_przy_tym_n = round(pewnosc_d(n_ocz, delta), 3), n_pewnosc_90 = n_90, n_pewnosc_99 = n_99)
}))
plan
write.csv(plan, "aipe-plan-d.csv", row.names = FALSE)

# Sprawdzenie symulacją: 2000 badań przy n = 128 i n_pewnosc_90 dla δ = 0.5 (dane symulowane)
set.seed(3511)
symuluj <- function(n, R = 2000) replicate(R, {
  a <- rnorm(n, 0.5); b <- rnorm(n)
  d <- (mean(a) - mean(b)) / sqrt((var(a) + var(b)) / 2)
  szer_d(d, n)
})
n_spr <- c(plan[2, "n_szer_przy_delta"], plan[2, "n_pewnosc_90"])
spr <- sapply(n_spr, function(n) { w <- symuluj(n); c(n = n, sr_szerokosc = mean(w), odsetek_w_celu = mean(w <= .50)) })
round(t(spr), 3)
round(sqrt(.9 * .1 / 2000), 3)                                 # błąd Monte Carlo odsetka przy .90

# Dane do rysunku 2: szerokość przy d = δ oraz 90. centyl szerokości (n na grupę 40–300)
siatka <- data.frame(n = seq(40, 300, 5))
siatka$szer_przy_delta <- sapply(siatka$n, function(n) szer_d(0.5, n))
siatka$centyl_90 <- sapply(siatka$n, function(n) {
  t90 <- qt(.90, 2 * n - 2, 0.5 / sqrt(2 / n))                 # 90. centyl t (ujemny ogon pomijalny)
  szer_d(t90 * sqrt(2 / n), n)
})
write.csv(siatka, "aipe-d-cohena.csv", row.names = FALSE)
Wynik w R
dolna gorna
0.147 0.851
       d n_moc_80 n_szer_przy_delta pewnosc_przy_tym_n n_pewnosc_90 n_pewnosc_99
[1,] 0.2      394               124              0.689          125          127
[2,] 0.5       64               127              0.539          130          133
[3,] 0.8       26               133              0.519          138          142
                    n sr_szerokosc odsetek_w_celu
n_szer_przy_delta 127        0.500          0.541
n_pewnosc_90      130        0.494          0.909
[1] 0.007
3. Korelacja: transformacja Fishera i pewność
R
# Krok 3. AIPE dla korelacji Pearsona: przedział z transformacji Fishera, oczekiwana szerokość i pewność
# Scenariusz: oczekiwane ρ = .30, cel: pełna szerokość 95% CI najwyżej ω = 0.20.
library(MASS)
options(width = 110)

ci_r   <- function(r, n) tanh(atanh(r) + c(-1, 1) * qnorm(.975) / sqrt(n - 3))
szer_r <- function(r, n) diff(ci_r(r, n))
# Szerokość maleje, gdy |r| rośnie, więc szerokość ≤ ω  ⇔  r ≥ r* (dla dodatnich r; ujemny ogon pomijalny).
# Rozkład z = atanh(r) przybliżamy normalnym N(atanh(ρ), 1/(n − 3)).
pewnosc_r <- function(n, rho, omega = .20) {
  if (szer_r(.999, n) > omega) return(0)
  r_gw <- uniroot(function(r) szer_r(r, n) - omega, c(0, .999))$root
  1 - pnorm((atanh(r_gw) - atanh(rho)) * sqrt(n - 3))
}
najmniejsze_n <- function(f, od = 10, do = 5000) { for (n in od:do) if (f(n)) return(n); NA }

plan <- t(sapply(c(.10, .30, .50), function(rho) {
  n_moc <- ceiling(((qnorm(.975) + qnorm(.80)) / atanh(rho))^2 + 3)   # moc .80, test dwustronny
  n_ocz <- najmniejsze_n(function(n) szer_r(rho, n) <= .20)
  n_90  <- najmniejsze_n(function(n) pewnosc_r(n, rho) >= .90, od = n_ocz)
  c(rho = rho, n_moc_80 = n_moc, n_szer_przy_rho = n_ocz,
    pewnosc_przy_tym_n = round(pewnosc_r(n_ocz, rho), 3), n_pewnosc_90 = n_90)
}))
plan
write.csv(plan, "aipe-plan-r.csv", row.names = FALSE)

# Sprawdzenie symulacją dla ρ = .30: 4000 prób dwuwymiarowych normalnych przy obu liczebnościach (dane symulowane)
set.seed(3512)
S <- matrix(c(1, .30, .30, 1), 2)
spr <- sapply(plan[2, c("n_szer_przy_rho", "n_pewnosc_90")], function(n) {
  w <- replicate(4000, szer_r(cor(mvrnorm(n, c(0, 0), S))[1, 2], n))
  c(n = n, sr_szerokosc = mean(w), odsetek_w_celu = mean(w <= .20))
})
round(t(spr), 3)
round(sqrt(.9 * .1 / 4000), 3)                                 # błąd Monte Carlo odsetka przy .90

# Dane do rysunku 2: szerokość przy r = ρ i 90. centyl szerokości (n = 100–700)
siatka <- data.frame(n = seq(100, 700, 10))
siatka$szer_przy_rho <- sapply(siatka$n, function(n) szer_r(.30, n))
siatka$centyl_90 <- sapply(siatka$n, function(n) szer_r(tanh(atanh(.30) - qnorm(.90) / sqrt(n - 3)), n))
write.csv(siatka, "aipe-korelacja.csv", row.names = FALSE)
Wynik w R
     rho n_moc_80 n_szer_przy_rho pewnosc_przy_tym_n n_pewnosc_90
[1,] 0.1      783             378              0.552          384
[2,] 0.3       85             320              0.514          344
[3,] 0.5       30             219              0.508          254
                  n sr_szerokosc odsetek_w_celu
n_szer_przy_rho 320        0.199          0.500
n_pewnosc_90    344        0.192          0.911
[1] 0.005
4. Precyzja w pilotażu: SD i odsetek ukończenia
R
# Krok 4. Precyzja w pilotażu: SD wyniku (do planowania badania głównego) i odsetek osób, które ukończą badanie
# 95% CI dla SD z rozkładu χ² (założenie normalności); granice podane jako wielokrotność SD z próby.
library(DescTools)
options(width = 110)

n <- c(20, 35, 50, 70, 100)
sd_ci <- t(sapply(n, function(k) c(n = k, dolna_x_s = sqrt((k - 1) / qchisq(.975, k - 1)),
                                    gorna_x_s = sqrt((k - 1) / qchisq(.025, k - 1)))))
round(sd_ci, 2)

# Co znaczy górna granica SD dla badania głównego? Liczebność na moc .80 dla różnicy 5 pkt przy SD = 10
# i przy SD równym górnej granicy z pilotażu na 20 i na 70 osobach
sapply(c(sd_10 = 10, gorna_n20 = 10 * unname(sd_ci[1, 3]), gorna_n70 = 10 * unname(sd_ci[4, 3])),
       function(s) ceiling(power.t.test(delta = 5, sd = s, power = .80)$n))

# Odsetek ukończenia 0.80 (Wilson): połowa szerokości 95% CI przy różnych liczebnościach pilotażu
round(sapply(setNames(n, paste("n =", n)), function(k) {
  ci <- BinomCI(round(.80 * k), k, method = "wilson"); unname(ci[, "upr.ci"] - ci[, "lwr.ci"]) / 2
}), 3)
Wynik w R
       n dolna_x_s gorna_x_s
[1,]  20      0.76      1.46
[2,]  35      0.81      1.31
[3,]  50      0.84      1.25
[4,]  70      0.86      1.20
[5,] 100      0.88      1.16
    sd_10 gorna_n20 gorna_n70
       64       135        92
 n = 20  n = 35  n = 50  n = 70 n = 100
  0.168   0.129   0.109   0.093   0.078
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 (przepisy 1 i 4: pakiet DescTools, przepis 3: pakiet MASS); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Mylenie pełnej szerokości z połową. „±0.10” to ω = 0.20. Pomyłka zmienia liczebność mniej więcej czterokrotnie.
- Plan na oczekiwaną szerokość bez słowa o pewności. Przy takim planie cel osiąga około połowy badań. Podaj γ albo napisz wprost, że planujesz na wartość oczekiwaną.
- Plan na wzór Walda, analiza przedziałem dokładnym. W przykładzie z odsetkiem 30% pewność spadła wtedy do .154.
- Zbyt optymistyczna wartość planowana. Przy korelacji szerokość rośnie, gdy r jest mniejsze od zakładanego. Planuj na ostrożną wartość albo policz kilka scenariuszy.
- Precyzja z próby nielosowej. Wąski przedział z wygodnej próby nie usuwa błędu doboru: opisuje precyzyjnie tylko populację, z której naprawdę pochodzi próba.
Najczęstsze pytania
Co to jest AIPE w planowaniu liczebności próby?
AIPE (accuracy in parameter estimation) to planowanie liczebności na dokładność oszacowania zamiast na moc testu. Wybierasz parametr, metodę przedziału i największą dopuszczalną pełną szerokość 95% CI (ω), a potem szukasz najmniejszego n, przy którym przedział będzie odpowiednio wąski – w oczekiwaniu albo z zadaną pewnością.
Czym jest pewność (assurance) przy planowaniu szerokości przedziału ufności?
To prawdopodobieństwo, że w Twoim badaniu przedział nie wyjdzie szerszy niż cel ω. Liczebność dla oczekiwanej szerokości daje pewność około .50. W przykładzie z korelacją .30 i ω = 0.20 pewność przy 320 osobach wyniosła .514, a .90 wymagało 344 osób.
Ile osób potrzeba, żeby oszacować korelację z dokładnością ±0.10?
Przy oczekiwanej korelacji .30 i 95% CI z transformacji Fishera pełna szerokość 0.20 wymaga 320 osób w oczekiwaniu i 344 osób z pewnością .90. Przy korelacji .10 potrzeba 384 osób, a przy .50 – 254 (pewność .90).
Czy przy małym efekcie lepiej planować próbę na precyzję niż na moc?
Często tak. Dla d = 0.2 moc .80 wymaga 394 osób na grupę, a 95% CI o szerokości 0.50 z pewnością .90 – tylko 125. Taki przedział nie rozstrzygnie istotności, ale da oszacowanie przydatne np. do metaanalizy. Przy dużych efektach jest odwrotnie: dla d = 0.8 moc wymaga 26 osób, a precyzja 138.
Czy liczebność z precyzji zależy od metody przedziału ufności?
Tak. Dla odsetka 30% i pełnej szerokości 0.10 oczekiwana szerokość wymaga 319 osób przy przedziale Wilsona i 340 przy Clopperze–Pearsonie, a pewność .90 – odpowiednio 338 i 359. Planuj na tę metodę, którą raportujesz w analizie.
Powiązane hasła
Przeczytaj też
Dobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikKalkulator liczebności próby
Ile osób do testu t, korelacji albo ankiety z marginesem błędu? Kalkulator zgodny z R, wzory, przykład i gotowy opis analizy mocy.
Czytaj →PoradnikKalkulator przedziału ufności
Średnia (t), proporcja (Wilson i Wald), korelacja (Fisher) i różnica średnich (Welch): kalkulator online, wzory, przykład w R i zapis APA.
Czytaj →Chcesz oszacować efekt, a nie tylko wykazać, że istnieje?
Pomożemy dobrać parametr, metodę przedziału i cel szerokości, policzyć liczebność z pewnością osiągnięcia celu i przygotować uzasadnienie, które samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bonett, D. G. (2002). Sample size requirements for estimating intraclass correlations with desired precision. Statistics in Medicine, 21(9), 1331–1335. https://doi.org/10.1002/sim.1108
- Bonett, D. G., & Wright, T. A. (2000). Sample size requirements for estimating Pearson, Kendall and Spearman correlations. Psychometrika, 65(1), 23–28. https://doi.org/10.1007/bf02294183
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Kelley, K., & Maxwell, S. E. (2003). Sample size for multiple regression: Obtaining regression coefficients that are accurate, not simply significant. Psychological Methods, 8(3), 305–321. https://doi.org/10.1037/1082-989x.8.3.305
- Kelley, K., & Rausch, J. R. (2006). Sample size planning for the standardized mean difference: Accuracy in parameter estimation via narrow confidence intervals. Psychological Methods, 11(4), 363–385. https://doi.org/10.1037/1082-989x.11.4.363
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Maxwell, S. E., Kelley, K., & Rausch, J. R. (2008). Sample size planning for statistical power and accuracy in parameter estimation. Annual Review of Psychology, 59(1), 537–563. https://doi.org/10.1146/annurev.psych.59.103006.093735
- Teare, M. D., Dimairo, M., Shephard, N., Hayman, A., Whitehead, A., & Walters, S. J. (2014). Sample size requirements to estimate key design parameters from external pilot randomised controlled trials: A simulation study. Trials, 15(1), Article 264. https://doi.org/10.1186/1745-6215-15-264 ● Otwarty dostęp
Cytowania BibTeX
@article{bonett2002sample, author={Bonett, Douglas G.}, title={{Sample size requirements for estimating intraclass correlations with desired precision}}, journal={Statistics in Medicine}, year={2002}, volume={21}, number={9}, pages={1331--1335}, doi={10.1002/sim.1108}}@article{bonett2000sample, author={Bonett, Douglas G. and Wright, Thomas A.}, title={{Sample size requirements for estimating Pearson, Kendall and Spearman correlations}}, journal={Psychometrika}, year={2000}, volume={65}, number={1}, pages={23--28}, doi={10.1007/bf02294183}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{kelley2003sample, author={Kelley, Ken and Maxwell, Scott E.}, title={{Sample size for multiple regression: Obtaining regression coefficients that are accurate, not simply significant}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={305--321}, doi={10.1037/1082-989x.8.3.305}}@article{kelley2006sample, author={Kelley, Ken and Rausch, Joseph R.}, title={{Sample size planning for the standardized mean difference: Accuracy in parameter estimation via narrow confidence intervals}}, journal={Psychological Methods}, year={2006}, volume={11}, number={4}, pages={363--385}, doi={10.1037/1082-989x.11.4.363}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{maxwell2008sample, author={Maxwell, Scott E. and Kelley, Ken and Rausch, Joseph R.}, title={{Sample size planning for statistical power and accuracy in parameter estimation}}, journal={Annual Review of Psychology}, year={2008}, volume={59}, number={1}, pages={537--563}, doi={10.1146/annurev.psych.59.103006.093735}}@article{teare2014sample, author={Teare, M. Dawn and Dimairo, Munyaradzi and Shephard, Neil and Hayman, Alex and Whitehead, Amy and Walters, Stephen J.}, title={{Sample size requirements to estimate key design parameters from external pilot randomised controlled trials: A simulation study}}, journal={Trials}, year={2014}, volume={15}, number={1}, eid={264}, doi={10.1186/1745-6215-15-264}}