Co to jest badanie pilotażowe i po co je robić?
Badanie pilotażowe (ang. pilot study) to próbna, zmniejszona wersja badania, którą przeprowadzasz przed badaniem właściwym, żeby sprawdzić, czy narzędzie i procedura działają tak, jak je zaplanowano. Van Teijlingen i Hundley (2001) zwracają uwagę, że termin ma dwa znaczenia: może oznaczać pomniejszoną wersję całego badania (studium wykonalności) albo pretest konkretnego narzędzia, np. kwestionariusza. W pracy dyplomowej z psychologii najczęściej chodzi o to drugie – ankietę sprawdzasz na kilkudziesięciu osobach, zanim roześlesz ją do kilkuset.
Pilotaż odpowiada na pytanie „czy da się to zrobić i czy narzędzie działa?”, a nie „czy moja hipoteza jest prawdziwa?”. Leon i in. (2011) podkreślają, że badanie pilotażowe służy ocenie wykonalności – rekrutacji, utrzymania uczestników w badaniu, procedur pomiaru i przebiegu – a nie testowaniu hipotez. To rozróżnienie ma praktyczną konsekwencję, do której wrócimy przy analizie mocy: wynik pilotażu nie mówi wiarygodnie, jak duży jest efekt.
Po co ten wysiłek? Błąd wykryty na 30 osobach kosztuje godzinę poprawek. Ten sam błąd wykryty po zebraniu 300 ankiet może przekreślić całe badanie: nieprzekodowana pozycja odwrócona, niedziałający filtr albo pytanie, które połowa osób rozumie inaczej, niż zamierzał autor. Pilotaż zwiększa szansę powodzenia badania głównego, choć jej nie gwarantuje (van Teijlingen i Hundley, 2001). Krótką definicję pojęcia znajdziesz w haśle badanie pilotażowe, a miejsce pilotażu w całym procesie przygotowania narzędzia opisujemy w poradniku jak zrobić ankietę do pracy dyplomowej.
Pretest, pilotaż i badanie wykonalności – czym się różnią?
Te nazwy bywają używane zamiennie, ale każda forma odpowiada na inne pytanie. Thabane i in. (2010) grupują powody prowadzenia pilotażu w cztery obszary: proces (np. rekrutacja, odsetek odmów i rezygnacji), zasoby (np. czas potrzebny na wypełnienie formularzy), zarządzanie (np. problemy z wprowadzaniem danych) i kwestie naukowe (np. zmienność wyników). W badaniu ankietowym przekłada się to na cztery formy sprawdzania narzędzia.
| Forma | Główne pytanie | Co robisz | Kiedy w pracy dyplomowej |
|---|---|---|---|
| Wywiad poznawczy (pretest poznawczy) | Czy ludzie rozumieją pytania tak, jak zamierzał autor? | Rozmowa jeden na jeden: głośne myślenie i pytania sondujące | Własne pytania, nowa skala, tłumaczone pozycje |
| Pretest techniczny | Czy ankieta działa? | Przejście wszystkich ścieżek i filtrów na komputerze i telefonie | Każda ankieta internetowa |
| Pilotaż ankiety | Jak całe narzędzie działa w małej próbie? | Wersja internetowa na osobach z populacji docelowej; analiza czasu, rozkładów, braków i spójności skal | Większość prac z ankietą |
| Badanie wykonalności (feasibility study) | Czy da się przeprowadzić całe badanie? | Próbna rekrutacja, procedura, interwencja i pomiar końcowy | Eksperymenty, interwencje, badania podłużne |
Dla randomizowanych badań pilotażowych i badań wykonalności powstało rozszerzenie wytycznych CONSORT: 26-punktowa lista kontrolna, która wymaga m.in. opisania, jak identyfikowano uczestników i uzyskiwano zgodę, oraz podania wcześniej określonych kryteriów decyzji, czy i jak przejść do badania właściwego (Eldridge i in., 2016). Nawet jeśli robisz zwykłą ankietę, a nie eksperyment, przejmij ten pomysł: zanim zaczniesz pilotaż, zapisz, jaki wynik oznacza „idziemy dalej”, a jaki „poprawiamy” – np. „jeśli mediana czasu przekroczy 15 minut, skracamy ankietę”.
Co sprawdzić w pilotażu ankiety?
Van Teijlingen i Hundley (2001) wymieniają wiele funkcji pilotażu, m.in. sprawdzenie narzędzi, protokołu, rekrutacji, logistyki i planowanej analizy oraz oszacowanie zmienności wyników. W ankiecie do pracy dyplomowej przekłada się to na osiem obszarów.
| Obszar | Sygnał ostrzegawczy | Jak to sprawdzić |
|---|---|---|
| 1. Zrozumiałość pytań | Różne interpretacje tego samego pytania, prośby o wyjaśnienie, komentarze „nie wiem, co zaznaczyć” | Wywiady poznawcze; pytanie otwarte „Czy coś było niejasne?” na końcu pilotażu |
| 2. Czas wypełniania | Mediana wyraźnie dłuższa, niż zakładano; porzucenia w połowie ankiety | Znaczniki czasu z platformy; liczba osób, które zaczęły i skończyły |
| 3. Działanie techniczne | Ktoś nie może przejść dalej, filtr prowadzi do złych pytań, tabela jest nieczytelna na telefonie | Przejście każdej ścieżki na kilku urządzeniach; próbny eksport danych |
| 4. Rozkłady odpowiedzi | Większość osób wybiera skrajną odpowiedź (efekt sufitu lub podłogi) | Odsetek odpowiedzi minimalnych i maksymalnych w każdej pozycji |
| 5. Braki danych | W jednym pytaniu wyraźnie więcej pominięć niż w pozostałych | Odsetek braków danych w każdej pozycji |
| 6. Spójność skal | Korelacja pozycja–reszta bliska zera lub ujemna | Korelacje pozycja–reszta i alfa Cronbacha z przedziałem ufności |
| 7. Procedura i rekrutacja | Mało osób kończy ankietę, pojawiają się pytania o anonimowość, zaproszenie jest niejasne | Odsetek ukończeń; komentarze uczestników; test treści zaproszenia |
| 8. Plan analizy | Brakuje zmiennej potrzebnej do hipotezy, odpowiedzi są źle zakodowane | Próbny eksport i uruchomienie skryptu analizy na danych z pilotażu |
Najczęściej pomijany jest punkt ósmy. Tymczasem właśnie próbne uruchomienie analizy pokazuje, że np. pozycja odwrócona nie została przekodowana, pytanie wielokrotnego wyboru wyeksportowało się do jednej kolumny, a zmienna potrzebna do moderacji w ogóle nie trafiła do ankiety. Jak przygotować plik do analizy, opisujemy w poradniku o eksporcie danych z Google Forms i LimeSurvey. Sprawdź też, czy działają pytania kontrolne i czy w danych nie widać wzorów nieuważnego odpowiadania.
Część problemów strukturalnych – niedziałający filtr, odwrócony klucz, pytanie bez zmienności – da się wychwycić jeszcze przed pilotażem z ludźmi, np. w pilotażu z syntetycznymi respondentami. Takie dane nie zastępują jednak prawdziwych uczestników: syntetyczni respondenci nie odtwarzają w pełni tego, jak konkretne osoby rozumieją pytania i reagują na nie (więcej w tekście o syntetycznych respondentach).
Ile osób do badania pilotażowego?
Nie ma jednej liczby – liczebność zależy od tego, co pilotaż ma sprawdzić. Hertzog (2008) pokazuje, że ogólne reguły typu „10% liczebności badania głównego” mogą nie wystarczyć, i na podstawie przedziałów ufności ocenia, czy próby od 10 do 40 osób na grupę dają dostatecznie precyzyjne oszacowania dla różnych celów pilotażu. Rekomendacje z literatury zebraliśmy w tabeli.
| Cel pilotażu | Rekomendacja | Źródło |
|---|---|---|
| Wywiady poznawcze – czy pytania są zrozumiałe | Rundy po ok. 10 wywiadów; w małych projektach nawet 5–6 wywiadów daje użyteczne informacje, a łącznie zwykle bada się 10–30 osób | Willis i Artino (2013) |
| Pretest kwestionariusza – wykrycie problemów z pozycjami | Domyślnie 30 osób | Perneger i in. (2015) |
| Pilotaż z porównaniem grup, gdy brak wcześniejszych danych – oszacowanie średniej i wariancji | 12 osób na grupę | Julious (2005) |
| Pilotaż z porównaniem grup – zależnie od tego, co trzeba oszacować i z jaką precyzją | 10–40 osób na grupę | Hertzog (2008) |
Dlaczego w preteście kwestionariusza 30, a nie 5 osób? Perneger i in. (2015) policzyli, że jeśli problem z pozycją dotyczy 5% respondentów, pretest na 10 osobach ma tylko 40% szans, by ujawniła go choć jedna osoba (na 20 osobach – 64%). Typowe małe pretesty (5–15 osób) mogą więc przeoczyć nawet częste problemy. Ten rachunek łatwo powtórzyć samodzielnie:
gdzie f to odsetek osób, u których problem występuje, a n – liczba osób w preteście. Rysunek 1 pokazuje tę zależność dla problemów dotyczących 5%, 10% i 20% respondentów.
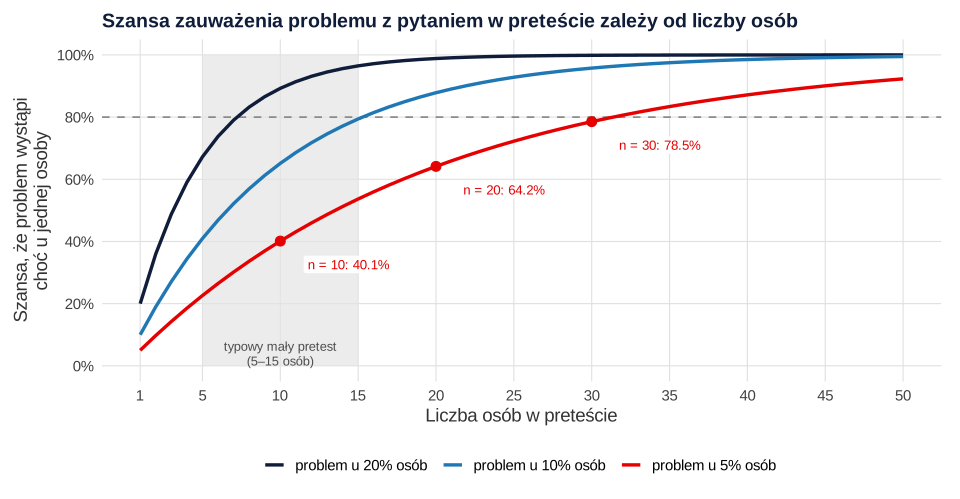
Gdy problem dotyczy co piątej osoby, 8 uczestników daje 80% szans na jego zauważenie. Gdy dotyczy co dwudziestej osoby, potrzeba 32 uczestników dla 80% szans i 59 dla 95% szans. Ten rachunek jest optymistyczny: zakłada, że każda osoba, której problem dotyczy, ujawni go, a Ty go zauważysz. W praktyce szanse są mniejsze – to kolejny argument za pilotażem na co najmniej kilkudziesięciu osobach i za wywiadami poznawczymi, w których o rozumienie pytań pytasz wprost.
Trzy zasady doboru osób do pilotażu:
- Badaj osoby z populacji docelowej, a nie znajomych z seminarium, którzy znają Twoje hipotezy. Jeśli badasz studentów pierwszego roku, pilotaż też zrób na studentach pierwszego roku.
- Zadbaj o różnorodność: osoby w różnym wieku, z różnych kierunków, wypełniające ankietę na telefonie i na komputerze. Problemy często dotyczą tylko części respondentów.
- Nie włączaj uczestników pilotażu do badania głównego. Willis i Artino (2013) zalecają, by ani osób z wywiadów poznawczych, ani ich danych nie wykorzystywać ponownie w badaniu właściwym, a van Teijlingen i Hundley (2001) zwracają uwagę, że osoby, które znają już narzędzie, mogą odpowiadać inaczej.
Dlaczego nie liczyć analizy mocy z wyniku pilotażu?
To częsty błąd w planowaniu liczebności. Robisz pilotaż na 24 osobach (12 na grupę), liczysz d Cohena i wpisujesz go do G*Power, żeby ustalić, ile osób potrzebujesz w badaniu głównym. Leon i in. (2011) odradzają to wprost: ze względu na nieprecyzyjność małych prób pilotaż nie dostarcza sensownego oszacowania wielkości efektu do planowania kolejnego badania. Podobnie ostrzegają Thabane i in. (2010): oszacowania efektu z małych prób bywają nierealistyczne lub obciążone, więc mogą wprowadzić w błąd przy obliczaniu liczebności.
Sprawdziliśmy to w symulacji. Założyliśmy, że w populacji różnica między dwiema grupami (np. studentami po treningu uważności i bez niego) wynosi d = 0.30. Wylosowaliśmy 10 000 pilotaży po 12 osób na grupę i 10 000 pilotaży po 50 osób na grupę i w każdym policzyliśmy d Cohena. Rysunek 2 pokazuje, jakie wartości mógłby zobaczyć badacz w swoim jedynym pilotażu.
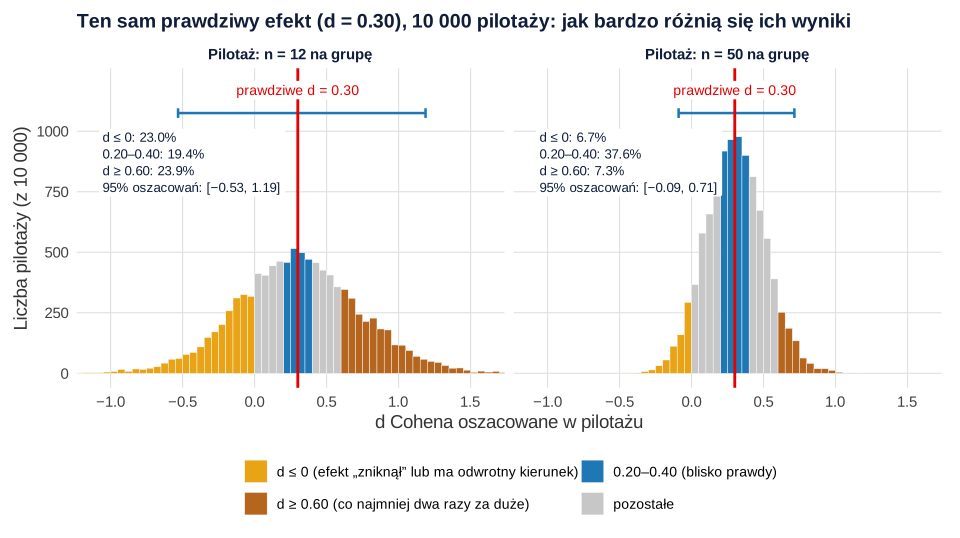
Przy 12 osobach na grupę 95% oszacowań mieści się między −0.53 a 1.19. W 23.0% pilotaży efekt „zniknął” albo wyszedł w przeciwnym kierunku (d ≤ 0), w 23.9% był co najmniej dwa razy za duży (d ≥ 0.60), a tylko 19.4% oszacowań trafiło w przedział 0.20–0.40. Pilotaż z 50 osobami na grupę jest wyraźnie lepszy, ale wciąż mało precyzyjny: 95% oszacowań leży między −0.09 a 0.71.
Co z tego wynika dla planowania badania? Aby wykryć d = 0.30 z mocą 80% (test t dla prób niezależnych, α = .05, test dwustronny), potrzeba 176 osób na grupę. Tabela pokazuje, co się dzieje, gdy zamiast tego wpiszesz do kalkulatora d z pilotażu.
| Wynik symulacji | Pilotaż: 12 osób na grupę | Pilotaż: 50 osób na grupę |
|---|---|---|
| Pilotaże z d ≤ 0 (nie da się z nich zaplanować badania) | 23.0% | 6.7% |
| Mediana zaplanowanej liczebności na grupęa | 91 | 156 |
| Zaplanowano mniej niż połowę potrzebnych 176 osób na grupęa | 49.0% | 29.1% |
| Mediana rzeczywistej mocy badania głównegoa | 52.1% | 75.2% |
| Badania główne z mocą poniżej 50%a | 48.7% | 28.6% |
| Kontynuacja tylko po „obiecującym” pilotażu (d ≥ 0.20): mediana liczebności na grupę / mediana mocy | 59 / 36.5% | 108 / 59.3% |
a Wśród pilotaży z d > 0. Liczebność badania głównego obliczono funkcją power.t.test() dla mocy 80% i α = .05, a rzeczywistą moc – dla prawdziwego d = 0.30. Obliczenia: R (dane symulowane).
Badacz, który zaplanuje badanie na podstawie pilotażu 12 + 12, w typowym przypadku zbierze 91 osób na grupę i będzie miał niewiele ponad 50% szans na wykrycie efektu, który naprawdę istnieje. Jeszcze gorzej, gdy badanie kontynuuje się tylko po „obiecującym” pilotażu: pilotaże z niedoszacowanym efektem odpadają, a te z przeszacowanym prowadzą do zbyt małych badań głównych (mediana mocy 36.5%). Albers i Lakens (2018) nazywają ten mechanizm obciążeniem kontynuacji (follow-up bias) i pokazują, że prowadzi on do niedoszacowania mocy badań głównych. Z drugiej strony 40.2% pilotaży 12 + 12 daje d < 0.20 – po takim wyniku łatwo porzucić pomysł, choć efekt istnieje.
Co robić zamiast tego?
- Oprzyj analizę mocy na najmniejszym efekcie, który ma dla Ciebie znaczenie, albo na wynikach metaanaliz i dużych badań. Lakens (2022) opisuje sześć sposobów uzasadnienia liczebności próby – od ograniczeń zasobów, przez analizę mocy a priori, po planowanie dokładności oszacowania – i wskazuje, jakie wielkości efektu warto przy tym rozważyć. Praktyczne kroki znajdziesz w haśle analiza mocy a priori w G*Power i w poradniku dobór liczebności próby.
- Wykorzystaj pilotaż do tego, co szacuje lepiej: zmienności wyników, czasu wypełniania, odsetka osób, które kończą badanie. Julious (2005) uzasadnia regułę 12 osób na grupę względami wykonalności oraz precyzją oszacowania średniej i wariancji. To inny cel niż oszacowanie efektu – rysunek 2 pokazuje, jak nieprecyzyjne jest d przy takiej liczebności.
- Pokaż niepewność: zamiast jednej liczby z pilotażu przygotuj tabelę liczebności dla kilku wartości efektu (np. d = 0.20, 0.30 i 0.40). Tabelę liczebności odzwierciedlającą niepewność oszacowań proponują Thabane i in. (2010).
- Nie testuj hipotez na danych z pilotażu. Wynik nieistotny w pilotażu nie oznacza braku efektu, a istotny nie potwierdza hipotezy (zob. błąd I i II rodzaju).
Przykład w R: analiza danych z pilotażu
Pierwszy przepis pokazuje szybką kontrolę danych z pilotażu ankiety, drugi – symulację, z której pochodzą liczby w tabeli powyżej. Rysunki przygotowano tym samym kodem rozszerzonym o wykresy.
Pilotaż ankiety: czas, braki, odpowiedzi skrajne i spójność skali
R
library(psych)
set.seed(29)
n <- 30                                                   # pilotaż: 30 studentów
stres <- rnorm(n)                                         # nasilenie stresu (zmienna ukryta)
pozycja <- function(a, b) pmin(5, pmax(1, round(a + b * stres + rnorm(n, 0, 0.8))))
pilot <- data.frame(
  czas_min = round(exp(rnorm(n, log(8.5), 0.35)), 1),    # czas wypełniania w minutach
  s1 = pozycja(3.0, 0.9), s2 = pozycja(4.6, 0.5), s3 = pozycja(2.9, 0.9),
  s4 = pozycja(3.0, -0.9),                                # pozycja z przeczeniem (odwrócona)
  s5 = pozycja(3.1, 0.8), s6 = pozycja(2.8, 0.9))
zle <- sample(n, 12); pilot$s4[zle] <- 6 - pilot$s4[zle]  # 12 osób źle odczytało przeczenie
pilot$s5[sample(n, 4)] <- NA                              # 4 osoby pominęły pytanie o pracę zarobkową
pilot$s4 <- 6 - pilot$s4                                  # rekodowanie pozycji odwróconej

# 1. Czas wypełniania: 10., 50. i 90. centyl (minuty)
round(quantile(pilot$czas_min, c(.10, .50, .90)), 1)

# 2. Braki danych oraz odsetek odpowiedzi skrajnych w każdej pozycji (%)
poz <- pilot[, paste0("s", 1:6)]
round(rbind(braki = 100 * colMeans(is.na(poz)),
            odp_1 = 100 * colMeans(poz == 1, na.rm = TRUE),
            odp_5 = 100 * colMeans(poz == 5, na.rm = TRUE)), 1)

# 3. Pierwszy rzut oka na rzetelność: korelacja pozycja–reszta, alfa bez pozycji, alfa z 95% CI
a <- psych::alpha(poz, warnings = FALSE)
round(data.frame(r_pozycja_reszta = a$item.stats$r.drop,
                 alfa_bez_pozycji = a$alpha.drop$raw_alpha, row.names = names(poz)), 2)
print(psych::alpha.ci(a$total$raw_alpha, n.obs = n, n.var = 6))
Wynik w R
 10%  50%  90%
 5.4  8.5 12.0
        s1   s2   s3 s4   s5   s6
braki  0.0  0.0  0.0  0 13.3  0.0
odp_1 13.3  0.0  6.7 20  3.8 13.3
odp_5  3.3 56.7 10.0 20  7.7 13.3
   r_pozycja_reszta alfa_bez_pozycji
s1             0.65             0.58
s2             0.20             0.71
s3             0.60             0.60
s4             0.04             0.81
s5             0.52             0.63
s6             0.74             0.54

   95% confidence boundaries (Feldt)
 lower alpha upper
   0.5   0.7  0.84
Symulacja: d Cohena z pilotażu a liczebność badania głównego
R
set.seed(2026)
d_cohena <- function(x, y) {
  sp <- sqrt(((length(x) - 1) * var(x) + (length(y) - 1) * var(y)) / (length(x) + length(y) - 2))
  (mean(x) - mean(y)) / sp
}
d12 <- replicate(10000, d_cohena(rnorm(12, 0.30, 1), rnorm(12, 0, 1)))  # pilotaże: 12 osób na grupę
d50 <- replicate(10000, d_cohena(rnorm(50, 0.30, 1), rnorm(50, 0, 1)))  # pilotaże: 50 osób na grupę
round(rbind(n12 = quantile(d12, c(.025, .975)), n50 = quantile(d50, c(.025, .975))), 2)
round(100 * c(n12 = mean(d12 <= 0), n50 = mean(d50 <= 0)), 1)            # % pilotaży z d <= 0

# Liczebność badania głównego policzona z d z pilotażu (moc 80%, alfa = .05, test dwustronny)
dod <- d12[d12 > 0]
n_plan <- sapply(dod, function(d)
  tryCatch(ceiling(power.t.test(delta = d, power = 0.80)$n), error = function(e) Inf))
moc <- sapply(n_plan, function(n) if (is.finite(n)) power.t.test(n = n, delta = 0.30)$power else 1)
c(potrzebne_n = ceiling(power.t.test(delta = 0.30, power = 0.80)$n),
  mediana_n_plan = median(n_plan), mediana_mocy = round(median(moc), 3),
  mediana_mocy_gdy_d_od_020 = round(median(moc[dod >= 0.20]), 3))
Wynik w R
     2.5% 97.5%
n12 -0.53  1.19
n50 -0.09  0.71
 n12  n50
23.0  6.7
              potrzebne_n            mediana_n_plan              mediana_mocy
                  176.000                    91.000                     0.521
mediana_mocy_gdy_d_od_020
                    0.365
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Co zmienić po pilotażu? Przykład decyzji
W przykładzie z kodu 30 studentów wypełniło roboczą, sześciopozycyjną skalę stresu związanego ze studiami. Każdy wynik prowadzi do konkretnej decyzji.
| Wynik pilotażu | Prawdopodobna przyczyna | Decyzja |
|---|---|---|
| Pozycja s4 („Nie czuję się przytłoczony/a liczbą obowiązków”): korelacja pozycja–reszta r = .04; alfa bez tej pozycji rośnie z .70 do .81 | Przeczenie w pozycji odwróconej – część osób odpowiadała tak, jakby pozycja była sformułowana twierdząco | Przeformułuj pozycję bez przeczenia i sprawdź ją w kilku wywiadach poznawczych; nie usuwaj pozycji tylko dlatego, że podnosi to alfę |
| Pozycja s2 („Zdarza mi się martwić egzaminami”): 56.7% osób wybrało najwyższą odpowiedź | Pozycja jest zbyt „łatwa” – zgadza się z nią prawie każdy (efekt sufitu) | Zaostrz treść (np. „Martwię się egzaminami tak bardzo, że trudno mi się skupić”) albo zmień format na częstość |
| Pozycja s5 („Trudno mi pogodzić studia z pracą zarobkową”): 13.3% braków | Pytanie nie dotyczy osób, które nie pracują | Dodaj pytanie filtrujące o pracę albo odpowiedź „nie dotyczy” i zakoduj ją osobno |
| Czas: mediana 8.5 min, 90% osób skończyło w ciągu 12.0 min | – | W zaproszeniu napisz „około 10 minut”; nie podawaj najkrótszego czasu |
| Alfa Cronbacha .70, 95% CI [.50, .84] | Mała próba – szeroki przedział ufności | Nie przedstawiaj alfy z pilotażu jako właściwości skali; policz ją ponownie w badaniu głównym (zob. spójność wewnętrzna) |
Po takich poprawkach wróć do pytania, co dalej z całym badaniem. Thabane i in. (2010) proponują cztery możliwe wnioski z pilotażu: przerwać (badanie główne jest niewykonalne), kontynuować ze zmianami protokołu, kontynuować bez zmian, ale ściśle monitorować przebieg albo kontynuować bez zmian. Jeśli pilotaż ujawnił tylko problemy z pytaniami, zwykle wystarczy wariant drugi: poprawiasz narzędzie i ruszasz z badaniem.
Poprawki trzeba jednak sprawdzić. W eksperymencie Lenznera i in. (2023) problemy wykryte w dziesięciu wywiadach poznawczych rzeczywiście ujawniały się w badaniu właściwym (n = 2200), ale wersja pytania poprawiona na ich podstawie nie musiała dawać danych lepszej jakości. Wniosek: pretestuj iteracyjnie – po zmianach przeprowadź kolejną, choćby krótką rundę wywiadów albo mini-pilotaż.
Osobna sprawa to dane. Jeśli po pilotażu zmieniłeś narzędzie, nie łącz danych z pilotażu z danymi z badania głównego. Van Teijlingen i Hundley (2001) opisują to jako ryzyko „zanieczyszczenia” wyników. Thabane i in. (2010) dopuszczają łączenie danych tylko wtedy, gdy dobór próby i metody były identyczne, a połączenie zaplanowano z góry w protokole – po zmianach w ankiecie ten warunek nie jest spełniony.
Jak opisać badanie pilotażowe w pracy?
Pilotaż opisz w rozdziale metodologicznym, w części o narzędziach lub procedurze. Lista kontrolna CROSS dla badań ankietowych obejmuje m.in. informację o pretestowaniu kwestionariusza: jaką metodą go przeprowadzono, na ilu osobach i jakie miały one cechy (Sharma i in., 2021). Van Teijlingen i Hundley (2001) zachęcają, by raportować, czego konkretnie nauczył nas pilotaż – samo zdanie „przeprowadzono pilotaż” nic czytelnikowi nie mówi.
| Element opisu | Co napisać |
|---|---|
| Cel | Co sprawdzałeś: zrozumiałość pytań, czas, działanie skal, procedurę, rekrutację |
| Uczestnicy | Liczba osób, sposób rekrutacji, podobieństwo do populacji docelowej |
| Metoda | Wywiady poznawcze (jaka technika), pilotaż internetowy, urządzenia |
| Wyniki | Czas wypełniania, problemy z pozycjami, braki danych, spójność skal z przedziałem ufności |
| Zmiany | Co zmieniono i dlaczego – najlepiej tabela „przed i po” w aneksie |
| Dane | Czy dane z pilotażu włączono do analiz (zwykle nie) i czy uczestnicy pilotażu brali udział w badaniu głównym |
Przykładowy opis na podstawie pilotażu z kodu (liczbę wywiadów poznawczych uzupełnij własną):
Gdzie umieścić ten akapit i jak opisać pozostałe elementy procedury, pokazujemy w poradniku o rozdziale metodologicznym pracy magisterskiej.
Najczęstsze błędy
- Pilotaż na znajomych – osoby spoza populacji docelowej, które znają cel badania, nie pokażą prawdziwych problemów z pytaniami.
- Za mało osób w preteście – przy 10 osobach problem dotyczący 5% respondentów ma 40% szans, by się ujawnić (Perneger i in., 2015).
- Analiza mocy z efektu z pilotażu – oszacowanie jest zbyt nieprecyzyjne (Leon i in., 2011), a kontynuowanie tylko „obiecujących” pilotaży zaniża moc badań głównych (Albers i Lakens, 2018).
- Testowanie hipotez na danych z pilotażu i raportowanie ich wartości p jako wyników pracy.
- Alfa z pilotażu jako dowód rzetelności – przy 30 osobach 95% przedział ufności dla α = .70 sięga od .50 do .84.
- Brak ponownego testu po poprawkach – poprawiona wersja pytania nie musi działać lepiej (Lenzner i in., 2023).
- Łączenie danych z pilotażu i badania głównego po zmianach w narzędziu.
- Pilotaż tylko na komputerze, choć część osób wypełni ankietę na telefonie – tabele i suwaki działają na smartfonie inaczej (zob. najczęstsze błędy w ankietach).
Najczęstsze pytania
Ile osób potrzeba do badania pilotażowego?
To zależy od celu. Wywiady poznawcze prowadzi się zwykle w rundach po ok. 10 osób, do pretestu kwestionariusza Perneger i in. (2015) rekomendują domyślnie 30 osób, a w pilotażu z porównaniem grup – 12 osób na grupę (Julious, 2005) albo 10–40 osób na grupę zależnie od tego, co chcesz oszacować (Hertzog, 2008).
Czy badanie pilotażowe jest obowiązkowe w pracy magisterskiej?
Nie ma ogólnej reguły, która by go wymagała – decydują promotor, wydział albo komisja etyczna. Pilotaż warto jednak zrobić przy każdej ankiecie z własnymi pytaniami lub nową skalą, bo błędów wykrytych po zebraniu danych zwykle nie da się już naprawić.
Czy dane z pilotażu można włączyć do badania głównego?
Zwykle nie. Jeśli po pilotażu zmieniłeś narzędzie, dane nie są porównywalne, a osoby z pilotażu znają już pytania. Łączenie danych ma sens tylko wtedy, gdy dobór próby i metody były identyczne, a połączenie zaplanowano z góry (Thabane i in., 2010).
Czy z pilotażu można obliczyć wielkość efektu do G*Power?
Nie należy tego robić. W naszej symulacji przy 12 osobach na grupę 95% oszacowań d mieściło się między −0.53 a 1.19, choć prawdziwe d wynosiło 0.30. Analizę mocy opieraj na najmniejszym efekcie, który ma znaczenie, albo na wynikach metaanaliz (Leon i in., 2011; Lakens, 2022).
Co zrobić, gdy pilotaż wypadł źle?
Potraktuj to jako sukces pilotażu – wykrył problemy przed badaniem głównym. Popraw pytania niezrozumiałe lub nieróżnicujące osób, skróć ankietę, napraw filtry, a poprawioną wersję sprawdź ponownie na kilku osobach. Gdy problem dotyczy wykonalności, np. rekrutacji, zmień procedurę.
Jak opisać badanie pilotażowe w pracy?
W rozdziale metodologicznym podaj cel pilotażu, liczbę i charakterystykę uczestników, metodę (np. wywiady poznawcze, pilotaż internetowy), najważniejsze wyniki i wprowadzone zmiany. Lista kontrolna CROSS obejmuje opis metody pretestu oraz liczby i cech osób, które w nim uczestniczyły (Sharma i in., 2021).
Powiązane hasła
Przeczytaj też
Jak zrobić ankietę do pracy dyplomowej
12 kroków od hipotez do czystych danych: skale, pytania, zgoda, pilotaż, Google Forms czy LimeSurvey, książka kodów, harmonogram i lista kontrolna.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikSyntetyczni respondenci (LLM) w badaniach
Co potrafią modele językowe odgrywające respondentów, gdzie zawodzą i do czego warto ich używać: dowody z badań, tabela „tak/nie” i wzór opisu w pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Albers, C., & Lakens, D. (2018). When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias. Journal of Experimental Social Psychology, 74, 187–195. https://doi.org/10.1016/j.jesp.2017.09.004 ● Otwarty dostęp
- Eldridge, S. M., Chan, C. L., Campbell, M. J., Bond, C. M., Hopewell, S., Thabane, L., & Lancaster, G. A. (2016). CONSORT 2010 statement: Extension to randomised pilot and feasibility trials. BMJ, 355, Article i5239. https://doi.org/10.1136/bmj.i5239 ● Otwarty dostęp
- Hertzog, M. A. (2008). Considerations in determining sample size for pilot studies. Research in Nursing & Health, 31(2), 180–191. https://doi.org/10.1002/nur.20247
- Julious, S. A. (2005). Sample size of 12 per group rule of thumb for a pilot study. Pharmaceutical Statistics, 4(4), 287–291. https://doi.org/10.1002/pst.185
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lenzner, T., Hadler, P., & Neuert, C. (2023). An experimental test of the effectiveness of cognitive interviewing in pretesting questionnaires. Quality & Quantity, 57(4), 3199–3217. https://doi.org/10.1007/s11135-022-01489-4 ● Otwarty dostęp
- Leon, A. C., Davis, L. L., & Kraemer, H. C. (2011). The role and interpretation of pilot studies in clinical research. Journal of Psychiatric Research, 45(5), 626–629. https://doi.org/10.1016/j.jpsychires.2010.10.008 ● Otwarty dostęp
- Perneger, T. V., Courvoisier, D. S., Hudelson, P. M., & Gayet-Ageron, A. (2015). Sample size for pre-tests of questionnaires. Quality of Life Research, 24(1), 147–151. https://doi.org/10.1007/s11136-014-0752-2 ● Otwarty dostęp: pełny tekst
- Sharma, A., Minh Duc, N. T., Luu Lam Thang, T., Nam, N. H., Ng, S. J., Abbas, K. S., Huy, N. T., Marušić, A., Paul, C. L., Kwok, J., Karbwang, J., de Waure, C., Drummond, F. J., Kizawa, Y., Taal, E., Vermeulen, J., Lee, G. H. M., Gyedu, A., To, K. G., . . . Karamouzian, M. (2021). A consensus-based Checklist for Reporting of Survey Studies (CROSS). Journal of General Internal Medicine, 36(10), 3179–3187. https://doi.org/10.1007/s11606-021-06737-1 ● Otwarty dostęp
- Thabane, L., Ma, J., Chu, R., Cheng, J., Ismaila, A., Rios, L. P., Robson, R., Thabane, M., Giangregorio, L., & Goldsmith, C. H. (2010). A tutorial on pilot studies: The what, why and how. BMC Medical Research Methodology, 10(1), Article 1. https://doi.org/10.1186/1471-2288-10-1 ● Otwarty dostęp
- van Teijlingen, E. R., & Hundley, V. (2001). The importance of pilot studies. Social Research Update. https://sru.soc.surrey.ac.uk/SRU35.html ● Otwarty dostęp
- Willis, G. B., & Artino, A. R., Jr. (2013). What do our respondents think we're asking? Using cognitive interviewing to improve medical education surveys. Journal of Graduate Medical Education, 5(3), 353–356. https://doi.org/10.4300/JGME-D-13-00154.1 ● Otwarty dostęp
Cytowania BibTeX
@article{albers2018power, author={Albers, Casper and Lakens, Daniël}, title={{When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={74}, pages={187--195}, doi={10.1016/j.jesp.2017.09.004}}@article{eldridge2016consort, author={Eldridge, Sandra M. and Chan, Claire L. and Campbell, Michael J. and Bond, Christine M. and Hopewell, Sally and Thabane, Lehana and Lancaster, Gillian A.}, title={{CONSORT 2010 statement: Extension to randomised pilot and feasibility trials}}, journal={BMJ}, year={2016}, volume={355}, eid={i5239}, doi={10.1136/bmj.i5239}}@article{hertzog2008considerations, author={Hertzog, Melody A.}, title={{Considerations in determining sample size for pilot studies}}, journal={Research in Nursing \& Health}, year={2008}, volume={31}, number={2}, pages={180--191}, doi={10.1002/nur.20247}}@article{julious2005sample, author={Julious, Steven A.}, title={{Sample size of 12 per group rule of thumb for a pilot study}}, journal={Pharmaceutical Statistics}, year={2005}, volume={4}, number={4}, pages={287--291}, doi={10.1002/pst.185}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lenzner2023experimental, author={Lenzner, Timo and Hadler, Patricia and Neuert, Cornelia}, title={{An experimental test of the effectiveness of cognitive interviewing in pretesting questionnaires}}, journal={Quality \& Quantity}, year={2023}, volume={57}, number={4}, pages={3199--3217}, doi={10.1007/s11135-022-01489-4}}@article{leon2011role, author={Leon, Andrew C. and Davis, Lori L. and Kraemer, Helena C.}, title={{The role and interpretation of pilot studies in clinical research}}, journal={Journal of Psychiatric Research}, year={2011}, volume={45}, number={5}, pages={626--629}, doi={10.1016/j.jpsychires.2010.10.008}}@article{perneger2015sample, author={Perneger, Thomas V. and Courvoisier, Delphine S. and Hudelson, Patricia M. and Gayet-Ageron, Angèle}, title={{Sample size for pre-tests of questionnaires}}, journal={Quality of Life Research}, year={2015}, volume={24}, number={1}, pages={147--151}, doi={10.1007/s11136-014-0752-2}}@article{sharma2021consensus, author={Sharma, Akash and Minh Duc, Nguyen Tran and Luu Lam Thang, Tai and Nam, Nguyen Hai and Ng, Sze Jia and Abbas, Kirellos Said and Huy, Nguyen Tien and Marušić, Ana and Paul, Christine L. and Kwok, Janette and Karbwang, Juntra and de Waure, Chiara and Drummond, Frances J. and Kizawa, Yoshiyuki and Taal, Erik and Vermeulen, Joeri and Lee, Gillian H. M. and Gyedu, Adam and To, Kien Gia and Verra, Martin L. and Jacqz-Aigrain, Évelyne M. and Leclercq, Wouter K. G. and Salminen, Simo T. and Sherbourne, Cathy Donald and Mintzes, Barbara and Lozano, Sergi and Tran, Ulrich S. and Matsui, Mitsuaki and Karamouzian, Mohammad}, title={{A consensus-based Checklist for Reporting of Survey Studies (CROSS)}}, journal={Journal of General Internal Medicine}, year={2021}, volume={36}, number={10}, pages={3179--3187}, doi={10.1007/s11606-021-06737-1}}@article{thabane2010tutorial, author={Thabane, Lehana and Ma, Jinhui and Chu, Rong and Cheng, Ji and Ismaila, Afisi and Rios, Lorena P. and Robson, Reid and Thabane, Marroon and Giangregorio, Lora and Goldsmith, Charles H.}, title={{A tutorial on pilot studies: The what, why and how}}, journal={BMC Medical Research Methodology}, year={2010}, volume={10}, number={1}, eid={1}, doi={10.1186/1471-2288-10-1}}@article{vanteijlingen2001importance, author={van Teijlingen, Edwin R. and Hundley, Vanora}, title={{The importance of pilot studies}}, journal={Social Research Update}, year={2001}, number={35}, url={https://sru.soc.surrey.ac.uk/SRU35.html}}@article{willis2013what, author={Willis, Gordon B. and Artino, Jr., Anthony R.}, title={{What do our respondents think we're asking? Using cognitive interviewing to improve medical education surveys}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={3}, pages={353--356}, doi={10.4300/jgme-d-13-00154.1}}