Co to jest d Cohena?
d Cohena to miara siły efektu dla różnicy dwóch średnich. Różnicę średnich dzieli się przez łączone odchylenie standardowe, dzięki czemu wynik nie zależy od jednostek pomiaru. Można więc porównywać efekty mierzone na różnych skalach, np. w punktach testu, sekundach czy wynikach kwestionariusza.
Wartość d = 0,5 oznacza, że średnia jednej grupy jest wyższa o pół odchylenia standardowego. Znak pokazuje tylko kierunek: jeśli zamienisz kolejność grup, d zmieni znak, ale nie wielkość. d Cohena jest naturalnym uzupełnieniem testu t dla prób niezależnych: test mówi, czy różnica jest statystycznie istotna, a d — jak jest duża.
Jak interpretować d Cohena?
Jacob Cohen (1988) zaproponował orientacyjne progi: 0,2 — efekt mały, 0,5 — średni, 0,8 — duży. Te same granice stosuje funkcja interpret_cohens_d() z pakietu effectsize w R (Ben-Shachar i in., 2020). Wartości poniżej 0,2 opisuje się jako bardzo małe lub pomijalne. Sawilowsky (2009) dodał kategorie „bardzo duży” (od 1,2) i „ogromny” (od 2,0).
| d Cohena | Etykieta (Cohen, 1988) | U3 | Wspólna część rozkładów | PS |
|---|---|---|---|---|
| poniżej 0,2 | bardzo mały (pomijalny) | — | — | — |
| 0,2 | mały | 57,9% | 92,0% | 55,6% |
| 0,5 | średni | 69,1% | 80,3% | 63,8% |
| 0,8 | duży | 78,8% | 68,9% | 71,4% |
| 1,2 | duży („bardzo duży” według Sawilowsky’ego, 2009) | 88,5% | 54,9% | 80,2% |
Kolumny tabeli tłumaczą d na język procentów. Przy założeniu rozkładów normalnych o równych wariancjach (McGraw i Wong, 1992):
- U3 — odsetek osób z grupy porównawczej, które mają wynik niższy od średniej grupy z wyższymi wynikami. Przy d = 0,5 to 69,1% (a nie 50%, jak przy braku różnicy).
- Wspólna część rozkładów — jaka część obu rozkładów się pokrywa. Nawet przy „dużym” efekcie d = 0,8 rozkłady pokrywają się w 68,9%.
- PS (prawdopodobieństwo przewagi) — szansa, że losowo wybrana osoba z jednej grupy ma wyższy wynik niż losowo wybrana osoba z drugiej. Przy d = 0,5 wynosi 63,8%.
d Cohena na wykresach
Poniższy rysunek, wykonany w R, pokazuje dwie grupy o rozkładzie normalnym i tym samym odchyleniu standardowym dla czterech wartości d. Szare pole to wspólna część rozkładów.
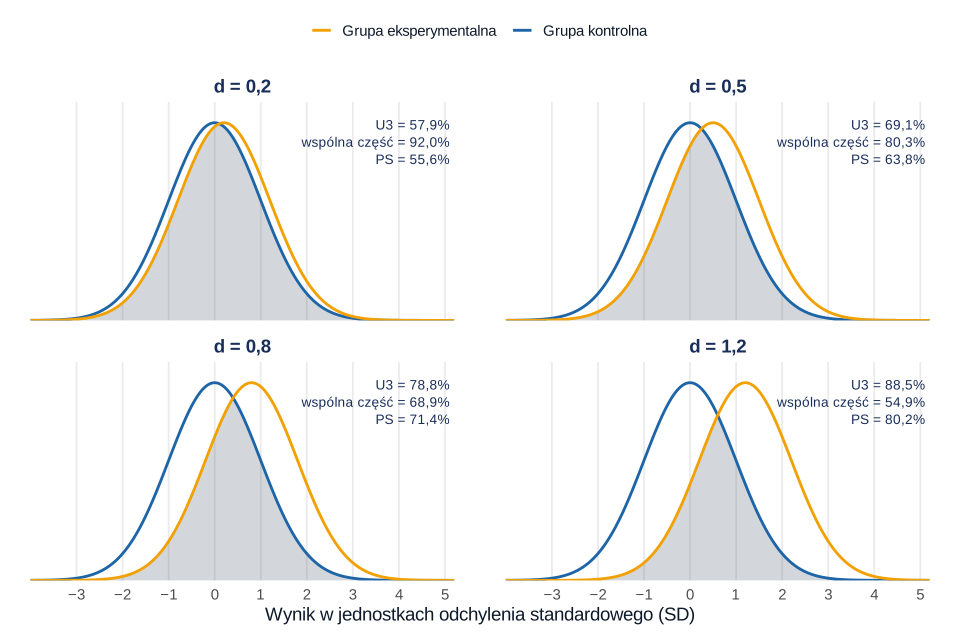
Wniosek z rysunku: nawet wyraźna różnica średnich oznacza duże nakładanie się wyników. Przy d = 0,8 wiele osób z grupy „słabszej” ma wyniki wyższe niż przeciętna osoba z grupy „lepszej”. Dlatego d opisuje różnicę przeciętnych wyników, a nie to, że każda osoba z jednej grupy przewyższa każdą osobę z drugiej.
Ta sama wartość d, różna precyzja
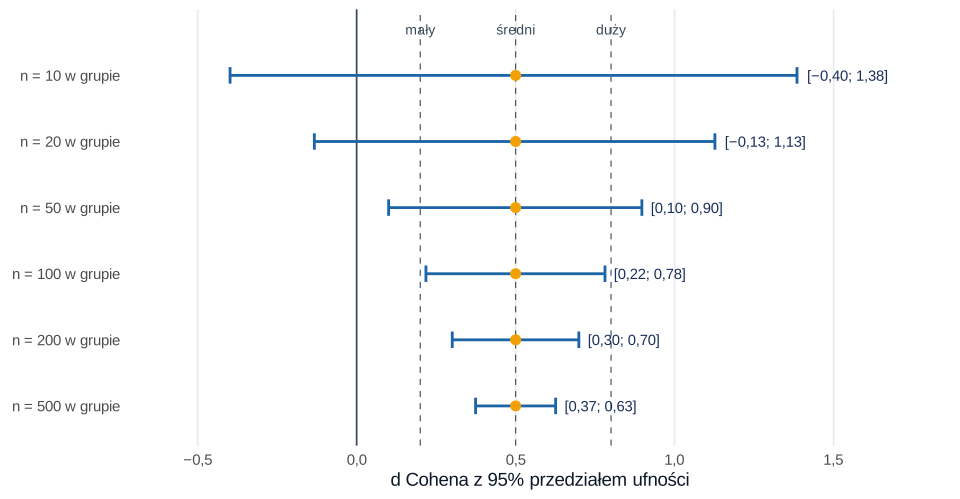
Wartość d z próby jest tylko oszacowaniem. Jej niepewność pokazuje przedział ufności, którego szerokość zależy przede wszystkim od liczebności grup. Na rysunku 2 każda próba ma dokładnie d = 0,5, ale 95% przedziały ufności (metoda niecentralnego rozkładu t, jak w pakiecie effectsize) bardzo się różnią.
| Liczebność w każdej grupie | d | 95% CI | Zakres zgodnych efektów |
|---|---|---|---|
| 10 | 0,50 | [−0,40; 1,38] | od efektu przeciwnego do dużego |
| 20 | 0,50 | [−0,13; 1,13] | od efektu przeciwnego do dużego |
| 50 | 0,50 | [0,10; 0,90] | od bardzo małego do dużego |
| 100 | 0,50 | [0,22; 0,78] | od małego do średniego |
| 200 | 0,50 | [0,30; 0,70] | od małego do średniego |
| 500 | 0,50 | [0,37; 0,63] | od małego do średniego |
Przy 20 osobach w grupie wynik d = 0,5 jest zgodny zarówno z brakiem różnicy, jak i z dużym efektem. Dopiero od około 100 osób w grupie przedział mieści się w zakresie efektów małych i średnich. Dlatego zamiast pisać „efekt był średni”, lepiej podać d z przedziałem ufności i opisać jego zakres. Planowanie liczebności pod oczekiwany efekt opisuje poradnik dobór liczebności próby.
Przykład: szkolenie a wynik testu wiedzy
W grupie po szkoleniu (n = 45) średni wynik testu wiedzy wyniósł M = 72,40 (SD = 11,80), a w grupie kontrolnej (n = 43) M = 66,10 (SD = 12,60). Łączone odchylenie standardowe wynosi 12,20, więc:
W R (pakiet effectsize) otrzymujemy d = 0,52, 95% CI [0,09; 0,94], oraz g Hedgesa = 0,51, 95% CI [0,09; 0,93]. Test t Studenta: t(86) = 2,42, p = 0,018. Według konwencji Cohena to efekt średni. Średnia grupy po szkoleniu przewyższała wyniki 69,7% osób z grupy kontrolnej (U3), a rozkłady pokrywały się w 79,6%.
Przedział ufności sięga jednak od wartości bardzo małych (0,09) do dużych (0,94). Uczciwy wniosek brzmi więc: szkolenie prawdopodobnie poprawia wyniki, ale na podstawie tej próby nie da się precyzyjnie określić, jak bardzo.
Kalkulator d Cohena z automatyczną interpretacją
Policz d Cohena dla dwóch grup niezależnych
Wpisz średnią, odchylenie standardowe i liczebność w obu grupach. Jako separatora dziesiętnego możesz użyć przecinka lub kropki.
Wpisz dane i kliknij „Oblicz d Cohena”. Kalkulator wymaga włączonej obsługi JavaScriptu.
Gotowy opis wyniku (APA 7)
Kalkulator liczy d z łączonym odchyleniem standardowym, 95% przedział ufności metodą niecentralnego rozkładu t, g Hedgesa z dokładną poprawką na małą próbę oraz test t Studenta. To te same metody, których domyślnie używa pakiet effectsize w R, więc wyniki zgadzają się z R do podanej liczby miejsc po przecinku. U3, wspólna część i PS zakładają rozkład normalny i równe wariancje.
Przykład w R
Te same obliczenia wykonasz w R. Wyniki poniżej pochodzą z uruchomienia kodu i są identyczne z liczbami w tekście oraz w kalkulatorze.
1. d Cohena, g Hedgesa i interpretacja w pakiecie effectsize
R
library(effectsize)

# Dane przykładowe: wynik testu wiedzy (0–100) po szkoleniu i w grupie kontrolnej.
# Funkcja tworzy dane o dokładnie zadanej średniej i SD, więc wynik nie zależy od losowania.
dane_grupy <- function(n, m, s) m + s * as.numeric(scale(rnorm(n)))
set.seed(2026)
szkolenie <- dane_grupy(45, 72.4, 11.8)
kontrola  <- dane_grupy(43, 66.1, 12.6)

cohens_d(szkolenie, kontrola)                      # d Cohena z 95% CI
hedges_g(szkolenie, kontrola)                      # g Hedgesa (poprawka na małą próbę)
interpret_cohens_d(0.52, rules = "cohen1988")      # słowna etykieta według Cohena

d <- cohens_d(szkolenie, kontrola)$Cohens_d
sprintf("U3 = %.3f; nakładanie = %.3f; PS = %.3f",
        d_to_u3(d), d_to_overlap(d), d_to_p_superiority(d))
Wynik w R
Cohen's d |       95% CI
------------------------
0.52      | [0.09, 0.94]

- Estimated using pooled SD.

Hedges' g |       95% CI
------------------------
0.51      | [0.09, 0.93]

- Estimated using pooled SD.

[1] "medium"
(Rules: cohen1988)

U3 = 0.697; nakładanie = 0.796; PS = 0.643
2. d Cohena z samych statystyk opisowych
R
# Gdy masz tylko średnie, odchylenia standardowe i liczebności
m1 <- 72.4; s1 <- 11.8; n1 <- 45
m2 <- 66.1; s2 <- 12.6; n2 <- 43
sp <- sqrt(((n1 - 1) * s1^2 + (n2 - 1) * s2^2) / (n1 + n2 - 2))   # łączone SD
d  <- (m1 - m2) / sp
cat(sprintf("sp = %.4f\nd  = %.4f\n", sp, d))
Wynik w R
sp = 12.1973
d  = 0.5165
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
d Cohena czy g Hedgesa?
W małych próbach d Cohena nieco przeszacowuje efekt w populacji. Hedges (1981) zaproponował poprawkę, która mnoży d przez współczynnik J zależny od liczby stopni swobody. Wynik nazywa się g Hedgesa. W naszym przykładzie z 88 osobami poprawka zmienia d = 0,517 na g = 0,512. Przy kilkunastu osobach w grupie różnica jest wyraźniejsza, a w metaanalizach standardem jest raportowanie g (Lakens, 2013).
Gdy odchylenia standardowe grup wyraźnie się różnią, np. interwencja zwiększyła zróżnicowanie wyników, łączone SD może być mylące. Wtedy rozważ Δ Glassa, która standaryzuje różnicę odchyleniem grupy kontrolnej, i opisz ten wybór w metodologii.
Najczęstsze błędy w interpretacji d Cohena
- Mechaniczne stosowanie progów 0,2/0,5/0,8 bez odniesienia do dziedziny, kosztów i korzyści (Funder i Ozer, 2019).
- Pomijanie przedziału ufności. Przy małych grupach ta sama wartość d jest zgodna z bardzo różnymi efektami w populacji (Cumming i Finch, 2001).
- Mylenie wariantów d, czyli porównywanie d dla grup niezależnych z dz dla pomiarów powtarzanych bez wyjaśnienia.
- Raportowanie samego d bez średnich, odchyleń standardowych i liczebności, które pozwalają innym przeliczyć wynik.
- Utożsamianie wielkości efektu z istotnością. Wartość p mówi o zgodności danych z hipotezą zerową, a d — o wielkości różnicy. Więcej w tekście o interpretacji wartości p.
- Interpretowanie U3 i PS bez założeń. Te przeliczenia zakładają rozkłady normalne i równe wariancje. Przy skośnych danych lepiej policzyć odpowiedniki nieparametryczne.
Jak zapisać d Cohena w pracy (APA 7)?
Szersze omówienie miar efektu — od r Pearsona po η² — znajdziesz w poradniku wielkość efektu: interpretacja.
Najczęstsze pytania
Jaka wartość d Cohena jest duża?
Według konwencji Cohena (1988) d = 0,2 to efekt mały, 0,5 — średni, a 0,8 — duży. To jednak punkty orientacyjne na wypadek braku lepszego odniesienia. Lepiej porównać wynik z efektami z podobnych badań i z najmniejszą różnicą, która ma znaczenie praktyczne w danej dziedzinie.
Czy d Cohena może być ujemne?
Tak. Znak pokazuje tylko kierunek różnicy i zależy od tego, którą grupę odejmujemy od której. d = −0,5 oznacza, że średnia grupy 1 jest o pół odchylenia standardowego niższa niż średnia grupy 2. Wielkość efektu ocenia się na podstawie wartości bezwzględnej.
Czy d Cohena może być większe niż 1?
Tak. d nie ma górnej granicy. d = 1,2 oznacza, że średnie różnią się o 1,2 odchylenia standardowego. Bardzo duże wartości są jednak rzadkie w psychologii i warto je sprawdzić pod kątem błędów, małej próby lub skrajnie jednorodnych grup.
Czym różni się d Cohena od g Hedgesa?
g Hedgesa to d Cohena pomnożone przez poprawkę zmniejszającą dodatnie obciążenie d w małych próbach. Przy kilkudziesięciu osobach w grupie różnica jest zwykle widoczna dopiero na drugim miejscu po przecinku; w bardzo małych próbach i w metaanalizach lepiej raportować g.
Jak policzyć d dla prób zależnych (pomiar przed i po)?
W układzie z powtarzanym pomiarem często liczy się dz: średnią różnic podzieloną przez odchylenie standardowe różnic. Taka miara nie jest porównywalna z d dla grup niezależnych, dlatego w raporcie trzeba nazwać użyty wariant (Lakens, 2013).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wielkość efektu: jak ocenić znaczenie wyniku poza wartością p
Wielkość efektu wyjaśniona praktycznie: Cohen d, Hedges g, r, R², iloraz szans, eta², przedziały ufności i znaczenie praktyczne.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikWartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikBadanie pilotażowe: po co, ile osób, co sprawdzić
Pilotaż a pretest, ile osób zbadać, co sprawdzić w danych i dlaczego nie liczyć mocy z efektu z pilotażu. Z symulacją, kodem R i wzorem opisu.
Czytaj →PoradnikAnaliza statystyczna w Excelu – możliwości i granice
Test t (Welch = T.TEST typ 3), chi-kwadrat, korelacja, regresja i Analysis ToolPak z polskimi nazwami funkcji, plikiem z formułami i listą tego, czego Excel nie policzy.
Czytaj →PoradnikStatystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →PoradnikAnaliza statystyczna w doktoracie
Seria badań z uzasadnioną liczebnością, harmonogram zgodny z IPB i oceną śródokresową, cykl publikacji bez salami slicing, dane, etyka i autorstwo.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →PoradnikP value krok po kroku
Jak powstaje wartość p: rozkład z prób, centralne twierdzenie graniczne, błąd standardowy, statystyka Z i pole pod krzywą – z przykładem i tablicą Z.
Czytaj →PoradnikTest t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →PoradnikBezpłatne programy do statystyki
jamovi, JASP, R, PSPP i G*Power: licencje, wersje i możliwości, ustawienia domyślne zmieniające wynik testu oraz wzory cytowania programu w pracy.
Czytaj →PoradnikMetaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikKontrasty planowane i analiza trendu
Od hipotez do wag kontrastów: trend liniowy i kwadratowy, kontrast interakcyjny, korekty, moc i tabela APA – na danych do pobrania, z kodem R.
Czytaj →PoradnikTabele i rysunki do artykułu
Wymogi czasopism, wykresy z danymi zamiast słupków, kolory czytelne dla daltonistów, eksport z R w 300 dpi i materiały uzupełniające.
Czytaj →PoradnikTriangulacja w badaniach
Rodzaje triangulacji, triangulacja ilościowa, macierz zbieżności, co zrobić z rozbieżnymi wynikami i jak opisać triangulację w artykule i rozprawie.
Czytaj →PoradnikKalkulator liczebności próby
Ile osób do testu t, korelacji albo ankiety z marginesem błędu? Kalkulator zgodny z R, wzory, przykład i gotowy opis analizy mocy.
Czytaj →PoradnikKonwerter wielkości efektu
Przelicz t na d Cohena, d na r i iloraz szans, η² na f albo d na NNT. Wzory ze źródłami, przykład w R i gotowe zdania do pracy.
Czytaj →PoradnikKalkulator wartości p
Dokładne p z z, t, χ², F i r, jedno- i dwustronnie, z wartością krytyczną dla α, przykładem w R i gotowym zapisem APA.
Czytaj →PoradnikTesty statystyczne – przewodnik po wyborze
Schemat wyboru testu i osiem etapów od hipotezy do zapisu APA: test t, ANOVA, testy nieparametryczne, chi-kwadrat, korelacje, regresja i poprawki.
Czytaj →Poradnikjamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →PoradnikR dla początkujących
Od instalacji R i RStudio do pierwszego testu t: wczytanie CSV i .sav, ramka danych, wynik skali, statystyki opisowe, d Cohena. Dane i skrypt do pobrania.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikWynik istotny, ale efekt mały
Dlaczego przy dużej próbie słaby efekt daje p < .001, jak ocenić jego znaczenie praktyczne i jak go uczciwie opisać w pracy – przykład w R.
Czytaj →PoradnikJak opisać wynik nieistotny
Co podać przy p > .05, jak odróżnić brak efektu od wyniku nierozstrzygającego, sformułowania źle i dobrze oraz gotowy wzór opisu w stylu APA.
Czytaj →Poradnikp = .06 – trend czy brak efektu?
Dlaczego p = .06 to ani trend, ani dowód braku efektu, co pokazuje symulacja replikacji i jak opisać taki wynik w pracy: efekt z CI i czułość badania.
Czytaj →PoradnikPSQI – jak policzyć wynik
Siedem komponentów 0–3, wynik globalny 0–21, próg powyżej 5, czas w łóżku przez północ, licencja i rzetelność – z przykładem w R i wzorem opisu.
Czytaj →PoradnikCBI – jak policzyć wynik wypalenia
Trzy skale wypalenia, przeliczenie odpowiedzi na 0–100, pozycja odwrócona, braki, licencja i rzetelność – z przykładem w R na danych pielęgniarek i wzorem opisu.
Czytaj →PoradnikEPDS – jak policzyć wynik
Punktacja 0–3 z pozycjami odwróconymi, wynik 0–30, progi 11–13 ze źródłami, pozycja 10 i plan bezpieczeństwa – z przykładem w R i wzorem opisu.
Czytaj →PoradnikGenerator opisu wyników APA
Statystyka, df i liczebności zamienione w zdanie APA 7 z p i wielkością efektu oraz kontrolą, czy p zgadza się ze statystyką.
Czytaj →PoradnikWielkość efektu w testach nieparametrycznych
r = Z/√N, korelacja rangowo-biseryjna, delta Cliffa, A Varghi–Delaneya, ε² i W Kendalla: co mierzą, jak je przeliczać i podać z CI – z kodem R.
Czytaj →PoradnikPrezentacja wyników na obronie
Ile slajdów i liczb, wykres zamiast tabeli z SPSS, wynik nieistotny jako efekt z przedziałem ufności – z dwiema parami slajdów „źle / dobrze” zrobionych w R.
Czytaj →PoradnikTSES – jak policzyć wynik
Poczucie skuteczności nauczyciela: 24 lub 12 pozycji, średnie 1–9, trzy podskale a wynik ogólny u studentów – z przykładem w R i wzorem opisu.
Czytaj →PoradnikMAAS – skala uważności: jak policzyć wynik
15 pozycji, wynik jako średnia 1–6, braki, alfa i omega, porównanie grup i warunki użycia – z przykładem w R i wzorem opisu w pracy.
Czytaj →PoradnikTest t w SPSS krok po kroku
Test t dla prób niezależnych i zależnych w SPSS: układ pliku, okna procedur, wiersz Welcha, wielkość efektu, jednostronne p i składnia T-TEST – z plikiem .sav do pobrania.
Czytaj →PoradnikeHEALS – jak policzyć wynik
8 pozycji 1–5, suma 8–40, pytania dodatkowe poza wynikiem, brak progów, struktura czynnikowa i licencja – z przykładem w R i wzorem opisu w pracy.
Czytaj →PoradnikJSS Spectora – jak policzyć wynik
Satysfakcja z pracy: 19 pozycji odwróconych, sumy 9 aspektów i wynik ogólny, warunki użycia i kontrola odwracania – z przykładem w R i wzorem opisu.
Czytaj →PoradnikRAND-36 – jak policzyć wynik
Oficjalny klucz RAND: przekodowanie na 0–100 i osiem skal, braki danych, różnica wobec SF-36 i wyników T, licencja, efekt sufitu i porównanie grup – z przykładem w R.
Czytaj →PoradnikAnaliza na małej próbie
Moc i szerokość CI przy 10–30 osobach, przeszacowane efekty, test permutacyjny, Fisher i bootstrap oraz wzór opisu ograniczenia – na pilotażu 10 + 10 w R.
Czytaj →PoradnikAnalizy pośrednie w praktyce
Plan grupowo-sekwencyjny w R: granice Pococka i OBF, wzrost N, symulacja błędu I rodzaju, daremność i zawyżony efekt po wczesnym zatrzymaniu.
Czytaj →PoradnikLiczebność próby z precyzji (AIPE)
Planowanie liczebności na szerokość przedziału ufności dla proporcji, d Cohena i korelacji, z pewnością osiągnięcia celu i kodem R.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →PoradnikPytania ze statystyki na obronę magisterską
Pytania promotora i recenzenta ułożone według analizy – od testu t i chi-kwadrat po regresję, ANOVA i alfę Cronbacha – z krótkimi odpowiedziami na liczbach.
Czytaj →PoradnikPytania na egzamin ze statystyki
66 krótkich pytań z odpowiedziami w 9 działach – od skal pomiarowych i SD po wartość p, moc, wybór testu, regresję i pytania „wyjaśnij różnicę”.
Czytaj →PoradnikMoc testu i liczebność próby – zadania
Dziesięć zadań: liczebność dla testu t, proporcji i korelacji, moc przy danym n, minimalny efekt, ubytek, efekt schematu, α i moc po fakcie.
Czytaj →PoradnikAnaliza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →PoradnikEksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikTest t w jamovi krok po kroku
Trzy testy t w jamovi: które pola zaznaczyć, jak czytać tabele Student, Welch i Mann–Whitney, gdzie jest d Cohena i jak opisać wynik w APA – z danymi do pobrania.
Czytaj →PoradnikPrzedziały ufności w pracy dyplomowej
Zapis APA, wybór przedziału dla średniej, odsetka, różnicy, korelacji i OR, poprawne i błędne zdania, nakładanie się przedziałów i słupki błędów – z tabelą wyników w R.
Czytaj →PoradnikTen sam wynik w pięciu dziedzinach
Jedna fikcyjna tabela i pięć gotowych akapitów wyników: psychologia, pielęgniarstwo, fizjoterapia, pedagogika, zarządzanie – co jest zwyczajem, a co obowiązkiem.
Czytaj →PoradnikStatistica – jak czytać wyniki
Kolumny arkuszy Statistiki dla testu t, ANOVA, korelacji, chi-kwadrat i regresji, znaczenie koloru, p<.00000 i gotowe zdania APA – z danymi do pobrania.
Czytaj →PoradnikAnaliza mocy w jamovi (jpower)
Moduł jpower: N, moc albo najmniejszy efekt dla testu t, tabele i wykresy mocy, δ w próbach zależnych i czego moduł nie liczy – z kontrolą w R.
Czytaj →PoradnikWielkość efektu w obrazkach: d = 0.2, 0.5 i 0.8
Nakładanie rozkładów, U3 i przewaga sprawdzone symulacją, d z małej i dużej próby, r na wykresie rozrzutu i OR jako słupki ryzyka – z kodem R.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Cumming, G., & Finch, S. (2001). A primer on the understanding, use, and calculation of confidence intervals that are based on central and noncentral distributions. Educational and Psychological Measurement, 61(4), 532–574. https://doi.org/10.1177/0013164401614002
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202
- Hedges, L. V. (1981). Distribution theory for Glass's estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Artykuł 863. https://doi.org/10.3389/fpsyg.2013.00863
- McGraw, K. O., & Wong, S. P. (1992). A common language effect size statistic. Psychological Bulletin, 111(2), 361–365. https://doi.org/10.1037/0033-2909.111.2.361
- Sawilowsky, S. S. (2009). New effect size rules of thumb. Journal of Modern Applied Statistical Methods, 8(2), 597–599. https://doi.org/10.22237/jmasm/1257035100
Cytowania BibTeX
@article{benshachar2020effectsize, author={Ben-Shachar, Mattan S. and L{\"u}decke, Daniel and Makowski, Dominique}, title={effectsize: Estimation of effect size indices and standardized parameters}, journal={Journal of Open Source Software}, year={2020}, volume={5}, number={56}, pages={2815}, doi={10.21105/joss.02815}}@book{cohen1988statistical, author={Cohen, Jacob}, title={Statistical Power Analysis for the Behavioral Sciences}, edition={2}, publisher={Lawrence Erlbaum Associates}, address={Hillsdale, NJ}, year={1988}}@article{cohen1992power, author={Cohen, Jacob}, title={A power primer}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{cumming2001primer, author={Cumming, Geoff and Finch, Sue}, title={A primer on the understanding, use, and calculation of confidence intervals that are based on central and noncentral distributions}, journal={Educational and Psychological Measurement}, year={2001}, volume={61}, number={4}, pages={532--574}, doi={10.1177/0013164401614002}}@article{funder2019evaluating, author={Funder, David C. and Ozer, Daniel J.}, title={Evaluating effect size in psychological research: Sense and nonsense}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={156--168}, doi={10.1177/2515245919847202}}@article{hedges1981distribution, author={Hedges, Larry V.}, title={Distribution theory for {G}lass's estimator of effect size and related estimators}, journal={Journal of Educational Statistics}, year={1981}, volume={6}, number={2}, pages={107--128}, doi={10.3102/10769986006002107}}@article{lakens2013calculating, author={Lakens, Dani{\"e}l}, title={Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and {ANOVA}s}, journal={Frontiers in Psychology}, year={2013}, volume={4}, pages={863}, doi={10.3389/fpsyg.2013.00863}}@article{mcgraw1992common, author={McGraw, Kenneth O. and Wong, S. P.}, title={A common language effect size statistic}, journal={Psychological Bulletin}, year={1992}, volume={111}, number={2}, pages={361--365}, doi={10.1037/0033-2909.111.2.361}}@article{sawilowsky2009new, author={Sawilowsky, Shlomo S.}, title={New effect size rules of thumb}, journal={Journal of Modern Applied Statistical Methods}, year={2009}, volume={8}, number={2}, pages={597--599}, doi={10.22237/jmasm/1257035100}}