Co to jest test t dla prób niezależnych?
Test t dla prób niezależnych (ang. independent samples t-test) sprawdza, czy średnie zmiennej ilościowej różnią się w dwóch grupach złożonych z różnych osób: w grupie eksperymentalnej i kontrolnej, wśród kobiet i mężczyzn, u studentów dwóch kierunków. Grupy wyznacza czynnik międzyobiektowy o dwóch poziomach, a każda osoba należy tylko do jednej grupy.
Hipoteza zerowa mówi, że średnie w obu populacjach są równe (H0: μ1 = μ2). Statystyka testowa to różnica średnich z prób podzielona przez jej błąd standardowy. Jeśli te same osoby zbadano dwa razy, potrzebny jest inny wariant – test t dla prób zależnych. Przegląd wszystkich wariantów znajdziesz w haśle test t Studenta.
Test Studenta czy test Welcha?
Test ma dwie wersje, które różnią się sposobem liczenia błędu standardowego różnicy i stopni swobody:
SDp to łączone odchylenie standardowe, czyli ważona średnia wariancji obu grup. Test Studenta zakłada więc, że wariancje w populacjach są równe (homogeniczność wariancji). Test Welcha – uogólnienie problemu Studenta na sytuację różnych wariancji (Welch, 1947) – tego nie wymaga i szacuje każdą wariancję osobno, dlatego jego stopnie swobody zwykle nie są liczbą całkowitą.
Delacre i in. (2017) argumentują, że założenie równych wariancji rzadko jest spełnione w psychologii, a test Welcha lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy wariancje są równe – dlatego powinien być wyborem domyślnym. Ruxton (2006) zwracał uwagę, że mimo to test Welcha jest używany rzadko. W R jest on domyślny w funkcji t.test(). Wersję dla trzech i więcej grup opisujemy w haśle test Welcha.
Rysunek 1 pokazuje, co dzieje się z odsetkiem fałszywych alarmów (błąd I rodzaju), gdy średnie w populacjach są równe, a zmieniają się liczebności i odchylenia standardowe grup. Każdy scenariusz to 20 000 symulowanych badań.
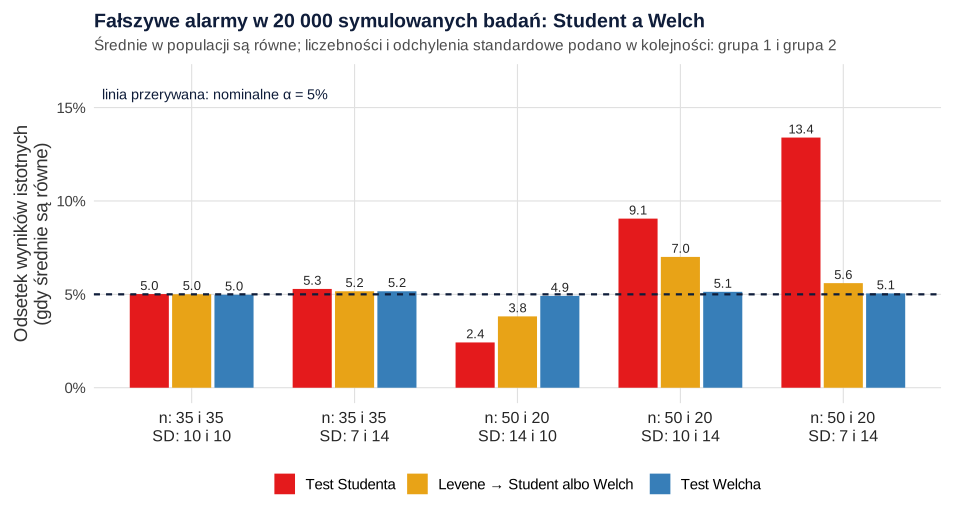
Przy równych liczebnościach wszystkie procedury działają podobnie (5.0–5.3% fałszywych alarmów). Kłopot zaczyna się, gdy grupy różnią się liczebnością i wariancją. Jeśli większe rozproszenie ma większa grupa, test Studenta staje się zbyt ostrożny (2.4% zamiast 5%) i traci moc. Jeśli większe rozproszenie ma mniejsza grupa, test Studenta daje fałszywe alarmy w 9.1% badań przy SD 10 i 14 oraz w 13.4% przy SD 7 i 14 – prawie trzy razy częściej niż deklarowane 5%. Test Welcha utrzymuje 4.9–5.2% we wszystkich scenariuszach.
Pomarańczowe słupki to popularna procedura dwuetapowa: najpierw test Levene’a, a potem – zależnie od jego wyniku – test Studenta albo Welcha. Przy umiarkowanej różnicy wariancji test Levene’a często jej nie wykrywa i procedura daje 7.0% fałszywych alarmów. To zgodne z wnioskiem Zimmermana (2004): wstępny test równości wariancji nie chroni poziomu istotności, a najlepszą ochronę daje bezwarunkowe stosowanie testu Welcha, gdy liczebności grup są nierówne.
Przykład: pisanie ekspresyjne a lęk przed egzaminem
Siedemdziesięcioro studentów przydzielono losowo (rzutem monetą) do jednego z dwóch warunków. Przed egzaminem przez 10 minut pisali o swoich obawach związanych z egzaminem (pisanie ekspresyjne, n = 39) albo o planie dnia (grupa kontrolna, n = 31). Następnie wypełnili skalę lęku przed egzaminem (20–80 punktów). Dane są symulowane; w populacjach, z których je losowaliśmy, odchylenia standardowe wynosiły 8 i 13 punktów.
| Grupa | n | M | SD | 95% CI dla M |
|---|---|---|---|---|
| Kontrolna | 31 | 50.68 | 11.87 | [46.32, 55.03] |
| Pisanie ekspresyjne | 39 | 44.72 | 9.04 | [41.79, 47.65] |
Średni lęk był w grupie pisania ekspresyjnego niższy o 5.96 punktu. Test Welcha: t(54.84) = 2.31, p = .025, 95% CI różnicy [0.79, 11.12]. Różnica jest istotna statystycznie, ale przedział ufności jest szeroki – od niecałego punktu do ponad 11 punktów.
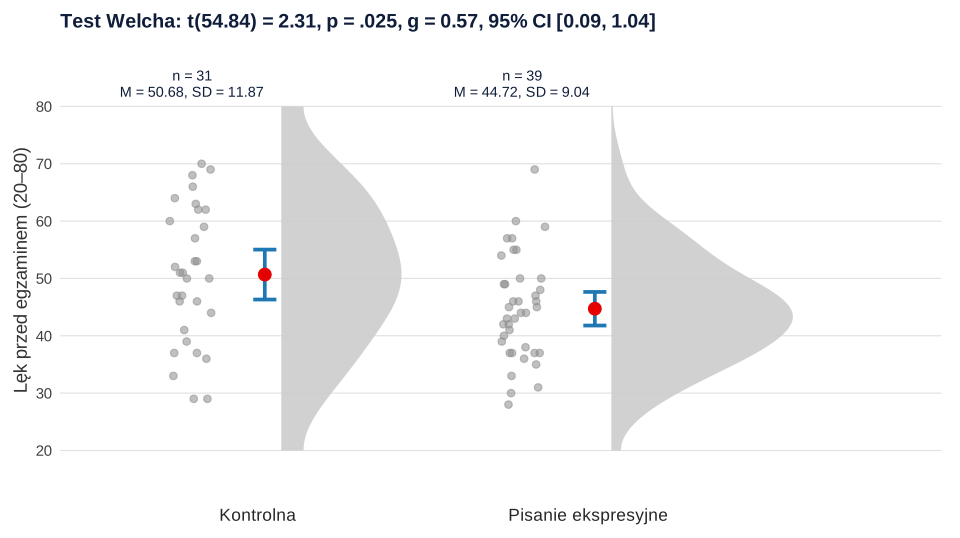
Rysunek 2 pokazuje to, czego nie widać w tabeli: wyniki w grupie kontrolnej są bardziej rozproszone, a rozkłady obu grup w dużej części się pokrywają. Wykres słupkowy ze średnimi ukryłby te informacje – Weissgerber i in. (2015) zwracają uwagę, że wykresy słupkowe mogą wyglądać identycznie przy bardzo różnych rozkładach danych.
Czy potrzebny jest test Levene’a?
Test Levene’a sprawdza hipotezę o równości wariancji. W przykładzie dał F(1, 68) = 3.09, p = .083 – wynik nieistotny, choć wiemy, że w populacjach odchylenia standardowe wynosiły 8 i 13 punktów. W małych i średnich próbach test Levene’a ma niską moc, a w dużych wykrywa różnice bez praktycznego znaczenia. Gdyby kierować się nim przy wyborze testu, wybralibyśmy test Studenta: t(68) = 2.39, p = .020 – wynik bardziej „optymistyczny” niż test Welcha, bo w tych danych mniejsza grupa ma większą wariancję.
Dlatego nie uzależniaj wyboru testu t od testu Levene’a – stosuj od razu test Welcha (Zimmerman, 2004; Delacre i in., 2017). Wynik testu Levene’a możesz podać opisowo, ale do decyzji nie jest potrzebny. Skąd biorą się różne wariancje w grupach i jak je opisywać, wyjaśniamy w haśle heterogeniczność wariancji.
Jak czytać dwa wiersze tabeli SPSS?
W SPSS wybierz Analiza → Porównywanie średnich → Test t dla prób niezależnych (ang. Analyze → Compare Means → Independent-Samples T Test). Przenieś lęk do pola „Zmienne testowane”, grupę do pola „Zmienna grupująca” i zdefiniuj kody grup. W tabeli „Test dla prób niezależnych” zobaczysz dwa wiersze dla tych samych danych:
| Wiersz w SPSS | Test Levene’a | t | df | p (dwustronne) | Różnica średnich | SE różnicy | 95% CI różnicy |
|---|---|---|---|---|---|---|---|
| Założono równość wariancji (Student) | F = 3.09, p = .083 | 2.39 | 68 | .020 | 5.96 | 2.50 | [0.97, 10.95] |
| Nie założono równości wariancji (Welch) | – | 2.31 | 54.84 | .025 | 5.96 | 2.58 | [0.79, 11.12] |
Odczytuj drugi wiersz – „Nie założono równości wariancji” to test Welcha – i podaj w raporcie jego ułamkowe df. Od wersji 27 SPSS dodaje tabelę wielkości efektu z d Cohena i poprawką Hedgesa, a w nowszych wersjach podaje osobno jednostronne i dwustronne p. W raporcie użyj dwustronnego, chyba że kierunek hipotezy zapisano przed badaniem.
Wielkość efektu: d Cohena i g Hedgesa
d Cohena wyraża różnicę średnich w jednostkach łączonego odchylenia standardowego. W małych próbach nieco zawyża efekt w populacji, dlatego Lakens (2013) zaleca podawanie g Hedgesa – tej samej miary z poprawką na małą próbę. W przykładzie g = 0.57, 95% CI [0.09, 1.04] (d = 0.57, 95% CI [0.09, 1.05]). Według typowych progów to efekt średni, ale przedział sięga od efektu znikomego do dużego: jedno badanie z 70 osobami nie wystarcza, by precyzyjnie ocenić siłę wpływu pisania ekspresyjnego. Progi i ich ograniczenia opisujemy w haśle d Cohena, a szerzej – w poradniku o interpretacji wielkości efektu.
Jak opisać wynik w pracy (APA)
W części „Analiza danych” dodaj zdanie: „Średnie porównano testem t Welcha, który nie zakłada równości wariancji”. Przy kilku zmiennych zależnych zestaw wyniki w tabeli – wzór znajdziesz w haśle tabela testu t w APA.
Przykład w R
Kod generuje dane z przykładu, liczy statystyki opisowe, test Levene’a, test Welcha, dla porównania test Studenta oraz g Hedgesa z przedziałem ufności. Liczby w tekście pochodzą z tego kodu.
Test Welcha, test Studenta i g Hedgesa
R
library(car); library(effectsize)
set.seed(2017)
pisanie  <- pmin(80, pmax(20, round(rnorm(39, 44, 8))))    # lęk 20–80
kontrola <- pmin(80, pmax(20, round(rnorm(31, 50, 13))))
dane <- data.frame(lek = c(kontrola, pisanie),
                   grupa = factor(rep(c("Kontrolna", "Pisanie"), c(31, 39)), levels = c("Kontrolna", "Pisanie")))
aggregate(lek ~ grupa, data = dane, FUN = function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
leveneTest(lek ~ grupa, data = dane, center = mean)        # test Levene'a jak w SPSS
t.test(lek ~ grupa, data = dane)                           # test Welcha (domyślny w R)
t.test(lek ~ grupa, data = dane, var.equal = TRUE)         # test Studenta – do porównania
hedges_g(lek ~ grupa, data = dane)                         # g Hedgesa z 95% CI
Wynik w R
Loading required package: carData
      grupa lek.n lek.M lek.SD
1 Kontrolna 31.00 50.68  11.87
2   Pisanie 39.00 44.72   9.04
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value  Pr(>F)
group  1  3.0922 0.08317 .
      68
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	Welch Two Sample t-test

data:  lek by grupa
t = 2.3126, df = 54.84, p-value = 0.02452
alternative hypothesis: true difference in means between group Kontrolna and group Pisanie is not equal to 0
95 percent confidence interval:
  0.7948114 11.1241299
sample estimates:
mean in group Kontrolna   mean in group Pisanie
               50.67742                44.71795


	Two Sample t-test

data:  lek by grupa
t = 2.385, df = 68, p-value = 0.01987
alternative hypothesis: true difference in means between group Kontrolna and group Pisanie is not equal to 0
95 percent confidence interval:
  0.9734106 10.9455307
sample estimates:
mean in group Kontrolna   mean in group Pisanie
               50.67742                44.71795

Hedges' g |       95% CI
------------------------
0.57      | [0.09, 1.04]

- Estimated using pooled SD.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (symulację z rysunku 1 wykonano w R bez dodatkowych pakietów); rysunki przygotowano w pakietach ggplot2 i ggdist. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2024). ggdist: Visualizations of distributions and uncertainty in the grammar of graphics. IEEE Transactions on Visualization and Computer Graphics, 30(1), 414–424. https://doi.org/10.1109/TVCG.2023.3327195
Najczęstsze błędy
- Odczytanie wiersza „Założono równość wariancji”, bo jest pierwszy – w przykładzie dałoby to p = .020 zamiast .025, a w innych danych może zmienić wniosek.
- Wybór testu na podstawie testu Levene’a – nieistotny wynik nie dowodzi równości wariancji (tu p = .083 mimo różnicy w populacji).
- Test dla prób niezależnych przy pomiarach powtarzanych – jeśli te same osoby badano dwa razy, użyj testu dla prób zależnych.
- Porównywanie wielu grup parami – przy trzech i więcej grupach użyj ANOVA (także w wersji Welcha) i porównań post hoc.
- Interpretacja wyniku nieistotnego jako braku różnicy – sprawdź przedział ufności i moc testu.
- Przejście na test Manna–Whitneya „bo grupy są nierówne” – nierówne liczebności i wariancje to sytuacja dla testu Welcha (Ruxton, 2006), a test Manna–Whitneya odpowiada na inne pytanie.
- Brak wielkości efektu i kierunku różnicy – podaj g z 95% CI i napisz, która grupa miała wyższe wyniki.
Najczęstsze pytania
Kiedy stosować test t dla prób niezależnych?
Gdy porównujesz średnie zmiennej ilościowej w dwóch grupach złożonych z różnych osób, np. w grupie eksperymentalnej i kontrolnej albo u kobiet i mężczyzn. Jeśli te same osoby zbadano dwa razy, użyj testu dla prób zależnych, a przy trzech i więcej grupach – analizy wariancji.
Który wiersz odczytać w SPSS: „Założono równość wariancji” czy „Nie założono”?
Odczytaj wiersz „Nie założono równości wariancji” – to test Welcha, zalecany jako domyślny (Delacre i in., 2017). Podaj jego ułamkowe stopnie swobody, np. t(54.84) = 2.31, p = .025. Pierwszy wiersz to klasyczny test Studenta.
Czy przed testem t trzeba wykonać test Levene'a?
Nie, jeśli od początku stosujesz test Welcha. Procedura „najpierw test Levene’a, potem Student albo Welch” nie chroni poziomu istotności, a najlepszą ochronę daje bezwarunkowe stosowanie testu Welcha (Zimmerman, 2004). Wynik testu Levene’a możesz podać opisowo.
Dlaczego w teście Welcha stopnie swobody nie są liczbą całkowitą?
Test Welcha szacuje wariancję każdej grupy osobno, a stopnie swobody wylicza ze wzoru Welcha–Satterthwaite’a, który uwzględnia wariancje i liczebności obu grup. Wynik zwykle jest ułamkiem, np. 54.84 – tak też podaj go w raporcie.
Jaką wielkość efektu podać przy teście t dla prób niezależnych?
Najczęściej d Cohena albo – lepiej – g Hedgesa, czyli d z poprawką na małą próbę (Lakens, 2013), zawsze z 95% przedziałem ufności. W R policzysz je funkcjami cohens_d() i hedges_g() z pakietu effectsize; SPSS od wersji 27 podaje je w tabeli wielkości efektu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikStatystyka do pracy magisterskiej
Plan analiz, CFA i omega, regresja hierarchiczna, moderacja i mediacja z bootstrapem, wzory opisu APA i pytania na obronie – z danymi i kodem R.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Ruxton, G. D. (2006). The unequal variance t-test is an underused alternative to Student's t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688–690. https://doi.org/10.1093/beheco/ark016
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
- Welch, B. L. (1947). The generalization of 'Student's' problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{ruxton2006unequal, author={Ruxton, Graeme D.}, title={{The unequal variance t-test is an underused alternative to Student's t-test and the Mann–Whitney U test}}, journal={Behavioral Ecology}, year={2006}, volume={17}, number={4}, pages={688--690}, doi={10.1093/beheco/ark016}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}@article{welch1947generalization, author={Welch, B. L.}, title={{The generalization of 'Student's' problem when several different population variances are involved}}, journal={Biometrika}, year={1947}, volume={34}, number={1–2}, pages={28--35}, doi={10.1093/biomet/34.1-2.28}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}