Który test t wybrać? Trzy pytania przed analizą
Test t Studenta porównuje średnie: jedną średnią z wartością odniesienia albo dwie średnie ze sobą. Wersję testu wybierasz na podstawie planu badania, a nie wyników. Najpierw ustal, ile średnich porównujesz. Potem sprawdź, czy wyniki pochodzą od różnych osób, czy od tych samych. Na końcu zastanów się, czy obserwacje są od siebie niezależne. Schemat na rysunku 1 prowadzi przez te decyzje.
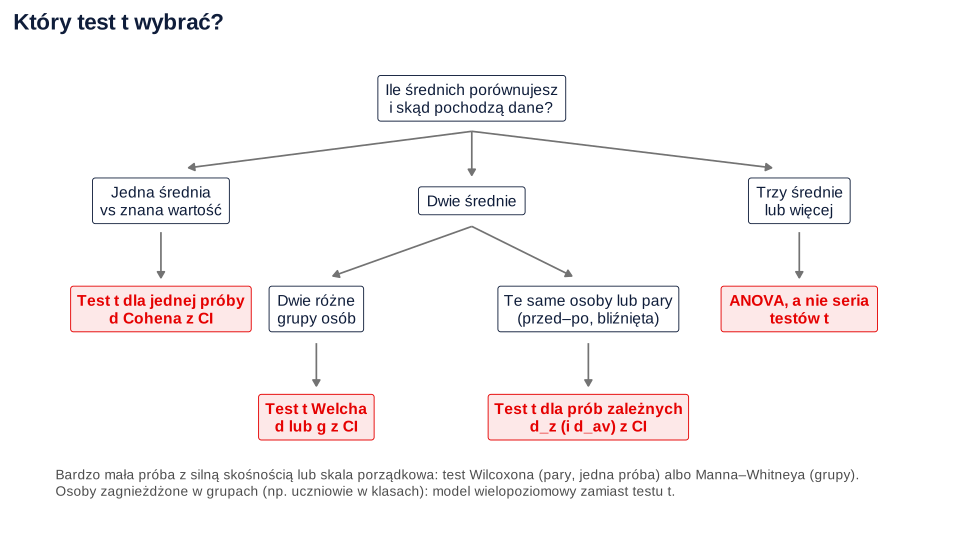
Każda z trzech wersji ma osobne hasło w słowniku ze wzorem i przykładem: test t dla jednej próby, test t dla prób niezależnych i test t dla prób zależnych. Tutaj przeprowadzimy wszystkie trzy na jednym zbiorze danych: od założeń, przez wynik i wielkość efektu, po wykres i zdanie do pracy.
| Wersja | Typowe pytanie | H0 | df | Wielkość efektu |
|---|---|---|---|---|
| Jedna próba | Czy średni lęk studentów różni się od środka skali? | μ = μ0 | n − 1 | d = (M − μ0) / SD |
| Próby niezależne (Welch) | Czy grupa z treningiem ma niższy lęk niż kontrolna? | μ1 = μ2 | ułamkowe, ze wzoru Welcha | d lub g Hedgesa |
| Próby zależne | Czy lęk tych samych osób spadł po treningu? | μróżnic = 0 | npar − 1 | dz, uzupełniająco dav |
Jeśli porównujesz trzy grupy lub więcej, przejdź do poradnika ANOVA krok po kroku. Seria testów t między wszystkimi parami grup zawyża ryzyko fałszywego alarmu (więcej w części o błędach).
Badanie przykładowe: trening oddechowy a lęk egzaminacyjny
Wyobraź sobie pracę magisterską o lęku egzaminacyjnym. Do badania zgłosiło się 64 osoby studiujące. Tydzień przed sesją wypełniły skalę lęku egzaminacyjnego (10 pozycji ocenianych od 1 do 4, wynik od 10 do 40; wyższy wynik oznacza większy lęk). Następnie 30 osób przez cztery tygodnie ćwiczyło oddychanie przeponowe, a 34 osoby z grupy kontrolnej nie dostały żadnego treningu. W dniu egzaminu wszyscy wypełnili skalę ponownie. Dane są symulowane, ale realistyczne. Możesz je pobrać jako plik CSV (kolumny: id, grupa, przed, po) i powtórzyć analizy w swoim programie.
Z tego jednego badania wynikają trzy pytania, a każde wymaga innej wersji testu:
- Czy lęk przed sesją jest wyższy niż środek skali (25 punktów)? To test t dla jednej próby.
- Czy w dniu egzaminu grupa z treningiem ma niższy lęk niż kontrolna? To test t dla prób niezależnych.
- Czy lęk osób z treningiem spadł między pierwszym a drugim pomiarem? To test t dla prób zależnych.
| Pomiar i grupa | n | M | SD | 95% CI dla M |
|---|---|---|---|---|
| Przed sesją, wszyscy | 64 | 26.72 | 5.33 | [25.39, 28.05] |
| Przed sesją, grupa treningowa | 30 | 26.47 | 5.39 | [24.45, 28.48] |
| Dzień egzaminu, grupa treningowa | 30 | 22.47 | 4.01 | [20.97, 23.96] |
| Dzień egzaminu, grupa kontrolna | 34 | 25.56 | 6.84 | [23.17, 27.94] |
Zwróć uwagę na odchylenia standardowe w dniu egzaminu. W grupie kontrolnej SD wynosi 6.84, w treningowej 4.01. Wariancja w grupie kontrolnej jest więc prawie trzy razy większa (46.74 wobec 16.05). Do tego jeszcze wrócimy.
Krok 1. Sprawdź założenia i zdecyduj, co zrobisz, gdy nie są spełnione
Test t ma cztery założenia: niezależność obserwacji, ilościową zmienną zależną, normalność i – w klasycznej wersji dla prób niezależnych – równość wariancji. Nie wszystkie są równie ważne, a do części z nich nie potrzebujesz żadnego testu.
Niezależność obserwacji
To założenie najważniejsze, bo wynika z planu badania i nie da się go naprawić po fakcie. Wynik jednej osoby nie może zależeć od wyniku innej. Problem pojawia się, gdy badasz całe klasy, pary partnerów albo grupy terapeutyczne. Osoby z jednej grupy są do siebie bardziej podobne niż osoby z różnych grup, a test t to ignoruje i daje zbyt małe p. Wtedy potrzebujesz modelu wielopoziomowego; procedurę pokazujemy w poradniku model wielopoziomowy krok po kroku. W naszym badaniu każdy uczestnik ćwiczył osobno, więc założenie jest spełnione.
Skala pomiaru
Zmienna zależna powinna być ilościowa. Suma lub średnia z kilku pozycji skali Likerta zwykle się do tego nadaje. Pojedyncza pozycja z czterema odpowiedziami już niekoniecznie.
Normalność: czego dotyczy i jak ją oceniać
Normalność dotyczy rozkładu średnich, a w praktyce reszt. Nie dotyczy surowych wyników całej próby. W teście dla jednej próby oceniasz rozkład wyników, w teście dla prób niezależnych – rozkład w każdej grupie osobno, a w teście dla prób zależnych – rozkład różnic, a nie wyników z każdego pomiaru. Przy kilkudziesięciu osobach w grupie test t dobrze znosi umiarkowane odstępstwa od rozkładu normalnego, bo rozkład średnich zbliża się do normalnego (działa tu centralne twierdzenie graniczne).
W przykładzie test Shapiro–Wilka dla wyników sprzed sesji dał W = 0.96, p = .047. Czy to dyskwalifikuje test t? Nie. Przy 64 osobach i rozkładzie bez skrajnej skośności o wyborze testu powinien decydować wykres Q-Q, a nie sama wartość p testu normalności. Ten sam test dla różnic w grupie treningowej dał W = 0.94, p = .103. Jak czytać wykresy i kiedy test normalności w ogóle się przydaje, opisujemy w poradniku jak sprawdzić normalność rozkładu.
Równość wariancji: wybierz test Welcha od razu
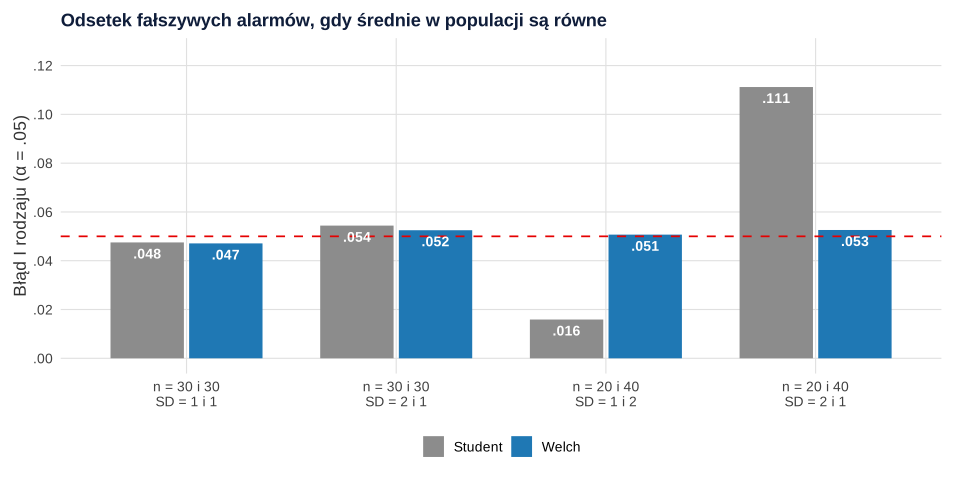
Klasyczny test Studenta dla prób niezależnych zakłada jednorodność wariancji. Zamiast to sprawdzać, użyj od razu testu t Welcha, który tego założenia nie wymaga. Delacre i in. (2017) pokazują, że w psychologii założenie równych wariancji rzadko jest spełnione. Test Welcha lepiej kontroluje błąd I rodzaju przy nierównych wariancjach, a gdy wariancje są równe, traci bardzo niewiele. Dlatego autorzy zalecają go jako wybór domyślny.
Częsta procedura dwuetapowa wygląda tak: najpierw test Levene’a, a potem, zależnie od jego wyniku, test Studenta albo Welcha. Zimmerman (2004) pokazał, że taka procedura nie chroni poziomu istotności i zwykle pogarsza sytuację. Najlepszą ochronę daje bezwarunkowe stosowanie testu Welcha, zwłaszcza przy nierównych liczebnościach grup.
Rysunek 2 pokazuje, dlaczego tak jest. Powtórzyliśmy 10 000 razy badanie, w którym średnie w populacji są równe, i policzyliśmy, jak często każdy test daje p < .05. Przy równych liczebnościach oba testy trzymają się blisko .05, nawet gdy jedno SD jest dwa razy większe od drugiego (.054 i .052). Kłopot zaczyna się, gdy grupy mają różną liczebność. Jeśli większe SD ma mniejsza grupa (20 osób), test Studenta daje fałszywy alarm w 11.1% badań zamiast w 5%. Jeśli większe SD ma większa grupa, staje się zbyt zachowawczy (1.6%) i traci moc. Test Welcha we wszystkich czterech wariantach mieści się w przedziale .047–.053. Przy równych wariancjach i d = 0.5 (30 + 30 osób) moc obu testów była praktycznie taka sama: .483 i .482.
Obserwacje odstające
Średnia i SD są wrażliwe na pojedyncze skrajne wyniki. Obejrzyj więc dane na wykresie pudełkowym albo punktowym, zanim cokolwiek usuniesz. Jak odróżnić błąd od prawdziwego, choć nietypowego wyniku i jak to opisać, wyjaśniamy w poradniku wartości odstające.
Gdy założenia nie są spełnione
- Nierówne wariancje – nic nie zmieniasz, bo test Welcha jest już Twoim wyborem domyślnym.
- Silna skośność albo pojedyncze skrajne wyniki przy małej próbie (np. kilkanaście osób w grupie) – zamiast testu dla prób niezależnych wybierz test U Manna–Whitneya, a zamiast testu dla prób zależnych lub jednej próby – test Wilcoxona. Pamiętaj, że te testy odpowiadają na nieco inne pytanie niż test t, bo nie porównują średnich. Fagerland (2012) pokazał, że przy dużych próbach i skośnych rozkładach test Wilcoxona–Manna–Whitneya może dać znacznie mniejsze p niż test t, nawet gdy średnie i mediany są równe, np. przy różnicy w rozproszeniu. Krok po kroku prowadzi przez nie poradnik testy nieparametryczne krok po kroku.
- Zmienna porządkowa (np. pojedyncza pozycja z pięcioma odpowiedziami) – również test rangowy.
- Zależne obserwacje (grupy, klasy, pary) – model wielopoziomowy. Żaden test nieparametryczny tego nie rozwiąże.
Krok 2a. Test t dla jednej próby: czy lęk przekracza środek skali?
Pierwsze pytanie dotyczy całej próby przed sesją. Średni lęk wynosi 26.72 punktu, a środek skali to 25. Test t sprawdza, czy różnica 1.72 punktu jest większa, niż można by oczekiwać przy losowym doborze 64 osób z populacji, w której średnia wynosi dokładnie 25:
Wynik: t(63) = 2.58, p = .012. Średnia z 95% CI wynosi 26.72 [25.39, 28.05], więc przedział nie obejmuje wartości 25. d Cohena to różnica średniej i wartości odniesienia podzielona przez SD: d = 0.32, 95% CI [0.07, 0.57]. Efekt jest niewielki, a przedział szeroki: zgodny zarówno z efektem bardzo małym, jak i umiarkowanym.
Wartość odniesienia musi mieć uzasadnienie. Środek skali to wartość teoretyczna: mówi tylko, że odpowiedzi przesuwają się w stronę „raczej się zgadzam”. Nie oznacza progu klinicznego. Jeśli masz normy z podręcznika testu albo wynik z wcześniejszego badania, porównanie z nimi jest bardziej informatywne.
Krok 2b. Test t dla prób niezależnych: trening a grupa kontrolna
Drugie pytanie porównuje dwie różne grupy osób w dniu egzaminu. Grupa treningowa miała średnio 22.47 punktu, kontrolna 25.56, więc różnica wynosi −3.09 punktu. Wynik obu wersji testu:
| Wersja testu | t | df | p | Różnica średnich, 95% CI |
|---|---|---|---|---|
| Welch (raportujesz) | −2.24 | 54.32 | .029 | −3.09 [−5.86, −0.32] |
| Student (dla porównania) | −2.17 | 62 | .034 | −3.09 [−5.94, −0.24] |
Wnioski z obu testów są tu takie same. Różnią się stopniami swobody: test Welcha szacuje je ze wzoru uwzględniającego wariancje i liczebności grup, dlatego są ułamkowe (54.32 zamiast 62). Test Levene’a w wersji z medianą dał F(1, 62) = 6.18, p = .016. Przy procedurze dwuetapowej ten wynik i tak skierowałby Cię do testu Welcha. Ponieważ test Welcha wybrałeś z góry, test Levene’a możesz pominąć albo podać tylko informacyjnie.
Dla wielkości efektu masz do wyboru dwa mianowniki. Przy teście Welcha naturalny jest pierwiastek ze średniej z dwóch wariancji. Tak liczy go np. JASP, gdy zaznaczysz test Welcha (JASP Team, b.d.-a). Wychodzi d = −0.55, 95% CI [−1.04, −0.06]. g Hedgesa koryguje obciążenie d w małych próbach (Hedges, 1981): g = −0.54, 95% CI [−1.03, −0.05]. Wersja z połączonym SD, typowa dla testu Studenta, daje d = −0.54, 95% CI [−1.04, −0.04]. Lakens (2013) pokazuje, że od schematu badania i wyboru wzoru zależy, czy wielkości efektu da się potem porównać z innymi badaniami. Dlatego w raporcie napisz, który wzór wybrałeś. Znak efektu zależy od kolejności grup. Ważne, by w tekście było jasne, która grupa ma niższy wynik.
Uwaga merytoryczna. W tym badaniu mamy też pomiar przed treningiem. Porównanie samych wyników z dnia egzaminu jest poprawne, bo przy losowym przydziale grupy na starcie nie różnią się systematycznie. Analiza kowariancji z pomiarem wyjściowym jako kowariantem (ANCOVA) ma jednak zwykle większą moc. Porównanie strategii na jednych danych znajdziesz w poradniku ANCOVA i analiza badania interwencyjnego przed i po.
Krok 2c. Test t dla prób zależnych: zmiana w grupie treningowej
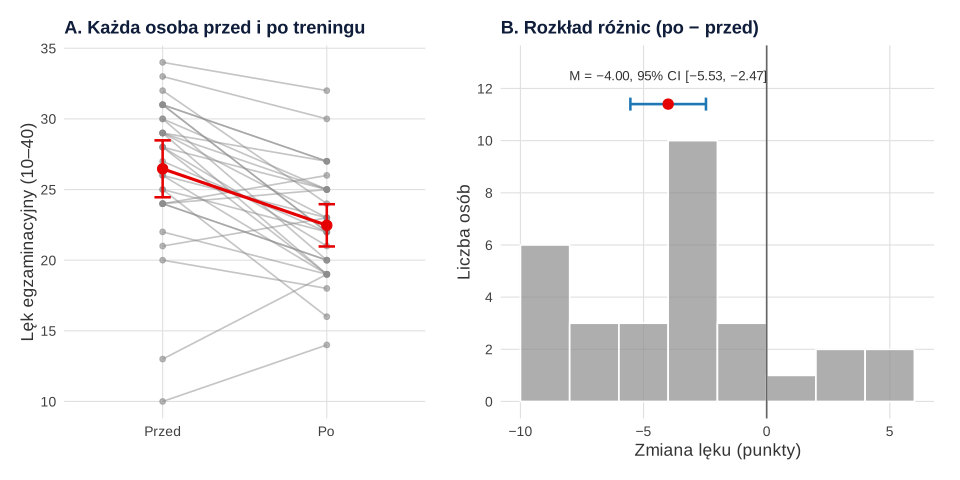
Trzecie pytanie dotyczy tych samych 30 osób zmierzonych dwa razy. Test dla prób zależnych liczy różnicę dla każdej osoby (po − przed), a potem sprawdza, czy średnia różnic odbiega od zera. Średnia różnica wynosi −4.00 punktu (SD różnic = 4.11), a wyniki przed i po korelują ze sobą (r = .65). Lęk spadł u 25 osób, a wzrósł u 5.
Wynik: t(29) = −5.33, p < .001, średnia różnica −4.00, 95% CI [−5.53, −2.47]. Gdyby te same dane potraktować jak dwie niezależne grupy, test pominąłby korelację między pomiarami i miałby znacznie większy błąd standardowy. Dlatego nigdy nie analizuj pomiarów powtarzanych testem dla prób niezależnych.
Wielkość efektu: dz czy dav?
W próbach zależnych wielkość efektu można standaryzować na dwa sposoby, a wyniki mogą się wyraźnie różnić:
- dz = średnia różnic / SD różnic = t / √n. W przykładzie dz = −0.97, 95% CI [−1.41, −0.54], a po poprawce na małą próbę −0.95, 95% CI [−1.37, −0.52]. Mówi, jak spójna jest zmiana u poszczególnych osób, i to ona decyduje o mocy testu.
- dav = średnia różnic / pierwiastek ze średniej wariancji obu pomiarów. W przykładzie dav = −0.84, 95% CI [−1.15, −0.53]. Ta miara jest bliższa d z badań międzygrupowych.
Im silniej korelują pomiary, tym bardziej dz przewyższa dav. Dunlap i in. (1996) ostrzegają, że wielkość efektu przeliczona wprost ze statystyki t bez uwzględnienia korelacji między pomiarami zawyża efekt, gdy porównujesz go z badaniami międzygrupowymi. Lakens (2013) szczegółowo porównuje miary dla planów wewnątrz- i międzyosobowych. Wniosek praktyczny: zawsze zaznacz, którą miarę podajesz, a gdy wynik ma być porównywany z badaniami międzygrupowymi, podaj obie.
Bez grupy kontrolnej to jeszcze nie efekt treningu
Istotny spadek w grupie treningowej nie dowodzi, że zadziałał trening. Lęk mógł spaść, bo osoby przyzwyczaiły się do skali albo dlatego, że skrajne wyniki z pierwszego pomiaru zbliżyły się do średniej (regresja do średniej). Dlatego potrzebna jest grupa kontrolna. W naszym badaniu lęk w grupie kontrolnej zmienił się średnio o −1.38 punktu, 95% CI [−3.16, 0.40]. Pytanie o efekt treningu dotyczy więc różnicy między grupami, a nie zmiany w jednej z nich.
Krok 3. Pokaż wynik na wykresie z przedziałami ufności
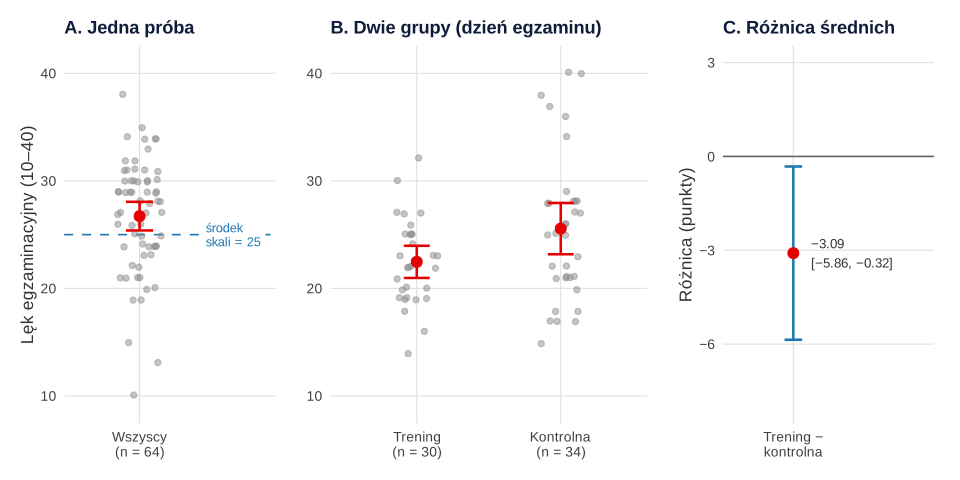
Wykres słupkowy ze średnimi ukrywa rozkład danych. Weissgerber i in. (2015) w przeglądzie 703 artykułów z czasopism fizjologicznych pokazali, że dane ciągłe przedstawiano głównie na wykresach słupkowych i liniowych, które przy bardzo różnych rozkładach mogą wyglądać identycznie. Lepiej pokaż pojedyncze wyniki, średnie i przedziały ufności, tak jak na rysunku 3.
Jak czytać taki wykres:
- Panel A – cały przedział ufności leży nad linią 25, co odpowiada wynikowi p < .05 w teście dla jednej próby.
- Panel B – przedziały obu grup częściowo na siebie zachodzą, a mimo to różnica jest istotna. Cumming i Finch (2005) podają „reguły oka” dla grup niezależnych: nakładanie się przedziałów nie oznacza braku istotnej różnicy. Przy 95% CI i podobnych liczebnościach grup p wynosi mniej więcej .05 wtedy, gdy przedziały zachodzą na siebie na około połowę średniej długości ramienia; przy mniejszym nakładaniu się p jest mniejsze.
- Panel C – o wniosku najlepiej świadczy przedział ufności samej różnicy. Tutaj [−5.86, −0.32] nie obejmuje zera, ale jego górna granica jest bliska zera. Efekt może więc być zarówno wyraźny, jak i znikomy.
W podpisie zawsze napisz, co oznaczają wąsy: przedział ufności, błąd standardowy czy odchylenie standardowe. Każdy z nich niesie inną informację: wąsy z SD opisują rozrzut wyników, a wąsy z błędu standardowego są mniej więcej dwa razy krótsze niż 95% CI.
W próbach zależnych przedziały ufności dla średnich z każdego pomiaru niewiele mówią o istotności zmiany, bo pomijają korelację między pomiarami. Lepiej pokazać linie dla każdej osoby i rozkład różnic, jak na rysunku 4.
Krok 4. Zinterpretuj wielkość efektu, a nie tylko p
Wartość p mówi tylko, czy dane są zaskakujące przy założeniu braku różnicy. O tym, jak duża jest różnica, mówi wielkość efektu razem z przedziałem ufności. Zestawienie miar dla testu t:
| Miara | Mianownik | Kiedy podać | Przykład |
|---|---|---|---|
| d dla jednej próby | SD próby | test dla jednej próby | 0.32 [0.07, 0.57] |
| d (połączone SD) | połączone SD obu grup | test Studenta, porównania z dawną literaturą | −0.54 [−1.04, −0.04] |
| d przy teście Welcha | pierwiastek ze średniej wariancji | test Welcha | −0.55 [−1.04, −0.06] |
| g Hedgesa | jak d, z poprawką na małą próbę | małe grupy, metaanalizy | −0.54 [−1.03, −0.05] |
| dz | SD różnic | próby zależne, analiza mocy | −0.97 [−1.41, −0.54] |
| dav | pierwiastek ze średniej wariancji obu pomiarów | próby zależne, porównanie z badaniami międzygrupowymi | −0.84 [−1.15, −0.53] |
Progi Cohena (0.2, 0.5, 0.8) traktuj jako ostateczność. Cohen (1992) podał je jako konwencjonalne wartości, przydatne głównie przy planowaniu liczebności próby. Różnicę 3 punktów na skali 10–40 lepiej odnieść do czegoś konkretnego: do zmiany uznawanej za istotną klinicznie, do efektów podobnych interwencji albo do zmienności wyników. Szerzej piszemy o tym w poradniku wielkość efektu – interpretacja. Gdy planujesz badanie, wielkość efektu potrzebna do wykrycia wyznacza liczebność grup; zobacz dobór liczebności próby.
Krok 5. Opisz wynik w stylu APA
Zdania dla każdej wersji testu masz w krokach 2a–2c. Każdy opis powinien zawierać te same elementy:
- nazwę testu i kierunek różnicy słowami („niższy lęk w grupie treningowej”);
- M i SD w każdej grupie lub pomiarze (albo średnią różnic);
- t ze stopniami swobody w nawiasie – przy teście Welcha ułamkowymi, z dwoma miejscami po kropce;
- dokładne p do trzech miejsc po kropce, bez zera przed kropką; poniżej .001 zapisz „p < .001”;
- różnicę średnich z 95% CI;
- wielkość efektu z 95% CI i informacją, jak ją policzono.
Przy kilku zmiennych zależnych zbierz wyniki w tabeli. Wzór znajdziesz w haśle tabela testu t w APA. Jeśli test jest jednostronny, napisz o tym wprost i uzasadnij wybór hipotezą sformułowaną przed zebraniem danych (zob. test jednostronny i dwustronny). Więcej gotowych zdań dla innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA.
Test t w SPSS i JASP: co zaznaczyć i co przepisać
SPSS
W SPSS wszystkie trzy testy są w menu Analyze → Compare Means:
- One-Sample T Test – wpisujesz wartość testową, z którą porównujesz średnią, i możesz zaznaczyć Estimate effect sizes (IBM Corp., b.d.-b).
- Independent-Samples T Test – wybierasz zmienną testowaną i zmienną grupującą, a przyciskiem Define Groups podajesz kody dwóch grup. Opcje Estimate effect sizes i Homogeneity of variance test (test Levene’a) są w oknie dialogowym, a poziom przedziału ufności ustawiasz w Options (IBM Corp., b.d.-a). Na wydruku przepisz wiersz dla nierównych wariancji, czyli wynik testu Welcha. Jak go odnaleźć i co przepisać z tabel testu t, pokazujemy w poradniku jak czytać wyniki z SPSS.
- Paired-Samples T Test – wybierasz pary zmiennych. Po zaznaczeniu Estimate effect sizes wybierasz mianownik (standardizer) dla d i g: Standard deviation of the difference daje dz, Corrected standard deviation of the difference koryguje go o korelację między pomiarami, a Average of variances daje dav (IBM Corp., b.d.-c).
JASP
W JASP wybierz T-Tests, a potem odpowiednią analizę. W Independent Samples T-Test zmienną zależną przenosisz do pola Variables, a grupującą do Grouping Variable. W sekcji Tests domyślnie zaznaczony jest Student – odznacz go i zaznacz Welch. W Additional Statistics zaznacz Location parameter z przedziałem ufności (różnica średnich), Effect Size (Cohen’s d, Glass’ delta albo Hedges’ g) z przedziałem ufności oraz Descriptives. W sekcji Assumption Checks masz Normality (test Shapiro–Wilka), Equality of variances (test Levene’a) i Q-Q plot residuals (JASP Team, b.d.-a). W Paired Samples T-Test opcja Correct for correlation przy wielkości efektu koryguje d o korelację między pomiarami, aby nie zawyżać efektu (JASP Team, b.d.-b). W tabeli wyników przepisz t, df, p, Mean difference z przedziałem ufności i wielkość efektu z przedziałem ufności.
Niezależnie od programu sprawdź, czy liczebności w tabeli zgadzają się z liczbą osób w bazie. Jeśli brakuje osób, sprawdź, jak program traktuje braki danych.
Test t w R: trzy wersje, wielkość efektu i symulacja
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R, bo przepis 2 korzysta z danych z przepisu 1. Test Welcha jest w funkcji t.test() ustawieniem domyślnym; klasyczny test Studenta wymaga argumentu var.equal = TRUE. Wielkości efektu z przedziałami ufności liczy pakiet effectsize, a test Levene’a – pakiet car. Pierwszy przepis zapisuje też dane do pliku CSV, który możesz pobrać powyżej.
1. Trzy testy t, założenia i wielkość efektu
R
# Przykład: trening oddechowy a lęk egzaminacyjny (dane symulowane, set.seed(4420)).
# 64 osoby studiujące; skala lęku egzaminacyjnego 10–40 (10 pozycji 1–4, wyższy wynik = większy lęk).
# Pomiar „przed” – tydzień przed sesją, pomiar „po” – w dniu egzaminu, po czterech tygodniach
# treningu oddechowego (n = 30) albo bez treningu (grupa kontrolna, n = 34).
library(effectsize)                                   # d Cohena, g Hedgesa i d_z z przedziałami ufności
es <- function(e) { e <- as.data.frame(e)[, c(1, 3, 4)]; e[] <- lapply(e, round, 2); e }   # zwięzły wydruk
set.seed(4420)
osoby <- function(n, m_przed, m_po, sd_przed, sd_po, r) {
  z1 <- rnorm(n); z2 <- r * z1 + sqrt(1 - r^2) * rnorm(n)
  data.frame(przed = pmin(40, pmax(10, round(m_przed + sd_przed * z1))),
             po    = pmin(40, pmax(10, round(m_po + sd_po * z2))))
}
trening   <- osoby(30, 27, 23.0, 5.0, 4.0, .6)
kontrolna <- osoby(34, 27, 26.5, 5.5, 6.5, .7)
dane <- rbind(cbind(id = 1:30, grupa = "trening", trening),
              cbind(id = 31:64, grupa = "kontrolna", kontrolna))
dane$grupa <- factor(dane$grupa, levels = c("trening", "kontrolna"))
write.csv(dane, "../test-t-krok-po-kroku-dane.csv", row.names = FALSE)   # plik do pobrania

# Statystyki opisowe z 95% CI dla średniej
opis <- function(x) { n <- length(x); m <- mean(x); s <- sd(x); h <- qt(.975, n - 1) * s / sqrt(n)
  round(c(n = n, M = m, SD = s, CI_dolna = m - h, CI_gorna = m + h), 2) }
rbind(przed_wszyscy = opis(dane$przed),
      po_trening    = opis(dane$po[dane$grupa == "trening"]),
      po_kontrolna  = opis(dane$po[dane$grupa == "kontrolna"]),
      przed_trening = opis(trening$przed))

# 1. Test t dla jednej próby: czy lęk przed sesją różni się od środka skali (25)?
t.test(dane$przed, mu = 25)
es(cohens_d(dane$przed, mu = 25))
es(hedges_g(dane$przed, mu = 25))
shapiro.test(dane$przed)

# 2. Test t dla prób niezależnych: lęk w dniu egzaminu, trening vs kontrolna
t.test(po ~ grupa, data = dane)                        # Welch – domyślnie w R
t.test(po ~ grupa, data = dane, var.equal = TRUE)      # klasyczny test Studenta, dla porównania
car::leveneTest(po ~ grupa, data = dane, center = median)
es(cohens_d(po ~ grupa, data = dane, pooled_sd = FALSE))   # d ze średniej wariancji (pasuje do Welcha)
es(hedges_g(po ~ grupa, data = dane, pooled_sd = FALSE))
es(cohens_d(po ~ grupa, data = dane))                      # d z połączonym SD (wersja Studenta)
round(tapply(dane$po, dane$grupa, var), 2)             # wariancje w grupach

# 3. Test t dla prób zależnych: przed vs po w grupie treningowej
roznica <- trening$po - trening$przed
round(c(M_roznicy = mean(roznica), SD_roznicy = sd(roznica), r_przed_po = cor(trening$przed, trening$po)), 2)
table(kierunek = sign(roznica))                         # −1 spadek, 0 bez zmian, 1 wzrost
t.test(trening$po, trening$przed, paired = TRUE)
shapiro.test(roznica)                                  # normalność różnic, nie wyników
es(repeated_measures_d(trening$po, trening$przed, method = "z", adjust = FALSE))   # d_z = M_różnic / SD_różnic
es(repeated_measures_d(trening$po, trening$przed, method = "z"))                   # to samo z poprawką Hedgesa (g_z)
es(repeated_measures_d(trening$po, trening$przed, method = "av", adjust = FALSE))  # d_av = M_różnic / średnie SD
t.test(kontrolna$po, kontrolna$przed, paired = TRUE)$conf.int  # dla porównania: zmiana w grupie kontrolnej
round(mean(kontrolna$po - kontrolna$przed), 2)

# Ryzyko przy wielu testach t zamiast ANOVA: trzy pary grup, każdy test na α = .05
round(1 - (1 - .05)^3, 3)
Wynik w R
               n     M   SD CI_dolna CI_gorna
przed_wszyscy 64 26.72 5.33    25.39    28.05
po_trening    30 22.47 4.01    20.97    23.96
po_kontrolna  34 25.56 6.84    23.17    27.94
przed_trening 30 26.47 5.39    24.45    28.48

	One Sample t-test

data:  dane$przed
t = 2.5789, df = 63, p-value = 0.01226
alternative hypothesis: true mean is not equal to 25
95 percent confidence interval:
 25.38692 28.05058
sample estimates:
mean of x
 26.71875

  Cohens_d CI_low CI_high
1     0.32   0.07    0.57
  Hedges_g CI_low CI_high
1     0.32   0.07    0.57

	Shapiro-Wilk normality test

data:  dane$przed
W = 0.96205, p-value = 0.04661


	Welch Two Sample t-test

data:  po by grupa
t = -2.2376, df = 54.322, p-value = 0.02937
alternative hypothesis: true difference in means between group trening and group kontrolna is not equal to 0
95 percent confidence interval:
 -5.8623550 -0.3219588
sample estimates:
  mean in group trening mean in group kontrolna
               22.46667                25.55882


	Two Sample t-test

data:  po by grupa
t = -2.1692, df = 62, p-value = 0.03391
alternative hypothesis: true difference in means between group trening and group kontrolna is not equal to 0
95 percent confidence interval:
 -5.9416406 -0.2426731
sample estimates:
  mean in group trening mean in group kontrolna
               22.46667                25.55882

Levene's Test for Homogeneity of Variance (center = median)
      Df F value  Pr(>F)
group  1  6.1807 0.01562 *
      62
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  Cohens_d CI_low CI_high
1    -0.55  -1.04   -0.06
  Hedges_g CI_low CI_high
1    -0.54  -1.03   -0.05
  Cohens_d CI_low CI_high
1    -0.54  -1.04   -0.04
  trening kontrolna
    16.05     46.74
 M_roznicy SD_roznicy r_przed_po
     -4.00       4.11       0.65
kierunek
-1  1
25  5

	Paired t-test

data:  trening$po and trening$przed
t = -5.3299, df = 29, p-value = 1.014e-05
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -5.534901 -2.465099
sample estimates:
mean difference
             -4


	Shapiro-Wilk normality test

data:  roznica
W = 0.94192, p-value = 0.1025

    d_z CI_low CI_high
1 -0.97  -1.41   -0.54
    d_z CI_low CI_high
1 -0.95  -1.37   -0.52
   d_av CI_low CI_high
1 -0.84  -1.15   -0.53
[1] -3.1635878  0.3988819
attr(,"conf.level")
[1] 0.95
[1] -1.38
[1] 0.143
2. Symulacja: test Studenta a test Welcha
R
# Symulacja: jak często test Studenta i test Welcha dają fałszywy alarm (H0 prawdziwa, α = .05)
# przy różnych liczebnościach i odchyleniach standardowych grup; 10 000 powtórzeń w każdym wariancie.
testy_p <- function(x, y) {                            # p z testu Studenta i Welcha dla wielu prób naraz (wiersze)
  n1 <- ncol(x); n2 <- ncol(y)
  m1 <- rowMeans(x); m2 <- rowMeans(y)
  v1 <- apply(x, 1, var); v2 <- apply(y, 1, var)
  sp <- ((n1 - 1) * v1 + (n2 - 1) * v2) / (n1 + n2 - 2)
  t_s <- (m1 - m2) / sqrt(sp * (1 / n1 + 1 / n2))
  se_w <- sqrt(v1 / n1 + v2 / n2); t_w <- (m1 - m2) / se_w
  df_w <- se_w^4 / ((v1 / n1)^2 / (n1 - 1) + (v2 / n2)^2 / (n2 - 1))
  cbind(Student = 2 * pt(-abs(t_s), n1 + n2 - 2), Welch = 2 * pt(-abs(t_w), df_w))
}
warianty <- data.frame(n1 = c(30, 30, 20, 20), n2 = c(30, 30, 40, 40),
                       sd1 = c(1, 2, 1, 2), sd2 = c(1, 1, 2, 1))
set.seed(4402)
B <- 10000
wyniki <- t(sapply(seq_len(nrow(warianty)), function(i) {
  w <- warianty[i, ]
  x <- matrix(rnorm(B * w$n1, 0, w$sd1), B); y <- matrix(rnorm(B * w$n2, 0, w$sd2), B)
  colMeans(testy_p(x, y) < .05)
}))
cbind(warianty, round(wyniki, 3))

# Ile kosztuje Welch, gdy wariancje są równe? Moc przy d = 0.5, n = 30 + 30
x <- matrix(rnorm(B * 30, 0.5, 1), B); y <- matrix(rnorm(B * 30, 0, 1), B)
round(colMeans(testy_p(x, y) < .05), 3)
all.equal(unname(testy_p(t(dane$po[dane$grupa == "trening"]), t(dane$po[dane$grupa == "kontrolna"]))[1, ]),
          c(t.test(po ~ grupa, dane, var.equal = TRUE)$p.value, t.test(po ~ grupa, dane)$p.value))   # zgodność z t.test()
Wynik w R
  n1 n2 sd1 sd2 Student Welch
1 30 30   1   1   0.048 0.047
2 30 30   2   1   0.054 0.052
3 20 40   1   2   0.016 0.051
4 20 40   2   1   0.111 0.053
Student   Welch
  0.483   0.482
[1] TRUE
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test() i shapiro.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy teście t
- Seria testów t zamiast ANOVA. Przy trzech grupach są trzy pary, a każdy test ma 5% szans na fałszywy alarm. Dla trzech niezależnych testów ryzyko co najmniej jednego fałszywego alarmu wynosi 1 − .953 = .143. Porównujesz wtedy wszystkie grupy jedną ANOVA, a pary – testem post hoc. Gdy musisz wykonać kilka testów t (np. dla kilku wskaźników), zastosuj poprawkę (zob. problem wielokrotnych porównań i poradnik poprawki na wielokrotne porównania).
- Wybór testu na podstawie testu Levene’a. Procedura dwuetapowa zniekształca poziom istotności (Zimmerman, 2004). Wybierz test Welcha z góry.
- Test dla prób niezależnych przy pomiarach powtarzanych. Ignoruje korelację między pomiarami, ma zawyżony błąd standardowy i mniejszą moc.
- Sprawdzanie normalności surowych wyników zamiast różnic w teście dla prób zależnych albo całej próby zamiast każdej grupy w teście dla prób niezależnych.
- Odruchowe przejście na test nieparametryczny tylko dlatego, że test Shapiro–Wilka dał p < .05 przy dużej próbie. Najpierw obejrzyj wykres Q-Q.
- Test jednostronny wybrany po obejrzeniu danych, żeby „zmieścić się” pod .05. Kierunek testu ustalasz przed badaniem.
- dz porównywane z d z badań międzygrupowych bez informacji, jak je policzono. Przy wysokiej korelacji pomiarów dz może być dużo większe niż dav.
- Zapis „p = .000” przepisany z wydruku. Wartość p nie jest równa zero, więc zapisz „p < .001”.
- Wynik nieistotny jako dowód braku różnicy. Brak istotności przy szerokim przedziale ufności oznacza niepewność. Jeśli chcesz wykazać, że grupy są podobne, potrzebujesz testu równoważności (TOST).
- Wniosek o skuteczności z samego pomiaru przed–po bez grupy kontrolnej (zob. krok 2c).
Jeśli nie masz pewności, czy wybrałeś właściwą wersję testu albo jak opisać efekt, możesz omówić analizę ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki w pracy musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Który test t wybrać do swoich danych?
Gdy porównujesz średnią z jedną znaną wartością (np. środkiem skali albo normą), wybierz test t dla jednej próby. Dla dwóch różnych grup osób wybierz test t Welcha, a dla tych samych osób zmierzonych dwa razy albo dla par – test t dla prób zależnych. Przy trzech grupach lub więcej zamiast testu t potrzebujesz ANOVA.
Czy przed testem t Welcha trzeba robić test Levene’a?
Nie. Test Welcha nie zakłada równych wariancji, więc nie musisz ich sprawdzać. Wybór testu na podstawie testu Levene’a nie chroni poziomu istotności (Zimmerman, 2004), dlatego lepiej od razu zastosować test Welcha. Test Levene’a możesz podać informacyjnie, ale nie uzależniaj od niego decyzji.
Jak policzyć d Cohena w teście t dla prób zależnych?
Najczęściej liczy się dz: średnią różnic dzieloną przez odchylenie standardowe różnic (to także t/√n). Gdy chcesz porównać wynik z badaniami międzygrupowymi, podaj też dav, w którym dzielisz przez pierwiastek ze średniej wariancji obu pomiarów. W pracy zawsze napisz, którą miarę podajesz (Lakens, 2013).
Czy można zrobić kilka testów t zamiast ANOVA?
Przy trzech grupach lub więcej – nie. Każdy dodatkowy test zwiększa szansę na fałszywy alarm: przy trzech niezależnych testach na poziomie .05 ryzyko co najmniej jednego wynosi .143. Porównaj grupy jedną ANOVA, a pary – testem post hoc.
Co zrobić, gdy rozkład w teście t nie jest normalny?
Najpierw obejrzyj wykres Q-Q. Przy kilkudziesięciu osobach w grupie test t dobrze znosi umiarkowaną skośność, a istotny test Shapiro–Wilka przy dużej próbie nie przesądza o zmianie testu. Przy małej próbie i silnej skośności wybierz test Manna–Whitneya albo Wilcoxona; opisujemy je w poradniku testy nieparametryczne krok po kroku.
Jak zapisać wynik testu t Welcha w stylu APA?
Podaj średnie i odchylenia standardowe obu grup, różnicę średnich z 95% CI, t z ułamkowymi stopniami swobody i dokładne p, np. t(54.32) = −2.24, p = .029, oraz wielkość efektu z przedziałem ufności, np. g = −0.54, 95% CI [−1.03, −0.05]. Napisz też, że zastosowano test Welcha.
Powiązane hasła
Przeczytaj też
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →Masz wyniki testu t i nie wiesz, jak je opisać?
Sprawdzimy, czy wybrałeś właściwą wersję testu, policzymy wielkość efektu z przedziałem ufności i wyjaśnimy wyniki tak, żebyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Dunlap, W. P., Cortina, J. M., Vaslow, J. B., & Burke, M. J. (1996). Meta-analysis of experiments with matched groups or repeated measures designs. Psychological Methods, 1(2), 170–177. https://doi.org/10.1037/1082-989x.1.2.170
- Fagerland, M. W. (2012). t-tests, non-parametric tests, and large studies—a paradox of statistical practice? BMC Medical Research Methodology, 12(1), Article 78. https://doi.org/10.1186/1471-2288-12-78 ● Otwarty dostęp
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- IBM Corp. (b.d.-a). Independent-Samples T Test. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-independent-samples-t-test ● Otwarty dostęp
- IBM Corp. (b.d.-b). One-Sample T Test. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-one-sample-t-test ● Otwarty dostęp
- IBM Corp. (b.d.-c). Paired-Samples T Test. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-paired-samples-t-test ● Otwarty dostęp
- JASP Team. (b.d.-a). Independent Samples T-Test [plik pomocy modułu T-Tests]. jaspTTests (GitHub). https://github.com/jasp-stats/jaspTTests/blob/master/inst/help/TTestIndependentSamples.md ● Otwarty dostęp
- JASP Team. (b.d.-b). Paired Samples T-Test [plik pomocy modułu T-Tests]. jaspTTests (GitHub). https://github.com/jasp-stats/jaspTTests/blob/master/inst/help/TTestPairedSamples.md ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{cumming2005inference, author={Cumming, Geoff and Finch, Sue}, title={{Inference by eye: Confidence intervals and how to read pictures of data}}, journal={American Psychologist}, year={2005}, volume={60}, number={2}, pages={170--180}, doi={10.1037/0003-066x.60.2.170}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{dunlap1996metaanalysis, author={Dunlap, William P. and Cortina, Jose M. and Vaslow, Joel B. and Burke, Michael J.}, title={{Meta-analysis of experiments with matched groups or repeated measures designs}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={170--177}, doi={10.1037/1082-989x.1.2.170}}@article{fagerland2012ttests, author={Fagerland, Morten W.}, title={{t-tests, non-parametric tests, and large studies—a paradox of statistical practice?}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={78}, doi={10.1186/1471-2288-12-78}}@article{hedges1981distribution, author={Hedges, Larry V.}, title={{Distribution theory for Glass’s estimator of effect size and related estimators}}, journal={Journal of Educational Statistics}, year={1981}, volume={6}, number={2}, pages={107--128}, doi={10.3102/10769986006002107}}@misc{ibmndindependentttest, author={{IBM Corp.}}, title={{Independent-Samples T Test}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-independent-samples-t-test}}@misc{ibmndonesamplettest, author={{IBM Corp.}}, title={{One-Sample T Test}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-one-sample-t-test}}@misc{ibmndpairedttest, author={{IBM Corp.}}, title={{Paired-Samples T Test}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-paired-samples-t-test}}@misc{jaspndindependentttest, author={{JASP Team}}, title={{Independent Samples T-Test [plik pomocy modułu T-Tests]}}, howpublished={jaspTTests (GitHub)}, year={b.d.-a}, url={https://github.com/jasp-stats/jaspTTests/blob/master/inst/help/TTestIndependentSamples.md}}@misc{jaspndpairedttest, author={{JASP Team}}, title={{Paired Samples T-Test [plik pomocy modułu T-Tests]}}, howpublished={jaspTTests (GitHub)}, year={b.d.-b}, url={https://github.com/jasp-stats/jaspTTests/blob/master/inst/help/TTestPairedSamples.md}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}