Ta sama różnica średnich, dwa różne wyniki
Wzór, założenia i opis APA testu dla par znajdziesz w haśle test t dla prób zależnych, a całą procedurę z wyborem testu – we wpisie test t Studenta krok po kroku. Tu pokazujemy na rysunkach, skąd bierze się przewaga testu dla par i od czego zależy.
Przykład jest fikcyjny. Trzydzieści osób rozwiązało test koncentracji uwagi (0–60 punktów) przed czterotygodniowym treningiem i po nim. Te same 30 par liczymy dwa razy: raz jak dwie różne grupy (test t dla prób niezależnych w wersji Welcha), drugi raz jako pary. Parametry populacji ustaliliśmy ręcznie tak, by przewaga testu dla par była wyraźna: średnia 30 punktów przed i 33 po, SD = 8 w obu pomiarach, korelacja pomiarów .8. Ziarno 579 ustalono raz i nie zmieniano go. Dane pobierzesz jako proby-zalezne-30-par.csv. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: te same pary, dwa testy
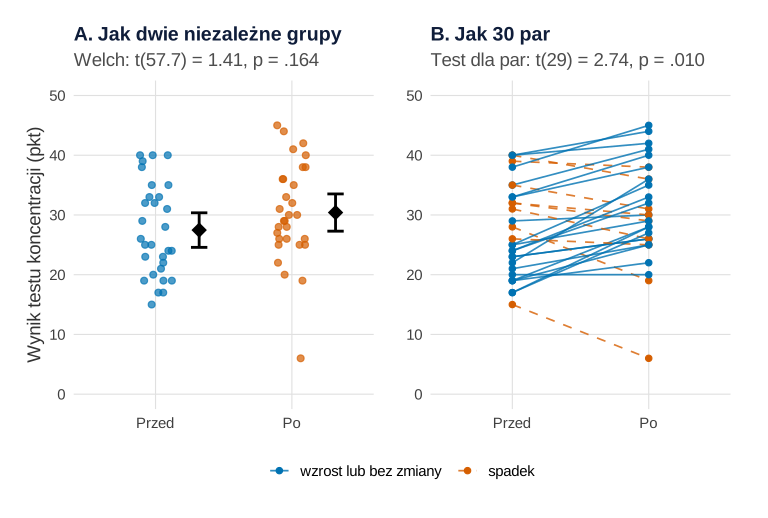
set.seed(579)).Co widać. Na panelu A średnia wzrosła z 27.47 do 30.40 punktu (różnica 2.93), ale rozrzut między osobami jest duży (SD 7.75 i 8.35), a przedziały ufności obu średnich mocno zachodzą na siebie. Test Welcha daje t(57.68) = 1.41, p = .164, a 95% CI różnicy to [−1.23, 7.10]. Test Studenta daje to samo. Panel B pokazuje, czego nie widać na A: osoby zachowują swoje miejsce w grupie (r = .74). Wynik wzrósł u 20 osób, u 9 spadł, u 1 się nie zmienił. Test dla par: t(29) = 2.74, p = .010, 95% CI [0.75, 5.12]. Różnica średnich jest w obu testach identyczna. Zmienił się tylko jej błąd standardowy.
Czego ten wykres nie pokazuje. Panel A sugeruje „brak różnicy”, bo oko porównuje zachodzące na siebie przedziały. Przy pomiarach powtarzanych taki odczyt jest błędny – przedziały pojedynczych średnich nie mówią nic o przedziale różnicy. Belia i in. (2005) pokazali, że wielu autorów artykułów nie bierze pod uwagę, czy dwie średnie na rycinie pochodzą od niezależnych grup, czy z pomiarów powtarzanych. Panel B nie mówi, czy wzrost wynika z treningu (zob. rysunek 5). Rysowanie par przy dużym n opisuje wpis porównanie grup na wykresie: od słupka do raincloud.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: rozkład różnic i błąd standardowy
Test dla par liczy dla każdej osoby różnicę po − przed i sprawdza, czy ich średnia odbiega od zera. Warto więc narysować właśnie różnice.
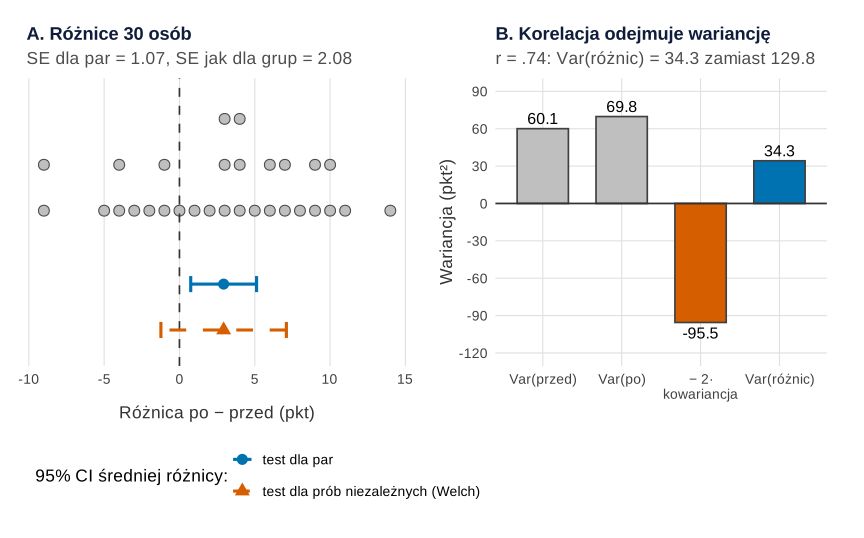
Co widać. Oba przedziały w panelu A mają ten sam środek (2.93), ale przedział z testu Welcha jest prawie dwa razy szerszy. Błąd standardowy różnicy wynosi 2.08 w teście dla prób niezależnych i 1.07 w teście dla par. Panel B pokazuje źródło tej różnicy. Wariancja różnic to suma wariancji obu pomiarów (60.05 + 69.77) minus podwojona kowariancja (95.54), czyli 34.27. Test dla prób niezależnych „nie wie” o kowariancji i używa całej sumy 129.8. Przy równych SD stosunek obu błędów standardowych to w przybliżeniu 1/√(1 − r). Przy r = .74 daje to 1.95, a w danych wyszło 1.95.
Czego ten wykres nie pokazuje. Założenie o normalności dotyczy różnic, nie każdego pomiaru osobno, a panel A pokazuje skrajne różnice. Gdy różnice są wyraźnie skośne, a próba mała, rozważ test Wilcoxona dla par. Panel B nie pokazuje niepewności: kowariancja z 30 osób jest tylko oszacowaniem. O samych przedziałach piszemy we wpisie przedział ufności w obrazkach.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: korelacja pomiarów a błąd różnicy
Z rysunku 2 wynika, że o przewadze testu dla par decyduje korelacja pomiarów przed i po. Wylosowaliśmy cztery zbiory po 30 par z tą samą średnią (30 i 33), tym samym SD (8) i korelacją −.5, 0, .5 albo .8. Wartości ustawiono ręcznie i w próbie wychodzą dokładnie (funkcja mvrnorm() z argumentem empirical = TRUE).
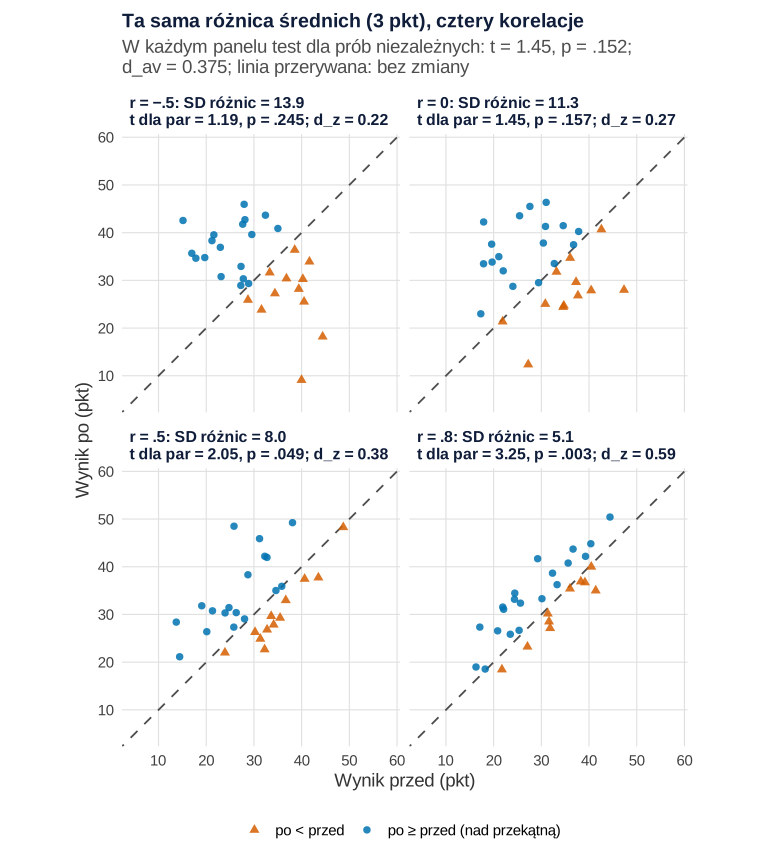
set.seed(579)).Co widać. Punkty nad przekątną to osoby, których wynik wzrósł. Im wyższa korelacja, tym ciaśniej chmura przylega do przekątnej i tym mniejsze są różnice w parach. SD różnic spada z 11.31 przy r = 0 do 8.00 przy .5 i 5.06 przy .8. Statystyka t testu dla par rośnie z 1.45 do 2.05 i 3.25 (p = .157, .049 i .003). Test dla prób niezależnych daje we wszystkich panelach to samo: t = 1.45, p = .152 – nie widzi korelacji. Przy r = 0 statystyka t jest w obu testach taka sama, a test dla par ma tylko mniej stopni swobody (29 zamiast 58).
Ujemna korelacja. Przy r = −.5 SD różnic wynosi aż 13.86, a test dla par jest słabszy niż test dla prób niezależnych (t = 1.19, p = .245). W badaniach przed–po to rzadkie; zdarza się raczej, gdy oba pomiary dzielą stałą pulę (np. punkty rozdzielane między dwie opcje). Nie przechodź wtedy na test dla prób niezależnych – dlaczego, pokazuje rysunek 4.
Czego ten wykres nie pokazuje. Każdy panel to jedna próba; p = .049 przy r = .5 w innej próbie mogłoby wyjść po drugiej stronie progu. Jak często test wykrywa efekt, pokazuje rysunek 4.
Podpis do pracy (np. w aneksie metodologicznym):
Zdanie do pracy (uzasadnienie planu badania):
Rysunek 4: moc i fałszywe alarmy w 10 000 powtórzeń
Symulacja: dla ośmiu wartości korelacji (od −.5 do .9) losujemy po 10 000 badań z 30 parami. Raz bez różnicy, raz z różnicą 0.4 SD pojedynczego pomiaru (w przykładzie było 0.375). Każde badanie liczymy oboma testami. Błąd Monte Carlo odsetka wynosi najwyżej 0.5 punktu procentowego (przy odsetku .50), a przy odsetku .05 – 0.22 punktu.
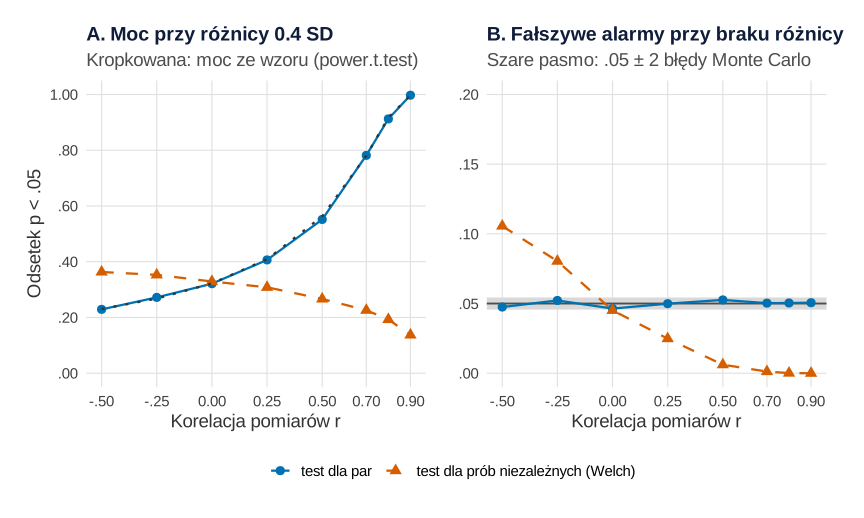
set.seed(579)).Co widać. Panel A: przy r = 0 oba testy mają podobną moc (.321 dla par, .329 Welch). Potem test dla par zyskuje: .552 przy r = .5, .912 przy .8 i .997 przy .9. Moc ze wzoru (power.t.test(type = "paired")) zgadza się z symulacją w granicach około dwóch błędów Monte Carlo (najwyżej 1.1 punktu procentowego różnicy). Test Welcha traci moc przy dodatniej korelacji: przy r = .8 wykrywa tę samą różnicę tylko w 19.3% badań. Panel B wyjaśnia dlaczego: przy dodatniej korelacji test dla prób niezależnych przeszacowuje błąd standardowy, więc fałszywych alarmów jest mniej niż 5% (2.5% przy r = .25, 0.6% przy .5). Przy ujemnej korelacji jest odwrotnie: 8.0% przy −.25 i 10.6% przy −.5. Test dla par trzyma się .05 przy każdej korelacji (od .046 do .053).
Czego ten wykres nie pokazuje. Przy ujemnej korelacji test Welcha ma wyższą „moc” (.363 wobec .229), ale ta przewaga jest pozorna. Zawdzięcza ją zaniżonemu błędowi standardowemu, przez który przy braku różnicy myli się dwa razy częściej, niż deklaruje. Zimmerman (1997) zwrócił uwagę, że podręczniki zwykle podkreślają utratę stopni swobody w teście dla par, która kosztuje niewiele, a pomijają zmianę poziomu istotności testu dla prób niezależnych zastosowanego do skorelowanych danych. Ta zmiana może być duża nawet przy niewielkiej korelacji. Symulacja zakłada też normalność, równe SD i brak braków danych. Pola α, β i mocy pokazuje wpis moc testu w obrazkach.
Podpis do pracy:
Zdanie do Metody (uzasadnienie liczebności):
Korelację zakładaną w analizie mocy weź z wcześniejszych danych – zob. dobór liczebności próby.
dz czy dav: ta sama zmiana, dwie liczby
Korelacja zmienia też standaryzowaną wielkość efektu – zależnie od wzoru (szczegóły w haśle wielkość efektu dla prób zależnych). dz dzieli średnią różnicę przez SD różnic, a dav – przez średnie SD obu pomiarów. Na rysunku 3 dav wynosi 0.375 w każdym panelu, bo średnie i SD pomiarów są identyczne. Natomiast dz rośnie razem z korelacją: 0.22, 0.27, 0.38 i 0.59. W przykładzie z rysunku 1 dz = 0.50, a dav = 0.36.
dz opisuje spójność zmiany u osób i wchodzi do analizy mocy testu dla par. dav da się porównać z d z badań na dwóch grupach. Dunlap i in. (1996) pokazali, że wielkość efektu przeliczona ze statystyki testu dla pomiarów skorelowanych bez uwzględnienia korelacji jest zawyżona. Lakens (2013) szczegółowo porównuje miary dla planów wewnątrz- i międzyosobowych. Zawsze napisz, którą wersję d podajesz.
Rysunek 5: regresja do średniej w przed–po
Załóżmy, że trening nie działa wcale, a kwalifikujemy do niego 25% osób z najniższym wynikiem. W symulacji 400 osób rozwiązuje test dwa razy bez interwencji, przy tej samej średniej i SD i korelacji .5 albo .8 (te same liczby losowe w obu panelach).
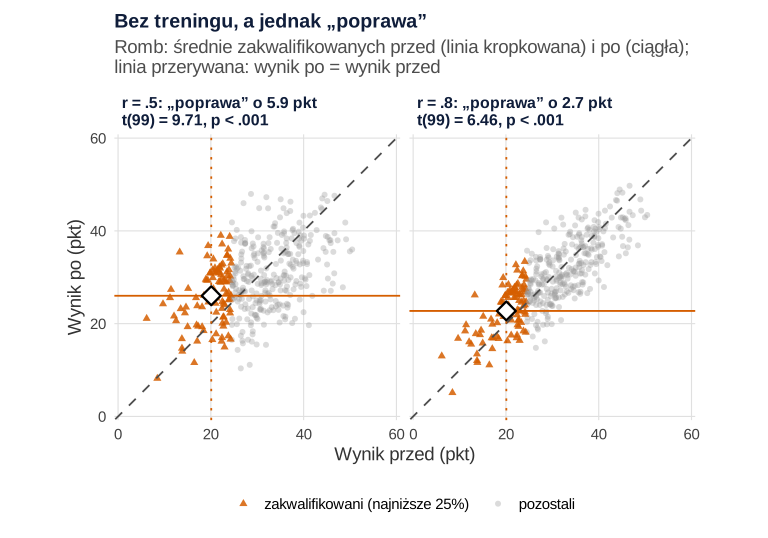
set.seed(579)).Co widać. Sto zakwalifikowanych osób miało średnio 20.09 punktu przed. Przy r = .5 po „treningu, którego nie było” mają 26.01, a test dla par daje t(99) = 9.71, p < .001. Przy r = .8 poprawa jest mniejsza (z 20.09 do 22.74), ale wciąż t(99) = 6.46, p < .001. Oczekiwaną wielkość tego zjawiska daje iloczyn (1 − r) × odległość średniej wybranych od średniej populacji: 4.96 i 1.98 punktu. W próbie wyszło 5.93 i 2.66 (losowość). Ta sama korelacja, która daje testowi dla par moc, decyduje o sile regresji do średniej – im słabsza, tym większa pozorna zmiana.
Czego ten wykres nie pokazuje. Test dla par nie odróżnia efektu interwencji od regresji do średniej. Barnett i in. (2005) podkreślają, że zjawisko jest tym silniejsze, im większy błąd pomiaru i gdy drugi pomiar ogląda się tylko w podgrupie wybranej według wyniku wyjściowego. Zmiana koreluje przy tym z wynikiem wyjściowym, zwykle ujemnie (Clifton i Clifton, 2019): kto zaczął nisko, „zyskuje” najwięcej. Chroni grupa kontrolna kwalifikowana tak samo i analiza z wynikiem wyjściowym jako kowariantem – ANCOVA w badaniu przed i po. Pełną symulację z obronami opisuje wpis regresja do średniej w badaniu przed–po.
Podpis do pracy (np. na obronę lub do dyskusji):
Zdanie do Dyskusji:
Który rysunek do pracy
- Do Wyników – panel B rysunku 1 (linie par) albo panel A rysunku 2 (różnice z przedziałem ufności z testu dla par). Same dwa słupki średnich z przedziałami sugerują wynik innego testu.
- Do Metody – zdanie o założonej korelacji (rysunki 3 i 4) przy uzasadnieniu liczebności.
- Do Dyskusji albo prezentacji na obronę – rysunek 5, gdy w badaniu przed–po nie było grupy kontrolnej.
Podział wariancji przy trzech grupach pokazuje wpis ANOVA w obrazkach. Więcej niż dwa pomiary – wpis dane podłużne na wykresie. Oba warunki w losowej kolejności omawia wpis schemat naprzemienny (crossover). Dwie niezależne grupy bez założenia normalności – wpis test U Manna–Whitneya w obrazkach.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje pomocnicze, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1, 3, 4 i 5), zaczyna się od własnego set.seed(579), więc skopiowany osobno da te same liczby co na stronie. Ziarno 579 ustalono raz i nie zmieniano go. Ręcznie ustalono: średnie 30 i 33 punkty, SD = 8 i korelację .8 w przykładzie z 30 parami; cztery korelacje na rysunku 3 (z empirical = TRUE, czyli dokładnie w próbie); siatkę korelacji, różnicę 0.4 SD i 10 000 powtórzeń w symulacji mocy; 400 osób, próg 25% i korelacje .5 i .8 w symulacji regresji do średniej. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane, trzy testy i dwa obrazy tych samych par: Rysunek 1
R
# Rysunek 1. Te same 30 par policzone testem dla prób niezależnych i testem dla par (dane fikcyjne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(przed = "#0072B2", po = "#D55E00", wzrost = "#0072B2", spadek = "#D55E00", szary = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03
p_apa <- function(p) ifelse(p < .001, "p < .001", paste("p =", bz(p, 3)))

# 30 osób: test koncentracji uwagi (0–60 pkt) przed 4-tygodniowym treningiem i po nim.
# Parametry populacji ustalone ręcznie: średnia 30 i 33 pkt, SD 8 w obu pomiarach, korelacja .8
n <- 30; mu_przed <- 30; mu_po <- 33; sd_pop <- 8; r_pop <- 0.8
set.seed(579)                                    # ziarno ustalone raz, bez dobierania pod wynik
z1 <- rnorm(n); z2 <- rnorm(n)
przed <- round(mu_przed + sd_pop * z1)
po <- round(mu_po + sd_pop * (r_pop * z1 + sqrt(1 - r_pop^2) * z2))
dane <- data.frame(osoba = 1:n, przed, po, roznica = po - przed)
write.csv(dane, "proby-zalezne-30-par.csv", row.names = FALSE)

# Statystyki opisowe i korelacja pomiarów
round(c(M_przed = mean(przed), SD_przed = sd(przed), M_po = mean(po), SD_po = sd(po),
        r = cor(przed, po), M_roznicy = mean(dane$roznica), SD_roznicy = sd(dane$roznica)), 2)
table(kierunek = sign(dane$roznica))             # -1 spadek, 0 bez zmiany, 1 wzrost
# Dwie wielkości efektu dla tej samej średniej różnicy: d_z (przez SD różnic) i d_av (przez średnie SD pomiarów)
round(c(d_z = mean(dane$roznica) / sd(dane$roznica), d_av = mean(dane$roznica) / ((sd(przed) + sd(po)) / 2)), 2)

# Te same liczby, trzy testy: Welch i Student (jakby grupy były niezależne) oraz test dla par
testy <- list(Welch = t.test(po, przed), Student = t.test(po, przed, var.equal = TRUE),
              pary = t.test(po, przed, paired = TRUE))
wyniki <- t(sapply(testy, function(tt) c(roznica = mean(po) - mean(przed), SE = tt$stderr,
                                        t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value,
                                        CI_dolna = tt$conf.int[1], CI_gorna = tt$conf.int[2])))
round(wyniki, 3)

# A: jak dane widzi test dla prób niezależnych – dwie chmury punktów, średnie z 95% CI
dl <- data.frame(osoba = rep(dane$osoba, 2), pomiar = factor(rep(c("Przed", "Po"), each = n), c("Przed", "Po")),
                 wynik = c(przed, po))
sr <- do.call(rbind, lapply(split(dl$wynik, dl$pomiar), function(x)
  data.frame(M = mean(x), dolna = t.test(x)$conf.int[1], gorna = t.test(x)$conf.int[2])))
sr$pomiar <- factor(rownames(sr), levels(dl$pomiar))
pa <- ggplot(dl, aes(pomiar, wynik)) +
  geom_point(aes(colour = pomiar), position = position_jitter(width = 0.12, height = 0, seed = 579),
             size = 2, alpha = 0.7) +
  geom_errorbar(data = sr, aes(y = M, ymin = dolna, ymax = gorna), width = 0.12, linewidth = 1,
                position = position_nudge(x = 0.32)) +
  geom_point(data = sr, aes(y = M), shape = 18, size = 5, position = position_nudge(x = 0.32)) +
  scale_colour_manual(values = c(Przed = kol[["przed"]], Po = kol[["po"]]), guide = "none") +
  scale_y_continuous(limits = c(0, 50), breaks = seq(0, 50, 10)) +
  labs(x = NULL, y = "Wynik testu koncentracji (pkt)", title = "A. Jak dwie niezależne grupy",
       subtitle = sprintf("Welch: t(%.1f) = %.2f, %s", wyniki["Welch", "df"], wyniki["Welch", "t"],
                          p_apa(wyniki["Welch", "p"]))) + motyw

# B: jak dane widzi test dla par – linia łączy dwa wyniki tej samej osoby
dl$kierunek <- factor(ifelse(rep(dane$roznica, 2) >= 0, "wzrost lub bez zmiany", "spadek"),
                      c("wzrost lub bez zmiany", "spadek"))
pb <- ggplot(dl, aes(pomiar, wynik, group = osoba)) +
  geom_line(aes(colour = kierunek, linetype = kierunek), linewidth = 0.6, alpha = 0.8) +
  geom_point(aes(colour = kierunek), size = 1.8) +
  scale_colour_manual(values = c("wzrost lub bez zmiany" = kol[["wzrost"]], "spadek" = kol[["spadek"]]), name = NULL) +
  scale_linetype_manual(values = c("wzrost lub bez zmiany" = "solid", "spadek" = "dashed"), name = NULL) +
  scale_y_continuous(limits = c(0, 50), breaks = seq(0, 50, 10)) +
  labs(x = NULL, y = NULL, title = "B. Jak 30 par",
       subtitle = sprintf("Test dla par: t(%d) = %.2f, %s", round(wyniki["pary", "df"]), wyniki["pary", "t"],
                          p_apa(wyniki["pary", "p"]))) + motyw
p1 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("proby-zalezne-te-same-pary.svg", p1, width = 8, height = 5.4)
Wynik w R
   M_przed   SD_przed       M_po      SD_po          r  M_roznicy SD_roznicy
     27.47       7.75      30.40       8.35       0.74       2.93       5.85
kierunek
-1  0  1
 9  1 20
 d_z d_av
0.50 0.36
        roznica    SE     t     df     p CI_dolna CI_gorna
Welch     2.933 2.080 1.410 57.677 0.164   -1.231    7.098
Student   2.933 2.080 1.410 58.000 0.164   -1.231    7.097
pary      2.933 1.069 2.744 29.000 0.010    0.747    5.119
2. Rozkład różnic i składniki wariancji: Rysunek 2
R
# Rysunek 2. Rozkład różnic i skąd bierze się mniejszy błąd standardowy (kontynuacja: dane, testy, wyniki,
# kol, motyw, bz z bloku 1; bez losowania)
library(ggplot2)
library(patchwork)

# Rozkład wariancji różnic: Var(po − przed) = Var(przed) + Var(po) − 2·kowariancja
v_przed <- var(dane$przed); v_po <- var(dane$po); kow <- cov(dane$przed, dane$po)
skladniki <- c(var_przed = v_przed, var_po = v_po, minus_2_kow = -2 * kow,
               var_roznic = v_przed + v_po - 2 * kow, kontrola_var_roznic = var(dane$roznica))
round(skladniki, 2)
# Błąd standardowy różnicy średnich w obu testach i ich stosunek
se <- c(SE_niezalezne = sqrt(v_przed / n + v_po / n), SE_pary = sd(dane$roznica) / sqrt(n))
round(c(se, stosunek = se[["SE_niezalezne"]] / se[["SE_pary"]],
        przyblizenie = 1 / sqrt(1 - cor(dane$przed, dane$po))), 3)   # przy równych SD stosunek ≈ 1/√(1 − r)

# A: różnice osób jako punkty i dwa przedziały ufności tej samej średniej różnicy
ci <- data.frame(test = factor(c("test dla par", "test dla prób niezależnych (Welch)"),
                               c("test dla par", "test dla prób niezależnych (Welch)")),
                 M = mean(dane$roznica), dolna = c(wyniki["pary", "CI_dolna"], wyniki["Welch", "CI_dolna"]),
                 gorna = c(wyniki["pary", "CI_gorna"], wyniki["Welch", "CI_gorna"]), y = c(-0.6, -1.6))
dane$stos <- ave(dane$roznica, dane$roznica, FUN = seq_along)     # osoby z tą samą różnicą – jedna nad drugą
pa <- ggplot(dane, aes(roznica, stos)) +
  geom_point(shape = 21, size = 3.4, fill = "grey75", colour = "grey30") +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey20") +
  geom_errorbar(data = ci, aes(y = y, xmin = dolna, xmax = gorna, colour = test, linetype = test),
                width = 0.35, linewidth = 1.1, orientation = "y", inherit.aes = FALSE) +
  geom_point(data = ci, aes(x = M, y = y, colour = test, shape = test), size = 3.5, inherit.aes = FALSE) +
  scale_colour_manual(values = c("test dla par" = kol[["przed"]], "test dla prób niezależnych (Welch)" = kol[["po"]]),
                      name = "95% CI średniej różnicy:") +
  scale_linetype_manual(values = c("test dla par" = "solid", "test dla prób niezależnych (Welch)" = "dashed"),
                        name = "95% CI średniej różnicy:") +
  scale_shape_manual(values = c("test dla par" = 16, "test dla prób niezależnych (Welch)" = 17),
                     name = "95% CI średniej różnicy:") +
  scale_y_continuous(NULL, breaks = NULL, limits = c(-2.1, 3.6)) +
  scale_x_continuous(breaks = seq(-10, 15, 5)) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "Różnica po − przed (pkt)", title = "A. Różnice 30 osób",
       subtitle = sprintf("SE dla par = %.2f, SE jak dla grup = %.2f", se[["SE_pary"]], se[["SE_niezalezne"]])) +
  motyw

# B: składniki wariancji różnic jako słupki
nazwy <- c("Var(przed)", "Var(po)", "− 2·\nkowariancja", "Var(różnic)")
sk <- data.frame(skladnik = factor(nazwy, nazwy),
                 wartosc = skladniki[1:4], rodzaj = c("dodaje", "dodaje", "odejmuje", "wynik"))
pb <- ggplot(sk, aes(skladnik, wartosc, fill = rodzaj)) +
  geom_col(width = 0.65, colour = "grey25") +
  geom_hline(yintercept = 0, colour = "grey20") +
  geom_text(aes(label = sprintf("%.1f", wartosc), vjust = ifelse(wartosc < 0, 1.4, -0.4)), size = 4.2) +
  scale_fill_manual(values = c(dodaje = "grey75", odejmuje = kol[["po"]], wynik = kol[["przed"]]), guide = "none") +
  scale_y_continuous(limits = c(-120, 90), breaks = seq(-120, 90, 30)) +
  labs(x = NULL, y = "Wariancja (pkt²)", title = "B. Korelacja odejmuje wariancję",
       subtitle = sprintf("r = %s: Var(różnic) = %.1f zamiast %.1f", bz(cor(dane$przed, dane$po)),
                          skladniki[["var_roznic"]], v_przed + v_po)) +
  motyw + theme(axis.text.x = element_text(size = rel(0.85)))
p2 <- pa + pb + plot_layout(widths = c(1.15, 1))
p2   # zapis: ggsave("proby-zalezne-rozklad-roznic.svg", p2, width = 9, height = 5.6)
Wynik w R
          var_przed              var_po         minus_2_kow          var_roznic
              60.05               69.77              -95.54               34.27
kontrola_var_roznic
              34.27
SE_niezalezne       SE_pary      stosunek  przyblizenie
        2.080         1.069         1.946         1.954
3. Cztery korelacje przy tej samej różnicy średnich: Rysunek 3
R
# Rysunek 3. Ta sama różnica średnich przy korelacji pomiarów r = −.5, 0, .5 i .8 (kontynuacja: n, kol, motyw,
# bz, p_apa z bloku 1)
library(ggplot2)

# MASS::mvrnorm() z empirical = TRUE: średnie (30 i 33), SD (8 i 8) i r w próbie są dokładnie takie, jak ustalono ręcznie,
# więc panele różnią się wyłącznie korelacją
korelacje <- c(-0.5, 0, 0.5, 0.8)
set.seed(579)
panele <- do.call(rbind, lapply(korelacje, function(r) {
  S <- matrix(c(1, r, r, 1), 2) * 8^2
  x <- MASS::mvrnorm(n, mu = c(30, 33), Sigma = S, empirical = TRUE)
  data.frame(r = r, przed = x[, 1], po = x[, 2])
}))

# Dla każdego r: SD różnic, oba testy i dwie wielkości efektu
podsum <- do.call(rbind, lapply(split(panele, panele$r), function(d) {
  roz <- d$po - d$przed; tp <- t.test(d$po, d$przed, paired = TRUE); tw <- t.test(d$po, d$przed)
  data.frame(r = d$r[1], M_roznicy = mean(roz), SD_roznic = sd(roz), SE_pary = tp$stderr, t_pary = tp$statistic,
             p_pary = tp$p.value, SE_niezal = tw$stderr, t_niezal = tw$statistic, p_niezal = tw$p.value,
             d_z = mean(roz) / sd(roz), d_av = mean(roz) / ((sd(d$przed) + sd(d$po)) / 2))
}))
print(round(podsum, 3), row.names = FALSE)

r_tekst <- sub("-", "−", sub("^(-?)0\\.", "\\1.", as.character(korelacje)))     # −.5, 0, .5, .8
etyk <- with(podsum, sprintf("r = %s: SD różnic = %.1f\nt dla par = %.2f, %s; d_z = %.2f",
                             r_tekst, SD_roznic, t_pary, p_apa(p_pary), d_z))
panele$panel <- factor(panele$r, korelacje, etyk)
p3 <- ggplot(panele, aes(przed, po)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey30", linetype = "dashed") +   # linia „bez zmiany”
  geom_point(aes(shape = po >= przed, colour = po >= przed), size = 2.2, alpha = 0.85) +
  facet_wrap(~ panel, ncol = 2) +
  scale_colour_manual(values = c("TRUE" = kol[["wzrost"]], "FALSE" = kol[["spadek"]]),
                      labels = c("TRUE" = "po ≥ przed (nad przekątną)", "FALSE" = "po < przed"), name = NULL) +
  scale_shape_manual(values = c("TRUE" = 16, "FALSE" = 17),
                     labels = c("TRUE" = "po ≥ przed (nad przekątną)", "FALSE" = "po < przed"), name = NULL) +
  coord_equal(xlim = c(5, 58), ylim = c(5, 58)) +
  labs(x = "Wynik przed (pkt)", y = "Wynik po (pkt)",
       title = "Ta sama różnica średnich (3 pkt), cztery korelacje",
       subtitle = sprintf("W każdym panelu test dla prób niezależnych: t = %.2f, %s;\nd_av = %.3f; linia przerywana: bez zmiany",
                          podsum$t_niezal[1], p_apa(podsum$p_niezal[1]), podsum$d_av[1])) +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.85)))
p3   # zapis: ggsave("proby-zalezne-cztery-korelacje.svg", p3, width = 8, height = 9)
Wynik w R
    r M_roznicy SD_roznic SE_pary t_pary p_pary SE_niezal t_niezal p_niezal
 -0.5         3    13.856   2.530  1.186  0.245     2.066    1.452    0.152
  0.0         3    11.314   2.066  1.452  0.157     2.066    1.452    0.152
  0.5         3     8.000   1.461  2.054  0.049     2.066    1.452    0.152
  0.8         3     5.060   0.924  3.248  0.003     2.066    1.452    0.152
   d_z  d_av
 0.217 0.375
 0.265 0.375
 0.375 0.375
 0.593 0.375
4. Symulacja mocy i fałszywych alarmów: Rysunek 4
R
# Rysunek 4. Moc i odsetek fałszywych alarmów obu testów w zależności od korelacji pomiarów
# (symulacja Monte Carlo; kontynuacja: kol, motyw, bz z bloku 1)
library(ggplot2)
library(patchwork)

# R badań po n par; różnica średnich = delta (w jednostkach SD pojedynczego pomiaru), korelacja r.
# Zwraca odsetek p < .05 w teście dla par i w teście Welcha (jakby próby były niezależne)
badania <- function(r, delta, n = 30, R = 10000) {
  z1 <- matrix(rnorm(R * n), R); z2 <- matrix(rnorm(R * n), R)
  przed <- z1; po <- delta + r * z1 + sqrt(1 - r^2) * z2
  roz <- po - przed
  t_p <- rowMeans(roz) / (apply(roz, 1, sd) / sqrt(n))
  v1 <- apply(przed, 1, var) / n; v2 <- apply(po, 1, var) / n
  t_w <- (rowMeans(po) - rowMeans(przed)) / sqrt(v1 + v2)
  df_w <- (v1 + v2)^2 / (v1^2 / (n - 1) + v2^2 / (n - 1))
  c(pary = mean(2 * pt(-abs(t_p), n - 1) < .05), Welch = mean(2 * pt(-abs(t_w), df_w) < .05))
}
siatka <- expand.grid(r = c(-0.5, -0.25, 0, 0.25, 0.5, 0.7, 0.8, 0.9), delta = c(0, 0.4))
set.seed(579)
sym <- cbind(siatka, t(mapply(badania, siatka$r, siatka$delta)))
sym$moc_wzor_pary <- ifelse(sym$delta > 0, sapply(sym$r, function(r)
  power.t.test(n = 30, delta = 0.4, sd = sqrt(2 * (1 - r)), type = "paired")$power), NA)
print(round(sym, 3), row.names = FALSE)
# Błąd Monte Carlo odsetka przy 10 000 powtórzeń: największy przy odsetku .5, a przy .05 – dużo mniejszy
round(c(blad_MC_przy_0.5 = sqrt(.5 * .5 / 10000), blad_MC_przy_0.05 = sqrt(.05 * .95 / 10000)), 4)

dl <- rbind(data.frame(sym[c("r", "delta")], test = "test dla par", odsetek = sym$pary),
            data.frame(sym[c("r", "delta")], test = "test dla prób niezależnych (Welch)", odsetek = sym$Welch))
dl$test <- factor(dl$test, c("test dla par", "test dla prób niezależnych (Welch)"))
skala <- list(scale_colour_manual(values = c("test dla par" = kol[["przed"]],
                                             "test dla prób niezależnych (Welch)" = kol[["po"]]), name = NULL),
              scale_shape_manual(values = c("test dla par" = 16, "test dla prób niezależnych (Welch)" = 17), name = NULL),
              scale_linetype_manual(values = c("test dla par" = "solid", "test dla prób niezależnych (Welch)" = "dashed"),
                                    name = NULL),
              scale_x_continuous(breaks = c(-0.5, -0.25, 0, 0.25, 0.5, 0.7, 0.9),
                                 labels = function(x) sub("^(-?)0\\.", "\\1.", format(x))))
pa <- ggplot(subset(dl, delta > 0), aes(r, odsetek, colour = test, shape = test, linetype = test)) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  geom_line(data = subset(sym, delta > 0), aes(r, moc_wzor_pary), inherit.aes = FALSE,
            colour = "grey20", linetype = "dotted", linewidth = 0.8) +
  skala + scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2), labels = bz) +
  labs(x = "Korelacja pomiarów r", y = "Odsetek p < .05", title = "A. Moc przy różnicy 0.4 SD",
       subtitle = "Kropkowana: moc ze wzoru (power.t.test)") + motyw
pb <- ggplot(subset(dl, delta == 0), aes(r, odsetek, colour = test, shape = test, linetype = test)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = .05 - 2 * sqrt(.05 * .95 / 10000),
           ymax = .05 + 2 * sqrt(.05 * .95 / 10000), fill = "grey85") +
  geom_hline(yintercept = .05, colour = "grey30") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  skala + scale_y_continuous(limits = c(0, 0.2), breaks = seq(0, 0.2, 0.05), labels = bz) +
  labs(x = "Korelacja pomiarów r", y = NULL, title = "B. Fałszywe alarmy przy braku różnicy",
       subtitle = "Szare pasmo: .05 ± 2 błędy Monte Carlo") + motyw
p4 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("proby-zalezne-moc-i-alfa.svg", p4, width = 9, height = 5.4)
Wynik w R
     r delta  pary Welch moc_wzor_pary
 -0.50   0.0 0.048 0.106            NA
 -0.25   0.0 0.052 0.080            NA
  0.00   0.0 0.046 0.045            NA
  0.25   0.0 0.050 0.025            NA
  0.50   0.0 0.053 0.006            NA
  0.70   0.0 0.050 0.001            NA
  0.80   0.0 0.050 0.000            NA
  0.90   0.0 0.051 0.000            NA
 -0.50   0.4 0.229 0.363         0.231
 -0.25   0.4 0.272 0.353         0.268
  0.00   0.4 0.321 0.329         0.322
  0.25   0.4 0.406 0.308         0.409
  0.50   0.4 0.552 0.266         0.563
  0.70   0.4 0.782 0.226         0.780
  0.80   0.4 0.912 0.193         0.917
  0.90   0.4 0.997 0.137         0.997
 blad_MC_przy_0.5 blad_MC_przy_0.05
           0.0050            0.0022
5. Regresja do średniej bez interwencji: Rysunek 5
R
# Rysunek 5. Regresja do średniej: „poprawa” osób zakwalifikowanych z najniższym wynikiem, bez żadnego treningu
# (kontynuacja: kol, motyw, bz, p_apa z bloku 1)
library(ggplot2)

# 400 osób, dwa pomiary tym samym testem, BRAK treningu: średnia 30 i SD 8 w obu pomiarach.
# Do „treningu” kwalifikujemy 25% osób z najniższym wynikiem przed. Te same liczby losowe przy r = .5 i .8
N <- 400
set.seed(579)
z1 <- rnorm(N); z2 <- rnorm(N)
rtm <- do.call(rbind, lapply(c(0.5, 0.8), function(r)
  data.frame(r = r, przed = 30 + 8 * z1, po = 30 + 8 * (r * z1 + sqrt(1 - r^2) * z2))))
rtm$wybrany <- rtm$przed <= quantile(30 + 8 * z1, 0.25)

wyn <- do.call(rbind, lapply(split(rtm, rtm$r), function(d) {
  w <- d[d$wybrany, ]; tt <- t.test(w$po, w$przed, paired = TRUE)
  data.frame(r = d$r[1], n_wybranych = nrow(w), r_w_probie = cor(d$przed, d$po), M_przed = mean(w$przed),
             M_po = mean(w$po), zmiana = mean(w$po - w$przed),
             oczekiwana_zmiana = (1 - d$r[1]) * (30 - mean(w$przed)),   # (1 − r) · odległość od średniej
             t = tt$statistic, df = tt$parameter, p = tt$p.value)
}))
print(round(wyn[names(wyn) != "p"], 3), row.names = FALSE)
signif(wyn$p, 3)                                  # wartości p dla r = .5 i .8

rtm$panel <- factor(rtm$r, c(0.5, 0.8), sprintf("r = %s: „poprawa” o %.1f pkt\nt(%d) = %.2f, %s",
                                               bz(c(0.5, 0.8), 1), wyn$zmiana, round(wyn$df), wyn$t,
                                               sapply(wyn$p, p_apa)))
rtm$grupa <- factor(ifelse(rtm$wybrany, "zakwalifikowani (najniższe 25%)", "pozostali"),
                    c("zakwalifikowani (najniższe 25%)", "pozostali"))
srodki <- data.frame(panel = levels(rtm$panel), M_przed = wyn$M_przed, M_po = wyn$M_po)
p5 <- ggplot(rtm, aes(przed, po)) +
  geom_point(aes(colour = grupa, shape = grupa, alpha = grupa), size = 1.7) +
  geom_abline(slope = 1, intercept = 0, colour = "grey30", linetype = "dashed") +
  geom_vline(data = srodki, aes(xintercept = M_przed), colour = kol[["spadek"]], linetype = "dotted") +
  geom_hline(data = srodki, aes(yintercept = M_po), colour = kol[["spadek"]]) +
  geom_point(data = srodki, aes(M_przed, M_po), shape = 23, size = 4.5, fill = "white", colour = "black", stroke = 1.2) +
  facet_wrap(~ panel, ncol = 2) +
  scale_colour_manual(values = c("zakwalifikowani (najniższe 25%)" = kol[["spadek"]], "pozostali" = "grey60"), name = NULL) +
  scale_shape_manual(values = c("zakwalifikowani (najniższe 25%)" = 17, "pozostali" = 16), name = NULL) +
  scale_alpha_manual(values = c("zakwalifikowani (najniższe 25%)" = 0.85, "pozostali" = 0.35), name = NULL) +
  coord_equal(xlim = c(2, 58), ylim = c(2, 58)) +
  labs(x = "Wynik przed (pkt)", y = "Wynik po (pkt)", title = "Bez treningu, a jednak „poprawa”",
       subtitle = "Romb: średnie zakwalifikowanych przed (linia kropkowana) i po (ciągła);\nlinia przerywana: wynik po = wynik przed") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.85)))
p5   # zapis: ggsave("proby-zalezne-regresja-do-sredniej.svg", p5, width = 8, height = 5.6)
Wynik w R
   r n_wybranych r_w_probie M_przed   M_po zmiana oczekiwana_zmiana     t df
 0.5         100      0.462  20.086 26.014  5.929             4.957 9.712 99
 0.8         100      0.798  20.086 22.742  2.656             1.983 6.459 99
[1] 4.65e-16 3.95e-09
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (para / niezależne; wzrost / spadek)" = c("#0072B2", "#D55E00"),
             "jasnoszary – cynober (wariancje / − 2·kowariancja)" = c("#BFBFBF", "#D55E00"),
             "jasnoszary – niebieski (wariancje / Var różnic)" = c("#BFBFBF", "#0072B2"),
             "cynober – szary (zakwalifikowani / pozostali)" = c("#D55E00", "#999999"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                         widzenie_typowe
niebieski – cynober (para / niezależne; wzrost / spadek)           114.6
jasnoszary – cynober (wariancje / − 2·kowariancja)                  80.1
jasnoszary – niebieski (wariancje / Var różnic)                     52.0
cynober – szary (zakwalifikowani / pozostali)                       77.2
czerwony – zielony (do unikania)                                   121.7
                                                         deuteranopia
niebieski – cynober (para / niezależne; wzrost / spadek)        108.3
jasnoszary – cynober (wariancje / − 2·kowariancja)               65.5
jasnoszary – niebieski (wariancje / Var różnic)                  55.9
cynober – szary (zakwalifikowani / pozostali)                    62.9
czerwony – zielony (do unikania)                                 21.1
                                                         protanopia
niebieski – cynober (para / niezależne; wzrost / spadek)       91.9
jasnoszary – cynober (wariancje / − 2·kowariancja)             61.5
jasnoszary – niebieski (wariancje / Var różnic)                47.3
cynober – szary (zakwalifikowani / pozostali)                  56.0
czerwony – zielony (do unikania)                               31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Testy t, losowania i moc ze wzoru (power.t.test()) – pakiet stats; dane o zadanej korelacji – funkcja mvrnorm() pakietu MASS. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Test dla prób niezależnych na pomiarach tych samych osób. Przy dodatniej korelacji traci moc, przy ujemnej daje za dużo fałszywych alarmów (rysunek 4).
- Ocenianie zmiany po zachodzeniu przedziałów dwóch średnich. Przy parach liczy się przedział różnicy (rysunki 1 i 2).
- „d = 0.50” bez nazwy wzoru. Przy tej samej zmianie dz i dav mogą różnić się wyraźnie.
- Analiza mocy z optymistyczną korelacją. Przy r = .8 zamiast .5 moc rośnie z .55 do .91 – załóż korelację z wcześniejszych danych (rysunek 4).
- Istotna poprawa w grupie wybranej za niski wynik jako dowód skuteczności. To może być regresja do średniej (rysunek 5).
Najczęstsze pytania
Dlaczego test dla par daje istotny wynik, a test dla prób niezależnych na tych samych danych nie?
Bo oba liczą tę samą różnicę średnich, ale dzielą ją przez inny błąd standardowy. Test dla par korzysta z różnic w obrębie osób, z których usunięto stałe różnice między ludźmi. W naszym przykładzie z 30 parami (r = .74) błąd standardowy wyniósł 1.07 zamiast 2.08, więc t wzrosło z 1.41 (p = .164) do 2.74 (p = .010).
Od czego zależy, o ile test dla par jest mocniejszy?
Głównie od korelacji pomiarów. Wariancja różnic to suma wariancji obu pomiarów minus podwojona kowariancja, więc im wyższa dodatnia korelacja, tym mniejsze SD różnic. W symulacji z 30 parami i różnicą 0.4 SD moc testu dla par wyniosła .32 przy r = 0, .55 przy .5 i .91 przy .8. Przy r = 0 oba testy mają podobną moc.
Co się dzieje, gdy pomiary korelują ujemnie?
Wariancja różnic jest wtedy większa niż przy pomiarach niezależnych i test dla par traci moc (w symulacji .23 przy r = −.5). Test dla prób niezależnych nie jest jednak lepszym wyjściem: przy r = −.5 dawał 10.6% fałszywych alarmów zamiast 5%. Test dla par trzymał poziom .05 przy każdej korelacji.
Dlaczego d_z wychodzi większe niż d_av?
Bo dz dzieli średnią różnicę przez SD różnic, a to maleje, gdy pomiary silnie korelują. dav dzieli przez średnie SD pomiarów, na które korelacja nie wpływa. Przy tej samej zmianie o 3 punkty i SD = 8 dav wynosiło 0.375, a dz – od 0.22 przy r = −.5 do 0.59 przy r = .8. Zawsze napisz, którą wersję podajesz.
Czy istotny wynik testu dla par dowodzi, że interwencja zadziałała?
Nie. Test sprawdza tylko, czy średnia zmiana różni się od zera. Gdy do badania kwalifikujesz osoby z niskim wynikiem, poprawią się one średnio nawet bez interwencji. W naszej symulacji bez żadnego treningu 100 najsłabszych osób „poprawiło się” o 5.9 punktu przy r = .5 (p < .001). Potrzebna jest grupa kontrolna kwalifikowana tak samo.
Powiązane hasła
Przeczytaj też
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikRegresja do średniej w badaniu przed–po
Dlaczego osoby zakwalifikowane za wysoki wynik „poprawiają się” bez leczenia, ile wynosi ten efekt i jak go usunąć grupą kontrolną, ANCOVA i osobnym pomiarem wyjściowym.
Czytaj →PoradnikMoc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →PoradnikPorównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →Masz pomiary przed i po i nie wiesz, jak je policzyć?
Pomożemy dobrać test, sprawdzić założenia na różnicach, policzyć wielkość efektu i opisać wynik w pracy – tak, żebyś umiał(a) wyjaśnić promotorowi i recenzentowi, dlaczego wybrano taką analizę.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Belia, S., Fidler, F., Williams, J., & Cumming, G. (2005). Researchers misunderstand confidence intervals and standard error bars. Psychological Methods, 10(4), 389–396. https://doi.org/10.1037/1082-989x.10.4.389
- Clifton, L., & Clifton, D. A. (2019). The correlation between baseline score and post-intervention score, and its implications for statistical analysis. Trials, 20(1), Article 43. https://doi.org/10.1186/s13063-018-3108-3 ● Otwarty dostęp
- Dunlap, W. P., Cortina, J. M., Vaslow, J. B., & Burke, M. J. (1996). Meta-analysis of experiments with matched groups or repeated measures designs. Psychological Methods, 1(2), 170–177. https://doi.org/10.1037/1082-989x.1.2.170
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Zimmerman, D. W. (1997). Teacher’s corner: A note on interpretation of the paired-samples t test. Journal of Educational and Behavioral Statistics, 22(3), 349–360. https://doi.org/10.3102/10769986022003349
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{belia2005researchers, author={Belia, Sarah and Fidler, Fiona and Williams, Jennifer and Cumming, Geoff}, title={{Researchers misunderstand confidence intervals and standard error bars}}, journal={Psychological Methods}, year={2005}, volume={10}, number={4}, pages={389--396}, doi={10.1037/1082-989x.10.4.389}}@article{clifton2019correlation, author={Clifton, Lei and Clifton, David A.}, title={{The correlation between baseline score and post-intervention score, and its implications for statistical analysis}}, journal={Trials}, year={2019}, volume={20}, number={1}, eid={43}, doi={10.1186/s13063-018-3108-3}}@article{dunlap1996metaanalysis, author={Dunlap, William P. and Cortina, Jose M. and Vaslow, Joel B. and Burke, Michael J.}, title={{Meta-analysis of experiments with matched groups or repeated measures designs}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={170--177}, doi={10.1037/1082-989x.1.2.170}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{zimmerman1997note, author={Zimmerman, Donald W.}, title={{Teacher’s corner: A note on interpretation of the paired-samples t test}}, journal={Journal of Educational and Behavioral Statistics}, year={1997}, volume={22}, number={3}, pages={349--360}, doi={10.3102/10769986022003349}}