Co to jest regresja do średniej?
Regresja do średniej (ang. regression to the mean) to zjawisko statystyczne: osoby, które w pierwszym pomiarze uzyskały wynik skrajny, w drugim uzyskują przeciętnie wynik bliższy średniej, nawet gdy nic się z nimi nie stało. Naturalna zmienność powtarzanych pomiarów wygląda wtedy jak rzeczywista zmiana. Efekt jest tym silniejszy, im większy błąd pomiaru, i najwyraźniejszy, gdy analizuje się tylko osoby wybrane na podstawie wyniku wyjściowego (Barnett i in., 2005). To jedno z głównych zagrożeń trafności wewnętrznej badań przed–po, do których kwalifikuje się osoby z nasilonymi objawami.
Skąd się bierze regresja do średniej
Wynik obserwowany to stały poziom osoby plus losowe wahanie. Kto w pierwszym pomiarze wypadł bardzo wysoko, ten częściej trafił na wahanie w górę; w drugim pomiarze wahanie losuje się od nowa. Gdy oba pomiary mają tę samą średnią i odchylenie standardowe, oczekiwany drugi wynik wynosi:
gdzie μ to średnia w populacji, a r – korelacja obu pomiarów, czyli rzetelność test–retest, gdy badana cecha się nie zmienia. Przy r = 1 regresji nie ma; przy niższym r w drugim pomiarze znika średnio część (1 − r) odchylenia od średniej.
Przykład
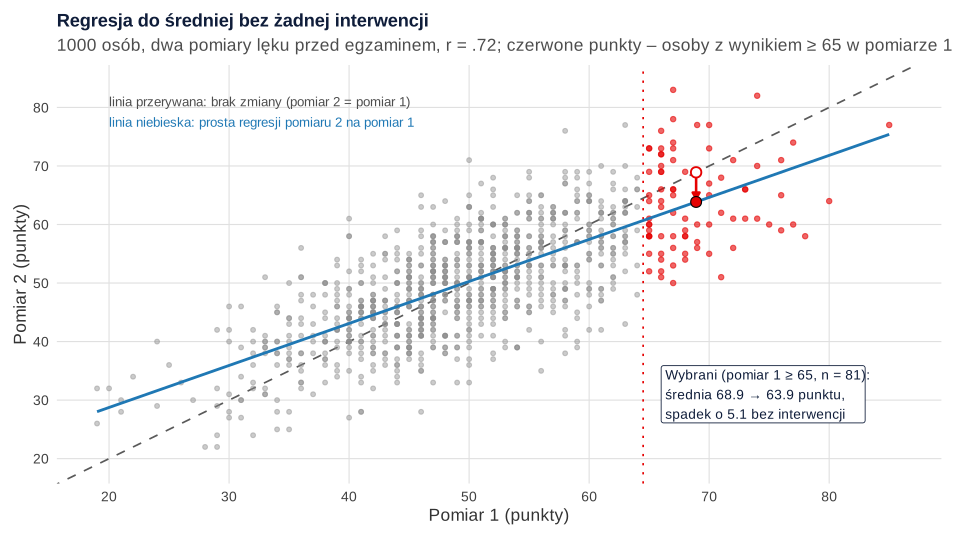
W symulacji 1000 osób studiujących dwa razy wypełniło skalę lęku przed egzaminem, bez żadnej interwencji (μ = 50, σ = 10; dane symulowane). Korelacja pomiarów wyniosła r = .72, a średnia w całej próbie prawie się nie zmieniła (50.21 i 50.42). Osoby z wynikiem co najmniej 65 punktów (n = 81) potraktowaliśmy jak zakwalifikowane do programu. Ich średnia spadła z 68.91 do 63.85 punktu, t(80) = −5.53, p < .001, choć programu nie było; wzór przewidywał 63.24 (rysunek 1).
Jak zapisać w pracy
Na co uważać
- Spadek wyniku po kwalifikacji za wysoki wynik nie dowodzi skuteczności. Istotny test t dla prób zależnych w przykładzie powstał bez interwencji. Potrzebna jest grupa kontrolna wybrana według tego samego kryterium: regresja do średniej wystąpi w obu grupach i zniknie z porównania.
- Analiza samych zmian nie rozwiązuje problemu. Zmiana jest prawie zawsze skorelowana z wynikiem wyjściowym, dlatego pomiar wyjściowy uwzględnij jako kowariant w ANCOVA (Clifton i Clifton, 2019).
- Zjawisko działa w obie strony. Najsłabsi uczniowie „poprawią się” po dowolnych zajęciach wyrównawczych, a najlepsi „pogorszą”.
- Kwalifikuj na podstawie jednego pomiaru, a jako wartość wyjściową przyjmij kolejny albo średnią z dwóch. Przykład z bólem przewlekłym omawiamy w poradniku statystyka dla fizjoterapeuty.
Symulacja regresji do średniej w R
Kod tworzy dwa pomiary tej samej cechy bez żadnej interwencji, wybiera osoby z wysokim wynikiem w pierwszym pomiarze i porównuje ich średnie z przewidywaniem ze wzoru. Liczby z przykładu i z rysunku pochodzą z tego kodu.
Pozorna poprawa w grupie wybranej za wysoki wynik
R
set.seed(81)
N <- 1000; r <- 0.70                                                 # liczba osób, korelacja test–retest
staly <- rnorm(N)                                                    # stały poziom lęku osoby (wynik z)
p1 <- round(50 + 10 * (sqrt(r) * staly + sqrt(1 - r) * rnorm(N)))   # pomiar 1
p2 <- round(50 + 10 * (sqrt(r) * staly + sqrt(1 - r) * rnorm(N)))   # pomiar 2, bez interwencji
round(c(r = cor(p1, p2), M1 = mean(p1), M2 = mean(p2)), 2)           # cała próba
w <- p1 >= 65                                                        # kwalifikacja: wysoki lęk w pomiarze 1
round(c(n = sum(w), M1 = mean(p1[w]), M2 = mean(p2[w]), zmiana = mean(p2[w] - p1[w]),
        M2_ze_wzoru = 50 + r * (mean(p1[w]) - 50)), 2)               # E(X2 | X1) = μ + r(X1 − μ)
with(t.test(p2[w], p1[w], paired = TRUE), round(c(t = unname(statistic), df = unname(parameter), p = p.value), 3))
Wynik w R
    r    M1    M2
 0.72 50.21 50.42
          n          M1          M2      zmiana M2_ze_wzoru
      81.00       68.91       63.85       -5.06       63.24
     t     df      p
-5.527 80.000  0.000
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Dlaczego występuje regresja do średniej?
Wynik obserwowany to stały poziom osoby plus losowe wahanie. Skrajny wynik często zawiera duże wahanie w tę samą stronę, a w kolejnym pomiarze wahanie jest nowe. Gdy korelacja pomiarów wynosi 1, regresji nie ma.
Jak odróżnić regresję do średniej od efektu terapii?
Porównaj zmianę z losowo utworzoną grupą kontrolną, kwalifikowaną według tego samego kryterium, najlepiej w ANCOVA z pomiarem wyjściowym jako kowariantem. Sama poprawa przed–po w jednej grupie tych zjawisk nie rozdziela.
Czy regresja do średniej dotyczy też niskich wyników?
Tak. Osoby wybrane za bardzo niski wynik w kolejnym pomiarze wypadają przeciętnie wyżej, np. najsłabsi uczniowie „poprawiają się” po każdych zajęciach wyrównawczych, nawet nieskutecznych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →PoradnikPytania na obronie z metodologii i statystyki
38 pytań komisji o hipotezy, schemat, próbę, narzędzia, analizy i wyniki – z przykładowymi odpowiedziami, ściągą na jedną stronę i planem przygotowania.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Clifton, L., & Clifton, D. A. (2019). The correlation between baseline score and post-intervention score, and its implications for statistical analysis. Trials, 20(1), Article 43. https://doi.org/10.1186/s13063-018-3108-3 ● Otwarty dostęp
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{clifton2019correlation, author={Clifton, Lei and Clifton, David A.}, title={{The correlation between baseline score and post-intervention score, and its implications for statistical analysis}}, journal={Trials}, year={2019}, volume={20}, number={1}, eid={43}, doi={10.1186/s13063-018-3108-3}}