Pozorna poprawa: pacjenci lepsi bez leczenia
Studentka pielęgniarstwa planuje pracę o programie edukacyjnym dla osób z nadciśnieniem. Do programu trafią pacjenci, którym podczas wizyty w przychodni zmierzono ciśnienie skurczowe co najmniej 150 mmHg. Po ośmiu tygodniach pielęgniarka zmierzy ciśnienie jeszcze raz. Student fizjoterapii robi to samo z bólem krzyża: kwalifikuje osoby z bólem co najmniej 6 w skali NRS i mierzy ból po serii zabiegów. Oba projekty mają ten sam słaby punkt. Część poprawy pojawi się nawet wtedy, gdy program i zabiegi nie działają wcale.
To regresja do średniej. Hasło w słowniku wyjaśnia jej definicję i podstawowy wzór. Tu skupiamy się na praktyce badania przed–po: skąd bierze się pozorna poprawa, ile jej oczekiwać przy danym progu kwalifikacji i jakie decyzje w planie badania i w analizie ją usuwają. Morton i Torgerson (2003) zwracają uwagę, że niewiedza o tym zjawisku prowadzi do błędnego wniosku, że efekt dał zabieg, choć dał go przypadek.
Skąd się bierze: stały poziom, wahanie i błąd odczytu
Pojedynczy pomiar ciśnienia składa się z trzech części:
- stałego poziomu osoby – tego, co chcesz zmienić programem;
- wahania z dnia na dzień (zmienności wewnątrzosobniczej) – stres przed wizytą, kawa, gorsza noc;
- błędu pojedynczego odczytu – ułożenie mankietu, odczyt, ruch pacjenta.
Dwie ostatnie części losują się przy każdym pomiarze od nowa. Kto w pomiarze kwalifikacyjnym przekroczył próg, ten częściej „trafił” na wahanie w górę. W następnym pomiarze tego wahania już nie ma i średnia grupy spada. To samo dzieje się z bólem: pacjent zgłasza się do fizjoterapeuty zwykle wtedy, gdy boli najbardziej.
Siłę zjawiska opisuje rzetelność test–retest, czyli korelacja dwóch pomiarów u osób, u których nic się nie zmieniło. W naszej symulacji stały poziom ma SD = 14 mmHg, wahanie dnia 7 mmHg, a błąd odczytu 5 mmHg. Rzetelność jednego odczytu wynosi więc 14² / (14² + 7² + 5²) = .726. Bland i Altman (1994) podkreślają, że im słabsza korelacja obu pomiarów, tym silniejsza regresja do średniej. Barnett i in. (2005) dodają, że efekt rośnie z błędem pomiaru i jest najbardziej widoczny, gdy dalsze pomiary analizuje się tylko w podgrupie wybranej według wyniku wyjściowego. Od standardowego błędu pomiaru zależy też, czy zmiana u jednej osoby jest wiarygodna – to temat wpisu o RCI, MDC i MCID.
Symulacja: 5000 osób, dwa pomiary, zero leczenia
W symulowanym badaniu przesiewowym zmierzyliśmy ciśnienie u 5000 osób dwa razy, w odstępie ośmiu tygodni, bez żadnej interwencji. W całej próbie średnia się nie zmieniła (131.63 i 131.61 mmHg), a korelacja pomiarów wyniosła r = .72. Dane możesz pobrać w pliku CSV.
Próg 150 mmHg przekroczyło 687 osób (13.74%). Ich średnie ciśnienie spadło ze 157.76 do 150.28 mmHg, czyli o 7.48 mmHg, 95% CI [−8.36, −6.60]. Test t dla prób zależnych dał t(686) = −16.75, p < .001. U 43.1% zakwalifikowanych ciśnienie spadło o co najmniej 10 mmHg. Gdyby to była grupa po programie edukacyjnym, wynik wyglądałby na wielki sukces. Rysunek 1 pokazuje, skąd ten spadek.
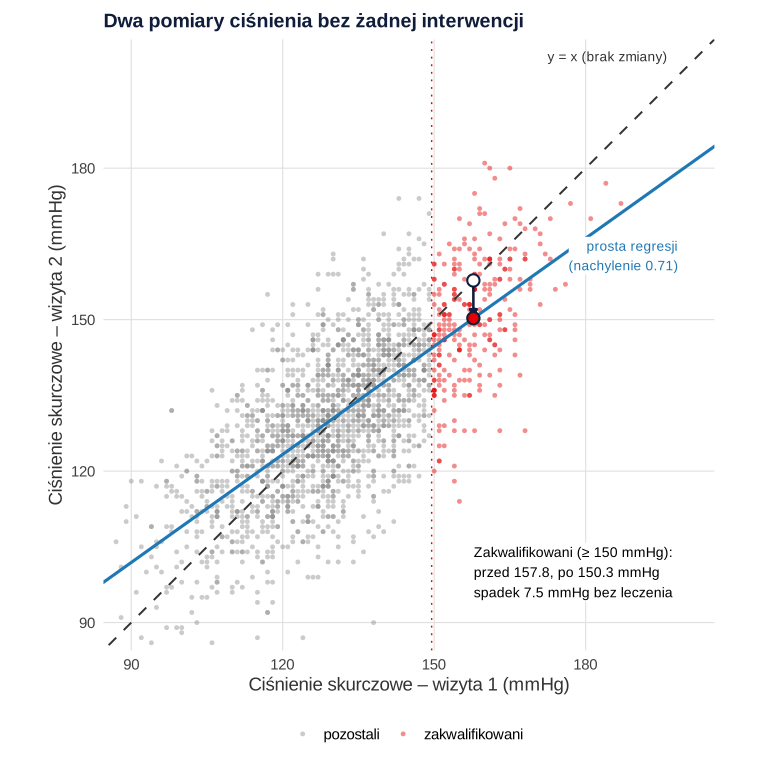
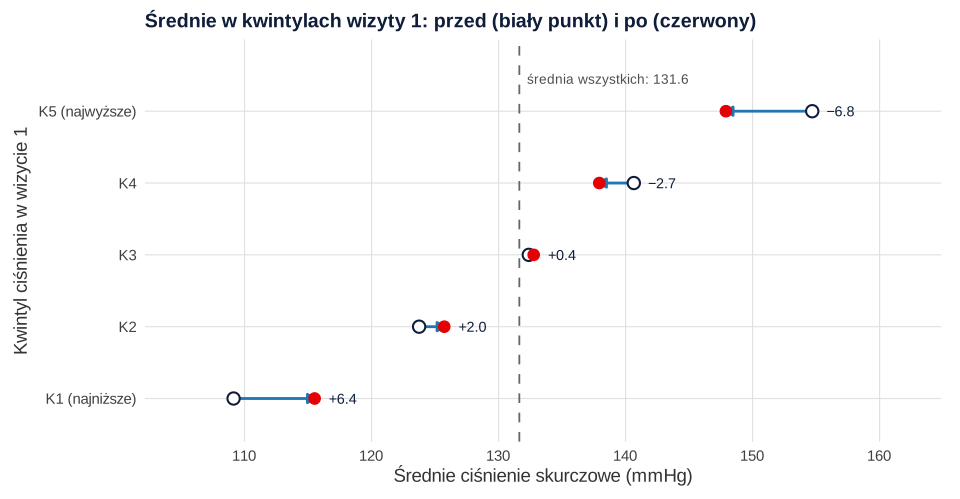
Zjawisko działa w obie strony. Na rysunku 2 podzieliliśmy całą próbę na piątki (kwintyle) według pierwszego pomiaru. Najwyższa piątka „obniżyła” ciśnienie o 6.80 mmHg, a najniższa „podwyższyła” o 6.38 mmHg. Środkowa prawie się nie zmieniła (+0.38). Dlatego wniosek „program najbardziej pomógł osobom z najwyższym ciśnieniem” bez grupy porównawczej niczego nie dowodzi.
Ile regresji się spodziewać: wzór z progiem kwalifikacji
Wzór ze słownika przewiduje drugi pomiar dla danej średniej grupy: μ + r × (X̄1 − μ). W naszych danych daje 150.48 mmHg, prawie tyle, ile zaobserwowaliśmy (150.28). Często jednak znasz tylko próg kwalifikacji, a nie średnią grupy po kwalifikacji – na przykład planujesz badanie. Wtedy, przy rozkładzie zbliżonym do normalnego, oczekiwany spadek wynosi:
Tu c to próg kwalifikacji, μ i SD – średnia i odchylenie standardowe w populacji, z której kwalifikujesz, a φ i Φ – gęstość i dystrybuanta rozkładu normalnego standaryzowanego. Iloraz φ(z) / [1 − Φ(z)] mówi, o ile odchyleń standardowych średnia osób powyżej progu przewyższa średnią wszystkich. Dla naszych danych wzór daje 7.29 mmHg, a symulacja – 7.48 mmHg. Linden (2013) sprawdził ten tradycyjny sposób liczenia w symulacji: przy danych normalnych dawał wartości zgodne z prawdziwymi, a przy danych skośnych zaniżał efekt. Tabela 1 pokazuje, jak oczekiwany spadek zależy od rzetelności i progu.
| Rzetelność test–retest r | Próg = μ + 1 SD | Próg = μ + 1.5 SD |
|---|---|---|
| .5 | 12.5 mmHg | 15.9 mmHg |
| .7 | 7.5 mmHg | 9.6 mmHg |
| .8 | 5.0 mmHg | 6.4 mmHg |
| .9 | 2.5 mmHg | 3.2 mmHg |
Tabela zakłada SD = 16.4 mmHg, jak w symulacji. Przy rzetelności .7 i progu o 1 SD powyżej średniej spodziewasz się spadku o 7.5 mmHg bez żadnego leczenia – to więcej niż prawdziwy efekt programu w następnym przykładzie. Im ostrzejszy próg i im słabszy pomiar, tym większa pozorna poprawa.
Obrona 1: grupa kontrolna z tym samym kryterium i ANCOVA
Najskuteczniejsza ochrona to grupa kontrolna zakwalifikowana według tego samego progu, najlepiej z losowym przydziałem. Regresja do średniej działa w obu grupach tak samo, więc znika z różnicy między nimi. W drugiej symulacji z badania przesiewowego 1500 osób zakwalifikowaliśmy 243 z ciśnieniem co najmniej 150 mmHg i losowo przydzieliliśmy je do programu edukacyjnego (121 osób) albo zwykłej opieki (122). Prawdziwy efekt programu ustawiliśmy na −5 mmHg.
| Analiza | Wynik | Co mierzy |
|---|---|---|
| Tylko grupa z programem, przed–po | −13.08 mmHg, 95% CI [−15.12, −11.04] | efekt programu + regresja do średniej |
| Tylko grupa kontrolna, przed–po | −8.25 mmHg | regresja do średniej (i naturalny przebieg) |
| Różnica zmian między grupami | −4.84 mmHg, 95% CI [−7.71, −1.96], p = .001 | efekt programu |
| ANCOVA z pomiarem wyjściowym | −4.57 mmHg, 95% CI [−7.43, −1.71], p = .002 | efekt programu |
Badanie bez grupy kontrolnej przypisałoby programowi spadek o 13.08 mmHg, ponad dwa i pół raza większy niż prawdziwy. Żeby nie polegać na jednym losowaniu, powtórzyliśmy badanie 2000 razy. Analiza samej grupy z programem dawała średnio −12.07 mmHg (SD oszacowań 1.09), a różnica zmian i ANCOVA – po −4.96 mmHg (SD 1.56 i 1.54). Obie analizy z grupą kontrolną trafiały w prawdziwy efekt, a ANCOVA była nieco bardziej precyzyjna.
Czy w pracy wybrać ANCOVA, czy różnicę zmian? Clifton i Clifton (2019) pokazują, że zmiana prawie zawsze koreluje z wynikiem wyjściowym, więc sama analiza zmian nie rozwiązuje problemu regresji do średniej ani przypadkowej nierównowagi grup. Zalecają uwzględnić pomiar wyjściowy jako kowariant. Senn (2006) wyjaśnia, że ANCOVA nie wymaga równości grup na starcie, by dać nieobciążone oszacowanie. Vickers i Altman (2001) zauważają, że to, czy większą moc ma porównanie wyników końcowych, czy zmian, zależy od korelacji pomiaru wyjściowego i końcowego. Porównanie wszystkich strategii na jednym zbiorze danych znajdziesz we wpisie ANCOVA w badaniu przed i po, a pułapkę grup nierandomizowanych – we wpisie o paradoksie Lorda.
Obrona 2: nie kwalifikuj i nie mierz wyjściowo tym samym pomiarem
Drugi sposób działa jeszcze przed analizą. Pomiar, na podstawie którego kwalifikujesz, nie powinien być jednocześnie pomiarem wyjściowym. W trzeciej symulacji (100 000 osób, bez interwencji) porównaliśmy cztery strategie. Osoby kwalifikowano odczytem co najmniej 150 mmHg, a pomiar końcowy był po ośmiu tygodniach.
| Pomiar wyjściowy | Przed | Po | Pozorna zmiana |
|---|---|---|---|
| A. Ten sam odczyt, który kwalifikował | 158.26 | 151.09 | −7.16 |
| B. Średnia 3 odczytów z wizyty kwalifikacyjnej | 156.69 | 151.09 | −5.59 |
| C. Osobna wizyta po kwalifikacji | 151.13 | 151.09 | −0.04 |
| D. Kwalifikacja i wyjściowy = średnia 2 wizyt | 157.40 | 153.26 | −4.14 |
Średnia trzech odczytów z jednej wizyty (B) pomogła niewiele, bo usuwa tylko błąd odczytu, a wahanie dnia zostaje. Kwalifikacja na średniej z dwóch wizyt (D) zmniejszyła regresję, ale jej nie usunęła. Prawie całkowicie usunął ją dopiero osobny pomiar wyjściowy po kwalifikacji (C): −0.04 mmHg. Zakwalifikowane osoby nadal mają wysokie ciśnienie, ale ich pomiar wyjściowy nie jest już „wybrany” za wysoką wartość. Barnett i in. (2005) podkreślają, że regresję do średniej można ograniczać nie tylko w analizie, ale już na etapie planu badania. Opisz je w kryteriach włączenia: który pomiar kwalifikuje, a który jest wyjściowy.
Obrona 3: gdy nie masz grupy kontrolnej, policz oczekiwaną regresję
W wielu pracach dyplomowych grupy kontrolnej nie da się zebrać. Schemat pretest–posttest bez grupy kontrolnej nie pozwala wtedy oszacować efektu, ale możesz pokazać, jaka część zmiany mieści się w regresji do średniej. Potrzebujesz rzetelności test–retest i średniej populacji, najlepiej z osobnego badania lub literatury. W przykładzie badanie pilotażowe 150 osób dało r = .75 i μ = 132.67 mmHg. Grupa z programem miała na starcie 158.39 mmHg, więc oczekiwana zmiana bez programu to −(1 − .75) × (158.39 − 132.67) = −6.36 mmHg. Po odjęciu jej od obserwowanej zmiany (−13.08) zostaje −6.72 mmHg.
Prawdziwy efekt wynosił −5, a grupa kontrolna w tym samym badaniu spadła o 8.25 mmHg, czyli więcej niż przewidział wzór. Korekta zależy od oszacowania rzetelności, kształtu rozkładu i założenia, że bez programu nic innego by się nie zmieniło. Traktuj ją jako argument w ograniczeniach badania, a nie jako oszacowanie efektu. Inne przyczyny zmiany w badaniu bez kontroli, takie jak efekt placebo czy naturalny przebieg choroby, omawia hasło o trafności wewnętrznej.
Jak to opisać w pracy
Badanie z grupą kontrolną – fragment wyników:
Badanie bez grupy kontrolnej – fragment ograniczeń:
Więcej przykładów z badań przed i po w zawodach medycznych znajdziesz we wpisach statystyka w pracy z pielęgniarstwa i statystyka dla fizjoterapeuty.
Najczęstsze błędy
- Istotny test t przed–po jako dowód skuteczności. W symulacji bez leczenia p < .001.
- Grupa kontrolna z innym kryterium. Jeśli kontrolą są osoby z „prawidłowym” ciśnieniem, regresja do średniej działa tylko w grupie badanej.
- Wniosek „najbardziej skorzystali najciężej chorzy”. Grupy skrajne przesuwają się do średniej same z siebie (rysunek 2).
- Kwalifikujący odczyt jako pomiar wyjściowy. To strategia A z tabeli – największa pozorna poprawa.
- Analiza samych zmian jako lek na regresję do średniej. W jednej grupie zmiana zawiera całą regresję do średniej.
Jeśli nie wiesz, którą analizę wybrać do swojego schematu, możesz skorzystać z konsultacji analizy statystycznej.
Wszystkie obliczenia w R
Trzy przepisy liczą wszystkie liczby z tekstu i tabel. Każdy działa samodzielnie i korzysta tylko z bazowego R. Rysunki powstały w ggplot2 z pliku CSV zapisanego przez przepis 1.
1. Pozorna poprawa bez leczenia (rysunki 1 i 2)
R
# B349 – regresja do średniej bez żadnej interwencji: ciśnienie skurczowe w badaniu przesiewowym (dane symulowane)
# Odczyt = stały poziom osoby + wahanie z dnia na dzień + błąd pojedynczego odczytu (mmHg)
set.seed(3490)
N <- 5000
sd_osoba <- 14; sd_dzien <- 7; sd_blad <- 5
poziom <- rnorm(N, 132, sd_osoba)                                     # stały poziom ciśnienia osoby
odczyt <- function() round(poziom + rnorm(N, 0, sd_dzien) + rnorm(N, 0, sd_blad))
w1 <- odczyt()                                                        # wizyta 1 (przesiew)
w2 <- odczyt()                                                        # wizyta 2 po 8 tygodniach, bez interwencji
dane <- data.frame(id = 1:N, w1, w2)
write.csv(dane, "../regresja-do-sredniej-cisnienie-dane.csv", row.names = FALSE)

# Rzetelność jednego odczytu z teorii: wariancja osób / wariancja całkowita
cat(sprintf("Rzetelność teoretyczna: %.3f\n", sd_osoba^2 / (sd_osoba^2 + sd_dzien^2 + sd_blad^2)))
r <- cor(w1, w2); mu <- mean(w1); s <- sd(w1)
print(round(c(M1 = mu, M2 = mean(w2), SD1 = s, SD2 = sd(w2), r = r), 2))

# Kwalifikacja: ciśnienie co najmniej 150 mmHg w wizycie 1
k <- w1 >= 150
zm <- w2[k] - w1[k]
print(round(c(n = sum(k), proc = 100 * mean(k), M1 = mean(w1[k]), M2 = mean(w2[k]), zmiana = mean(zm)), 2))
tt <- t.test(w2[k], w1[k], paired = TRUE)
print(round(c(t = unname(tt$statistic), df = unname(tt$parameter), dol = tt$conf.int[1], gor = tt$conf.int[2]), 2))
cat("p =", signif(tt$p.value, 3), "\n")
cat(sprintf("Odsetek zakwalifikowanych ze spadkiem o co najmniej 10 mmHg: %.1f%%\n", 100 * mean(zm <= -10)))

# Przewidywanie: E(X2 | X1) = mu + r(X1 - mu) dla średniej grupy
cat(sprintf("Średnia w wizycie 2 ze wzoru: %.2f\n", mu + r * (mean(w1[k]) - mu)))
# Oczekiwana regresja przy progu c (rozkład normalny): (1 - r) * s * phi(z) / (1 - Phi(z)), z = (c - mu) / s
z <- (149.5 - mu) / s                                                  # 149.5: odczyty zaokrąglone do 1 mmHg
cat(sprintf("Oczekiwany spadek ze wzoru z progiem: %.2f mmHg\n", (1 - r) * s * dnorm(z) / (1 - pnorm(z))))

# Grupy skrajne i środkowe: kwintyle wizyty 1
kw <- cut(w1, quantile(w1, 0:5 / 5), include.lowest = TRUE, labels = paste0("K", 1:5))
sr <- aggregate(cbind(w1, w2, zmiana = w2 - w1) ~ kw, data.frame(w1, w2, kw), mean)
sr[, -1] <- round(sr[, -1], 2); print(sr)
Wynik w R
Rzetelność teoretyczna: 0.726
    M1     M2    SD1    SD2      r
131.63 131.61  16.32  16.15   0.72
     n   proc     M1     M2 zmiana
687.00  13.74 157.76 150.28  -7.48
     t     df    dol    gor
-16.75 686.00  -8.36  -6.60
p = 4.7e-53
Odsetek zakwalifikowanych ze spadkiem o co najmniej 10 mmHg: 43.1%
Średnia w wizycie 2 ze wzoru: 150.48
Oczekiwany spadek ze wzoru z progiem: 7.29 mmHg
  kw     w1     w2 zmiana
1 K1 109.14 115.52   6.38
2 K2 123.74 125.72   1.98
3 K3 132.38 132.77   0.38
4 K4 140.65 137.93  -2.72
5 K5 154.70 147.90  -6.80
2. Badanie z grupą kontrolną, korekta i 2000 powtórzeń
R
# B349 – badanie przed–po z grupą kontrolną: program edukacyjny prowadzony przez pielęgniarkę (dane symulowane)
# Kwalifikacja: ciśnienie skurczowe co najmniej 150 mmHg w wizycie przesiewowej; prawdziwy efekt programu = -5 mmHg
badanie <- function(n_przesiew = 1500, efekt = -5) {
  poziom <- rnorm(n_przesiew, 132, 14)
  odczyt <- function() round(poziom + rnorm(n_przesiew, 0, 7) + rnorm(n_przesiew, 0, 5))
  przed <- odczyt()
  k <- which(przed >= 150)
  grupa <- sample(rep(0:1, length.out = length(k)))                   # 0 = zwykła opieka, 1 = program
  po <- odczyt()[k] + efekt * grupa
  data.frame(grupa, przed = przed[k], po)
}
set.seed(3497)
d <- badanie()
d$zmiana <- d$po - d$przed
print(table(d$grupa))
sr <- aggregate(cbind(przed, po, zmiana) ~ grupa, d, mean); sr[, -1] <- round(sr[, -1], 2); print(sr)

# (a) Tylko grupa z programem, test t dla prób zależnych – tak wyglądałoby badanie bez kontroli
p1 <- with(d[d$grupa == 1, ], t.test(po, przed, paired = TRUE))
print(round(c(zmiana = unname(p1$estimate), dol = p1$conf.int[1], gor = p1$conf.int[2], t = unname(p1$statistic), df = unname(p1$parameter)), 2))
cat("p =", signif(p1$p.value, 3), "\n")
# (b) Różnica zmian między grupami i (c) ANCOVA z pomiarem wyjściowym
m_zm <- lm(zmiana ~ grupa, d); m_anc <- lm(po ~ przed + grupa, d)
wyn <- rbind(roznica_zmian = c(coef(m_zm)["grupa"], confint(m_zm)["grupa", ], summary(m_zm)$coef["grupa", 4]),
             ancova = c(coef(m_anc)["grupa"], confint(m_anc)["grupa", ], summary(m_anc)$coef["grupa", 4]))
colnames(wyn) <- c("b", "dol", "gor", "p"); print(signif(wyn, 4))

# (d) Korekta oczekiwanej regresji w grupie z programem: rzetelność i średnia z osobnego badania test–retest
pilot_poziom <- rnorm(150, 132, 14)
pilot1 <- round(pilot_poziom + rnorm(150, 0, 7) + rnorm(150, 0, 5))
pilot2 <- round(pilot_poziom + rnorm(150, 0, 7) + rnorm(150, 0, 5))
r_tr <- cor(pilot1, pilot2); mu <- mean(c(pilot1, pilot2))
m_przed <- mean(d$przed[d$grupa == 1])
oczek <- -(1 - r_tr) * (m_przed - mu)                                  # oczekiwana zmiana bez programu
print(round(c(r = r_tr, mu = mu, oczekiwana = oczek, obserwowana = unname(p1$estimate),
              po_korekcie = unname(p1$estimate) - oczek), 2))

# Symulacja 2000 badań: średnie oszacowanie efektu i jego rozrzut (prawdziwy efekt = -5)
set.seed(3493)
sym <- t(replicate(2000, {
  s <- badanie(); s$zmiana <- s$po - s$przed
  c(jedna_grupa = mean(s$zmiana[s$grupa == 1]),
    roznica_zmian = unname(coef(lm(zmiana ~ grupa, s))["grupa"]),
    ancova = unname(coef(lm(po ~ przed + grupa, s))["grupa"]))
}))
print(round(rbind(srednia = colMeans(sym), SD = apply(sym, 2, sd)), 2))
Wynik w R
  0   1
122 121
  grupa  przed     po zmiana
1     0 157.25 149.00  -8.25
2     1 158.39 145.31 -13.08
zmiana    dol    gor      t     df
-13.08 -15.12 -11.04 -12.71 120.00
p = 5.79e-24
                   b    dol    gor        p
roznica_zmian -4.837 -7.714 -1.959 0.001073
ancova        -4.570 -7.429 -1.711 0.001848
          r          mu  oczekiwana obserwowana po_korekcie
       0.75      132.67       -6.36      -13.08       -6.72
        jedna_grupa roznica_zmian ancova
srednia      -12.07         -4.96  -4.96
SD             1.09          1.56   1.54
3. Cztery definicje pomiaru wyjściowego i tabela oczekiwanej regresji
R
# B349 – jak wybór pomiaru wyjściowego zmienia pozorną poprawę (bez interwencji, dane symulowane)
set.seed(3494)
N <- 1e5
poziom <- rnorm(N, 132, 14)
wizyta <- function(odczyty = 1) {                                      # jedna wizyta: wspólne wahanie dnia + błąd każdego odczytu
  dzien <- rnorm(N, 0, 7)
  rowMeans(sapply(seq_len(odczyty), function(i) poziom + dzien + rnorm(N, 0, 5)))
}

# Trzy odczyty tego samego dnia: pierwszy służy do kwalifikacji
dzien1 <- rnorm(N, 0, 7); e <- matrix(rnorm(3 * N, 0, 5), N)
odczyty_v1 <- poziom + dzien1 + e
kwal <- odczyty_v1[, 1]
v1_srednia3 <- rowMeans(odczyty_v1)
v1b <- wizyta(1)                                                       # osobna wizyta tydzień później
v2 <- wizyta(1)                                                        # pomiar końcowy po 8 tygodniach
k <- kwal >= 150

strategie <- rbind(
  "A: wyjściowy = odczyt kwalifikacyjny"         = c(mean(kwal[k]), mean(v2[k])),
  "B: wyjściowy = średnia 3 odczytów tej wizyty" = c(mean(v1_srednia3[k]), mean(v2[k])),
  "C: wyjściowy = osobna wizyta"                 = c(mean(v1b[k]), mean(v2[k])))
k2 <- (kwal + v1b) / 2 >= 150                                          # D: kwalifikacja na średniej z dwóch wizyt
strategie <- rbind(strategie, "D: kwalifikacja i wyjściowy = średnia 2 wizyt" =
                     c(mean(((kwal + v1b) / 2)[k2]), mean(v2[k2])))
colnames(strategie) <- c("przed", "po")
print(round(cbind(strategie, pozorna_zmiana = strategie[, 2] - strategie[, 1]), 2))
cat(sprintf("Zakwalifikowani: A–C n = %d, D n = %d\n", sum(k), sum(k2)))

# Oczekiwana regresja do średniej (mmHg) dla progu odległego o 1 i 1.5 SD od średniej przy różnej rzetelności
oczek <- function(r, z, s = sqrt(14^2 + 7^2 + 5^2)) (1 - r) * s * dnorm(z) / (1 - pnorm(z))
tab <- outer(c(.5, .7, .8, .9), c(1, 1.5), oczek)
dimnames(tab) <- list(r = c(".5", ".7", ".8", ".9"), prog = c("mu + 1 SD", "mu + 1.5 SD"))
print(round(tab, 1))
Wynik w R
                                               przed     po pozorna_zmiana
A: wyjściowy = odczyt kwalifikacyjny          158.26 151.09          -7.16
B: wyjściowy = średnia 3 odczytów tej wizyty  156.69 151.09          -5.59
C: wyjściowy = osobna wizyta                  151.13 151.09          -0.04
D: kwalifikacja i wyjściowy = średnia 2 wizyt 157.40 153.26          -4.14
Zakwalifikowani: A–C n = 13634, D n = 11988
    prog
r    mu + 1 SD mu + 1.5 SD
  .5      12.5        15.9
  .7       7.5         9.6
  .8       5.0         6.4
  .9       2.5         3.2
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak obliczyć spodziewaną regresję do średniej przy progu kwalifikacji?
Przy rozkładzie zbliżonym do normalnego oczekiwany spadek w grupie z wynikiem co najmniej c wynosi (1 − r) × SD × φ(z) / [1 − Φ(z)], gdzie z = (c − μ) / SD, a r to rzetelność test–retest. W przykładzie z ciśnieniem wzór dał 7.29 mmHg, a symulacja 7.48 mmHg. Przy rozkładach skośnych wzór może zaniżać efekt (Linden, 2013).
Czy grupa kontrolna usuwa regresję do średniej?
Tak, jeśli kwalifikujesz do niej osoby według tego samego kryterium i najlepiej przydzielasz je losowo. Regresja do średniej działa wtedy w obu grupach jednakowo i znika z różnicy między nimi. W symulacji 2000 badań różnica zmian i ANCOVA dawały średnio −4.96 mmHg przy prawdziwym efekcie −5, a analiza samej grupy z programem −12.07 mmHg.
Czy średnia z kilku pomiarów wyjściowych chroni przed regresją do średniej?
Częściowo. Średnia trzech odczytów z tej samej wizyty zmniejsza tylko błąd pojedynczego odczytu, a nie wahanie z dnia na dzień, więc w symulacji pozorny spadek zmalał z 7.16 do 5.59 mmHg. Najlepiej działa pomiar wyjściowy z osobnej wizyty, innej niż kwalifikacyjna: pozorna zmiana wyniosła wtedy −0.04 mmHg.
Dlaczego pacjenci z największym bólem poprawiają się najbardziej?
Częściowo dlatego, że trafili do badania w gorszym niż zwykle momencie. Ból, ciśnienie czy wynik skali wahają się z dnia na dzień, a osoby wybrane za skrajny wynik częściej złapały wahanie w górę. W kolejnym pomiarze wahanie losuje się od nowa, więc ich średnia wraca w stronę średniej populacji, a najsłabsze wyniki – rosną.
Jak opisać regresję do średniej w ograniczeniach pracy?
Napisz, według jakiego kryterium kwalifikowano osoby, że kwalifikacja na podstawie jednego pomiaru sprzyja regresji do średniej i jak ją ograniczono (grupa kontrolna, osobny pomiar wyjściowy, ANCOVA). Jeśli nie było grupy kontrolnej, podaj przybliżoną wielkość spodziewanej regresji z rzetelności test–retest i zaznacz, że to tylko szacunek.
Powiązane hasła
Przeczytaj też
Regresja do średniej – wizualizacja na obrazkach
Wynik prawdziwy i błąd, strzałki przed–po, chmura pomiarów w przód i wstecz, korelacja test–retest i 1000 badań kursu bez efektu – pięć rysunków z kodem R.
Czytaj →PoradnikNie da się połączyć pomiaru przed i po
Uczciwe łączenie kodów regułami ustalonymi z góry, analiza jak dla dwóch grup, utrata mocy, selektywne łączenie, kod R i gotowe zdania.
Czytaj →PoradnikBadanie bez grupy kontrolnej – jak wzmocnić plan
Sześć dodatków do planu jednej grupy, co każdy daje i czego nie rozwiązuje, symulacja w R i gotowe zdania do metody i ograniczeń.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikParadoks Lorda: ANCOVA czy wynik różnicowy?
Kiedy obie analizy badania przed–po się zgadzają, kiedy myli się każda z nich, regresja do średniej, graf przyczynowy i symulacja w R.
Czytaj →PoradnikRCI, MDC i MCID
SEM, MDC95, RCI i kryteria Jacobsona–Truaxa, MCID z kotwicy i metod rozkładowych, analiza responderów z 95% CI i koszt dychotomizacji – z kodem R.
Czytaj →Twoi pacjenci poprawili się, ale nie wiesz, ile to terapia?
Sprawdzimy schemat badania i kryteria kwalifikacji, policzymy analizę z pomiarem wyjściowym w R i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (1994). Statistics notes: Some examples of regression towards the mean. BMJ, 309(6957), 780. https://doi.org/10.1136/bmj.309.6957.780 ● Otwarty dostęp
- Clifton, L., & Clifton, D. A. (2019). The correlation between baseline score and post-intervention score, and its implications for statistical analysis. Trials, 20(1), Article 43. https://doi.org/10.1186/s13063-018-3108-3 ● Otwarty dostęp
- Linden, A. (2013). Assessing regression to the mean effects in health care initiatives. BMC Medical Research Methodology, 13(1), Article 119. https://doi.org/10.1186/1471-2288-13-119 ● Otwarty dostęp
- Morton, V., & Torgerson, D. J. (2003). Effect of regression to the mean on decision making in health care. BMJ, 326(7398), 1083–1084. https://doi.org/10.1136/bmj.326.7398.1083 ● Otwarty dostęp
- Senn, S. (2006). Change from baseline and analysis of covariance revisited. Statistics in Medicine, 25(24), 4334–4344. https://doi.org/10.1002/sim.2682
- Vickers, A. J., & Altman, D. G. (2001). Analysing controlled trials with baseline and follow up measurements. BMJ, 323(7321), 1123–1124. https://doi.org/10.1136/bmj.323.7321.1123 ● Otwarty dostęp
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{bland1994some, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: Some examples of regression towards the mean}}, journal={BMJ}, year={1994}, volume={309}, number={6957}, pages={780}, doi={10.1136/bmj.309.6957.780}}@article{clifton2019correlation, author={Clifton, Lei and Clifton, David A.}, title={{The correlation between baseline score and post-intervention score, and its implications for statistical analysis}}, journal={Trials}, year={2019}, volume={20}, number={1}, eid={43}, doi={10.1186/s13063-018-3108-3}}@article{linden2013assessing, author={Linden, Ariel}, title={{Assessing regression to the mean effects in health care initiatives}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={119}, doi={10.1186/1471-2288-13-119}}@article{morton2003effect, author={Morton, Veronica and Torgerson, David J.}, title={{Effect of regression to the mean on decision making in health care}}, journal={BMJ}, year={2003}, volume={326}, number={7398}, pages={1083--1084}, doi={10.1136/bmj.326.7398.1083}}@article{senn2006change, author={Senn, Stephen}, title={{Change from baseline and analysis of covariance revisited}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={24}, pages={4334--4344}, doi={10.1002/sim.2682}}@article{vickers2001analysing, author={Vickers, Andrew J. and Altman, Douglas G.}, title={{Analysing controlled trials with baseline and follow up measurements}}, journal={BMJ}, year={2001}, volume={323}, number={7321}, pages={1123--1124}, doi={10.1136/bmj.323.7321.1123}}