Dwa pliki, a pary się nie składają
Ankieta przed warsztatem i ta sama ankieta po nim. W pierwszym pliku 90 wierszy, w drugim 84, a kody tylko częściowo do siebie pasują: „an07 jo” zamiast „AN07JO”, imię ojca przed imieniem matki, jedna litera inna, kilka kodów zupełnie obcych. Albo gorzej: kodu w ogóle nie było, bo ankieta miała być w pełni anonimowa. To nie koniec badania, ale zmienia się to, co możesz policzyć i co wolno Ci napisać.
Jak zaprojektować kod, żeby do tego nie doszło, opisuje wpis o kodzie identyfikacyjnym w ankiecie anonimowej, a technikę złączania plików – wpis o łączeniu danych z kilku plików. Tu zaczynamy w chwili, gdy dane są już zebrane. Najpierw spróbujesz połączyć to, co się da, i zrobisz to uczciwie. Potem przeliczysz to, czego połączyć się nie da, a na koniec dowiesz się, ile to kosztuje i jak to opisać.
Przykład przewodni (fikcyjny, dane symulowane). Student mierzy lęk egzaminacyjny (10–50 punktów) przed czterotygodniowym warsztatem i po nim. Kod ma sześć znaków: dwie litery imienia matki, dzień urodzenia, dwie litery imienia ojca. W metryczce są płeć i rok urodzenia. Pomiar 1 wypełniło 90 osób, pomiar 2 – 84 osoby.
Najpierw ustal, który to przypadek
„Nie da się połączyć” obejmuje kilka różnych sytuacji. Od tego, która z nich jest Twoja, zależy cała dalsza droga.
| Sytuacja | Co zwykle da się odzyskać | Analiza |
|---|---|---|
| Brak kodu, ankieta w pełni anonimowa w tej samej grupie | Nic na poziomie osób. Nie odtwarzaj par z metryczki: to próba identyfikacji wbrew obietnicy z informacji dla uczestnika | Dwa pomiary jak dwie grupy; opis składu obu grup |
| Kody z błędami zapisu: wielkość liter, spacje, myślniki | Prawie wszystko, po ujednoliceniu zapisu | Test dla prób zależnych na parach |
| Kody z pomyłkami: literówka, zamieniona kolejność elementów | Większość, regułami ustalonymi z góry; część zostaje niepewna | Pary pewne w analizie głównej, niepewne w analizie wrażliwości |
| Kod zapomniany albo wymyślony od nowa | Zwykle nic. Zgadywanie po metryczce daje fałszywe pary | Osoba liczy się jako niepołączona |
| Część osób tylko w jednym pomiarze | Nic do odzyskania: to utrata uczestników albo nowi uczestnicy | Pary + porównanie połączonych z niepołączonymi + wrażliwość |
| Ten sam kod u dwóch osób | Często, jeśli metryczka je rozróżnia | Jak wyżej; bez rozróżnienia oba rekordy zostają niepołączone |
W prawdziwych danych zwykle występuje kilka sytuacji naraz. W badaniach terenowych kody tworzone przez uczestników łączyły się częściowo: McGloin i in. (1996) połączyli poprawnie 75.2% par, 22.1% zostało bez pary, a 2.7% połączono błędnie. Twoja sytuacja nie jest więc wyjątkiem i nie świadczy o złej pracy.
Uczciwe łączenie: reguły ustalone przed wynikami
Najważniejsza zasada brzmi: łączysz wyłącznie po kodzie i metryczce, a reguły zapisujesz, zanim spojrzysz na wyniki badanej zmiennej. Jeśli przy niepewnej parze wybierasz kandydata, „bo wynik pasuje”, dopasowanie zaczyna produkować zmianę, którą potem testujesz. To ta sama elastyczność decyzji, która według Simmonsa i in. (2011) może drastycznie podnieść odsetek fałszywie pozytywnych wyników. Szerzej o tym mechanizmie piszemy w haśle ogród rozwidlających się ścieżek.
W praktyce zrób to w czterech krokach.
- Odłóż kolumny z wynikami. Do łączenia potrzebujesz tylko identyfikatora rekordu, kodu i metryczki. Najprościej zapisać je w osobnej kopii pliku.
- Spisz reguły i ich kolejność. Od najpewniejszej do najmniej pewnej. Każdy rekord z pomiaru 1 może trafić do pary najwyżej raz.
- Zdecyduj z góry, co jest niepewne. Przypadki niepewne nie wchodzą do analizy głównej. Trafiają na osobną listę, a do analizy wrażliwości tylko wtedy, gdy przewiduje to plan.
- Prowadź dziennik decyzji. Jeden wiersz na rekord z pomiaru 2: reguła, para, uwagi. Wzór dziennika znajdziesz we wpisie o regułach kontroli danych i dzienniku zmian.
Reguły w przykładzie wyglądały tak:
Odległość Levenshteina to najmniejsza liczba wstawień, usunięć i zamian pojedynczych znaków, która zamienia jeden kod w drugi. W R liczy ją bazowa funkcja adist(). Schnell i in. (2010) pokazali, że łączenie kodów tą miarą zmniejsza straty przypadków w porównaniu z wcześniejszymi metodami. Ile tolerancji wybrać przy danej długości kodu i liczebności, symulacyjnie pokazuje wpis o kodzie identyfikacyjnym. Tu ważniejsze jest, że próg wybierasz przed patrzeniem na wynik, a nie dobierasz go po fakcie.
Co dało łączenie w przykładzie
| Reguła | Rekordy z pomiaru 2 | Uwagi |
|---|---|---|
| R1: ten sam kod po ujednoliceniu | 61 | w tym 6 dopiero po ujednoliceniu zapisu |
| R2: te same elementy, inna kolejność | 4 | imię ojca wpisane przed imieniem matki |
| R3: jeden znak różnicy | 7 | literówki przy zgodnej metryczce |
| Pary pewne razem | 72 | analiza główna |
| R4: niepewne | 6 | osobna lista z kandydatami |
| Brak pary | 6 | kod obcy lub osoba nowa |
W pomiarze 1 cztery kody miały po dwie osoby, ale w każdej parze różniła je płeć. Ponieważ dane są symulowane, można sprawdzić coś, czego w prawdziwym badaniu nie zobaczysz: wszystkie 72 pary pewne były prawdziwe. W obu pomiarach wzięło udział 78 osób, więc 6 z nich zostało bez pary. Z 6 przypadków niepewnych prawdziwa para znalazła się wśród kandydatów w 4, a 2 dotyczyły osób, których w pomiarze 1 w ogóle nie było. Gdyby trafiły do analizy głównej, dołożyłyby 2 fałszywe pary. Dlatego niepewne trzymasz osobno.
W prawdziwym badaniu taką kontrolę możesz zrobić częściowo: przejrzyj ręcznie pary z regułami R2 i R3 i porównaj pozostałe pola metryczki, jeśli są (np. kierunek, rok studiów). Nie patrz przy tym na wyniki lęku. Doidge i Harron (2019) opisują, że brakujące połączenia i fałszywe połączenia działają w analizie jak braki danych, błąd pomiaru i niereprezentatywny dobór, a w efekcie prowadzą do błędu informacji i błędu selekcji.
Gdy połączyć się nie da: dwa pomiary jak dwie grupy
Bez kodu albo przy kodach, z których nic nie zostało, możesz porównać pomiar 1 i pomiar 2 jak dwie niezależne grupy: testem Welcha albo, przy wynikach porządkowych lub silnie skośnych, testem Manna–Whitneya. Wybór testu sprawdzisz w kreatorze wyboru testu. Zmienia się jednak przede wszystkim interpretacja.
- Pytanie brzmi inaczej. Nie „o ile zmienił się lęk u uczestników”, tylko „czy średni lęk w grupie po warsztacie różnił się od średniego lęku przed nim”. O zmianie u osób nic nie wiesz: nie wiesz, u ilu osób lęk spadł, a u ilu wzrósł.
- Jeśli w obu pomiarach są dokładnie te same osoby, różnica średnich jest liczbowo równa średniej zmianie. Sam wynik jest więc w porządku, a problem dotyczy niepewności. Test Welcha zakłada niezależność, więc przy dodatniej korelacji pomiarów przed i po przedział ufności jest za szeroki, a test zbyt ostrożny. Mann–Whitney także zakłada dwie niezależne próby, więc to samo zastrzeżenie dotyczy i jego.
- Jeśli skład grup się różni (część osób odpadła, część doszła), różnica średnich miesza zmianę z tym, kto był obecny. Porównaj metryczkę obu pomiarów i opisz różnice.
- Tracisz analizy, które wymagają par: wielkość efektu dz, korelację przed–po, odsetek osób z poprawą, ANCOVA z pomiarem wyjściowym, wykresy zmian indywidualnych.
W przykładzie różnica między wszystkimi rekordami wyniosła −2.41 punktu (M = 29.74 przed i 27.33 po), test Welcha dał t(154.95) = −1.89, p = .060, 95% CI [−4.93, 0.10]. Na 72 parach pewnych średnia zmiana wyniosła −2.65 punktu, t(71) = −3.64, p < .001, 95% CI [−4.11, −1.20]. Oszacowania są bliskie, ale przedział z testu Welcha ma 5.03 punktu szerokości, a przedział z par 2.91 punktu, bo korelacja przed–po w parach wynosiła r = .76.
Ile kosztuje brak par: zależy od korelacji
Odchylenie standardowe różnic maleje wraz z korelacją pomiarów, więc test sparowany korzysta z tego, że ludzie zachowują swoje miejsce w grupie. Test dla grup niezależnych tego nie widzi. Symulacja: te same 50 osób, dwa pomiary (SD = 10), prawdziwa zmiana 3 punkty, czyli 0.3 SD, po 10 000 powtórzeń dla każdej korelacji. Parametry ustawiono ręcznie.
| Korelacja r | SD różnic | Moc: test sparowany | Moc: test Welcha | Fałszywe alarmy: test Welcha |
|---|---|---|---|---|
| 0 | 14.14 | 31.61% | 31.80% | 5.26% |
| .3 | 11.83 | 41.86% | 28.79% | 1.83% |
| .5 | 10.00 | 53.72% | 24.76% | 0.55% |
| .7 | 7.75 | 76.46% | 19.89% | 0.07% |
| .9 | 4.47 | 99.62% | 10.06% | 0.00% |
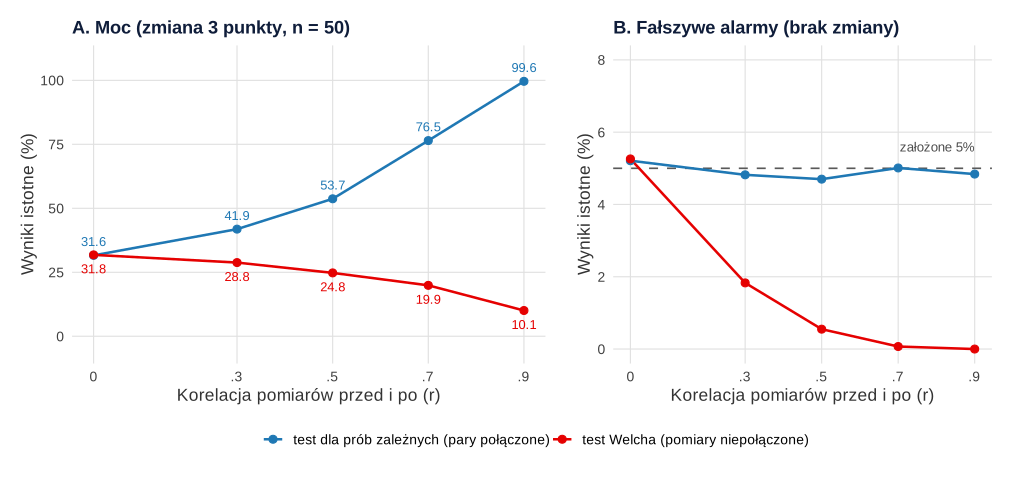
Przy r = 0 oba testy są praktycznie równoważne. Już przy r = .5 test sparowany ma ponad dwa razy większą moc (53.72% wobec 24.76%). Panel B pokazuje drugą stronę medalu: test Welcha na danych zależnych rzadziej daje fałszywe alarmy, niż zakłada α = .05, bo przeszacowuje błąd standardowy. Nie jest więc „mniej rygorystyczny”, tylko ślepy na część informacji. Żeby test dla grup naprawdę niezależnych miał 80% mocy przy tej zmianie, potrzeba 176 osób w każdej grupie. O mocy testu i o tym, co zrobić z mniejszą próbą, piszemy też we wpisie zebrano mniej osób, niż planowano.
Część par połączona: analiza główna, wrażliwość i porównanie
Najczęstszy układ to częściowe połączenie: część osób ma parę, część nie. Wtedy masz trzy zadania.
- Analiza główna na parach pewnych. Test sparowany, średnia zmiana z przedziałem ufności i dz. W przykładzie: n = 72, zmiana −2.65 (SD = 6.18), dz = −0.43.
- Analizy wrażliwości. Pierwsza: pary pewne plus niepewne (w przykładzie n = 78, zmiana −2.69, p < .001). Druga: wszystkie rekordy jak dwie grupy, czyli test Welcha z poprzedniej sekcji. Gdy wszystkie trzy wyniki wskazują ten sam kierunek i podobną wielkość, wniosek jest odporny na sposób łączenia. Gdy się rozjeżdżają, napisz to wprost. Ogólnie o takim sprawdzaniu: analiza wrażliwości.
- Porównanie połączonych z niepołączonymi w pomiarze 1. Czy osoby z parą różniły się na starcie od pozostałych? W przykładzie połączeni mieli średnio 30.40 punktu (n = 72), a niepołączeni 27.11 (n = 18). Różnica standaryzowana wynosi 0.46 SD, p = .084. To, że p > .05, nie oznacza braku różnicy: przy 18 osobach test ma małą moc, więc podaj samą różnicę i ją skomentuj.
Jest też rozwiązanie, które wykorzystuje wszystkie dane naraz. Derrick i in. (2017) opisują test t dla prób częściowo nakładających się, który zamiast odrzucać pojedyncze obserwacje łączy informację z par i z rekordów bez pary; artykuł podaje przykład i pakiet R. Inna droga to model mieszany w formacie długim, w którym osoba z jednym pomiarem nadal wnosi informację. Metody największej wiarygodności i imputacja wielokrotna wykorzystują częściowe dane (Graham, 2009), a porównanie z klasyczną analizą znajdziesz we wpisie ANOVA z powtarzanymi pomiarami czy model mieszany. W pracy dyplomowej takie podejście zwykle wymaga zgody promotora, a także w nim pary muszą pochodzić z reguł ustalonych z góry.
Kiedy podzbiór połączonych zniekształca wynik
Kod poprawnie wpisują raczej osoby uważne i zaangażowane. Jeśli te same osoby więcej zyskują na programie, pary pewne pokażą większą poprawę niż w całej grupie. Grube i in. (1989) stwierdzili, że uczniowie niepołączeni różnili się od połączonych dokładnie (m.in. słabszą więzią ze szkołą i częstszym używaniem substancji), choć różnice były małe, a współczynniki regresji podobne. Harron i in. (2017) zaliczają obciążenie wynikające z rekordów niepołączonych lub połączonych błędnie do głównych wyzwań przy łączeniu danych.
Symulacja (parametry fikcyjne, ustawione ręcznie): 150 osób, wszystkie obecne w obu pomiarach, prawdziwa średnia zmiana lęku −2.00 punktu. Bardziej zaangażowani zyskują więcej, a szansa połączenia kodu rośnie z zaangażowaniem. Łącznie łączy się 66.0% osób. Dla porównania wariant, w którym 70.0% osób łączy się niezależnie od zaangażowania.
| Analiza | Łączenie losowe | Łączenie selektywne |
|---|---|---|
| Średnia zmiana: pary połączone | −2.00 | −2.64 (obciążenie −0.64) |
| Różnica średnich: wszystkie rekordy | −2.00 | −2.00 |
| SD oszacowań: pary / wszystkie rekordy | 0.43 / 0.37 | 0.45 / 0.37 |
| Połączeni a niepołączeni w pomiarze 1: różnica | 0.01 | −0.94 |
| Ta różnica istotna (p < .05) | 5.2% badań | 12.9% badań |
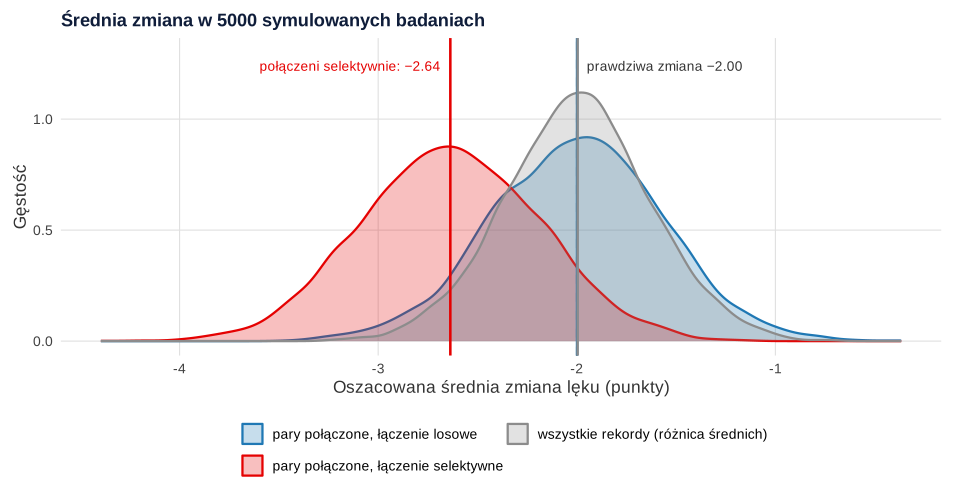
Trzy wnioski. Po pierwsze, przy łączeniu selektywnym pary pewne przeszacowały spadek lęku o 0.64 punktu, czyli o blisko jedną trzecią prawdziwego efektu. Po drugie, różnica średnich wszystkich rekordów nie była obciążona, bo w tej symulacji wszyscy byli obecni w obu pomiarach i gubiło się tylko połączenie. Jej słabością jest szeroki przedział z poprzedniej sekcji, a nie przesunięcie. Po trzecie, porównanie połączonych z niepołączonymi w pomiarze 1 wykryło problem tylko w 12.9% badań. Takie porównanie trzeba zrobić, ale wynik nieistotny nie dowodzi, że podzbiór jest reprezentatywny. Dlatego analiza wrażliwości na wszystkich rekordach to nie ozdoba, tylko jedyna kontrola kierunku obciążenia, jaką masz. Podobny mechanizm dotyczy wycofań po zebraniu danych, a osobnym zjawiskiem, które także zawyża poprawę w badaniu przed–po, jest regresja do średniej.
Gotowe zdania do Metody, Wyników i Ograniczeń
Wytyczne GUILD (Gilbert i in., 2018) zwracają uwagę, że czytelnik połączonych danych potrzebuje informacji o samym procesie łączenia, inaczej nie oceni możliwego obciążenia. W pracy dyplomowej wystarczy kilka liczb i jedno zdanie o regułach. Liczby wpisz też do diagramu przepływu.
Metoda – łączenie pomiarów:
Metoda – brak kodu:
Wyniki:
Ograniczenia:
Liczby w zdaniach pochodzą z fikcyjnego przykładu; podstaw własne. Jak włączyć to do całego rozdziału, opisują wpisy o badaniu przed i po i o ograniczeniach badania.
Wiadomość do promotora
Napisz, zanim policzysz cokolwiek na wynikach. Wtedy reguły łączenia i plan analizy są ustalone wspólnie, a nie dopasowane do tego, co wyszło.
Jeśli wyniki już znasz, napisz to wprost. Uczciwiej jest przyznać, że reguły powstały po pierwszym podejrzeniu wyników, i pokazać wszystkie warianty, niż udawać, że plan był wcześniej.
Najczęstsze błędy
- Dopasowywanie po wynikach. „Ten kandydat ma podobny wynik, więc to pewnie ta osoba” sztucznie tworzy korelację i zmianę.
- Zmiana reguły po zobaczeniu efektu. Tolerancja jednego znaku, potem dwóch, „bo wtedy wychodzi istotnie”, to p-hacking.
- Niepewne pary w analizie głównej. W przykładzie 2 z 6 byłyby fałszywe.
- Test sparowany na „parach” z pozycji w pliku. Wiersz 15 w obu plikach to nie ta sama osoba, nawet jeśli plików jest tyle samo.
- Odtwarzanie par w ankiecie anonimowej po metryczce. To identyfikowanie osób wbrew obietnicy, a przy tym przy kilku osobach o tym samym roku i płci zgadywanie.
- Opisywanie testu Welcha jako „zmiany u uczestników”. Wynik dotyczy średnich grupy w dwóch pomiarach.
- Analiza tylko na parach, bez słowa o niepołączonych. Brakuje wtedy liczby, porównania i analizy wrażliwości, a podzbiór może być selektywny.
- Ręczne poprawianie kodów w pliku surowym. Poprawki rób skryptem i zapisuj w dzienniku. Plik surowy zostaje nietknięty; patrz też co sprawdzić, gdy wynik wygląda podejrzanie.
Łączenie kodów, moc i selektywne łączenie w R
Trzy przepisy liczą wszystkie liczby z tabel i tekstu; rysunki powstały w osobnym skrypcie. Ziaren nie wybierano pod wynik. Ręcznie ustawiono: liczebności (90 i 84 rekordy; 50 i 150 osób), liczby błędów w kodach, zmianę o 3 punkty przy SD = 10, siłę związku zaangażowania ze zmianą (−2 punkty na 1 SD) i z szansą połączenia (1.2 w skali logitu) oraz odsetek połączeń 70%. Pobierz fikcyjny plik z obu pomiarów w CSV (174 wiersze: kod, płeć, rok urodzenia, wynik).
Reguły dopasowania z adist(), analiza główna i wrażliwość
R
# Kody z błędami: dopasowanie pomiaru przed i po regułami ustalonymi z góry.
# Dane, kody i wyniki są w całości fikcyjne.
set.seed(527)

# 1. Fikcyjne badanie: 90 osób w pomiarze 1, 78 z nich wraca, 6 nowych w pomiarze 2
imiona <- c("AN","BA","EW","GR","HA","JO","KA","MA","MO","TE","UR","ZO")
n1 <- 90
osoby <- data.frame(
  osoba = sprintf("P%03d", 1:n1),          # prawdziwa tożsamość: znana tylko w symulacji
  kod = paste0(sample(imiona, n1, TRUE), sprintf("%02d", sample(1:28, n1, TRUE)),
               sample(imiona, n1, TRUE)),  # imię matki, dzień urodzenia, imię ojca
  plec = sample(c("K", "M"), n1, TRUE, prob = c(.7, .3)),
  rok = sample(1999:2006, n1, TRUE))
osoby$kod[2] <- osoby$kod[1]; osoby$plec[1:2] <- c("K", "M")   # dwie osoby z tym samym kodem
osoby$przed <- round(pmin(pmax(rnorm(n1, 30, 7), 10), 50))     # lęk egzaminacyjny 10-50
osoby$po <- round(pmin(pmax(osoby$przed - 2.5 + rnorm(n1, 0, 5.5), 10), 50))

wraca <- sort(c(1:2, sample(3:n1, 76)))
t1 <- data.frame(rekord = sprintf("A%03d", 1:n1), osoba = osoby$osoba, kod = osoby$kod,
                 plec = osoby$plec, rok = osoby$rok, wynik = osoby$przed)
t2 <- data.frame(osoba = osoby$osoba[wraca], kod = osoby$kod[wraca], plec = osoby$plec[wraca],
                 rok = osoby$rok[wraca], wynik = osoby$po[wraca])

# Błędy przy ponownym wpisaniu kodu (liczby ustawione ręcznie)
zmien <- sample(3:nrow(t2))
male  <- zmien[1:6];   kolej <- zmien[7:10]; lit1 <- zmien[11:17]
lit2  <- zmien[18:20]; inny  <- zmien[21:22]; metr <- zmien[23]
podmien <- function(k, ile) {
  for (i in sample(c(1, 2, 5, 6), ile)) substr(k, i, i) <- sample(setdiff(LETTERS, substr(k, i, i)), 1)
  k
}
t2$kod[male]  <- sub("^(..)(..)", "\\1 \\2", tolower(t2$kod[male]))   # "an07 jo"
t2$kod[kolej] <- paste0(substr(t2$kod[kolej], 5, 6), substr(t2$kod[kolej], 3, 4),
                        substr(t2$kod[kolej], 1, 2))                   # matka i ojciec zamienieni
t2$kod[lit1]  <- sapply(t2$kod[lit1], podmien, ile = 1)
t2$kod[lit2]  <- sapply(t2$kod[lit2], podmien, ile = 2)
t2$kod[inny]  <- paste0(sample(imiona, 2), sprintf("%02d", sample(1:28, 2)), sample(imiona, 2))
t2$kod[metr]  <- podmien(t2$kod[metr], 1); t2$rok[metr] <- t2$rok[metr] + 1
nowi <- data.frame(osoba = sprintf("N%02d", 1:6),
                   kod = paste0(sample(imiona, 6, TRUE), sprintf("%02d", sample(1:28, 6, TRUE)),
                                sample(imiona, 6, TRUE)),
                   plec = sample(c("K", "M"), 6, TRUE), rok = sample(1999:2006, 6, TRUE),
                   wynik = round(rnorm(6, 28, 7)))
t2 <- rbind(t2, nowi)
t2 <- t2[sample(nrow(t2)), ]
t2$rekord <- sprintf("B%03d", seq_len(nrow(t2)))
prawda1 <- t1[, c("rekord", "osoba")]; prawda2 <- t2[, c("rekord", "osoba")]
t1$osoba <- NULL; t2$osoba <- NULL          # w prawdziwym badaniu tej kolumny nie ma
plik <- rbind(cbind(pomiar = 1, t1), cbind(pomiar = 2, t2[, names(t1)]))
write.csv(plik, "kody-przed-po-fikcyjne.csv", row.names = FALSE)

# 2. Reguły zapisane przed otwarciem wyników: używają tylko kodu i metryczki
d <- read.csv("kody-przed-po-fikcyjne.csv")
a <- d[d$pomiar == 1, ]; b <- d[d$pomiar == 2, ]
norm <- function(k) gsub("[^A-Z0-9]", "", toupper(k))
a$kn <- norm(a$kod); b$kn <- norm(b$kod)
bloki <- function(k) paste(sort(c(substr(k, 1, 2), substr(k, 3, 4), substr(k, 5, 6))), collapse = "")
odl <- adist(b$kn, a$kn)                          # odległość Levenshteina: wiersze b, kolumny a
metr_ok <- outer(b$plec, a$plec, "==") & outer(b$rok, a$rok, "==")
blok_ok <- outer(sapply(b$kn, bloki), sapply(a$kn, bloki), "==")

b$para <- NA; b$regula <- "brak pary"; b$kand <- NA
wolne <- rep(TRUE, nrow(a))
przypisz <- function(warunek, nazwa) {
  for (i in which(is.na(b$para))) {
    kand <- which(warunek[i, ] & wolne)
    if (length(kand) == 1) { b$para[i] <<- a$rekord[kand]; b$regula[i] <<- nazwa; wolne[kand] <<- FALSE }
  }
}
przypisz(odl == 0 & metr_ok, "R1 ten sam kod po ujednoliceniu")
przypisz(blok_ok & metr_ok, "R2 te same elementy, inna kolejność")
przypisz(odl == 1 & metr_ok, "R3 jeden znak różnicy")
# R4: kandydat niepewny - do osobnej listy, nie do analizy głównej
for (i in which(is.na(b$para))) {
  kand <- which((odl[i, ] <= 2 | blok_ok[i, ]) & wolne)
  if (length(kand) >= 1) { b$regula[i] <- "R4 niepewne (2 znaki lub metryczka)"
                           b$kand[i] <- paste(a$rekord[kand], collapse = ";") }
}
cat("Rekordy: pomiar 1 =", nrow(a), " pomiar 2 =", nrow(b),
    " kody powtórzone w pomiarze 1:", sum(duplicated(a$kn)), "\n\n")
print(as.data.frame(table(regula = b$regula)), row.names = FALSE)
cat("R1 dopiero po ujednoliceniu zapisu:", sum(b$kod != b$kn & grepl("^R1", b$regula)), "\n")
# Dziennik decyzji: przypadki niepewne zostają osobno, z listą kandydatów
print(b[b$regula == "R4 niepewne (2 znaki lub metryczka)", c("rekord", "kod", "kand")], row.names = FALSE)

# 3. Tylko w symulacji: czy połączenia są prawdziwe?
b$prawda <- prawda1$rekord[match(prawda2$osoba[match(b$rekord, prawda2$rekord)], prawda1$osoba)]
pewne <- !is.na(b$para)
cat("\nPołączenia pewne:", sum(pewne), " w tym błędne:", sum(b$para[pewne] != b$prawda[pewne]), "\n")
cat("Osoby obecne w obu pomiarach:", sum(!is.na(b$prawda)),
    " niepołączone mimo obecności:", sum(!pewne & !is.na(b$prawda)), "\n")
ni <- b$regula == "R4 niepewne (2 znaki lub metryczka)"
cat("Niepewne:", sum(ni), " z prawdziwą parą wśród kandydatów:",
    sum(mapply(function(k, p) !is.na(p) && p %in% strsplit(k, ";")[[1]], b$kand[ni], b$prawda[ni])), "\n")

# 4. Dopiero teraz wyniki: analiza główna, wrażliwość, porównanie połączonych
p_apa <- function(p) if (p < .001) "< .001" else paste("=", sub("^0", "", formatC(p, format = "f", digits = 3)))
pary <- merge(a[, c("rekord", "wynik")], b[pewne, c("para", "wynik")],
              by.x = "rekord", by.y = "para", suffixes = c("_przed", "_po"))
zm <- pary$wynik_po - pary$wynik_przed
tz <- t.test(pary$wynik_po, pary$wynik_przed, paired = TRUE)
cat("\nAnaliza główna (pary pewne): n =", nrow(pary), " zmiana =", round(mean(zm), 2),
    " SD zmiany =", round(sd(zm), 2), " r przed-po =", round(cor(pary$wynik_przed, pary$wynik_po), 2), "\n")
cat("t(", tz$parameter, ") =", round(tz$statistic, 2), " p", p_apa(tz$p.value),
    " 95% CI [", round(tz$conf.int[1], 2), ",", round(tz$conf.int[2], 2), "]  d_z =",
    round(mean(zm) / sd(zm), 2), "\n")

kand1 <- sapply(strsplit(b$kand[ni], ";"), `[`, 1)   # pierwszy kandydat niepewny
pary2 <- rbind(pary, data.frame(rekord = kand1, wynik_przed = a$wynik[match(kand1, a$rekord)],
                                wynik_po = b$wynik[ni]))
t2z <- t.test(pary2$wynik_po, pary2$wynik_przed, paired = TRUE)
cat("Wrażliwość (pewne + niepewne): n =", nrow(pary2), " zmiana =",
    round(mean(pary2$wynik_po - pary2$wynik_przed), 2), " p", p_apa(t2z$p.value), "\n")

tw <- t.test(b$wynik, a$wynik)                       # wszystkie rekordy, grupy niezależne
cat("Wszystkie rekordy, Welch: M po =", round(mean(b$wynik), 2), " M przed =", round(mean(a$wynik), 2),
    " różnica =", round(mean(b$wynik) - mean(a$wynik), 2), "\n")
cat("t(", round(tw$parameter, 2), ") =", round(tw$statistic, 2), " p", p_apa(tw$p.value),
    " 95% CI [", round(tw$conf.int[1], 2), ",", round(tw$conf.int[2], 2), "]\n")

a$polaczony <- a$rekord %in% b$para
tp <- t.test(wynik ~ polaczony, data = a)
cat("\nPomiar 1: połączeni M =", round(mean(a$wynik[a$polaczony]), 2), " (n =", sum(a$polaczony),
    "), niepołączeni M =", round(mean(a$wynik[!a$polaczony]), 2), " (n =", sum(!a$polaczony), ")\n")
cat("Różnica standaryzowana =", round((mean(a$wynik[a$polaczony]) - mean(a$wynik[!a$polaczony])) / sd(a$wynik), 2),
    " p", p_apa(tp$p.value), "\n")
Wynik
Rekordy: pomiar 1 = 90  pomiar 2 = 84  kody powtórzone w pomiarze 1: 4

                              regula Freq
                           brak pary    6
     R1 ten sam kod po ujednoliceniu   61
 R2 te same elementy, inna kolejność    4
               R3 jeden znak różnicy    7
 R4 niepewne (2 znaki lub metryczka)    6
R1 dopiero po ujednoliceniu zapisu: 6
 rekord    kod kand
   B001 TE13ZO A065
   B025 EW17UT A087
   B033 MO18JO A037
   B034 BN08TC A056
   B068 AN22PW A071
   B073 RO13PA A063

Połączenia pewne: 72  w tym błędne: 0
Osoby obecne w obu pomiarach: 78  niepołączone mimo obecności: 6
Niepewne: 6  z prawdziwą parą wśród kandydatów: 4

Analiza główna (pary pewne): n = 72  zmiana = -2.65  SD zmiany = 6.18  r przed-po = 0.76
t( 71 ) = -3.64  p < .001  95% CI [ -4.11 , -1.2 ]  d_z = -0.43
Wrażliwość (pewne + niepewne): n = 78  zmiana = -2.69  p < .001
Wszystkie rekordy, Welch: M po = 27.33  M przed = 29.74  różnica = -2.41
t( 154.95 ) = -1.89  p = .060  95% CI [ -4.93 , 0.1 ]

Pomiar 1: połączeni M = 30.4  (n = 72 ), niepołączeni M = 27.11  (n = 18 )
Różnica standaryzowana = 0.46  p = .084
Moc: test sparowany a test Welcha przy różnej korelacji
R
# Ile mocy traci się, gdy pomiarów nie da się połączyć?
# Te same 50 osób, dwa pomiary; analiza sparowana albo jak dla grup niezależnych.
# Parametry są fikcyjne: zmiana 3 punkty, SD = 10 w każdym pomiarze.
set.seed(5272)
B <- 10000; n <- 50; sd_y <- 10; zmiana <- 3
korelacje <- c(0, .3, .5, .7, .9)

jedno <- function(r, delta) {
  przed <- rnorm(n, 30, sd_y)
  po <- 30 + delta + r * (przed - 30) + rnorm(n, 0, sd_y * sqrt(1 - r^2))
  roz <- po - przed
  t_spar <- mean(roz) / (sd(roz) / sqrt(n))                      # test t dla prób zależnych
  se2 <- var(po) / n + var(przed) / n                             # Welch: grupy niezależne
  t_w <- (mean(po) - mean(przed)) / sqrt(se2)
  df_w <- se2^2 / ((var(po) / n)^2 / (n - 1) + (var(przed) / n)^2 / (n - 1))
  c(sparowany = 2 * pt(-abs(t_spar), n - 1) < .05,
    niezalezny = 2 * pt(-abs(t_w), df_w) < .05)
}

wyniki <- do.call(rbind, lapply(korelacje, function(r) {
  h1 <- rowMeans(replicate(B, jedno(r, zmiana)))
  h0 <- rowMeans(replicate(B, jedno(r, 0)))
  data.frame(r = r, moc_sparowany = 100 * h1[["sparowany"]],
             moc_niezalezny = 100 * h1[["niezalezny"]],
             alfa_sparowany = 100 * h0[["sparowany"]],
             alfa_niezalezny = 100 * h0[["niezalezny"]],
             SD_roznic = sd_y * sqrt(2 * (1 - r)),
             d_z = zmiana / (sd_y * sqrt(2 * (1 - r))))
}))
print(round(wyniki, 2), row.names = FALSE)

# Sprawdzenie wzorem: moc testu sparowanego z power.t.test()
cat("\nMoc z wzoru (test sparowany):",
    round(100 * sapply(korelacje, function(r)
      power.t.test(n = n, delta = zmiana, sd = sd_y * sqrt(2 * (1 - r)),
                   type = "paired")$power), 2), "\n")
# Ile osób w każdym pomiarze potrzebuje test dla grup niezależnych, by mieć 80% mocy?
cat("Grupy niezależne, moc 80%: n =", ceiling(power.t.test(delta = zmiana, sd = sd_y, power = .8)$n),
    "na pomiar\n")
Wynik
   r moc_sparowany moc_niezalezny alfa_sparowany alfa_niezalezny SD_roznic  d_z
 0.0         31.61          31.80           5.21            5.26     14.14 0.21
 0.3         41.86          28.79           4.82            1.83     11.83 0.25
 0.5         53.72          24.76           4.70            0.55     10.00 0.30
 0.7         76.46          19.89           5.01            0.07      7.75 0.39
 0.9         99.62          10.06           4.84            0.00      4.47 0.67

Moc z wzoru (test sparowany): 31.23 41.99 54.76 76.57 99.64
Grupy niezależne, moc 80%: n = 176 na pomiar
Selektywne łączenie: obciążenie zmiany na parach
R
# Selektywne łączenie: kody poprawnie wpisują częściej osoby bardziej zaangażowane.
# Parametry są fikcyjne; wszyscy są obecni w obu pomiarach, gubi się tylko połączenie.
set.seed(5273)
B <- 5000; n <- 150

jedno <- function(selektywne) {
  zaang <- rnorm(n)                                   # zaangażowanie (niezmierzone)
  przed <- 30 - 1 * zaang + rnorm(n, 0, 6.5)          # lęk przed: lekko związany z zaangażowaniem
  zmiana <- -2 - 2 * zaang + rnorm(n, 0, 4)           # zaangażowani zyskują więcej
  po <- przed + zmiana
  logit <- qlogis(.70) + if (selektywne) 1.2 * zaang else 0
  pol <- runif(n) < plogis(logit)                     # czy kod udało się połączyć
  c(prawdziwa = mean(zmiana),
    polaczeni = mean(zmiana[pol]),
    wszyscy_welch = mean(po) - mean(przed),
    odsetek_pol = 100 * mean(pol),
    roznica_T1 = mean(przed[pol]) - mean(przed[!pol]),
    T1_istotna = t.test(przed[pol], przed[!pol])$p.value < .05)
}

f <- function(x, d = 2) formatC(round(x, d) + 0, format = "f", digits = d)
for (s in c(FALSE, TRUE)) {
  w <- replicate(B, jedno(s))
  cat(if (s) "\nŁączenie selektywne" else "Łączenie niezależne od zaangażowania", "\n")
  m <- rowMeans(w)
  cat("  odsetek połączonych:", f(m[["odsetek_pol"]], 1), "%\n")
  cat("  prawdziwa średnia zmiana (wszyscy):", f(m[["prawdziwa"]], 2), "\n")
  cat("  średnia zmiana u połączonych:", f(m[["polaczeni"]], 2),
      " obciążenie:", f(m[["polaczeni"]] - m[["prawdziwa"]], 2), "\n")
  cat("  różnica średnich wszystkich rekordów (Welch):", f(m[["wszyscy_welch"]], 2),
      " obciążenie:", f(m[["wszyscy_welch"]] - m[["prawdziwa"]], 2), "\n")
  cat("  SD oszacowań: połączeni", f(sd(w["polaczeni", ]), 2),
      " wszyscy", f(sd(w["wszyscy_welch", ]), 2), "\n")
  cat("  różnica w T1 połączeni - niepołączeni:", f(m[["roznica_T1"]], 2),
      " istotna w", f(100 * m[["T1_istotna"]], 1), "% badań\n")
  if (s) wyniki_sel <- w else wyniki_los <- w
}
Wynik
Łączenie niezależne od zaangażowania
  odsetek połączonych: 70.0 %
  prawdziwa średnia zmiana (wszyscy): -2.00
  średnia zmiana u połączonych: -2.00  obciążenie: 0.00
  różnica średnich wszystkich rekordów (Welch): -2.00  obciążenie: 0.00
  SD oszacowań: połączeni 0.43  wszyscy 0.37
  różnica w T1 połączeni - niepołączeni: 0.01  istotna w 5.2 % badań

Łączenie selektywne
  odsetek połączonych: 66.0 %
  prawdziwa średnia zmiana (wszyscy): -2.00
  średnia zmiana u połączonych: -2.64  obciążenie: -0.64
  różnica średnich wszystkich rekordów (Welch): -2.00  obciążenie: 0.00
  SD oszacowań: połączeni 0.45  wszyscy 0.37
  różnica w T1 połączeni - niepołączeni: -0.94  istotna w 12.9 % badań
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe, w tym adist() z pakietu utils i t.test() oraz power.t.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim policzysz zmianę, sprawdź
- Czy wiesz, który to przypadek: brak kodu, błędy zapisu, pomyłki, osoby tylko w jednym pomiarze?
- Czy reguły łączenia są spisane, uporządkowane i datowane przed otwarciem wyników?
- Czy łączysz tylko po kodzie i metryczce, a kolumny wyników są odłożone?
- Czy każdy rekord z pomiaru 1 trafia do pary najwyżej raz, a powtórzone kody rozstrzyga metryczka?
- Czy przypadki niepewne są na osobnej liście i poza analizą główną?
- Czy dziennik zawiera regułę dla każdego rekordu z pomiaru 2?
- Czy masz liczby: rekordy w każdym pomiarze, pary pewne, niepewne, bez pary?
- Czy porównałeś(-aś) połączonych z niepołączonymi w pomiarze 1 i podałeś(-aś) wielkość różnicy, a nie tylko p?
- Czy policzyłeś(-aś) analizę wrażliwości na wszystkich rekordach i z parami niepewnymi?
- Czy przy teście Welcha piszesz o różnicy średnich grupy, a nie o zmianie u osób?
- Czy promotor zna reguły i plan, zanim zobaczył wyniki?
Najczęstsze pytania
Co zrobić, gdy kody z ankiety przed i po się nie zgadzają?
Ujednolić zapis (wielkie litery, bez spacji), a potem łączyć regułami opartymi tylko na kodzie i metryczce, np. ta sama kolejność elementów po zamianie albo jeden znak różnicy przy zgodnej płci i roku urodzenia. Reguły zapisz przed otwarciem wyników, przypadki niepewne trzymaj osobno, a każdą decyzję wpisz do dziennika.
Czy mogę użyć testu dla prób niezależnych, jeśli to te same osoby?
Tak, gdy nie da się ustalić par, ale to rozwiązanie awaryjne. Test Welcha porówna średnie dwóch pomiarów, a wynik opiszesz jako różnicę między pomiarami w grupie, a nie zmianę u osób. Przy dodatniej korelacji pomiarów test jest zachowawczy: przedział jest za szeroki, a moc niższa niż w teście sparowanym.
Ile mocy tracę, gdy nie połączę pomiarów?
Zależy od korelacji przed–po. W symulacji dla 50 osób i zmiany o 0.3 SD moc testu sparowanego rosła od 31.6% przy r = 0 do 99.6% przy r = .9, a moc testu Welcha spadała od 31.8% do 10.1%. Im stabilniejsza cecha, tym więcej tracisz.
Czy mogę dopasować osoby po podobnych wynikach?
Nie. Wynik badanej zmiennej nie może być kryterium łączenia, bo wtedy dopasowanie tworzy korelację i zmianę, które potem testujesz. Łącz wyłącznie po kodzie i metryczce, z regułami spisanymi przed analizą.
Jak opisać w pracy, że części osób nie udało się połączyć?
Podaj liczbę rekordów w każdym pomiarze, liczbę par według reguł, liczbę przypadków niepewnych i niepołączonych. Dodaj porównanie połączonych z niepołączonymi w pierwszym pomiarze i analizę wrażliwości na wszystkich rekordach, a w ograniczeniach napisz, że podzbiór połączonych może być selektywny.
Powiązane hasła
Przeczytaj też
Kod identyfikacyjny w ankiecie anonimowej
Jak zbudować kod respondenta, ile osób ma taki sam, dopasowanie z odległością Levenshteina, fałszywe pary i RODO – z symulacją w R.
Czytaj →PoradnikŁączenie danych z kilku plików ankiety
Arkusze od oddziałów, pomiar przed i po, dokumentacja: ujednolicenie kodów, krotność złączeń i kontrola liczby wierszy w R i SPSS.
Czytaj →PoradnikBadanie przed i po – opis metody i wnioski
Gotowy podrozdział „Metoda” dla jednej grupy i grupy nierandomizowanej, symulacja regresji do średniej i zdania, które wolno napisać we wnioskach.
Czytaj →Pomiary przed i po się nie łączą, a termin się zbliża?
Pomożemy ustalić reguły łączenia, policzymy analizę główną i wrażliwości w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Derrick, B., Toher, D., & White, P. (2017). How to compare the means of two samples that include paired observations and independent observations: A companion to Derrick, Russ, Toher and White (2017). The Quantitative Methods for Psychology, 13(2), 120–126. https://doi.org/10.20982/tqmp.13.2.p120 ● Otwarty dostęp: pełny tekst
- Doidge, J. C., & Harron, K. L. (2019). Reflections on modern methods: Linkage error bias. International Journal of Epidemiology, 48(6), Article dyz203. https://doi.org/10.1093/ije/dyz203 ● Otwarty dostęp
- Gilbert, R., Lafferty, R., Hagger-Johnson, G., Harron, K., Zhang, L.-C., Smith, P., Dibben, C., & Goldstein, H. (2018). GUILD: GUidance for Information about Linking Data sets. Journal of Public Health, 40(1), 191–198. https://doi.org/10.1093/pubmed/fdx037 ● Otwarty dostęp
- Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60(1), 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
- Grube, J. W., Morgan, M., & Kearney, K. A. (1989). Using self-generated identification codes to match questionnaires in panel studies of adolescent substance use. Addictive Behaviors, 14(2), 159–171. https://doi.org/10.1016/0306-4603(89)90044-0
- Harron, K., Dibben, C., Boyd, J., Hjern, A., Azimaee, M., Barreto, M. L., & Goldstein, H. (2017). Challenges in administrative data linkage for research. Big Data & Society, 4(2), Article 2053951717745678. https://doi.org/10.1177/2053951717745678 ● Otwarty dostęp
- McGloin, J., Holcomb, S., & Main, D. S. (1996). Matching anonymous pre-posttests using subject-generated information. Evaluation Review, 20(6), 724–736. https://doi.org/10.1177/0193841x9602000604
- Schnell, R., Bachteler, T., & Reiher, J. (2010). Improving the use of self-generated identification codes. Evaluation Review, 34(5), 391–418. https://doi.org/10.1177/0193841x10387576
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Cytowania BibTeX
@article{derrick2017how, author={Derrick, Ben and Toher, Deirdre and White, Paul}, title={{How to compare the means of two samples that include paired observations and independent observations: A companion to Derrick, Russ, Toher and White (2017)}}, journal={The Quantitative Methods for Psychology}, year={2017}, volume={13}, number={2}, pages={120--126}, doi={10.20982/tqmp.13.2.p120}}@article{doidge2019reflections, author={Doidge, James C. and Harron, Katie L.}, title={{Reflections on modern methods: Linkage error bias}}, journal={International Journal of Epidemiology}, year={2019}, volume={48}, number={6}, eid={dyz203}, doi={10.1093/ije/dyz203}}@article{gilbert2018guild, author={Gilbert, Ruth and Lafferty, Rosemary and Hagger-Johnson, Gareth and Harron, Katie and Zhang, Li-Chun and Smith, Peter and Dibben, Chris and Goldstein, Harvey}, title={{GUILD: GUidance for Information about Linking Data sets}}, journal={Journal of Public Health}, year={2018}, volume={40}, number={1}, pages={191--198}, doi={10.1093/pubmed/fdx037}}@article{graham2009missing, author={Graham, John W.}, title={{Missing data analysis: Making it work in the real world}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={549--576}, doi={10.1146/annurev.psych.58.110405.085530}}@article{grube1989using, author={Grube, Joel W. and Morgan, Mark and Kearney, Kathleen A.}, title={{Using self-generated identification codes to match questionnaires in panel studies of adolescent substance use}}, journal={Addictive Behaviors}, year={1989}, volume={14}, number={2}, pages={159--171}, doi={10.1016/0306-4603(89)90044-0}}@article{harron2017challenges, author={Harron, Katie and Dibben, Chris and Boyd, James and Hjern, Anders and Azimaee, Mahmoud and Barreto, Mauricio L. and Goldstein, Harvey}, title={{Challenges in administrative data linkage for research}}, journal={Big Data \& Society}, year={2017}, volume={4}, number={2}, eid={2053951717745678}, doi={10.1177/2053951717745678}}@article{mcgloin1996matching, author={McGloin, Joe and Holcomb, Sherry and Main, Deborah S.}, title={{Matching anonymous pre-posttests using subject-generated information}}, journal={Evaluation Review}, year={1996}, volume={20}, number={6}, pages={724--736}, doi={10.1177/0193841x9602000604}}@article{schnell2010improving, author={Schnell, Rainer and Bachteler, Tobias and Reiher, Jörg}, title={{Improving the use of self-generated identification codes}}, journal={Evaluation Review}, year={2010}, volume={34}, number={5}, pages={391--418}, doi={10.1177/0193841x10387576}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}