Dwa podejścia do tych samych danych
Masz dwie grupy – na przykład interwencję i listę oczekujących – oraz cztery pomiary tej samej zmiennej. Klasyczny wybór to ANOVA z powtarzanymi pomiarami w schemacie mieszanym: czynnik międzyobiektowy „grupa” i czynnik wewnątrzobiektowy „czas”. Recenzent coraz częściej pyta jednak, dlaczego nie liniowy model mieszany (ang. linear mixed model, LMM). Oba podejścia odpowiadają na to samo pytanie – czy zmiana w czasie zależy od grupy – ale inaczej traktują korelację pomiarów tej samej osoby i osoby, którym brakuje pomiarów.
Gueorguieva i Krystal (2004) przejrzeli artykuły z czasopisma psychiatrycznego z lat 1989–2001. ANOVA z powtarzanymi pomiarami wciąż była szeroko stosowana mimo ryzyka błędnej interpretacji, a autorzy wskazali przewagi modeli mieszanych: wykorzystują wszystkie dostępne dane, właściwie uwzględniają korelację pomiarów, elastyczniej modelują czas i lepiej radzą sobie z brakami. Sprawdzamy to na jednym przykładzie, także po usunięciu części pomiarów tak, jak robi to odpadanie z badania. Liczby pochodzą z kodu w sekcji Kod R (dane symulowane).
Kiedy wystarcza ANOVA z powtarzanymi pomiarami
ANOVA z powtarzanymi pomiarami jest dobrym wyborem, gdy spełnione są trzy warunki:
- Komplet danych. Każda osoba ma wszystkie pomiary. Osoba z jednym brakiem wypada z analizy w całości.
- Czynniki kategorialne. Czas to kilka nazwanych momentów (przed, w trakcie, po), a predyktory nie zmieniają się w czasie.
- Sferyczność albo poprawka. Założenie sferyczności wymaga równych wariancji różnic między każdą parą pomiarów. W danych podłużnych rzadko jest spełnione, bo osoby różnią się tempem zmian. Stosuj wtedy poprawkę stopni swobody Greenhouse’a–Geissera (Greenhouse i Geisser, 1959) albo Huynha–Feldta.
Model mieszany nie jest automatycznie lepszy. W symulacji Haverkampa i Beauducela (2017) z 20–100 osobami i 3, 6 lub 9 pomiarami wyniki przemawiały za ANOVA z poprawką Huynha–Feldta, zwłaszcza przy naruszonej sferyczności, małej próbie i wielu pomiarach, a model wielopoziomowy z nieustrukturyzowaną macierzą kowariancji dawał silnie zawyżony błąd I rodzaju przy 20 osobach i co najmniej sześciu pomiarach. Gdy dane są porządkowe albo bardzo odległe od rozkładu normalnego, a masz jedną grupę, rozważ test Friedmana.
Kiedy lepszy jest model mieszany
Model mieszany to regresja, w której pomiary (poziom 1) są zagnieżdżone w osobach (poziom 2). Efekty stałe opisują przeciętną trajektorię w grupach, a efekty losowe – różnice między osobami w poziomie wyjściowym (losowy wyraz wolny) i tempie zmian (losowe nachylenie). Funkcja lmer() z pakietu lme4 szacuje takie modele metodą największej wiarygodności albo REML, a efekty stałe i losowe zapisuje się w jednej formule (Bates i in., 2015). Model mieszany ma przewagę w pięciu sytuacjach:
- Braki danych i odpadanie. Model korzysta z każdego dostępnego pomiaru, także osób, które odpadły. Gdy braki są typu MAR, czyli zależą od danych obserwowanych (np. od wcześniejszych wyników), metoda największej wiarygodności pozwala uniknąć obciążenia, jakie daje usuwanie przypadków – o ile model dobrze opisuje dane. Schafer i Graham (2002) odradzają starsze metody ad hoc i rekomendują właśnie tę estymację oraz imputację wielokrotną (zob. braki danych).
- Nierówne odstępy. ANOVA „nie wie”, że między T3 a T4 minęły cztery tygodnie, a między T1 a T2 – dwa. Model mieszany używa rzeczywistego czasu pomiaru, nawet jeśli różni się między osobami.
- Czas jako zmienna ciągła. Zamiast trzech stopni swobody dla czterech pomiarów szacujesz jedno nachylenie (np. zmianę na tydzień) i jego różnicę między grupami.
- Predyktory na dwóch poziomach. Obok cech stałych osoby (grupa, wiek) możesz włączyć zmienne mierzone przy każdym pomiarze, np. liczbę ukończonych modułów programu.
- Wiele bodźców. Gdy każda osoba ocenia wiele zdjęć lub słów, bodźce też są losową próbą. Judd, Westfall i Kenny (2012) pokazali, że pomijanie tej zmienności prowadzi do znacznych obciążeń, i zaproponowali modele ze skrzyżowanymi efektami losowymi osób i bodźców, np.
(1 + warunek | osoba) + (1 | bodziec).
| Cecha | ANOVA z powtarzanymi pomiarami | Model mieszany (LMM) |
|---|---|---|
| Format danych | szeroki: wiersz = osoba | długi: wiersz = pomiar |
| Osoby z brakami | usuwane w całości | wnoszą wszystkie dostępne pomiary |
| Braki nie obciążają wyników | gdy są całkowicie losowe (MCAR) | także przy brakach MAR, jeśli model jest dobrze określony |
| Czas | czynnik kategorialny | kategorialny albo ciągły |
| Korelacje pomiarów | sferyczność albo poprawka ε | modelowane wprost (efekty losowe lub kowariancja reszt) |
| Różnice w tempie zmian | część błędu | losowe nachylenie |
| Stopnie swobody testów | dokładne przy sferyczności | przybliżone (Satterthwaite, Kenward–Roger) |
| Główne ryzyko | obciążenie przy odpadaniu | źle dobrana struktura efektów losowych |
Przykład: program redukcji stresu, 2 grupy × 4 pomiary
W badaniu (dane symulowane) 100 dorosłych z podwyższonym stresem przydzielono losowo do 8-tygodniowego programu radzenia sobie ze stresem online (n = 50) albo na listę oczekujących (n = 50). Stres mierzono skalą 0–40 w tygodniu 0 (T1), 2 (T2), 4 (T3) i 8 (T4), więc odstępy są nierówne. W modelu, z którego wygenerowaliśmy dane, osoby różnią się poziomem wyjściowym i tempem zmian, a w programie stres spada o 0.5 punktu na tydzień szybciej niż na liście.
| Pomiar | Lista oczekujących M (SD) | Program M (SD) |
|---|---|---|
| T1 (tydzień 0) | 21.90 (6.20) | 22.34 (6.35) |
| T2 (tydzień 2) | 22.78 (5.70) | 21.24 (6.22) |
| T3 (tydzień 4) | 21.92 (5.11) | 20.06 (6.45) |
| T4 (tydzień 8) | 22.24 (6.40) | 17.54 (6.64) |
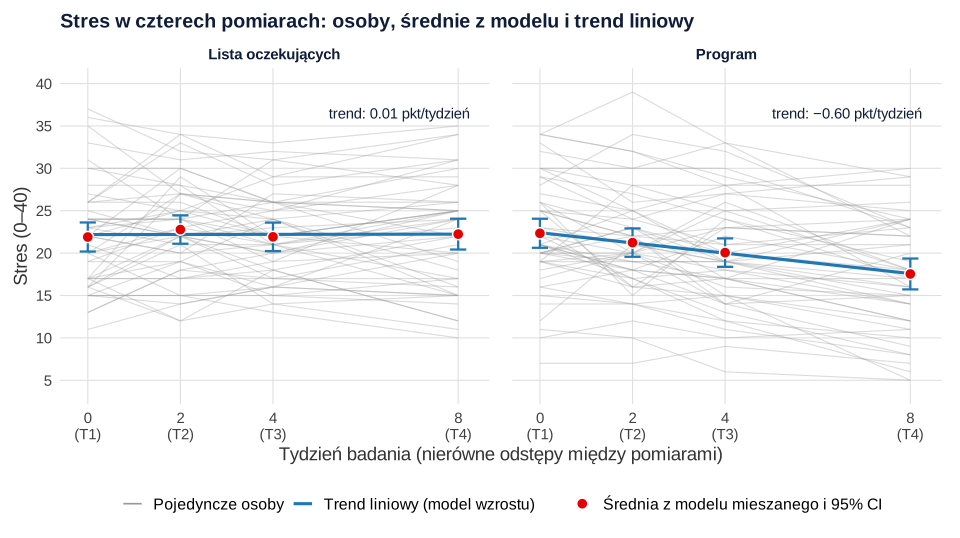
W programie średni stres spadł z 22.34 do 17.54 punktu, a na liście oczekujących pozostał podobny. Korelacje między pomiarami słabły wraz z odstępem w czasie: od .82 dla T2 i T3 do .57 dla T1 i T4. To typowy sygnał, że sferyczność może być naruszona. Rysunek 1 pokazuje trajektorie wszystkich osób.
Krok 1. ANOVA z powtarzanymi pomiarami w pakiecie afex
Funkcja aov_ez() z pakietu afex sama przekształca dane i ustawia kontrasty sumacyjne. Najważniejsze wyniki:
- Sferyczność. Test Mauchly’ego wskazał na jej naruszenie, W = .76, p < .001; εGG = .83, εHF = .86.
- Interakcja grupa × czas, czyli kluczowy test: F(2.50, 245.12) = 11.82, p < .001, η²G = .022. Poprawka Greenhouse’a–Geissera nie zmienia wartości F, tylko mnoży oba stopnie swobody przez ε; bez niej test ma postać F(3, 294) = 11.82.
- Efekty główne czasu, F(2.50, 245.12) = 11.43, p < .001, i grupy, F(1, 98) = 2.98, p = .087, przy istotnej interakcji mają ograniczone znaczenie (zob. efekt główny i efekt interakcji).
η²G to uogólnione eta kwadrat, które Bakeman (2005) zaleca w schematach z powtarzanymi pomiarami, bo pozwala porównywać efekty między schematami wewnątrz- i międzyobiektowymi. Niskie wartości wynikają tu z dużych stałych różnic między osobami.
Sam test interakcji nie mówi, gdzie leży różnica, więc zaplanuj kontrast główny – tu różnicę między grupami w zmianie od T1 do T4 – i policz go w pakiecie emmeans. Wyniósł −5.14 punktu, 95% CI [−7.35, −2.93], t(98) = −4.63, p < .001: w programie stres spadł o 5.14 punktu bardziej niż na liście oczekujących. Różnice zmian do T2 (−1.98, p = .019) i do T3 (−2.30, p = .015; korekta Holma) były mniejsze. Porównania po ANOVA omawiamy w poradniku ANOVA krok po kroku i w haśle testy post hoc.
Krok 2. Ten sam przykład jako model mieszany w lmerTest
Zacznij od modelu z samym losowym wyrazem wolnym: stres ~ grupa * czas + (1 | id). Zakłada on jednakową korelację każdej pary pomiarów (złożoną symetrię), czyli to samo co ANOVA bez poprawki, i przy komplecie danych daje identyczny test interakcji, F(3, 294) = 11.82, p < .001. W najprostszej wersji model mieszany jest więc tą samą ANOVA zapisaną jako regresja.
Korelacje pomiarów słabły jednak z upływem czasu, więc dodajemy losowe nachylenie czasu w tygodniach: stres ~ grupa * czas + (1 + tydzien | id). W efektach stałych czas jest czynnikiem (jak w ANOVA), a w efektach losowych – liczbą tygodni, więc każda osoba ma własne tempo zmian. Wyniki:
- Efekty losowe. Odchylenie standardowe wyrazów wolnych wyniosło 5.54 punktu, nachyleń – 0.48 punktu na tydzień, ich korelacja −.24, a odchylenie standardowe reszt 2.60.
- Porównanie struktur. Losowe nachylenie wyraźnie poprawiło dopasowanie: χ²(2) = 22.04, p < .001; AIC spadło z 2296.5 do 2278.5. Przy testowaniu wariancji ten test jest zachowawczy, bo zerowa wariancja leży na granicy dopuszczalnych wartości.
- Interakcja grupa × czas: F(3, 202.45) = 7.83, p < .001 (stopnie swobody Satterthwaite’a).
- Kontrast główny: −5.14, 95% CI [−7.25, −3.03], t(106) = −4.82, p < .001. Różnica między grupami w T4 wyniosła −4.70 punktu, t(104) = −3.62, p = .002, a w T1 – 0.44 punktu, p = .720 (korekta Holma dla czterech porównań).
Dlaczego F wynosi 7.83, a nie 11.82? ANOVA liczy F przy założeniu sferyczności i dopiero potem obniża stopnie swobody, a model mieszany od razu korzysta z oszacowanej struktury kowariancji, w której zmiany na dłuższych odcinkach czasu są bardziej zróżnicowane. Kontrast główny ma tę samą wartość, bo przy komplecie danych oba podejścia szacują te same średnie w komórkach; różnią się błędy standardowe i stopnie swobody.
Krok 3. Czas jako zmienna ciągła: model wzrostu
Rysunek 1 sugeruje, że średnie zmieniają się liniowo w tygodniach. Zamiast czterech poziomów czasu możesz więc wpisać liczbę tygodni: stres ~ grupa * tydzien + (1 + tydzien | id). To model wzrostu (ang. growth model): każda grupa ma własną linię, a każda osoba – własne odchylenie od niej.
- Na liście oczekujących stres praktycznie się nie zmieniał: 0.006 punktu na tydzień, 95% CI [−0.175, 0.187].
- W programie spadał szybciej: interakcja grupa × tydzień, b = −0.609, 95% CI [−0.865, −0.353], t(98.0) = −4.66, p < .001. Nachylenie w programie wyniosło −0.603 punktu na tydzień, a po 8 tygodniach różnica między grupami sięga −4.87 punktu.
- Trend liniowy opisuje średnie równie dobrze jak model z czterema poziomami czasu: χ²(4) = 3.86, p = .425 (porównanie modeli dopasowanych metodą największej wiarygodności), a AIC jest niższe (2280.3 wobec 2284.5).
Jedna liczba „o ile szybciej spada stres w programie” jest łatwiejsza do interpretacji niż test o trzech stopniach swobody i uwzględnia nierówne odstępy. To jednak dodatkowe założenie: jeśli efekt wygasa albo pojawia się skokowo, trend liniowy go zniekształci, więc porównaj go z modelem z czasem kategorialnym. Zob. też hasło schemat podłużny i poradnik o modelach cross-lagged.
| Analiza (komplet danych, N = 100) | Test grupa × czas | Różnica zmian T1 → T4 [95% CI] |
|---|---|---|
| ANOVA, poprawka Greenhouse’a–Geissera | F(2.50, 245.12) = 11.82, p < .001 | −5.14 [−7.35, −2.93], t(98) = −4.63 |
| Model mieszany: losowy wyraz wolny i nachylenie | F(3, 202.45) = 7.83, p < .001 | −5.14 [−7.25, −3.03], t(106) = −4.82 |
| Model wzrostu (czas w tygodniach) | b = −0.609 [−0.865, −0.353], t(98.0) = −4.66, p < .001 | 8 × b = −4.87 |
Jaką strukturę efektów losowych wybrać?
Barr i in. (2013) pokazali w symulacjach, że w testowaniu hipotez konfirmacyjnych modele najlepiej uogólniają wyniki, gdy zawierają maksymalną strukturę efektów losowych uzasadnioną schematem badania; modele z samymi losowymi wyrazami wolnymi wypadają gorzej, gdy osoby różnią się reakcją na manipulację. Według Matuschka i in. (2017) model maksymalny chroni przed zawyżeniem błędu I rodzaju, ale może wyraźnie obniżać moc, a struktura wspierana przez dane, wybrana kryterium wyboru modelu, dawała wyższą moc bez zawyżania błędu I rodzaju. Praktyczny wniosek: zacznij od struktury uzasadnionej schematem, upraszczaj ją tylko wtedy, gdy dane jej nie udźwigną, i zapisz regułę upraszczania z góry – najlepiej w planie analizy statystycznej.
Schemat 2 grupy × 4 pomiary uzasadnia losowy wyraz wolny osoby i losowe nachylenie czasu, ale nie losowy efekt grupy, bo każda osoba należy do jednej grupy. Nie da się też dodać losowego nachylenia dla czterech poziomów czynnika czas: przy jednym pomiarze na osobę w każdym punkcie efektów losowych byłoby tyle co obserwacji (400), a lme4 przerywa obliczenia komunikatem o nieidentyfikowalnych parametrach (przepis 3 w sekcji Kod R).
- Korelacja efektów losowych. Model z korelacją wyrazu wolnego i nachylenia nie różnił się istotnie od modelu bez niej (zapis
(1 + tydzien || id)), χ²(1) = 2.73, p = .099. Efekt grupa × tydzień był w obu taki sam (−0.609), a jego błąd standardowy różnił się minimalnie (0.131 i 0.127). Użyj struktury z planu analizy, a drugą pokaż jako analizę wrażliwości. - REML czy ML. Struktury efektów losowych porównuj na modelach REML z tymi samymi efektami stałymi, a modele o różnych efektach stałych – na modelach ML (
anova()w lme4 przelicza je automatycznie, chyba że podaszrefit = FALSE).
Singular fit i ostrzeżenia o zbieżności
Komunikat boundary (singular) fit: see help('isSingular') oznacza, że model jest zbyt złożony dla danych: któraś wariancja efektu losowego wyszła (prawie) zerowa albo korelacja (prawie) ±1. Wywołaliśmy go celowo, dodając losowy składnik kwadratowy czasu: jego odchylenie standardowe wyniosło 0.026, korelacja z nachyleniem liniowym −.95, a rePCA() pokazała składową o zerowej wariancji. Dokumentacja lme4 wyjaśnia, że osobliwy model jest statystycznie dobrze zdefiniowany, ale grozi przeuczeniem i niską mocą, problemami numerycznymi oraz niewłaściwymi testami Walda i ilorazu wiarygodności. Przyznaje też, że nie ma zgody, jak postępować – wśród propozycji wymienia unikanie zbyt złożonych modeli, wybór modelu równoważący trafność i ryzyko przeuczenia oraz strategię „keep it maximal”, w której usuwa się tylko składniki uniemożliwiające poprawne dopasowanie.
Ostrzeżenie Model failed to converge with max|grad| = … to inna sprawa. W naszej symulacji pojawiło się w 71 i 67 z 1000 dopasowań modelu z losowym nachyleniem, choć model był poprawnie określony, a oszacowania z tych dopasowań nie odbiegały od pozostałych (95% CI obejmowały prawdziwą wartość w 95.8% i 95.5% przypadków). Dokumentacja lme4 zaznacza, że takie ostrzeżenia nie muszą oznaczać błędnego dopasowania. Zaleca sprawdzić specyfikację i dane, wystandaryzować predyktory ciągłe, zaostrzyć kryteria zbieżności, a jako „złoty standard” – funkcję allFit(), która dopasowuje model wszystkimi dostępnymi optymalizatorami. Jeśli wyniki są praktycznie takie same, ostrzeżenie jest fałszywym alarmem.
Stopnie swobody: Satterthwaite czy Kenward–Roger?
W modelu mieszanym statystyki t i F dla efektów stałych nie mają dokładnych stopni swobody, dlatego lme4 w podsumowaniu modelu nie podaje wartości p. Luke (2017) pokazał w symulacjach, że test ilorazu wiarygodności i traktowanie statystyki t jak z są nieco liberalne, zwłaszcza w małych próbach, a odsetek błędów I rodzaju był najbliższy .05 przy modelach szacowanych metodą REML i przybliżeniu stopni swobody Kenwarda–Rogera lub Satterthwaite’a. Kenward i Roger (1997) zaproponowali przy tym także skorygowaną macierz kowariancji efektów stałych o mniejszym obciążeniu w małych próbach.
| Test | Satterthwaite | Kenward–Roger |
|---|---|---|
| Interakcja grupa × czas, komplet danych | F(3, 202.45) = 7.83, p < .001 | F(3, 208.94) = 7.80, p < .001 |
| Kontrast T1 → T4, komplet danych | SE = 1.07, t(106) = −4.82 | SE = 1.07, t(106) = −4.82 |
| Kontrast T1 → T4, dane z odpadaniem | SE = 1.12, t(92.6) = −4.79 | SE = 1.13, t(92.7) = −4.78 |
Obie metody dały tu praktycznie to samo. lmerTest domyślnie stosuje metodę Satterthwaite’a, a emmeans dla modeli z lmer() – Kenwarda–Rogera (pakiet pbkrtest), z której jednak przy ponad 3000 obserwacji domyślnie rezygnuje, bo wymaga sporo obliczeń. Sprawdzaj więc wiersz Degrees-of-freedom method w wyniku i podawaj metodę w artykule.
R² marginalne i warunkowe
Nakagawa i Schielzeth (2013) zaproponowali dla modeli mieszanych dwie miary: R² marginalne (wariancja wyjaśniona przez efekty stałe) i R² warunkowe (przez efekty stałe i losowe łącznie). W modelu wzrostu R²m = .06, a R²c = .83: grupa i czas wyjaśniają niewielką część zmienności pojedynczych pomiarów, a większość wynika ze stałych różnic między osobami i różnic w tempie zmian. Niskie R²m nie oznacza, że efekt programu jest praktycznie nieważny, dlatego obok R² podawaj wielkość efektu w jednostkach skali – tu −4.87 punktu po 8 tygodniach.
Funkcja r2_nakagawa() z pakietu performance ostrzega, gdy zmienna z losowym nachyleniem nie występuje wśród efektów stałych (jak w modelu z czasem kategorialnym), bo zawyża to R² warunkowe – dlatego raportujemy R² z modelu wzrostu. Siłę zagnieżdżenia opisuje też korelacja wewnątrzklasowa (ICC).
Odpadanie z badania: ten sam przykład z brakami danych
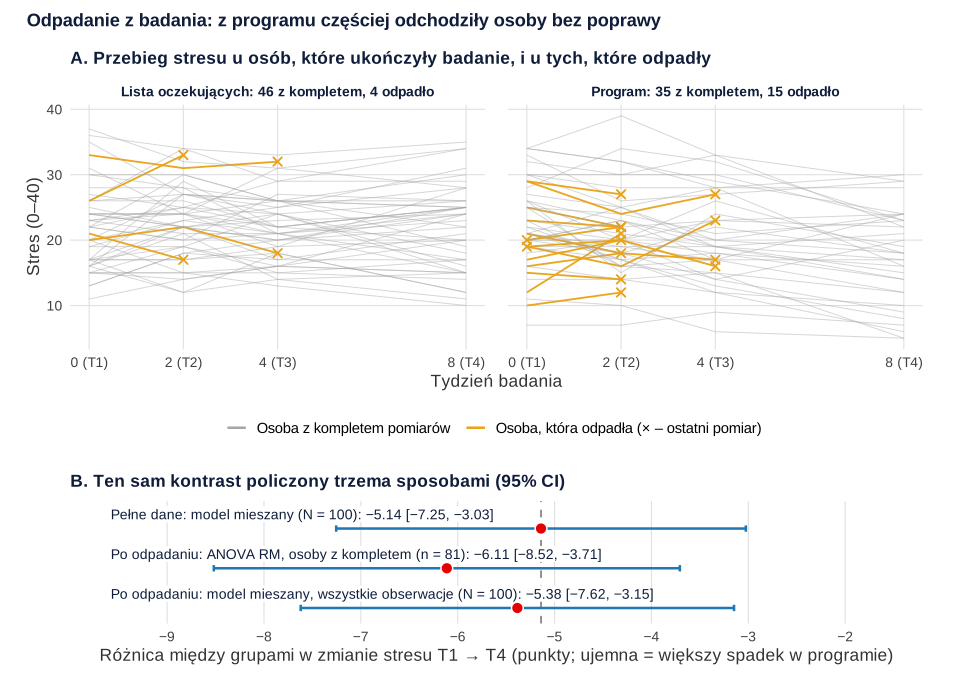
Teraz to samo badanie z odpadaniem. Przed T2 było ono czysto losowe (szansa 4% w obu grupach). Później z programu odchodziły głównie osoby, którym program nie pomagał – prawdopodobieństwo odejścia rosło wraz z obserwowaną dotąd zmianą stresu – a z listy oczekujących osoby odchodziły losowo. Takie braki są typu MAR, bo zależą od danych zebranych przed odejściem. Do T4 dotrwało 46 osób z listy oczekujących i 35 z programu; z 400 pomiarów zostało 366 (rysunek 2A).
- ANOVA usuwa 19 osób z brakami (4 z listy i 15 z programu) i analizuje 81 pozostałych. Interakcja: F(2.59, 204.75) = 13.28, p < .001, η²G = .029. Kontrast główny: −6.11, 95% CI [−8.52, −3.71], t(79) = −5.06, p < .001.
- Model mieszany z losowym wyrazem wolnym i nachyleniem wykorzystuje wszystkie 366 pomiarów 100 osób. Interakcja: F(3, 178.92) = 7.82, p < .001. Kontrast główny: −5.38, 95% CI [−7.62, −3.15], t(92.7) = −4.78, p < .001.
Bez odpadania ta sama analiza dała −5.14. ANOVA na osobach z kompletem pomiarów przeszacowała efekt programu prawie o punkt, bo w programie zostały głównie osoby, którym się poprawiło. Model mieszany, który korzysta z wcześniejszych pomiarów osób odchodzących, był dużo bliżej wyniku z pełnych danych (rysunek 2B). W modelu wzrostu różnica nachyleń wyniosła −0.632 punktu na tydzień, 95% CI [−0.904, −0.361], wobec −0.609 bez braków.
Jeden zbiór danych to tylko ilustracja, dlatego powtórzyliśmy cały eksperyment tysiąc razy. Inną drogą przy brakach jest imputacja wielokrotna, którą pokazujemy w poradniku braki danych i imputacja wielokrotna w R.
Symulacja: 1000 badań z odpadaniem typu MAR
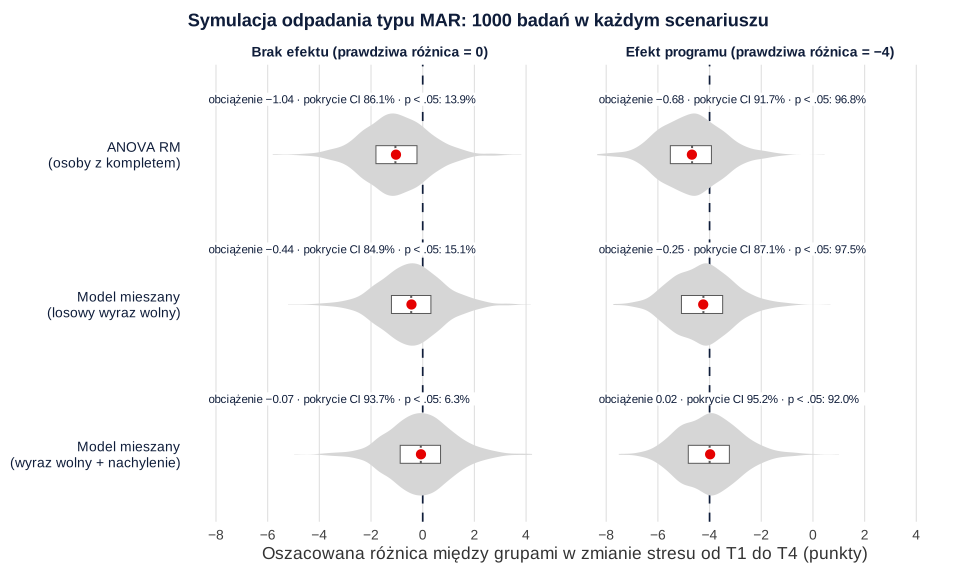
Wygenerowaliśmy po 1000 zbiorów danych z tym samym modelem i mechanizmem odpadania w dwóch scenariuszach: program działa (prawdziwa różnica zmian od T1 do T4 wynosi −4 punkty) albo nie działa (0). Do końca badania dotrwało średnio 79.8 i 76.3 osoby; w T4 brakowało 16.8% i 16.7% pomiarów na liście oczekujących oraz 23.5% i 30.7% w programie. Porównaliśmy ANOVA na osobach z kompletem pomiarów (kontrast główny to test t dla zmian T1 → T4, równy kontrastowi z emmeans), model z samym losowym wyrazem wolnym i model z losowym wyrazem wolnym i nachyleniem (stopnie swobody Satterthwaite’a).
| Scenariusz | Metoda | Średnie oszacowanie | Obciążenie | SD oszacowań | Średni SE | Pokrycie 95% CI | Wyniki p < .05 |
|---|---|---|---|---|---|---|---|
| Brak efektu (0) | ANOVA, osoby z kompletem | −1.04 | −1.04 | 1.25 | 1.20 | 86.1% | 13.9% |
| Model mieszany: wyraz wolny | −0.44 | −0.44 | 1.22 | 0.94 | 84.9% | 15.1% | |
| Model mieszany: wyraz wolny i nachylenie | −0.07 | −0.07 | 1.23 | 1.17 | 93.7% | 6.3% | |
| Efekt programu (−4) | ANOVA, osoby z kompletem | −4.68 | −0.68 | 1.19 | 1.17 | 91.7% | 96.8% |
| Model mieszany: wyraz wolny | −4.25 | −0.25 | 1.15 | 0.92 | 87.1% | 97.5% | |
| Model mieszany: wyraz wolny i nachylenie | −3.98 | 0.02 | 1.16 | 1.15 | 95.2% | 92.0% |
- ANOVA na osobach z kompletem pomiarów była obciążona. Gdy program nie działał, średnio „wykrywała” spadek stresu o 1.04 punktu i dawała wynik istotny w 13.9% badań zamiast w 5%. Gdy działał, przeszacowywała efekt o 0.68 punktu. Jej wyższy odsetek wyników istotnych (96.8% wobec 92.0%) jest skutkiem obciążenia, a nie zaletą.
- Model z samym losowym wyrazem wolnym nie wystarczył. Zakłada złożoną symetrię, więc zaniżał błąd standardowy zmiany na dłuższym odcinku: średni SE wynosił 0.94 i 0.92, a rzeczywiste SD oszacowań – 1.22 i 1.15. Pokrycie przedziałów spadło do 84.9–87.1%, a odsetek fałszywie istotnych wyników wzrósł do 15.1% – zgodnie z wnioskiem Barra i in. (2013) o modelach bez losowych nachyleń.
- Model z losowym wyrazem wolnym i nachyleniem był praktycznie nieobciążony (−0.07 i 0.02), jego średni SE był bliski rzeczywistemu rozrzutowi oszacowań, a odsetek fałszywie istotnych wyników wyniósł 6.3%.
Warunki symulacji były sprzyjające: model był poprawnie określony, a braki – typu MAR. Gdy odejście zależy od wartości, której nie zmierzyłeś (braki MNAR), obciążony może być także model mieszany; sprawdź wtedy, jak wnioski zmieniają się przy różnych założeniach o brakach. Pytania recenzentów o braki i zagnieżdżenie danych zebraliśmy we wpisie najczęstsze zarzuty recenzentów do statystyki, a wzory odpowiedzi, także w sprawie modelu mieszanego – w poradniku odpowiedź recenzentom.
Jak opisać analizę w artykule (APA)
Meteyard i Davies (2020) przeanalizowali 400 artykułów z modelami mieszanymi i za najbardziej niepokojące uznali zróżnicowanie w raportowaniu. Opis powinien pozwolić odtworzyć model, więc podaj:
- efekty stałe (z kodowaniem czynników) i losowe, zmienną czasu i jej jednostkę;
- regułę wyboru struktury efektów losowych i postępowanie przy problemach ze zbieżnością;
- metodę estymacji, metodę stopni swobody oraz program z wersjami pakietów;
- liczbę osób i obserwacji oraz liczbę brakujących pomiarów w grupach i punktach czasu;
- efekty stałe z 95% CI, kontrasty z nazwą korekty, odchylenia standardowe efektów losowych i reszt, R² marginalne i warunkowe.
Jeśli zostajesz przy ANOVA, podaj test Mauchly’ego, ε, nazwę poprawki i ułamkowe stopnie swobody – wzór opisu znajdziesz w haśle ANOVA z powtarzanymi pomiarami. Opis modelu wzrostu z przykładu:
Ten sam opis po angielsku, do sekcji Statistical analysis i Results:
Pełne wyniki zbierz w tabeli; ogólne zasady znajdziesz w poradnikach wytyczne APA dla metodologii i statystyki oraz jak opisać wyniki w stylu APA, a dane i kod do artykułu przygotujesz według poradnika pakiet replikacyjny.
Tabela 1
Liniowy model mieszany zmian stresu w czasie (model wzrostu)
| Parametr | b | SE | 95% CI | t (df) | p | |
|---|---|---|---|---|---|---|
| LL | UL | |||||
| Efekty stałe | ||||||
| Wyraz wolny | 22.188 | 0.833 | 20.555 | 23.821 | 26.63 (98.0) | < .001 |
| Grupa (program vs lista oczekujących) | 0.216 | 1.178 | −2.093 | 2.525 | 0.18 (98.0) | .855 |
| Tydzień | 0.006 | 0.092 | −0.175 | 0.187 | 0.07 (98.0) | .946 |
| Grupa × tydzień | −0.609 | 0.131 | −0.865 | −0.353 | −4.66 (98.0) | < .001 |
| Efekty losowe (SD) | ||||||
| Wyraz wolny osoby | 5.54 | |||||
| Nachylenie tygodnia | 0.48 | |||||
| Korelacja wyrazu wolnego i nachylenia | −.24 | |||||
| Reszta | 2.60 | |||||
Uwaga. N = 100 osób, 400 obserwacji. Estymacja REML, stopnie swobody Satterthwaite’a. Grupą odniesienia jest lista oczekujących; współczynnik dla tygodnia to zmiana stresu na tydzień w tej grupie. R²m = .06, R²c = .83. LL i UL – dolna i górna granica przedziału ufności. Dane symulowane.
Jeśli chcesz, żeby ktoś niezależnie sprawdził strukturę modelu, obsługę braków i opis wyników przed wysłaniem artykułu, zajrzyj do oferty analiz statystycznych dla badaczy. Wyniki opisujesz i bronisz Ty, więc każda decyzja analityczna musi być dla Ciebie jasna.
Model mieszany w SPSS
W SPSS ANOVA z powtarzanymi pomiarami to procedura GLM Repeated Measures (Analyze > General Linear Model > Repeated Measures...), która sama wyświetla test Mauchly’ego i poprawki ε. Model mieszany liczy procedura Linear Mixed Models z wersji Standard albo modułu Advanced Statistics (IBM Corp., b.d.), na danych w formacie długim. Kroki w wersji 30:
- Analyze > Mixed Models > Linear...
- W oknie Linear Mixed Models: Subjects and Repeated przenieś identyfikator osoby do pola Subjects; pole Repeated zostaw puste. (Jeśli wolisz wprost modelować kowariancję pomiarów, dodaj tam zmienną pomiaru i wybierz Repeated Covariance Type, np. Unstructured.)
- W głównym oknie wskaż zmienną zależną, czynnik (grupa) i kowariant (tydzień).
- Fixed: zbuduj efekty grupy, tygodnia i interakcji (opcja Factorial), pozostaw Include Intercept.
- Random: dodaj tydzień i wyraz wolny, jako Covariance type wybierz Unstructured, a identyfikator osoby przenieś do Subject Groupings.
- Estimation: w części Method wybierz REML, a w części Degrees of freedom – Satterthwaite approximation albo Kenward-Roger approximation.
- Statistics: zaznacz Parameter estimates for fixed effects i Covariances of random effects. Testy Walda z Tests for covariance parameters opierają się na asymptotycznych błędach standardowych, więc w małych próbach traktuj je ostrożnie.
- EM Means porównuje tylko poziomy efektów głównych (Compare Main Effects, korekta Bonferroni lub Sidak); porównania grup w każdym pomiarze wymagają podkomendy EMMEANS w składni polecenia MIXED.
Kod R: wszystkie analizy z tego wpisu
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R – przepisy 2–5 korzystają z obiektów utworzonych wcześniej (dane, glowny, odpadanie()). Potrzebne pakiety: afex, lme4, lmerTest, emmeans, pbkrtest, performance i MASS. Pakiety wczytaliśmy przed uruchomieniem, dlatego w wynikach nie ma komunikatów powitalnych.
1. Dane, statystyki opisowe i ANOVA z powtarzanymi pomiarami (afex)
R
# Dane symulowane: 8-tygodniowy program radzenia sobie ze stresem (online) i lista oczekujących,
# stres (skala 0–40) w tygodniach 0, 2, 4 i 8 – nierówne odstępy między pomiarami; N = 100 (2 × 50)
library(afex)      # aov_ez(): ANOVA z powtarzanymi pomiarami
library(emmeans)   # emmeans(), contrast()

set.seed(3838)
n_gr <- 50
N <- 2 * n_gr
tydz <- c(0, 2, 4, 8)
grupa_os <- factor(rep(c("kontrolna", "program"), each = n_gr), levels = c("kontrolna", "program"))
# losowe odchylenia osób od średniej trajektorii: wyraz wolny (SD = 5) i tempo zmian (SD = 0.5 pkt/tydzień), r = −0.2
u <- MASS::mvrnorm(N, mu = c(0, 0), Sigma = matrix(c(25, -0.5, -0.5, 0.25), 2))
dane <- expand.grid(os = 1:N, pomiar = 1:4)
dane$grupa   <- grupa_os[dane$os]
dane$tydzien <- tydz[dane$pomiar]
nachylenie <- ifelse(dane$grupa == "program", -0.65, -0.15)   # średnia zmiana stresu na tydzień
stres <- 22 + nachylenie * dane$tydzien + u[dane$os, 1] + u[dane$os, 2] * dane$tydzien + rnorm(nrow(dane), sd = 2.5)
dane$stres <- pmin(pmax(round(stres), 0), 40)
dane$id    <- factor(sprintf("os%03d", dane$os))
dane$czas  <- factor(paste0("T", dane$pomiar))
dane <- dane[order(dane$os, dane$pomiar), c("id", "grupa", "czas", "tydzien", "stres")]
head(dane, 4)

# Średnie i SD w komórkach grupa × czas
opis <- aggregate(stres ~ czas + grupa, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
print(do.call(data.frame, opis), row.names = FALSE)
# Korelacje pomiarów (cała próba): im dalej w czasie, tym słabsze
szer <- reshape(dane[, c("id", "czas", "stres")], idvar = "id", timevar = "czas", direction = "wide")
round(cor(szer[, -1]), 2)

# ANOVA w schemacie mieszanym: grupa (międzyobiektowy) × czas (wewnątrzobiektowy)
anova_rm <- aov_ez(id = "id", dv = "stres", data = dane, between = "grupa", within = "czas")
summary(anova_rm)$sphericity.tests        # test Mauchly'ego
summary(anova_rm)$pval.adjustments[, c("GG eps", "HF eps")]
nice(anova_rm, correction = "none", es = "ges") # bez poprawki (zakłada sferyczność)
nice(anova_rm, correction = "GG", es = "ges")   # poprawka Greenhouse'a–Geissera, η² uogólnione

# Kontrast główny (z planu analizy): różnica między grupami w zmianie od T1 do T4
emm_anova <- emmeans(anova_rm, ~ grupa * czas)          # kolejność: kontrolna T1, program T1, ..., program T4
glowny <- list("program vs kontrolna: zmiana T1-T4" = c(1, -1, 0, 0, 0, 0, -1, 1))
summary(contrast(emm_anova, glowny), infer = TRUE)
# Wszystkie zmiany od T1 (T2, T3, T4) – z korektą Holma
contrast(emm_anova, interaction = c(grupa = "revpairwise", czas = "trt.vs.ctrl1"), adjust = "holm")
Wynik w R
       id     grupa czas tydzien stres
1   os001 kontrolna   T1       0    22
101 os001 kontrolna   T2       2    20
201 os001 kontrolna   T3       4    27
301 os001 kontrolna   T4       8    26
 czas     grupa stres.M stres.SD
   T1 kontrolna   21.90     6.20
   T2 kontrolna   22.78     5.70
   T3 kontrolna   21.92     5.11
   T4 kontrolna   22.24     6.40
   T1   program   22.34     6.35
   T2   program   21.24     6.22
   T3   program   20.06     6.45
   T4   program   17.54     6.64
         stres.T1 stres.T2 stres.T3 stres.T4
stres.T1     1.00     0.76     0.74     0.57
stres.T2     0.76     1.00     0.82     0.76
stres.T3     0.74     0.82     1.00     0.78
stres.T4     0.57     0.76     0.78     1.00
Contrasts set to contr.sum for the following variables: grupa
           Test statistic    p-value
czas              0.76337 8.4805e-05
grupa:czas        0.76337 8.4805e-05
            GG eps    HF eps
czas       0.83375 0.8573367
grupa:czas 0.83375 0.8573367
Anova Table (Type 3 tests)

Response: stres
      Effect     df    MSE         F  ges p.value
1      grupa  1, 98 122.86    2.98 + .024    .087
2       czas 3, 294   9.48 11.43 *** .021   <.001
3 grupa:czas 3, 294   9.48 11.82 *** .022   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1
Anova Table (Type 3 tests)

Response: stres
      Effect           df    MSE         F  ges p.value
1      grupa        1, 98 122.86    2.98 + .024    .087
2       czas 2.50, 245.12  11.37 11.43 *** .021   <.001
3 grupa:czas 2.50, 245.12  11.37 11.82 *** .022   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
 contrast                           estimate   SE df lower.CL upper.CL t.ratio
 program vs kontrolna: zmiana T1-T4    -5.14 1.11 98    -7.35    -2.93  -4.626
 p.value
 <0.0001

Confidence level used: 0.95
 grupa_revpairwise   czas_trt.vs.ctrl1 estimate    SE df t.ratio p.value
 program - kontrolna T2 - T1              -1.98 0.829 98  -2.388  0.0188
 program - kontrolna T3 - T1              -2.30 0.844 98  -2.724  0.0153
 program - kontrolna T4 - T1              -5.14 1.110 98  -4.626 <0.0001

P value adjustment: holm method for 3 tests
2. Model mieszany i model wzrostu (lmerTest, emmeans, performance)
R
# Model mieszany na tych samych danych (ramka dane i lista glowny z przepisu 1)
library(lmerTest)     # lmer() z testami F i t (Satterthwaite); ładuje lme4
library(emmeans)
library(performance)  # r2_nakagawa()

# (a) Sam losowy wyraz wolny = złożona symetria: test interakcji jak w ANOVA bez poprawki
m_ri <- lmer(stres ~ grupa * czas + (1 | id), data = dane)
anova(m_ri)

# (b) Losowy wyraz wolny i losowe nachylenie czasu (w tygodniach): osoby różnią się tempem zmian
m_rs <- lmer(stres ~ grupa * czas + (1 + tydzien | id), data = dane)
VarCorr(m_rs)
anova(m_ri, m_rs, refit = FALSE)        # czy losowe nachylenie poprawia dopasowanie? (REML)
anova(m_rs)                             # testy F, stopnie swobody Satterthwaite'a
anova(m_rs, ddf = "Kenward-Roger")      # to samo z poprawką Kenwarda–Rogera (pakiet pbkrtest)

# Kontrast główny i różnice między grupami w każdym pomiarze (emmeans dla lmer: domyślnie df Kenwarda–Rogera)
emm_rs <- emmeans(m_rs, ~ grupa * czas)
summary(contrast(emm_rs, glowny), infer = TRUE)
summary(contrast(emmeans(m_rs, ~ grupa * czas, lmer.df = "satterthwaite"), glowny), infer = TRUE)
summary(pairs(emmeans(m_rs, ~ grupa | czas), reverse = TRUE), by = NULL, adjust = "holm")

# (c) Czas jako zmienna ciągła: model wzrostu z losowym wyrazem wolnym i nachyleniem
m_lin <- lmer(stres ~ grupa * tydzien + (1 + tydzien | id), data = dane)
round(summary(m_lin)$coefficients, 3)
round(confint(m_lin, parm = "beta_", method = "Wald"), 3)
VarCorr(m_lin)
b <- fixef(m_lin)
round(c(nachylenie_program = b[["tydzien"]] + b[["grupaprogram:tydzien"]], roznica_po_8_tyg = 8 * b[["grupaprogram:tydzien"]]), 3)
anova(m_lin, m_rs)      # ML: czy trend liniowy opisuje średnie równie dobrze jak 4 poziomy czasu?
r2_nakagawa(m_lin)      # R² marginalne i warunkowe
r2_nakagawa(m_rs)       # tu tydzień jest tylko w efektach losowych – pakiet ostrzega o zawyżeniu
Wynik w R
Type III Analysis of Variance Table with Satterthwaite's method
           Sum Sq Mean Sq NumDF DenDF F value    Pr(>F)
grupa       28.30   28.30     1    98  2.9849   0.08719 .
czas       325.17  108.39     3   294 11.4322 4.118e-07 ***
grupa:czas 336.15  112.05     3   294 11.8182 2.489e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 Groups   Name        Std.Dev. Corr
 id       (Intercept) 5.53557
          tydzien     0.48273  -0.239
 Residual             2.60046
Data: dane
Models:
m_ri: stres ~ grupa * czas + (1 | id)
m_rs: stres ~ grupa * czas + (1 + tydzien | id)
     npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m_ri   10 2296.5 2336.4 -1138.3    2276.5
m_rs   12 2278.5 2326.4 -1127.2    2254.5 22.043  2  1.635e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Type III Analysis of Variance Table with Satterthwaite's method
            Sum Sq Mean Sq NumDF   DenDF F value    Pr(>F)
grupa       20.186  20.186     1  98.001  2.9850   0.08719 .
czas       155.079  51.693     3 202.453  7.6442 7.258e-05 ***
grupa:czas 158.812  52.937     3 202.453  7.8282 5.721e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Type III Analysis of Variance Table with Kenward-Roger's method
            Sum Sq Mean Sq NumDF  DenDF F value    Pr(>F)
grupa       20.186  20.186     1  98.00  2.9850   0.08719 .
czas       155.079  51.693     3 208.94  7.6131 7.437e-05 ***
grupa:czas 158.812  52.937     3 208.94  7.7963 5.864e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 contrast                           estimate   SE  df lower.CL upper.CL t.ratio
 program vs kontrolna: zmiana T1-T4    -5.14 1.07 106    -7.25    -3.03  -4.819
 p.value
 <0.0001

Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95
 contrast                           estimate   SE  df lower.CL upper.CL t.ratio
 program vs kontrolna: zmiana T1-T4    -5.14 1.07 106    -7.25    -3.03  -4.819
 p.value
 <0.0001

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
 contrast            czas estimate   SE  df t.ratio p.value
 program - kontrolna T1       0.44 1.22 114   0.360  0.7197
 program - kontrolna T2      -1.54 1.20 128  -1.287  0.4007
 program - kontrolna T3      -1.86 1.20 131  -1.550  0.3710
 program - kontrolna T4      -4.70 1.30 104  -3.622  0.0018

Degrees-of-freedom method: kenward-roger
P value adjustment: holm method for 4 tests
                     Estimate Std. Error     df t value Pr(>|t|)
(Intercept)            22.188      0.833 98.002  26.634    0.000
grupaprogram            0.216      1.178 98.002   0.183    0.855
tydzien                 0.006      0.092 98.005   0.068    0.946
grupaprogram:tydzien   -0.609      0.131 98.005  -4.663    0.000
                      2.5 % 97.5 %
(Intercept)          20.555 23.821
grupaprogram         -2.093  2.525
tydzien              -0.175  0.187
grupaprogram:tydzien -0.865 -0.353
 Groups   Name        Std.Dev. Corr
 id       (Intercept) 5.5359
          tydzien     0.4829   -0.239
 Residual             2.5993
nachylenie_program   roznica_po_8_tyg
            -0.603             -4.871
refitting model(s) with ML (instead of REML)
Data: dane
Models:
m_lin: stres ~ grupa * tydzien + (1 + tydzien | id)
m_rs: stres ~ grupa * czas + (1 + tydzien | id)
      npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m_lin    8 2280.3 2312.3 -1132.2    2264.3
m_rs    12 2284.5 2332.4 -1130.2    2260.5 3.8608  4     0.4252
# R2 for Mixed Models

  Conditional R2: 0.832
     Marginal R2: 0.062
Warning: Random slopes not present as fixed effects. This artificially inflates
  the conditional random effect variances.
  Respecify the fixed effects structure of your model (add random slopes
  as fixed effects).
# R2 for Mixed Models

  Conditional R2: 0.831
     Marginal R2: 0.064
3. Struktura efektów losowych: model nieidentyfikowalny i osobliwe dopasowanie
R
# Struktura efektów losowych: co da się oszacować przy jednym pomiarze na osobę w każdym punkcie czasu
library(lmerTest)

# 1. Losowe nachylenie dla 4-poziomowego czynnika czas: tyle efektów losowych, ile obserwacji – model nieidentyfikowalny
try(lmer(stres ~ grupa * czas + (1 + czas | id), data = dane))

# 2. Losowy wyraz wolny, nachylenie liniowe i kwadratowe: model za złożony – osobliwe dopasowanie
m_kw <- lmer(stres ~ grupa * tydzien + (1 + tydzien + I(tydzien^2) | id), data = dane)
isSingular(m_kw)
VarCorr(m_kw)
summary(rePCA(m_kw))   # ostatnia składowa ma (prawie) zerową wariancję

# 3. Prostsza struktura: efekty losowe bez korelacji (||) i porównanie z modelem z korelacją
m_lin <- lmer(stres ~ grupa * tydzien + (1 + tydzien | id), data = dane)
m_nk  <- lmer(stres ~ grupa * tydzien + (1 + tydzien || id), data = dane)
anova(m_nk, m_lin, refit = FALSE)
# Czy wniosek o efekcie stałym zależy od tej decyzji?
round(rbind(z_korelacja = summary(m_lin)$coefficients["grupaprogram:tydzien", ],
            bez_korelacji = summary(m_nk)$coefficients["grupaprogram:tydzien", ]), 3)
Wynik w R
Error : number of observations (=400) <= number of random effects (=400) for term (1 + czas | id); the random-effects parameters and the residual variance (or scale parameter) are probably unidentifiable
boundary (singular) fit: see help('isSingular')
[1] TRUE
 Groups   Name         Std.Dev. Corr
 id       (Intercept)  5.679877
          tydzien      0.688052 -0.404
          I(tydzien^2) 0.026499  0.675 -0.948
 Residual              2.585412
$id
Importance of components:
                         [,1]    [,2] [,3]
Standard deviation     2.1996 0.24323    0
Proportion of Variance 0.9879 0.01208    0
Cumulative Proportion  0.9879 1.00000    1

Data: dane
Models:
m_nk: stres ~ grupa * tydzien + (1 + tydzien || id)
m_lin: stres ~ grupa * tydzien + (1 + tydzien | id)
      npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m_nk     7 2284.3 2312.2 -1135.1    2270.3
m_lin    8 2283.5 2315.5 -1133.8    2267.5 2.7279  1    0.09861 .
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
              Estimate Std. Error      df t value Pr(>|t|)
z_korelacja     -0.609      0.131  98.005  -4.663        0
bez_korelacji   -0.609      0.127 105.646  -4.809        0
4. Odpadanie typu MAR: ANOVA na osobach z kompletem a model mieszany
R
# Te same osoby, ale część odpada z badania (MAR): w programie częściej odchodzą osoby bez poprawy
# (zależy to od zmiany obserwowanej przed odejściem), w grupie kontrolnej – losowo
library(afex); library(lmerTest); library(emmeans)

odpadanie <- function(dane) {
  szer <- reshape(dane[, c("id", "grupa", "czas", "stres")], idvar = c("id", "grupa"), timevar = "czas", direction = "wide")
  Y <- as.matrix(szer[, paste0("stres.T", 1:4)])
  w_programie <- szer$grupa == "program"
  obecny <- rep(TRUE, nrow(Y))
  brak <- matrix(FALSE, nrow(Y), 4)
  for (j in 2:4) {
    p <- if (j == 2) rep(0.04, nrow(Y)) else                                # przed T2: 4% w obu grupach
      ifelse(w_programie, plogis(-2.0 + (Y[, j - 1] - Y[, 1]) / 3),         # program: brak poprawy → odejście
             plogis(-2.6))                                                   # kontrolna: ok. 7% przed T3 i T4
    obecny <- obecny & (runif(nrow(Y)) >= p)
    brak[, j] <- !obecny
  }
  dane$stres[as.vector(t(brak))] <- NA       # dane są posortowane według osoby i pomiaru
  dane
}
set.seed(19)
dane_mar <- odpadanie(dane)
table(grupa = dane_mar$grupa, czas = dane_mar$czas, obserwowany = !is.na(dane_mar$stres))[, , "TRUE"]
sum(!is.na(dane_mar$stres))       # liczba dostępnych pomiarów (z 400)

# ANOVA z powtarzanymi pomiarami: tylko osoby z kompletem czterech pomiarów
kompletni <- names(which(tapply(!is.na(dane_mar$stres), dane_mar$id, all)))
dane_kompl <- droplevels(dane_mar[dane_mar$id %in% kompletni, ])
table(dane_kompl$grupa[dane_kompl$czas == "T1"])
anova_kompl <- aov_ez(id = "id", dv = "stres", data = dane_kompl, between = "grupa", within = "czas")
nice(anova_kompl, correction = "GG", es = "ges")
summary(contrast(emmeans(anova_kompl, ~ grupa * czas), glowny), infer = TRUE)

# Model mieszany: wszystkie dostępne obserwacje (także osób, które odpadły)
m_rs_mar <- lmer(stres ~ grupa * czas + (1 + tydzien | id), data = dane_mar)
anova(m_rs_mar)
summary(contrast(emmeans(m_rs_mar, ~ grupa * czas), glowny), infer = TRUE)
summary(contrast(emmeans(m_rs_mar, ~ grupa * czas, lmer.df = "satterthwaite"), glowny), infer = TRUE)
m_lin_mar <- lmer(stres ~ grupa * tydzien + (1 + tydzien | id), data = dane_mar)
round(summary(m_lin_mar)$coefficients["grupaprogram:tydzien", ], 3)
round(confint(m_lin_mar, parm = "grupaprogram:tydzien", method = "Wald"), 3)
Wynik w R
           czas
grupa       T1 T2 T3 T4
  kontrolna 50 50 48 46
  program   50 48 39 35
[1] 366

kontrolna   program
       46        35
Contrasts set to contr.sum for the following variables: grupa
Anova Table (Type 3 tests)

Response: stres
      Effect           df    MSE         F  ges p.value
1      grupa        1, 79 128.63      0.74 .008    .393
2       czas 2.59, 204.75  10.84 11.92 *** .026   <.001
3 grupa:czas 2.59, 204.75  10.84 13.28 *** .029   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
 contrast                           estimate   SE df lower.CL upper.CL t.ratio
 program vs kontrolna: zmiana T1-T4    -6.11 1.21 79    -8.52    -3.71  -5.058
 p.value
 <0.0001

Confidence level used: 0.95
Type III Analysis of Variance Table with Satterthwaite's method
            Sum Sq Mean Sq NumDF   DenDF F value    Pr(>F)
grupa       23.045  23.045     1  98.876  3.2765  0.073315 .
czas       149.993  49.998     3 178.924  7.1087  0.000154 ***
grupa:czas 165.005  55.002     3 178.924  7.8202 6.201e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 contrast                           estimate   SE   df lower.CL upper.CL
 program vs kontrolna: zmiana T1-T4    -5.38 1.13 92.7    -7.62    -3.15
 t.ratio p.value
  -4.780 <0.0001

Degrees-of-freedom method: kenward-roger
Confidence level used: 0.95
 contrast                           estimate   SE   df lower.CL upper.CL
 program vs kontrolna: zmiana T1-T4    -5.38 1.12 92.6    -7.62    -3.15
 t.ratio p.value
  -4.790 <0.0001

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
  Estimate Std. Error         df    t value   Pr(>|t|)
    -0.632      0.138     86.529     -4.567      0.000
                      2.5 % 97.5 %
grupaprogram:tydzien -0.904 -0.361
5. Symulacja: 2 × 1000 badań z odpadaniem typu MAR
R
# Symulacja: odpadanie typu MAR (funkcja odpadanie() z przepisu 4), po 1000 zbiorów danych w dwóch scenariuszach.
# Szacowany efekt: różnica między grupami w zmianie stresu od T1 do T4 (prawdziwa: −4 albo 0 punktów)
library(lmerTest)

generuj <- function(efekt_tyg, n_gr = 50, tydz = c(0, 2, 4, 8)) {   # ten sam model co w przepisie 1
  N <- 2 * n_gr
  u <- MASS::mvrnorm(N, mu = c(0, 0), Sigma = matrix(c(25, -0.5, -0.5, 0.25), 2))
  d <- expand.grid(os = 1:N, pomiar = 1:4)
  d$grupa   <- factor(ifelse(d$os <= n_gr, "kontrolna", "program"), levels = c("kontrolna", "program"))
  d$tydzien <- tydz[d$pomiar]
  nachylenie <- ifelse(d$grupa == "program", -0.15 + efekt_tyg, -0.15)
  y <- 22 + nachylenie * d$tydzien + u[d$os, 1] + u[d$os, 2] * d$tydzien + rnorm(nrow(d), sd = 2.5)
  d$stres <- pmin(pmax(round(y), 0), 40)
  d$id <- factor(sprintf("os%03d", d$os)); d$czas <- factor(paste0("T", d$pomiar))
  d[order(d$os, d$pomiar), c("id", "grupa", "czas", "tydzien", "stres")]
}
dopasuj <- function(formula, d) {      # lmer, który zapamiętuje ostrzeżenia o zbieżności zamiast je wypisywać
  ostrz <- FALSE
  m <- withCallingHandlers(lmer(formula, data = d),
                           warning = function(w) { ostrz <<- TRUE; invokeRestart("muffleWarning") },
                           message = function(w) invokeRestart("muffleMessage"))
  k <- summary(m)$coefficients["grupaprogram:czasT4", ]
  c(est = k[["Estimate"]], se = k[["Std. Error"]], lo = k[["Estimate"]] - qt(.975, k[["df"]]) * k[["Std. Error"]],
    hi = k[["Estimate"]] + qt(.975, k[["df"]]) * k[["Std. Error"]], p = k[["Pr(>|t|)"]],
    osobliwy = isSingular(m), ostrzezenie = ostrz)
}
jeden_zbior <- function(efekt_tyg) {
  d <- odpadanie(generuj(efekt_tyg))
  Y <- matrix(d$stres, ncol = 4, byrow = TRUE)
  prog <- matrix(d$grupa == "program", ncol = 4, byrow = TRUE)[, 1]
  ok <- complete.cases(Y)              # ANOVA: osoby z kompletem pomiarów; kontrast = test t dla zmian T1 → T4
  tt <- t.test(Y[ok & prog, 4] - Y[ok & prog, 1], Y[ok & !prog, 4] - Y[ok & !prog, 1], var.equal = TRUE)
  wyn <- rbind(anova_kompletni      = c(est = unname(tt$estimate[1] - tt$estimate[2]), se = tt$stderr, lo = tt$conf.int[1],
                                        hi = tt$conf.int[2], p = tt$p.value, osobliwy = NA, ostrzezenie = NA),
               mieszany_wyraz_wolny = dopasuj(stres ~ grupa * czas + (1 | id), d),
               mieszany_nachylenie  = dopasuj(stres ~ grupa * czas + (1 + tydzien | id), d))
  data.frame(metoda = rownames(wyn), wyn, n_kompl = sum(ok), brak_T4_kontr = mean(is.na(Y[!prog, 4])),
             brak_T4_prog = mean(is.na(Y[prog, 4])), row.names = NULL)
}
set.seed(2038)
sym <- do.call(rbind, lapply(c(-0.5, 0), function(efekt) {
  z <- do.call(rbind, replicate(1000, jeden_zbior(efekt), simplify = FALSE))
  cbind(prawda = 8 * efekt, z)
}))

# Podsumowanie: obciążenie, rozrzut oszacowań a średni błąd standardowy, pokrycie 95% CI
# i odsetek wyników p < .05 (moc albo błąd I rodzaju)
wyniki <- do.call(rbind, lapply(split(sym, list(sym$metoda, sym$prawda)), function(x) data.frame(
  prawda = x$prawda[1], metoda = x$metoda[1], srednia = mean(x$est), obciazenie = mean(x$est) - x$prawda[1],
  SD = sd(x$est), sredni_SE = mean(x$se), pokrycie_95 = mean(x$lo <= x$prawda[1] & x$hi >= x$prawda[1]), p_ponizej_05 = mean(x$p < .05),
  osobliwe = sum(x$osobliwy), ostrzezenia = sum(x$ostrzezenie))))
tab <- wyniki[order(-wyniki$prawda, wyniki$metoda), ]
tab[, 3:6] <- lapply(tab[, 3:6], sprintf, fmt = "%.2f"); tab[, 7:8] <- lapply(tab[, 7:8], sprintf, fmt = "%.3f")
print(tab, row.names = FALSE)
# Ile osób odpadło (średnio na zbiór danych)
round(aggregate(cbind(n_kompl, brak_T4_kontr, brak_T4_prog) ~ prawda, data = sym[sym$metoda == "anova_kompletni", ], FUN = mean), 3)
# Czy dopasowania z ostrzeżeniem o zbieżności dały inne wyniki? (model z losowym nachyleniem)
x <- sym[sym$metoda == "mieszany_nachylenie", ]
round(aggregate(cbind(blad = est - prawda, pokrycie = lo <= prawda & hi >= prawda) ~ prawda + ostrzezenie, data = x, FUN = mean), 3)
Wynik w R
 prawda               metoda srednia obciazenie   SD sredni_SE pokrycie_95
      0      anova_kompletni   -1.04      -1.04 1.25      1.20       0.861
      0  mieszany_nachylenie   -0.07      -0.07 1.23      1.17       0.937
      0 mieszany_wyraz_wolny   -0.44      -0.44 1.22      0.94       0.849
     -4      anova_kompletni   -4.68      -0.68 1.19      1.17       0.917
     -4  mieszany_nachylenie   -3.98       0.02 1.16      1.15       0.952
     -4 mieszany_wyraz_wolny   -4.25      -0.25 1.15      0.92       0.871
 p_ponizej_05 osobliwe ostrzezenia
        0.139       NA          NA
        0.063        0          71
        0.151        0           0
        0.968       NA          NA
        0.920        0          67
        0.975        0           0
  prawda n_kompl brak_T4_kontr brak_T4_prog
1     -4  79.833         0.168        0.235
2      0  76.329         0.167        0.307
  prawda ostrzezenie   blad pokrycie
1     -4           0  0.026    0.952
2      0           0 -0.076    0.935
3     -4           1 -0.050    0.955
4      0           1  0.045    0.958
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W artykule podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- afex (wersja 1.5-1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2-1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- pbkrtest (wersja 0.5.5): Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models – The R package pbkrtest. Journal of Statistical Software, 59(9), 1–30. https://doi.org/10.18637/jss.v059.i09
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), Article 3139. https://doi.org/10.21105/joss.03139
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Usuwanie osób z brakami bez sprawdzenia, dlaczego odpadły. Gdy odpadanie zależy od wcześniejszych wyników, analiza osób z kompletem pomiarów jest obciążona.
- Model mieszany z samym losowym wyrazem wolnym w danych podłużnych. To ANOVA bez poprawki na sferyczność w innym zapisie; gdy osoby różnią się tempem zmian, zaniża błędy standardowe.
- Struktura efektów losowych dobrana pod wynik. Zapisz regułę wyboru i upraszczania przed analizą (Barr i in., 2013; Matuschek i in., 2017).
- Ignorowanie osobliwego dopasowania albo usuwanie efektów losowych przy każdym ostrzeżeniu o zbieżności bez sprawdzenia innych optymalizatorów.
- Wartości p z traktowania t jak z. Używaj metody Satterthwaite’a albo Kenwarda–Rogera i podaj ją (Luke, 2017).
- Brak informacji o tym, kto i kiedy odpadł.
- Pomijanie losowej zmienności bodźców w eksperymentach z wieloma bodźcami (Judd i in., 2012).
- Liczebność próby „na oko”. Moc zależy od liczby osób i pomiarów oraz wariancji efektów losowych, więc najlepiej oszacować ją symulacją jak w przepisie 5 (zob. dobór liczebności próby). Prostsze schematy przed–po omawiamy w poradniku statystyka w pracy z fizjoterapii.
Najczęstsze pytania
Czy ANOVA z powtarzanymi pomiarami i model mieszany dają ten sam wynik?
Tylko w szczególnym przypadku: przy komplecie danych model mieszany z samym losowym wyrazem wolnym daje ten sam test F co ANOVA bez poprawki na sferyczność (w przykładzie F(3, 294) = 11.82). Gdy dodasz losowe nachylenie albo w danych są braki, wyniki się rozchodzą, bo model inaczej opisuje kowariancję pomiarów i korzysta też z niepełnych przypadków.
Co zrobić, gdy lmer zgłasza boundary (singular) fit?
Komunikat oznacza, że któraś wariancja efektu losowego jest (prawie) zerowa albo korelacja wynosi (prawie) ±1, czyli model jest zbyt złożony dla danych. Sprawdź VarCorr() i rePCA(), usuń zbędny składnik (np. korelację albo nachylenie o zerowej wariancji) i opisz tę decyzję w artykule. Nie wybieraj struktury efektów losowych pod oczekiwany wynik.
Satterthwaite czy Kenward–Roger – którą metodę stopni swobody wybrać w modelu mieszanym?
W symulacjach Luke’a (2017) obie metody, zastosowane do modeli szacowanych metodą REML, utrzymywały błąd I rodzaju blisko .05 także w mniejszych próbach. Kenward–Roger dodatkowo koryguje błędy standardowe efektów stałych, ale wymaga więcej obliczeń – pakiet emmeans przy ponad 3000 obserwacji domyślnie z niego rezygnuje. W przykładzie z tego wpisu obie metody dały praktycznie ten sam wynik; w artykule podaj, której użyłeś.
Ile pomiarów na osobę potrzeba do modelu z losowym nachyleniem?
Żeby oddzielić losowe nachylenie od błędu pomiaru, potrzebujesz co najmniej trzech pomiarów przynajmniej u części osób; gdy wszyscy mają tylko dwa, model z losowym wyrazem wolnym, nachyleniem i resztą nie jest identyfikowalny. Osoby z jednym lub dwoma pomiarami nadal wnoszą informację o efektach stałych, więc ich nie usuwaj.
Jak opisać model mieszany w artykule naukowym?
Podaj wzór modelu (efekty stałe i losowe), regułę wyboru struktury efektów losowych, metodę estymacji (REML lub ML), metodę stopni swobody, program z wersjami pakietów, efekty stałe z 95% CI, wariancje efektów losowych, R² marginalne i warunkowe oraz problemy ze zbieżnością i sposób ich rozwiązania. Meteyard i Davies (2020) w przeglądzie 400 artykułów za najbardziej niepokojące uznali właśnie rozbieżności w raportowaniu modeli mieszanych.
Czy model mieszany rozwiązuje problem braków danych w pomiarach powtarzanych?
Tylko częściowo: pozwala uniknąć obciążenia, gdy braki są typu MAR (zależą od danych obserwowanych, np. od wcześniejszych pomiarów) i gdy model dobrze opisuje strukturę kowariancji. Przy brakach MNAR, gdy odejście zależy od niezmierzonej wartości, obciążenie może pozostać, więc sprawdź wrażliwość wniosków na założenia o brakach. W naszej symulacji model z samym losowym wyrazem wolnym również dawał obciążone wyniki.
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →Recenzent prosi o model mieszany zamiast ANOVA?
Pomożemy dobrać i uzasadnić strukturę efektów losowych, policzyć model w R lub SPSS, sprawdzić wpływ braków danych i wyjaśnić wyniki, które potem samodzielnie opiszesz i obronisz w recenzji.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Gueorguieva, R., & Krystal, J. H. (2004). Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry. Archives of General Psychiatry, 61(3), 310–317. https://doi.org/10.1001/archpsyc.61.3.310
- Haverkamp, N., & Beauducel, A. (2017). Violation of the sphericity assumption and its effect on Type-I error rates in repeated measures ANOVA and multi-level linear models (MLM). Frontiers in Psychology, 8, Article 1841. https://doi.org/10.3389/fpsyg.2017.01841 ● Otwarty dostęp
- IBM Corp. (b.d.). IBM SPSS Advanced Statistics 30. IBM Documentation. Pobrano 16 października 2026 z https://www.ibm.com/docs/en/SSLVMB_30.0.0/pdf/IBM_SPSS_Advanced_Statistics.pdf ● Otwarty dostęp
- Judd, C. M., Westfall, J., & Kenny, D. A. (2012). Treating stimuli as a random factor in social psychology: A new and comprehensive solution to a pervasive but largely ignored problem. Journal of Personality and Social Psychology, 103(1), 54–69. https://doi.org/10.1037/a0028347
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
- Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001 ● Otwarty dostęp
- Meteyard, L., & Davies, R. A. I. (2020). Best practice guidance for linear mixed-effects models in psychological science. Journal of Memory and Language, 112, Article 104092. https://doi.org/10.1016/j.jml.2020.104092 ● Otwarty dostęp: pełny tekst
- Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining R² from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
Cytowania BibTeX
@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{greenhouse1959methods, author={Greenhouse, Samuel W. and Geisser, Seymour}, title={{On methods in the analysis of profile data}}, journal={Psychometrika}, year={1959}, volume={24}, number={2}, pages={95--112}, doi={10.1007/bf02289823}}@article{gueorguieva2004move, author={Gueorguieva, Ralitza and Krystal, John H.}, title={{Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry}}, journal={Archives of General Psychiatry}, year={2004}, volume={61}, number={3}, pages={310--317}, doi={10.1001/archpsyc.61.3.310}}@article{haverkamp2017violation, author={Haverkamp, Nicolas and Beauducel, André}, title={{Violation of the sphericity assumption and its effect on Type-I error rates in repeated measures ANOVA and multi-level linear models (MLM)}}, journal={Frontiers in Psychology}, year={2017}, volume={8}, eid={1841}, doi={10.3389/fpsyg.2017.01841}}@misc{ibmadvancedstatistics30, author={{IBM Corp.}}, title={{IBM SPSS Advanced Statistics 30}}, howpublished={IBM Documentation}, publisher={IBM Corp.}, url={https://www.ibm.com/docs/en/SSLVMB_30.0.0/pdf/IBM_SPSS_Advanced_Statistics.pdf}}@article{judd2012treating, author={Judd, Charles M. and Westfall, Jacob and Kenny, David A.}, title={{Treating stimuli as a random factor in social psychology: A new and comprehensive solution to a pervasive but largely ignored problem}}, journal={Journal of Personality and Social Psychology}, year={2012}, volume={103}, number={1}, pages={54--69}, doi={10.1037/a0028347}}@article{kenward1997small, author={Kenward, Michael G. and Roger, James H.}, title={{Small sample inference for fixed effects from restricted maximum likelihood}}, journal={Biometrics}, year={1997}, volume={53}, number={3}, pages={983--997}, doi={10.2307/2533558}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}@article{matuschek2017balancing, author={Matuschek, Hannes and Kliegl, Reinhold and Vasishth, Shravan and Baayen, Harald and Bates, Douglas}, title={{Balancing Type I error and power in linear mixed models}}, journal={Journal of Memory and Language}, year={2017}, volume={94}, pages={305--315}, doi={10.1016/j.jml.2017.01.001}}@article{meteyard2020best, author={Meteyard, Lotte and Davies, Robert A. I.}, title={{Best practice guidance for linear mixed-effects models in psychological science}}, journal={Journal of Memory and Language}, year={2020}, volume={112}, eid={104092}, doi={10.1016/j.jml.2020.104092}}@article{nakagawa2013general, author={Nakagawa, Shinichi and Schielzeth, Holger}, title={{A general and simple method for obtaining R² from generalized linear mixed-effects models}}, journal={Methods in Ecology and Evolution}, year={2013}, volume={4}, number={2}, pages={133--142}, doi={10.1111/j.2041-210x.2012.00261.x}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}