Dwa poziomy jednego wykresu
W badaniu podłużnym te same osoby mierzysz kilka razy. Wykres ma wtedy odpowiedzieć na dwa pytania: jak zmienia się przeciętna osoba w grupie i jak bardzo osoby różnią się przebiegiem zmiany. Linia średnich odpowiada tylko na pierwsze. Weissgerber i in. (2015) pokazali, że dane ciągłe w artykułach przedstawiano głównie na wykresach słupkowych i liniowych, a takie wykresy przy bardzo różnych rozkładach mogą wyglądać identycznie. Przy danych podłużnych ukrywają też, kto i kiedy odpadł.
Poniżej sześć rysunków jednego zbioru. Ogólne zasady wykresów (numer, tytuł, nota, eksport) są we wpisach wykresy w pracy dyplomowej i tabele i rysunki do artykułu. Porównanie grup w jednym pomiarze opisuje wpis od słupka do raincloud.
Przykład i dane
Dane są fikcyjne (symulowane). 80 studentów: 40 w ośmiotygodniowym treningu uważności, 40 na liście oczekujących. Stres (skala 0–40) mierzono w tygodniach 0, 1, 2, 4 i 8 – odstępy są celowo nierówne. Wizyty miały do 6 dni opóźnienia: „tydzień 8” to od 8.00 do 8.86 tygodnia. Część osób odpadła; szansa rezygnacji rosła z poprzednim wynikiem stresu, czyli braki są typu MAR (MCAR, MAR, MNAR). Z 400 zaplanowanych pomiarów wykonano 350; komplet ma 57 osób, a 7 osób ma tylko pomiar startowy. Na liście oczekujących połowa osób w symulacji się poprawia, a połowa pogarsza (w pliku tej informacji nie ma). Parametry ustawiono ręcznie, ziarno set.seed(563) ustalono raz, bez dobierania pod wynik. Plik w formacie długim (jeden wiersz = osoba × pomiar): dane-podluzne-stres.csv.
| Grupa | Tydz. 0 | Tydz. 1 | Tydz. 2 | Tydz. 4 | Tydz. 8 |
|---|---|---|---|---|---|
| Trening | 40 | 38 | 36 | 36 | 35 |
| Lista oczekujących | 40 | 35 | 32 | 31 | 27 |
Paleta. Grupy mają kolory Okabe–Ito (niebieski i pomarańczowy) oraz różny kształt punktu i rodzaj linii, więc kolor nie jest jedynym nośnikiem informacji. Mapy barw o nierównych gradientach i zestawienia czerwono-zielone zniekształcają dane i są nieczytelne dla osób z zaburzeniami widzenia barw (Crameri i in., 2020). W symulacji deuteranopii (colorspace::deutan, przepis 1) niebieski i pomarańczowy różnią się jasnością (44 wobec 73 w skali 0–100), więc pozostają rozróżnialne.
Rysunek 1. Linie osób (wykres spaghetti)
Zacznij od surowych danych: jedna linia na osobę, oś x w rzeczywistym czasie pomiaru. Wszystkie osoby są szarym tłem, a 20 wylosowanych (11 z treningu, 9 z listy) – kolorem.
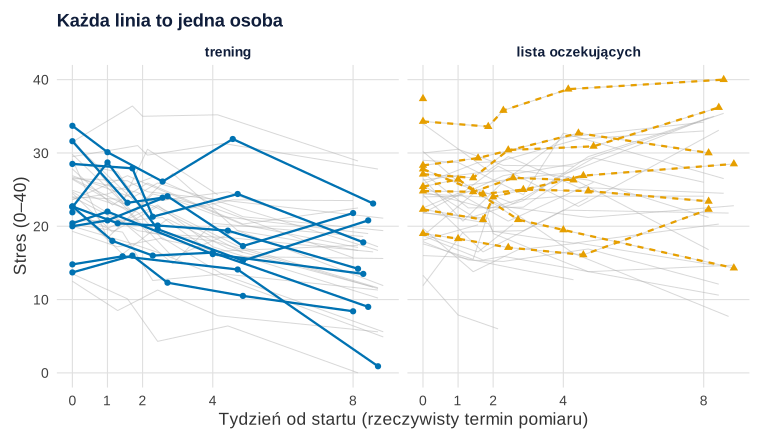
Co widać. W treningu większość linii opada, ale nie wszystkie tak samo: u kilku osób linia jest prawie płaska, a niektóre w ostatnim odcinku rosną. Na liście oczekujących linie idą w obu kierunkach, a rozrzut wyników rośnie z czasem. Punkty jednego pomiaru nie leżą na jednej pionowej linii – terminy wizyt się różnią.
Czego nie pokazuje i jak może zmylić. Osoby z jednym pomiarem (7) nie mają linii, więc wypadają z obrazu. Linia przechodzi gładko przez opuszczoną wizytę, jakby pomiar był. Wyróżnione osoby losuj. Średniej i niepewności wykres nie pokazuje.
Podpis do pracy:
Zdanie do Wyników:
Kod: przepis 2.
Rysunek 2. Średnie z 95% CI i liczbą osób pod osią
Drugi poziom to średnie grup z 95% przedziałami ufności. W panelu A punkty i przedziały obu grup w tygodniach 0–2 leżą na sobie. Panel B przesuwa grupy (position_dodge) i łączy średnie linią. Pod osią jest liczba osób: trening | lista.
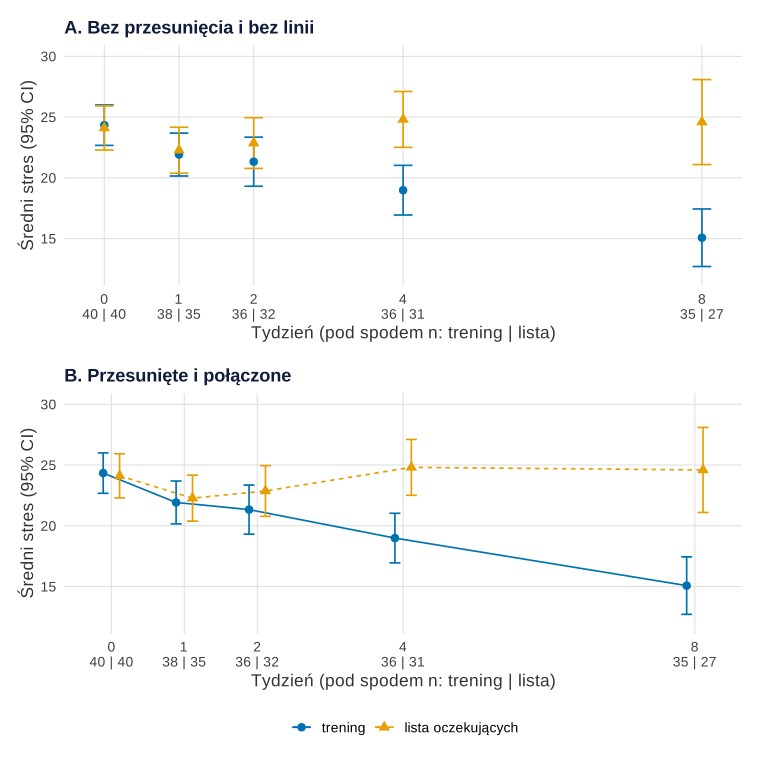
Co widać. Na starcie grupy mają prawie te same średnie: 24.3 i 24.1. W treningu stres spada do 15.1 w 8. tygodniu, 95% CI [12.7, 17.4]. Na liście oczekujących średnia waha się wokół 22–25 i w 8. tygodniu wynosi 24.6, 95% CI [21.1, 28.1]. Liczba osób spada od 40 do 35 w treningu i od 40 do 27 na liście.
Czego nie pokazuje i jak może zmylić. Linia między punktami sugeruje ciągłą zmianę, a między tygodniem 4 i 8 nie było żadnego pomiaru. Średnia z 8. tygodnia dotyczy tylko osób obecnych – przy odpadaniu to inny skład grupy niż na starcie. Reguły odczytu nakładania się przedziałów (Cumming i Finch, 2005) dotyczą grup niezależnych. Wolno więc nimi porównać dwie grupy w tym samym tygodniu, ale nie dwa pomiary tej samej grupy. Wielu badaczy myli to i nie odróżnia słupków SE od przedziałów ufności (Belia i in., 2005). Napisz w podpisie, co pokazują słupki. Przedziały dla pomiarów zależnych omawia wpis ANOVA z powtarzanymi pomiarami krok po kroku, a wykres średnich w jamovi – wpis ANOVA z powtarzanymi pomiarami w jamovi.
Podpis do pracy:
Zdanie do Wyników:
Kod: przepis 3.
Rysunek 3. Oś czasu: rzeczywiste odstępy, nie kategorie
Gdy czas jest czynnikiem, programy rysują pomiary jako równe kategorie (panel A). Panel B pokazuje te same średnie na osi ciągłej.
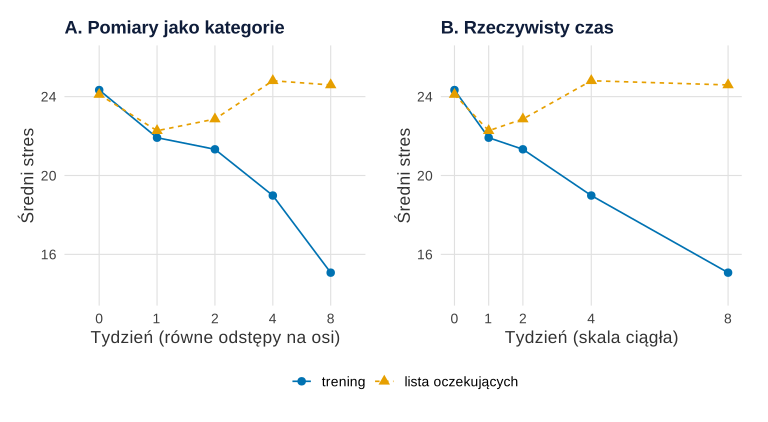
Co widać. W panelu A spadek w treningu wygląda na przyspieszający: najbardziej stromy jest ostatni odcinek. Panel B pokazuje po początkowym spadku prawie prostą linię. Przeliczone na tydzień spadki między kolejnymi pomiarami wynoszą −2.42, −0.59, −1.17 i −0.98 – ostatni odcinek wcale nie jest najszybszy, jest po prostu czterotygodniowy.
Czego nie pokazuje i jak może zmylić. Oba panele umieszczają średnie w tygodniach z planu, a rzeczywiste wizyty były do 6 dni później. Gdy terminy różnią się między osobami, lepiej modelować rzeczywisty czas każdej osoby. Mehta i West (2000) pokazali, że gdy osoby wchodzą do badania w różnym wieku, analiza oparta na średnich i kowariancjach daje obciążone oszacowania wariancji wyrazu wolnego i jego kowariancji z nachyleniem. Analiza indywidualnych danych daje oszacowania zgodne z modelem wielopoziomowym.
Podpis do pracy:
Zdanie do Wyników:
Kod: przepis 4.
Rysunek 4. Wybrane osoby w osobnych panelach
Do trajektorii potrzebny jest model. Dopasowano model mieszany w pakiecie lme4 (Bates i in., 2015): stres zależy od czasu w tygodniach, grupy i ich interakcji, z losowym wyrazem wolnym i losowym nachyleniem czasu dla osób. W treningu stres spadał średnio o 1.03 punktu na tydzień (SE = 0.11). Na liście oczekujących nachylenie było większe o 1.11 (SE = 0.16), czyli wynosiło 0.08. Odchylenie standardowe nachyleń osób wyniosło 0.55, a reszt 2.51. Budowę modelu opisuje wpis modele wzrostu w lme4. Rysunek 4 pokazuje sześć osób wybranych ręcznie tak, by różniły się kierunkiem zmiany i liczbą pomiarów.
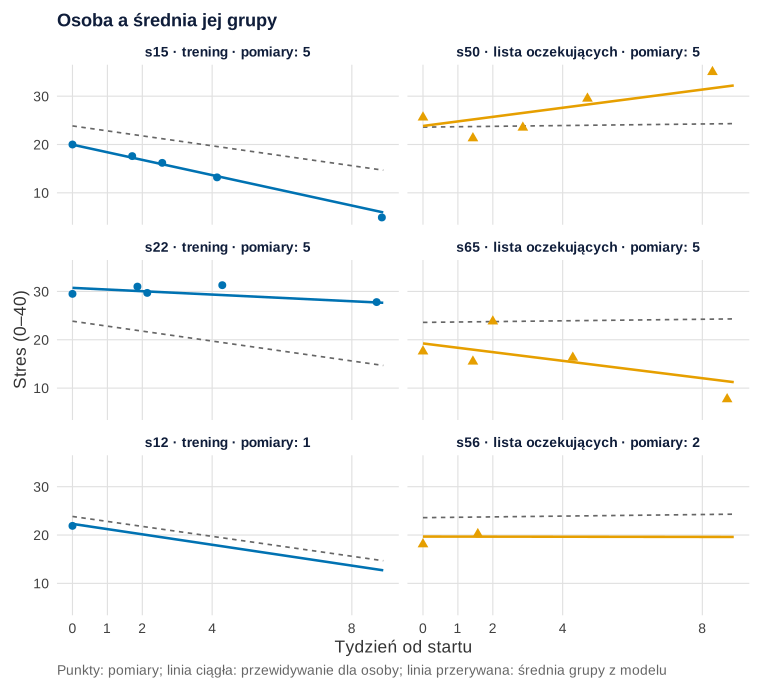
Co widać. Osoba s15 poprawia się szybciej niż jej grupa (−1.58 wobec −1.03 na tydzień), a s22 prawie wcale (−0.35). Na liście oczekujących s50 pogarsza się (0.94), a s65 poprawia (−0.90), choć średnia grupy jest płaska. Osoba s12 ma jeden pomiar: jej linia biegnie prawie równolegle do średniej grupy (nachylenie −1.08 wobec −1.03), bo model zna tylko jej wynik startowy.
Czego nie pokazuje i jak może zmylić. Linia osoby to przewidywanie modelu, nie dane. Przy jednym lub dwóch pomiarach model „pożycza” nachylenie od grupy (ściąganie do średniej, efekty losowe). Linia s12 po tygodniu 0 to ekstrapolacja.
Podpis do pracy:
Zdanie do Wyników:
Kod: przepis 5 (model) i przepis 6 (rysunek).
Rysunek 5. Trajektorie z modelu: średnia i osoby
Rysunek łączy oba poziomy. Gruba linia to przewidywanie z efektów stałych z 95% CI, cienkie linie – przewidywania dla osób w zakresie czasu, w którym były mierzone, a krzyżyki – średnie obserwowane z Rysunku 2. Biesanz i in. (2004) zalecają wykreślać efekty w całym przedziale czasu z przedziałami ufności, bo znaczenie parametrów zależy od kodowania czasu.
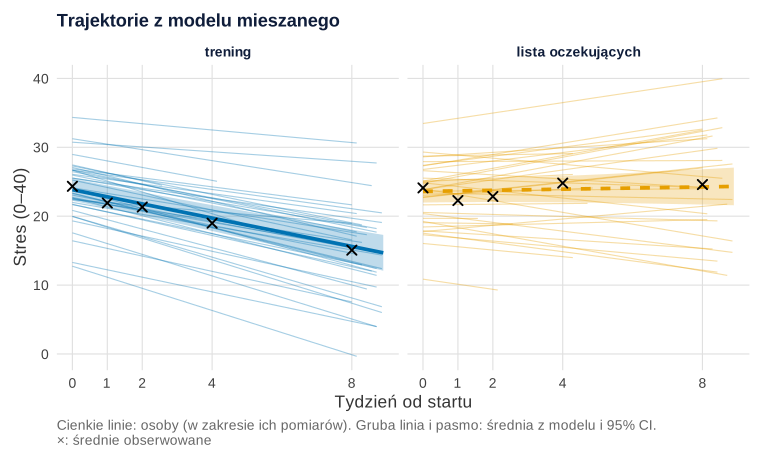
Co widać. Model dobrze odtwarza średnie obserwowane. W 8. tygodniu przewiduje 15.6 w treningu, 95% CI [13.2, 18.1], przy średniej obserwowanej 15.1. Na liście oczekujących przewiduje 24.2 [21.7, 26.8] przy obserwowanej 24.6. Różnice wynikają m.in. z tego, że model korzysta z wcześniejszych pomiarów osób, które później odpadły. Przy brakach MAR to jego przewaga nad średnimi z dostępnych danych (porównanie podejść: ANOVA czy model mieszany).
Czego nie pokazuje i jak może zmylić. Pasmo to przedział ufności średniej, a nie zakres, w którym znajdzie się większość osób – rozrzut osób widać w cienkich liniach (różnicę pasma ufności i predykcji omawia wpis wynik regresji na wykresie). Model liniowy rysuje proste, nawet gdy zmiana jest krzywoliniowa. Część linii schodzi w okolice 0 i 40, czyli do krańców skali; model nie wie, że skala ma granice.
Podpis do pracy:
Zdanie do Wyników:
Kod: przepis 7. Ten sam typ rysunku dla modelu w programie jamovi pokazuje wpis model mieszany w jamovi, a w SPSS – MIXED w SPSS. Opis modelu w tekście pracy: jak opisać wyniki modelu mieszanego.
Rysunek 6. Płaska średnia, dwa kierunki zmiany
Czy płaska średnia oznacza, że osoby się nie zmieniają? Dla każdej osoby z co najmniej trzema pomiarami policzono prostą regresji stresu na czasie. W panelu A osoby podzielono według znaku nachylenia, a panel B pokazuje rozkład nachyleń w obu grupach.
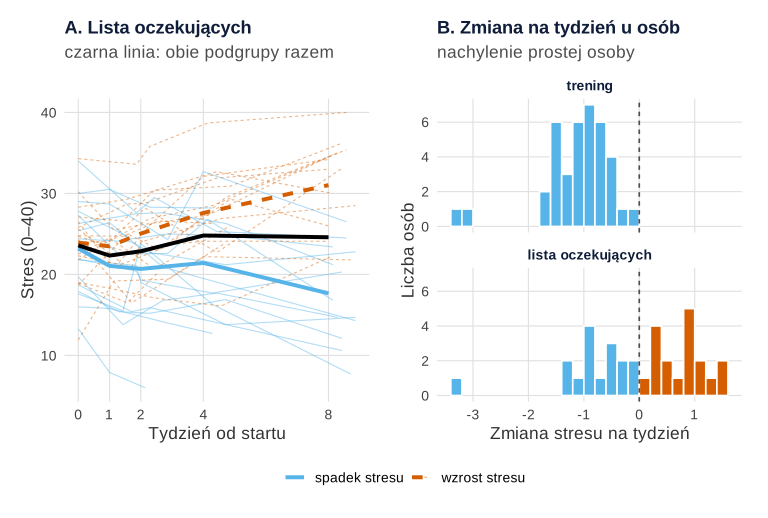
Co widać. Średnia zmiana na liście oczekujących wynosi 0.00 punktu na tydzień, ale 16 z 34 osób ma spadek stresu, a 18 wzrost. Rozkład nachyleń jest tam szeroki (SD = 1.01) i ma dwa skupienia po obu stronach zera. W treningu wszystkie 38 osób ma nachylenie ujemne (M = −1.11, SD = 0.63). Krzywa średnia nie musi przypominać przebiegu żadnej osoby – to klasyczny problem wnioskowania z krzywych grupowych (Estes, 1956).
Czego nie pokazuje i jak może zmylić. Podział według znaku nachylenia jest robiony po fakcie: osoba z nachyleniem 0.05 trafia do „wzrostu”, choć jej zmiana mieści się w błędzie pomiaru. Nachylenie z trzech pomiarów bliskich w czasie jest bardzo niepewne – stąd skrajne wartości poniżej −3. To sygnał do sprawdzenia, nie dowód dwóch typów osób. Klasy trajektorii bada się modelami LCGA i GMM (trajektorie rozwojowe), a zmienność wewnątrz osoby oddziela się od różnic między osobami tak, jak we wpisie efekty wewnątrz- i międzyosobowe.
Podpis do pracy:
Zdanie do Wyników:
Kod: przepis 8.
Które rysunki do pracy
- Zawsze: średnie z CI i liczbą osób (Rysunek 2) albo – przy modelu mieszanym – przewidywania modelu (Rysunek 5).
- Prawie zawsze: linie osób (Rysunek 1) – w tekście albo w aneksie.
- Gdy pasuje do pytania: panele osób (Rysunek 4) przy małych próbach, rozkład nachyleń (Rysunek 6), gdy pytasz o różnice w tempie zmiany.
Wykresy samych braków omawia wpis braki danych na wykresie.
Kod R wszystkich rysunków
Pobierz plik dane-podluzne-stres.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – kolejne korzystają z obiektów utworzonych wcześniej. Kod jest samowystarczalny: motyw i paletę definiuje przepis 1, a każdy rysunek zapisuje ggsave() do pliku SVG. Rysunki na tej stronie mają motyw serwisu (krój i kolor tytułów); dane, geometrie i skale są te same co w pokazanym kodzie. Ziarno danych i ziarno losowania 20 wyróżnionych osób (oba 563) ustalono raz, bez dobierania pod wynik; sześć osób na Rysunku 4 wybrano ręcznie.
1. Dane, liczba osób w pomiarach i paleta
R
# Dane podłużne na wykresie: ustawienia, dane i liczba osób w każdym pomiarze (dane fikcyjne)
library(ggplot2); library(patchwork); library(lme4)
options(width = 100)
dane <- read.csv("dane-podluzne-stres.csv", encoding = "UTF-8")
dane$grupa <- factor(dane$grupa, levels = c("trening", "lista oczekujących"))
obs <- subset(dane, !is.na(stres))               # tylko wykonane pomiary (format długi)
head(dane, 5)

# ile osób ma pomiar w każdej fali – te liczby trafią pod oś wykresu
n_fala <- table(obs$grupa, obs$tydzien_plan)
n_fala
# rzeczywiste terminy pomiarów w każdej fali (w tygodniach od startu)
round(sapply(split(obs$tydzien, obs$tydzien_plan), range), 2)
# ile osób ma 1, 2, ..., 5 pomiarów
table(liczba_pomiarow = tapply(!is.na(dane$stres), dane$id, sum))

# wspólny motyw i paleta Okabe–Ito; grupy różnią się też kształtem punktu i rodzajem linii
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"), strip.text = element_text(face = "bold"),
        plot.caption = element_text(hjust = 0, colour = "grey40"),
        plot.background = element_rect(fill = "white", colour = NA))
paleta  <- c("trening" = "#0072B2", "lista oczekujących" = "#E69F00")
ksztalt <- c("trening" = 16, "lista oczekujących" = 17)
linia   <- c("trening" = "solid", "lista oczekujących" = "22")
paleta_zmiana <- c("spadek stresu" = "#56B4E9", "wzrost stresu" = "#D55E00")

# kontrola czytelności: barwy w symulacji deuteranopii i ich jasność (L w skali 0–100)
kolory <- c(paleta, paleta_zmiana)
jasnosc <- function(k) round(colorspace::coords(as(colorspace::hex2RGB(k), "polarLUV"))[, "L"])
data.frame(kolor = kolory, deutan = colorspace::deutan(kolory),
           L = jasnosc(kolory), L_deutan = jasnosc(colorspace::deutan(kolory)))
Wynik w R
   id   grupa pomiar tydzien_plan tydzien stres
1 s01 trening      1            0    0.00  14.8
2 s01 trening      2            1    1.43  15.9
3 s01 trening      3            2      NA    NA
4 s01 trening      4            4    4.71  14.1
5 s01 trening      5            8    8.71   0.9

                      0  1  2  4  8
  trening            40 38 36 36 35
  lista oczekujących 40 35 32 31 27
     0    1    2    4    8
[1,] 0 1.00 2.00 4.00 8.00
[2,] 0 1.86 2.86 4.86 8.86
liczba_pomiarow
 1  2  3  4  5
 7  1  4 11 57
                     kolor  deutan  L L_deutan
trening            #0072B2 #3B67B1 46       44
lista oczekujących #E69F00 #CAB411 71       73
spadek stresu      #56B4E9 #87A4E8 70       68
wzrost stresu      #D55E00 #9E8C00 54       58
2. Rysunek 1 – wykres spaghetti
R
# Rysunek 1. Wykres spaghetti: wszystkie osoby w tle, 20 losowych osób wyróżnionych (kontynuacja: obs, motyw, paleta)
set.seed(563)                                        # losowanie 20 osób do wyróżnienia
wyroznione <- sample(unique(obs$id), 20)
rys1 <- ggplot(obs, aes(tydzien, stres, group = id)) +
  geom_line(colour = "grey70", alpha = 0.5, linewidth = 0.35) +   # tło: wszystkie osoby z grupy
  geom_line(data = subset(obs, id %in% wyroznione), aes(colour = grupa, linetype = grupa), linewidth = 0.8) +
  geom_point(data = subset(obs, id %in% wyroznione), aes(colour = grupa, shape = grupa), size = 1.8) +
  facet_wrap(~ grupa) +
  scale_x_continuous(breaks = c(0, 1, 2, 4, 8)) +
  scale_colour_manual(values = paleta) + scale_shape_manual(values = ksztalt) +
  scale_linetype_manual(values = linia) +
  labs(title = "Każda linia to jedna osoba", x = "Tydzień od startu (rzeczywisty termin pomiaru)",
       y = "Stres (0–40)", colour = NULL, shape = NULL, linetype = NULL) +
  motyw + theme(legend.position = "none")
ggsave("dane-podluzne-spaghetti.svg", rys1, width = 8, height = 4.6)
table(grupa = obs$grupa[!duplicated(obs$id) & obs$id %in% wyroznione])   # ile wyróżnionych w grupach
Wynik w R
grupa
           trening lista oczekujących
                11                  9
3. Rysunek 2 – średnie z 95% CI i liczbą osób pod osią
R
# Rysunek 2. Średnie z 95% CI w grupach: bez przesunięcia i z przesunięciem, z liczbą osób pod osią
# (kontynuacja: obs, n_fala, motyw, paleta)
srednie <- do.call(rbind, lapply(split(obs, list(obs$grupa, obs$tydzien_plan)), function(d) {
  n <- nrow(d); M <- mean(d$stres); SD <- sd(d$stres); t <- qt(.975, n - 1)
  data.frame(grupa = d$grupa[1], tydzien_plan = d$tydzien_plan[1], n = n, M = M, SD = SD,
             dolna = M - t * SD / sqrt(n), gorna = M + t * SD / sqrt(n))
}))
rownames(srednie) <- NULL
print(transform(srednie, M = round(M, 1), SD = round(SD, 1), dolna = round(dolna, 1), gorna = round(gorna, 1)))

# etykiety osi: tydzień i pod nim n w grupach (trening | lista)
etyk_n <- paste0(colnames(n_fala), "\n", n_fala["trening", ], " | ", n_fala["lista oczekujących", ])
skala_x <- scale_x_continuous(breaks = c(0, 1, 2, 4, 8), labels = etyk_n)
wspolne <- list(scale_colour_manual(values = paleta), scale_shape_manual(values = ksztalt), skala_x, coord_cartesian(ylim = c(12, 30)),
                labs(x = "Tydzień (pod spodem n: trening | lista)", y = "Średni stres (95% CI)",
                     colour = NULL, shape = NULL, linetype = NULL), motyw)
rys2a <- ggplot(srednie, aes(tydzien_plan, M, colour = grupa, shape = grupa)) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.25) +
  geom_point(size = 2.6) + wspolne + labs(title = "A. Bez przesunięcia i bez linii") +
  theme(legend.position = "none")
przes <- position_dodge(width = 0.45)
rys2b <- ggplot(srednie, aes(tydzien_plan, M, colour = grupa, shape = grupa, linetype = grupa)) +
  geom_line(position = przes) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.3, linetype = "solid", position = przes) +
  geom_point(size = 2.6, position = przes) + scale_linetype_manual(values = linia) + wspolne + labs(title = "B. Przesunięte i połączone")
rys2 <- rys2a / rys2b                                # panele jeden pod drugim: szeroka oś czasu
ggsave("dane-podluzne-srednie-ci.svg", rys2, width = 8, height = 8)
Wynik w R
                grupa tydzien_plan  n    M  SD dolna gorna
1             trening            0 40 24.3 5.2  22.7  26.0
2  lista oczekujących            0 40 24.1 5.7  22.3  25.9
3             trening            1 38 21.9 5.4  20.2  23.7
4  lista oczekujących            1 35 22.3 5.5  20.4  24.2
5             trening            2 36 21.3 6.0  19.3  23.3
6  lista oczekujących            2 32 22.9 5.8  20.8  25.0
7             trening            4 36 19.0 6.0  16.9  21.0
8  lista oczekujących            4 31 24.8 6.3  22.5  27.1
9             trening            8 35 15.1 6.9  12.7  17.4
10 lista oczekujących            8 27 24.6 8.8  21.1  28.1
4. Rysunek 3 – oś kategorii a oś czasu
R
# Rysunek 3. Oś czasu: pomiary jako równe kategorie a rzeczywiste odstępy (kontynuacja: srednie, motyw, paleta)
os_wspolne <- list(geom_line(), geom_point(size = 2.6),
                   scale_colour_manual(values = paleta), scale_shape_manual(values = ksztalt),
                   scale_linetype_manual(values = linia), coord_cartesian(ylim = c(14, 26)),
                   labs(y = "Średni stres", colour = NULL, shape = NULL, linetype = NULL), motyw)
rys3a <- ggplot(srednie, aes(factor(tydzien_plan), M, group = grupa, colour = grupa,
                             shape = grupa, linetype = grupa)) +
  os_wspolne + labs(title = "A. Pomiary jako kategorie", x = "Tydzień (równe odstępy na osi)")
rys3b <- ggplot(srednie, aes(tydzien_plan, M, colour = grupa, shape = grupa, linetype = grupa)) +
  os_wspolne + scale_x_continuous(breaks = c(0, 1, 2, 4, 8)) +
  labs(title = "B. Rzeczywisty czas", x = "Tydzień (skala ciągła)")
rys3 <- rys3a + rys3b + plot_layout(guides = "collect") & theme(legend.position = "bottom")
ggsave("dane-podluzne-os-czasu.svg", rys3, width = 8, height = 4.4)
# spadek w grupie treningowej na tydzień między kolejnymi pomiarami
tr <- subset(srednie, grupa == "trening")
round(diff(tr$M) / diff(tr$tydzien_plan), 2)
Wynik w R
[1] -2.42 -0.59 -1.17 -0.985. Model mieszany i przewidywania
R
# Model mieszany: czas rzeczywisty, grupa i ich interakcja, losowy wyraz wolny i nachylenie (kontynuacja: obs, srednie)
m <- lmer(stres ~ tydzien * grupa + (tydzien | id), data = obs)
round(summary(m)$coefficients, 2)
print(VarCorr(m), digits = 2)

# przewidywania stałe (średnia trajektoria grupy) z 95% CI z macierzy kowariancji efektów stałych
siatka <- expand.grid(tydzien = seq(0, 8.9, by = 0.1), grupa = levels(obs$grupa))
X <- model.matrix(~ tydzien * grupa, siatka)
siatka$stres <- drop(X %*% fixef(m))
se <- sqrt(rowSums((X %*% as.matrix(vcov(m))) * X))
siatka$dolna <- siatka$stres - 1.96 * se
siatka$gorna <- siatka$stres + 1.96 * se

# przewidywania osobnicze (efekty stałe + losowe) w zakresie czasu, w którym osoba była mierzona
zakres <- aggregate(tydzien ~ id + grupa, data = obs, FUN = range)
osobnicze <- do.call(rbind, lapply(seq_len(nrow(zakres)), function(i)
  data.frame(id = zakres$id[i], grupa = zakres$grupa[i],
             tydzien = seq(zakres$tydzien[i, 1], zakres$tydzien[i, 2], length.out = 20))))
osobnicze$stres <- predict(m, newdata = osobnicze)

# tydzień 8: średnia obserwowana (tylko osoby obecne) a średnia z modelu (wszyscy, przy założeniu MAR)
t8 <- subset(siatka, abs(tydzien - 8) < 1e-8)
data.frame(grupa = t8$grupa, obserwowana = round(subset(srednie, tydzien_plan == 8)$M, 1),
           z_modelu = round(t8$stres, 1), dolna = round(t8$dolna, 1), gorna = round(t8$gorna, 1))
Wynik w R
                                Estimate Std. Error t value
(Intercept)                        23.85       0.82   29.07
tydzien                            -1.03       0.11   -9.28
grupalista oczekujących            -0.25       1.16   -0.21
tydzien:grupalista oczekujących     1.11       0.16    6.74
 Groups   Name        Std.Dev. Corr
 id       (Intercept) 4.88
          tydzien     0.55     0.29
 Residual             2.51
               grupa obserwowana z_modelu dolna gorna
1            trening        15.1     15.6  13.2  18.1
2 lista oczekujących        24.6     24.2  21.7  26.8
6. Rysunek 4 – wybrane osoby
R
# Rysunek 4. Wybrane osoby w osobnych panelach: pomiary, linia osoby z modelu i średnia linia grupy
# (kontynuacja: obs, m, siatka, motyw, paleta)
wybrane <- c("s15", "s50", "s22", "s65", "s12", "s56")   # wybrane ręcznie: różne kierunki zmiany i liczba pomiarów
n_osoby <- table(obs$id)
etykieta <- function(id) {
  g <- as.character(obs$grupa[match(id, obs$id)])
  factor(paste0(id, " · ", g, " · pomiary: ", n_osoby[id]),
         levels = paste0(wybrane, " · ", as.character(obs$grupa[match(wybrane, obs$id)]),
                         " · pomiary: ", n_osoby[wybrane]))
}
pom <- subset(obs, id %in% wybrane)
pom$panel <- etykieta(pom$id)
linie_osob <- expand.grid(tydzien = seq(0, 8.9, by = 0.1), id = wybrane, stringsAsFactors = FALSE)
linie_osob$grupa <- obs$grupa[match(linie_osob$id, obs$id)]
linie_osob$osoba <- predict(m, newdata = linie_osob)                 # efekty stałe + losowe tej osoby
linie_osob$srednia <- predict(m, newdata = linie_osob, re.form = NA)  # tylko efekty stałe (średnia grupy)
linie_osob$panel <- etykieta(linie_osob$id)
rys4 <- ggplot(linie_osob, aes(tydzien)) +
  geom_line(aes(y = srednia), colour = "grey40", linetype = "22") +
  geom_line(aes(y = osoba, colour = grupa), linewidth = 0.9) +
  geom_point(data = pom, aes(y = stres, colour = grupa, shape = grupa), size = 2.4) +
  facet_wrap(~ panel, ncol = 2) +
  scale_x_continuous(breaks = c(0, 1, 2, 4, 8)) +
  scale_colour_manual(values = paleta) + scale_shape_manual(values = ksztalt) +
  labs(title = "Osoba a średnia jej grupy", x = "Tydzień od startu", y = "Stres (0–40)",
       colour = NULL, shape = NULL,
       caption = "Punkty: pomiary; linia ciągła: przewidywanie dla osoby; linia przerywana: średnia grupy z modelu") +
  motyw + theme(legend.position = "none")
ggsave("dane-podluzne-wybrane-osoby.svg", rys4, width = 8, height = 7.2)
# nachylenia (zmiana na tydzień): osoby z modelu a średnia ich grupy
k <- coef(m)$id[wybrane, ]
lista <- obs$grupa[match(wybrane, obs$id)] == "lista oczekujących"
data.frame(pomiary = as.vector(n_osoby[wybrane]),
           nachylenie_osoby = round(k$tydzien + lista * k$`tydzien:grupalista oczekujących`, 2),
           nachylenie_grupy = round(fixef(m)["tydzien"] + lista * fixef(m)["tydzien:grupalista oczekujących"], 2),
           row.names = wybrane)
Wynik w R
    pomiary nachylenie_osoby nachylenie_grupy
s15       5            -1.58            -1.03
s50       5             0.94             0.08
s22       5            -0.35            -1.03
s65       5            -0.90             0.08
s12       1            -1.08            -1.03
s56       2            -0.01             0.08
7. Rysunek 5 – trajektorie z modelu
R
# Rysunek 5. Trajektorie z modelu mieszanego: linie osób (efekty stałe + losowe) i średnia grupy z 95% CI
# (kontynuacja: osobnicze, siatka, srednie, motyw, paleta)
rys5 <- ggplot(siatka, aes(tydzien, stres)) +
  geom_line(data = osobnicze, aes(group = id, colour = grupa), alpha = 0.35, linewidth = 0.4) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna, fill = grupa), alpha = 0.25) +
  geom_line(aes(colour = grupa, linetype = grupa), linewidth = 1.3) +
  geom_point(data = srednie, aes(tydzien_plan, M), shape = 4, size = 2.6, stroke = 1, colour = "black") +
  facet_wrap(~ grupa) +
  scale_x_continuous(breaks = c(0, 1, 2, 4, 8)) +
  scale_colour_manual(values = paleta) + scale_fill_manual(values = paleta) +
  scale_linetype_manual(values = linia) +
  labs(title = "Trajektorie z modelu mieszanego", x = "Tydzień od startu", y = "Stres (0–40)",
       caption = "Cienkie linie: osoby (w zakresie ich pomiarów). Gruba linia i pasmo: średnia z modelu i 95% CI.\n×: średnie obserwowane") +
  motyw + theme(legend.position = "none")
ggsave("dane-podluzne-trajektorie-model.svg", rys5, width = 8, height = 4.8)
8. Rysunek 6 – płaska średnia i rozkład nachyleń
R
# Rysunek 6. Płaska średnia, dwa kierunki zmiany: nachylenia z prostych regresji osób (≥ 3 pomiary)
# (kontynuacja: obs, motyw, paleta_zmiana)
nachyl <- do.call(rbind, lapply(split(obs, obs$id), function(d) {
  if (nrow(d) < 3) return(NULL)
  data.frame(id = d$id[1], grupa = d$grupa[1], b = unname(coef(lm(stres ~ tydzien, data = d))[2]))
}))
nachyl$kierunek <- factor(ifelse(nachyl$b < 0, "spadek stresu", "wzrost stresu"), levels = names(paleta_zmiana))
table(nachyl$grupa, nachyl$kierunek)
round(sapply(split(nachyl$b, nachyl$grupa), function(b) c(M = mean(b), SD = sd(b), min = min(b), max = max(b))), 2)

lista <- merge(subset(obs, grupa == "lista oczekujących"), nachyl[, c("id", "kierunek")])
sr_kier <- aggregate(stres ~ kierunek + tydzien_plan, data = lista, FUN = mean)
sr_all  <- aggregate(stres ~ tydzien_plan, data = lista, FUN = mean)
rys6a <- ggplot(lista, aes(tydzien, stres)) +
  geom_line(aes(group = id, colour = kierunek, linetype = kierunek), alpha = 0.45, linewidth = 0.4) +
  geom_line(data = sr_kier, aes(tydzien_plan, stres, colour = kierunek, linetype = kierunek), linewidth = 1.4) +
  geom_line(data = sr_all, aes(tydzien_plan, stres), colour = "black", linewidth = 1.4) +
  scale_x_continuous(breaks = c(0, 1, 2, 4, 8)) +
  scale_colour_manual(values = paleta_zmiana) + scale_linetype_manual(values = c("solid", "22")) +
  labs(title = "A. Lista oczekujących", subtitle = "czarna linia: obie podgrupy razem",
       x = "Tydzień od startu", y = "Stres (0–40)", colour = NULL, linetype = NULL) + motyw
rys6b <- ggplot(nachyl, aes(b, fill = kierunek)) +
  geom_histogram(binwidth = 0.2, boundary = 0, colour = "white") +
  geom_vline(xintercept = 0, linetype = "22", colour = "grey30") +
  facet_wrap(~ grupa, ncol = 1) +
  scale_fill_manual(values = paleta_zmiana) +
  labs(title = "B. Zmiana na tydzień u osób", subtitle = "nachylenie prostej osoby",
       x = "Zmiana stresu na tydzień", y = "Liczba osób", fill = NULL) + motyw +
  theme(legend.position = "none")
rys6 <- rys6a + rys6b + plot_layout(guides = "collect") +
  plot_annotation(theme = theme(legend.position = "bottom"))
ggsave("dane-podluzne-dwa-kierunki-zmiany.svg", rys6, width = 8, height = 5.4)
Wynik w R
                     spadek stresu wzrost stresu
  trening                       38             0
  lista oczekujących            16            18
    trening lista oczekujących
M     -1.11               0.00
SD     0.63               1.01
min   -3.21              -3.37
max    0.00               1.46
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Sama linia średnich bez linii osób.
- Brak liczby osób w pomiarach – nie widać, że w 8. tygodniu średnia dotyczy 27, nie 40 osób.
- Czas jako równe kategorie przy nierównych odstępach – zmienia pozorny kształt zmiany.
- Wnioski o zmianie w czasie z nakładania się przedziałów pomiarów zależnych.
- Linie osób z modelu narysowane poza zakresem ich pomiarów bez zaznaczenia, że to ekstrapolacja.
- Podpis bez informacji, co pokazują słupki (SD, SE czy 95% CI) i czy dane są obserwowane, czy z modelu.
Najczęstsze pytania
Jak zrobić wykres spaghetti w R?
Przygotuj dane w formacie długim (osoba, czas, wynik) i w ggplot2 użyj geom_line(aes(group = id)). Przy kilkudziesięciu osobach daj liniom szary kolor i przezroczystość, a kilka losowo wybranych osób wyróżnij kolorem. Na osi x umieść rzeczywisty czas pomiaru, a grupy pokaż w osobnych panelach.
Czy łączyć średnie z kolejnych pomiarów linią?
Tak, gdy to ta sama grupa mierzona w czasie – linia pomaga śledzić zmianę. Pamiętaj jednak, że między punktami nie było pomiarów, a przy odpadaniu kolejne średnie dotyczą innego składu osób. Dlatego pod osią podaj liczbę osób w każdym pomiarze, a punkty grup przesuń (position_dodge), żeby przedziały się nie zasłaniały.
Czy z nakładania się przedziałów ufności na wykresie można wnioskować o zmianie w czasie?
Nie. Reguły odczytu nakładania się przedziałów dotyczą grup niezależnych, np. dwóch grup w tym samym tygodniu. Zmiana w czasie w tej samej grupie dotyczy pomiarów zależnych – o niej rozstrzyga model albo przedział ufności dla różnicy, a nie wygląd dwóch przedziałów na wykresie.
Jak narysować trajektorie z modelu mieszanego lme4?
Średnią trajektorię grupy policz z efektów stałych: predict(m, newdata, re.form = NA), a jej 95% przedział ufności z macierzy vcov(m). Linie osób daje predict(m, newdata), czyli efekty stałe plus losowe. Linie osób rysuj tylko w zakresie czasu, w którym dana osoba była mierzona.
Dlaczego średnia zmiana w grupie może być bliska zera, choć osoby się zmieniają?
Bo w grupie mogą być osoby, które się poprawiają, i osoby, które się pogarszają – ich zmiany się znoszą. W przykładzie średnia zmiana na liście oczekujących wyniosła 0.00 na tydzień, a 16 z 34 osób miało spadek stresu, 18 wzrost. Taki obraz widać na liniach osób i na rozkładzie nachyleń, nie na wykresie średnich.
Powiązane hasła
Przeczytaj też
Modele wzrostu w lme4
Losowy wyraz wolny i nachylenie czasu, kodowanie czasu, nieregularne terminy, predyktor × czas, braki MAR, porównanie z LGM i wzór opisu APA.
Czytaj →PoradnikPorównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Masz dane z kilku pomiarów i nie wiesz, jak je pokazać?
Pomożemy dobrać wykresy do schematu badania, dopasować model mieszany i opisać trajektorie tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Belia, S., Fidler, F., Williams, J., & Cumming, G. (2005). Researchers misunderstand confidence intervals and standard error bars. Psychological Methods, 10(4), 389–396. https://doi.org/10.1037/1082-989x.10.4.389
- Biesanz, J. C., Deeb-Sossa, N., Papadakis, A. A., Bollen, K. A., & Curran, P. J. (2004). The role of coding time in estimating and interpreting growth curve models. Psychological Methods, 9(1), 30–52. https://doi.org/10.1037/1082-989x.9.1.30
- Crameri, F., Shephard, G. E., & Heron, P. J. (2020). The misuse of colour in science communication. Nature Communications, 11(1), Article 5444. https://doi.org/10.1038/s41467-020-19160-7 ● Otwarty dostęp
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Estes, W. K. (1956). The problem of inference from curves based on group data. Psychological Bulletin, 53(2), 134–140. https://doi.org/10.1037/h0045156
- Mehta, P. D., & West, S. G. (2000). Putting the individual back into individual growth curves. Psychological Methods, 5(1), 23–43. https://doi.org/10.1037/1082-989x.5.1.23
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{belia2005researchers, author={Belia, Sarah and Fidler, Fiona and Williams, Jennifer and Cumming, Geoff}, title={{Researchers misunderstand confidence intervals and standard error bars}}, journal={Psychological Methods}, year={2005}, volume={10}, number={4}, pages={389--396}, doi={10.1037/1082-989x.10.4.389}}@article{biesanz2004role, author={Biesanz, Jeremy C. and Deeb-Sossa, Natalia and Papadakis, Alison A. and Bollen, Kenneth A. and Curran, Patrick J.}, title={{The role of coding time in estimating and interpreting growth curve models}}, journal={Psychological Methods}, year={2004}, volume={9}, number={1}, pages={30--52}, doi={10.1037/1082-989x.9.1.30}}@article{crameri2020misuse, author={Crameri, Fabio and Shephard, Grace E. and Heron, Philip J.}, title={{The misuse of colour in science communication}}, journal={Nature Communications}, year={2020}, volume={11}, number={1}, eid={5444}, doi={10.1038/s41467-020-19160-7}}@article{cumming2005inference, author={Cumming, Geoff and Finch, Sue}, title={{Inference by eye: Confidence intervals and how to read pictures of data}}, journal={American Psychologist}, year={2005}, volume={60}, number={2}, pages={170--180}, doi={10.1037/0003-066x.60.2.170}}@article{estes1956problem, author={Estes, W. K.}, title={{The problem of inference from curves based on group data}}, journal={Psychological Bulletin}, year={1956}, volume={53}, number={2}, pages={134--140}, doi={10.1037/h0045156}}@article{mehta2000putting, author={Mehta, Paras D. and West, Stephen G.}, title={{Putting the individual back into individual growth curves}}, journal={Psychological Methods}, year={2000}, volume={5}, number={1}, pages={23--43}, doi={10.1037/1082-989x.5.1.23}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}