lmerTest przepisz b, SE, t, df i p, a z części „Random effects” – wariancje albo SD (zawsze napisz które). W przykładzie efekt hałasu wyniósł b = −3.64 punktu, ICC = .625, R²m = .133, a R²c = .762.Co jest inne w opisie modelu mieszanego
Opis zwykłej regresji mieści się w jednym akapicie: współczynniki, R² i test całego modelu. Model mieszany (wielopoziomowy) ma dwie części. Efekty stałe odpowiadają na pytania badawcze, a efekty losowe opisują, jak bardzo osoby, klasy czy szkoły różnią się od siebie. Czytelnik musi znać obie części, żeby zrozumieć wynik. Do tego w lmer wartości p nie pojawiają się same, a w wydruku jest kilka liczb, które w pracy zwykle się pomija.
Meteyard i Davies (2020) przejrzeli 400 artykułów z liniowymi modelami mieszanymi i przeprowadzili ankietę wśród 163 badaczy. Najwięcej rozbieżności dotyczyło właśnie raportowania, dlatego autorzy sformułowali zalecenia skupione na opisie modelu. Ten wpis zakłada, że model już masz. Jak go zbudować krok po kroku, pokazuje model wielopoziomowy krok po kroku w R, a kiedy wybrać go zamiast ANOVA – wpis ANOVA z powtarzanymi pomiarami czy model mieszany. Tu zajmujemy się tylko tym, co i jak przepisać do pracy.
Przykład: hałas a wynik testu uwagi
Studentka bada, czy hałas w tle obniża wyniki w teście uwagi. Każda z 64 osób rozwiązała sześć bloków testu: trzy w ciszy i trzy przy nagranym hałasie biurowym, w kolejności naprzemiennej, różnej dla połowy osób. Wynik bloku to liczba poprawnych odpowiedzi (0–60). Przed badaniem każdy wypełnił krótką skalę wrażliwości na hałas (1–5). Z powodu awarii komputera przepadło 9 bloków. Zostało 375 obserwacji: 56 osób ma wszystkie sześć bloków, 7 osób – pięć, a jedna – cztery. Dane są symulowane, można je pobrać w pliku CSV, a wszystkie liczby pochodzą z kodu na końcu wpisu.
Obserwacje tej samej osoby nie są niezależne. Zwykły test t na 375 blokach traktowałby je jak 375 różnych osób – to pseudoreplikacja. Dane są w formacie długim: jeden wiersz to jeden blok. Model końcowy ma postać:
Hałas zakodowano 0 = cisza, 1 = hałas. Wrażliwość wycentrowano względem średniej osób (M = 3.07, SD = 0.80), więc efekt hałasu dotyczy osoby o przeciętnej wrażliwości. Część (1 + hałas | osoba) oznacza, że każda osoba ma własny poziom wyników (losowy wyraz wolny) i własny efekt hałasu (losowe nachylenie). Taką strukturę ustalono przed analizą, bo hałas zmienia się wewnątrz osób. Barr i in. (2013) pokazali, że w testowaniu hipotez model bez losowych nachyleń dla czynnika wewnątrzosobowego gorzej uogólnia wyniki.
Opis metody: co musi się znaleźć
W części „Analiza statystyczna” rozdziału metodologicznego opisz model tak, żeby ktoś inny mógł go odtworzyć:
- Strukturę danych: liczbę osób i obserwacji, liczbę pomiarów na osobę i braki.
- Efekty stałe: predyktory, ich kodowanie (0/1, kontrasty) i centrowanie.
- Efekty losowe: względem czego (osoby, klasy) i które parametry są losowe; skąd wzięła się ta struktura.
- Estymację: REML dla modelu końcowego, ML przy porównywaniu modeli różniących się efektami stałymi (zob. REML a ML).
- Testy i przedziały: metodę stopni swobody i sposób liczenia 95% CI.
- Program: R z wersją i pakiety z wersjami.
Po co df? Pakiet lme4 (Bates i in., 2015) nie podaje wartości p dla efektów stałych. Dodaje je pakiet lmerTest, który liczy stopnie swobody metodą Satterthwaite’a albo Kenwarda–Rogera (Kuznetsova i in., 2017). Luke (2017) w symulacjach pokazał, że traktowanie t jak z i test ilorazu wiarygodności są nieco liberalne w małych próbach, a odsetek błędów I rodzaju najbliższy .05 dają REML z jednym z tych przybliżeń. Przy małej liczbie grup McNeish (2017) zaleca REML z poprawką Kenwarda–Rogera.
Z wydruku do pracy: co przepisać, a co pominąć
Wydruk summary() z lmerTest ma kilka części. Tabela niżej mówi, co z każdej trafia do pracy.
| Element wydruku | W pracy | Uwagi |
|---|---|---|
Formula, fit by REML, Satterthwaite's method | Opis metody | Opisz słowami, nie wklejaj formuły R. |
REML criterion, Scaled residuals | Pomiń | Reszty sprawdź na wykresach diagnostycznych. |
Random effects: Variance, Std.Dev., Corr | Tabela, część „Efekty losowe” | Napisz, czy podajesz wariancje czy SD. |
Number of obs, groups | Opis metody, nota tabeli | Liczba obserwacji i osób. |
Estimate | b | W jednostkach zmiennej zależnej. |
Std. Error, df, t value | SE, df, t | df dwa miejsca po przecinku, np. t(61.47). |
Pr(>|t|) | p | Trzy miejsca, „< .001” zamiast 7.42e-11. |
| Gwiazdki istotności | Pomiń | Podawaj dokładne p. |
Wydruk nie zawiera przedziałów ufności. Dla efektów stałych policz je z tych samych df co test (kod w przepisie poniżej) albo funkcją confint(), i napisz, którą metodą. Ogólne zasady zapisu liczb opisuje jak opisać wyniki w stylu APA, a czytanie wydruków innych programów – jak czytać wyniki z SPSS.
ICC: ile zmienności to różnice między osobami
Zanim opiszesz predyktory, pokaż, jak silne jest zagnieżdżenie. Służy do tego korelacja wewnątrzklasowa (ICC) z modelu pustego, czyli bez predyktorów. W przykładzie wariancja między osobami wyniosła τ00 = 30.16, a wariancja wewnątrz osób σ² = 18.08, więc ICC = 30.16 / (30.16 + 18.08) = .625. Około 62.5% zmienności wyników w blokach to stałe różnice między osobami. To dużo i uzasadnia model mieszany. Ile wynosi taki wskaźnik dla innych liczebności, możesz sprawdzić w kalkulatorze ICC i efektu schematu.
Uwaga na funkcję icc() z pakietu performance użytą na modelu końcowym. Dla naszego modelu zwraca ICC skorygowane = .725, bo liczy je bez wariancji wyjaśnionej przez efekty stałe i z wariancją losowego nachylenia. To inna wielkość niż ICC z modelu pustego. W opisie struktury danych podaj tę drugą.
Efekty stałe: b, przedział i interpretacja
Każdy efekt stały opisz jak w regresji: b, 95% CI, t z df i p. Interpretacja zależy od kodowania. Przy hałasie zakodowanym 0/1 i wycentrowanej wrażliwości:
- Wyraz wolny (b = 42.52) to przewidywany wynik w ciszy u osoby o przeciętnej wrażliwości.
- Hałas (b = −3.64, 95% CI [−4.56, −2.71]) to różnica hałas − cisza u osoby o przeciętnej wrażliwości, a nie „średni efekt w całej próbie bez względu na wszystko”.
- Wrażliwość (b = −0.95, 95% CI [−2.88, 0.97], p = .326) to związek wrażliwości z wynikiem w ciszy.
- Interakcja (b = −2.16, 95% CI [−3.34, −0.99]): każdy punkt wrażliwości więcej to efekt hałasu silniejszy o 2.16 punktu.
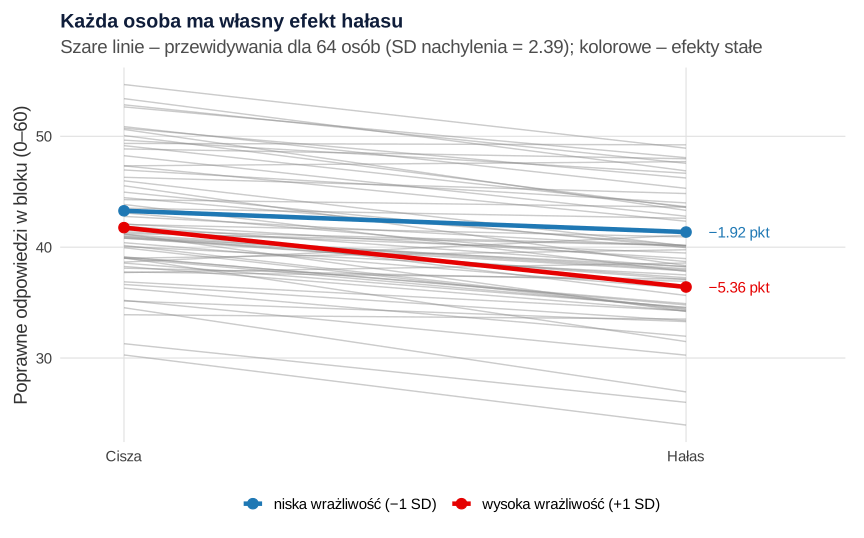
Interakcję zawsze rozpisz na proste efekty. Przy wrażliwości o 1 SD poniżej średniej hałas obniżał wynik o 1.92 punktu, 95% CI [−3.20, −0.63], a o 1 SD powyżej – o 5.36 punktu, 95% CI [−6.65, −4.06]. Jeśli dodajesz test porównujący modele z interakcją i bez niej, licz go na dopasowaniach ML i napisz to: χ²(1) = 12.50, p < .001.
Po wklejeniu do pracy dodaj kursywę dla b, t i p.
Efekty losowe: wariancje, SD i co one znaczą
Część „Random effects” wydruku zawiera trzy liczby, które studenci najczęściej pomijają. Wariancja losowego wyrazu wolnego wyniosła 33.00 (SD = 5.74 punktu), wariancja losowego nachylenia hałasu 5.71 (SD = 2.39 punktu), ich korelacja −.39, a wariancja reszt 11.61 (SD = 3.41). Zawsze napisz, czy podajesz wariancje, czy odchylenia standardowe – obie liczby stoją w wydruku obok siebie i łatwo je pomylić.
Odchylenie standardowe nachylenia łatwo przełożyć na treść. Przy rozkładzie normalnym efektów losowych hałas u około 95% osób o przeciętnej wrażliwości mieścił się w przedziale od −8.32 do 1.05 punktu. U części osób hałas niemal nie szkodził, a u innych obniżał wynik o kilka punktów. Rysunek 1 pokazuje tę różnorodność.
Do pracy możesz dodać 95% CI dla odchyleń standardowych z profilowej funkcji wiarygodności: dla wyrazu wolnego [4.67, 6.91], dla nachylenia [1.11, 3.37]. Jeśli promotor pyta, czy nachylenie „jest istotne”, podaj test ilorazu wiarygodności dla efektów losowych (ranova()): χ²(2) = 8.98, p = .011. Pamiętaj, że wariancja nie może być ujemna, więc taki test bywa konserwatywny. Nieistotny wynik nie jest powodem, by usunąć nachylenie, które wynika ze schematu badania (Barr i in., 2013). Gdy model z pełną strukturą się nie zbiega, postępuj według wpisu model mieszany się nie zbiega i opisz każdą zmianę w strukturze.
R² Nakagawy: marginalne i warunkowe
Nakagawa i Schielzeth (2013) zaproponowali dla modeli mieszanych dwie miary R². Marginalne R² to część wariancji wyjaśniona przez efekty stałe. Warunkowe R² to część wyjaśniona przez efekty stałe i losowe razem. W R policzysz je funkcją r2_nakagawa() z pakietu performance. W przykładzie R²m = .133, a R²c = .762. Rysunek 2 pokazuje, skąd się biorą: dzieli całkowitą wariancję wyniku na trzy składniki.
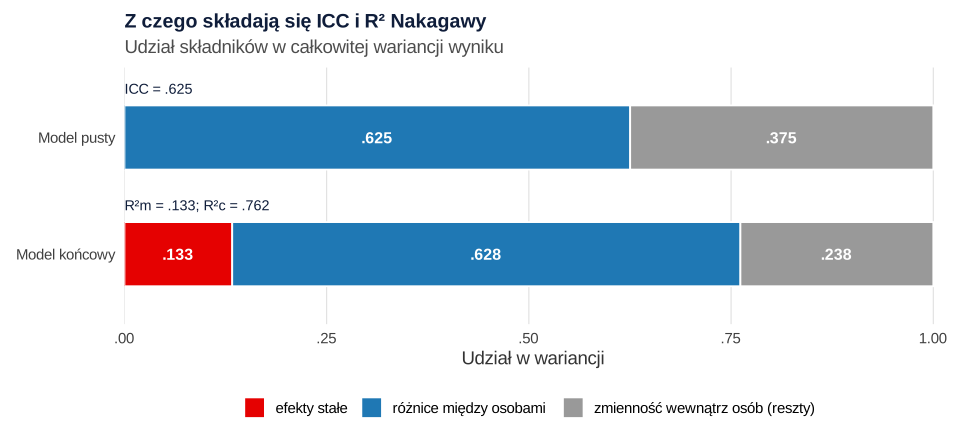
Niskie R²m nie znaczy, że hałas nie ma znaczenia. Wyniki w blokach zależą głównie od tego, kto rozwiązuje test, a efekt hałasu (3.64 punktu) to ponad połowa SD wyników w każdym warunku (6.70 w ciszy i 6.69 w hałasie). Dlatego obok R² zawsze podawaj efekt w jednostkach skali.
Tabela APA dla modelu mieszanego
Jedna tabela z efektami stałymi u góry i efektami losowymi u dołu zwykle wystarczy. Ogólne zasady budowy tabel znajdziesz we wpisie tabele APA w pracy z psychologii i w haśle o tabeli regresji w APA.
Tabela 1
Liniowy model mieszany wyników testu uwagi w ciszy i w hałasie
| Parametr | b | SE | 95% CI | t | df | p |
|---|---|---|---|---|---|---|
| Efekty stałe | ||||||
| Wyraz wolny | 42.52 | 0.76 | [41.00, 44.04] | 55.98 | 62.10 | < .001 |
| Hałas (0 = cisza, 1 = hałas) | −3.64 | 0.46 | [−4.56, −2.71] | −7.86 | 61.47 | < .001 |
| Wrażliwość na hałasa | −0.95 | 0.96 | [−2.88, 0.97] | −0.99 | 62.14 | .326 |
| Hałas × wrażliwość | −2.16 | 0.59 | [−3.34, −0.99] | −3.67 | 62.02 | < .001 |
| Efekty losowe | Wariancja | SD | ||||
| Wyraz wolny (osoby) | 33.00 | 5.74 | ||||
| Nachylenie hałasu (osoby) | 5.71 | 2.39 | ||||
| Korelacja wyrazu wolnego i nachylenia | −.39 | |||||
| Reszta | 11.61 | 3.41 | ||||
Uwaga. N = 64 osoby, 375 obserwacji (4–6 bloków na osobę). Estymacja REML; stopnie swobody i 95% CI efektów stałych z przybliżenia Satterthwaite’a. ICC (model pusty) = .625. R²m = .133, R²c = .762. Dane symulowane.
a Wycentrowana względem średniej osób (M = 3.07).
Nie powtarzaj w tekście wszystkich liczb z tabeli. W wynikach opisz efekty związane z hipotezami, a resztę zostaw w tabeli (American Psychological Association, 2020).
Najczęstsze błędy w opisie modelu mieszanego
- Brak struktury efektów losowych. Zdanie „zastosowano model mieszany” bez informacji, co jest losowe i względem czego, nie pozwala odtworzyć analizy.
- Wartości p bez metody. Jeśli p pochodzi z lmerTest, napisz „df Satterthwaite’a”. Jeśli z testu ilorazu wiarygodności, podaj χ² i to, czy modele dopasowano ML.
- Pomylone wariancje i SD. 5.71 i 2.39 to ten sam parametr. Bez nazwy czytelnik nie wie, który podajesz.
- ICC z niewłaściwego modelu. ICC z modelu końcowego (.725) to nie to samo co ICC z modelu pustego (.625).
- Jedno R². Podaj oba współczynniki Nakagawy i napisz, który jest który.
- Efekt główny przy interakcji czytany jak średni efekt. Przy kodowaniu 0/1 i centrowaniu to efekt dla konkretnej wartości drugiej zmiennej.
- Gwiazdki i notacja naukowa (
7.42e-11,***) przepisane z wydruku. - Brak liczby obserwacji i braków. Model mieszany korzysta ze wszystkich dostępnych pomiarów – napisz, ilu ich było.
Jeśli promotor odsyła rozdział wyników z uwagami, typowe poprawki opisuje wpis poprawki promotora w rozdziale wyników.
Model mieszany w R: kod i wynik
Przepis tworzy dane, zapisuje plik CSV i liczy wszystkie wyniki z tekstu i tabeli. Uruchom go z folderu, w którym ma powstać podfolder z danymi (plik trafia do folderu nadrzędnego, ../). Rysunki powstały w osobnym skrypcie na tych samych danych.
Model pusty, model końcowy, CI, komponenty wariancji, ICC i R²
R
# B330 – jak opisać wyniki modelu mieszanego: hałas a wynik testu uwagi (dane symulowane)
# 64 osoby × 6 bloków testu (3 w ciszy, 3 w hałasie); wynik = liczba poprawnych odpowiedzi w bloku (0–60)
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(performance) })
set.seed(3301)
J <- 64; bloki <- 6
osoby <- data.frame(osoba = factor(1:J), wrazliwosc = round(pmin(5, pmax(1, rnorm(J, 3, 0.8))), 1))
u0 <- rnorm(J, 0, 5); u1 <- rnorm(J, -0.3 * u0 / 5 * 3, 3 * sqrt(1 - 0.3^2))     # SD 5 i 3, korelacja około −.30
dane <- data.frame(osoba = factor(rep(1:J, each = bloki)), blok = rep(1:bloki, J))
dane$halas <- as.integer(ifelse(as.integer(dane$osoba) %% 2 == 0, dane$blok %in% c(2, 4, 6), dane$blok %in% c(1, 3, 5)))
dane$wrazliwosc <- osoby$wrazliwosc[dane$osoba]
dane$wrazliwosc_c <- dane$wrazliwosc - mean(osoby$wrazliwosc)            # centrowanie względem średniej osób
i <- as.integer(dane$osoba)
dane$wynik <- round(42 + u0[i] + (-3.5 + u1[i]) * dane$halas - 0.3 * dane$wrazliwosc_c -
                    1.6 * dane$halas * dane$wrazliwosc_c + rnorm(nrow(dane), 0, 3.5))
dane$wynik <- pmin(60, pmax(0, dane$wynik))
dane <- dane[-sample(nrow(dane), 9), ]                                    # 9 bloków utraconych (awaria)
write.csv(dane, "../model-mieszany-halas-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Struktura danych: liczba osób, obserwacji, bloków na osobę
cat("Osoby:", nlevels(droplevels(dane$osoba)), "| obserwacje:", nrow(dane), "\n")
print(table(table(dane$osoba)))
print(aggregate(wynik ~ halas, dane, function(y) round(c(M = mean(y), SD = sd(y)), 2)))
cat(sprintf("Wrażliwość na hałas (poziom osób): M = %.2f, SD = %.2f\n", mean(osoby$wrazliwosc), sd(osoby$wrazliwosc)))

# Model pusty i ICC
m0 <- lmer(wynik ~ 1 + (1 | osoba), data = dane, REML = TRUE)
print(VarCorr(m0), comp = "Variance")
print(icc(m0))

# Model końcowy: hałas (0 = cisza, 1 = hałas), wrażliwość (centrowana), interakcja,
# losowy wyraz wolny i losowe nachylenie hałasu dla osób; REML, df Satterthwaite'a
m1 <- lmer(wynik ~ halas * wrazliwosc_c + (1 + halas | osoba), data = dane, REML = TRUE)
cat("Ostrzeżenie singular fit:", isSingular(m1), "\n")
print(summary(m1, ddf = "Satterthwaite"), correlation = FALSE)

# 95% CI dla efektów stałych z rozkładu t z df Satterthwaite'a (zgodne z testem t z tabeli)
tab <- coef(summary(m1, ddf = "Satterthwaite"))
ci_t <- cbind(b = tab[, "Estimate"], SE = tab[, "Std. Error"],
              dol = tab[, "Estimate"] - qt(0.975, tab[, "df"]) * tab[, "Std. Error"],
              gor = tab[, "Estimate"] + qt(0.975, tab[, "df"]) * tab[, "Std. Error"],
              t = tab[, "t value"], df = tab[, "df"])
print(data.frame(round(ci_t, 3), p = signif(tab[, "Pr(>|t|)"], 3)))

# 95% CI z profilowej funkcji wiarygodności dla SD efektów losowych i SD reszt
# (profil korelacji efektów losowych jest tu niemonotoniczny – lme4 ostrzega – więc jej CI pomijamy)
ci_sd <- suppressWarnings(suppressMessages(confint(m1, parm = "theta_", method = "profile", signames = FALSE)))
print(round(ci_sd[!grepl("^cor", rownames(ci_sd)), ], 2))

# Komponenty wariancji: wariancje i SD
print(VarCorr(m1), comp = c("Variance", "Std.Dev."))

# Zakres, w którym leży efekt hałasu u około 95% osób (przy średniej wrażliwości): b ± 1.96 × SD nachylenia
sd_nach <- attr(VarCorr(m1)$osoba, "stddev")[["halas"]]
cat(sprintf("Efekt hałasu u ~95%% osób: od %.2f do %.2f\n",
            fixef(m1)[["halas"]] - 1.96 * sd_nach, fixef(m1)[["halas"]] + 1.96 * sd_nach))

# R² Nakagawy i Schielzetha oraz ICC skorygowane z modelu końcowego
print(r2_nakagawa(m1))
print(icc(m1))

# Czy nachylenie hałasu różni się między osobami? LRT dla efektów losowych (REML)
print(ranova(m1))

# Porównanie modeli z interakcją i bez niej – LRT na dopasowaniach ML
m1a <- lmer(wynik ~ halas + wrazliwosc_c + (1 + halas | osoba), data = dane, REML = FALSE)
m1b <- update(m1, REML = FALSE)
print(anova(m1a, m1b))

# Proste nachylenia hałasu dla wrażliwości o 1 SD poniżej i powyżej średniej (CI z przybliżenia normalnego)
s <- sd(osoby$wrazliwosc); b <- fixef(m1); V <- as.matrix(vcov(m1))
for (w in c(-s, s)) {
  k <- c(0, 1, 0, w); est <- sum(k * b); se <- sqrt(drop(t(k) %*% V %*% k))
  cat(sprintf("Wrażliwość %+.2f: efekt hałasu = %.2f, 95%% CI [%.2f, %.2f]\n", w, est, est - 1.96 * se, est + 1.96 * se))
}
Wynik w R
Osoby: 64 | obserwacje: 375

 4  5  6
 1  7 56
  halas wynik.M wynik.SD
1     0   42.48     6.70
2     1   38.91     6.69
Wrażliwość na hałas (poziom osób): M = 3.07, SD = 0.80
 Groups   Name        Variance
 osoba    (Intercept) 30.157
 Residual             18.075
# Intraclass Correlation Coefficient

    Adjusted ICC: 0.625
  Unadjusted ICC: 0.625
Ostrzeżenie singular fit: FALSE
Linear mixed model fit by REML. t-tests use Satterthwaite's method [
lmerModLmerTest]
Formula: wynik ~ halas * wrazliwosc_c + (1 + halas | osoba)
   Data: dane

REML criterion at convergence: 2185.7

Scaled residuals:
     Min       1Q   Median       3Q      Max
-2.44622 -0.62751  0.01106  0.62181  2.25918

Random effects:
 Groups   Name        Variance Std.Dev. Corr
 osoba    (Intercept) 33.00    5.745
          halas        5.71    2.390    -0.39
 Residual             11.61    3.407
Number of obs: 375, groups:  osoba, 64

Fixed effects:
                   Estimate Std. Error      df t value Pr(>|t|)
(Intercept)         42.5206     0.7596 62.0999  55.978  < 2e-16 ***
halas               -3.6359     0.4628 61.4748  -7.856 7.42e-11 ***
wrazliwosc_c        -0.9532     0.9625 62.1405  -0.990 0.325853
halas:wrazliwosc_c  -2.1619     0.5883 62.0156  -3.675 0.000499 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                        b    SE    dol    gor      t     df        p
(Intercept)        42.521 0.760 41.002 44.039 55.978 62.100 7.36e-55
halas              -3.636 0.463 -4.561 -2.711 -7.856 61.475 7.42e-11
wrazliwosc_c       -0.953 0.963 -2.877  0.971 -0.990 62.140 3.26e-01
halas:wrazliwosc_c -2.162 0.588 -3.338 -0.986 -3.675 62.016 4.99e-04
                     2.5 % 97.5 %
sd_(Intercept)|osoba  4.67   6.91
sd_halas|osoba        1.11   3.37
sigma                 3.13   3.73
 Groups   Name        Variance Std.Dev. Corr
 osoba    (Intercept) 33.0042  5.7449
          halas        5.7103  2.3896   -0.386
 Residual             11.6105  3.4074
Efekt hałasu u ~95% osób: od -8.32 do 1.05
# R2 for Mixed Models

  Conditional R2: 0.762
     Marginal R2: 0.133
# Intraclass Correlation Coefficient

    Adjusted ICC: 0.725
  Unadjusted ICC: 0.628
ANOVA-like table for random-effects: Single term deletions

Model:
wynik ~ halas * wrazliwosc_c + (1 + halas | osoba)
                             npar  logLik    AIC    LRT Df Pr(>Chisq)
<none>                          8 -1092.8 2201.7
halas in (1 + halas | osoba)    6 -1097.3 2206.7 8.9781  2    0.01123 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Data: dane
Models:
m1a: wynik ~ halas + wrazliwosc_c + (1 + halas | osoba)
m1b: wynik ~ halas * wrazliwosc_c + (1 + halas | osoba)
    npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m1a    7 2215.9 2243.4 -1100.9    2201.9
m1b    8 2205.4 2236.8 -1094.7    2189.4 12.504  1  0.0004062 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Wrażliwość -0.80: efekt hałasu = -1.92, 95% CI [-3.20, -0.63]
Wrażliwość +0.80: efekt hałasu = -5.36, 95% CI [-6.65, -4.06]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4, lmerTest i performance; rysunki przygotowano w pakietach ggplot2, svglite, insight i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- insight (wersja 1.4.6): Lüdecke, D., Waggoner, P., & Makowski, D. (2019). insight: A unified interface to access information from model objects in R. Journal of Open Source Software, 4(38), 1412. https://doi.org/10.21105/joss.01412
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Co napisać o modelu mieszanym w części „Analiza statystyczna”?
Podaj zmienną zależną, efekty stałe z kodowaniem i centrowaniem, jednostki efektów losowych (np. osoby) i to, które parametry są losowe (wyraz wolny, nachylenie). Dodaj metodę estymacji (REML albo ML), metodę stopni swobody (np. Satterthwaite), sposób liczenia 95% CI oraz program i wersje pakietów. Wzór takiego akapitu jest w sekcji „Opis metody”.
Czy w modelu mieszanym podawać wariancję czy odchylenie standardowe efektu losowego?
Jedno albo drugie, ale z nazwą. Wariancja (np. τ00 = 33.00) przydaje się do liczenia ICC, a odchylenie standardowe (5.74 punktu) jest w jednostkach wyniku i łatwiej je zinterpretować. Wydruk lmer pokazuje obie wartości obok siebie w kolumnach Variance i Std.Dev..
Które ICC podać: z modelu pustego czy z modelu końcowego?
Do opisu struktury danych podaj ICC z modelu pustego (bez predyktorów) – mówi, jaka część wariancji wyniku to stałe różnice między jednostkami. ICC z funkcji icc() dla modelu z predyktorami i losowym nachyleniem to inna wielkość (w przykładzie .725 zamiast .625). Jeśli podajesz obie, nazwij każdą.
Jak zinterpretować R² marginalne i warunkowe w pracy magisterskiej?
Marginalne R² to część wariancji wyjaśniona przez efekty stałe, a warunkowe – przez efekty stałe i losowe razem (Nakagawa i Schielzeth, 2013). Duża różnica między nimi oznacza, że wyniki zależą głównie od stałych różnic między osobami. Niskie R²m nie znaczy, że efekt jest nieważny – podaj też efekt w punktach skali.
Czy w modelu mieszanym trzeba podawać standaryzowane współczynniki beta?
Nie. Standardowo podaje się niestandaryzowane b z SE i 95% CI, bo przy predyktorze 0/1 mają prostą interpretację: różnica w punktach skali. Jeśli promotor prosi o współczynniki standaryzowane, napisz, jak je policzono, bo w modelach wielopoziomowych nie ma jednego oczywistego sposobu standaryzacji.
Powiązane hasła
Przeczytaj też
Model mieszany (MIXED) w SPSS krok po kroku
Linear Mixed Models od pliku w formacie długim po opis APA: Subjects i Repeated, losowy wyraz wolny, ICC, struktury AR(1), CS i UN, średnie brzegowe i składnia MIXED – na przykładzie dwóch grup i trzech pomiarów z brakami.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Masz model mieszany, ale nie wiesz, jak go opisać?
Sprawdzimy specyfikację i wydruk modelu, wyjaśnimy każdą liczbę i pomożemy ułożyć tabelę oraz opis wyników tak, żebyś umiał(a) samodzielnie je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13 ● Otwarty dostęp
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
- McNeish, D. (2017). Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction. Multivariate Behavioral Research, 52(5), 661–670. https://doi.org/10.1080/00273171.2017.1344538
- Meteyard, L., & Davies, R. A. I. (2020). Best practice guidance for linear mixed-effects models in psychological science. Journal of Memory and Language, 112, Article 104092. https://doi.org/10.1016/j.jml.2020.104092 ● Otwarty dostęp: pełny tekst
- Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining R² from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{kuznetsova2017lmertest, author={Kuznetsova, Alexandra and Brockhoff, Per B. and Christensen, Rune H. B.}, title={{lmerTest package: Tests in linear mixed effects models}}, journal={Journal of Statistical Software}, year={2017}, volume={82}, number={13}, pages={1--26}, doi={10.18637/jss.v082.i13}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}@article{mcneish2017small, author={McNeish, Daniel}, title={{Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction}}, journal={Multivariate Behavioral Research}, year={2017}, volume={52}, number={5}, pages={661--670}, doi={10.1080/00273171.2017.1344538}}@article{meteyard2020best, author={Meteyard, Lotte and Davies, Robert A. I.}, title={{Best practice guidance for linear mixed-effects models in psychological science}}, journal={Journal of Memory and Language}, year={2020}, volume={112}, eid={104092}, doi={10.1016/j.jml.2020.104092}}@article{nakagawa2013general, author={Nakagawa, Shinichi and Schielzeth, Holger}, title={{A general and simple method for obtaining R² from generalized linear mixed-effects models}}, journal={Methods in Ecology and Evolution}, year={2013}, volume={4}, number={2}, pages={133--142}, doi={10.1111/j.2041-210x.2012.00261.x}}