Kiedy dane wymagają modelu wielopoziomowego?
Dane są zagnieżdżone, gdy obserwacje tworzą grupy: uczniowie są w klasach, pracownicy w zespołach, pacjenci u terapeutów, a mieszkańcy w gminach. Osoby z jednej grupy dzielą warunki, przełożonego albo nauczyciela, więc ich wyniki są do siebie bardziej podobne niż wyniki osób z różnych grup. Zwykła regresja wieloraka zakłada, że każda obserwacja wnosi niezależną informację, dlatego przy takich danych zaniża błędy standardowe. Aarts i in. (2014) znaleźli dane zagnieżdżone w 53% z 314 przejrzanych artykułów z czołowych czasopism neuronaukowych i pokazali, że pominięcie zależności między obserwacjami może podnieść odsetek fałszywie istotnych wyników daleko powyżej nominalnego α, nawet do 80%.
Model wielopoziomowy (ang. multilevel model, także hierarchiczny model liniowy albo liniowy model mieszany) rozwiązuje ten problem. Oprócz przeciętnych zależności szacuje, jak bardzo grupy różnią się poziomem wyniku i siłą związków. Definicje, równania i rozróżnienie efektów stałych i losowych znajdziesz w haśle słownika. Ten wpis jest praktyczną procedurą: przechodzimy przez pięć kolejnych modeli na jednym zbiorze danych, z kodem R, wynikami i wzorem raportu.
Wpis dotyczy danych przekrojowych, w których na poziomie 1 są osoby, a na poziomie 2 – grupy. Te same narzędzia stosuje się do pomiarów powtarzanych, gdzie na poziomie 1 są kolejne pomiary, a na poziomie 2 – osoby. Tam pojawiają się jednak inne pytania: o kształt zmian w czasie, porównanie z ANOVA z powtarzanymi pomiarami i odpadanie z badania. Opisujemy je osobno we wpisie pomiary powtarzane: ANOVA czy model mieszany.
Klasyczne podręczniki to prace Raudenbusha i Bryka (2002) oraz Hoxa i in. (2017). Ten drugi pokazuje estymację i interpretację modeli na przykładach z psychologii i edukacji. W R modele dopasowuje się funkcją lmer() z pakietu lme4, metodą największej wiarygodności lub REML (Bates i in., 2015).
Przykład: wyczerpanie pracowników w 60 zespołach
W badaniu (dane symulowane) wzięło udział 598 pracowników z 60 zespołów jednej organizacji. Zespoły liczyły od 4 do 16 osób, średnio 9.97. Mamy trzy zmienne:
- wyczerpanie emocjonalne – zmienna zależna, średnia pozycji skali 1–7 (M = 3.64, SD = 1.17);
- obciążenie pracą – predyktor poziomu 1, ocena osoby na skali 1–5 (M = 3.01, SD = 0.81);
- wsparcie kierownika – predyktor poziomu 2, jedna wartość dla całego zespołu z oceny w corocznym audycie, skala 1–5 (średnia 60 zespołów: 3.34, SD = 0.68).
Pytania badawcze są trzy. Czy osoby bardziej obciążone pracą są bardziej wyczerpane? Czy zespoły z lepszym wsparciem kierownika są mniej wyczerpane? I czy wsparcie kierownika osłabia związek obciążenia z wyczerpaniem? Ostatnie pytanie dotyczy interakcji międzypoziomowej: cecha zespołu zmienia siłę związku na poziomie osób. Dane w formacie długim (jeden wiersz = jedna osoba, kolumna z kodem zespołu) możesz pobrać: model-wielopoziomowy-dane-zespoly.csv.
Plan analizy: pięć modeli po kolei
Model wielopoziomowy buduje się stopniowo, a każdy krok odpowiada na jedno pytanie. Zaplanuj tę sekwencję przed analizą i wpisz ją do planu analizy statystycznej. Porządek kroków jest podobny do trzyetapowej procedury z modelem pustym, testem losowego nachylenia i modelem końcowym, którą Sommet i Morselli (2017) opisali dla wielopoziomowej regresji logistycznej.
| Model | Co dodajemy | Pytanie |
|---|---|---|
| M0 | tylko losowy wyraz wolny | Jaka część wariancji wyczerpania przypada na różnice między zespołami (ICC)? |
| M1 | obciążenie: odchylenie od średniej zespołu (CWC) i średnia zespołu (CGM) | Jaki jest związek obciążenia z wyczerpaniem wewnątrz zespołów, a jaki między zespołami? |
| M2 | wsparcie kierownika (poziom 2) | Czy zespoły z lepszym wsparciem są mniej wyczerpane? |
| M3 | losowe nachylenie obciążenia | Czy związek obciążenia z wyczerpaniem różni się między zespołami? |
| M4 | interakcja wsparcie × obciążenie (CWC) | Czy wsparcie kierownika wyjaśnia te różnice nachyleń? |
Krok 1. Model pusty, ICC i efekt schematu
Model pusty (M0) nie ma predyktorów: wyczerpanie osoby to średnia ogólna plus odchylenie jej zespołu plus odchylenie osoby od średniej zespołu. Dzieli więc wariancję wyniku na dwie części:
- między zespołami: τ00 = 0.410;
- wewnątrz zespołów: σ² = 0.943.
Korelacja wewnątrzklasowa (ICC) mówi, że 30.3% zróżnicowania wyczerpania to różnice między zespołami. ICC to także oczekiwana korelacja wyników dwóch losowo wybranych osób z tego samego zespołu.
Skutki pominięcia tej zależności pokazuje efekt schematu:
Dla pytań o różnice między zespołami 598 osób niesie tyle informacji co około 161 niezależnych obserwacji (598 / 3.72). W literaturze krąży reguła, że przy Deff < 2 można pominąć wielopoziomową strukturę danych. Lai i Kwok (2015) sprawdzili ją w symulacji i doszli do wniosku, że nie należy jej stosować, gdy interesują nas efekty predyktorów wyższego poziomu albo gdy grupy liczą mniej niż 10 osób. W naszym badaniu oba warunki są spełnione, a Deff i tak jest prawie dwa razy wyższy od progu. Nie traktuj ICC jako testu, który „zezwala” na model wielopoziomowy. Jeśli schemat badania jest zagnieżdżony, a pytania dotyczą także grup, model wielopoziomowy jest po prostu właściwym modelem.
Krok 2. Centrowanie: oddziel efekt wewnątrz i między zespołami
Obciążenie pracą zmienia się na dwóch poziomach. Osoby w jednym zespole różnią się obciążeniem, ale różnią się też przeciętne obciążenia zespołów. Te dwa źródła zmienności mogą mieć różny związek z wyczerpaniem. Enders i Tofighi (2007) pokazują, że od sposobu centrowania predyktorów poziomu 1 zależy, jak należy interpretować wyraz wolny i nachylenia, a wybór między centrowaniem do średniej ogólnej i do średniej grupy powinno wyznaczać pytanie badawcze. W przykładzie tworzymy dwie zmienne:
- CWC (ang. centering within cluster) – odchylenie obciążenia osoby od średniej jej zespołu; ta zmienna ma zerową średnią w każdym zespole i niesie wyłącznie zmienność wewnątrzzespołową;
- CGM (ang. centering grand mean) dla średniej zespołu – przeciętne obciążenie zespołu minus średnia ogólna (3.01); to predyktor poziomu 2.
Jeśli wprowadzisz do modelu tylko obciążenie wycentrowane względem średniej ogólnej, dostaniesz jeden współczynnik, b = 0.62 (SE = 0.05). To mieszanina dwóch różnych efektów, którą trudno zinterpretować. Model M1 z obiema zmiennymi rozdziela je:
- efekt wewnątrzzespołowy: b = 0.55 (SE = 0.06) – osoba obciążona o 1 punkt bardziej niż reszta jej zespołu ma przeciętnie o 0.55 punktu wyższe wyczerpanie;
- efekt międzyzespołowy: b = 1.04 (SE = 0.14) – zespół o 1 punkt bardziej obciążony od innego zespołu ma przeciętnie o 1.04 punktu wyższe średnie wyczerpanie.
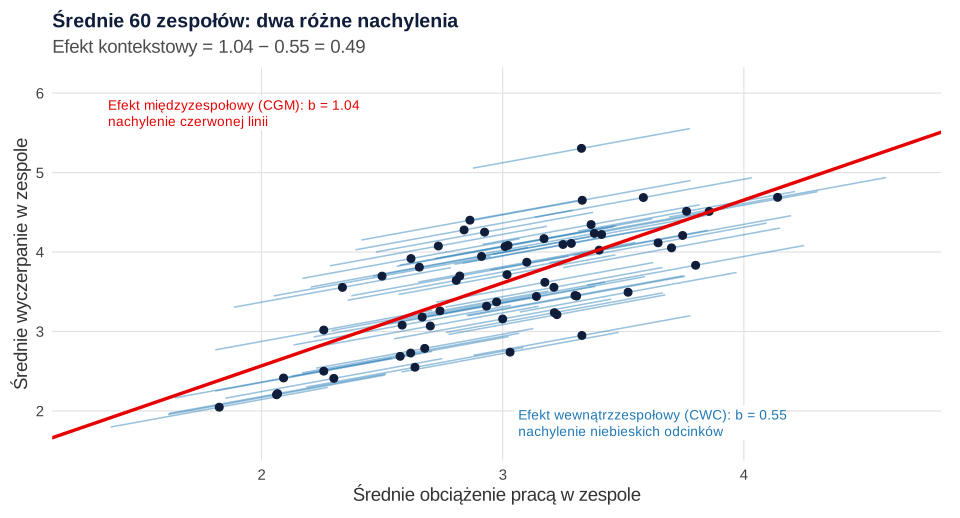
Różnica między tymi nachyleniami to efekt kontekstowy: o ile wyższe jest wyczerpanie osoby w bardziej obciążonym zespole przy tym samym obciążeniu własnym. W modelu, w którym obciążenie jest wycentrowane do średniej ogólnej, a średnia zespołu wchodzi jako drugi predyktor, współczynnik średniej zespołu jest właśnie tym efektem: b = 0.49, 95% CI [0.20, 0.78], t(86.39) = 3.31, p = .001. Praca w zespole, w którym wszyscy są przeciążeni, wiąże się z dodatkowym wyczerpaniem ponad to, co wynika z własnego obciążenia. To dane korelacyjne, więc nie przesądzają o przyczynie.
Rozróżnienie poziomów chroni przed dwoma błędami wnioskowania. Związek między średnimi grup nie musi odpowiadać związkowi u osób, czyli błąd ekologiczny, a pojedynczy współczynnik z modelu bez rozdzielenia poziomów miesza oba efekty. Podobne pułapki opisuje hasło agregacja danych.
Krok 3. Predyktory poziomu 1 i 2
Model M2 dodaje wsparcie kierownika, wycentrowane względem średniej 60 zespołów. Zespoły z lepszym wsparciem są mniej wyczerpane: b = −0.28, SE = 0.09, t(58.45) = −3.07, p = .003. Zwróć uwagę na stopnie swobody. Dla predyktora poziomu 2 wynoszą około 58, a nie około 590, bo informacji o wsparciu dostarcza 60 zespołów, a nie 598 osób.
Przydatnym podsumowaniem jest to, ile wariancji wyjaśniają predyktory na każdym poziomie. Porównuje się w tym celu komponenty wariancji z modelem pustym:
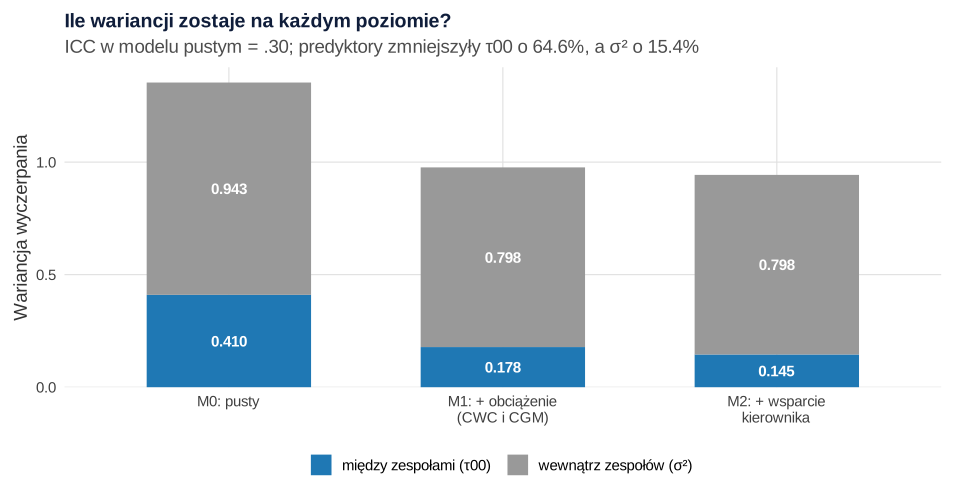
Obciążenie (M1) zmniejszyło wariancję między zespołami z 0.410 do 0.178, czyli o 56.5%, a wariancję wewnątrz zespołów o 15.4%. Wsparcie kierownika (M2) zmniejszyło wariancję między zespołami do 0.145. Łącznie predyktory wyjaśniają więc 64.6% różnic między zespołami. Takie „R² dla poziomu” bywa mylące w modelach z losowymi nachyleniami i może nawet zmaleć po dodaniu predyktora (Nakagawa i Schielzeth, 2013), dlatego w raporcie podaje się częściej R² marginalne i warunkowe (o nich w kroku 6).
Dla porównania naiwna regresja MNK z tymi samymi predyktorami (bez uwzględnienia zespołów) daje dla wsparcia kierownika błąd standardowy 0.058, a model wielopoziomowy – 0.092. Dla średniego obciążenia zespołu jest to 0.083 i 0.127. Zwykła regresja zaniża niepewność właśnie tych efektów, które najczęściej interesują badaczy organizacji: efektów cech grup.
Krok 4. Losowe nachylenia: czy związek różni się między zespołami?
Do tej pory zakładaliśmy, że związek obciążenia z wyczerpaniem jest taki sam w każdym zespole. Model M3 pozwala nachyleniu obciążenia (CWC) różnić się między zespołami. Dodaje dwa parametry: wariancję nachyleń (τ11) i ich korelację z wyrazem wolnym. Porównujemy go z M2 testem ilorazu wiarygodności. Oba modele mają te same efekty stałe, więc test można wykonać na dopasowaniach REML: χ²(2) = 9.05, p = .011. Odchylenie standardowe nachyleń między zespołami wynosi 0.32, a przeciętne nachylenie w modelu M2 – 0.55, więc w części zespołów związek jest wyraźnie silniejszy niż w innych.
Test wariancji ma jedną osobliwość: wariancja nie może być ujemna, więc hipoteza zerowa (τ11 = 0) leży na granicy możliwych wartości. Zwykły rozkład χ² daje wtedy zbyt duże p. Popularna poprawka to p z mieszaniny rozkładów χ²(1) i χ²(2) z wagami ½, która u nas wynosi .007. Oba warianty prowadzą tu do tego samego wniosku, ale przy wynikach granicznych różnica ma znaczenie.
Czy losowe nachylenia wprowadzać zawsze, czy tylko wtedy, gdy test je „potwierdzi”? Barr i in. (2013) argumentują, że w konfirmacyjnym testowaniu hipotez model powinien mieć maksymalną strukturę efektów losowych uzasadnioną schematem badania. Matuschek i in. (2017) pokazują, że model maksymalny chroni przed błędem I rodzaju, ale może wyraźnie obniżać moc, i proponują strukturę wspieraną przez dane, wybieraną kryterium wyboru modelu. Praktyczny kompromis jest taki: jeśli testujesz interakcję międzypoziomową z predyktorem poziomu 1, ten predyktor powinien mieć losowe nachylenie. Bez niego test interakcji traktuje zróżnicowanie nachyleń jak szum na poziomie osób, a błąd standardowy interakcji może być zaniżony. Co robić przy ostrzeżeniach o osobliwym dopasowaniu (singular fit) i problemach ze zbieżnością, opisujemy we wpisie o pomiarach powtarzanych.
Krok 5. Interakcja międzypoziomowa
Model M4 dodaje iloczyn wsparcia kierownika i obciążenia (CWC). Pytamy, czy wsparcie wyjaśnia, dlaczego w jednych zespołach obciążenie silniej wiąże się z wyczerpaniem niż w innych. Interakcja jest istotna: b = −0.30, 95% CI [−0.48, −0.11], t(39.92) = −3.16, p = .003. Wsparcie kierownika działa więc jak moderator: im jest lepsze, tym słabszy związek obciążenia z wyczerpaniem. Interakcję sonduje się tak samo jak w zwykłej regresji: prostymi nachyleniami albo techniką Johnsona–Neymana, którą Bauer i Curran (2005) uogólnili na modele wielopoziomowe. Logikę tej procedury opisujemy we wpisie analiza moderacji krok po kroku.
| Wsparcie kierownika | Nachylenie obciążenia (CWC) | 95% CI |
|---|---|---|
| Niskie (−1 SD) | 0.75 | [0.57, 0.93] |
| Przeciętne (M) | 0.55 | [0.42, 0.68] |
| Wysokie (+1 SD) | 0.35 | [0.16, 0.53] |
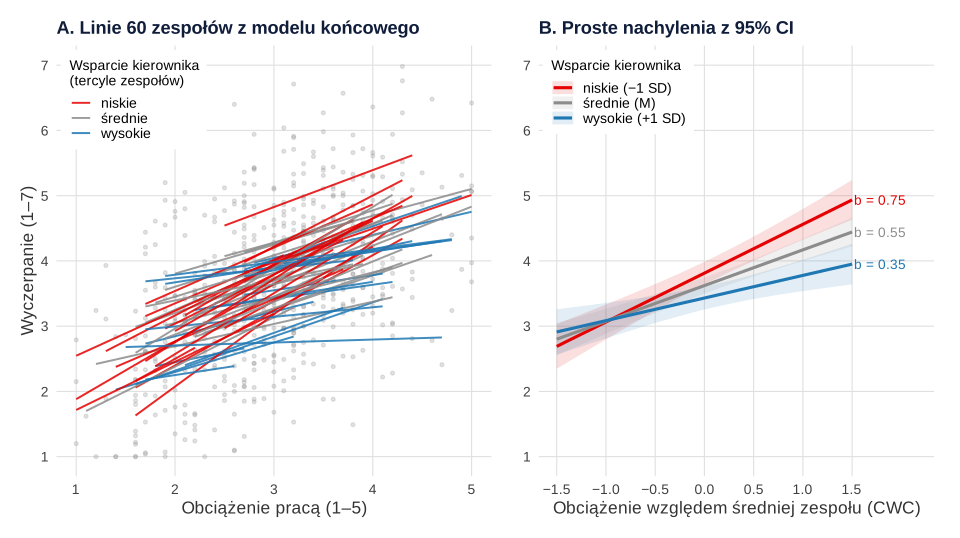
Przy niskim wsparciu każdy dodatkowy punkt obciążenia (względem średniej zespołu) wiąże się z wyczerpaniem wyższym o 0.75 punktu, a przy wysokim – o 0.35 punktu. Nawet przy wysokim wsparciu związek pozostaje dodatni, bo przedział ufności nie obejmuje zera. Wsparcie kierownika łagodzi więc związek, ale go nie znosi. Po dodaniu interakcji wariancja losowych nachyleń spadła z 0.101 do 0.067, czyli o 34.2%. Około jednej trzeciej różnic w nachyleniach między zespołami wiąże się zatem ze wsparciem kierownika, a reszta pozostaje niewyjaśniona.
Ponieważ obciążenie w interakcji jest wycentrowane w zespołach, jest to czysta interakcja międzypoziomowa. Gdyby obciążenie było wycentrowane do średniej ogólnej, iloczyn mieszałby moderację efektu wewnątrzzespołowego z interakcją dwóch zmiennych poziomu 2 (wsparcia i średniego obciążenia zespołu). Enders i Tofighi (2007) zalecają dlatego centrowanie w grupach, gdy pytanie dotyczy efektu na poziomie osób albo interakcji międzypoziomowej.
Porównanie modeli: LRT, AIC, BIC oraz REML a ML
Modele wielopoziomowe można szacować dwiema metodami: klasyczną metodą największej wiarygodności (ML) albo metodą ograniczonej największej wiarygodności (REML). Różnica jest praktyczna:
- REML daje mniej obciążone oszacowania komponentów wariancji, zwłaszcza gdy grup jest niewiele. McNeish (2017) wyjaśnia, dlaczego ML zawodzi przy małej liczbie grup i dlaczego w takich próbach zaleca się REML z poprawką Kenwarda–Rogera. W lme4 to ustawienie domyślne.
- ML trzeba użyć, gdy porównujesz modele różniące się efektami stałymi. Wiarygodność REML zależy od tego, jakie efekty stałe są w modelu, więc nie nadaje się do takich porównań. Funkcja
anova()dla modeli z lme4 automatycznie dopasowuje je wtedy ponownie metodą ML.
W naszym przykładzie efekty stałe modelu M4 w obu metodach są praktycznie identyczne: wsparcie −0.2816 w REML i −0.2819 w ML. Różnią się komponenty wariancji: τ00 wynosi 0.148 w REML i 0.137 w ML, a τ11 – 0.067 i 0.058. ML zaniża wariancje na poziomie zespołów, bo nie uwzględnia stopni swobody zużytych na efekty stałe. Model końcowy raportuj więc z oszacowaniami REML, a porównania efektów stałych wykonuj na ML.
| Model | Liczba parametrów | AIC | BIC | LRT względem poprzedniego |
|---|---|---|---|---|
| M0: pusty | 3 | 1765.1 | 1778.3 | – |
| M1: + obciążenie (CWC, CGM) | 5 | 1637.7 | 1659.7 | χ²(2) = 131.39, p < .001 |
| M2: + wsparcie kierownika | 6 | 1630.6 | 1656.9 | χ²(1) = 9.14, p = .003 |
| M3: + losowe nachylenie | 8 | 1625.9 | 1661.0 | χ²(2) = 8.67, p = .013 |
| M4: + interakcja międzypoziomowa | 9 | 1618.3 | 1657.9 | χ²(1) = 9.54, p = .002 |
Kryterium AIC maleje z każdym krokiem i najlepiej ocenia model M4. BIC, który mocniej karze za liczbę parametrów, wskazuje model M2 (1656.9), choć model M4 jest tuż za nim (1657.9). Kryteria informacyjne nie są testami istotności i mogą prowadzić do różnych wniosków. Model końcowy wybieraj według hipotez zapisanych przed analizą, a kryteria traktuj jako informację pomocniczą. Test losowego nachylenia (M3) w tabeli liczono na dopasowaniach ML, dlatego jego wynik (χ²(2) = 8.67) nieco różni się od testu na REML z kroku 4.
Stopnie swobody, wartości p i R²
Pakiet lme4 celowo nie podaje wartości p dla efektów stałych, bo w modelach mieszanych liczba stopni swobody nie jest oczywista. Luke (2017) w symulacjach porównał popularne metody. Test ilorazu wiarygodności i traktowanie statystyki t jak z okazały się nieco liberalne, zwłaszcza w małych próbach. Odsetek błędów I rodzaju był najbliższy .05, gdy modele szacowano metodą REML, a stopnie swobody wyznaczano przybliżeniem Satterthwaite’a albo Kenwarda–Rogera. W R oba przybliżenia daje pakiet lmerTest. W naszym przykładzie metoda Kenwarda–Rogera dla interakcji daje t(37.27) = −3.12, p = .003, a Satterthwaite t(39.92) = −3.16, p = .003. Przy 60 grupach wybór metody nie zmienia wniosków, ale przy kilkunastu grupach może je zmienić. Ile grup potrzeba do takich analiz, piszemy we wpisie dobór liczebności próby.
Jako miarę wielkości efektu dla całego modelu podaj dwa współczynniki R² zaproponowane przez Nakagawę i Schielzetha (2013): marginalne R² (wariancja wyjaśniona przez efekty stałe) i warunkowe R² (przez efekty stałe i losowe łącznie). W modelu M4 wynoszą one R²m = .317 i R²c = .447. Obciążenie, wsparcie i ich interakcja wyjaśniają więc około 32% wariancji wyczerpania, a uwzględnienie różnic między zespołami podnosi ten odsetek do około 45%. Więcej o R² w modelach mieszanych znajdziesz we wpisie o pomiarach powtarzanych.
Jak opisać model wielopoziomowy w artykule?
Meteyard i Davies (2020) przeanalizowali ankietę wśród 163 badaczy i 400 artykułów. Znaleźli duże zróżnicowanie w budowaniu modeli mieszanych, a najwięcej problemów – w ich raportowaniu. Na tej podstawie sformułowali zalecenia dobrej praktyki skupione właśnie na raporcie. Sprawdź przed wysłaniem tekstu, czy opis zawiera:
- strukturę danych: liczbę jednostek na każdym poziomie, zakres i średnią liczebność grup, liczbę braków;
- ICC z modelu pustego i, gdy to pomaga, efekt schematu;
- sposób centrowania każdego predyktora (CWC, CGM) i uzasadnienie;
- pełną strukturę efektów losowych modelu końcowego i sposób jej wyboru, w tym problemy ze zbieżnością;
- metodę estymacji (REML do modelu końcowego, ML do porównań) i metodę stopni swobody;
- efekty stałe z b, SE, 95% CI, t, df i p;
- komponenty wariancji (τ00, τ11, ich korelację, σ²) i R² marginalne i warunkowe;
- porównania modeli (LRT, AIC/BIC) oraz program i wersje pakietów.
Najwygodniej zebrać wyniki modelu końcowego w jednej tabeli:
Tabela 1
Wielopoziomowy model wyczerpania emocjonalnego pracowników (model M4)
| Parametr | b | SE | 95% CI | t | df | p |
|---|---|---|---|---|---|---|
| Efekty stałe | ||||||
| Wyraz wolny | 3.62 | 0.06 | [3.50, 3.74] | 58.53 | 59.86 | < .001 |
| Obciążenie (CWC) | 0.55 | 0.07 | [0.42, 0.68] | 8.32 | 50.73 | < .001 |
| Średnie obciążenie zespołu (CGM) | 1.07 | 0.13 | [0.82, 1.31] | 8.40 | 61.80 | < .001 |
| Wsparcie kierownika | −0.28 | 0.09 | [−0.46, −0.10] | −3.07 | 58.35 | .003 |
| Obciążenie × wsparcie | −0.30 | 0.09 | [−0.48, −0.11] | −3.16 | 39.92 | .003 |
| Efekty losowe | ||||||
| Wariancja wyrazu wolnego (τ00) | 0.148 | |||||
| Wariancja nachylenia obciążenia (τ11) | 0.067 | |||||
| Korelacja wyrazu wolnego i nachylenia | −.30 | |||||
| Wariancja reszt (σ²) | 0.749 | |||||
Uwaga. N = 598 pracowników w 60 zespołach (4–16 osób). Estymacja REML; stopnie swobody metodą Satterthwaite’a; 95% CI z profilowej funkcji wiarygodności. CWC = odchylenie od średniej zespołu; CGM = średnia zespołu wycentrowana względem średniej ogólnej; wsparcie kierownika wycentrowano względem średniej zespołów. ICC (model pusty) = .303. R²m = .317, R²c = .447. Dane symulowane.
Wzór opisu metody i wyników dla tego przykładu:
Jeśli recenzent pyta, dlaczego nie użyłeś zwykłej regresji z błędami standardowymi skorygowanymi na klastrowanie albo dlaczego model ma właśnie taką strukturę efektów losowych, gotowe odpowiedzi znajdziesz we wpisie odpowiedzi recenzentom w sprawie statystyki. Gdy potrzebujesz pomocy przy budowie i raportowaniu modelu do artykułu albo grantu, zajrzyj do oferty analiz statystycznych dla badaczy.
Model wielopoziomowy w R: kod i wynik
Skrypt generuje dane symulowane z tego wpisu i dopasowuje wszystkie modele po kolei: od modelu pustego do interakcji międzypoziomowej. Liczby w tekście, tabelach i na rysunkach pochodzą z tego uruchomienia.
Pięć modeli: ICC, centrowanie, losowe nachylenie, interakcja międzypoziomowa i porównania
R
# B49 – model wielopoziomowy krok po kroku: pracownicy w zespołach (dane symulowane)
library(lme4)         # lmer()
library(lmerTest)     # testy t z df Satterthwaite'a, ranova()
library(performance)  # icc(), r2_nakagawa()
library(emmeans)      # emtrends(): proste nachylenia

# --- 1. Dane symulowane: 60 zespołów, 4–16 osób w zespole --------------------------------
set.seed(1)
J <- 60
zesp <- data.frame(zespol = factor(sprintf("Z%02d", 1:J)),
                   n_j = sample(4:16, J, replace = TRUE),
                   obc_zesp = rnorm(J, 3.0, 0.45),                          # przeciętne obciążenie w zespole
                   wsparcie = pmin(pmax(round(rnorm(J, 3.4, 0.7), 1), 1), 5), # wsparcie kierownika (1–5), poziom 2
                   u0 = rnorm(J, 0, 0.42), u1 = rnorm(J, 0, 0.22))
dane <- zesp[rep(1:J, zesp$n_j), ]
dane$obciazenie <- pmin(pmax(round(dane$obc_zesp + rnorm(nrow(dane), 0, 0.7), 1), 1), 5)
x_w <- dane$obciazenie - ave(dane$obciazenie, dane$zespol)
dane$wyczerpanie <- with(dane, pmin(pmax(round(
  3.6 + (0.55 + u1 - 0.30 * (wsparcie - 3.4)) * x_w + 1.00 * (ave(obciazenie, zespol) - 3) -
    0.35 * (wsparcie - 3.4) + u0 + rnorm(nrow(dane), 0, 0.85), 2), 1), 7))
dane <- dane[, c("zespol", "obciazenie", "wsparcie", "wyczerpanie")]
rownames(dane) <- NULL
c(N = nrow(dane), zespoly = nlevels(dane$zespol), n_min = min(table(dane$zespol)),
  n_max = max(table(dane$zespol)), n_sr = mean(table(dane$zespol)))
round(sapply(dane[, -1], function(x) c(M = mean(x), SD = sd(x))), 2)

# --- 2. Centrowanie: CWC (względem średniej zespołu) i CGM (średnie zespołów względem średniej ogólnej)
dane$obc_sr  <- ave(dane$obciazenie, dane$zespol)              # średnia zespołu
dane$obc_cwc <- dane$obciazenie - dane$obc_sr                  # odchylenie osoby od średniej zespołu
dane$obc_cgm <- dane$obc_sr - mean(dane$obciazenie)            # średnia zespołu względem średniej ogólnej
dane$obc_gmc <- dane$obciazenie - mean(dane$obciazenie)        # klasyczne centrowanie do średniej ogólnej
dane$wsp_c   <- dane$wsparcie - mean(zesp$wsparcie)            # wsparcie wycentrowane na poziomie zespołów
round(c(sr_ogolna_obc = mean(dane$obciazenie), sr_wsparcie = mean(zesp$wsparcie),
        SD_wsparcie = sd(zesp$wsparcie)), 2)

# --- 3. Model pusty: ICC i efekt schematu ------------------------------------------------
m0 <- lmer(wyczerpanie ~ 1 + (1 | zespol), data = dane)
summary(m0)
icc(m0)
vc0 <- as.data.frame(VarCorr(m0))$vcov
icc0 <- vc0[1] / sum(vc0)
n_sr <- mean(table(dane$zespol))
round(c(tau00 = vc0[1], sigma2 = vc0[2], ICC = icc0, deff = 1 + (n_sr - 1) * icc0,
        N_efektywne = nrow(dane) / (1 + (n_sr - 1) * icc0)), 3)

# --- 4. Predyktory poziomu 1 i 2 z rozdzieleniem efektów wewnątrz- i międzyzespołowych ------
m_gmc <- lmer(wyczerpanie ~ obc_gmc + (1 | zespol), data = dane)       # jeden współczynnik „mieszany”
m1 <- lmer(wyczerpanie ~ obc_cwc + obc_cgm + (1 | zespol), data = dane)
m2 <- lmer(wyczerpanie ~ obc_cwc + obc_cgm + wsp_c + (1 | zespol), data = dane)
round(coef(summary(m_gmc)), 3)
round(coef(summary(m1)), 3)
round(coef(summary(m2)), 3)
# komponenty wariancji w kolejnych modelach i odsetek wyjaśnionej wariancji na każdym poziomie
vc <- sapply(list(m0 = m0, m1 = m1, m2 = m2), function(m) as.data.frame(VarCorr(m))$vcov)
rownames(vc) <- c("tau00", "sigma2")
round(rbind(vc, R2_poziom2 = 1 - vc["tau00", ] / vc["tau00", "m0"],
            R2_poziom1 = 1 - vc["sigma2", ] / vc["sigma2", "m0"]), 3)
# efekt kontekstowy = efekt międzyzespołowy − efekt wewnątrzzespołowy (model z obc_gmc i obc_cgm)
m1k <- lmer(wyczerpanie ~ obc_gmc + obc_cgm + (1 | zespol), data = dane)
round(coef(summary(m1k)), 3)
round(confint(m1k, parm = "obc_cgm", method = "Wald"), 2)

# --- 5. Losowe nachylenie obciążenia: test ilorazu wiarygodności (REML) -----------------
m3 <- lmer(wyczerpanie ~ obc_cwc + obc_cgm + wsp_c + (1 + obc_cwc | zespol), data = dane)
anova(m2, m3, refit = FALSE)
ranova(m3)
# wariancja nie może być ujemna (test na granicy przestrzeni parametrów): p z mieszaniny χ²(1) i χ²(2)
lrt <- anova(m2, m3, refit = FALSE)$Chisq[2]
round(c(LRT = lrt, p_chi2_df2 = pchisq(lrt, 2, lower.tail = FALSE),
        p_mieszanina = 0.5 * pchisq(lrt, 1, lower.tail = FALSE) + 0.5 * pchisq(lrt, 2, lower.tail = FALSE)), 4)
VarCorr(m3)

# --- 6. Interakcja międzypoziomowa: wsparcie kierownika × obciążenie (CWC) ---------------
m4 <- lmer(wyczerpanie ~ obc_cwc * wsp_c + obc_cgm + (1 + obc_cwc | zespol), data = dane)
summary(m4)
round(confint(m4, parm = "beta_", method = "profile"), 2)   # 95% CI efektów stałych

# proste nachylenia obciążenia przy niskim (−1 SD), średnim i wysokim (+1 SD) wsparciu
sd_wsp <- sd(zesp$wsparcie)
emtrends(m4, ~ wsp_c, var = "obc_cwc", at = list(wsp_c = c(-sd_wsp, 0, sd_wsp)),
         lmer.df = "satterthwaite")
# zmniejszenie wariancji losowych nachyleń po dodaniu interakcji
round(c(tau11_m3 = VarCorr(m3)$zespol[2, 2], tau11_m4 = VarCorr(m4)$zespol[2, 2],
        redukcja = 1 - VarCorr(m4)$zespol[2, 2] / VarCorr(m3)$zespol[2, 2]), 3)

# --- 7. Porównanie modeli efektów stałych: ML (refit), AIC, BIC, LRT --------------------
anova(m0, m1, m2, m3, m4)               # anova() z lmerTest dopasowuje modele ponownie metodą ML

# --- 8. REML a ML: te same efekty stałe, inne komponenty wariancji ---------------------
m4_ml <- update(m4, REML = FALSE)
round(rbind(REML = c(fixef(m4), as.data.frame(VarCorr(m4))$vcov),
            ML = c(fixef(m4_ml), as.data.frame(VarCorr(m4_ml))$vcov)), 4)

# --- 9. R² marginalne i warunkowe, porównanie z naiwną regresją MNK --------------------
r2_nakagawa(m4)
ols <- lm(wyczerpanie ~ obc_cwc * wsp_c + obc_cgm, data = dane)
round(rbind(MLM = coef(summary(m4))[c("wsp_c", "obc_cgm"), 1:2],
            OLS = coef(summary(ols))[c("wsp_c", "obc_cgm"), 1:2]), 3)

# --- 10. Kenward–Roger zamiast Satterthwaite'a dla efektów stałych modelu końcowego ----
round(coef(summary(m4, ddf = "Kenward-Roger")), 3)

write.csv(dane[, c("zespol", "obciazenie", "wsparcie", "wyczerpanie")],
          "../model-wielopoziomowy-dane-zespoly.csv", row.names = FALSE)
Wynik w R
Loading required package: Matrix

Attaching package: ‘lmerTest’

The following object is masked from ‘package:lme4’:

    lmer

The following object is masked from ‘package:stats’:

    step

Welcome to emmeans.
Caution: You lose important information if you filter this package's results.
See '? untidy'
         N    zespoly      n_min      n_max       n_sr
598.000000  60.000000   4.000000  16.000000   9.966667
   obciazenie wsparcie wyczerpanie
M        3.01     3.32        3.64
SD       0.81     0.69        1.17
sr_ogolna_obc   sr_wsparcie   SD_wsparcie
         3.01          3.34          0.68
Linear mixed model fit by REML. t-tests use Satterthwaite's method ['lmerModLmerTest']
Formula: wyczerpanie ~ 1 + (1 | zespol)
   Data: dane

REML criterion at convergence: 1762

Scaled residuals:
    Min      1Q  Median      3Q     Max
-2.9162 -0.6103  0.0116  0.6526  3.2409

Random effects:
 Groups   Name        Variance Std.Dev.
 zespol   (Intercept) 0.4104   0.6406
 Residual             0.9431   0.9711
Number of obs: 598, groups:  zespol, 60

Fixed effects:
            Estimate Std. Error      df t value Pr(>|t|)
(Intercept)   3.6086     0.0927 59.0010   38.93   <2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Intraclass Correlation Coefficient

    Adjusted ICC: 0.303
  Unadjusted ICC: 0.303
      tau00      sigma2         ICC        deff N_efektywne
      0.410       0.943       0.303       3.719     160.813
            Estimate Std. Error      df t value Pr(>|t|)
(Intercept)    3.618      0.071  58.817  50.942        0
obc_gmc        0.617      0.053 590.218  11.745        0
            Estimate Std. Error      df t value Pr(>|t|)
(Intercept)    3.622      0.067  61.060  54.425        0
obc_cwc        0.554      0.056 541.680   9.847        0
obc_cgm        1.043      0.137  63.697   7.617        0
            Estimate Std. Error      df t value Pr(>|t|)
(Intercept)    3.621      0.062  60.045  58.229    0.000
obc_cwc        0.554      0.056 542.096   9.848    0.000
obc_cgm        1.076      0.129  62.763   8.367    0.000
wsp_c         -0.283      0.092  58.446  -3.069    0.003
              m0    m1    m2
tau00      0.410 0.178 0.145
sigma2     0.943 0.798 0.798
R2_poziom2 0.000 0.565 0.646
R2_poziom1 0.000 0.154 0.154
            Estimate Std. Error      df t value Pr(>|t|)
(Intercept)    3.622      0.067  61.060  54.425    0.000
obc_gmc        0.554      0.056 541.680   9.847    0.000
obc_cgm        0.490      0.148  86.387   3.307    0.001
        2.5 % 97.5 %
obc_cgm   0.2   0.78
Data: dane
Models:
m2: wyczerpanie ~ obc_cwc + obc_cgm + wsp_c + (1 | zespol)
m3: wyczerpanie ~ obc_cwc + obc_cgm + wsp_c + (1 + obc_cwc | zespol)
   npar    AIC    BIC  logLik -2*log(L) Chisq Df Pr(>Chisq)
m2    6 1643.5 1669.8 -815.73    1631.5
m3    8 1638.4 1673.6 -811.21    1622.4 9.051  2    0.01083 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
ANOVA-like table for random-effects: Single term deletions

Model:
wyczerpanie ~ obc_cwc + obc_cgm + wsp_c + (1 + obc_cwc | zespol)
                                  npar  logLik    AIC   LRT Df Pr(>Chisq)
<none>                               8 -811.21 1638.4
obc_cwc in (1 + obc_cwc | zespol)    6 -815.73 1643.5 9.051  2    0.01083 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
         LRT   p_chi2_df2 p_mieszanina
      9.0510       0.0108       0.0067
 Groups   Name        Std.Dev. Corr
 zespol   (Intercept) 0.38542
          obc_cwc     0.31824  -0.271
 Residual             0.86632
Linear mixed model fit by REML. t-tests use Satterthwaite's method ['lmerModLmerTest']
Formula: wyczerpanie ~ obc_cwc * wsp_c + obc_cgm + (1 + obc_cwc | zespol)
   Data: dane

REML criterion at convergence: 1616

Scaled residuals:
     Min       1Q   Median       3Q      Max
-3.03158 -0.65268  0.00145  0.60044  3.01347

Random effects:
 Groups   Name        Variance Std.Dev. Corr
 zespol   (Intercept) 0.14814  0.3849
          obc_cwc     0.06661  0.2581   -0.30
 Residual             0.74900  0.8654
Number of obs: 598, groups:  zespol, 60

Fixed effects:
              Estimate Std. Error       df t value Pr(>|t|)
(Intercept)    3.62199    0.06188 59.86363  58.528  < 2e-16 ***
obc_cwc        0.54761    0.06586 50.73462   8.315 4.88e-11 ***
wsp_c         -0.28161    0.09181 58.34509  -3.067  0.00327 **
obc_cgm        1.06701    0.12700 61.80264   8.402 8.16e-12 ***
obc_cwc:wsp_c -0.29662    0.09394 39.92153  -3.157  0.00303 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Correlation of Fixed Effects:
            (Intr) obc_cw wsp_c  obc_cg
obc_cwc     -0.125
wsp_c        0.011 -0.001
obc_cgm      0.014 -0.004 -0.084
obc_cwc:ws_ -0.001  0.022 -0.132  0.000
Computing profile confidence intervals ...
              2.5 % 97.5 %
(Intercept)    3.50   3.74
obc_cwc        0.42   0.68
wsp_c         -0.46  -0.10
obc_cgm        0.82   1.31
obc_cwc:wsp_c -0.48  -0.11
  wsp_c obc_cwc.trend     SE   df lower.CL upper.CL
 -0.677         0.748 0.0906 46.1    0.566    0.931
  0.000         0.548 0.0659 50.7    0.415    0.680
  0.677         0.347 0.0926 44.1    0.160    0.533

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
tau11_m3 tau11_m4 redukcja
   0.101    0.067    0.342
refitting model(s) with ML (instead of REML)
Data: dane
Models:
m0: wyczerpanie ~ 1 + (1 | zespol)
m1: wyczerpanie ~ obc_cwc + obc_cgm + (1 | zespol)
m2: wyczerpanie ~ obc_cwc + obc_cgm + wsp_c + (1 | zespol)
m3: wyczerpanie ~ obc_cwc + obc_cgm + wsp_c + (1 + obc_cwc | zespol)
m4: wyczerpanie ~ obc_cwc * wsp_c + obc_cgm + (1 + obc_cwc | zespol)
   npar    AIC    BIC  logLik -2*log(L)    Chisq Df Pr(>Chisq)
m0    3 1765.1 1778.3 -879.54    1759.1
m1    5 1637.7 1659.7 -813.85    1627.7 131.3916  2  < 2.2e-16 ***
m2    6 1630.6 1656.9 -809.28    1618.6   9.1353  1   0.002507 **
m3    8 1625.9 1661.0 -804.94    1609.9   8.6734  2   0.013080 *
m4    9 1618.3 1657.9 -800.17    1600.3   9.5364  1   0.002014 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
     (Intercept) obc_cwc   wsp_c obc_cgm obc_cwc:wsp_c
REML      3.6220  0.5476 -0.2816  1.0670       -0.2966 0.1481 0.0666 -0.0293 0.7490
ML        3.6224  0.5481 -0.2819  1.0663       -0.2956 0.1374 0.0577 -0.0289 0.7489
# R2 for Mixed Models

  Conditional R2: 0.447
     Marginal R2: 0.317
        Estimate Std. Error
wsp_c     -0.282      0.092
obc_cgm    1.067      0.127
wsp_c     -0.294      0.058
obc_cgm    1.071      0.083
              Estimate Std. Error     df t value Pr(>|t|)
(Intercept)      3.622      0.062 55.850  58.482    0.000
obc_cwc          0.548      0.066 47.397   8.254    0.000
wsp_c           -0.282      0.092 54.427  -3.064    0.003
obc_cgm          1.067      0.129 58.244   8.249    0.000
obc_cwc:wsp_c   -0.297      0.095 37.272  -3.124    0.003
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele dopasowano w pakiecie lme4, testy efektów stałych ze stopniami swobody Satterthwaite’a i Kenwarda–Rogera policzono w pakietach lmerTest i pbkrtest, ICC i R² – w pakiecie performance, a proste nachylenia – w pakiecie emmeans. Rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2-1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), Article 3139. https://doi.org/10.21105/joss.03139
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- pbkrtest (wersja 0.5.5): Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models – The R package pbkrtest. Journal of Statistical Software, 59(9), 1–30. https://doi.org/10.18637/jss.v059.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w modelach wielopoziomowych
- Jeden współczynnik dla predyktora poziomu 1 bez rozdzielenia poziomów – w przykładzie dałby b = 0.62, mieszaninę efektu wewnątrzzespołowego (0.55) i międzyzespołowego (1.04).
- Rezygnacja z modelu wielopoziomowego, „bo ICC jest małe” albo Deff < 2 – reguła ta zawodzi dla predyktorów poziomu 2 i małych grup (Lai i Kwok, 2015).
- Interakcja międzypoziomowa bez losowego nachylenia predyktora poziomu 1 – test interakcji staje się zbyt liberalny.
- Porównywanie modeli o różnych efektach stałych na dopasowaniach REML – do takich porównań potrzebujesz ML.
- Zwykłe p z rozkładu χ² przy teście wariancji bez wzmianki, że test leży na granicy przestrzeni parametrów i jest zachowawczy.
- Interpretowanie stopni swobody liczonych od liczby osób dla predyktorów poziomu 2 – o ich precyzji decyduje liczba grup.
- Brak informacji o centrowaniu – bez niej czytelnik nie wie, co znaczy wyraz wolny ani które nachylenie raportujesz.
- Przyczynowa interpretacja efektów poziomu 2 w badaniu obserwacyjnym – wsparcie kierownika nie było przydzielane losowo, a w schemacie korelacyjnym model opisuje związki.
- Raport bez komponentów wariancji i ICC – same efekty stałe nie pokazują, ile zróżnicowania leży na każdym poziomie.
Najczęstsze pytania
Jak obliczyć ICC z modelu pustego w R?
Dopasuj model bez predyktorów z losowym wyrazem wolnym, np. lmer(y ~ 1 + (1 | grupa)), i podziel wariancję między grupami przez sumę wariancji między grupami i reszt: ICC = τ00 / (τ00 + σ²). Ten sam wynik daje funkcja icc() z pakietu performance. W przykładzie z 60 zespołami ICC = .303, czyli 30.3% wariancji wyczerpania to różnice między zespołami.
Czym się różni centrowanie CWC od CGM w modelu wielopoziomowym?
CWC (centrowanie w grupach) odejmuje od wyniku osoby średnią jej grupy, więc współczynnik opisuje związek wewnątrz grup. CGM (centrowanie do średniej ogólnej) stosuje się do zmiennych poziomu 2, w tym do średnich grup. Wprowadzenie obu zmiennych rozdziela efekt wewnątrzgrupowy i międzygrupowy, a ich różnica to efekt kontekstowy (Enders i Tofighi, 2007).
Kiedy w modelu wielopoziomowym używać REML, a kiedy ML?
REML daje mniej obciążone oszacowania komponentów wariancji, zwłaszcza przy małej liczbie grup, więc tą metodą raportuj model końcowy (McNeish, 2017). Do porównywania modeli różniących się efektami stałymi (test ilorazu wiarygodności, AIC, BIC) użyj ML. Modele różniące się tylko efektami losowymi możesz porównać na dopasowaniach REML.
Czy interakcja międzypoziomowa wymaga losowego nachylenia?
Tak, predyktor poziomu 1 z interakcji powinien mieć w modelu losowe nachylenie. Bez niego zróżnicowanie nachyleń między grupami trafia do reszt na poziomie osób, a błąd standardowy interakcji może być zaniżony. Losowe nachylenie warto dodać nawet wtedy, gdy test jego wariancji jest nieistotny.
Co podać w raporcie modelu wielopoziomowego w artykule?
Strukturę danych (liczbę grup i osób), ICC, sposób centrowania, pełną strukturę efektów losowych, metodę estymacji i stopni swobody, efekty stałe z b, SE, 95% CI, t, df i p, komponenty wariancji oraz R² marginalne i warunkowe. Meteyard i Davies (2020) pokazali, że to właśnie raportowanie modeli mieszanych jest w psychologii najbardziej niejednolite.
Powiązane hasła
Przeczytaj też
ANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →Masz dane zagnieżdżone i nie wiesz, jak zbudować model?
Pomożemy zaplanować sekwencję modeli, dobrać centrowanie i strukturę efektów losowych, wykonamy analizę w R i przygotujemy tabele oraz opis metody do artykułu lub odpowiedzi recenzentom.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Aarts, E., Verhage, M., Veenvliet, J. V., Dolan, C. V., & van der Sluis, S. (2014). A solution to dependency: Using multilevel analysis to accommodate nested data. Nature Neuroscience, 17(4), 491–496. https://doi.org/10.1038/nn.3648
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373–400. https://doi.org/10.1207/s15327906mbr4003_5 ● Otwarty dostęp
- Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121–138. https://doi.org/10.1037/1082-989x.12.2.121
- Hox, J. J., Moerbeek, M., & van de Schoot, R. (2017). Multilevel analysis: Techniques and applications (3rd ed.). Routledge. https://doi.org/10.4324/9781315650982
- Lai, M. H. C., & Kwok, O. (2015). Examining the rule of thumb of not using multilevel modeling: The “design effect smaller than two” rule. The Journal of Experimental Education, 83(3), 423–438. https://doi.org/10.1080/00220973.2014.907229
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
- Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001 ● Otwarty dostęp
- McNeish, D. (2017). Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction. Multivariate Behavioral Research, 52(5), 661–670. https://doi.org/10.1080/00273171.2017.1344538
- Meteyard, L., & Davies, R. A. I. (2020). Best practice guidance for linear mixed-effects models in psychological science. Journal of Memory and Language, 112, Article 104092. https://doi.org/10.1016/j.jml.2020.104092 ● Otwarty dostęp: pełny tekst
- Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining R² from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage.
- Sommet, N., & Morselli, D. (2017). Keep calm and learn multilevel logistic modeling: A simplified three-step procedure using Stata, R, Mplus, and SPSS. International Review of Social Psychology, 30(1), 203–218. https://doi.org/10.5334/irsp.90 ● Otwarty dostęp
Cytowania BibTeX
@article{aarts2014solution, author={Aarts, Emmeke and Verhage, Matthijs and Veenvliet, Jesse V. and Dolan, Conor V. and van der Sluis, Sophie}, title={{A solution to dependency: Using multilevel analysis to accommodate nested data}}, journal={Nature Neuroscience}, year={2014}, volume={17}, number={4}, pages={491--496}, doi={10.1038/nn.3648}}@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{bauer2005probing, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Probing interactions in fixed and multilevel regression: Inferential and graphical techniques}}, journal={Multivariate Behavioral Research}, year={2005}, volume={40}, number={3}, pages={373--400}, doi={10.1207/s15327906mbr4003_5}}@article{enders2007centering, author={Enders, Craig K. and Tofighi, Davood}, title={{Centering predictor variables in cross-sectional multilevel models: A new look at an old issue}}, journal={Psychological Methods}, year={2007}, volume={12}, number={2}, pages={121--138}, doi={10.1037/1082-989x.12.2.121}}@book{hox2017multilevel, author={Hox, Joop J. and Moerbeek, Mirjam and van de Schoot, Rens}, title={{Multilevel analysis: Techniques and applications (3rd ed.)}}, year={2017}, publisher={Routledge}, doi={10.4324/9781315650982}}@article{lai2015examining, author={Lai, Mark H. C. and Kwok, Oi-man}, title={{Examining the rule of thumb of not using multilevel modeling: The “design effect smaller than two” rule}}, journal={The Journal of Experimental Education}, year={2015}, volume={83}, number={3}, pages={423--438}, doi={10.1080/00220973.2014.907229}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}@article{matuschek2017balancing, author={Matuschek, Hannes and Kliegl, Reinhold and Vasishth, Shravan and Baayen, Harald and Bates, Douglas}, title={{Balancing Type I error and power in linear mixed models}}, journal={Journal of Memory and Language}, year={2017}, volume={94}, pages={305--315}, doi={10.1016/j.jml.2017.01.001}}@article{mcneish2017small, author={McNeish, Daniel}, title={{Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction}}, journal={Multivariate Behavioral Research}, year={2017}, volume={52}, number={5}, pages={661--670}, doi={10.1080/00273171.2017.1344538}}@article{meteyard2020best, author={Meteyard, Lotte and Davies, Robert A. I.}, title={{Best practice guidance for linear mixed-effects models in psychological science}}, journal={Journal of Memory and Language}, year={2020}, volume={112}, eid={104092}, doi={10.1016/j.jml.2020.104092}}@article{nakagawa2013general, author={Nakagawa, Shinichi and Schielzeth, Holger}, title={{A general and simple method for obtaining R² from generalized linear mixed-effects models}}, journal={Methods in Ecology and Evolution}, year={2013}, volume={4}, number={2}, pages={133--142}, doi={10.1111/j.2041-210x.2012.00261.x}}@book{raudenbush2002hierarchical, author={Raudenbush, Stephen W. and Bryk, Anthony S.}, title={{Hierarchical linear models: Applications and data analysis methods (2nd ed.)}}, year={2002}, publisher={Sage}}@article{sommet2017keep, author={Sommet, Nicolas and Morselli, Davide}, title={{Keep calm and learn multilevel logistic modeling: A simplified three-step procedure using Stata, R, Mplus, and SPSS}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={203--218}, doi={10.5334/irsp.90}}