Model mieszany w jamovi: moduł GAMLj
Liniowy model mieszany przydaje się, gdy te same osoby mierzysz kilka razy, a ktoś opuścił pomiar. Kiedy wybrać go zamiast ANOVA, wyjaśnia wpis ANOVA z powtarzanymi pomiarami czy model mieszany, a samą ANOVA w jamovi – wpis ANOVA z powtarzanymi pomiarami w jamovi. Tutaj zajmujemy się oknem, opcjami i tabelami.
Podstawowe menu jamovi nie ma modelu mieszanego. Daje go moduł GAMLj, który w bibliotece modułów nazywa się General Analyses for Linear Models (v3). Instalujesz go przyciskiem Modules → jamovi library i jest dostępny od razu (The jamovi project, b.d.). Pierwsze kroki w programie opisuje wpis jamovi krok po kroku.
Opisujemy wersję 3.7.2 modułu (Gallucci, b.d.-b). Strony pomocy GAMLj opisują wcześniejsze wersje: strona główna podaje 3.0.0, a przykład z pomiarami powtarzanymi – 2.0.0 (Gallucci, b.d.-a). Dlatego nazwy menu, opcji i tabel wzięliśmy z plików definicji analizy w repozytorium modułu; w polskiej wersji interfejsu mogą się różnić. GAMLj szacuje model funkcją lmer z pakietu lmerTest, a średnie brzegowe liczy pakietem emmeans (Gallucci, b.d.-b). Samego modułu nie uruchamialiśmy – liczby policzyliśmy w R tymi samymi funkcjami.
Przykład i pliki do pobrania
Dane są fikcyjne. 72 osoby studiujące wylosowano do tutoringu ze statystyki (n = 36) albo do grupy kontrolnej (n = 36). Poczucie własnej skuteczności w statystyce (10–50 pkt) zmierzono cztery razy: w tygodniu 0, 4, 8 i 12. Część osób zrezygnowała z badania: komplet ma 57 osób, a 15 osób ma od jednego do trzech pomiarów. Czy grupy różnią się zmianą w czasie?
Pobierz plik CSV albo plik .sav z etykietami. Plik ma 262 wiersze i kolumny id, grupa, pomiar (1–4), tydzien (0, 4, 8, 12) i skutecznosc. Ziarno losowania wybraliśmy spośród kilkudziesięciu tak, żeby przykład miał wyraźną interakcję i losowe nachylenie bez ostrzeżeń o zbieżności.
Dane w formacie długim
GAMLj potrzebuje formatu długiego: jeden wiersz to jeden pomiar jednej osoby (Gallucci, b.d.-a). To odwrotnie niż w oknie Repeated Measures ANOVA, gdzie każdy pomiar jest osobną kolumną. Brakujący pomiar to po prostu brak wiersza, więc osoba z dwoma pomiarami zostaje w analizie. Sprawdź typy zmiennych w zakładce Setup:
grupaipomiar– Nominal. Zmienne kategorialne muszą być nominalne albo porządkowe (Gallucci, b.d.-a). Kolejność poziomów ma znaczenie, bo pierwszy poziom jest odniesieniem;id– zmienna grupująca (klaster), tu też Nominal;tydzieniskutecznosc– Continuous.
Etykiety i braki ustawisz według wpisu przygotowanie danych w jamovi. Średnie obserwowane w tygodniu 0 były w grupach prawie równe (28.78 i 28.75), a w tygodniu 12 wyniosły 28.11 w kontrolnej i 36.00 w tutoringu.
Okno Linear Mixed Model krok po kroku
- Linear Models → GAMLj3 → Linear Mixed Model (Gallucci, b.d.-b).
skutecznoscprzeciągnij do Dependent Variable,grupaipomiardo Factors, aiddo Cluster variables. - Fixed Effects: efekty główne i interakcja czynników trafiają do Model Terms automatycznie (Gallucci, b.d.-a). Sprawdź, że jest
grupa ✻ pomiar. - Random Effects: z listy Components wybierz Intercept | id. Kreska to notacja lme4: „losowo zmienny między” (Gallucci, b.d.-a). Tak powstaje losowy wyraz wolny osoby.
- Estimation i Options: w polu Estimation pod listami zmiennych zostaw zaznaczone REML, a w panelu Options – DF Method = Satterthwaite. Druga możliwość to Kenward-Roger, oznaczony w oknie jako wolny (Gallucci, b.d.-b). Oba przybliżenia z REML dawały w symulacjach Luke’a (2017) odsetek błędów I rodzaju bliski .05.
- Estimated Marginal Means: przenieś
grupa ✻ pomiar. Simple Effects:grupado Simple effects variable,pomiardo Moderators. - Plots:
pomiarna Horizontal axis,grupaw Separate lines, a w Display zaznacz Confidence Intervals (Gallucci, b.d.-a).
Liczby policzono w R tymi samymi funkcjami co GAMLj; układ kolumn jak w definicji tabel GAMLj. Pogrubione liczby trafią do pracy.
Krok 1: model pusty i ICC
Zacznij od modelu bez efektów stałych: usuń wszystko z Model Terms i zostaw Intercept | id.
| Groups | Name | Variance | SD | ICC |
|---|---|---|---|---|
| id | (Intercept) | 26.420 | 5.140 | .599 |
| Residual | 17.671 | 4.204 |
GAMLj liczy ICC jako wariancję wyrazu wolnego podzieloną przez sumę tej wariancji i wariancji reszt (Gallucci, b.d.-b): 26.420 / (26.420 + 17.671) = .60. Około 60% zmienności to stałe różnice między osobami, więc pomiary tej samej osoby są silnie skorelowane. W SPSS ten iloraz trzeba czasem policzyć samemu z tabeli parametrów kowariancji.
Krok 2: tabele modelu z losowym wyrazem wolnym
Teraz dodaj z powrotem grupa, pomiar i grupa ✻ pomiar. Tabela Model Info wypisuje m.in. formułę, metodę df, liczebność i wiersz Converged (Gallucci, b.d.-b). Jeśli pojawi się ostrzeżenie o zbieżności albo dopasowaniu osobliwym, zajrzyj do wpisu model mieszany się nie zbiega.
| F | df | df (res) | p | |
|---|---|---|---|---|
| grupa | 7.953 | 1 | 71.49 | .006 |
| pomiar | 7.547 | 3 | 187.95 | < .001 |
| grupa ✻ pomiar | 11.126 | 3 | 187.95 | < .001 |
Tabelę daje funkcja anova pakietu lmerTest z F typu III (Gallucci, b.d.-b). Ułamkowe df (res) to przybliżenie Satterthwaite’a (Kuznetsova i in., 2017). Najważniejsza jest interakcja: grupy różnią się przebiegiem zmian.
| Efekt | Estimate | SE | Lower | Upper | df | t | p |
|---|---|---|---|---|---|---|---|
| (Intercept) | 30.444 | 0.632 | 29.200 | 31.688 | 71.49 | 48.198 | < .001 |
| grupa: tutoring − kontrolna | 3.562 | 1.263 | 1.075 | 6.050 | 71.49 | 2.820 | .006 |
| pomiar: 2 − 1 | 1.496 | 0.630 | 0.255 | 2.737 | 186.98 | 2.375 | .019 |
| pomiar: 3 − 1 | 2.114 | 0.655 | 0.825 | 3.403 | 188.82 | 3.230 | .001 |
| pomiar: 4 − 1 | 3.111 | 0.677 | 1.777 | 4.444 | 189.58 | 4.593 | < .001 |
| grupa ✻ pomiar (2 − 1) | 2.685 | 1.260 | 0.204 | 5.167 | 186.98 | 2.131 | .034 |
| grupa ✻ pomiar (3 − 1) | 3.936 | 1.309 | 1.358 | 6.514 | 188.82 | 3.006 | .003 |
| grupa ✻ pomiar (4 − 1) | 7.740 | 1.354 | 5.072 | 10.407 | 189.58 | 5.714 | < .001 |
Kluczem jest kodowanie simple, domyślne w GAMLj. Każdy poziom porównywany jest z pierwszym, a kody są wyśrodkowane (Gallucci, b.d.-a). Wyraz wolny 30.44 to średnia ze wszystkich ośmiu średnich brzegowych. Efekt grupy 3.56 to różnica tutoring − kontrolna uśredniona po czterech pomiarach. Współczynnik interakcji 7.74 mówi, o ile różnica grup w tygodniu 12 jest większa niż w tygodniu 0: 7.71 − (−0.03). Lower i Upper to przedziały Walda; przyjęliśmy dla nich rozkład t z df = liczba pomiarów minus liczba parametrów (252).
Tabela Random Components tego modelu: wariancja wyrazu wolnego 24.518 (SD = 4.952), reszt 13.966 (SD = 3.737), ICC = .637. Tabela Model Fit podaje R² marginalne i warunkowe (Gallucci, b.d.-b). Według formuł Nakagawy i Schielzetha (2013) wynoszą .136 i .687. Efekty stałe wyjaśniają więc 14% wariancji, a razem z różnicami między osobami – 69%. Zob. hasło R² w modelach wielopoziomowych.
Średnie brzegowe i simple effects
Średnie brzegowe to średnie przewidywane przez model. Tabela Estimate Marginal Means – grupa:pomiar ma kolumny Mean, SE, df, Lower i Upper (Gallucci, b.d.-b). Rysunek 1 pokazuje to samo, co wykres z panelu Plots z przedziałami ufności.
| pomiar | grupa | Mean | SE | df | Lower | Upper |
|---|---|---|---|---|---|---|
| 1 (tydz. 0) | kontrolna | 28.778 | 1.034 | 122.93 | 26.731 | 30.824 |
| 1 (tydz. 0) | tutoring | 28.750 | 1.034 | 122.93 | 26.703 | 30.797 |
| 2 (tydz. 4) | kontrolna | 28.931 | 1.043 | 125.58 | 26.868 | 30.995 |
| 2 (tydz. 4) | tutoring | 31.589 | 1.043 | 125.58 | 29.525 | 33.652 |
| 3 (tydz. 8) | kontrolna | 28.924 | 1.086 | 140.74 | 26.777 | 31.071 |
| 3 (tydz. 8) | tutoring | 32.832 | 1.059 | 131.19 | 30.738 | 34.926 |
| 4 (tydz. 12) | kontrolna | 28.019 | 1.116 | 151.60 | 25.813 | 30.224 |
| 4 (tydz. 12) | tutoring | 35.730 | 1.084 | 140.46 | 33.587 | 37.873 |
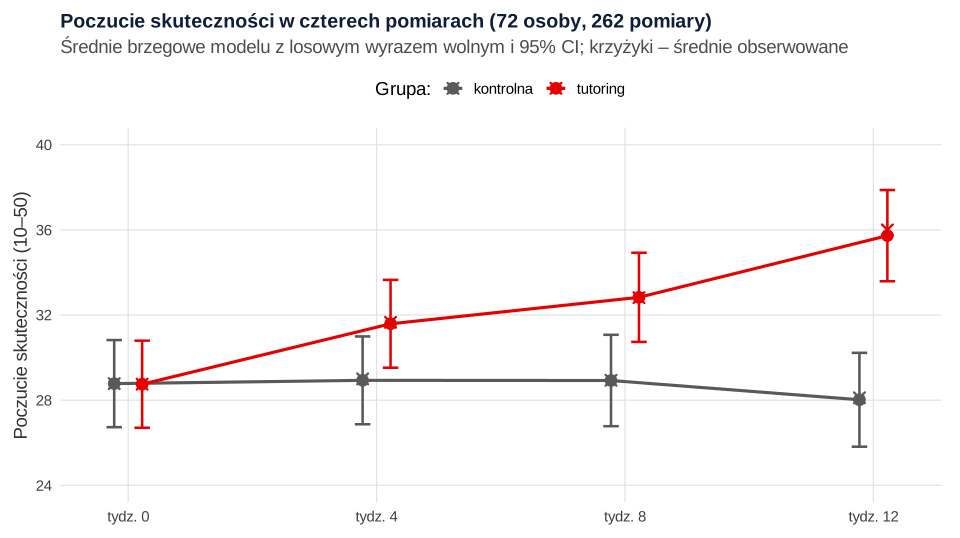
Przy brakach średnie brzegowe odbiegają od obserwowanych (w tygodniu 12 w tutoringu 35.73 wobec 36.00), bo model korzysta z wcześniejszych pomiarów osób, które odpadły. Panel Simple Effects odpowiada na pytanie: w którym pomiarze grupy się różnią? To efekty proste grupy na każdym poziomie pomiaru. GAMLj liczy je pakietem emmeans z tą samą metodą df (Gallucci, b.d.-b).
| pomiar | Estimate | SE | Lower | Upper | df | t | p |
|---|---|---|---|---|---|---|---|
| 1 (tydz. 0) | −0.028 | 1.462 | −2.922 | 2.867 | 122.93 | −0.019 | .985 |
| 2 (tydz. 4) | 2.658 | 1.475 | −0.261 | 5.576 | 125.58 | 1.802 | .074 |
| 3 (tydz. 8) | 3.908 | 1.517 | 0.909 | 6.908 | 136.01 | 2.577 | .011 |
| 4 (tydz. 12) | 7.712 | 1.556 | 4.637 | 10.787 | 146.10 | 4.957 | < .001 |
Druga tabela, ANOVA for Simple Effects, podaje to samo jako test F z Num df = 1. Przy dwóch grupach F = t², np. w tygodniu 12 F(1, 146.10) = 24.57. Na starcie grupy się nie różniły, a różnica rosła: 2.66 pkt po 4 tygodniach (p = .074), 3.91 po 8 i 7.71 po 12. Jeśli te cztery porównania nie były zaplanowane jako główne, zastosuj korektę, np. Holma.
Krok 3: czas jako kowarianta i losowe nachylenie
Pomiary były co 4 tygodnie, więc czas można potraktować liczbowo. Usuń pomiar z Factors, a tydzien przeciągnij do Covariates. W Random Effects wybierz Intercept | id i tydzien | id. Domyślnie oba efekty są skorelowane (Correlated) (Gallucci, b.d.-a). Tak powstaje losowe nachylenie: każda osoba ma własne tempo zmian. Barr i in. (2013) pokazali w symulacjach, że gdy osoby różnią się reakcją na manipulację, modele z samym losowym wyrazem wolnym gorzej uogólniają wyniki. Zalecają strukturę efektów losowych tak pełną, jak pozwala schemat badania.
Uwaga na Covariates Scaling. Domyślnie GAMLj centruje kowarianty (Centered) (Gallucci, b.d.-a), tu na średnim tygodniu wszystkich wierszy, 5.60. Wyraz wolny 30.36 to więc wynik w tygodniu 5.6, a efekt grupy 3.36 (t(70.93) = 2.65, p = .010) to różnica grup w tym tygodniu, a nie na starcie. Nachylenie tygodnia 0.256 to średnie z obu grup. Najważniejsza jest interakcja grupa ✻ tydzien: 0.617 pkt na tydzień, F(1, 62.66) = 22.18, p < .001. Simple effects dla kowarianty dają nachylenie w każdej grupie: −0.053 w kontrolnej (p = .578) i 0.564 w tutoringu, t(61.45) = 6.21, p < .001.
| Groups | Name | Variance | SD | ICC |
|---|---|---|---|---|
| id | (Intercept) | 25.507 | 5.050 | .708 |
| id | tydzien | 0.134 | 0.366 | |
| Residual | 10.529 | 3.245 |
SD nachyleń 0.37 pkt na tydzień jest duże wobec średniego tempa w tutoringu (0.56). Przy rozkładzie normalnym około 95% osób z tej grupy miałoby tempo od −0.15 do 1.28 pkt na tydzień (0.56 ± 1.96 × 0.37). Linie osób (rysunek 2) pokazuje też opcja Random effects w panelu Plots. Korelację wyrazu wolnego z nachyleniem (.41) GAMLj podaje w osobnej tabeli Random Parameters correlations. ICC liczy tylko dla wyrazu wolnego, więc tu dotyczy tygodnia 5.6 i zmieni się po innym centrowaniu.
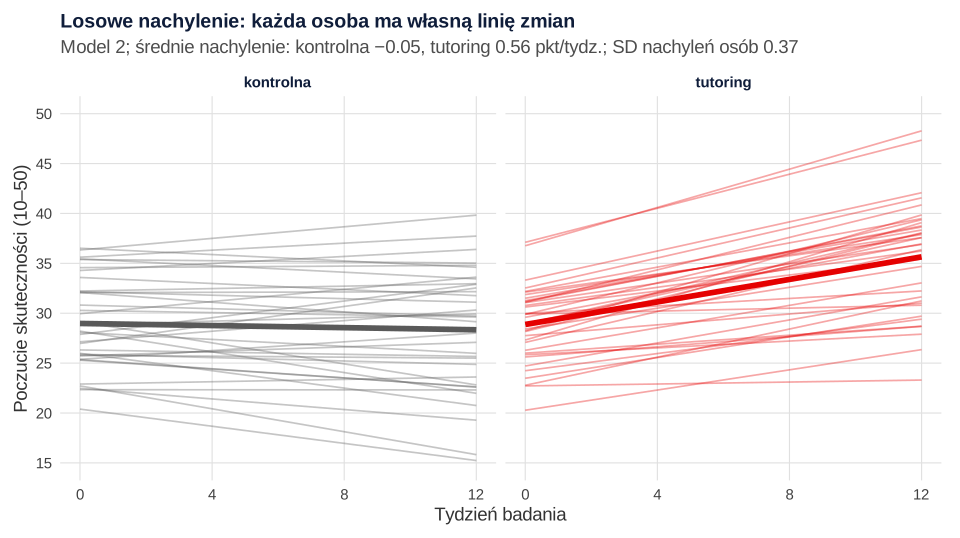
Czy losowe nachylenie jest potrzebne? Zaznacz w Random Effects opcję LRT for Random effects. GAMLj liczy wtedy test funkcją ranova z pakietu lmerTest (Gallucci, b.d.-a) i pokazuje tabelę Random Effect LRT. Usunięcie nachylenia (i jego korelacji z wyrazem wolnym) pogarsza model: LRT = 15.30, df = 2, p < .001, a AIC rośnie z 1574.6 do 1585.9. Strukturę efektów losowych ustal jednak przed analizą – ten test nie służy do szukania modelu, w którym interakcja „wychodzi”.
GAMLj a MIXED w SPSS
Procedurę Analyze → Mixed Models → Linear opisuje wpis model mieszany (MIXED) w SPSS. Porównanie:
- Testy F i średnie brzegowe są te same: domyślnie REML, df Satterthwaite’a i typ III.
- Współczynniki efektów stałych różnią się. SPSS porównuje z ostatnią kategorią i podaje efekt grupy w kategorii odniesienia pomiaru. GAMLj porównuje z pierwszym poziomem i podaje efekty uśrednione.
- ICC GAMLj wypisuje w Random Components. W SPSS bywa, że trzeba go policzyć z Estimates of Covariance Parameters.
- Struktury kowariancji reszt. SPSS ma ich ponad 20. GAMLj w panelu Residuals Structure oferuje Identity, Compound Symmetry, Unstructured, AR(1) i ARMA(1,1); poza Identity model szacuje wtedy pakiet nlme (Gallucci, b.d.-b).
- Kowarianty GAMLj domyślnie centruje.
Zapis wyników w stylu APA
W Metodzie podaj program i moduł z wersją, efekty stałe i losowe, metodę estymacji i df, kodowanie czynników oraz liczbę osób z niepełnymi danymi i założenie o brakach (MAR). Zasady tabeli opisuje wpis jak opisać wyniki modelu mieszanego. Wzór do dostosowania:
Zdania do innych analiz przygotuje generator opisu wyników APA.
Te same liczby w R (lme4, lmerTest, emmeans)
GAMLj nie ma tu odpowiednika pakietu jmv, więc liczby odtwarzamy funkcjami, których moduł używa wewnętrznie: lmerTest::lmer z REML i optymalizatorem bobyqa, anova(type = 3) z df Satterthwaite’a, ranova oraz emmeans (Gallucci, b.d.-b). Kodowanie simple i centrowanie kowarianty ustawiamy ręcznie. Przepis 1 tworzy pliki do pobrania, przepis 2 liczy wszystkie tabele. Uruchom je po kolei w jednym folderze.
1. Dane w formacie długim i pliki CSV oraz .sav
R
# B547 – model mieszany w jamovi (GAMLj): dane do pobrania w formacie długim
# Dane symulowane, set.seed(5474) – ziarno wybrane spośród kilkudziesięciu tak, by przykład
# miał wyraźną interakcję i losowe nachylenie bez ostrzeżeń o zbieżności.
# 72 osoby studiujące losowo przydzielone do tutoringu ze statystyki (n = 36) albo grupy kontrolnej (n = 36).
# Poczucie własnej skuteczności w statystyce (10–50 pkt) zmierzono 4 razy: w tygodniu 0, 4, 8 i 12.
# Część osób zrezygnowała z badania – ich późniejszych pomiarów (wierszy) po prostu nie ma.
suppressPackageStartupMessages(library(haven))
set.seed(5474)
n <- 72
grupa <- rep(c("kontrolna", "tutoring"), each = n / 2)
tyg <- c(0, 4, 8, 12)
u0 <- rnorm(n, 0, 5)                                  # stałe różnice między osobami
u1 <- rnorm(n, 0, 0.25)                               # różne tempo zmian u różnych osób
b <- ifelse(grupa == "tutoring", 0.55, 0.10)          # średni przyrost na tydzień w grupach
d <- data.frame(id = rep(1:n, each = 4), grupa = rep(grupa, each = 4),
                pomiar = rep(1:4, n), tydzien = rep(tyg, n))
d$skutecznosc <- round(28 + u0[d$id] + (b[d$id] + u1[d$id]) * d$tydzien + rnorm(nrow(d), 0, 3.5))
d$skutecznosc <- pmin(50, pmax(10, d$skutecznosc))
# rezygnacja: przed każdym z pomiarów 2–4 osoba odpada na stałe z prawdopodobieństwem .06
odpada <- sapply(1:n, function(i) { k <- which(runif(3) < .06); if (length(k)) k[1] + 1 else 5 })
d <- d[d$pomiar < odpada[d$id], ]
rownames(d) <- NULL

write.csv(d, "model-mieszany-w-jamovi-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
sav <- d
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$grupa <- labelled(ifelse(d$grupa == "kontrolna", 1, 2), labels = c("kontrolna" = 1, "tutoring" = 2),
                      label = "Grupa")
sav$pomiar <- labelled(sav$pomiar, labels = c("tydzień 0" = 1, "tydzień 4" = 2, "tydzień 8" = 3, "tydzień 12" = 4),
                       label = "Pomiar")
sav$tydzien <- labelled(sav$tydzien, label = "Tydzień badania")
sav$skutecznosc <- labelled(sav$skutecznosc, label = "Poczucie własnej skuteczności w statystyce (10–50)")
write_sav(sav, "model-mieszany-w-jamovi-dane.sav")

cat("wierszy:", nrow(d), "; osób:", length(unique(d$id)), "\n")
print(table(pomiary_na_osobe = table(d$id)))
print(head(d, 5), row.names = FALSE)
opis <- aggregate(skutecznosc ~ grupa + pomiar, data = d, FUN = function(x) c(N = length(x), M = mean(x), SD = sd(x)))
print(do.call(data.frame, opis), digits = 4, row.names = FALSE)
Wynik:
wierszy: 262 ; osób: 72
pomiary_na_osobe
 1  2  3  4
 2  7  6 57
 id     grupa pomiar tydzien skutecznosc
  1 kontrolna      1       0          25
  2 kontrolna      1       0          23
  2 kontrolna      2       4          26
  2 kontrolna      3       8          27
  2 kontrolna      4      12          28
     grupa pomiar skutecznosc.N skutecznosc.M skutecznosc.SD
 kontrolna      1            36         28.78          6.160
  tutoring      1            36         28.75          5.400
 kontrolna      2            35         29.00          5.780
  tutoring      2            35         31.66          5.530
 kontrolna      3            30         28.93          7.105
  tutoring      3            33         32.82          6.673
 kontrolna      4            27         28.11          7.218
  tutoring      4            30         36.00          6.534
2. Tabele GAMLj: model pusty, losowy wyraz wolny i losowe nachylenie
R
# B547 – liczby do tabel GAMLj (Linear Mixed Model) policzone w lme4, lmerTest i emmeans
# Ustawienia jak domyślne w GAMLj: REML, df Satterthwaite'a, F typu III, kodowanie czynników "simple"
# (pierwszy poziom = odniesienie, kody wyśrodkowane), kowarianty wyśrodkowane, optymalizator bobyqa.
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(emmeans) })
emm_options(msg.interaction = FALSE, lmer.df = "satterthwaite")
ster <- lmerControl(optimizer = "bobyqa")
d <- read.csv("model-mieszany-w-jamovi-dane.csv")
d$id <- factor(d$id)
d$grupa <- factor(d$grupa, levels = c("kontrolna", "tutoring"))
d$pomiar <- factor(d$pomiar, levels = 1:4)
simple <- function(f) { k <- nlevels(f); contr.treatment(k) - 1 / k }   # kodowanie "simple" z GAMLj
contrasts(d$grupa) <- simple(d$grupa)
contrasts(d$pomiar) <- simple(d$pomiar)
d$tydzien_c <- d$tydzien - mean(d$tydzien)          # Covariates Scaling: Centered
cat(sprintf("średni tydzień (punkt centrowania) = %.3f\n", mean(d$tydzien)))
icc <- function(m) { v <- as.data.frame(VarCorr(m)); v$vcov[1] / (v$vcov[1] + sigma(m)^2) }

# Model 0 – bez efektów stałych, losowy wyraz wolny osoby: Random Components i ICC
m0 <- lmer(skutecznosc ~ 1 + (1 | id), data = d, REML = TRUE, control = ster)
print(as.data.frame(VarCorr(m0))[, c("grp", "vcov", "sdcor")], digits = 5, row.names = FALSE)
cat(sprintf("ICC = %.3f\n", icc(m0)))

# Model 1 – grupa * pomiar, losowy wyraz wolny (Intercept | id)
m1 <- lmer(skutecznosc ~ grupa * pomiar + (1 | id), data = d, REML = TRUE, control = ster)
# Fixed Effects Omnibus Tests: F, df, df (res), p
print(anova(m1, type = 3, ddf = "Satterthwaite"), digits = 5)
# Parameter Estimates (Fixed coefficients); przedział Walda z df = obserwacje - liczba parametrów modelu
wsp <- summary(m1, ddf = "Satterthwaite")$coefficients
df_wald <- nobs(m1) - (length(fixef(m1)) + length(getME(m1, "theta")) + 1)
q <- qt(.975, df_wald)
print(round(cbind(wsp[, 1:2], Lower = wsp[, 1] - q * wsp[, 2], Upper = wsp[, 1] + q * wsp[, 2], wsp[, 3:5]), 3))
# Random Components z ICC
print(as.data.frame(VarCorr(m1))[, c("grp", "vcov", "sdcor")], digits = 5, row.names = FALSE)
cat(sprintf("ICC = %.3f\n", icc(m1)))
# R² marginalne i warunkowe (Nakagawa i Schielzeth): wariancja części stałej, losowej i reszt
v_f <- var(as.vector(model.matrix(m1) %*% fixef(m1)))
v_r <- as.data.frame(VarCorr(m1))$vcov[1]
cat(sprintf("R2 marginalne = %.3f; R2 warunkowe = %.3f\n",
            v_f / (v_f + v_r + sigma(m1)^2), (v_f + v_r) / (v_f + v_r + sigma(m1)^2)))
# Estimated Marginal Means – grupa:pomiar (Mean, SE, df, Lower, Upper)
em <- emmeans(m1, ~ grupa | pomiar)
print(summary(em), digits = 5)
# Simple Effects: grupa w każdym pomiarze (Parameter Estimates i ANOVA for Simple Effects)
print(summary(contrast(em, method = "revpairwise"), infer = TRUE), digits = 5)
print(joint_tests(m1, by = "pomiar"), digits = 5)

# Model 2 – tydzień jako kowarianta (wyśrodkowana), losowy wyraz wolny i nachylenie (Intercept + tydzien | id)
m2 <- lmer(skutecznosc ~ grupa * tydzien_c + (1 + tydzien_c | id), data = d, REML = TRUE, control = ster)
cat("singular:", isSingular(m2), "\n")
print(anova(m2, type = 3, ddf = "Satterthwaite"), digits = 5)
wsp2 <- summary(m2, ddf = "Satterthwaite")$coefficients
print(round(wsp2, 4))
# Random Components (Variance, SD, ICC dla wyrazu wolnego) i korelacja wyrazu wolnego z nachyleniem
print(as.data.frame(VarCorr(m2))[, c("grp", "var1", "var2", "vcov", "sdcor")], digits = 4, row.names = FALSE)
cat(sprintf("ICC (wyraz wolny przy średnim tygodniu) = %.3f\n", icc(m2)))
# Random Effect LRT: czy losowe nachylenie jest potrzebne (lmerTest::ranova)
print(ranova(m2), digits = 5)
# Simple Effects dla kowarianty: nachylenie tygodnia w każdej grupie
print(summary(emtrends(m2, ~ grupa, var = "tydzien_c"), infer = TRUE), digits = 4)
Wynik:
średni tydzień (punkt centrowania) = 5.603
      grp   vcov  sdcor
       id 26.420 5.1400
 Residual 17.671 4.2036
ICC = 0.599
Type III Analysis of Variance Table with Satterthwaite's method
             Sum Sq Mean Sq NumDF   DenDF F value    Pr(>F)
grupa        111.07  111.07     1  71.491  7.9525   0.00621 **
pomiar       316.19  105.40     3 187.946  7.5467 8.557e-05 ***
grupa:pomiar 466.15  155.38     3 187.946 11.1256 9.350e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
               Estimate Std. Error  Lower  Upper      df t value Pr(>|t|)
(Intercept)      30.444      0.632 29.200 31.688  71.491  48.198    0.000
grupa2            3.562      1.263  1.075  6.050  71.491   2.820    0.006
pomiar2           1.496      0.630  0.255  2.737 186.981   2.375    0.019
pomiar3           2.114      0.655  0.825  3.403 188.817   3.230    0.001
pomiar4           3.111      0.677  1.777  4.444 189.580   4.593    0.000
grupa2:pomiar2    2.685      1.260  0.204  5.167 186.981   2.131    0.034
grupa2:pomiar3    3.936      1.309  1.358  6.514 188.817   3.006    0.003
grupa2:pomiar4    7.740      1.354  5.072 10.407 189.580   5.714    0.000
      grp   vcov  sdcor
       id 24.518 4.9516
 Residual 13.966 3.7371
ICC = 0.637
R2 marginalne = 0.136; R2 warunkowe = 0.687
pomiar = 1:
 grupa     emmean     SE     df lower.CL upper.CL
 kontrolna 28.778 1.0339 122.93   26.731   30.824
 tutoring  28.750 1.0339 122.93   26.703   30.797

pomiar = 2:
 grupa     emmean     SE     df lower.CL upper.CL
 kontrolna 28.931 1.0427 125.58   26.868   30.995
 tutoring  31.589 1.0427 125.58   29.525   33.652

pomiar = 3:
 grupa     emmean     SE     df lower.CL upper.CL
 kontrolna 28.924 1.0861 140.74   26.777   31.071
 tutoring  32.832 1.0587 131.19   30.738   34.926

pomiar = 4:
 grupa     emmean     SE     df lower.CL upper.CL
 kontrolna 28.019 1.1161 151.60   25.813   30.224
 tutoring  35.730 1.0839 140.46   33.587   37.873

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
pomiar = 1:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 tutoring - kontrolna -0.027778 1.4622 122.93 -2.92212   2.8666  -0.019  0.9849

pomiar = 2:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 tutoring - kontrolna  2.657648 1.4746 125.58 -0.26055   5.5758   1.802  0.0739

pomiar = 3:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 tutoring - kontrolna  3.908266 1.5167 136.01  0.90896   6.9076   2.577  0.0110

pomiar = 4:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 tutoring - kontrolna  7.711774 1.5559 146.10  4.63689  10.7867   4.957 <0.0001

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
pomiar = 1:
 model term df1    df2 F.ratio p.value
 grupa        1 122.93   0.000  0.9849

pomiar = 2:
 model term df1    df2 F.ratio p.value
 grupa        1 125.58   3.248  0.0739

pomiar = 3:
 model term df1    df2 F.ratio p.value
 grupa        1 136.01   6.640  0.0110

pomiar = 4:
 model term df1    df2 F.ratio p.value
 grupa        1 146.10  24.568 <0.0001

singular: FALSE
Type III Analysis of Variance Table with Satterthwaite's method
                 Sum Sq Mean Sq NumDF  DenDF F value    Pr(>F)
grupa            73.809  73.809     1 70.925  7.0101 0.0099807 **
tydzien_c       160.402 160.402     1 62.663 15.2344 0.0002347 ***
grupa:tydzien_c 233.492 233.492     1 62.663 22.1763 1.422e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                 Estimate Std. Error      df t value Pr(>|t|)
(Intercept)       30.3601     0.6345 70.9253 47.8500    0e+00
grupa2             3.3598     1.2690 70.9253  2.6477    1e-02
tydzien_c          0.2558     0.0655 62.6627  3.9031    2e-04
grupa2:tydzien_c   0.6173     0.1311 62.6627  4.7092    0e+00
      grp        var1      var2    vcov  sdcor
       id (Intercept)      <NA> 25.5067 5.0504
       id   tydzien_c      <NA>  0.1340 0.3661
       id (Intercept) tydzien_c  0.7645 0.4135
 Residual        <NA>      <NA> 10.5289 3.2448
ICC (wyraz wolny przy średnim tygodniu) = 0.708
ANOVA-like table for random-effects: Single term deletions

Model:
skutecznosc ~ grupa * tydzien_c + (1 + tydzien_c | id)
                                  npar  logLik    AIC    LRT Df Pr(>Chisq)
<none>                               8 -779.32 1574.6
tydzien_c in (1 + tydzien_c | id)    6 -786.97 1585.9 15.298  2  0.0004765 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 grupa     tydzien_c.trend      SE    df lower.CL upper.CL t.ratio p.value
 kontrolna        -0.05283 0.09449 63.81  -0.2416   0.1359  -0.559  0.5780
 tutoring          0.56449 0.09086 61.45   0.3828   0.7461   6.213 <0.0001

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i svglite (kodu rysunków nie pokazujemy). Moduł GAMLj i jamovi nie były uruchamiane. W pracy podaj wersję jamovi i GAMLj albo R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Dane w formacie szerokim. GAMLj potrzebuje wiersza na pomiar. Okno Repeated Measures ANOVA – odwrotnie.
idw Factors zamiast w Cluster variables. Osoba stałaby się efektem stałym, a model nie miałby efektu losowego.- Puste Random Effects. Bez co najmniej Intercept | id to nie jest model mieszany.
- Efekt grupy czytany jak w SPSS. Przy kodowaniu simple to efekt uśredniony, a przy wyśrodkowanej kowariancie – różnica przy jej średniej.
- Struktura efektów losowych dobrana po wyniku testu interakcji. Ustal ją przed analizą i opisz w pracy.
Osoby w zespołach albo klasach liczy się tak samo – teorię opisuje wpis model wielopoziomowy krok po kroku w R. Interakcje z predyktorem ilościowym omawia wpis moderacja w jamovi, a analizę dobierzesz w kreatorze doboru testu.
Najczęstsze pytania
Gdzie w jamovi jest model mieszany?
Podstawowe jamovi go nie ma. W bibliotece modułów (Modules → jamovi library) zainstaluj moduł General Analyses for Linear Models (v3), czyli GAMLj. Analiza pojawi się jako Linear Models → GAMLj3 → Linear Mixed Model (Gallucci, b.d.-b). Moduł jest dostępny od razu, bez ponownego uruchamiania programu (The jamovi project, b.d.).
Dlaczego współczynniki z GAMLj różnią się od tych z SPSS?
Testy F są takie same, ale czynniki są inaczej kodowane. GAMLj domyślnie stosuje kodowanie simple: porównuje każdy poziom z pierwszym, a kody są wyśrodkowane (Gallucci, b.d.-a). Efekt grupy to więc różnica uśredniona po pomiarach. SPSS porównuje z ostatnią kategorią i podaje różnicę w kategorii odniesienia drugiego czynnika.
Jak policzyć ICC w GAMLj?
Uruchom model z samą osobą w Cluster variables, losowym wyrazem wolnym i bez efektów stałych. Tabela Random Components ma kolumnę ICC, liczoną jako wariancja wyrazu wolnego podzielona przez sumę tej wariancji i wariancji reszt (Gallucci, b.d.-b). W przykładzie ICC = .60. Przy losowym nachyleniu ICC zależy od punktu centrowania czasu.
Satterthwaite czy Kenward–Roger w GAMLj?
Domyślny Satterthwaite wystarcza w większości prac. W symulacjach Luke’a (2017) REML z którymkolwiek z tych przybliżeń dawał odsetek błędów I rodzaju bliski .05 także w małych próbach. Kenward–Roger w GAMLj jest opisany jako wolny (Gallucci, b.d.-b). Metodę wybierz przed analizą i podaj ją w Metodzie.
Czy GAMLj usuwa osoby z brakującym pomiarem?
Nie usuwa całej osoby. W formacie długim brakujący pomiar to brak wiersza, a pozostałe pomiary tej osoby zostają w modelu. W przykładzie analizowano 262 pomiary 72 osób, także 15 osób bez kompletu. To założenie MAR – opisz je w pracy.
Powiązane hasła
Przeczytaj też
Model mieszany (MIXED) w SPSS krok po kroku
Linear Mixed Models od pliku w formacie długim po opis APA: Subjects i Repeated, losowy wyraz wolny, ICC, struktury AR(1), CS i UN, średnie brzegowe i składnia MIXED – na przykładzie dwóch grup i trzech pomiarów z brakami.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami w jamovi
Okno Repeated Measures ANOVA na schemacie grupa × czas: czynnik i poziomy, format szeroki, sferyczność z poprawką, η²G, post hoc z korektą i średnie brzegowe – z kodem jmv.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikJak opisać wyniki modelu mieszanego
Co przepisać z wydruku lmer do pracy: struktura modelu, REML, df Satterthwaite’a, efekty stałe z CI, wariancje losowe, ICC i R² Nakagawy – z tabelą APA i wzorami zdań.
Czytaj →Masz model mieszany w jamovi i nie wiesz, co przepisać do pracy?
Sprawdzimy Twój plik .omv, format danych, efekty stałe i losowe, ostrzeżenia, średnie brzegowe i simple effects i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Gallucci, M. (b.d.-a). GAMLj: Mixed models (GAMLj Mixed models, Mixed Models module technical details, Mixed Models: Repeated measures designs). GAMLj documentation. https://gamlj.github.io/mixed.html ● Otwarty dostęp
- Gallucci, M. (b.d.-b). GAMLj3: General analyses for linear models (v3) – kod źródłowy modułu jamovi (wersja 3.7.2). GitHub. https://github.com/gamlj/gamlj ● Otwarty dostęp
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13 ● Otwarty dostęp
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
- Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining R² from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
- The jamovi project. (b.d.). Library modules. https://www.jamovi.org/modules.html ● Otwarty dostęp
Cytowania BibTeX
@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@misc{galluccindgamljmixed, author={Gallucci, Marcello}, title={{GAMLj: Mixed models (GAMLj Mixed models, Mixed Models module technical details, Mixed Models: Repeated measures designs)}}, howpublished={GAMLj documentation}, year={b.d.-a}, url={https://gamlj.github.io/mixed.html}}@misc{galluccindgamljrepo, author={Gallucci, Marcello}, title={{GAMLj3: General analyses for linear models (v3) – kod źródłowy modułu jamovi (wersja 3.7.2)}}, howpublished={GitHub}, year={b.d.-b}, url={https://github.com/gamlj/gamlj}}@article{kuznetsova2017lmertest, author={Kuznetsova, Alexandra and Brockhoff, Per B. and Christensen, Rune H. B.}, title={{lmerTest package: Tests in linear mixed effects models}}, journal={Journal of Statistical Software}, year={2017}, volume={82}, number={13}, pages={1--26}, doi={10.18637/jss.v082.i13}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}@article{nakagawa2013general, author={Nakagawa, Shinichi and Schielzeth, Holger}, title={{A general and simple method for obtaining R² from generalized linear mixed-effects models}}, journal={Methods in Ecology and Evolution}, year={2013}, volume={4}, number={2}, pages={133--142}, doi={10.1111/j.2041-210x.2012.00261.x}}@misc{jamovindmodules, author={{The jamovi project}}, title={{Library modules}}, howpublished={jamovi}, year={b.d.}, url={https://www.jamovi.org/modules.html}}