6 - $source, wynik skali w Compute, filtr w Filters i kontrola w Analyses → Exploration → Descriptives. Wynik skali licz formułą MEAN(…, min_valid=5), a nie samym MEAN(…): bez argumentów jeden brak odbiera osobie wynik, a ignore_missing=1 liczy go nawet z jednej odpowiedzi. Rok studiów i pozycje Likerta ustaw jako Ordinal, bo tabele częstości działają tylko dla zmiennych nominalnych i porządkowych.Po co przygotowywać dane w jamovi przed analizą
jamovi liczy wszystko, co dostanie. Rok studiów jako zmienna ciągła nie da tabeli częstości, a nieodwrócona pozycja zepsuje wynik skali. Formuła MEAN bez dodatkowych argumentów po cichu odbierze wynik każdemu, kto pominął choć jedno pytanie. Ten wpis prowadzi przez przygotowanie zbioru i statystyki opisowe na jednym przykładzie: import, typy zmiennych i poziomy, Transform i Compute, filtry, Descriptives i tabele częstości.
Nie powtarzamy tu podstaw programu. Instalację, układ okna i pierwszy test opisuje poradnik jamovi krok po kroku, a sam program – hasło jamovi. Te same czynności w SPSS pokazuje wpis przygotowanie danych w SPSS. To pierwszy wpis serii o jamovi. Kolejne kroki to test t w jamovi i alfa Cronbacha i omega w jamovi.
Nazwy menu i opcji podajemy po angielsku, według dokumentacji jamovi i pakietu jmv. Polskie nazwy podajemy tylko dla okna Descriptives, sprawdzone w pliku tłumaczeń jmv. Pozostałe etykiety w polskiej wersji językowej mogą się różnić.
Plik przykładowy: ankieta 160 osób studiujących
Liczby we wpisie pochodzą z symulowanej ankiety online 160 osób studiujących ze skalą stresu przed sesją (6 pozycji, odpowiedzi 1–5). Pozycje s3 („spokój w czasie sesji”) i s6 („panowanie nad nauką”) są sformułowane odwrotnie. Do tego dochodzą płeć, wiek, rok i tryb studiów, liczba godzin snu oraz pytanie kontrolne. Pytanie kontrolne brzmi „zaznacz raczej się zgadzam”, więc poprawna odpowiedź to 4. Pominięte pytania to puste komórki.
Pobierz plik CSV (płeć i tryb zapisane słowami) albo plik .sav (kody liczbowe z etykietami wartości).
Krok 1. Otwórz plik i sprawdź, co jamovi rozpoznał
Plik otworzysz z menu ☰ → Open → This PC. jamovi czyta m.in. CSV, pliki Excela, SPSS, Stata i SAS (The jamovi project, b.d.-a). Typ każdej kolumny program zgaduje z danych i może się pomylić (The jamovi project, b.d.-b). Po imporcie przejrzyj więc ikonki typu pomiaru przy nazwach kolumn.
Najczęstsze problemy po imporcie:
- Odpowiedzi zapisane słowami. Eksport z Google Forms ma w komórkach teksty typu „raczej się zgadzam”. Taka kolumna nie nadaje się do
MEAN. Zamień odpowiedzi na liczby jeszcze przed importem, jak w poradniku dane z Google Forms i LimeSurvey. - Kod braku zapisany liczbą. Brak zapisany jako 99 albo −99 zdefiniuj w edytorze zmiennej, inaczej trafi do średniej.
- Polskie znaki. CSV zapisuj w kodowaniu UTF-8.
Krok 2. Typy zmiennych, poziomy i braki
Edytor zmiennej otworzysz przyciskiem Setup w zakładce Data, podwójnym kliknięciem nagłówka kolumny albo klawiszem F3 (The jamovi project, b.d.-b). Każda zmienna ma dwa ustawienia. Measure type to poziom pomiaru: Continuous, Ordinal, Nominal albo ID. Data type to zapis: Integer, Decimal albo Text. Continuous odpowiada Scale z SPSS, a ID służy do numerów osób, których się nie analizuje (The jamovi project, b.d.-b, b.d.-c).
| Zmienna | Measure type | Data type | Co ustawić |
|---|---|---|---|
| id | ID | Integer | nic więcej |
| plec, tryb | Nominal | Text | kolejność poziomów (np. stacjonarne przed niestacjonarnymi) |
| rok | Ordinal | Integer | etykiety poziomów: 1 = „I rok” … 5 = „V rok” |
| s1–s6, kontrola | Ordinal | Integer | etykiety 1–5 według kafeterii |
| wiek, sen | Continuous | Integer / Decimal | kontrola minimum i maksimum |
| stres (obliczana) | Continuous | Decimal | opis zmiennej: reguła braków |
Typ pomiaru decyduje, co pokaże Descriptives. Frequency tables działa tylko dla zmiennych nominalnych i porządkowych. Histogram, wykres pudełkowy i wykres Q-Q są tylko dla zmiennych ciągłych (The jamovi project, b.d.-e). Rok studiów zapisany jako Continuous da więc „średni rok studiów” zamiast tabeli liczebności. Pojedyncza pozycja Likerta to zwykle skala porządkowa, a wynik całej skali traktujemy jako ciągły.
W tym samym oknie ustaw też (The jamovi project, b.d.-c):
- Etykiety i kolejność poziomów. Kliknij poziom i wpisz etykietę, kolejność zmień strzałkami. Pierwszy poziom pojawia się pierwszy w tabelach i na wykresach.
- Kody braków. W części Missing values kliknij Add Missing Value i wpisz warunek, np.
== 99. Puste komórki są brakami same z siebie, a jamovi oznacza je jako NA (The jamovi project, b.d.-b). - Poziom bez odpowiedzi. Poziom, którego nikt nie wybrał, zniknie z tabel. Dodaj go przyciskiem + i włącz Retain unused levels in analyses.
Krok 3. Transform: pozycje odwrócone
W jamovi są dwa rodzaje nowych kolumn. Zmienna przekształcona (Transform) to jedna reguła zastosowana do wielu kolumn naraz. Każda nowa kolumna jest powiązana ze swoją zmienną źródłową, więc oryginał zostaje nietknięty. Zmienna obliczana (Compute) to jedna formuła na jedną kolumnę, np. wynik skali (The jamovi project, b.d.-b). Do pozycji odwróconych wybierz Transform:
- Zaznacz nagłówki
s3is6(Ctrl albo ⌘ i kliknięcie). - W zakładce Data kliknij Transform. jamovi utworzy dwie nowe kolumny z ustawioną zmienną źródłową.
- W polu przekształcenia wybierz Create New Transform… i wpisz formułę
6 - $source, czyli (max + min) − odpowiedź.$sourceoznacza odpowiedź w kolumnie źródłowej. - W polu Variable suffix ustal końcówkę nazwy, którą jamovi dopisze do nazwy zmiennej źródłowej po myślniku (The jamovi project, b.d.-b). W tekście nazywamy nowe kolumny
s3_ris6_r.
Przycisk Add recode condition dodaje warunki „jeśli … to …”, sprawdzane po kolei (obowiązuje pierwszy spełniony). Przyda się do łączenia kategorii (The jamovi project, b.d.-b). Sprawdź wynik tabelą krzyżową starej i nowej zmiennej (w jamovi: Frequencies → Independent Samples, opisane we wpisie o chi-kwadrat w jamovi):
| s3 \ s3_r | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 1 | 0 | 0 | 0 | 0 | 20 |
| 2 | 0 | 0 | 0 | 31 | 0 |
| 3 | 0 | 0 | 53 | 0 | 0 |
| 4 | 0 | 28 | 0 | 0 | 0 |
| 5 | 23 | 0 | 0 | 0 | 0 |
Liczebności z kodu R pokazanego niżej. Dane symulowane.
Wszystkie liczby leżą na przekątnej od prawego górnego do lewego dolnego rogu, czyli odwrócenie jest poprawne.
Krok 4. Compute: wynik skali i braki danych
Wynik skali to zmienna obliczana. W zakładce Data kliknij Compute albo Add i wybierz zmienną obliczaną. Potem nadaj nazwę stres i wpisz formułę. Przycisk fx pokazuje listę funkcji. MEAN i SUM liczą w wierszu, czyli dla jednej osoby. VMEAN i VSUM liczą dla całej kolumny (The jamovi project, b.d.-b). Pomyłka między nimi daje każdej osobie ten sam wynik.
Najważniejsza decyzja dotyczy braków. Dokumentacja jamovi tego nie opisuje, ale lista funkcji w edytorze formuł podaje pełną postać: MEAN( number 1, number 2, …, ignore_missing=0, min_valid=0 ). Kod źródłowy programu pokazuje, co robią te argumenty (The jamovi project, b.d.-d):
MEAN(s1, s2, s3_r, s4, s5, s6_r)– jeden brak daje brak wyniku;MEAN(s1, s2, s3_r, s4, s5, s6_r, ignore_missing=1)– średnia dostępnych odpowiedzi, nawet jeśli jest tylko jedna;MEAN(s1, s2, s3_r, s4, s5, s6_r, min_valid=5)– średnia dostępnych odpowiedzi, ale tylko u osób z co najmniej pięcioma.
Tak samo działa SUM. W pliku przykładowym komplet odpowiedzi ma 137 osób, jednej brakuje 20 osobom, a dwóch – trzem. Tak wyglądają trzy wersje wyniku:
| stres_domyslny | stres_wszystkie | stres | |
|---|---|---|---|
| N | 137 | 160 | 157 |
| Missing | 23 | 0 | 3 |
| Mean | 3.14 | 3.12 | 3.14 |
| Standard deviation | 0.87 | 0.89 | 0.90 |
| Minimum | 1.17 | 1.17 | 1.17 |
| Maximum | 5.00 | 5.00 | 5.00 |
Tabela Descriptives. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi. Wartości zaokrąglono do dwóch miejsc. Zmienne obliczane odtworzono w R regułą z kodu jamovi. Dane symulowane.
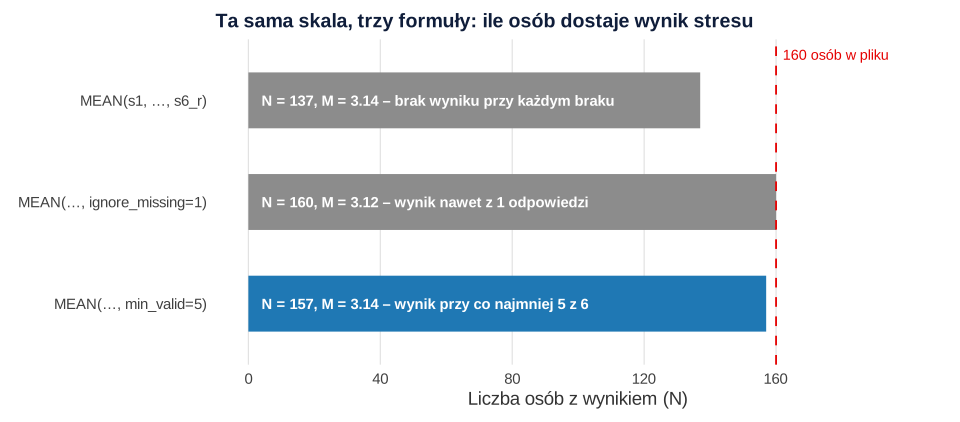
MEAN. Niebieski słupek to wersja zalecana w tym przykładzie. Obliczenia: R (dane symulowane).Średnie prawie się nie różnią, ale N już tak. Formuła domyślna wyrzuca z analiz 23 osoby (14%) z powodu jednego pominiętego pytania. ignore_missing=1 liczy wynik nawet z jednej odpowiedzi. Rozsądny kompromis to min_valid=5, odpowiednik MEAN.5 z SPSS. Jeśli podręcznik narzędzia podaje sumę, pomnóż średnią przez liczbę pozycji: MEAN(…, min_valid=5) * 6. Dlaczego, wyjaśnia hasło wynik skali: średnia czy suma, a klucz i podskale – poradnik jak policzyć wynik kwestionariusza.
Uśrednianie dostępnych pozycji to wygodna reguła, a nie metoda bez założeń. Mazza i in. (2015) pokazali w symulacjach, że może dawać obciążenie nawet przy brakach całkowicie losowych. Ustal próg przed analizą i opisz go w pracy. Przy większej liczbie braków sprawdź, czy są losowe (hasło braki danych MCAR, MAR, MNAR). Nie zastępuj braków średnią kolumny, choć dokumentacja jamovi pokazuje taki przykład. To zaniża rozrzut i korelacje.
Po każdym Compute sprawdź typ nowej zmiennej (Continuous) oraz N, minimum i maksimum. Maksimum powyżej 5 na skali 1–5 oznacza niezdefiniowany kod braku.
Krok 5. Filters: kto wchodzi do analizy
Osoby, które źle odpowiedziały na pytanie kontrolne, wyłącz filtrem, a nie usuwaniem wierszy. W zakładce Data kliknij Filters i wpisz formułę kontrola == 4. Filtr wyklucza wiersze, dla których formuła nie jest prawdziwa. Wykluczone wiersze robią się szare, a analizy przeliczają się same. Kilka filtrów działa kaskadowo: każdy następny dostaje tylko wiersze przepuszczone przez poprzedni (The jamovi project, b.d.-b).
W przykładzie 151 osób odpowiedziało 4, a 9 – inaczej. Dane zostają w pliku. Regułę wykluczenia zapisz przed analizą i podaj w pracy liczbę wykluczonych osób. Dalsze tabele dotyczą 151 osób.
Krok 6. Exploration → Descriptives
Wybierz Analyses → Exploration → Descriptives. Zmienne stres i sen przeciągnij do pola Variables, a tryb do Split by (The jamovi project, b.d.-a). W polskiej wersji tłumaczenie jmv podaje „Eksploracja” → „Statystyki opisowe” i pole „Podziel według” (The jamovi project, b.d.-e). Domyślny układ to Variables across columns; przy wielu zmiennych wygodniejsze bywa Variables across rows.
W panelu Statistics zostaw N i Missing, a dołóż Median, IQR, Confidence interval for Mean, Skewness, Kurtosis i Shapiro-Wilk (The jamovi project, b.d.-e).
| tryb | stres | sen | |
|---|---|---|---|
| N | stacjonarne | 97 | 99 |
| niestacjonarne | 51 | 52 | |
| Missing | stacjonarne | 2 | 0 |
| niestacjonarne | 1 | 0 | |
| Mean | stacjonarne | 3.11 | 6.97 |
| niestacjonarne | 3.20 | 6.84 | |
| 95% CI mean | stacjonarne | [2.92, 3.29] | [6.80, 7.15] |
| niestacjonarne | [2.95, 3.44] | [6.57, 7.10] | |
| Median | stacjonarne | 3.17 | 6.90 |
| niestacjonarne | 3.17 | 6.70 | |
| Standard deviation | stacjonarne | 0.92 | 0.88 |
| niestacjonarne | 0.87 | 0.96 | |
| IQR | stacjonarne | 1.50 | 1.30 |
| niestacjonarne | 1.50 | 1.20 | |
| Minimum | stacjonarne | 1.17 | 4.20 |
| niestacjonarne | 1.67 | 5.00 | |
| Maximum | stacjonarne | 5.00 | 9.40 |
| niestacjonarne | 4.67 | 9.20 | |
| Skewness (SE) | stacjonarne | −0.03 (0.24) | −0.14 (0.24) |
| niestacjonarne | 0.04 (0.33) | 0.46 (0.33) | |
| Kurtosis (SE) | stacjonarne | −0.77 (0.49) | 0.36 (0.48) |
| niestacjonarne | −1.27 (0.66) | −0.12 (0.65) | |
| Shapiro-Wilk W | stacjonarne | 0.98 | 0.99 |
| niestacjonarne | 0.94 | 0.98 | |
| Shapiro-Wilk p | stacjonarne | .212 | .484 |
| niestacjonarne | .017 | .349 |
Tabela Descriptives (filtr kontrola == 4, N = 151). Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi. Wartości zaokrąglono, a przedział ufności i błędy standardowe połączono w jednej komórce. Dane symulowane.
Jak czytać tę tabelę:
- N i Missing liczą się osobno dla każdej zmiennej i grupy. Te liczby podaj w pracy.
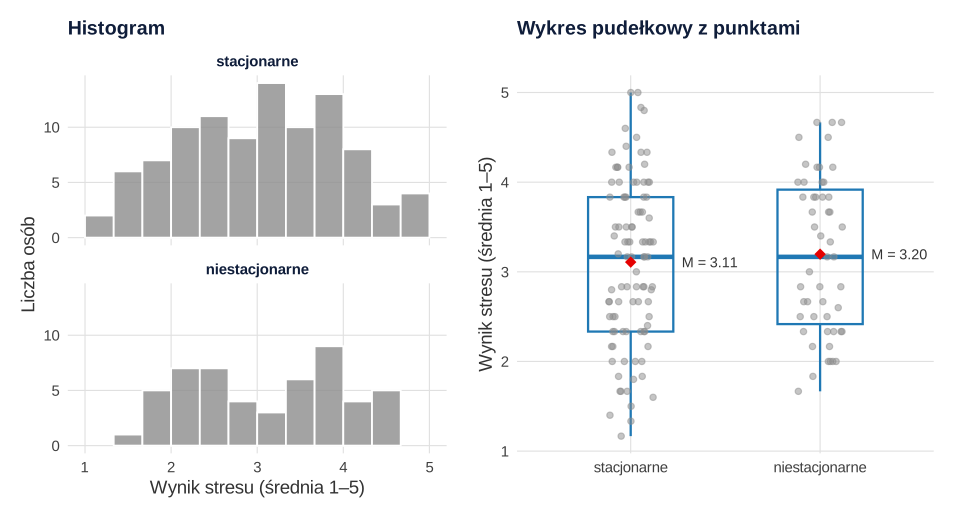
- Mean i Median prawie się pokrywają, a skośność jest bliska zera, więc rozkład jest symetryczny. Średnią podawaj z SD, a medianę z IQR.
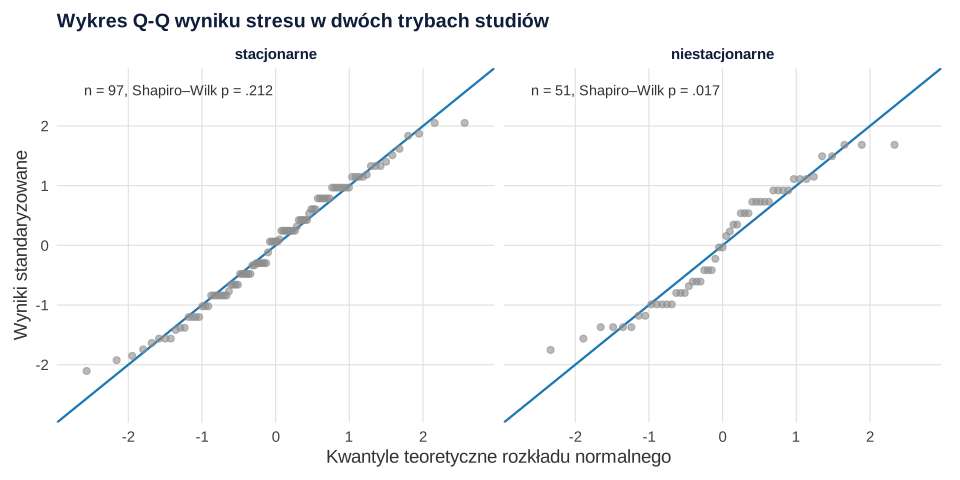
- Shapiro-Wilk wyszedł istotny w grupie niestacjonarnej, p = .017, choć skośność wynosi 0.04. Powodem jest ujemna kurtoza (−1.27), czyli rozkład bardziej płaski od normalnego. Patrz najpierw na wykres. Ocena wykresu ma sens raczej powyżej 50 osób, a testy formalne bywają zawodne w dużych próbach (Kim, 2012). Więcej w haśle test Shapiro–Wilka i poradniku jak sprawdzić normalność rozkładu.
W panelu Plots zaznacz Histogram, Box plot z Data i Q-Q. Podobne wykresy dają te opcje w jamovi; nasze narysowaliśmy w R.
Krok 7. Tabele częstości
Dla zmiennych kategorialnych zaznacz Frequency tables (po polsku „Tabele częstości”) pod polem zmiennych. Średnia i SD nie mają tu sensu, więc w panelu Statistics zostaw tylko N i Missing. Tak wygląda tabela dla roku studiów:
| rok | Counts | % of Total | Cumulative % |
|---|---|---|---|
| I rok | 49 | 32.5% | 32.5% |
| II rok | 36 | 23.8% | 56.3% |
| III rok | 20 | 13.2% | 69.5% |
| IV rok | 31 | 20.5% | 90.1% |
| V rok | 15 | 9.9% | 100.0% |
Tabela Frequencies of rok (N = 151). Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi. Odsetki zaokrąglono do jednego miejsca. Dane symulowane.
Etykiety i kolejność wierszy pochodzą z edytora zmiennej. Cumulative % ma sens tylko dla zmiennej porządkowej: 56.3% osób jest na I albo II roku. W tej samej analizie wśród 151 osób było 97 kobiet (64.2%), 51 mężczyzn (33.8%) i 3 osoby, które wybrały „inna lub wolę nie podawać” (2.0%). Stacjonarnie studiowało 99 osób (65.6%). Z tych liczb zbudujesz tabelę 1 z charakterystyką próby. Ile miejsc po przecinku podać i co wpisać do tabeli opisowej, wyjaśnia wpis statystyki opisowe w pracy.
To samo w R (pakiet jmv)
Wszystkie wbudowane analizy jamovi są dostępne w R jako pakiet jmv, a tryb składni w jamovi (menu ⋮ → Syntax mode) pokazuje kod R analizy (The jamovi project, b.d.-a). Dlatego tabele Descriptives poniżej są takie same jak w programie. Samego jamovi tu nie uruchamialiśmy. Zmienne przekształcone i obliczane nie należą do jmv, bo liczy je arkusz jamovi. Odtworzyliśmy je w R regułą z kodu źródłowego programu (The jamovi project, b.d.-d).
Typy zmiennych, Transform, Compute, filtr i Descriptives funkcjami jmv
R
# B405 – przygotowanie danych i statystyki opisowe tak jak w jamovi (analizy: pakiet jmv)
library(jmv)
dane <- read.csv("przygotowanie-danych-jamovi-ankieta.csv", fileEncoding = "UTF-8")
nrow(dane)

# Krok 1. Typy zmiennych (Setup): płeć i tryb – Nominal, rok studiów – Ordinal z etykietami poziomów
dane$plec <- factor(dane$plec, levels = c("kobieta", "mężczyzna", "inna lub wolę nie podawać"))
dane$tryb <- factor(dane$tryb, levels = c("stacjonarne", "niestacjonarne"))
dane$rok  <- factor(dane$rok, levels = 1:5, labels = c("I rok", "II rok", "III rok", "IV rok", "V rok"),
                    ordered = TRUE)

# Krok 2. Transform: pozycje odwrócone s3 i s6, przekształcenie 6 - $source
dane$s3_r <- 6 - dane$s3
dane$s6_r <- 6 - dane$s6
table(s3 = dane$s3, s3_r = dane$s3_r)                    # kontrola przekodowania

# Krok 3. Compute: wynik skali stresu. Funkcja MEAN w jamovi ma argumenty ignore_missing i min_valid;
# poniżej ta sama reguła co w kodzie jamovi (bez argumentów każdy brak daje brak wyniku).
MEAN <- function(X, ignore_missing = 0, min_valid = 0) apply(X, 1, function(v) {
  if (min_valid > 0 || ignore_missing != 0) v <- v[!is.na(v)]
  if (length(v) < min_valid) NA else mean(v)
})
poz <- dane[c("s1", "s2", "s3_r", "s4", "s5", "s6_r")]
table(liczba_odpowiedzi = rowSums(!is.na(poz)))
dane$stres_domyslny <- MEAN(poz)                         # MEAN(s1, s2, s3_r, s4, s5, s6_r)
dane$stres_wszystkie <- MEAN(poz, ignore_missing = 1)    # MEAN(..., ignore_missing=1)
dane$stres <- MEAN(poz, min_valid = 5)                   # MEAN(..., min_valid=5)
descriptives(dane, vars = c("stres_domyslny", "stres_wszystkie", "stres"),
             median = FALSE, min = TRUE, max = TRUE)

# Krok 4. Filters: kontrola == 4 (osoby, które poprawnie odpowiedziały na pytanie kontrolne)
table(kontrola = dane$kontrola)
anal <- subset(dane, kontrola == 4)
nrow(anal)

# Krok 5. Exploration → Descriptives: Frequency tables dla zmiennych kategorialnych
descriptives(anal, vars = c("plec", "tryb", "rok"), freq = TRUE, mean = FALSE, median = FALSE, sd = FALSE,
             min = FALSE, max = FALSE)

# Krok 6. Exploration → Descriptives: stres i sen, Split by: tryb
descriptives(anal, vars = c("stres", "sen"), splitBy = "tryb", ci = TRUE, iqr = TRUE,
             skew = TRUE, kurt = TRUE, sw = TRUE)
Wynik w R
[1] 160
   s3_r
s3   1  2  3  4  5
  1  0  0  0  0 20
  2  0  0  0 31  0
  3  0  0 53  0  0
  4  0 28  0  0  0
  5 23  0  0  0  0
liczba_odpowiedzi
  4   5   6
  3  20 137

 DESCRIPTIVES

 Descriptives
 ────────────────────────────────────────────────────────────────────────
                         stres_domyslny    stres_wszystkie    stres
 ────────────────────────────────────────────────────────────────────────
   N                                137                160          157
   Missing                           23                  0            3
   Mean                        3.138686           3.124375     3.136306
   Standard deviation         0.8671024          0.8916412    0.8954728
   Minimum                     1.166667           1.166667     1.166667
   Maximum                     5.000000           5.000000     5.000000
 ────────────────────────────────────────────────────────────────────────

kontrola
  1   2   3   4   5
  3   1   2 151   3
[1] 151

 DESCRIPTIVES

 Descriptives
 ──────────────────────────────────
              plec    tryb    rok
 ──────────────────────────────────
   N           151     151    151
   Missing       0       0      0
 ──────────────────────────────────


 FREQUENCIES

 Frequencies of plec
 ─────────────────────────────────────────────────────────────────────
   plec                         Counts    % of Total    Cumulative %
 ─────────────────────────────────────────────────────────────────────
   kobieta                          97      64.23841        64.23841
   mężczyzna                        51      33.77483        98.01325
   inna lub wolę nie podawać         3       1.98675       100.00000
 ─────────────────────────────────────────────────────────────────────


 Frequencies of tryb
 ──────────────────────────────────────────────────────────
   tryb              Counts    % of Total    Cumulative %
 ──────────────────────────────────────────────────────────
   stacjonarne           99      65.56291        65.56291
   niestacjonarne        52      34.43709       100.00000
 ──────────────────────────────────────────────────────────


 Frequencies of rok
 ───────────────────────────────────────────────────
   rok        Counts    % of Total    Cumulative %
 ───────────────────────────────────────────────────
   I rok          49      32.45033        32.45033
   II rok         36      23.84106        56.29139
   III rok        20      13.24503        69.53642
   IV rok         31      20.52980        90.06623
   V rok          15       9.93377       100.00000
 ───────────────────────────────────────────────────


 DESCRIPTIVES

 Descriptives
 ──────────────────────────────────────────────────────────────────────────
                              tryb              stres          sen
 ──────────────────────────────────────────────────────────────────────────
   N                          stacjonarne                97            99
                              niestacjonarne             51            52
   Missing                    stacjonarne                 2             0
                              niestacjonarne              1             0
   Mean                       stacjonarne          3.108247      6.971717
                              niestacjonarne       3.196732      6.836538
   95% CI mean lower bound    stacjonarne          2.922362      6.795870
                              niestacjonarne       2.951244      6.570644
   95% CI mean upper bound    stacjonarne          3.294133      7.147565
                              niestacjonarne       3.442220      7.102433
   Median                     stacjonarne          3.166667      6.900000
                              niestacjonarne       3.166667      6.700000
   Standard deviation         stacjonarne         0.9223063     0.8816775
                              niestacjonarne      0.8728308     0.9550750
   IQR                        stacjonarne          1.500000      1.300000
                              niestacjonarne       1.500000      1.200000
   Minimum                    stacjonarne          1.166667      4.200000
                              niestacjonarne       1.666667      5.000000
   Maximum                    stacjonarne          5.000000      9.400000
                              niestacjonarne       4.666667      9.200000
   Skewness                   stacjonarne       -0.03338405    -0.1360270
                              niestacjonarne     0.03889259     0.4550161
   Std. error skewness        stacjonarne         0.2449753     0.2425606
                              niestacjonarne      0.3334641     0.3304137
   Kurtosis                   stacjonarne        -0.7727999     0.3579915
                              niestacjonarne      -1.269694    -0.1249216
   Std. error kurtosis        stacjonarne         0.4853297     0.4806302
                              niestacjonarne      0.6559204     0.6500932
   Shapiro-Wilk W             stacjonarne         0.9821670     0.9875698
                              niestacjonarne      0.9434621     0.9752685
   Shapiro-Wilk p             stacjonarne         0.2116971     0.4844667
                              niestacjonarne      0.0169475     0.3485958
 ──────────────────────────────────────────────────────────────────────────
   Note. The CI of the mean assumes sample means follow a
   t-distribution with N - 1 degrees of freedom
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv. Plik .sav zapisano pakietem haven, a rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersję jamovi albo R, której faktycznie użyłeś(-aś).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Jak opisać przygotowanie danych i statystyki opisowe w pracy
Wzór akapitu do metod i wyników:
Zdania do kolejnych testów przygotuje generator opisu wyników w stylu APA, a test do hipotezy pomoże dobrać kreator doboru testu. Liczenie statystyk opisowych przećwiczysz w zadaniach ze statystyki opisowej.
Najczęstsze błędy
- Typy zmiennych zostawione po imporcie. Kod roku jako Continuous daje średnią zamiast tabeli częstości, a odpowiedzi zapisane tekstem nie wchodzą do
MEAN. MEANbez argumentów. Każdy brak odbiera osobie wynik. W przykładzie straciłyby go 23 osoby, prawie co siódma.VMEANzamiastMEAN. Każda osoba dostaje średnią całej próby.- Odwracanie w miejscu. Nadpisany oryginał nie pozwala sprawdzić przekodowania.
- Usuwanie wierszy zamiast filtra. Filtr zostawia ślad i da się go wyłączyć.
- Shapiro–Wilk jako wyrocznia. Przy dużej próbie test wychwyci każde drobne odchylenie. Patrz na histogram, wykres Q-Q i skośność.
Jeśli chcesz, żeby ktoś sprawdził Twój plik .omv przed analizą, zajrzyj do oferty analizy statystyczne dla studentów. Decyzje o danych musisz jednak umieć wyjaśnić samodzielnie.
Najczęstsze pytania
Jak policzyć średnią z kilku pytań w jamovi, gdy są braki danych?
Utwórz zmienną obliczaną (Compute) z formułą MEAN(s1, s2, s3_r, s4, s5, s6_r, min_valid=5). Argument min_valid liczy średnią z dostępnych odpowiedzi tylko u osób, które mają ich co najmniej tyle. Bez argumentów MEAN zwraca brak przy każdym pominiętym pytaniu, a ignore_missing=1 liczy wynik nawet z jednej odpowiedzi. Próg ustal przed analizą i podaj w pracy.
Jak odwrócić punktację pytania w jamovi?
Zaznacz kolumny pozycji odwróconych, kliknij Transform w zakładce Data i utwórz przekształcenie z formułą (max + min) minus $source, np. 6 - $source dla skali 1–5. Każda pozycja dostanie nową kolumnę powiązaną z oryginałem. Wynik sprawdź tabelą krzyżową: liczebności muszą leżeć na przekątnej.
Dlaczego jamovi nie pokazuje tabeli częstości?
Opcja Frequency tables w Descriptives działa tylko dla zmiennych typu Nominal i Ordinal. Jeśli kod roku studiów albo odpowiedzi Likerta zostały wczytane jako Continuous, zmień typ w edytorze zmiennej (dwuklik nagłówka albo F3). Przy okazji dodaj etykiety poziomów, żeby tabela pokazywała słowa zamiast kodów.
Jak wykluczyć osoby z analizy w jamovi bez usuwania danych?
Użyj filtra: zakładka Data → Filters i formuła, np. kontrola == 4. Wiersze, dla których formuła nie jest prawdziwa, zostają w pliku, ale robią się szare i nie wchodzą do analiz. Kilka filtrów działa kaskadowo, a każdy możesz wyłączyć.
Czym różni się MEAN od VMEAN w jamovi?
MEAN liczy średnią w wierszu, czyli wynik jednej osoby z kilku pytań. VMEAN liczy średnią całej kolumny i wpisuje tę samą liczbę każdej osobie. Do wyniku skali potrzebujesz MEAN, a VMEAN przydaje się np. do centrowania zmiennej.
Powiązane hasła
Przeczytaj też
jamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →PoradnikPrzygotowanie danych w SPSS
Variable View, kody braków 99 i 999, pozycje odwrócone w Recode into Different Variables i wynik skali z MEAN.5 – z tabelami kontrolnymi, składnią i plikiem .sav.
Czytaj →PoradnikTest t w jamovi krok po kroku
Trzy testy t w jamovi: które pola zaznaczyć, jak czytać tabele Student, Welch i Mann–Whitney, gdzie jest d Cohena i jak opisać wynik w APA – z danymi do pobrania.
Czytaj →Przygotowujesz dane w jamovi i nie wiesz, czy wynik skali i filtry są dobrze ustawione?
Sprawdzimy Twój plik .omv – typy zmiennych, przekodowania, formuły wyniku i filtry – oraz wyjaśnimy każdy krok tak, żebyś umiał(a) samodzielnie opisać i obronić przygotowanie danych.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Kim, H.-Y. (2012). Statistical notes for clinical researchers: Assessing normal distribution (1). Restorative Dentistry & Endodontics, 37(4), 245–248. https://doi.org/10.5395/rde.2012.37.4.245 ● Otwarty dostęp
- Mazza, G. L., Enders, C. K., & Ruehlman, L. S. (2015). Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation. Multivariate Behavioral Research, 50(5), 504–519. https://doi.org/10.1080/00273171.2015.1068157 ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.-a). jamovi documentation: Getting started, Data handling and Analyses. jamovi docs. https://docs.jamovi.org/ ● Otwarty dostęp
- The jamovi project. (b.d.-b). The spreadsheet. jamovi docs (user manual). https://docs.jamovi.org/usermanual/um_4_spreadsheet.html ● Otwarty dostęp
- The jamovi project. (b.d.-c). Data variables. jamovi docs (data handling). https://docs.jamovi.org/data/data_1_overview_data_variables.html ● Otwarty dostęp
- The jamovi project. (b.d.-d). jamovi source code: compute functions (server/jamovi/server/compute/functions.py) and formula editor function list (client/main/vareditor/formulatoolbar.ts). GitHub repository jamovi/jamovi, branch main. https://github.com/jamovi/jamovi/blob/main/server/jamovi/server/compute/functions.py ● Otwarty dostęp
- The jamovi project. (b.d.-e). Descriptives: analysis and user-interface definitions (jamovi/descriptives.a.yaml, jamovi/descriptives.u.yaml) and Polish translation (i18n/pl.json) of the jmv package. GitHub repository jamovi/jmv; jmv 2.7.7 (CRAN). https://github.com/jamovi/jmv/blob/main/jamovi/descriptives.u.yaml ● Otwarty dostęp
Cytowania BibTeX
@article{kim2012assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (1)}}, journal={Restorative Dentistry \& Endodontics}, year={2012}, volume={37}, number={4}, pages={245--248}, doi={10.5395/rde.2012.37.4.245}}@article{mazza2015addressing, author={Mazza, Gina L. and Enders, Craig K. and Ruehlman, Linda S.}, title={{Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={5}, pages={504--519}, doi={10.1080/00273171.2015.1068157}}@misc{jamovindocs, author={{The jamovi project}}, title={{jamovi documentation: Getting started, Data handling and Analyses}}, howpublished={jamovi docs}, year={b.d.-a}, url={https://docs.jamovi.org/}}@misc{jamovindspreadsheet, author={{The jamovi project}}, title={{The spreadsheet}}, howpublished={jamovi docs (user manual)}, year={b.d.-b}, url={https://docs.jamovi.org/usermanual/um_4_spreadsheet.html}}@misc{jamovindvariables, author={{The jamovi project}}, title={{Data variables}}, howpublished={jamovi docs (data handling)}, year={b.d.-c}, url={https://docs.jamovi.org/data/data_1_overview_data_variables.html}}@misc{jamovifunctionssource, author={{The jamovi project}}, title={{jamovi source code: compute functions (server/jamovi/server/compute/functions.py) and formula editor function list (client/main/vareditor/formulatoolbar.ts)}}, howpublished={GitHub repository jamovi/jamovi, branch main}, year={b.d.-d}, url={https://github.com/jamovi/jamovi/blob/main/server/jamovi/server/compute/functions.py}}@misc{jmvdescriptivesdef, author={{The jamovi project}}, title={{Descriptives: analysis and user-interface definitions (jamovi/descriptives.a.yaml, jamovi/descriptives.u.yaml) and Polish translation (i18n/pl.json) of the jmv package}}, howpublished={GitHub repository jamovi/jmv; jmv 2.7.7 (CRAN)}, year={b.d.-e}, url={https://github.com/jamovi/jmv/blob/main/jamovi/descriptives.u.yaml}}