Do czego służą analizy z menu Frequencies
Gdy obie zmienne są kategorialne, liczysz osoby w komórkach tabeli krzyżowej i sprawdzasz, czy rozkład jednej zmiennej zależy od drugiej. W jamovi wszystkie takie analizy są w menu Analyses → Frequencies (The jamovi project, b.d.-c). Wybór zależy od układu danych:
| Pytanie badawcze | Pozycja w menu Frequencies | Test |
|---|---|---|
| Czy dwie zmienne kategorialne są powiązane (różne osoby w grupach)? | Contingency Tables → Independent Samples (χ² test of association) | chi-kwadrat niezależności, test Fishera |
| Czy odpowiedź „tak/nie” zmieniła się u tych samych osób (przed i po)? | Contingency Tables → Paired Samples (McNemar test) | test McNemara |
| Czy rozkład jednej zmiennej zgadza się z założonymi proporcjami? | One Sample Proportion Tests → N Outcomes (χ² goodness of fit) | chi-kwadrat zgodności |
Interfejs programu omawiają wpis jamovi krok po kroku i hasło jamovi, a logikę testu – poradnik test chi-kwadrat krok po kroku. Odpowiednik w SPSS opisuje wpis chi-kwadrat w SPSS.
Ścieżki menu i nazwy opcji sprawdziliśmy w dokumentacji jamovi i w plikach definicji analiz pakietu jmv, który zawiera te same analizy co program (The jamovi project, b.d.-a, b.d.-c). Podajemy angielskie nazwy z interfejsu. W polskiej wersji językowej programu nazwy mogą się różnić.
Przykład i pliki do pobrania
Dane są symulowane. 240 osób studiujących wypełniło ankietę: kierunek (kierunek: psychologia, pedagogika, zarządzanie), tryb studiów (tryb), preferowana forma egzaminu (forma_egzaminu: test, ustny, projekt; 4 osoby nie odpowiedziały), zaliczenie statystyki w pierwszym terminie (zaliczenie: tak/nie) i dwa razy to samo pytanie „Czy umiesz samodzielnie wykonać test chi-kwadrat w programie?” – przed warsztatem z jamovi i po nim (umiem_przed, umiem_po).
Pobierz plik CSV z etykietami tekstowymi albo plik .sav z kodami liczbowymi i etykietami wartości. Jak otworzyć plik w programie, pokazuje wpis jamovi krok po kroku.
Przygotowanie danych w jamovi
- Typ pomiaru. Każda zmienna w jamovi ma Measure type (Continuous, Ordinal, Nominal, ID) i Data type (Integer, Decimal, Text). Program nadaje je przy wczytaniu, a zmienisz je w edytorze zmiennej po dwukliku na nagłówku kolumny (The jamovi project, b.d.-b). Kierunek, tryb i odpowiedzi „tak/nie” ustaw jako Nominal. Kolumna
idto ID. - Etykiety poziomów. W pliku .sav kody 1, 2, 3 mają już etykiety. Jeśli wpisujesz dane sam, kliknij poziom w edytorze zmiennej i wpisz nazwę, np. 1 → „psychologia” (The jamovi project, b.d.-b).
- Kolejność poziomów. Poziom na górze listy w edytorze zmiennej będzie pierwszym wierszem lub pierwszą kolumną każdej tabeli. Przestawisz go strzałkami (The jamovi project, b.d.-b). W tabeli 2 × 2 kolejność zmienia kierunek ilorazu szans – wrócimy do tego niżej. Po otwarciu pliku CSV sprawdź ją ręcznie.
- Braki danych. Puste komórki jamovi traktuje jako braki. Kod typu 9 = „brak odpowiedzi” trzeba wskazać w Missing values, inaczej stanie się osobną kategorią (The jamovi project, b.d.-b). Więcej o przygotowaniu pliku przeczytasz we wpisie przygotowanie danych i statystyki opisowe w jamovi.
- Masz tylko gotową tabelę liczebności? Wpisz każdą komórkę jako wiersz: kategoria wiersza, kategoria kolumny i liczba osób. Zmienną z liczbą osób przeciągnij do pola Counts (optional) (The jamovi project, b.d.-a). Wynik jest taki sam jak dla danych surowych (sprawdzenie w części „To samo w R”).
Independent Samples krok po kroku
Hipoteza: preferowana forma egzaminu zależy od kierunku studiów.
- Wybierz Analyses → Frequencies → Contingency Tables → Independent Samples. Zmienną grupującą (
kierunek) przeciągnij do pola Rows, a zmienną wyniku (forma_egzaminu) – do Columns. Pole Layers zostaw puste; zmienna w warstwie daje osobną tabelę dla każdej swojej kategorii (The jamovi project, b.d.-a, b.d.-c). - Statistics. W części Tests domyślnie zaznaczony jest tylko χ². Możesz dodać Likelihood ratio i Fisher's exact test, a w części Nominal – Phi and Cramer's V (The jamovi project, b.d.-c).
- Cells. Zostaw Observed counts, dodaj Expected counts i w części Percentages zaznacz Row.
- Post Hoc Tests. Zaznacz Standardized residuals (adjusted Pearson). Pole Highlight values above obok wyróżnia reszty powyżej progu, domyślnie 2.0 (The jamovi project, b.d.-c).
- Plots (opcjonalnie). Bar Plot z osią Y w procentach (Percentages, within rows) pokaże odsetki w grupach.
Opcje z części Ordinal (Gamma, Kendall's tau-b, Mantel-Haenszel) mają sens tylko przy uporządkowanych kategoriach obu zmiennych.
Jak czytać tabele wyników
Tabele mają układ tabel jamovi, a liczby zaokrągliliśmy do trzech miejsc po przecinku. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi. Pogrubiono to, co trafi do pracy.
| kierunek | test | ustny | projekt | Total | |
|---|---|---|---|---|---|
| psychologia | Observed | 48 | 20 | 36 | 104 |
| Expected | 40.983 | 23.356 | 39.661 | 104.000 | |
| % within row | 46.2% | 19.2% | 34.6% | 100.0% | |
| pedagogika | Observed | 29 | 25 | 19 | 73 |
| Expected | 28.767 | 16.394 | 27.839 | 73.000 | |
| % within row | 39.7% | 34.2% | 26.0% | 100.0% | |
| zarządzanie | Observed | 16 | 8 | 35 | 59 |
| Expected | 23.250 | 13.250 | 22.500 | 59.000 | |
| % within row | 27.1% | 13.6% | 59.3% | 100.0% | |
| Total | Observed | 93 | 53 | 90 | 236 |
| % within row | 39.4% | 22.5% | 38.1% | 100.0% |
Contingency Tables. Czytaj wiersze % within row, a nie liczebności – grupy mają różną wielkość. Projekt wybrało 59.3% osób z zarządzania i 26.0–34.6% osób z pozostałych kierunków. Egzamin ustny wybrało 34.2% osób z pedagogiki i 13.6–19.2% pozostałych. W tabeli jest 236 osób, bo 4 nie odpowiedziały na pytanie o formę egzaminu.
Wiersz Expected sprawdź sam. W kodzie jmv nie ma ostrzeżenia o małych liczebnościach oczekiwanych, jakie daje np. stopka w SPSS (The jamovi project, b.d.-c). Kim (2017) przypomina zasadę: najwyżej 20% komórek z liczebnością oczekiwaną poniżej 5 i żadna poniżej 1. Tu najmniejsza wynosi 13.25, więc warunek jest spełniony.
| Value | df | p | |
|---|---|---|---|
| χ² | 20.633 | 4 | < .001 |
| Likelihood ratio | 19.940 | 4 | < .001 |
| Fisher's exact test | < .001 | ||
| N | 236 | ||
| Phi-coefficient | NaN | ||
| Cramer's V | 0.209 |
χ² Tests. Raportuj wiersz χ²: χ²(4, N = 236) = 20.63, p < .001. Iloraz wiarygodności zwykle prowadzi do tego samego wniosku i nie musisz go podawać. W kodzie jmv test Fishera jest liczony także dla tabel większych niż 2 × 2; gdy dokładne obliczenie się nie uda, program przechodzi na metodę Monte Carlo i dodaje przypis (The jamovi project, b.d.-c).
Nominal. Dla tabeli 3 × 3 jamovi pokazuje przy Phi-coefficient wartość NaN (brak liczby). To nie błąd: współczynnik phi jest określony tylko dla tabel 2 × 2. Podaj V Craméra = .21. Kim (2017) wskazuje V jako miarę efektu dla tabel większych niż 2 × 2.
Która komórka odpowiada za wynik: Post Hoc Tests
Istotny χ² nie mówi, gdzie w tabeli jest związek – to pokazują reszty, których analizę w tabelach krzyżowych opisał Haberman (1973). Z czterech rodzajów reszt w jamovi wybierz Standardized residuals (adjusted Pearson). W kodzie jmv to reszty skorygowane, takie same jak Adjusted Residual w SPSS (The jamovi project, b.d.-c). Przy niezależności mają w przybliżeniu rozkład normalny standardowy.
| kierunek | test | ustny | projekt |
|---|---|---|---|
| psychologia | 1.883 | −1.054 | −0.988 |
| pedagogika | 0.067 | 2.904 | −2.563 |
| zarządzanie | −2.230 | −1.891 | 3.869 |
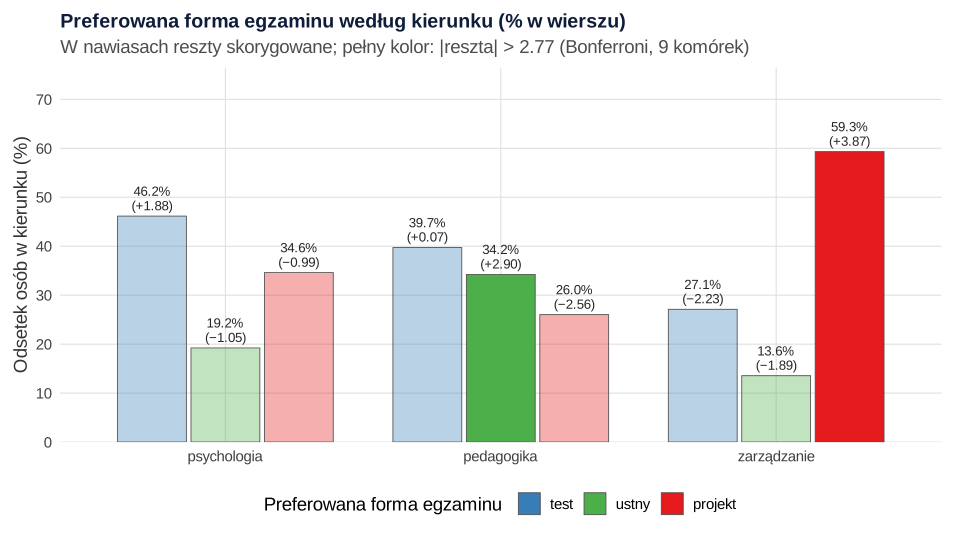
Próg 2.0 z pola Highlight values above wyróżni cztery komórki. Ale komórek jest dziewięć, więc rośnie ryzyko przypadkowego „trafienia”. Z korektą Bonferroniego na dziewięć komórek próg wynosi 2.77 – wpisz go w polu progu. Przekraczają go dwie komórki: osoby z zarządzania częściej wybierały projekt (3.87), a osoby z pedagogiki – egzamin ustny (2.90). Napisz w pracy, jaki próg przyjąłeś(-łaś).
Tabela 2 × 2: poprawka, test Fishera i iloraz szans
Drugie pytanie: czy tryb studiów wiąże się z zaliczeniem statystyki w pierwszym terminie? W tym samym oknie przeciągnij tryb do Rows i zaliczenie do Columns. Dla tabeli 2 × 2 w Statistics pojawia się więcej możliwości: χ² continuity correction, z test for difference in 2 proportions oraz miary z części Comparative Measures (2x2 only): Odds ratio, Relative risk i Difference in proportions z przedziałami ufności (The jamovi project, b.d.-a, b.d.-c).
| Value | df / 95% CI | p | |
|---|---|---|---|
| % zaliczenia (tak): stacjonarne / niestacjonarne | 73.5% / 54.8% | ||
| χ² | 8.843 | 1 | .003 |
| χ² continuity correction | 8.029 | 1 | .005 |
| z test difference in 2 proportions | 2.974 | .003 | |
| Fisher's exact test | .003 | ||
| Difference in 2 proportions | 0.186 | [0.063, 0.310] | |
| Odds ratio | 2.281 | [1.318, 3.947] | |
| Relative risk | 1.340 | [1.088, 1.650] | |
| Phi-coefficient | 0.192 |
Zaliczyło 73.5% osób studiujących stacjonarnie i 54.8% niestacjonarnie. Test z dla dwóch proporcji to ten sam test co χ² bez poprawki: 2.974² = 8.843, p jest identyczne. Który wiersz testu podać? Campbell (2007) porównał siedem testów dla tabel 2 × 2. Najlepiej wypadł chi-kwadrat w wersji „N − 1”, gdy najmniejsza liczebność oczekiwana wynosi co najmniej 1, a test Fishera–Irwina, gdy jest mniejsza. Jamovi wersji „N − 1” nie podaje, ale łatwo ją policzyć: χ² × (N − 1)/N = 8.81, p = .003. Tu wszystkie wiersze prowadzą do tego samego wniosku. Kiedy wybrać test Fishera, omawia wpis chi-kwadrat czy test Fishera.
Iloraz szans i kolejność poziomów. Iloraz szans 2.28, 95% CI [1.32, 3.95], znaczy: szansa zaliczenia w pierwszym terminie była 2.28 raza większa w pierwszym wierszu (stacjonarne) niż w drugim. Jamovi liczy go zawsze dla pierwszej kolumny i pierwszego wiersza. Gdy w edytorze zmiennej niestacjonarne stoi na górze, ta sama tabela da OR = 0.44, 95% CI [0.25, 0.76] – czyli odwrotność. Ryzyko względne 1.34 i różnica proporcji 0.186 też porównują wiersze (opcja Compare: rows) i dotyczą pierwszej kolumny („tak”). Zanim przepiszesz OR, sprawdź, które poziomy są pierwsze. Gdy w komórce jest 0, jamovi stosuje poprawkę Haldane'a–Anscombe'a i zaznacza to w przypisie (The jamovi project, b.d.-c). Ten sam problem kodowania wraca w regresji logistycznej w jamovi.
Paired Samples: test McNemara przed i po
To samo pytanie zadano tym samym 240 osobom dwa razy, więc zwykły χ² jest tu błędem. Wybierz Analyses → Frequencies → Contingency Tables → Paired Samples. Do Rows przeciągnij umiem_przed, do Columns – umiem_po. W Percentages zaznacz Row. Okno ma też opcje χ² continuity correction i Log odds ratio exact (The jamovi project, b.d.-a, b.d.-c).
| umiem_przed | tak | nie | Total | |
|---|---|---|---|---|
| tak | Count | 63 | 7 | 70 |
| % within row | 90.0% | 10.0% | ||
| nie | Count | 58 | 112 | 170 |
| % within row | 34.1% | 65.9% | ||
| Total | Count | 121 | 119 | 240 |
| McNemar χ² (df = 1) | 40.015, p < .001 | |||
| χ² continuity correction (df = 1) | 38.462, p < .001 | |||
Test McNemara patrzy tylko na pary niezgodne: 58 osób zmieniło odpowiedź z „nie” na „tak”, a 7 – z „tak” na „nie”. Odsetek odpowiedzi „tak” wzrósł z 29.2% (70/240) do 50.4% (121/240).
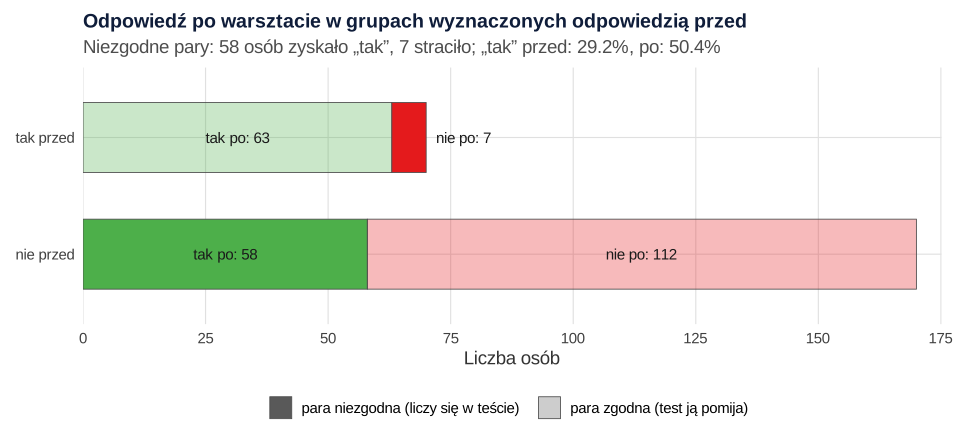
Który wiersz podać? Fagerland, Lydersen i Laake (2013) porównali wersje testu McNemara w symulacjach. Wersja z poprawką na ciągłość nie sprawdziła się w żadnym scenariuszu, a wersję asymptotyczną bez poprawki zalecają, jeśli akceptuje się niewielkie przekroczenia poziomu α. Raportuj więc wiersz χ² bez poprawki. Przy małej liczbie par niezgodnych sprawdź wersję mid-p poza jamovi – omawia ją wpis test McNemara przed i po.
N Outcomes: test chi-kwadrat zgodności
Czy struktura próby odpowiada strukturze wydziału, w której 45% studiuje psychologię, 30% pedagogikę i 25% zarządzanie (liczby przyjęte w przykładzie)? Wybierz Analyses → Frequencies → One Sample Proportion Tests → N Outcomes i przeciągnij kierunek do pola Variable. Zaznacz Expected counts, a w części Expected Proportions wpisz w kolumnie Ratio 45, 30 i 25 (The jamovi project, b.d.-a, b.d.-c). Domyślnie każda kategoria ma Ratio = 1, czyli program testuje równe proporcje.
| Level | Count | Proportion | |
|---|---|---|---|
| psychologia | Observed | 105 | 0.438 |
| Expected | 108.000 | 0.450 | |
| pedagogika | Observed | 74 | 0.308 |
| Expected | 72.000 | 0.300 | |
| zarządzanie | Observed | 61 | 0.254 |
| Expected | 60.000 | 0.250 | |
| χ² (df = 2) | 0.156, p = .925 | ||
Wynik nieistotny znaczy tylko, że nie wykryto odchylenia od struktury wydziału – nie dowodzi reprezentatywności próby.
Zapis wyników w stylu APA
Podaj odsetki w grupach, χ² z df i N, p, miarę efektu i komórki z dużymi resztami:
Gotowe zdania do innych testów przygotuje generator opisu wyników APA.
To samo w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc poniższy kod daje te same liczby co okna opisane wyżej (The jamovi project, b.d.-a). Nazwy argumentów odpowiadają opcjom w oknie, np. pcRow to Row w Percentages, a resS to Standardized residuals. Samego jamovi tu nie uruchamialiśmy – liczby w tekście pochodzą z tego kodu. R drukuje więcej miejsc po przecinku niż tabele powyżej, a p zapisuje jako 0.0029426 zamiast .003.
Tabele krzyżowe, test McNemara i test zgodności funkcjami jmv
R
# Chi-kwadrat i tabele krzyżowe w jamovi – te same analizy w R pakietem jmv (silnik analiz jamovi)
suppressPackageStartupMessages(library(jmv))
invisible(suppressMessages(loadNamespace("vcdExtra")))   # pakiet pomocniczy jmv: bez komunikatu przy ładowaniu
dane <- read.csv("chi-kwadrat-jamovi-dane.csv")
# Kolejność poziomów jak w edytorze zmiennej jamovi (pierwszy poziom = pierwszy wiersz/kolumna)
dane$kierunek <- factor(dane$kierunek, levels = c("psychologia", "pedagogika", "zarządzanie"))
dane$forma_egzaminu <- factor(dane$forma_egzaminu, levels = c("test", "ustny", "projekt"))
dane$tryb <- factor(dane$tryb, levels = c("stacjonarne", "niestacjonarne"))
for (v in c("zaliczenie", "umiem_przed", "umiem_po")) dane[[v]] <- factor(dane[[v]], levels = c("tak", "nie"))

# 1. Frequencies → Independent Samples (χ² test of association): kierunek × forma egzaminu
contTables(data = dane, rows = "kierunek", cols = "forma_egzaminu",
           chiSq = TRUE, likeRat = TRUE, fisher = TRUE, phiCra = TRUE,
           obs = TRUE, exp = TRUE, pcRow = TRUE, resS = TRUE)

# 2. Tabela 2 × 2: tryb studiów × zaliczenie w 1. terminie, miary porównawcze
contTables(data = dane, rows = "tryb", cols = "zaliczenie",
           chiSq = TRUE, chiSqCorr = TRUE, fisher = TRUE, zProp = TRUE, phiCra = TRUE,
           odds = TRUE, relRisk = TRUE, diffProp = TRUE, ci = TRUE, pcRow = TRUE)

# 3. Pułapka kolejności poziomów: odwrócone poziomy zmiennej wiersza dają odwrotność ilorazu szans
odwr <- dane
odwr$tryb <- factor(odwr$tryb, levels = c("niestacjonarne", "stacjonarne"))
contTables(data = odwr, rows = "tryb", cols = "zaliczenie", chiSq = FALSE, odds = TRUE, ci = TRUE)

# 4. Gotowa tabela liczebności: pole Counts (optional) daje te same wyniki co dane surowe
agreg <- as.data.frame(table(tryb = dane$tryb, zaliczenie = dane$zaliczenie))
agreg
z_counts <- contTables(data = agreg, rows = "tryb", cols = "zaliczenie", counts = "Freq", chiSq = TRUE)
z_counts$freqs
z_counts$chiSq

# 5. Frequencies → Paired Samples (McNemar test): przed i po warsztacie
contTablesPaired(data = dane, rows = "umiem_przed", cols = "umiem_po",
                 chiSq = TRUE, chiSqCorr = TRUE, pcRow = TRUE)

# 6. Frequencies → N Outcomes (χ² goodness of fit): struktura próby a struktura wydziału 45/30/25%
propTestN(data = dane, var = "kierunek", expected = TRUE, ratio = c(45, 30, 25))
# 7. Poza jamovi: chi-kwadrat „N − 1” dla tabeli 2 × 2 i najmniejsza liczebność oczekiwana
x2 <- chisq.test(table(dane$tryb, dane$zaliczenie), correct = FALSE)
n <- sum(x2$observed)
x2_n1 <- unname(x2$statistic) * (n - 1) / n
round(c(min_oczekiwana = min(x2$expected), chi2_N1 = x2_n1, p = pchisq(x2_n1, 1, lower.tail = FALSE)), 4)
packageVersion("jmv")
Wynik w R
 CONTINGENCY TABLES

 Contingency Tables
 ───────────────────────────────────────────────────────────────────────────────────
   kierunek                       test         ustny        projekt      Total
 ───────────────────────────────────────────────────────────────────────────────────
   psychologia    Observed               48           20           36          104
                  Expected         40.98305     23.35593     39.66102    104.00000
                  % within row     46.15385     19.23077     34.61538    100.00000

   pedagogika     Observed               29           25           19           73
                  Expected         28.76695     16.39407     27.83898     73.00000
                  % within row     39.72603     34.24658     26.02740    100.00000

   zarządzanie    Observed               16            8           35           59
                  Expected         23.25000     13.25000     22.50000     59.00000
                  % within row     27.11864     13.55932     59.32203    100.00000

   Total          Observed               93           53           90          236
                  Expected         93.00000     53.00000     90.00000    236.00000
                  % within row     39.40678     22.45763     38.13559    100.00000
 ───────────────────────────────────────────────────────────────────────────────────


 χ² Tests
 ──────────────────────────────────────────────────────
                          Value       df    p
 ──────────────────────────────────────────────────────
   χ²                     20.63285     4    0.0003744
   Likelihood ratio       19.94047     4    0.0005131
   Fisher's exact test                      0.0005807
   N                           236
 ──────────────────────────────────────────────────────


 Nominal
 ────────────────────────────────
                      Value
 ────────────────────────────────
   Phi-coefficient          NaN
   Cramer's V         0.2090782
 ────────────────────────────────


 Post Hoc Test (Standardized residuals)
 ─────────────────────────────────────────────────────────
   kierunek       test           ustny        projekt
 ─────────────────────────────────────────────────────────
   psychologia     1.88279573    -1.054421    -0.9882536
   pedagogika      0.06716669     2.904338    -2.5628158
   zarządzanie    -2.23040577    -1.891260     3.8687235
 ─────────────────────────────────────────────────────────


 CONTINGENCY TABLES

 Contingency Tables
 ─────────────────────────────────────────────────────────────────────────
   tryb                              tak          nie          Total
 ─────────────────────────────────────────────────────────────────────────
   stacjonarne       Observed              108           39          147
                     % within row     73.46939     26.53061    100.00000

   niestacjonarne    Observed               51           42           93
                     % within row     54.83871     45.16129    100.00000

   Total             Observed              159           81          240
                     % within row     66.25000     33.75000    100.00000
 ─────────────────────────────────────────────────────────────────────────


 χ² Tests
 ─────────────────────────────────────────────────────────────────────
                                         Value       df    p
 ─────────────────────────────────────────────────────────────────────
   χ²                                    8.842737     1    0.0029426
   χ² continuity correction              8.029128     1    0.0046031
   z test difference in 2 proportions    2.973674          0.0029426
   Fisher's exact test                                     0.0033717
   N                                          240
 ─────────────────────────────────────────────────────────────────────


 Comparative Measures
 ───────────────────────────────────────────────────────────────────────
                                  Value        Lower         Upper
 ───────────────────────────────────────────────────────────────────────
   Difference in 2 proportions    0.1863068    0.06251873    0.3100948
   Odds ratio                      2.280543      1.317732     3.946840
   Relative risk                   1.339736      1.087648     1.650251
 ───────────────────────────────────────────────────────────────────────


 Nominal
 ────────────────────────────────
                      Value
 ────────────────────────────────
   Phi-coefficient    0.1919498
   Cramer's V         0.1919498
 ────────────────────────────────


 CONTINGENCY TABLES

 Contingency Tables
 ─────────────────────────────────────────
   tryb              tak    nie    Total
 ─────────────────────────────────────────
   niestacjonarne     51     42       93
   stacjonarne       108     39      147
   Total             159     81      240
 ─────────────────────────────────────────


 χ² Tests
 ──────────────
        Value
 ──────────────
   N      240
 ──────────────


 Comparative Measures
 ─────────────────────────────────────────────────────
                 Value        Lower        Upper
 ─────────────────────────────────────────────────────
   Odds ratio    0.4384921    0.2533673    0.7588798
 ─────────────────────────────────────────────────────

            tryb zaliczenie Freq
1    stacjonarne        tak  108
2 niestacjonarne        tak   51
3    stacjonarne        nie   39
4 niestacjonarne        nie   42

 Contingency Tables
 ─────────────────────────────────────────
   tryb              tak    nie    Total
 ─────────────────────────────────────────
   stacjonarne       108     39      147
   niestacjonarne     51     42       93
   Total             159     81      240
 ─────────────────────────────────────────


 χ² Tests
 ─────────────────────────────────────
         Value       df    p
 ─────────────────────────────────────
   χ²    8.842737     1    0.0029426
   N          240
 ─────────────────────────────────────


 PAIRED SAMPLES CONTINGENCY TABLES

 Contingency Tables
 ──────────────────────────────────────────────────────────────────
   umiem_przed                    tak          nie          Total
 ──────────────────────────────────────────────────────────────────
   tak            Count                  63            7       70
                  % within row     90.00000     10.00000

   nie            Count                  58          112      170
                  % within row     34.11765     65.88235

   Total          Count                 121          119      240
                  % within row     50.41667     49.58333
 ──────────────────────────────────────────────────────────────────


 McNemar Test
 ────────────────────────────────────────────────────────────
                               Value       df    p
 ────────────────────────────────────────────────────────────
   χ²                          40.01538     1    < .0000001
   χ² continuity correction    38.46154     1    < .0000001
   N                                240
 ────────────────────────────────────────────────────────────


 PROPORTION TEST (N OUTCOMES)

 Proportions - kierunek
 ──────────────────────────────────────────────────────
   Level                      Count        Proportion
 ──────────────────────────────────────────────────────
   psychologia    Observed          105     0.4375000
                  Expected    108.00000     0.4500000

   pedagogika     Observed           74     0.3083333
                  Expected     72.00000     0.3000000

   zarządzanie    Observed           61     0.2541667
                  Expected     60.00000     0.2500000
 ──────────────────────────────────────────────────────


 χ² Goodness of Fit
 ────────────────────────────────
   χ²           df    p
 ────────────────────────────────
   0.1555556     2    0.9251700
 ────────────────────────────────

min_oczekiwana        chi2_N1              p
       31.3875         8.8059         0.0030
[1] ‘2.7.7’
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv; jmv korzysta wewnętrznie z pakietu vcd (phi, V Craméra, iloraz szans). Plik .sav zapisano pakietem haven, a rysunki przygotowano w pakiecie ggplot2. Samego jamovi nie uruchamialiśmy – w pracy podaj wersję programu, której faktycznie użyłeś(-łaś).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- vcd (wersja 1.4.13): Meyer, D., Zeileis, A., Hornik, K., & Friendly, M. (2024). vcd: Visualizing categorical data [R package]. https://doi.org/10.32614/CRAN.package.vcd
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Odsetki w złym kierunku. Zaznaczone Column zamiast Row odpowiada na pytanie „kto wybiera projekt”, a nie „czym różnią się kierunki”.
- Brak kontroli liczebności oczekiwanych. Jamovi nie ostrzega o małych wartościach – zaznacz Expected counts i sprawdź je sam.
- Phi przepisane z tabeli większej niż 2 × 2 albo próba „naprawienia” wartości NaN. Dla takich tabel podaj V Craméra.
- Iloraz szans bez sprawdzenia kolejności poziomów. Ta sama tabela daje 2.28 albo 0.44 zależnie od tego, który poziom stoi pierwszy.
- Zwykły χ² dla pomiarów powtarzanych zamiast Paired Samples (McNemar).
Wybór testu ułatwi kreator doboru testu. Przećwiczyć liczenie i interpretację możesz na zbiorze chi-kwadrat – zadania z rozwiązaniami. Kolejne wpisy z serii o jamovi to test t w jamovi i ANOVA w jamovi.
Najczęstsze pytania
Gdzie w jamovi jest test chi-kwadrat?
W menu Analyses → Frequencies. Test niezależności dwóch zmiennych to Contingency Tables → Independent Samples, test McNemara dla tych samych osób – Contingency Tables → Paired Samples, a test zgodności jednej zmiennej z założonymi proporcjami – One Sample Proportion Tests → N Outcomes. W polskiej wersji językowej nazwy mogą się różnić.
Dlaczego jamovi pokazuje NaN przy współczynniku phi?
Bo tabela jest większa niż 2 × 2, a phi jest określone tylko dla tabel 2 × 2. To nie błąd danych. Dla tabeli 3 × 3 podaj V Craméra z tego samego wiersza tabeli Nominal.
Jak w jamovi zrobić chi-kwadrat z gotowej tabeli liczebności?
Wpisz każdą komórkę jako osobny wiersz: kategoria wiersza, kategoria kolumny i liczba osób. W oknie Independent Samples przeciągnij zmienną z liczbą osób do pola Counts (optional). Wynik będzie taki sam jak dla danych surowych.
Dlaczego iloraz szans w jamovi wyszedł mniejszy niż 1, choć grupa wypadła lepiej?
Jamovi liczy iloraz szans dla pierwszego wiersza i pierwszej kolumny tabeli. Jeśli na górze listy poziomów stoi druga grupa, dostaniesz odwrotność, np. 0.44 zamiast 2.28. Kolejność poziomów zmienisz strzałkami w edytorze zmiennej.
Które reszty z Post Hoc Tests w jamovi podać w pracy?
Standardized residuals (adjusted Pearson), czyli reszty skorygowane. Domyślny próg wyróżnienia 2.0 nie uwzględnia liczby komórek – przy dziewięciu komórkach z poprawką Bonferroniego przyjmij 2.77 i napisz w pracy, jaki próg zastosowałeś(-łaś).
Powiązane hasła
Przeczytaj też
jamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →PoradnikChi-kwadrat w SPSS krok po kroku
Crosstabs w SPSS od pliku po opis APA: opcje Statistics i Cells, wiersz Pearsona, V Craméra, reszty skorygowane, test dokładny, Weight Cases i składnia CROSSTABS – z plikiem .sav.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →Masz tabele krzyżowe z jamovi i nie wiesz, co z nich przepisać?
Sprawdzimy układ danych, wybór testu i kolejność poziomów, policzymy analizę i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13(1), Article 91. https://doi.org/10.1186/1471-2288-13-91 ● Otwarty dostęp
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- The jamovi project. (b.d.-a). Contingency Tables (contTables). jamovi documentation. https://docs.jamovi.org/jmv/jmv_contTables.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). Data Variables. jamovi documentation. https://docs.jamovi.org/data/data_1_overview_data_variables.html ● Otwarty dostęp
- The jamovi project. (b.d.-c). jmv: Definitions of the Frequencies analyses (0000.yaml, conttables, conttablespaired and proptestn .a.yaml and .u.yaml). GitHub repository jamovi/jmv. https://github.com/jamovi/jmv/tree/master/jamovi ● Otwarty dostęp
Cytowania BibTeX
@article{campbell2007chisquared, author={Campbell, Ian}, title={{Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={19}, pages={3661--3675}, doi={10.1002/sim.2832}}@article{fagerland2013mcnemar, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={91}, doi={10.1186/1471-2288-13-91}}@article{haberman1973analysis, author={Haberman, Shelby J.}, title={{The analysis of residuals in cross-classified tables}}, journal={Biometrics}, year={1973}, volume={29}, number={1}, pages={205--220}, doi={10.2307/2529686}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@misc{jamovindjmvconttables, author={{The jamovi project}}, title={{Contingency Tables (contTables)}}, howpublished={jamovi documentation}, year={b.d.-a}, publisher={The jamovi project}, url={https://docs.jamovi.org/jmv/jmv_contTables.html}}@misc{jamovindzmienne, author={{The jamovi project}}, title={{Data Variables}}, howpublished={jamovi documentation}, year={b.d.-b}, publisher={The jamovi project}, url={https://docs.jamovi.org/data/data_1_overview_data_variables.html}}@misc{jamovigithubjmvfrequencies, author={{The jamovi project}}, title={{jmv: Definitions of the Frequencies analyses (0000.yaml, conttables, conttablespaired and proptestn .a.yaml and .u.yaml)}}, howpublished={GitHub repository jamovi/jmv}, year={b.d.-c}, publisher={The jamovi project}, url={https://github.com/jamovi/jmv/tree/master/jamovi}}