Do czego służy tabela krzyżowa z testem chi-kwadrat
Test chi-kwadrat niezależności sprawdza, czy dwie zmienne jakościowe są ze sobą powiązane, np. czy miejsce zamieszkania w czasie studiów wiąże się z preferowaną formą zajęć. W SPSS liczy go procedura Crosstabs, która przy okazji buduje tabelę krzyżową. Logikę testu, warunki i obliczenia w R omawia poradnik test chi-kwadrat krok po kroku, a wybór między chi-kwadrat a testem Fishera – wpis chi-kwadrat czy test Fishera. Tu zajmujemy się samym SPSS.
Ścieżki menu, nazwy opcji i składnię sprawdziliśmy w oficjalnej dokumentacji IBM SPSS Statistics (IBM Corp., b.d.-a, b.d.-b, b.d.-c, b.d.-d, b.d.-e). Podajemy je po angielsku, a polskie – według polskiej dokumentacji IBM 32.0.0; tłumaczenia różnią się między wersjami, więc w Twoim programie nazwy mogą być nieco inne. Jak czytać tabelę 2 × 2 z pięcioma wierszami testów, pokazuje wpis jak czytać wyniki z SPSS – tego tu nie powtarzamy.
Przykład i pliki do pobrania
Dane są symulowane. 264 osoby studiujące podały, gdzie mieszkają w czasie studiów (zamieszkanie: 1 = z rodzicami, 2 = akademik, 3 = wynajmowane mieszkanie) i jaką formę zajęć wolą (forma: 1 = stacjonarne, 2 = hybrydowe, 3 = zdalne). Cztery osoby nie odpowiedziały na drugie pytanie. Hipoteza: preferowana forma zajęć zależy od miejsca zamieszkania.
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV (zob. plik .sav).
Przygotowanie danych
- Jeden wiersz – jedna osoba. Każda zmienna to osobna kolumna z kodami liczbowymi i etykietami wartości. Dokumentacja IBM przypomina, że wartości tekstowe SPSS sortuje alfabetycznie, więc kolejność kategorii może się pomieszać (IBM Corp., b.d.-c). Kody liczbowe tego problemu nie mają.
- Poziom pomiaru. Obie zmienne to skale nominalne. Jeśli kategorie są uporządkowane, rozważ też miary porządkowe (zob. skala porządkowa).
- Braki danych. Kody typu 9 = „brak odpowiedzi” zdefiniuj w Variable View jako braki, inaczej staną się czwartą kategorią tabeli. Jak to zrobić, pokazuje wpis przygotowanie danych w SPSS.
- Masz tylko gotową tabelę liczebności? Wpisz każdą komórkę jako wiersz: kod wiersza, kod kolumny i liczbę osób. Potem wybierz Data → Weight Cases, zaznacz Weight cases by i wskaż zmienną z liczbą osób. Wartość 3 liczy się wtedy jak trzy obserwacje. Ważenie działa, dopóki go nie wyłączysz, i zapisuje się z plikiem, a wiersze z wagą 0 lub brakującą wypadają z analizy (IBM Corp., b.d.-e). Przykład takiego pliku znajdziesz niżej, w części o teście dokładnym.
Crosstabs krok po kroku
- Analyze → Descriptive Statistics → Crosstabs (w polskiej dokumentacji: Analiza → Statystyka opisowa → Tabele krzyżowe; IBM Corp., b.d.-c). Zmienną grupującą (
zamieszkanie) przenieś do Row(s), a zmienną wyniku (forma) – do Column(s). Pole warstwy (Layer) zostaw puste. Zmienna w warstwie daje osobną tabelę i osobny test dla każdej jej wartości, np. osobno dla kobiet i mężczyzn (IBM Corp., b.d.-c). - Statistics (Statystyki). Zaznacz Chi-square (Chi-kwadrat) oraz w grupie Nominal opcję Phi and Cramer’s V (Współczynnik Phi i współczynnik V Cramera) (IBM Corp., b.d.-b). Innych miar nie zaznaczaj „na zapas”.
- Cells (Komórki). Zaznacz liczebności Observed i Expected (Obserwowane, Oczekiwane), odsetki Row (Wiersz) i reszty Adjusted standardized (Skorygowane standaryzowane) (IBM Corp., b.d.-a). Odsetki licz w obrębie grup porównywanych w hipotezie. Grupy są w wierszach, więc zaznacz Row.
- Paste (Wklej) zamiast OK. SPSS wklei polecenie CROSSTABS do edytora składni (IBM Corp., b.d.-c). Zapisz je razem z danymi.
W oknie Cells są jeszcze dwie opcje warte uwagi. Compare column proportions (Porównaj proporcje kolumn) porównuje parami odsetki w kolumnach testem z i oznacza różnice literami w indeksie. Z opcją Adjust p-values (Bonferroni method) stosuje korektę Bonferroniego (IBM Corp., b.d.-a, b.d.-d). Porównuje kolumny, więc ma sens, gdy grupy umieścisz w kolumnach. Create APA style table formatuje tabelę według APA, ale wtedy nie zaznaczysz liczebności i odsetków osobno (IBM Corp., b.d.-a).
Wydruk krok po kroku
Tabele mają układ tabel wynikowych SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Pogrubiono liczby, które trafią do pracy.
| Valid | Missing | Total | ||||
|---|---|---|---|---|---|---|
| N | Percent | N | Percent | N | Percent | |
| zamieszkanie * forma | 260 | 98.5% | 4 | 1.5% | 264 | 100.0% |
Pierwsza tabela mówi, ile osób weszło do analizy: 260 z 264. W pracy napisz, że cztery osoby bez odpowiedzi wyłączono.
| forma | Total | ||||
|---|---|---|---|---|---|
| stacjonarne | hybrydowe | zdalne | |||
| z rodzicami | Count | 33 | 32 | 22 | 87 |
| Expected Count | 40.2 | 27.1 | 19.7 | 87.0 | |
| % within zamieszkanie | 37.9% | 36.8% | 25.3% | 100.0% | |
| Adjusted Residual | −1.9 | 1.4 | .7 | ||
| akademik | Count | 47 | 21 | 7 | 75 |
| Expected Count | 34.6 | 23.4 | 17.0 | 75.0 | |
| % within zamieszkanie | 62.7% | 28.0% | 9.3% | 100.0% | |
| Adjusted Residual | 3.4 | −.7 | −3.3 | ||
| wynajmowane mieszkanie | Count | 40 | 28 | 30 | 98 |
| Expected Count | 45.2 | 30.5 | 22.2 | 98.0 | |
| % within zamieszkanie | 40.8% | 28.6% | 30.6% | 100.0% | |
| Adjusted Residual | −1.3 | −.7 | 2.4 | ||
| Total | Count | 120 | 81 | 59 | 260 |
| Expected Count | 120.0 | 81.0 | 59.0 | 260.0 | |
| % within zamieszkanie | 46.2% | 31.2% | 22.7% | 100.0% | |
W tabeli krzyżowej czytaj odsetki w wierszu (% within zamieszkanie), a nie liczebności. Grupy mają różną wielkość, więc same liczby osób wprowadzają w błąd. Zajęcia stacjonarne wybrało 62.7% osób z akademika, a 37.9–40.8% w pozostałych grupach. Zajęcia zdalne wybrało 9.3% osób z akademika i 30.6% osób w wynajmowanych mieszkaniach. Expected Count to liczebności oczekiwane, gdyby zmienne były niezależne – służą do sprawdzenia warunków testu i nie trafiają do pracy.
| Value | df | Asymp. Sig. (2-sided) | |
|---|---|---|---|
| Pearson Chi-Square | 16.509a | 4 | .002 |
| Likelihood Ratio | 17.556 | 4 | .002 |
| Linear-by-Linear Association | .109 | 1 | .741 |
| N of Valid Cases | 260 |
a. 0 cells (0.0%) have expected count less than 5. The minimum expected count is 17.02.
Dla tabeli większej niż 2 × 2 opcja Chi-square daje chi-kwadrat Pearsona i iloraz wiarygodności, a przy obu zmiennych liczbowych także test związku liniowego (IBM Corp., b.d.-b, b.d.-d). Raportuj wiersz Pearson Chi-Square: χ²(4) = 16.51, p = .002. Liczba stopni swobody to (3 − 1)(3 − 1) = 4. Wiersz Likelihood Ratio zwykle prowadzi do tego samego wniosku i nie trzeba go podawać. Pomiń wiersz Linear-by-Linear Association. Traktuje kody 1–3 jak liczby, a tu kolejność kategorii nic nie znaczy. Najważniejsza jest jednak stopka a: żadna komórka nie ma liczebności oczekiwanej poniżej 5, a najmniejsza wynosi 17.02. Warunki testu są więc spełnione.
| Value | Approximate Significance | ||
|---|---|---|---|
| Nominal by Nominal | Phi | .252 | .002 |
| Cramer’s V | .178 | .002 | |
| N of Valid Cases | 260 | ||
Dla tabeli większej niż 2 × 2 podaj V Craméra, nie phi. Współczynnik phi może tu przekroczyć 1, a V dzieli chi-kwadrat przez N razy (mniejsza liczba kategorii − 1), więc mieści się w przedziale 0–1. Kim (2017) przypomina, że dla tabel większych niż 2 × 2 właściwą miarą jest V. Wartość .178 w tabeli 3 × 3 oznacza związek wyraźny, ale daleki od silnego. Kolumna Approximate Significance powtarza p z testu Pearsona.
Która komórka odpowiada za wynik: reszty skorygowane
Istotny test mówi tylko, że gdzieś w tabeli jest związek. Gdzie – pokazują reszty, a dokładniej reszty skorygowane standaryzowane z wiersza Adjusted Residual. To różnica między liczebnością obserwowaną a oczekiwaną podzielona przez jej błąd standardowy (IBM Corp., b.d.-a). Analizę reszt w tabelach krzyżowych zaproponował Haberman (1973). Przy niezależności reszty mają w przybliżeniu rozkład normalny standardowy, więc |reszta| > 1.96 to sygnał, że komórka odbiega od niezależności. Sharpe (2015) omawia cztery sposoby szukania źródła istotnego wyniku testu chi-kwadrat; jednym z nich jest właśnie analiza reszt.
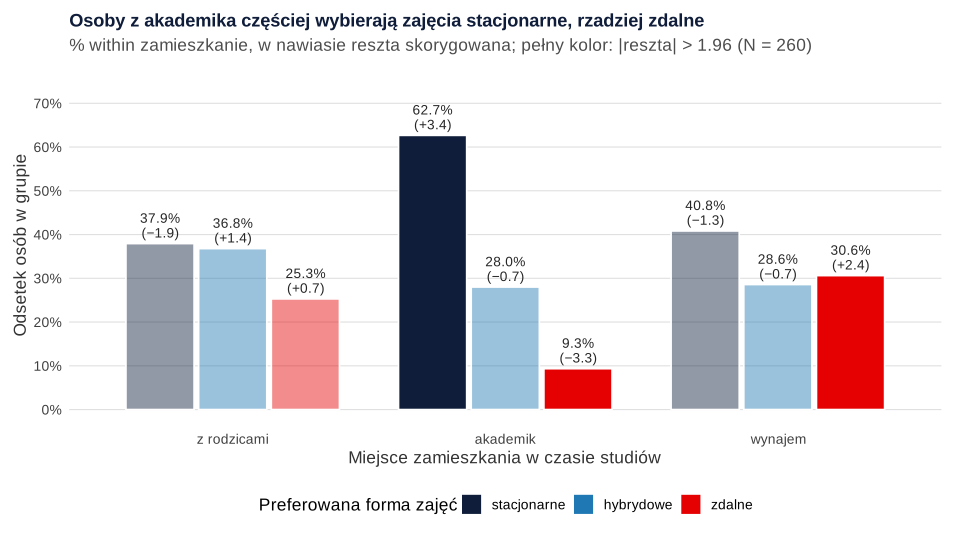
W przykładzie wyróżniają się trzy komórki: osoby z akademika częściej wybierały zajęcia stacjonarne (reszta 3.4) i rzadziej zdalne (−3.3), a osoby z wynajmowanych mieszkań częściej zdalne (2.4). Ale komórek jest dziewięć, więc rośnie ryzyko przypadkowego „trafienia” (zob. problem wielokrotnych porównań). Z poprawką Bonferroniego na dziewięć komórek próg wynosi |reszta| > 2.77. Przekraczają go tylko dwie komórki akademika. Napisz w pracy, jaki próg przyjąłeś.
Małe liczebności: test dokładny i Monte Carlo
Gdy liczebności oczekiwane są małe, p z wiersza Pearsona to tylko przybliżenie. Dla tabel 2 × 2 SPSS sam dodaje test Fishera (IBM Corp., b.d.-b). Dla większych tabel dokładne p wymaga podkomendy /METHOD. Według dokumentacji polecenia CROSSTABS jest ona dostępna tylko w SPSS Statistics Premium Edition albo z opcją Exact Tests (IBM Corp., b.d.-d). Bez tego modułu dostaniesz wyłącznie wyniki asymptotyczne. Dokumentacja opisuje dwie metody:
EXACT– dokładne p dla zaznaczonych statystyk; domyślny limit to 5 minut na test, a obliczenia mogą wymagać dużo pamięci;MC– oszacowanie dokładnego p metodą Monte Carlo z przedziałem ufności (domyślnie 99%, 10 000 losowanych tabel). Wynik różni się nieco między uruchomieniami. Przy teście dłuższym niż 30 minut dokumentacja zaleca właśnie tę metodę (IBM Corp., b.d.-d).
Dla tabeli r × c test dokładny Fishera to uogólnienie znane jako test Fishera–Freemana–Haltona. Mehta i Patel (1983) opisali algorytm, który czyni go obliczalnym. Pokazali też, że w rzadkich tabelach test Fishera i chi-kwadrat Pearsona często prowadzą do sprzecznych wniosków.
Przykład: pilotaż z gotowej tabeli. W pilotażu 30 osób odpowiedziało na te same pytania, a my mamy tylko tabelę liczebności. Plik do Weight Cases ma dziewięć wierszy:
| zamieszkanie | forma = 1 | forma = 2 | forma = 3 |
|---|---|---|---|
| 1 (z rodzicami) | liczba = 3 | liczba = 4 | liczba = 4 |
| 2 (akademik) | liczba = 7 | liczba = 1 | liczba = 1 |
| 3 (wynajmowane mieszkanie) | liczba = 3 | liczba = 4 | liczba = 3 |
W pliku SPSS każda komórka to osobny wiersz z trzema kolumnami: zamieszkanie, forma i liczba (układ wierszy pokazuje kod R niżej). Wszystkie dziewięć komórek ma liczebność oczekiwaną poniżej 5, a najmniejsza wynosi 2.40. Stopka tabeli Chi-Square Tests pokaże więc 9 komórek (100.0%). Wyniki z R:
| Metoda | Odpowiednik w SPSS | p |
|---|---|---|
| χ² Pearsona, przybliżenie asymptotyczne, χ²(4) = 6.33 | domyślny wydruk | .176 |
| χ² Pearsona, p dokładne (wszystkie 1809 tabel o tych samych sumach brzegowych) | /METHOD=EXACT | .189 |
| Test Fishera–Freemana–Haltona, p dokładne | /METHOD=EXACT | .204 |
| χ² Pearsona, Monte Carlo (10 000 tabel), 99% CI [.182, .203] | /METHOD=MC | .192 |
Wniosek się tu nie zmienia, ale przy małych liczebnościach podaj p dokładne i napisz, którą metodą je uzyskano. V Craméra = .33 w pilotażu na 30 osobach jest bardzo niepewne – nie porównuj go z wynikiem z głównego badania. Łączenie kategorii jako alternatywę omawia wpis chi-kwadrat czy test Fishera. Pojedynczą tabelę 2 × 2 albo r × c szybko sprawdzisz w kalkulatorze tabeli 2 × 2 i r × c.
Zapis wyników w stylu APA
Podaj odsetki w grupach (najlepiej w tabeli), χ² z df i N, p, V Craméra oraz komórki z dużymi resztami i przyjęty próg. Wzory do dostosowania:
Gotowe zdania do innych testów przygotuje generator opisu wyników APA. Nie pisz „Sig. = .000”, tylko p < .001 (zob. wartość p).
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według opisu polecenia CROSSTABS w Command Syntax Reference (IBM Corp., b.d.-d), ale nie uruchamialiśmy jej w SPSS. Wiersz /METHOD zadziała tylko z modułem Exact Tests albo w wersji Premium – bez niego usuń ten wiersz. Przepis 2 w R tworzy pliki do pobrania i liczy liczby z tabel tymi samymi metodami co SPSS: liczebności oczekiwane, reszty skorygowane, chi-kwadrat Pearsona, iloraz wiarygodności, test związku liniowego, phi i V Craméra oraz dokładne p dla pilotażu.
1. Składnia SPSS: CROSSTABS dla danych surowych i zagregowanych
SPSS
* Tabela krzyżowa i test chi-kwadrat: miejsce zamieszkania a preferowana forma zajęć.
* Składnia zgodna z opisem CROSSTABS w Command Syntax Reference; nie była uruchamiana w SPSS.
CROSSTABS
  /TABLES=zamieszkanie BY forma
  /STATISTICS=CHISQ PHI
  /CELLS=COUNT EXPECTED ROW ASRESID.

* Pilotaż z tabeli zagregowanej: ważenie wierszy liczbą osób (Data > Weight Cases).
WEIGHT BY liczba.
* /METHOD wymaga opcji Exact Tests albo SPSS Statistics Premium Edition.
* Zamiast EXACT można wpisać MC CIN(99) SAMPLES(10000).
CROSSTABS
  /TABLES=zamieszkanie BY forma
  /STATISTICS=CHISQ PHI
  /CELLS=COUNT EXPECTED ROW ASRESID
  /METHOD=EXACT TIMER(5).
WEIGHT OFF.
2. Te same liczby w R i pliki .sav oraz CSV
R
# B289 – chi-kwadrat w SPSS: liczby do tabel w układzie SPSS (Crosstabs)
# Dane symulowane, set.seed(2895): 264 osoby studiujące, miejsce zamieszkania w czasie studiów
# (1 = z rodzicami, 2 = akademik, 3 = wynajmowane mieszkanie) i preferowana forma zajęć
# (1 = stacjonarne, 2 = hybrydowe, 3 = zdalne); 4 osoby nie odpowiedziały na pytanie o formę zajęć.
# Metody jak w procedurze Crosstabs: liczebności oczekiwane, % w wierszu, reszty skorygowane
# standaryzowane, chi-kwadrat Pearsona, iloraz wiarygodności, test związku liniowego, phi i V Craméra.
suppressPackageStartupMessages(library(haven))
set.seed(2895)
n_gr <- c(88, 76, 100)
zamieszkanie <- rep(1:3, n_gr)
pr <- rbind(c(.36, .36, .28), c(.58, .28, .14), c(.38, .36, .26))
forma <- sapply(zamieszkanie, function(g) sample(1:3, 1, prob = pr[g, ]))
forma[c(17, 120, 181, 240)] <- NA                # 4 osoby bez odpowiedzi
dane <- data.frame(id = seq_along(zamieszkanie), zamieszkanie, forma)

# Krok 1. Plik .sav z etykietami zmiennych i wartości – i ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$zamieszkanie <- labelled(sav$zamieszkanie, label = "Miejsce zamieszkania w czasie studiów",
  labels = c("z rodzicami" = 1, "akademik" = 2, "wynajmowane mieszkanie" = 3))
sav$forma <- labelled(sav$forma, label = "Preferowana forma zajęć",
  labels = c("stacjonarne" = 1, "hybrydowe" = 2, "zdalne" = 3))
write_sav(sav, "../chi-kwadrat-spss-dane-przyklad.sav")
write.csv(dane, "../chi-kwadrat-spss-dane-przyklad.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# Krok 2. Case Processing Summary: ważne i brakujące obserwacje
c(Valid = sum(complete.cases(dane)), Missing = sum(!complete.cases(dane)), Total = nrow(dane))
round(100 * c(Valid = mean(complete.cases(dane)), Missing = mean(!complete.cases(dane))), 1)

# Krok 3. Crosstabulation: Count, Expected Count, % within zamieszkanie, Adjusted Residual
tb <- table(factor(dane$zamieszkanie, 1:3, c("z rodzicami", "akademik", "wynajem")),
            factor(dane$forma, 1:3, c("stacjonarne", "hybrydowe", "zdalne")))
N <- sum(tb)
ct <- chisq.test(tb, correct = FALSE)
addmargins(tb)
round(addmargins(ct$expected), 1)
round(100 * prop.table(tb, 1), 1)
round(ct$stdres, 1)                              # reszty skorygowane (Haberman) = ASRESID w SPSS

# Krok 4. Chi-Square Tests: Pearson, Likelihood Ratio, Linear-by-Linear Association
G2 <- 2 * sum(tb * log(tb / ct$expected))
kody <- na.omit(dane)
r <- cor(kody$zamieszkanie, kody$forma)
LL <- (N - 1) * r^2
df <- unname(ct$parameter)
round(rbind(Pearson = c(Value = unname(ct$statistic), df = df, p = ct$p.value),
            Likelihood_Ratio = c(G2, df, pchisq(G2, df, lower.tail = FALSE)),
            Linear_by_Linear = c(LL, 1, pchisq(LL, 1, lower.tail = FALSE))), 3)
format.pval(ct$p.value, digits = 3)
c(N_valid = N, komorki_E_ponizej_5 = sum(ct$expected < 5), min_E = round(min(ct$expected), 2))

# Krok 5. Symmetric Measures: phi i V Craméra (p z testu chi-kwadrat Pearsona)
X2 <- unname(ct$statistic)
round(c(Phi = sqrt(X2 / N), Cramers_V = sqrt(X2 / (N * (min(dim(tb)) - 1))), Approx_Sig = ct$p.value), 3)

# Krok 6. Które komórki odbiegają: próg dla |reszty skorygowanej| z poprawką Bonferroniego na 9 komórek
round(qnorm(1 - .05 / (2 * length(tb))), 2)
which(abs(ct$stdres) > qnorm(1 - .05 / (2 * length(tb))), arr.ind = TRUE)

# Krok 7. Pilotaż z tabeli zagregowanej (Weight Cases): 30 osób, małe liczebności oczekiwane
pil <- matrix(c(3, 4, 4,  7, 1, 1,  3, 4, 3), 3, byrow = TRUE, dimnames = dimnames(tb))
agreg <- data.frame(zamieszkanie = rep(1:3, each = 3), forma = rep(1:3, 3), liczba = as.vector(t(pil)))
agreg                                            # układ pliku do Weight Cases (zmienna liczba)
cp <- suppressWarnings(chisq.test(pil, correct = FALSE))
round(cp$expected, 2); c(komorki_E_ponizej_5 = sum(cp$expected < 5), min_E = round(min(cp$expected), 2))
# Rozkład dokładny: wszystkie tabele 3 × 3 o tych samych sumach brzegowych (prawdop. hipergeometryczne)
rs <- rowSums(pil); cs <- colSums(pil); n <- sum(pil)
lp <- function(m) sum(lfactorial(rs)) + sum(lfactorial(cs)) - lfactorial(n) - sum(lfactorial(m))
x2 <- function(m) { e <- outer(rs, cs) / n; sum((m - e)^2 / e) }
wyn <- NULL
for (a in 0:min(rs[1], cs[1])) for (b in 0:min(rs[1] - a, cs[2])) {
  c13 <- rs[1] - a - b; if (c13 > cs[3]) next
  for (d in 0:min(rs[2], cs[1] - a)) for (e in 0:min(rs[2] - d, cs[2] - b)) {
    c23 <- rs[2] - d - e; if (c23 > cs[3] - c13) next
    m <- rbind(c(a, b, c13), c(d, e, c23), cs - c(a, b, c13) - c(d, e, c23))
    if (any(m < 0)) next
    wyn <- rbind(wyn, c(lp = lp(m), x2 = x2(m)))
  }
}
P <- exp(wyn[, "lp"]); eps <- 1e-7
c(liczba_tabel = nrow(wyn), suma_P = round(sum(P), 6))
round(c(chi2 = unname(cp$statistic), df = unname(cp$parameter), p_asymptotyczne = cp$p.value,
        p_dokladne_Pearson = sum(P[wyn[, "x2"] >= unname(cp$statistic) - eps]),
        p_dokladne_Fisher = sum(P[wyn[, "lp"] <= lp(pil) + eps])), 4)
round(fisher.test(pil)$p.value, 4)               # kontrola: test Fishera–Freemana–Haltona
set.seed(2026)
p_mc <- chisq.test(pil, simulate.p.value = TRUE, B = 10000)$p.value      # Monte Carlo, 10 000 tabel
round(c(p_MC = p_mc, dolna_99 = p_mc - qnorm(.995) * sqrt(p_mc * (1 - p_mc) / 10000),
        gorna_99 = p_mc + qnorm(.995) * sqrt(p_mc * (1 - p_mc) / 10000)), 4)
round(sqrt(unname(cp$statistic) / (n * 2)), 3)  # V Craméra w pilotażu
Wynik w R
  Valid Missing   Total
    260       4     264
  Valid Missing
   98.5     1.5

              stacjonarne hybrydowe zdalne Sum
  z rodzicami          33        32     22  87
  akademik             47        21      7  75
  wynajem              40        28     30  98
  Sum                 120        81     59 260

              stacjonarne hybrydowe zdalne Sum
  z rodzicami        40.2      27.1   19.7  87
  akademik           34.6      23.4   17.0  75
  wynajem            45.2      30.5   22.2  98
  Sum               120.0      81.0   59.0 260

              stacjonarne hybrydowe zdalne
  z rodzicami        37.9      36.8   25.3
  akademik           62.7      28.0    9.3
  wynajem            40.8      28.6   30.6

              stacjonarne hybrydowe zdalne
  z rodzicami        -1.9       1.4    0.7
  akademik            3.4      -0.7   -3.3
  wynajem            -1.3      -0.7    2.4
                  Value df     p
Pearson          16.509  4 0.002
Likelihood_Ratio 17.556  4 0.002
Linear_by_Linear  0.109  1 0.741
[1] "0.00241"
            N_valid komorki_E_ponizej_5               min_E
             260.00                0.00               17.02
       Phi  Cramers_V Approx_Sig
     0.252      0.178      0.002
[1] 2.77
         row col
akademik   2   1
akademik   2   3
  zamieszkanie forma liczba
1            1     1      3
2            1     2      4
3            1     3      4
4            2     1      7
5            2     2      1
6            2     3      1
7            3     1      3
8            3     2      4
9            3     3      3

              stacjonarne hybrydowe zdalne
  z rodzicami        4.77       3.3   2.93
  akademik           3.90       2.7   2.40
  wynajem            4.33       3.0   2.67
komorki_E_ponizej_5               min_E
                9.0                 2.4
liczba_tabel       suma_P
        1809            1
              chi2                 df    p_asymptotyczne p_dokladne_Pearson  p_dokladne_Fisher
            6.3275             4.0000             0.1760             0.1891             0.2037
[1] 0.2037
    p_MC dolna_99 gorna_99
  0.1924   0.1822   0.2025
[1] 0.325
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. Składni SPSS nie uruchamialiśmy. W pracy podaj wersję programu, którego faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Odsetki w złym kierunku. „% within forma” odpowiada na pytanie, kto wybiera daną formę, a nie czym różnią się grupy.
- Przepisany wiersz Linear-by-Linear Association dla zmiennych nominalnych.
- Pominięta stopka o liczebnościach oczekiwanych poniżej 5.
- Phi zamiast V Craméra w tabeli większej niż 2 × 2.
- Interpretacja jednej komórki bez reszt, np. „osoby z rodzicami wolą zajęcia hybrydowe”, choć reszta wynosi tylko 1.4.
- Chi-kwadrat na odsetkach albo na pomiarach powtarzanych. Test wymaga liczebności i niezależnych obserwacji. Dla dwóch pomiarów tych samych osób użyj testu McNemara.
- Kod braku liczony jako kategoria albo zapomniane
WEIGHT OFFpo pracy z tabelą zagregowaną.
Jeśli nie wiesz, czy chi-kwadrat pasuje do hipotezy, skorzystaj z kreatora doboru testu. Dwie proporcje porównasz też jako różnicę odsetków z przedziałem ufności – zob. jak porównać odsetki w dwóch grupach. Pozostałe wpisy z serii o SPSS to test t w SPSS, ANOVA w SPSS, korelacja i regresja w SPSS oraz testy nieparametryczne w SPSS.
Najczęstsze pytania
Gdzie w SPSS jest test chi-kwadrat dla dwóch zmiennych jakościowych?
W menu Analyze → Descriptive Statistics → Crosstabs (w polskiej dokumentacji IBM: Analiza → Statystyka opisowa → Tabele krzyżowe). Test nie uruchomi się sam: w oknie Statistics trzeba zaznaczyć Chi-square, a dla siły związku – Phi and Cramer’s V. Test zgodności dla jednej zmiennej to inna procedura, z grupy testów nieparametrycznych.
Jak policzyć chi-kwadrat w SPSS, gdy mam tylko gotową tabelę liczebności?
Wpisz każdą komórkę jako osobny wiersz: kod kategorii pierwszej zmiennej, kod drugiej i liczbę osób. Potem Data → Weight Cases, Weight cases by i zmienna z liczbą osób. Crosstabs policzy wtedy test tak, jakby każda osoba była osobnym wierszem. Po analizie wyłącz ważenie, bo zapisuje się ono razem z plikiem.
Czy test dokładny Fishera dla tabeli 3 × 3 wymaga dodatkowego modułu SPSS?
Tak. Dla tabel 2 × 2 SPSS podaje test Fishera w zwykłym wydruku, ale dokładne p i metoda Monte Carlo dla większych tabel wymagają podkomendy METHOD, a według dokumentacji IBM ta działa tylko z opcją Exact Tests albo w SPSS Statistics Premium Edition. Bez modułu dostaniesz wyłącznie p asymptotyczne.
Którą resztę z tabeli Crosstabs podać w pracy?
Resztę skorygowaną standaryzowaną (Adjusted Residual), bo przy niezależności ma w przybliżeniu rozkład normalny standardowy i łatwo ją porównać z progiem 1.96. Przy wielu komórkach zaostrz próg poprawką Bonferroniego – w tabeli 3 × 3 to 2.77 – i napisz w pracy, jaki próg przyjąłeś.
Czy trzeba raportować wiersz Linear-by-Linear Association z wydruku SPSS?
Przy zmiennych nominalnych nie. Ten test traktuje kody kategorii jak liczby i sprawdza związek liniowy, więc ma sens tylko wtedy, gdy obie zmienne mają uporządkowane kategorie. W przykładzie dał p = .741 przy istotnym teście Pearsona, bo odpowiada na inne pytanie.
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →Masz tabele krzyżowe z SPSS i nie wiesz, co z nich przepisać?
Sprawdzimy układ danych, warunki testu i wybór między chi-kwadrat a testem dokładnym oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- IBM Corp. (b.d.-a). Crosstabs cell display. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=crosstabs-cell-display ● Otwarty dostęp
- IBM Corp. (b.d.-b). Crosstabs statistics. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=crosstabs-statistics ● Otwarty dostęp
- IBM Corp. (b.d.-c). Crosstabs. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-crosstabs ● Otwarty dostęp
- IBM Corp. (b.d.-d). CROSSTABS. IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-crosstabs ● Otwarty dostęp
- IBM Corp. (b.d.-e). Weight cases. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/base/idh_weig.html ● Otwarty dostęp
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- Mehta, C. R., & Patel, N. R. (1983). A network algorithm for performing Fisher’s exact test in r × c contingency tables. Journal of the American Statistical Association, 78(382), 427–434. https://doi.org/10.1080/01621459.1983.10477989
- Sharpe, D. (2015). Chi-square test is statistically significant: Now what? Practical Assessment, Research, and Evaluation, 20, Article 8. https://doi.org/10.7275/tbfa-x148 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{haberman1973analysis, author={Haberman, Shelby J.}, title={{The analysis of residuals in cross-classified tables}}, journal={Biometrics}, year={1973}, volume={29}, number={1}, pages={205--220}, doi={10.2307/2529686}}@misc{ibmndcrosstabscells, author={{IBM Corp.}}, title={{Crosstabs cell display}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=crosstabs-cell-display}}@misc{ibmndcrosstabs, author={{IBM Corp.}}, title={{Crosstabs statistics}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=crosstabs-statistics}}@misc{ibmndcrosstabs32, author={{IBM Corp.}}, title={{Crosstabs}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=features-crosstabs}}@misc{ibmndcrosstabssyntax32, author={{IBM Corp.}}, title={{CROSSTABS}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-crosstabs}}@misc{ibmndweightcases32, author={{IBM Corp.}}, title={{Weight cases}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/base/idh_weig.html}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{mehta1983network, author={Mehta, Cyrus R. and Patel, Nitin R.}, title={{A network algorithm for performing Fisher’s exact test in r × c contingency tables}}, journal={Journal of the American Statistical Association}, year={1983}, volume={78}, number={382}, pages={427--434}, doi={10.1080/01621459.1983.10477989}}@article{sharpe2015chisquare, author={Sharpe, Donald}, title={{Chi-square test is statistically significant: Now what?}}, journal={Practical Assessment, Research, and Evaluation}, year={2015}, volume={20}, eid={8}, doi={10.7275/tbfa-x148}}