Do czego służy jednoczynnikowa ANOVA w SPSS
Jednoczynnikowa analiza wariancji porównuje średnie zmiennej ilościowej w trzech lub więcej niezależnych grupach. Logikę testu F, założenia i wybór wielkości efektu omawia poradnik ANOVA krok po kroku, w którym całą analizę pokazano w R. Tutaj zajmujemy się tylko SPSS: przygotowaniem pliku, kolejnymi oknami procedury One-Way ANOVA, składnią i tym, co z wydruku przepisać do pracy.
Ścieżki menu i nazwy opcji sprawdziliśmy w oficjalnej dokumentacji IBM SPSS Statistics 31 (IBM Corp., b.d.-a, b.d.-b, b.d.-c, b.d.-d). Podajemy je po angielsku. W polskiej wersji interfejsu nazwy mogą brzmieć inaczej, ale układ okien jest ten sam. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS. Nie powtarzamy ich tutaj.
Przykład i pliki do pobrania
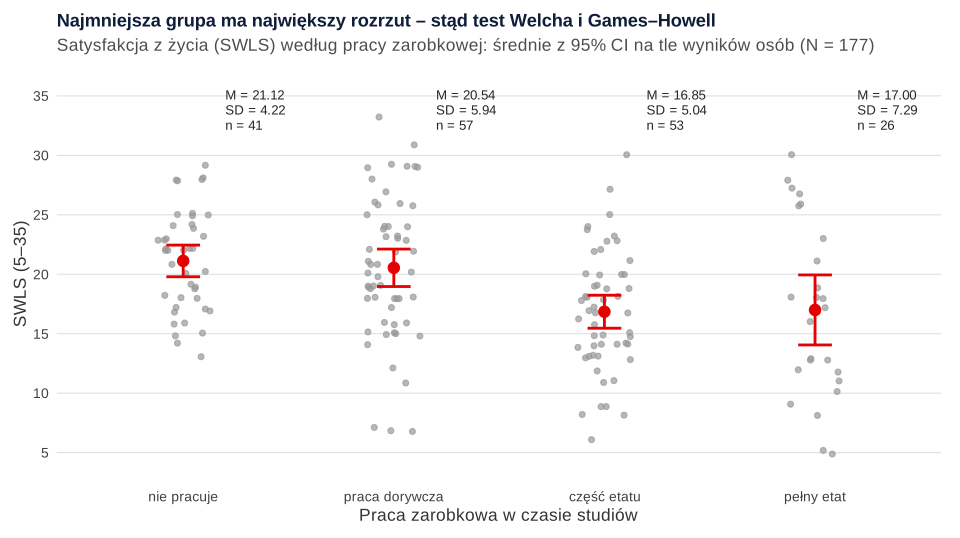
Wszystkie liczby pochodzą z jednego zbioru symulowanego. 180 osób studiujących wypełniło skalę satysfakcji z życia (SWLS, wynik 5–35) i odpowiedziało na pytanie o pracę zarobkową. Powstały cztery grupy: nie pracuje (n = 42), praca dorywcza (n = 58), część etatu (n = 54) i pełny etat (n = 26). Trzy osoby nie wypełniły skali i mają kod 99, więc do analizy weszło 177 osób. Grupy są nierówne, a najmniejsza z nich ma największy rozrzut wyników.
Pobierz plik .sav z etykietami zmiennych i wartości oraz zdefiniowanym brakiem 99. Ten sam zbiór masz też w pliku CSV. Format SPSS opisuje hasło plik .sav.
Przygotowanie danych
ANOVA w SPSS wymaga formatu długiego: jedna kolumna z wynikiem i jedna kolumna z kodem grupy. Nie twórz osobnych kolumn z wynikami dla każdej grupy. W widoku zmiennych (Variable View) sprawdź trzy rzeczy:
- Zmienna grupująca jest liczbowa, z kodami 1–4 i etykietami wartości (1 = nie pracuje itd.). Dokumentacja polecenia ONEWAY podaje, że każda różna wartość czynnika tworzy osobną grupę (IBM Corp., b.d.-d).
- Kody braków są zdefiniowane. Wartość 99 w kolumnie braków (Missing) sprawia, że SPSS ją pomija. Bez tego kod 99 zostałby policzony jako wynik i podniósłby średnią grupy.
- Zmienna zależna jest ilościowa. Wynik skali, np. suma pozycji SWLS, musi być już policzony (IBM Corp., b.d.-a).
Etykiety, poziom pomiaru, braki i liczenie wyniku skali krok po kroku pokazuje wpis przygotowanie danych w SPSS. Kodowanie ankiety z Google Forms opisuje wpis dane z Google Forms i LimeSurvey do SPSS i R.
ANOVA w SPSS krok po kroku: okna procedury
- Analyze → Compare Means → One-Way ANOVA. W oknie głównym przenieś
swlsna listę zmiennych zależnych, apracado pola czynnika. Dokumentacja dopuszcza kilka zmiennych zależnych, ale tylko jeden czynnik (IBM Corp., b.d.-a). - Options. Zaznacz Descriptive, Homogeneity of variance test, Brown-Forsythe, Welch i Means plot. W części Missing Values zostaw Exclude cases analysis by analysis (IBM Corp., b.d.-b).
- Post Hoc. W grupie Equal Variances Assumed zaznacz Tukey, a w grupie Equal Variances Not Assumed – Games-Howell. Poziom istotności zostaw na .05 (opcja Null Hypothesis test; IBM Corp., b.d.-c).
- Estimate effect size for overall tests. Pole w oknie głównym dodaje tabelę ANOVA Effect Sizes (IBM Corp., b.d.-a). Podkomendę wielkości efektu wprowadzono w wersji 27 (IBM Corp., b.d.-d), więc w starszych wersjach policz η² ręcznie (niżej).
- Paste zamiast OK. SPSS wklei składnię do okna edytora. Zapisz ją razem z danymi – analiza będzie powtarzalna.
Przycisk Contrasts służy do kontrastów zaplanowanych przed zebraniem danych, a Bootstrap – do przedziałów bootstrapowych. Gotową składnię znajdziesz w sekcji składnia SPSS i kod R.
Jak czytać wydruk: tabela po tabeli
Tabele niżej mają układ tabel wynikowych SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Pogrubiono liczby, które trafią do pracy.
Statystyki opisowe
| N | Mean | Std. Deviation | Std. Error | 95% Confidence Interval for Mean | Minimum | Maximum | ||
|---|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | |||||||
| nie pracuje | 41 | 21.122 | 4.220 | .659 | 19.790 | 22.454 | 13 | 29 |
| praca dorywcza | 57 | 20.544 | 5.937 | .786 | 18.968 | 22.119 | 7 | 33 |
| część etatu | 53 | 16.849 | 5.040 | .692 | 15.460 | 18.238 | 6 | 30 |
| pełny etat | 26 | 17.000 | 7.288 | 1.429 | 14.056 | 19.944 | 5 | 30 |
| Total | 177 | 19.051 | 5.841 | .439 | 18.184 | 19.917 | 5 | 33 |
Najpierw sprawdź N. Liczebności powinny się sumować do liczby osób z ważnym wynikiem: 41 + 57 + 53 + 26 = 177. W trzech pierwszych grupach odpadło po jednej osobie z kodem 99, w grupie z pełnym etatem braków nie było. Średnia lub maksimum powyżej 35 oznacza niezdefiniowane braki. Do pracy przepisz M i SD każdej grupy, nie błąd standardowy. Już tu widać problem: SD w grupie z pełnym etatem jest prawie dwa razy większe niż w grupie niepracującej.
Test Levene’a
| Wariant testu | Levene Statistic | df1 | df2 | Sig. |
|---|---|---|---|---|
| od średniej | 3.414 | 3 | 173 | .019 |
| od mediany | 3.421 | 3 | 173 | .019 |
Według składni ONEWAY SPSS liczy test Levene’a od średniej, od mediany i od średniej przyciętej (IBM Corp., b.d.-d). Pokazujemy dwa pierwsze warianty. Klasyczny test Levene’a to wiersz liczony od średniej: F(3, 173) = 3.41, p = .019. Wariancje różnią się więc istotnie, a grupy są nierówne. To dokładnie sytuacja, w której klasyczny test F może dawać zbyt wiele fałszywych alarmów (Delacre i in., 2019).
Nie traktuj jednak testu Levene’a jak bramki „tak/nie”: przy dużych próbach wykrywa drobne różnice, a przy małych przeocza duże. Delacre i in. (2019) zalecają test Welcha jako domyślny przy porównywaniu średnich.
Tabela ANOVA
| Sum of Squares | df | Mean Square | F | Sig. | |
|---|---|---|---|---|---|
| Between Groups | 669.219 | 3 | 223.073 | 7.233 | .000 |
| Within Groups | 5335.323 | 173 | 30.840 | ||
| Total | 6004.542 | 176 |
Klasyczny test F wskazuje różnice między grupami, F(3, 173) = 7.23, p < .001. Skoro jednak wariancje są nierówne, w pracy podasz wynik z następnej tabeli. Z tej tabeli weź sumy kwadratów, bo posłużą do obliczenia wielkości efektu. Wzór tabeli do pracy pokazuje hasło tabela ANOVA w APA.
Testy Welcha i Browna–Forsythe’a
| Statistic | df1 | df2 | Sig. | |
|---|---|---|---|---|
| Welch | 8.282 | 3 | 78.679 | .000 |
| Brown-Forsythe | 6.646 | 3 | 98.332 | .000 |
Dokumentacja IBM opisuje obie statystyki jako lepsze od F, gdy założenie równych wariancji nie jest spełnione (IBM Corp., b.d.-b). ANOVA Welcha pochodzi z pracy Welcha (1951), a zmodyfikowane F* – od Browna i Forsythe’a (1974). Welch daje tu F(3, 78.68) = 8.28, p < .001. Ułamkowe df2 to efekt korekty – przepisz je z dwoma miejscami po przecinku.
Nie myl tej tabeli z wariantem testu Levene’a od mediany. Ten wariant też bywa nazywany testem Browna–Forsythe’a, ale testuje wariancje, a nie średnie (zob. test Browna–Forsythe’a). Jeden test odporny, najlepiej Welcha, wybierz przed analizą.
Wielkość efektu: η² z tabeli lub ręcznie
W SPSS 27 i nowszym pole Estimate effect size for overall tests dodaje tabelę ANOVA Effect Sizes (IBM Corp., b.d.-a). Przepisz z niej miarę, którą zapowiadasz w metodzie, razem z przedziałem ufności, i nazwij ją w tekście tak jak w wydruku. Ręczne obliczenie zajmuje minutę i działa w każdej wersji:
- η² = suma kwadratów między grupami / suma kwadratów ogółem = 669.219 / 6004.542 = .11;
- ω² = (669.219 − 3 × 30.840) / (6004.542 + 30.840) = .10.
η² zawyża efekt w populacji, zwłaszcza w małych próbach. ω² jest mniej obciążona, ale rzadziej raportowana, m.in. z braku jasnych wskazówek, jak ją policzyć z wydruku SPSS (Kroes i Finley, 2025). W jednoczynnikowej ANOVA η² i η² cząstkowe są sobie równe. Rozróżnienie ma znaczenie dopiero przy kilku czynnikach.
Testy post hoc: Tukey a Games–Howell
| Test | (I) praca | (J) praca | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval | |
|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||||
| Tukey HSD | nie pracuje | praca dorywcza | .578 | 1.137 | .957 | −2.372 | 3.528 |
| Tukey HSD | nie pracuje | część etatu | 4.273* | 1.155 | .002 | 1.277 | 7.269 |
| Tukey HSD | nie pracuje | pełny etat | 4.122* | 1.392 | .018 | .510 | 7.734 |
| Tukey HSD | praca dorywcza | część etatu | 3.695* | 1.060 | .003 | .946 | 6.444 |
| Tukey HSD | praca dorywcza | pełny etat | 3.544* | 1.314 | .038 | .135 | 6.953 |
| Tukey HSD | pełny etat | część etatu | .151 | 1.330 | 1.000 | −3.300 | 3.600 |
| Games-Howell | nie pracuje | praca dorywcza | .578 | 1.026 | .943 | −2.105 | 3.261 |
| Games-Howell | nie pracuje | część etatu | 4.273* | .956 | .000 | 1.772 | 6.774 |
| Games-Howell | nie pracuje | pełny etat | 4.122 | 1.574 | .059 | −.119 | 8.362 |
| Games-Howell | praca dorywcza | część etatu | 3.695* | 1.048 | .003 | .961 | 6.429 |
| Games-Howell | praca dorywcza | pełny etat | 3.544 | 1.631 | .148 | −.826 | 7.913 |
| Games-Howell | pełny etat | część etatu | .151 | 1.588 | 1.000 | −4.120 | 4.422 |
SPSS wypisuje każdą parę dwa razy, w obu kierunkach, i oznacza gwiazdką różnice istotne na poziomie .05 (IBM Corp., b.d.-d). W odtworzeniu zostawiliśmy po jednym wierszu dla pary. Porównaj oba testy dla grupy z pełnym etatem. Test Tukeya zakłada wspólną wariancję i jeden błąd standardowy dla wszystkich grup, więc „pożycza” małą zmienność od większych grup. Uznaje wtedy różnice z grupą pełnoetatową za istotne (p = .018 i .038). Test Gamesa–Howella liczy osobny błąd standardowy i stopnie swobody dla każdej pary. Przy dużym rozrzucie w małej grupie te dwie różnice przestają być istotne (p = .059 i .148).
Który wynik jest właściwy? Przy nierównych wariancjach i liczebnościach – Games–Howell. Games i Howell (1976) pokazali w symulacjach, że przy nierównych n zadowalającą kontrolę błędu I rodzaju dawała tylko statystyka Behrensa–Fishera, czyli porównanie z osobnymi wariancjami grup. To podejście wykorzystuje test Gamesa–Howella. Sauder i DeMars (2019) sprawdzili 18 procedur dostępnych w SPSS. Błąd I rodzaju poprawnie kontrolowały tylko cztery testy zaprojektowane na naruszone założenia, a Games–Howell miał wśród nich nieco największą moc. Pełne porównanie testów i tabelę „sytuacja → test” znajdziesz we wpisie testy post hoc – który wybrać.
Tabela Homogeneous Subsets po teście Tukeya (IBM Corp., b.d.-d) nie jest w pracy potrzebna.
Wykres średnich
Opcja Means plot rysuje średnie grup (IBM Corp., b.d.-b). Nie pokazuje rozrzutu ani niepewności, więc do pracy lepiej się nie nadaje. Czytelniejszy jest wykres średnich z 95% przedziałami ufności na tle wyników osób, jak rysunek 1. W R wystarczy pakiet ggplot2 i funkcja geom_errorbar() z przedziałami policzonymi w przepisie 2 niżej.
Zapis wyników w stylu APA
Opisz test, który zaplanowałeś. Podaj średnie i odchylenia, wynik testu Welcha z ułamkowymi df, wielkość efektu i porównania par z przedziałami ufności. W metodzie dopisz, że z powodu nierównych wariancji i liczebności użyto testu Welcha i Gamesa–Howella. Wzór do dostosowania:
Ostatnie zdanie nie znaczy, że grupa pełnoetatowa „jest taka sama” jak niepracująca. Różnica średnich wynosi 4.12 punktu, czyli tyle, ile przy części etatu, ale przedział ufności jest szeroki: od −0.12 do 8.36. Grupa jest po prostu za mała, żeby to rozstrzygnąć. Jak opisać taki wynik, pokazuje wpis jak opisać wyniki w stylu APA. Zdania do innych testów przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w oknie edytora składni SPSS (tym samym, które otwiera przycisk Paste). Napisaliśmy ją według opisu polecenia ONEWAY w Command Syntax Reference (IBM Corp., b.d.-d), ale nie uruchamialiśmy jej w SPSS. Podkomendy /ES i /CRITERIA działają od wersji 27, więc w starszej usuń te dwa wiersze. Przepis 2 w R tworzy pliki do pobrania i liczy wszystkie liczby z tabel tymi samymi metodami co SPSS: test Levene’a od średniej (car::leveneTest(center = mean)), test Welcha, F* Browna–Forsythe’a, test Tukeya w wariancie dla nierównych n i test Gamesa–Howella.
1. Składnia SPSS: ONEWAY z Welchem, Tukeyem i Games–Howellem
SPSS
* Jednoczynnikowa ANOVA: SWLS według pracy zarobkowej.
* Składnia zgodna z opisem ONEWAY w Command Syntax Reference; nie była uruchamiana w SPSS.
ONEWAY swls BY praca
  /ES=OVERALL
  /STATISTICS=DESCRIPTIVES HOMOGENEITY BROWNFORSYTHE WELCH
  /PLOT MEANS
  /MISSING=ANALYSIS
  /CRITERIA=CILEVEL(0.95)
  /POSTHOC=TUKEY GH ALPHA(0.05).
2. Te same liczby w R i pliki .sav oraz CSV
R
# B265 – jednoczynnikowa ANOVA z testami post hoc: liczby do tabel w układzie SPSS
# Dane symulowane, set.seed(2651): satysfakcja z życia (SWLS, 5–35) a praca zarobkowa studentów (4 grupy).
# Metody jak w procedurze One-Way ANOVA w SPSS: test Levene'a od średniej (i od mediany),
# klasyczne F, F Welcha, F* Browna–Forsythe'a, Tukey HSD (Tukey–Kramer) i Games–Howell.
suppressPackageStartupMessages({ library(haven); library(car) })
set.seed(2651)
n_gr <- c(42, 58, 54, 26)
etyk <- c("nie pracuje" = 1, "praca dorywcza" = 2, "część etatu" = 3, "pełny etat" = 4)
praca <- rep(1:4, n_gr)
swls <- round(pmin(35, pmax(5, rnorm(sum(n_gr), c(20.5, 19.5, 17.8, 16.0)[praca], c(4.6, 5.4, 5.8, 8.2)[praca]))))
swls[c(17, 88, 131)] <- 99                       # 99 = brak odpowiedzi (brak zdefiniowany przez użytkownika)
dane <- data.frame(id = seq_along(praca), praca, swls)

# Krok 1. Plik .sav z etykietami zmiennych i wartości oraz brakiem 99 – i ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$praca <- labelled(sav$praca, labels = etyk, label = "Praca zarobkowa w czasie studiów")
sav$swls <- labelled_spss(sav$swls, labels = c("brak odpowiedzi" = 99), na_values = 99,
                          label = "Satysfakcja z życia – SWLS (5–35)")
write_sav(sav, "../anova-spss-dane-przyklad.sav")
write.csv(dane, "../anova-spss-dane-przyklad.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Krok 2. Analiza bez braków (SPSS pomija wartość 99, bo jest zdefiniowana jako brak)
d <- subset(dane, swls != 99)
d$praca <- factor(d$praca, levels = 1:4, labels = names(etyk))
k <- nlevels(d$praca); N <- nrow(d)
c(N = N, braki = sum(dane$swls == 99))

# Krok 3. Statystyki opisowe (opcja Descriptive): N, M, SD, SE, 95% CI średniej, min., maks.
opis <- do.call(rbind, lapply(split(d$swls, d$praca), function(x) {
  n <- length(x); m <- mean(x); s <- sd(x); se <- s / sqrt(n); t <- qt(.975, n - 1)
  c(N = n, Mean = m, SD = s, SE = se, Lower = m - t * se, Upper = m + t * se, Min = min(x), Max = max(x)) }))
round(rbind(opis, Total = { x <- d$swls; n <- length(x); se <- sd(x) / sqrt(n)
  c(n, mean(x), sd(x), se, mean(x) - qt(.975, n - 1) * se, mean(x) + qt(.975, n - 1) * se, min(x), max(x)) }), 3)

# Krok 4. Test Levene'a (opcja Homogeneity of variance test): wiersz „od średniej” i „od mediany”
leveneTest(swls ~ praca, data = d, center = mean)
leveneTest(swls ~ praca, data = d, center = median)

# Krok 5. Tabela ANOVA (klasyczne F)
m_aov <- aov(swls ~ praca, data = d)
tab <- summary(m_aov)[[1]]; tab
SSB <- tab$`Sum Sq`[1]; SSW <- tab$`Sum Sq`[2]; SST <- SSB + SSW; MSW <- tab$`Mean Sq`[2]

# Krok 6. Testy odporne (opcje Welch i Brown-Forsythe)
oneway.test(swls ~ praca, data = d, var.equal = FALSE)            # F Welcha
ni <- opis[, "N"]; vi <- opis[, "SD"]^2
mian <- sum((1 - ni / N) * vi)
F_bf <- SSB / mian                                                  # F* Browna–Forsythe'a (1974)
ci <- (1 - ni / N) * vi / mian
df2_bf <- 1 / sum(ci^2 / (ni - 1))
c(F = F_bf, df1 = k - 1, df2 = df2_bf, p = pf(F_bf, k - 1, df2_bf, lower.tail = FALSE))

# Krok 7. Wielkość efektu liczona z tabeli ANOVA: eta², epsilon², omega²
round(c(eta2 = SSB / SST, epsilon2 = (SSB - (k - 1) * MSW) / SST,
        omega2 = (SSB - (k - 1) * MSW) / (SST + MSW)), 3)

# Krok 8. Tukey HSD (przy nierównych n to wariant Tukeya–Kramera, jak w SPSS)
TukeyHSD(m_aov, conf.level = .95)

# Krok 9. Games–Howell: osobny błąd standardowy i df Welcha dla każdej pary
gh <- function(i, j) {
  mi <- opis[i, "Mean"]; mj <- opis[j, "Mean"]; si <- vi[i] / ni[i]; sj <- vi[j] / ni[j]
  se <- sqrt(si + sj); df <- (si + sj)^2 / (si^2 / (ni[i] - 1) + sj^2 / (ni[j] - 1))
  q <- abs(mi - mj) / se * sqrt(2); kr <- qtukey(.95, k, df) / sqrt(2)
  data.frame(I = rownames(opis)[i], J = rownames(opis)[j], roznica = mi - mj, SE = se, df = df,
             p = ptukey(q, k, df, lower.tail = FALSE), dolna = mi - mj - kr * se, gorna = mi - mj + kr * se)
}
pary <- t(combn(k, 2))
wyn_gh <- do.call(rbind, lapply(seq_len(nrow(pary)), function(r) gh(pary[r, 1], pary[r, 2])))
print(wyn_gh, digits = 4, row.names = FALSE)
# kontrola: ten sam wynik daje rstatix::games_howell_test()
rstatix::games_howell_test(d, swls ~ praca)[, c("group1", "group2", "estimate", "p.adj")]
Wynik:
    N braki
  177     3
                 N   Mean    SD    SE  Lower  Upper Min Max
nie pracuje     41 21.122 4.220 0.659 19.790 22.454  13  29
praca dorywcza  57 20.544 5.937 0.786 18.968 22.119   7  33
część etatu     53 16.849 5.040 0.692 15.460 18.238   6  30
pełny etat      26 17.000 7.288 1.429 14.056 19.944   5  30
Total          177 19.051 5.841 0.439 18.184 19.917   5  33
Levene's Test for Homogeneity of Variance (center = mean)
       Df F value  Pr(>F)
group   3  3.4141 0.01874 *
      173
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Levene's Test for Homogeneity of Variance (center = median)
       Df F value  Pr(>F)
group   3   3.421 0.01858 *
      173
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
             Df Sum Sq Mean Sq F value    Pr(>F)
praca         3  669.2  223.07  7.2332 0.0001336 ***
Residuals   173 5335.3   30.84
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	One-way analysis of means (not assuming equal variances)

data:  swls and praca
F = 8.282, num df = 3.000, denom df = 78.679, p-value = 7.438e-05

           F          df1          df2            p
6.645961e+00 3.000000e+00 9.833183e+01 3.916141e-04
    eta2 epsilon2   omega2
   0.111    0.096    0.096
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = swls ~ praca, data = d)

$praca
                                 diff       lwr        upr     p adj
praca dorywcza-nie pracuje -0.5780916 -3.528218  2.3720344 0.9570152
część etatu-nie pracuje    -4.2728946 -7.269234 -1.2765556 0.0016386
pełny etat-nie pracuje     -4.1219512 -7.733685 -0.5102178 0.0182236
część etatu-praca dorywcza -3.6948030 -6.443823 -0.9457833 0.0034414
pełny etat-praca dorywcza  -3.5438596 -6.953212 -0.1345078 0.0382194
pełny etat-część etatu      0.1509434 -3.298475  3.6003614 0.9994749

              I              J roznica     SE     df       p   dolna gorna
    nie pracuje praca dorywcza  0.5781 1.0261  95.99 0.94264 -2.1047 3.261
    nie pracuje    część etatu  4.2729 0.9558  91.38 0.00013  1.7715 6.774
    nie pracuje     pełny etat  4.1220 1.5740  35.75 0.05931 -0.1186 8.362
 praca dorywcza    część etatu  3.6948 1.0477 107.14 0.00343  0.9605 6.429
 praca dorywcza     pełny etat  3.5439 1.6314  40.76 0.14824 -0.8256 7.913
    część etatu     pełny etat -0.1509 1.5882  37.12 0.99969 -4.4221 4.120
# A tibble: 6 × 4
  group1         group2         estimate   p.adj
  <chr>          <chr>             <dbl>   <dbl>
1 nie pracuje    praca dorywcza   -0.578 0.943
2 nie pracuje    część etatu      -4.27  0.00013
3 nie pracuje    pełny etat       -4.12  0.059
4 praca dorywcza część etatu      -3.69  0.003
5 praca dorywcza pełny etat       -3.54  0.148
6 część etatu    pełny etat        0.151 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek wykonano w pakiecie ggplot2. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.3) [Computer software]. https://doi.org/10.32614/CRAN.package.rstatix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Kod braku liczony jako wynik. Kod 99 bez definicji w kolumnie Missing podnosi średnią grupy. Zawsze sprawdź N i maksimum w statystykach opisowych.
- Dane w formacie szerokim – osobna kolumna wyników dla każdej grupy.
- Przepisanie wyniku testu Levene’a jako wyniku ANOVA. F(3, 173) = 3.41 dotyczy wariancji, a nie średnich.
- Tukey przy nierównych wariancjach. W przykładzie dałby dwie „istotne” różnice, których Games–Howell nie potwierdza.
- Wybór testu po obejrzeniu wyników. Zaznaczenie wszystkich testów z okna Post Hoc i wybór tego z najmniejszym p zawyża ryzyko fałszywego odkrycia (zob. problem wielokrotnych porównań).
- „Sig. = .000” przepisane dosłownie. W pracy pisz p < .001.
- Brak wielkości efektu albo η² cząstkowe opisane jako η² bez wyjaśnienia, skąd pochodzi.
Gdy grup jest tylko dwie, zamiast ANOVA użyj testu t; krok po kroku pokazuje go wpis test t w SPSS. Gdy wynik jest porządkowy albo skrajnie skośny, rozważ test Kruskala–Wallisa. Normalność sprawdzaj na resztach, a nie na surowych wynikach w grupach (normalność reszt czy zmiennych). Jeśli nie wiesz, czy ANOVA w ogóle pasuje do Twojej hipotezy, skorzystaj z kreatora doboru testu. Pozostałe wpisy z serii o SPSS to alfa Cronbacha w SPSS oraz korelacja i regresja w SPSS.
Najczęstsze pytania
Gdzie w SPSS znajdę jednoczynnikową ANOVA?
W menu Analyze → Compare Means → One-Way ANOVA (IBM Corp., b.d.-a). W oknie głównym podajesz zmienną zależną i jedną zmienną grupującą, a przyciski Options i Post Hoc otwierają test Levene’a, test Welcha i porównania par. W polskiej wersji interfejsu nazwy mogą brzmieć inaczej, ale kolejność okien jest ta sama.
Który wynik z SPSS przepisać, gdy test Levene’a wyszedł istotny?
Zamiast wiersza Between Groups z tabeli ANOVA przepisz wiersz Welch z tabeli testów odpornych, z ułamkowymi stopniami swobody, np. F(3, 78.68) = 8.28, p < .001. Porównania par podaj według testu Gamesa–Howella. Najlepiej zapowiedz test Welcha w metodzie z góry, niezależnie od wyniku Levene’a (Delacre i in., 2019).
Dlaczego w SPSS Tukey pokazuje istotną różnicę, a Games–Howell nie?
Test Tukeya używa jednej, wspólnej wariancji wszystkich grup, więc mała grupa z dużym rozrzutem dostaje zbyt mały błąd standardowy. Games–Howell liczy błąd i stopnie swobody osobno dla każdej pary. Przy nierównych wariancjach i liczebnościach wiarygodniejszy jest Games–Howell (Sauder i DeMars, 2019).
Jak policzyć eta kwadrat do jednoczynnikowej ANOVA z wydruku SPSS?
Podziel sumę kwadratów z wiersza Between Groups przez sumę z wiersza Total, np. 669.219 / 6004.542 = .11. Mniej obciążoną omegę kwadrat policzysz jako (SS między − (k − 1) × MS wewnątrz) / (SS ogółem + MS wewnątrz). W SPSS 27 i nowszym pole Estimate effect size for overall tests dodaje tabelę ANOVA Effect Sizes.
Czy do ANOVA w SPSS grupy muszą być równoliczne?
Nie, procedura działa przy dowolnych liczebnościach. Nierówne grupy w połączeniu z nierównymi wariancjami sprawiają jednak, że klasyczne F i test Tukeya przestają poprawnie kontrolować błąd I rodzaju. Wtedy wybierz test Welcha i porównania Gamesa–Howella.
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikTesty post hoc – który wybrać?
Tabela sytuacja → test, Tukey, Games–Howell, Dunnett, Scheffé i Dunn na jednym przykładzie oraz symulacja błędu I rodzaju i mocy w R.
Czytaj →Masz wydruk ANOVA z SPSS i nie wiesz, który wiersz przepisać?
Sprawdzimy przygotowanie danych, wybór testu i porównań par oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, M. B., & Forsythe, A. B. (1974). The small sample behavior of some statistics which test the equality of several means. Technometrics, 16(1), 129–132. https://doi.org/10.1080/00401706.1974.10489158
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- IBM Corp. (b.d.-a). One-Way ANOVA. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=features-one-way-anova ● Otwarty dostęp
- IBM Corp. (b.d.-b). One-Way ANOVA Options. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=anova-one-way-options ● Otwarty dostęp
- IBM Corp. (b.d.-c). One-Way ANOVA Post Hoc Tests. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=anova-one-way-post-hoc-tests ● Otwarty dostęp
- IBM Corp. (b.d.-d). ONEWAY. IBM SPSS Statistics 31.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=reference-oneway ● Otwarty dostęp
- Kroes, A. D. A., & Finley, J. R. (2025). Demystifying omega squared: Practical guidance for effect size in common analysis of variance designs. Psychological Methods, 30(4), 866–887. https://doi.org/10.1037/met0000581
- Sauder, D. C., & DeMars, C. E. (2019). An updated recommendation for multiple comparisons. Advances in Methods and Practices in Psychological Science, 2(1), 26–44. https://doi.org/10.1177/2515245918808784 ● Otwarty dostęp
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3–4), 330–336. https://doi.org/10.1093/biomet/38.3-4.330
Cytowania BibTeX
@article{brown1974small, author={Brown, Morton B. and Forsythe, Alan B.}, title={{The small sample behavior of some statistics which test the equality of several means}}, journal={Technometrics}, year={1974}, volume={16}, number={1}, pages={129--132}, doi={10.1080/00401706.1974.10489158}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{games1976pairwise, author={Games, Paul A. and Howell, John F.}, title={{Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={2}, pages={113--125}, doi={10.3102/10769986001002113}}@misc{ibmndonewayanova, author={{IBM Corp.}}, title={{One-Way ANOVA}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=features-one-way-anova}}@misc{ibmndonewayoptions, author={{IBM Corp.}}, title={{One-Way ANOVA Options}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=anova-one-way-options}}@misc{ibmndonewayposthoc, author={{IBM Corp.}}, title={{One-Way ANOVA Post Hoc Tests}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=anova-one-way-post-hoc-tests}}@misc{ibmndonewaysyntax, author={{IBM Corp.}}, title={{ONEWAY}}, howpublished={IBM SPSS Statistics 31.0.0 Command Syntax Reference}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=reference-oneway}}@article{kroes2025demystifying, author={Kroes, Antoinette D. A. and Finley, Jason R.}, title={{Demystifying omega squared: Practical guidance for effect size in common analysis of variance designs}}, journal={Psychological Methods}, year={2025}, volume={30}, number={4}, pages={866--887}, doi={10.1037/met0000581}}@article{sauder2019updated, author={Sauder, Derek C. and DeMars, Christine E.}, title={{An updated recommendation for multiple comparisons}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={26--44}, doi={10.1177/2515245918808784}}@article{welch1951comparison, author={Welch, B. L.}, title={{On the comparison of several mean values: An alternative approach}}, journal={Biometrika}, year={1951}, volume={38}, number={3–4}, pages={330--336}, doi={10.1093/biomet/38.3-4.330}}