Co mierzy SWLS
Skala satysfakcji z życia (Satisfaction With Life Scale, SWLS) to krótki kwestionariusz samoopisowy, który mierzy globalne zadowolenie z życia. Opracowali ją Diener i in. (1985) jako wąsko ukierunkowaną miarę ogólnej oceny własnego życia. Skala celowo nie obejmuje pokrewnych zjawisk, takich jak afekt pozytywny czy samotność. Badany nie ocenia osobno zdrowia, pracy czy finansów, tylko wydaje jeden ogólny sąd o swoim życiu według własnych kryteriów. W modelu dobrostanu subiektywnego SWLS odpowiada więc komponentowi poznawczemu, czyli sądowi o życiu, a nie emocjom (Pavot i in., 1991).
W pracach z nauk o zdrowiu SWLS pojawia się często jako miara subiektywnej jakości życia pacjentów, opiekunów i personelu. Pavot i Diener (2008) w drugim przeglądzie skali piszą, że jej wyniki korelują z miarami zdrowia psychicznego i przewidują późniejsze zachowania. Dodają, że w psychologii zdrowia skalę stosuje się do oceny subiektywnej jakości życia osób z poważnymi problemami zdrowotnymi. Wcześniejszy, obszerny przegląd właściwości skali opublikowali Pavot i Diener (1993).
Skala jest chroniona prawem autorskim, ale według oficjalnej strony Eda Dienera badacze mogą jej używać bez zgody i bez opłat, pod warunkiem podania autorów i wyłącznie do celów niekomercyjnych (Diener, b.d.). Strona udostępnia też tłumaczenia. Jeśli korzystasz z polskiej wersji, ustal, skąd pochodzi i czy ma opublikowaną walidację. Polskie adaptacje narzędzi bywają też dystrybuowane przez wydawców testów, więc sprawdź warunki użycia wersji, którą masz. Własności polskiej wersji opisuj wyłącznie na podstawie jej publikacji walidacyjnej. Wzór takiego opisu znajdziesz w poradniku opis narzędzia badawczego w pracy.
Jak policzyć wynik SWLS
SWLS ma pięć pozycji (Diener, b.d.). Każda jest stwierdzeniem o własnym życiu, a badany zaznacza stopień zgody na skali od 1 (zdecydowanie się nie zgadzam) do 7 (zdecydowanie się zgadzam) (Clench-Aas i in., 2011). Wszystkie pozycje są sformułowane w tym samym kierunku, więc SWLS nie ma pozycji odwróconych. Wynik to suma odpowiedzi w zakresie 5–35, a wyższy wynik oznacza większe zadowolenie z życia. Treść pozycji jest w oryginalnym formularzu. Do pracy jej nie przepisuj, wystarczy opis tematów: trzy pierwsze pozycje dotyczą oceny obecnego życia, a dwie ostatnie – oceny dotychczasowego życia i tego, co udało się w nim osiągnąć (Clench-Aas i in., 2011).
| Cecha | SWLS |
|---|---|
| Co mierzy | globalne zadowolenie z życia (poznawczy komponent dobrostanu) |
| Liczba pozycji | 5, jeden wynik ogólny |
| Skala odpowiedzi | 1–7, od braku zgody do pełnej zgody |
| Pozycje odwrócone | brak |
| Wynik | suma 5–35 (albo średnia 1–7) |
| Teoretyczny środek skali | 20 punktów (odpowiedź 4 we wszystkich pozycjach) |
| Oryginał | Diener i in. (1985) |
Liczenie wyniku sprowadza się do czterech kroków:
- Sprawdź kodowanie według klucza odpowiedzi: 1 to najsilniejszy brak zgody, 7 – najsilniejsza zgoda. Jeśli formularz zapisał odpowiedzi jako 0–6, dodaj 1 do każdej.
- Wyszukaj wartości niemożliwe. Wszystko poza 1–7 to błąd. Zero nie oznacza „brak odpowiedzi”, chyba że tak opisano je w książce kodowej – wtedy zamień je na brak.
- Zastosuj regułę dla braków. Przy pięciu pozycjach jeden brak to aż 20% informacji. Często stosowana umowa: przy jednym braku liczysz wynik proporcjonalnie (średnia z czterech odpowiedzi × 5), przy dwóch i więcej osoba nie dostaje wyniku. To decyzja badacza, a nie zalecenie autorów, więc opisz ją w pracy. Gdy braków jest dużo, przeczytaj o mechanizmach braków danych.
- Zsumuj odpowiedzi i sprawdź, czy wszystkie wyniki mieszczą się w zakresie 5–35.
Sumę możesz zamienić na średnią z pozycji (1–7). Obie formy niosą tę samą informację, ale suma ułatwia porównanie z publikacjami, które zwykle podają wynik 5–35. Kiedy która forma jest wygodniejsza, wyjaśniamy w haśle wynik skali: średnia czy suma. Pełną procedurę liczenia wyniku kwestionariusza, także w Excelu i SPSS, opisuje poradnik jak policzyć wynik kwestionariusza krok po kroku.
Jak zinterpretować wynik
SWLS nie ma progów diagnostycznych. Niskie zadowolenie z życia nie jest zaburzeniem, więc nie ma tu odpowiednika punktu odcięcia znanego z narzędzi przesiewowych, takich jak GAD-7 i PHQ-9. Wynik możesz interpretować na trzy sposoby.
- Względem środka skali. Wynik 20 odpowiada odpowiedzi 4 we wszystkich pozycjach, czyli środkowi skali odpowiedzi. Wyniki powyżej 20 oznaczają przewagę zgody ze stwierdzeniami o zadowoleniu, wyniki poniżej – przewagę braku zgody. To interpretacja treściowa, a nie norma.
- Według opisowych przedziałów autora. Na oficjalnej stronie skali (Diener, b.d.) jest dokument „Understanding Scores on the Satisfaction with Life Scale” (Diener, 2006), który dzieli sumę 5–35 na sześć przedziałów (tabela niżej). Każdy przedział ma krótki opis słowny. Według Dienera (2006) przeciętne zadowolenie z życia w krajach rozwiniętych gospodarczo mieści się w przedziale 20–24, a niski wynik po niedawnym trudnym zdarzeniu zwykle z czasem rośnie. Dokument nie podaje danych, z których wyprowadzono granice, więc traktuj je jako język opisu, a nie normy ani progi kliniczne.
- Względem innych badań. Średnią z Twojej próby możesz zestawić z wynikami opublikowanych badań w podobnych grupach. Przy takim porównaniu potrzebna jest ostrożność, bo zadowolenie z życia zależy od kraju, wieku i sytuacji życiowej. W dużej norweskiej próbie skala była niezmiennicza względem płci, ale nie w pełni między grupami wieku, więc porównania grup wiekowych wymagały ostrożności (Clench-Aas i in., 2011).
| Suma (5–35) | Średnia z pozycji (1–7) | Opis według Dienera (2006) |
|---|---|---|
| 30–35 | 6–7 | bardzo wysoki wynik, wysokie zadowolenie z życia |
| 25–29 | 5–6 | wysoki wynik |
| 20–24 | 4–5 | wynik przeciętny |
| 15–19 | 3–4 | nieco poniżej przeciętnej |
| 10–14 | 2–3 | niezadowolenie z życia |
| 5–9 | 1–2 | skrajne niezadowolenie z życia |
Granice dla średniej z pozycji też pochodzą z dokumentu, ale zachodzą na siebie (np. średnia 5.0 pasuje do dwóch wierszy). Jeśli liczysz średnią albo wynik proporcjonalny przy brakach, przelicz go na sumę (średnia × 5), zaokrąglij do całości i dopiero wtedy przypisz przedział. Tę zasadę opisz w pracy razem z cytowaniem Dienera (2006).
W pracy nie dziel próby na „niski, przeciętny i wysoki” poziom za pomocą tercyli albo M ± 1 SD, jeśli nie masz ku temu powodu. Taki podział zależy od próby, a wnioski wyciągnięte na jego podstawie tracą informację. Zalety i wady każdej metody wyznaczania poziomów omawiamy w poradniku niski, przeciętny, wysoki wynik. Polskich norm na tej stronie nie podajemy: jeśli ich potrzebujesz, szukaj ich w podręczniku polskiej adaptacji, a o samych normach przeczytasz w haśle normy testowe.
Przykład: zadowolenie z życia personelu pielęgniarskiego
Wyobraź sobie pracę magisterską z pielęgniarstwa o dobrostanie personelu. W anonimowej ankiecie SWLS wypełniło 286 pielęgniarek i pielęgniarzy z jednego szpitala. Dane są symulowane, ale realistyczne. Możesz je pobrać jako plik CSV (kolumny swls1–swls5, kodowanie 1–7) i powtórzyć obliczenia.
Kontrola wartości wykazała jedną odpowiedź zakodowaną jako 0. Takiej wartości nie ma na skali, więc została zamieniona na brak. Ostatecznie 9 osób miało jeden brak, a 2 osoby po dwa. Te dwie osoby nie dostały wyniku, a pozostałym wynik policzono proporcjonalnie. Wynik ma 284 osoby.
| Miara | Suma (5–35) | Średnia z pozycji (1–7) |
|---|---|---|
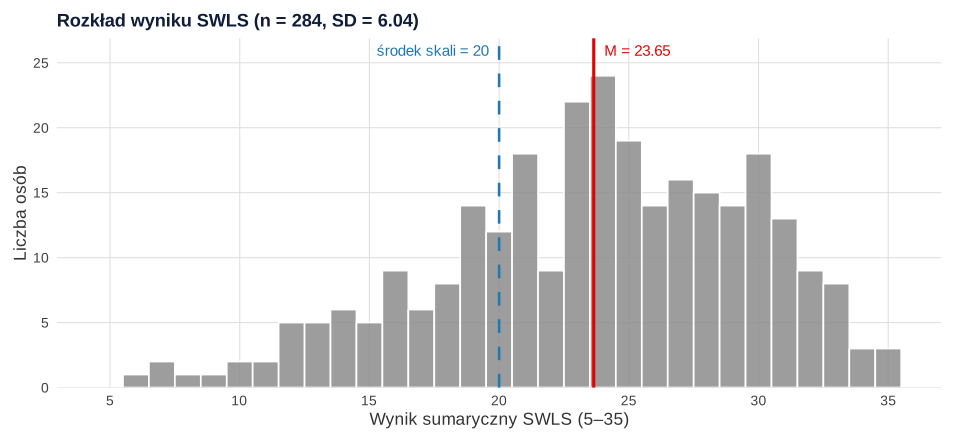
| M [95% CI] | 23.65 [22.94, 24.35] | 4.73 |
| SD | 6.04 | 1.21 |
| Me [Q1, Q3] | 24 [20, 28] | – |
| Zakres w próbie | 6–35 | – |
| Skośność | −0.47 | – |
Rozkład jest lewostronnie skośny (rysunek 1). Większość osób ma wyniki powyżej środka skali, ale nie brakuje też wyników bardzo niskich. Maksymalny wynik 35 uzyskały 3 osoby, a minimalnego 5 nie uzyskał nikt, więc efekt sufitu jest tu niewielki. Wynik powyżej 20 miało 205 osób (72.2%), dokładnie 20 – 12 osób (4.2%), a poniżej 20 – 67 osób (23.6%). Średnia była wyższa od środka skali, t(283) = 10.19, p < .001, d = 0.60 (zob. test t dla jednej próby). Taki test ma sens tylko wtedy, gdy pytanie badawcze naprawdę dotyczy przewagi zgody nad brakiem zgody. Średnia 23.65 mieści się w przedziale 20–24, który Diener (2006) opisuje jako wynik przeciętny.
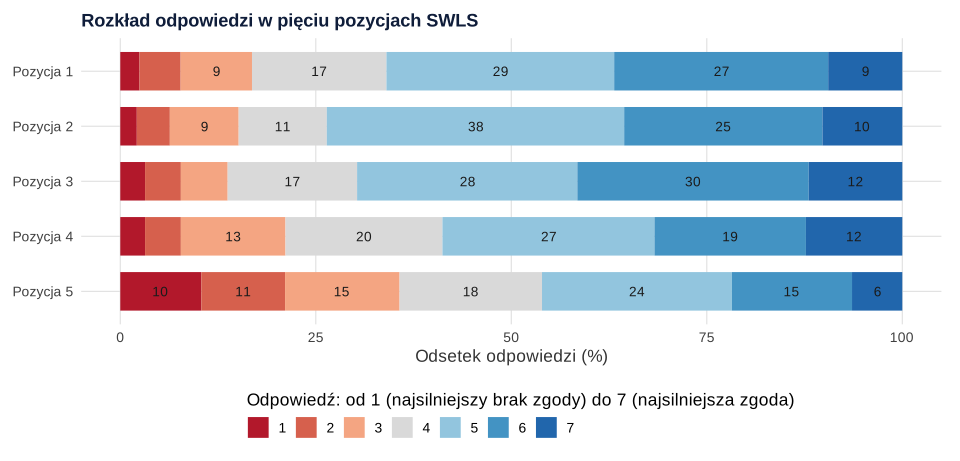
Warto też obejrzeć pozycje osobno (rysunek 2). Średnie pozycji 1–4 wynoszą od 4.71 do 4.99, a pozycja 5 ma wyraźnie niższą średnią: 4.07. Pozycja 5 dotyczy tego, czy badany zmieniłby coś w swoim dotychczasowym życiu, a takie stwierdzenie łatwiej odrzucić niż ogólną ocenę zadowolenia. Podobny wzór, z najniższą średnią w ostatniej pozycji, opisali Clench-Aas i in. (2011) w próbie norweskiej.
Rzetelność: alfa i omega
Diener i in. (1985) opisali wysoką spójność wewnętrzną i stabilność wyników w czasie, a w dużej próbie norweskiej α wyniosła .91 (Clench-Aas i in., 2011). We własnej próbie alfa Cronbacha wyniosła .87, 95% CI [.84, .89]. Korelacje pozycja–reszta mieściły się w przedziale .63–.76, a usunięcie którejkolwiek pozycji obniżało α (do wartości .82–.85). Żadnej pozycji nie warto więc usuwać, zresztą przy skali standaryzowanej i tak byś tego nie robił(a).
Alfa zakłada, że wszystkie pozycje mają takie same ładunki. W SWLS ładunek pozycji 5 bywa słabszy niż pozostałych (Clench-Aas i in., 2011), a w naszym przykładzie najniższe ładunki miały pozycje 4 i 5. Lepszym wskaźnikiem jest wtedy omega McDonalda (McNeish, 2018). Z modelu jednoczynnikowego omega wyniosła .87, a z modelu z korelacją reszt pozycji 4 i 5 – .84. Spadek wynika z tego, że część wspólnej wariancji tych dwóch pozycji nie pochodzi z czynnika ogólnego. Jak opisać rzetelność w pracy, pokazuje wzór raportowania alfy Cronbacha.
Jednoczynnikowa CFA: krótko
Jeśli chcesz sprawdzić, czy w Twojej próbie SWLS mierzy jeden czynnik, wykonaj konfirmacyjną analizę czynnikową w pakiecie lavaan (Rosseel, 2012). Odpowiedzi 1–7 potraktowaliśmy jako ilościowe i użyliśmy estymatora MLR, odpornego na odstępstwa od rozkładu normalnego. Braki uwzględniła metoda FIML. Przy wyraźnie skośnych odpowiedziach albo krótszej skali rozważ estymator WLSMV dla danych porządkowych.
Model jednoczynnikowy z pięcioma pozycjami ma tylko 5 stopni swobody. W przykładzie dopasowanie było niejednoznaczne. CFI = .975 i SRMR = .032 wyglądają dobrze, ale RMSEA = .109 przekracza orientacyjne wartości proponowane przez Hu i Bentlera (1999). Przy tak małej liczbie stopni swobody RMSEA ma bardzo szeroki przedział ufności: od .061 do .161.
Clench-Aas i in. (2011) uzyskali najlepsze dopasowanie w modelu z korelacją reszt pozycji 4 i 5. Uzasadnienie jest treściowe: obie pozycje odnoszą się do dotychczasowego życia, a nie do obecnej sytuacji. Ten sam model w naszych danych pasował bardzo dobrze. Poprawa była istotna w teście różnicy chi-kwadrat z poprawką Satorry–Bentlera, Δχ²(1) = 18.03, p < .001. Korelacja reszt wyniosła .28, a ładunki standaryzowane mieściły się w przedziale .63–.85.
| Model | χ² (df) | p | CFI | TLI | RMSEA [90% CI] | SRMR |
|---|---|---|---|---|---|---|
| 1. Jeden czynnik | 20.27 (5) | .001 | .975 | .950 | .109 [.061, .161] | .032 |
| 2. Jeden czynnik + korelacja reszt pozycji 4 i 5 | 3.50 (4) | .478 | 1.000 | 1.002 | .000 [.000, .090] | .011 |
Dodaj tę korelację tylko wtedy, gdy masz uzasadnienie treściowe albo literaturę, a nie dlatego, że poprawia wskaźniki. Taką modyfikację opisz w pracy wprost. Więcej o wskaźnikach dopasowania i ich raportowaniu znajdziesz w poradniku analiza czynnikowa EFA i CFA i w haśle tabela dopasowania modelu CFA w APA. Jeśli porównujesz grupy, np. kobiety i mężczyzn, sprawdź też inwariancję pomiaru.
Gdy ankieta musi być bardzo krótka, możesz rozważyć trzypozycyjną wersję SWLS-3. Kjell i Diener (2021) pokazali na trzech zbiorach danych, że ma ona właściwości psychometryczne co najmniej tak dobre jak wersja pięciopozycyjna. Pamiętaj jednak, że wyniki SWLS-3 nie są porównywalne z sumą 5–35.
Jak opisać SWLS w pracy
W części „Metoda” podaj autorów, liczbę pozycji, skalę odpowiedzi, sposób liczenia wyniku, regułę dla braków i rzetelność we własnej próbie. W części „Wyniki” wystarczą statystyki opisowe, a CFA opisz tylko wtedy, gdy ją wykonano.
SWLS w R: wynik, alfa i CFA
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R, bo przepis 2 korzysta z danych z przepisu 1. Przepis 1 zapisuje też dane do pliku CSV, który możesz pobrać powyżej.
1. Wynik, braki, rozkład i rzetelność
R
# SWLS: wynik, braki, rozkład i rzetelność (dane symulowane, set.seed(6512)).
# 286 osób z personelu pielęgniarskiego szpitala powiatowego, anonimowa ankieta.
# Odpowiedzi 1–7 (1 = zdecydowanie się nie zgadzam ... 7 = zdecydowanie się zgadzam); brak pozycji odwróconych.
suppressPackageStartupMessages(library(psych))
set.seed(6512)
n <- 286
zad <- rnorm(n)                                          # ogólne zadowolenie z życia (cecha ukryta)
przesz <- rnorm(n)                                       # wspólna część pozycji 4 i 5 (ocena dotychczasowego życia)
lad <- c(.80, .78, .86, .70, .62)
lp  <- c(0, 0, 0, .35, .35)
progi <- list(c(-2.1, -1.5, -1.0, -0.45, 0.35, 1.30),
              c(-2.2, -1.6, -1.1, -0.55, 0.25, 1.20),
              c(-2.2, -1.6, -1.1, -0.55, 0.20, 1.15),
              c(-2.0, -1.4, -0.9, -0.35, 0.40, 1.35),
              c(-1.4, -0.85, -0.35, 0.15, 0.80, 1.60))   # pozycja 5: najniższe odpowiedzi
swls <- sapply(1:5, function(j) {
  y <- lad[j] * zad + lp[j] * przesz + sqrt(1 - lad[j]^2 - lp[j]^2) * rnorm(n)
  findInterval(y, progi[[j]]) + 1                        # kategorie 1–7
})
colnames(swls) <- paste0("swls", 1:5)
dane <- data.frame(id = 1:n, swls)
dane[sample(n, 6), "swls5"] <- NA                        # pojedyncze braki
dane[sample(n, 2), "swls2"] <- NA
dane[c(58, 211), c("swls3", "swls4")] <- NA              # dwie osoby z dwoma brakami
dane$swls1[97] <- 0                                      # błąd kodowania: 0 zamiast brakującej odpowiedzi
write.csv(dane, "../skala-swls-dane.csv", row.names = FALSE)

poz <- paste0("swls", 1:5)
# Krok 1. Wartości niemożliwe (poza 1–7)
which(!is.na(as.matrix(dane[poz])) & !(as.matrix(dane[poz]) %in% 1:7), arr.ind = TRUE)
dane$swls1[dane$swls1 == 0] <- NA                        # 0 nie istnieje na skali 1–7 – traktujemy jako brak
# Krok 2. Braki na osobę
table(braki = rowSums(is.na(dane[poz])))
# Krok 3. Wynik: suma 5–35; umownie przy jednym braku średnia z 4 odpowiedzi × 5 (zaokrąglona)
b <- rowSums(is.na(dane[poz]))
dane$SWLS <- round(rowMeans(dane[poz], na.rm = TRUE) * 5); dane$SWLS[b > 1] <- NA
dane$SWLS_srednia <- dane$SWLS / 5                       # ta sama informacja w metryce 1–7
c(z_wynikiem = sum(!is.na(dane$SWLS)), bez_wyniku = sum(is.na(dane$SWLS)))
range(dane$SWLS, na.rm = TRUE)

x <- na.omit(dane$SWLS)
round(c(M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)),
        skosnosc = psych::skew(x), M_1do7 = mean(x) / 5, SD_1do7 = sd(x) / 5), 2)
round(t.test(x)$conf.int, 2)
round(colMeans(dane[poz], na.rm = TRUE), 2)              # średnie pozycji (1–7)
# Położenie względem teoretycznego środka skali (20 = odpowiedź 4 we wszystkich pozycjach)
tab <- table(cut(x, c(4, 19, 20, 35), labels = c("ponizej 20", "rowno 20", "powyzej 20")))
cbind(n = tab, proc = round(100 * prop.table(tab), 1))
t.test(x, mu = 20)
round((mean(x) - 20) / sd(x), 2)                          # d dla jednej próby względem środka skali
c(min_5 = sum(x == 5), max_35 = sum(x == 35))             # efekt podłogi i sufitu

# Krok 4. Rzetelność: alfa z 95% CI (Feldt) i korelacje pozycja–reszta
a <- psych::alpha(dane[poz], warnings = FALSE)
round(c(alfa = a$total$raw_alpha, CI_dolna = a$feldt$lower.ci[[1]], CI_gorna = a$feldt$upper.ci[[1]]), 2)
round(a$item.stats$r.drop, 2)
round(a$alpha.drop$raw_alpha, 2)                          # alfa po usunięciu pozycji
Wynik w R
     row col
[1,]  97   1
braki
  0   1   2
275   9   2
z_wynikiem bez_wyniku
       284          2
[1]  6 35
       M       SD       Me       Q1       Q3 skosnosc   M_1do7  SD_1do7
   23.65     6.04    24.00    20.00    28.00    -0.47     4.73     1.21
[1] 22.94 24.35
attr(,"conf.level")
[1] 0.95
swls1 swls2 swls3 swls4 swls5
 4.85  4.96  4.99  4.71  4.07
             n proc
ponizej 20  67 23.6
rowno 20    12  4.2
powyzej 20 205 72.2

	One Sample t-test

data:  x
t = 10.186, df = 283, p-value < 2.2e-16
alternative hypothesis: true mean is not equal to 20
95 percent confidence interval:
 22.94293 24.35284
sample estimates:
mean of x
 23.64789

[1] 0.6
 min_5 max_35
     0      3
    alfa CI_dolna CI_gorna
    0.87     0.84     0.89
[1] 0.76 0.69 0.73 0.63 0.66
[1] 0.82 0.84 0.83 0.85 0.85
2. Jednoczynnikowa CFA
R
# Jednoczynnikowa CFA skali SWLS (korzysta z obiektu dane z b65-1-wynik.R)
suppressPackageStartupMessages(library(lavaan))
m1 <- 'zadowolenie =~ swls1 + swls2 + swls3 + swls4 + swls5'
m2 <- paste(m1, 'swls4 ~~ swls5', sep = "\n")             # wspólna wariancja reszt pozycji 4 i 5
f1 <- cfa(m1, data = dane, estimator = "MLR", missing = "fiml", std.lv = TRUE)
f2 <- cfa(m2, data = dane, estimator = "MLR", missing = "fiml", std.lv = TRUE)
miary <- c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
           "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr")
round(rbind(model_1 = fitMeasures(f1, miary), model_2 = fitMeasures(f2, miary)), 3)
lavTestLRT(f1, f2)                                        # test różnicy chi-kwadrat (poprawka Satorry–Bentlera)
st <- standardizedSolution(f2)
round(setNames(st$est.std[st$op == "=~"], poz), 2)         # ładunki standaryzowane, model 2
round(st$est.std[st$op == "~~" & st$lhs == "swls4" & st$rhs == "swls5"], 2)   # korelacja reszt 4 i 5
st1 <- standardizedSolution(f1); round(setNames(st1$est.std[st1$op == "=~"], poz), 2)   # model 1
omega <- function(fit) {                                   # omega = (suma ładunków)² / wariancja sumy wg modelu
  pe <- parameterEstimates(fit); l <- sum(pe$est[pe$op == "=~"])
  th <- pe[pe$op == "~~" & pe$lhs != "zadowolenie", ]
  bl <- sum(th$est[th$lhs == th$rhs]) + 2 * sum(th$est[th$lhs != th$rhs])
  l^2 / (l^2 + bl)
}
round(c(omega_model_1 = omega(f1), omega_model_2 = omega(f2)), 2)
Wynik w R
        chisq.scaled df.scaled pvalue.scaled cfi.robust tli.robust rmsea.robust
model_1       20.274         5         0.001      0.975      0.950        0.109
model_2        3.499         4         0.478      1.000      1.002        0.000
        rmsea.ci.lower.robust rmsea.ci.upper.robust  srmr
model_1                 0.061                 0.161 0.032
model_2                 0.000                 0.090 0.011

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the robust test that
   should be reported per model. A robust difference test is a function of two standard (not
   robust) statistics.

   Df    AIC    BIC   Chisq Chisq diff Df diff Pr(>Chisq)
f2  4 4501.4 4559.9  3.9184
f1  5 4517.8 4572.6 22.2940     18.031       1  2.173e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
swls1 swls2 swls3 swls4 swls5
 0.85  0.78  0.83  0.63  0.66
[1] 0.28
swls1 swls2 swls3 swls4 swls5
 0.84  0.77  0.82  0.66  0.69
omega_model_1 omega_model_2
         0.87          0.84
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja t.test() z pakietu stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Szukanie pozycji odwróconych. SWLS ich nie ma. Odwrócenie którejkolwiek pozycji zniszczy wynik i obniży α.
- Kodowanie 0–6 albo zero jako brak. Przed sumowaniem sprawdź, czy minimum wyniku wynosi co najmniej 5, a maksimum najwyżej 35.
- Własne „normy”. Podział na tercyle z własnej próby to nie poziomy zadowolenia z życia. Jeśli używasz przedziałów opisowych, weź granice z dokumentu Dienera (2006) i zacytuj go.
- Diagnostyczny język. Niski wynik SWLS to niskie zadowolenie z życia, a nie zaburzenie. Nie pisz o „osobach z niską satysfakcją wymagających pomocy”, jeśli Twoje dane tego nie pokazują.
- Bezrefleksyjne indeksy modyfikacji. Korelacja reszt pozycji 4 i 5 ma uzasadnienie w treści i w literaturze. Dodawanie kolejnych korelacji tylko dla poprawy CFI to dopasowywanie modelu do danych.
- Przepisanie rzetelności z oryginału. Podaj α lub ω we własnej próbie. Dane z publikacji możesz dodać jako tło.
W tej samej serii opisujemy też PSS-10 i Skalę Samooceny Rosenberga, w której pozycje odwrócone i spór o jednowymiarowość są głównym problemem. Jeśli chcesz, żeby ktoś sprawdził Twoje obliczenia albo pomógł zinterpretować CFA, zajrzyj do naszej pomocy w analizie danych dla studentów.
Najczęstsze pytania
Jak policzyć wynik w skali SWLS?
Zsumuj odpowiedzi na pięć stwierdzeń, każde ocenione od 1 do 7. Wynik mieści się w zakresie 5–35, a wyższy oznacza większe zadowolenie z życia. SWLS nie ma pozycji odwróconych, więc niczego nie przekodowujesz – sprawdź tylko, czy formularz nie zapisał odpowiedzi jako 0–6.
Jaki wynik SWLS jest niski, a jaki wysoki?
SWLS nie ma progów diagnostycznych. Diener (2006) w dokumencie „Understanding Scores on the Satisfaction with Life Scale” opisuje sześć przedziałów sumy: 5–9 skrajne niezadowolenie, 10–14 niezadowolenie, 15–19 nieco poniżej przeciętnej, 20–24 wynik przeciętny, 25–29 wysoki i 30–35 bardzo wysoki. To opisy interpretacyjne, a nie normy, więc przy ich użyciu zacytuj dokument i nie nazywaj ich progami klinicznymi.
Czy SWLS ma pozycje odwrócone?
Nie. Wszystkie pięć stwierdzeń jest sformułowanych w tym samym kierunku: zgoda oznacza większe zadowolenie z życia. Jeśli po policzeniu alfy któraś pozycja ma ujemną korelację z resztą skali, szukaj błędu w kodowaniu danych, a nie pozycji odwróconej.
Czy SWLS jest jednoczynnikowa?
Zwykle tak, ale w wielu badaniach lepiej pasuje model jednoczynnikowy z korelacją reszt pozycji 4 i 5, które dotyczą oceny dotychczasowego życia (Clench-Aas i in., 2011). Taką modyfikację wprowadzaj z uzasadnieniem treściowym i opisz ją w pracy.
Czy mogę użyć SWLS w pracy dyplomowej bez zgody autorów?
Według oficjalnej strony Eda Dienera badacze mogą używać SWLS bez zgody i opłat, jeśli podadzą autorów i wykorzystują skalę niekomercyjnie (Diener, b.d.). Polskie adaptacje mogą mieć własne warunki użycia, więc sprawdź je u źródła wersji, z której korzystasz.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikSkala Samooceny Rosenberga – wynik
Pozycje odwrócone, zakres 0–30, braki, alfa, interpretacja bez progów i CFA z efektem metody w R – z gotowym opisem do pracy.
Czytaj →PoradnikGAD-7 i PHQ-9 – jak policzyć wynik
Suma 0–21 i 0–27, braki, progi 5/10/15/20 ze źródłami, próg przesiewowy 10, pozycja 9 PHQ-9 i przykład w R z opisem do pracy.
Czytaj →Masz wyniki SWLS i nie wiesz, jak je opisać?
Sprawdzimy wynik i rzetelność skali, w razie potrzeby wykonamy CFA i wyjaśnimy wyniki tak, żebyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Clench-Aas, J., Nes, R. B., Dalgard, O. S., & Aarø, L. E. (2011). Dimensionality and measurement invariance in the Satisfaction with Life Scale in Norway. Quality of Life Research, 20(8), 1307–1317. https://doi.org/10.1007/s11136-011-9859-x ● Otwarty dostęp
- Diener, E. (2006). Understanding scores on the Satisfaction with Life Scale. Ed Diener. https://eddiener.com/wp-content/uploads/2024/09/Understanding-SWLS-Scores.pdf ● Otwarty dostęp
- Diener, E. (b.d.). Satisfaction With Life Scale (SWLS). Ed Diener. https://eddiener.com/satisfaction-with-life-scale-swls/ ● Otwarty dostęp
- Diener, E., Emmons, R. A., Larsen, R. J., & Griffin, S. (1985). The Satisfaction With Life Scale. Journal of Personality Assessment, 49(1), 71–75. https://doi.org/10.1207/s15327752jpa4901_13
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Kjell, O. N. E., & Diener, E. (2021). Abbreviated three-item versions of the Satisfaction with Life Scale and the Harmony in Life Scale yield as strong psychometric properties as the original scales. Journal of Personality Assessment, 103(2), 183–194. https://doi.org/10.1080/00223891.2020.1737093 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Pavot, W., & Diener, E. (1993). Review of the Satisfaction With Life Scale. Psychological Assessment, 5(2), 164–172. https://doi.org/10.1037/1040-3590.5.2.164
- Pavot, W., & Diener, E. (2008). The Satisfaction With Life Scale and the emerging construct of life satisfaction. The Journal of Positive Psychology, 3(2), 137–152. https://doi.org/10.1080/17439760701756946
- Pavot, W., Diener, E., Colvin, C. R., & Sandvik, E. (1991). Further validation of the Satisfaction With Life Scale: Evidence for the cross-method convergence of well-being measures. Journal of Personality Assessment, 57(1), 149–161. https://doi.org/10.1207/s15327752jpa5701_17
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
Cytowania BibTeX
@article{clenchaas2011dimensionality, author={Clench-Aas, Jocelyne and Nes, Ragnhild Bang and Dalgard, Odd Steffen and Aarø, Leif Edvard}, title={{Dimensionality and measurement invariance in the Satisfaction with Life Scale in Norway}}, journal={Quality of Life Research}, year={2011}, volume={20}, number={8}, pages={1307--1317}, doi={10.1007/s11136-011-9859-x}}@misc{diener2006understanding, author={Diener, Ed}, title={{Understanding scores on the Satisfaction with Life Scale}}, howpublished={Ed Diener}, year={2006}, url={https://eddiener.com/wp-content/uploads/2024/09/Understanding-SWLS-Scores.pdf}}@misc{dienerndswls, author={Diener, Ed}, title={{Satisfaction With Life Scale (SWLS)}}, howpublished={Ed Diener}, year={b.d.}, url={https://eddiener.com/satisfaction-with-life-scale-swls/}}@article{diener1985satisfaction, author={Diener, Ed and Emmons, Robert A. and Larsen, Randy J. and Griffin, Sharon}, title={{The Satisfaction With Life Scale}}, journal={Journal of Personality Assessment}, year={1985}, volume={49}, number={1}, pages={71--75}, doi={10.1207/s15327752jpa4901_13}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{kjell2021abbreviated, author={Kjell, Oscar N. E. and Diener, Ed}, title={{Abbreviated three-item versions of the Satisfaction with Life Scale and the Harmony in Life Scale yield as strong psychometric properties as the original scales}}, journal={Journal of Personality Assessment}, year={2021}, volume={103}, number={2}, pages={183--194}, doi={10.1080/00223891.2020.1737093}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{pavot1993review, author={Pavot, William and Diener, Ed}, title={{Review of the Satisfaction With Life Scale}}, journal={Psychological Assessment}, year={1993}, volume={5}, number={2}, pages={164--172}, doi={10.1037/1040-3590.5.2.164}}@article{pavot2008satisfaction, author={Pavot, William and Diener, Ed}, title={{The Satisfaction With Life Scale and the emerging construct of life satisfaction}}, journal={The Journal of Positive Psychology}, year={2008}, volume={3}, number={2}, pages={137--152}, doi={10.1080/17439760701756946}}@article{pavot1991further, author={Pavot, William and Diener, Ed and Colvin, C. Randall and Sandvik, Ed}, title={{Further validation of the Satisfaction With Life Scale: Evidence for the cross-method convergence of well-being measures}}, journal={Journal of Personality Assessment}, year={1991}, volume={57}, number={1}, pages={149--161}, doi={10.1207/s15327752jpa5701_17}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}