Co to jest ładunek czynnikowy?
Ładunek czynnikowy (ang. factor loading, symbol λ) to współczynnik opisujący związek obserwowanej zmiennej – zwykle pozycji kwestionariusza – z czynnikiem w analizie czynnikowej. W modelu czynnikowym wynik pozycji to suma wpływów czynników pomnożonych przez ładunki oraz części swoistej:
W analizie standaryzowanych zmiennych (macierzy korelacji) ładunek ma trzy praktyczne interpretacje. Przy jednym czynniku lub czynnikach nieskorelowanych:
- jest korelacją pozycji z czynnikiem – λ = .70 to korelacja .70;
- jego kwadrat to część wariancji pozycji wyjaśniona przez czynnik – λ² = .49, czyli 49%; suma λ² po czynnikach to wspólność h²;
- iloczyn ładunków dwóch pozycji odtwarza ich korelację: rij ≈ λiλj. Czynnik „tłumaczy” więc, dlaczego pozycje ze sobą korelują.
Przy rotacji ukośnej pierwsza interpretacja się rozdwaja. Ładunek z macierzy wzoru to unikalny wpływ czynnika, podobny do współczynnika β w regresji. Korelację pozycji z czynnikiem pokazuje macierz struktury.
Przykład: skala prokrastynacji akademickiej
Dwieście osób studiujących wypełniło 8-pozycyjną skalę prokrastynacji akademickiej (np. „Odkładam naukę do ostatniej chwili”; odpowiedzi 1–5; dane symulowane z modelu jednoczynnikowego). Model jednoczynnikowy oszacowany metodą największej wiarygodności dobrze opisuje dane: χ²(20) = 30.44, p = .063, RMSEA = .051, TLI = .963.
| Pozycja | Ładunek λ | λ² = h² | Swoistość 1 − λ² |
|---|---|---|---|
| pro1 | .70 | .50 | .50 |
| pro2 | .70 | .50 | .50 |
| pro3 | .64 | .41 | .59 |
| pro4 | .73 | .53 | .47 |
| pro5 | .65 | .42 | .58 |
| pro6 | .52 | .27 | .73 |
| pro7 | .46 | .21 | .79 |
| pro8 | .26 | .07 | .93 |
Pięć pierwszych pozycji ma ładunki .64–.73: czynnik wyjaśnia w nich 41–53% wariancji (dla pro1 49.6%). Pozycja pro8 ma ładunek .26 – czynnik wyjaśnia w niej tylko 6.5% wariancji. Iloczyn ładunków dobrze odtwarza korelacje: dla pro1 i pro2 model przewiduje .496, a obserwowana korelacja wynosi .498; dla pro1 i pro8 – .180 wobec .171. Największa rozbieżność między korelacją obserwowaną a odtworzoną dotyczy pary pro2–pro8 i wynosi .12.
Jaki ładunek jest „wystarczający”?
W praktyce funkcjonują konwencje, a nie prawa statystyki: .30 lub .32 jako minimum, by uznać pozycję za związaną z czynnikiem (λ² ≈ 10%), .40 jako częsty próg w skalach psychologicznych i .50 lub .70 jako ładunki „dobre” i „bardzo dobre”. W CFA i PLS-SEM próg .70 bierze się stąd, że wtedy czynnik wyjaśnia co najmniej połowę wariancji pozycji – zob. AVE i ładunek zewnętrzny. Ważniejsze od samego progu są trzy pytania:
- Czy ładunek jest oszacowany precyzyjnie? To zależy od liczebności próby (zob. niżej).
- Czy pozycja ma ładunki krzyżowe? Pozycja z ładunkami .45 i .40 na dwóch czynnikach nie różnicuje konstruktów, nawet jeśli oba ładunki przekraczają próg.
- Czy niski ładunek ma wytłumaczenie treściowe? Odwrócone brzmienie, wąski aspekt konstruktu, niejasne sformułowanie, mała zmienność odpowiedzi.
Ładunek ma błąd standardowy
Ładunek z próby jest oszacowaniem, a jego precyzja zależy głównie od liczebności próby i wspólności pozycji. MacCallum i in. (1999) pokazali, że potrzebna próba zależy od poziomu wspólności i liczby pozycji na czynnik, a nie od jednej stałej reguły. Guadagnoli i Velicer (1988) badali, jak liczebność próby wpływa na stabilność wzorów ładunków. Rysunek 1 pokazuje to na przykładzie: z tej samej populacji pobrano dwie próby, 100 i 400 osób, i dla każdego ładunku policzono 95% przedział bootstrapowy (1000 losowań).
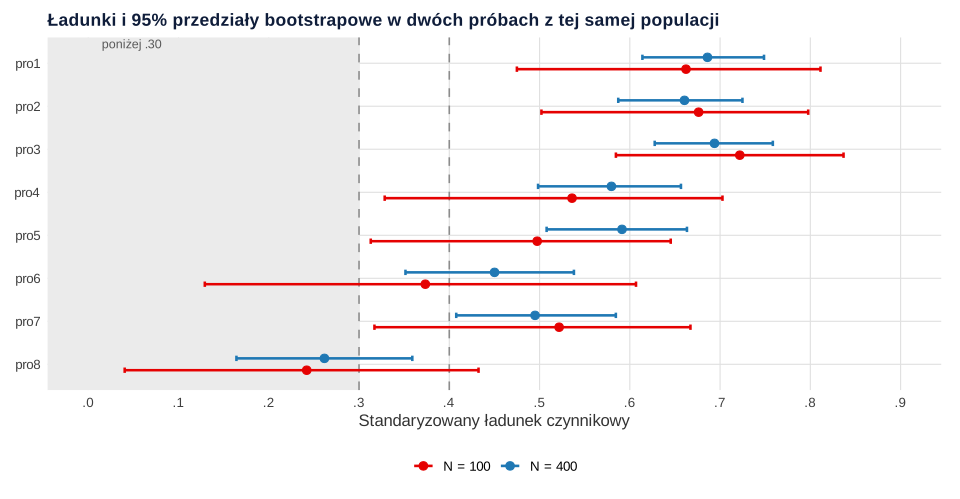
Przy 100 osobach przedziały mają średnio szerokość .35. Ładunek pro6 wynosi .37, ale przedział [.13, .61] obejmuje zarówno wartości „za niskie”, jak i całkiem dobre. Przy 400 osobach średnia szerokość spada do .16, a ten sam ładunek to .45 [.35, .54]. Decyzja „usuwam pozycję, bo ma ładunek .37” podjęta na 100 osobach może po prostu odzwierciedlać błąd próby. Pozycja pro8 jest słaba w obu próbach (.24 i .26) – tu decyzja jest bezpieczniejsza.
Ładunek w PCA, EFA i CFA
| Analiza | Co oznacza ładunek | Na co uważać |
|---|---|---|
| PCA | Korelacja zmiennej ze składową | Zawyżony względem modelu czynnikowego, zwłaszcza przy niewielu pozycjach (Widaman, 1993) |
| EFA | Ładunek wzoru (po rotacji) na każdym czynniku | Zależy od metody ekstrakcji i rotacji; wszystkie pozycje ładują wszystkie czynniki |
| CFA | Ładunek tylko na czynniku wskazanym w modelu; niestandaryzowany i standaryzowany | Raportuj standaryzowane; ładunki krzyżowe są ustalone na 0 |
Fabrigar i in. (1999) oraz Watkins (2018) podkreślają, że interpretacja ładunków zależy od wcześniejszych decyzji: modelu, metody ekstrakcji, liczby czynników i rotacji. Dlatego w raporcie zawsze podawaj, skąd pochodzą ładunki.
Ładunki a rzetelność skali
Ładunki z modelu jednoczynnikowego wystarczą do policzenia omegi McDonalda: ω = (Σλ)² / [(Σλ)² + Σ(1 − λ²)]. W przykładzie ω = .810. Przy tych samych ładunkach pozostałych pozycji pominięcie pro8 podnosi omegę tylko do .824, bo pozycja o ładunku .26 wnosi niewiele zarówno do wariancji prawdziwej, jak i do błędu. Słaba pozycja rzadko „psuje” rzetelność dłuższej skali. Problemem jest raczej to, że niewiele mówi o konstrukcie, a jej obecność w sumie wyników rozmywa jego znaczenie.
Ładunki służą też do oceny trafności: wysokie ładunki pozycji na „własnym” czynniku przy niskich ładunkach krzyżowych są jednym z argumentów za trafnością teoretyczną skali, a porównanie ładunków w grupach (np. kobiet i mężczyzn) to pierwszy krok badania inwariancji pomiaru.
Jak opisać ładunki w pracy (APA)
Pełne ładunki pokaż w tabeli według wzoru tabeli analizy czynnikowej w APA. Ładunki zapisuj bez zera przed kropką, bo mieszczą się w przedziale od −1 do 1. W tekście podaj zakres, wskaż pozycje słabe i napisz, co z nimi zrobiłeś.
Jak ładunki wykorzystać przy ocenie rzetelności (np. omega McDonalda) i walidacji skali, opisujemy w poradnikach Jak zbudować i zwalidować skalę psychometryczną oraz Analiza czynnikowa EFA i CFA.
Przykład w R
Kod generuje dane skali prokrastynacji, szacuje model jednoczynnikowy metodą największej wiarygodności, liczy λ², porównuje korelacje obserwowane z iloczynami ładunków, wskazuje największą resztę, podaje dopasowanie modelu i wyznacza bootstrapowe przedziały ufności ładunków w próbach 100 i 400 osób (obliczenia trwają kilka sekund).
Ładunki czynnikowe, odtwarzanie korelacji i przedziały bootstrapowe
R
# R178 – Ładunek czynnikowy: interpretacja, odtwarzanie korelacji i niepewność oszacowania
# Dane symulowane: 8 pozycji skali prokrastynacji akademickiej (1–5), model jednoczynnikowy, N = 200
suppressPackageStartupMessages({library(MASS); library(psych)})
lam <- c(.75, .70, .70, .65, .60, .55, .45, .30)
generuj <- function(n, seed) {
  set.seed(seed)
  Sigma <- lam %*% t(lam); diag(Sigma) <- 1
  z <- mvrnorm(n, rep(0, 8), Sigma)
  d <- as.data.frame(apply(z, 2, function(x) as.integer(cut(x, c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf)))))
  names(d) <- paste0("pro", 1:8); d
}
dane <- generuj(200, 178)

m <- fa(dane, nfactors = 1, fm = "ml")
l <- m$loadings[, 1]
round(cbind(ladunek = l, h2 = l^2, swoistosc = 1 - l^2), 2)
# Ładunek² = część wariancji pozycji wyjaśniona przez czynnik
round(c(pro1 = 100 * unname(l[1])^2, pro8 = 100 * unname(l[8])^2), 1)

# Model odtwarza korelacje jako iloczyny ładunków: r(pro1, pro2) ≈ λ1 × λ2
R <- cor(dane)
round(c(obserwowana = R[1, 2], z_modelu = unname(l[1] * l[2])), 3)
round(c(obserwowana = R[1, 8], z_modelu = unname(l[1] * l[8])), 3)
reszty <- R - l %*% t(l); diag(reszty) <- 0
round(max(abs(reszty)), 3)
which(abs(reszty) == max(abs(reszty)), arr.ind = TRUE)[1, ]
round(c(chi2 = m$STATISTIC, df = m$dof, p = m$PVAL, RMSEA = m$RMSEA[1], TLI = m$TLI), 3)
# Omega McDonalda z ładunków modelu jednoczynnikowego: (suma λ)² / [(suma λ)² + suma (1 − λ²)]
round(c(omega = sum(l)^2 / (sum(l)^2 + sum(1 - l^2)),
        omega_bez_pro8 = sum(l[-8])^2 / (sum(l[-8])^2 + sum(1 - l[-8]^2))), 3)

# Niepewność: 95% przedziały bootstrapowe ładunków przy N = 100 i N = 400 (różne próby z tej samej populacji)
set.seed(1780)
ci <- function(d) {
  b <- replicate(1000, { i <- sample(nrow(d), replace = TRUE)
    abs(fa(d[i, ], nfactors = 1, fm = "ml")$loadings[, 1]) })
  t(apply(b, 1, quantile, c(.025, .975)))
}
d100 <- generuj(100, 1781); d400 <- generuj(400, 1782)
k100 <- cbind(ladunek = abs(fa(d100, 1, fm = "ml")$loadings[, 1]), ci(d100))
k400 <- cbind(ladunek = abs(fa(d400, 1, fm = "ml")$loadings[, 1]), ci(d400))
round(k100, 2); round(k400, 2)
round(c(sr_szerokosc_N100 = mean(k100[, 3] - k100[, 2]), sr_szerokosc_N400 = mean(k400[, 3] - k400[, 2])), 2)
Wynik w R
     ladunek   h2 swoistosc
pro1    0.70 0.50      0.50
pro2    0.70 0.50      0.50
pro3    0.64 0.41      0.59
pro4    0.73 0.53      0.47
pro5    0.65 0.42      0.58
pro6    0.52 0.27      0.73
pro7    0.46 0.21      0.79
pro8    0.26 0.07      0.93
pro1 pro8
49.6  6.5
obserwowana    z_modelu
      0.498       0.496
obserwowana    z_modelu
      0.171       0.180
[1] 0.12
row col
  8   2
       chi2          df           p RMSEA.RMSEA         TLI
     30.444      20.000       0.063       0.051       0.963
         omega omega_bez_pro8
         0.810          0.824
     ladunek 2.5% 97.5%
pro1    0.66 0.47  0.81
pro2    0.68 0.50  0.80
pro3    0.72 0.58  0.84
pro4    0.54 0.33  0.70
pro5    0.50 0.31  0.65
pro6    0.37 0.13  0.61
pro7    0.52 0.32  0.67
pro8    0.24 0.04  0.43
     ladunek 2.5% 97.5%
pro1    0.69 0.61  0.75
pro2    0.66 0.59  0.72
pro3    0.69 0.63  0.76
pro4    0.58 0.50  0.66
pro5    0.59 0.51  0.66
pro6    0.45 0.35  0.54
pro7    0.50 0.41  0.58
pro8    0.26 0.16  0.36
sr_szerokosc_N100 sr_szerokosc_N400
             0.35              0.16
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; model czynnikowy oszacowano pakietem psych, dane wygenerowano pakietem MASS, rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Interpretowanie ładunku wzoru jako korelacji przy rotacji ukośnej – korelację z czynnikiem pokazuje macierz struktury.
- Mechaniczne cięcie na progu .40 – przy małej próbie ładunek .37 może mieć przedział od .13 do .61; decyzję opieraj też na treści i powtórzeniu w innej próbie.
- Ignorowanie ładunków krzyżowych – wysoki ładunek główny nie wystarczy, jeśli pozycja podobnie silnie ładuje inny czynnik.
- Porównywanie ładunków z PCA i z CFA – ładunki składowych są systematycznie wyższe niż ładunki czynników wspólnych.
- Ujemne ładunki pozycji odwróconych bez rekodowania – przed analizą zrekoduj pozycje odwrócone albo jasno opisz znak w tabeli.
- Zapis „0.70” zamiast „.70” – w stylu APA ładunki, jako wartości ograniczone do przedziału od −1 do 1, zapisuje się bez zera wiodącego.
Najczęstsze pytania
Jaki ładunek czynnikowy uznaje się za wystarczający?
Najczęściej przyjmuje się minimum .30–.40; przy .40 czynnik wyjaśnia 16% wariancji pozycji. W CFA i PLS-SEM za dobre uznaje się ładunki od .70, bo wtedy czynnik wyjaśnia co najmniej połowę wariancji. To konwencje – uwzględnij też liczebność próby, ładunki krzyżowe i treść pozycji.
Co oznacza kwadrat ładunku czynnikowego?
Przy czynnikach nieskorelowanych kwadrat ładunku to część wariancji pozycji wyjaśniona przez dany czynnik. Ładunek .70 oznacza 49% wariancji, a ładunek .26 – tylko około 7%. Suma kwadratów ładunków pozycji na wszystkich czynnikach to jej wspólność.
Czy ładunek czynnikowy może być ujemny?
Tak. Ujemny ładunek oznacza, że wyższe wyniki pozycji idą w parze z niższym poziomem czynnika. Zwykle dotyczy to pozycji odwróconych, które przed analizą warto zrekodować. Ujemny ładunek pozycji, która nie jest odwrócona, to sygnał do sprawdzenia jej treści i kodowania.
Ile osób potrzeba, żeby ładunki czynnikowe były stabilne?
Nie ma jednej liczby: potrzebna próba zależy od wspólności pozycji i liczby pozycji na czynnik. W przykładzie średnia szerokość 95% przedziału ładunku wynosiła .35 przy 100 osobach i .16 przy 400, więc przy małych próbach różnice rzędu .10 między ładunkami nic nie znaczą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikCB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Guadagnoli, E., & Velicer, W. F. (1988). Relation of sample size to the stability of component patterns. Psychological Bulletin, 103(2), 265–275. https://doi.org/10.1037/0033-2909.103.2.265
- MacCallum, R. C., Widaman, K. F., Zhang, S., & Hong, S. (1999). Sample size in factor analysis. Psychological Methods, 4(1), 84–99. https://doi.org/10.1037/1082-989x.4.1.84
- Watkins, M. W. (2018). Exploratory factor analysis: A guide to best practice. Journal of Black Psychology, 44(3), 219–246. https://doi.org/10.1177/0095798418771807 ● Otwarty dostęp
- Widaman, K. F. (1993). Common factor analysis versus principal component analysis: Differential bias in representing model parameters? Multivariate Behavioral Research, 28(3), 263–311. https://doi.org/10.1207/s15327906mbr2803_1
Cytowania BibTeX
@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{guadagnoli1988relation, author={Guadagnoli, Edward and Velicer, Wayne F.}, title={{Relation of sample size to the stability of component patterns}}, journal={Psychological Bulletin}, year={1988}, volume={103}, number={2}, pages={265--275}, doi={10.1037/0033-2909.103.2.265}}@article{maccallum1999sample, author={MacCallum, Robert C. and Widaman, Keith F. and Zhang, Shaobo and Hong, Sehee}, title={{Sample size in factor analysis}}, journal={Psychological Methods}, year={1999}, volume={4}, number={1}, pages={84--99}, doi={10.1037/1082-989x.4.1.84}}@article{watkins2018exploratory, author={Watkins, Marley W.}, title={{Exploratory factor analysis: A guide to best practice}}, journal={Journal of Black Psychology}, year={2018}, volume={44}, number={3}, pages={219--246}, doi={10.1177/0095798418771807}}@article{widaman1993common, author={Widaman, Keith F.}, title={{Common factor analysis versus principal component analysis: Differential bias in representing model parameters?}}, journal={Multivariate Behavioral Research}, year={1993}, volume={28}, number={3}, pages={263--311}, doi={10.1207/s15327906mbr2803_1}}