Co to jest metoda głównych składowych w analizie czynnikowej?
Metoda głównych składowych (ang. principal components, PC) jako metoda ekstrakcji to sposób wyodrębniania „czynników” w procedurze analizy czynnikowej, w którym analizuje się pełną macierz korelacji – z jedynkami na przekątnej. Uzyskane wymiary są w rzeczywistości głównymi składowymi, a nie czynnikami wspólnymi. W oknie analizy czynnikowej SPSS (procedura FACTOR) jest to domyślna metoda ekstrakcji („Principal components”), dlatego wiele prac nazywa „eksploracyjną analizą czynnikową” coś, co technicznie jest analizą głównych składowych (PCA) z rotacją.
To hasło dotyczy właśnie tej sytuacji: skutków wyboru PC zamiast metody czynników wspólnych, np. metody osi głównych (PAF) albo największej wiarygodności (ML). PCA jako samodzielną technikę redukcji danych opisujemy w osobnym haśle.
Czym różni się od ekstrakcji czynników wspólnych?
Różnica leży w tym, co trafia na przekątną analizowanej macierzy. Model czynnikowy zakłada, że wariancja każdej pozycji dzieli się na część wspólną (wyjaśnianą przez czynniki) i część swoistą (specyficzną treść pozycji oraz błąd pomiaru):
| Cecha | Główne składowe (PC) | Osie główne (PAF) / ML |
|---|---|---|
| Przekątna macierzy | 1 (cała wariancja) | Wspólności h² (tylko wariancja wspólna) |
| Błąd pomiaru | Wchodzi do składowych | Oddzielony jako wariancja swoista |
| Model zmiennej ukrytej | Brak – składowa to ważona suma pozycji | Tak – czynnik wyjaśnia korelacje pozycji |
| Ładunki | Zawyżone, zwłaszcza przy małej liczbie pozycji | Bliższe ładunkom populacyjnym |
| Korelacje czynników po rotacji ukośnej | Zaniżone | Bliższe prawdziwym |
Velicer i Jackson (1990) zestawili argumenty obu stron, m.in. liczbowe podobieństwo rozwiązań i problem rozwiązań niewłaściwych. Takie rozwiązania, np. przypadek Heywooda, zdarzają się w modelu czynnikowym, a w PCA nie, bo na przekątnej zawsze stoi 1. Widaman (1993) pokazał jednak, że różnica w ładunkach zależy od liczby wskaźników na czynnik – im mniej pozycji, tym silniej PCA zawyża ładunki. Przy skorelowanych wymiarach zaniża też korelacje między nimi. W symulacjach de Wintera i Dodou (2016) ładunki PCA były wyższe i stabilniejsze, ale słabiej odzwierciedlały prawdziwe ładunki przy zbyt małej lub zbyt dużej liczbie wymiarów i przy nierównych ładunkach. Fabrigar i in. (1999) zaliczają wybór modelu i metody ekstrakcji do kluczowych decyzji w EFA, które badacze często podejmują w wątpliwy sposób. Spór trwa od dekad, a Gorsuch (1990) wniósł do niego komentarz o faktach „dobrze i mało znanych”.
Przykład: ta sama skala, dwie metody ekstrakcji
Trzysta osób studiujących wypełniło krótką skalę lęku przed egzaminem: trzy pozycje mierzą zamartwianie się (zam1–zam3), trzy – emocjonalność, czyli objawy fizjologiczne (emo1–emo3); odpowiedzi 1–5. Dane symulowano z modelu dwuczynnikowego o ładunkach .55 i korelacji czynników .40. Po pocięciu odpowiedzi na pięć kategorii ładunki w danych są nieco niższe, około .50. Te same dane przeanalizowano dwiema metodami ekstrakcji – z dwoma czynnikami i rotacją oblimin.
| Pozycja | Ładunek PC | Ładunek PAF | h² PC | h² PAF |
|---|---|---|---|---|
| zam1 | .75 | .57 | .55 | .31 |
| zam2 | .62 | .42 | .45 | .23 |
| zam3 | .72 | .46 | .50 | .21 |
| emo1 | .73 | .60 | .55 | .37 |
| emo2 | .72 | .48 | .50 | .22 |
| emo3 | .68 | .47 | .47 | .22 |
| Korelacja wymiarów | PC: .16 | PAF: .33 | |||
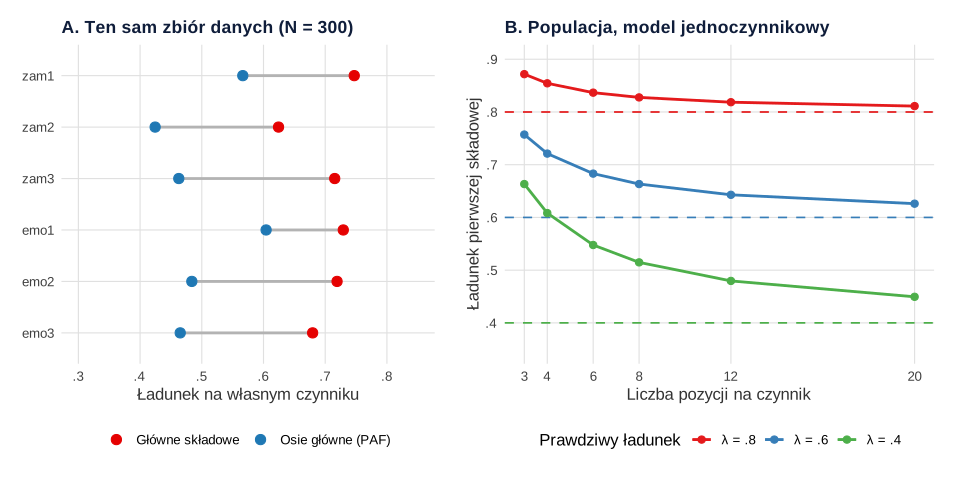
Ładunki na „własnym” wymiarze wynoszą średnio .70 przy PC i .50 przy PAF. Rozwiązanie PC wygląda imponująco – wszystkie ładunki powyżej .60 – ale ta przewaga jest artefaktem: składowe przejmują także wariancję swoistą i błąd. Metoda PC sugeruje, że pozycje mierzą konstrukt prawie dwa razy lepiej (wspólności .45–.55 zamiast .21–.37), niż jest w rzeczywistości. Korelacja między zamartwianiem się a emocjonalnością spada z .33 do .16, co mogłoby skłonić do błędnego wniosku, że to prawie niezależne wymiary.
Od czego zależy zawyżenie ładunków?
W modelu jednoczynnikowym z p pozycjami o jednakowym ładunku λ ładunek pierwszej składowej w populacji ma prostą postać:
Panel B rysunku 1 pokazuje ten wzór w liczbach. Przy λ = .50 ładunek składowej wynosi .71 dla 3 pozycji, .61 dla 6, .56 dla 12 i .54 dla 20. Przy słabszych pozycjach (λ = .40) zawyżenie jest jeszcze większe: .66 dla 3 pozycji. Przy silnych (λ = .80) maleje: .87 dla 3 i .81 dla 20 pozycji. Wniosek praktyczny: krótkie podskale i umiarkowane ładunki to dokładnie warunki typowych kwestionariuszy psychologicznych, w których różnica jest największa. W długich testach z silnymi pozycjami PC i PAF dają zbliżone wyniki.
Kiedy metoda głównych składowych jest w porządku?
- Gdy celem jest redukcja danych, a nie model konstruktu – np. połączenie sześciu wskaźników aktywności w jeden indeks albo ograniczenie liczby predyktorów przy współliniowości.
- Jako szybki wstępny przegląd struktury, jeśli dalsze decyzje i raport opierasz na modelu czynników wspólnych.
- Gdy metoda PAF lub ML nie zbiega się albo daje wspólności większe od 1 – wtedy jednak najpierw szukaj przyczyny (za dużo czynników, za mało osób, pozycje prawie identyczne).
Jeżeli piszesz o konstruktach – lęku, wsparciu, osobowości – i chcesz potem sprawdzić strukturę w CFA, wybierz w SPSS ekstrakcję „Principal axis factoring” lub „Maximum likelihood”, a w R psych::fa() zamiast principal(). Rozwiązanie PC daje ładunki, których CFA nie potwierdzi w tej samej wysokości.
Jak opisać metodę ekstrakcji w pracy (APA)
Nazwij metodę precyzyjnie. Jeśli użyłeś głównych składowych, nie pisz „analiza czynnikowa”, tylko „analiza głównych składowych z rotacją oblimin”, i uzasadnij wybór celem analizy. Jeśli użyłeś PAF, napisz to wprost – recenzent często sprawdza właśnie ten szczegół.
Wzór tabeli znajdziesz w haśle tabela analizy czynnikowej w APA, a pełną ścieżkę decyzji – w poradniku Analiza czynnikowa EFA i CFA.
Przykład w R
Kod generuje dane z przykładu, wykonuje ekstrakcję metodą głównych składowych (psych::principal) i metodą osi głównych (psych::fa, fm = "pa"), porównuje ładunki, wspólności i korelację wymiarów, a na końcu liczy zawyżenie ładunków PC w populacji ze wzoru i sprawdza wzór na macierzy populacyjnej.
Główne składowe a osie główne na tych samych danych
R
# R170 – metoda głównych składowych jako metoda ekstrakcji w analizie czynnikowej
# Dane symulowane: 6 pozycji skali lęku przed egzaminem – 3 pozycje „zamartwianie się”,
# 3 pozycje „emocjonalność”; ładunki populacyjne .55, korelacja czynników .40; N = 300, odpowiedzi 1–5
suppressPackageStartupMessages({library(MASS); library(psych); library(GPArotation)})
set.seed(170)
L <- matrix(0, 6, 2); L[1:3, 1] <- .55; L[4:6, 2] <- .55
Phi <- matrix(c(1, .40, .40, 1), 2)
Sigma <- L %*% Phi %*% t(L); diag(Sigma) <- 1
z <- mvrnorm(300, rep(0, 6), Sigma)
dane <- as.data.frame(apply(z, 2, function(x) as.integer(cut(x, c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf)))))
names(dane) <- c("zam1", "zam2", "zam3", "emo1", "emo2", "emo3")

# Ekstrakcja metodą głównych składowych (jak domyślnie w SPSS: Principal components)
pc <- principal(dane, nfactors = 2, rotate = "oblimin")
# Ekstrakcja metodą osi głównych (czynniki wspólne)
paf <- fa(dane, nfactors = 2, fm = "pa", rotate = "oblimin")

ladunki <- data.frame(PC_1 = pc$loadings[, 1], PC_2 = pc$loadings[, 2],
                      PAF_1 = paf$loadings[, 1], PAF_2 = paf$loadings[, 2])
round(ladunki, 2)
round(cbind(h2_PC = pc$communality, h2_PAF = paf$communality), 2)
round(c(korelacja_PC = pc$Phi[1, 2], korelacja_PAF = paf$Phi[1, 2]), 2)
round(c(sr_ladunek_PC = mean(apply(abs(pc$loadings), 1, max)),
        sr_ladunek_PAF = mean(apply(abs(paf$loadings), 1, max))), 2)

# Populacja: o ile PCA zawyża ładunek przy jednym czynniku o ładunku λ i p pozycjach
# (ładunek pierwszej składowej = sqrt((1 + (p − 1) λ²) / p))
pop <- expand.grid(lambda = c(.4, .5, .6, .7, .8), p = c(3, 4, 6, 8, 12, 20))
pop$ladunek_PCA <- with(pop, sqrt((1 + (p - 1) * lambda^2) / p))
# sprawdzenie wzoru na macierzy populacyjnej dla λ = .5, p = 3
S <- matrix(.25, 3, 3); diag(S) <- 1
round(sqrt(eigen(S)$values[1]) * abs(eigen(S)$vectors[, 1]), 3)
round(reshape(pop, idvar = "lambda", timevar = "p", direction = "wide"), 2)
Wynik w R
      PC_1  PC_2 PAF_1 PAF_2
zam1 -0.04  0.75 -0.04  0.57
zam2  0.17  0.62  0.13  0.42
zam3 -0.05  0.72 -0.01  0.46
emo1  0.73  0.07  0.60  0.02
emo2  0.72 -0.09  0.48 -0.05
emo3  0.68  0.02  0.47  0.01
     h2_PC h2_PAF
zam1  0.55   0.31
zam2  0.45   0.23
zam3  0.50   0.21
emo1  0.55   0.37
emo2  0.50   0.22
emo3  0.47   0.22
 korelacja_PC korelacja_PAF
         0.16          0.33
 sr_ladunek_PC sr_ladunek_PAF
           0.7            0.5
[1] 0.707 0.707 0.707
  lambda ladunek_PCA.3 ladunek_PCA.4 ladunek_PCA.6 ladunek_PCA.8 ladunek_PCA.12
1    0.4          0.66          0.61          0.55          0.51           0.48
2    0.5          0.71          0.66          0.61          0.59           0.56
3    0.6          0.76          0.72          0.68          0.66           0.64
4    0.7          0.81          0.79          0.76          0.74           0.73
5    0.8          0.87          0.85          0.84          0.83           0.82
  ladunek_PCA.20
1           0.45
2           0.54
3           0.63
4           0.72
5           0.81
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; ekstrakcję wykonano pakietem psych (rotacja oblimin z GPArotation), dane wygenerowano pakietem MASS, rysunek przygotowano w ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Nazywanie PCA analizą czynnikową – jeśli w SPSS zostawiłeś domyślne „Principal components”, w pracy napisz, że to analiza głównych składowych.
- Chwalenie się wysokimi ładunkami z PC – przy trzech–czterech pozycjach na wymiar ładunki są zawyżone – w przykładzie o .13–.26; nie porównuj ich z ładunkami z CFA ani z innych badań opartych na PAF lub ML.
- Wniosek o niezależności wymiarów – po ekstrakcji PC korelacje wymiarów są zaniżone; w przykładzie .16 zamiast .33.
- Łączenie PC z kryterium Kaisera bez refleksji – domyślny zestaw SPSS (główne składowe + wartości własne > 1) to dwie decyzje podjęte automatycznie; sprawdź je obie, zob. metoda Kaisera.
- Interpretowanie h² z PC jako wspólności – przy PC „wspólność” zawiera też wariancję swoistą; prawdziwe zasoby zmienności wspólnej szacuje model czynnikowy.
Najczęstsze pytania
Czy metoda głównych składowych to analiza czynnikowa?
Formalnie nie. Główne składowe są ważonymi sumami pozycji i obejmują całą ich wariancję, także błąd pomiaru, a model czynnikowy wyjaśnia tylko wariancję wspólną. W SPSS obie metody są w tym samym oknie, dlatego w raporcie nazwij dokładnie metodę ekstrakcji, której użyłeś.
Dlaczego ładunki z głównych składowych są wyższe niż z osi głównych?
Bo składowe przejmują także wariancję swoistą pozycji. Zawyżenie jest największe przy niewielu pozycjach na wymiar i umiarkowanych ładunkach: przy trzech pozycjach o prawdziwym ładunku .50 ładunek pierwszej składowej wynosi w populacji .71. Przy 20 pozycjach różnica maleje do .54 wobec .50.
Którą metodę ekstrakcji wybrać w SPSS do pracy magisterskiej?
Jeśli badasz strukturę skali psychologicznej i interesują Cię konstrukty, wybierz osie główne (Principal axis factoring) lub największą wiarygodność (Maximum likelihood). Główne składowe zostaw na sytuacje, w których chcesz po prostu zredukować wiele zmiennych do kilku indeksów.
Czy po ekstrakcji głównymi składowymi można robić CFA?
Można, ale nie oczekuj, że CFA potwierdzi ładunki w tej samej wysokości – ładunki z głównych składowych są zawyżone. Do przygotowania CFA lepiej nadaje się EFA z modelem czynników wspólnych, najlepiej na innej próbie niż ta, na której testujesz model.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- de Winter, J. C. F., & Dodou, D. (2016). Common factor analysis versus principal component analysis: A comparison of loadings by means of simulations. Communications in Statistics – Simulation and Computation, 45(1), 299–321. https://doi.org/10.1080/03610918.2013.862274 ● Otwarty dostęp: pełny tekst
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Gorsuch, R. L. (1990). Common factor analysis versus component analysis: Some well and little known facts. Multivariate Behavioral Research, 25(1), 33–39. https://doi.org/10.1207/s15327906mbr2501_3
- Velicer, W. F., & Jackson, D. N. (1990). Component analysis versus common factor analysis: Some issues in selecting an appropriate procedure. Multivariate Behavioral Research, 25(1), 1–28. https://doi.org/10.1207/s15327906mbr2501_1
- Widaman, K. F. (1993). Common factor analysis versus principal component analysis: Differential bias in representing model parameters? Multivariate Behavioral Research, 28(3), 263–311. https://doi.org/10.1207/s15327906mbr2803_1
Cytowania BibTeX
@article{dewinter2016common, author={de Winter, Joost C. F. and Dodou, Dimitra}, title={{Common factor analysis versus principal component analysis: A comparison of loadings by means of simulations}}, journal={Communications in Statistics – Simulation and Computation}, year={2016}, volume={45}, number={1}, pages={299--321}, doi={10.1080/03610918.2013.862274}}@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{gorsuch1990common, author={Gorsuch, Richard L.}, title={{Common factor analysis versus component analysis: Some well and little known facts}}, journal={Multivariate Behavioral Research}, year={1990}, volume={25}, number={1}, pages={33--39}, doi={10.1207/s15327906mbr2501_3}}@article{velicer1990component, author={Velicer, Wayne F. and Jackson, Douglas N.}, title={{Component analysis versus common factor analysis: Some issues in selecting an appropriate procedure}}, journal={Multivariate Behavioral Research}, year={1990}, volume={25}, number={1}, pages={1--28}, doi={10.1207/s15327906mbr2501_1}}@article{widaman1993common, author={Widaman, Keith F.}, title={{Common factor analysis versus principal component analysis: Differential bias in representing model parameters?}}, journal={Multivariate Behavioral Research}, year={1993}, volume={28}, number={3}, pages={263--311}, doi={10.1207/s15327906mbr2803_1}}