Co to jest PCA?
PCA, czyli analiza głównych składowych (ang. principal component analysis), to technika redukcji wymiaru: zamienia zestaw skorelowanych zmiennych w nowe, nieskorelowane zmienne – główne składowe – z których każda jest ważoną sumą zmiennych wyjściowych. Pierwsza składowa ma największą możliwą wariancję, druga – największą spośród kierunków prostopadłych do pierwszej, i tak dalej. Jolliffe i Cadima (2016) podkreślają, że wyznaczenie składowych sprowadza się do znalezienia wartości i wektorów własnych macierzy kowariancji lub korelacji, a składowe wynikają z danych, a nie z założonego z góry modelu.
Idea pochodzi od Pearsona (1901), który szukał prostych i płaszczyzn najlepiej dopasowanych do chmury punktów. Nazwę i rozwinięcie dla zestawu zmiennych psychologicznych zawdzięczamy Hotellingowi (1933). W psychologii PCA służy do budowania indeksów (np. wskaźnika ogólnego funkcjonowania poznawczego z kilku testów), do ograniczania liczby predyktorów skorelowanych ze sobą i do wstępnego przeglądu struktury danych.
Jak działa PCA – geometria i wzory
Dla p zmiennych standaryzowanych składowa to kombinacja liniowa z wagami a, czyli elementami wektora własnego macierzy korelacji R:
Wariancja składowej równa się jej wartości własnej λ, a suma wartości własnych – liczbie zmiennych p. Odsetek wariancji wyjaśnianej przez składową to λ / p. Ładunek to korelacja zmiennej ze składową: wektor własny (wagi) przeskalowany pierwiastkiem z wartości własnej. Wagi i ładunki to więc dwie różne tabele, które programy pokazują pod podobnymi nazwami.
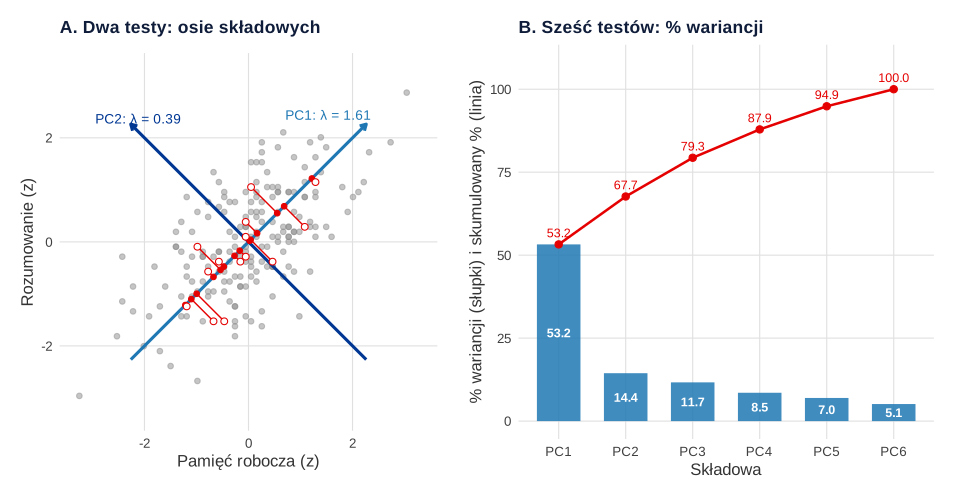
Najprościej zobaczyć to na dwóch zmiennych. Pamięć robocza i rozumowanie w przykładzie poniżej korelują na poziomie r = .61. Dla dwóch standaryzowanych zmiennych wartości własne wynoszą 1 + r i 1 − r (tu 1.61 i 0.39), a osie składowych leżą zawsze pod kątem 45° – wagi to ±.707. Pierwsza składowa biegnie wzdłuż „długiej osi” chmury punktów i jest po prostu przeskalowaną sumą obu wyników. Druga – ich różnicą (rysunek 1A). Rzutowanie punktów na pierwszą oś zachowuje 80% informacji (1.61 / 2).
Przykład: indeks funkcjonowania poznawczego z sześciu testów
Dwieście dorosłych osób wykonało sześć testów poznawczych: pamięć roboczą, szybkość przetwarzania, uwagę, fluencję słowną, rozumowanie i słownictwo (wyniki w skali T; średnie 49.5–50.5, SD 9.0–10.5; dane symulowane). Celem jest jeden lub dwa wskaźniki zamiast sześciu wyników. PCA na macierzy korelacji dała następujące wyniki:
| Test | Ładunek PC1 | Ładunek PC2 | Waga PC1 (wektor własny) |
|---|---|---|---|
| Pamięć robocza | .80 | .03 | .445 |
| Szybkość przetwarzania | .66 | .53 | .370 |
| Uwaga | .72 | .42 | .404 |
| Fluencja słowna | .69 | −.19 | .386 |
| Rozumowanie | .79 | −.16 | .444 |
| Słownictwo | .71 | −.59 | .395 |
| Wartość własna (% wariancji) | 3.20 (53.2%) | 0.87 (14.4%) |
Pierwsza składowa ma dodatnie ładunki .66–.80 dla wszystkich testów i wyjaśnia 53.2% wariancji – to ogólny wskaźnik sprawności poznawczej. Druga (14.4%) jest dwubiegunowa: szybkość i uwaga po stronie dodatniej, słownictwo po ujemnej. Odróżnia więc osoby szybkie od osób z dużą wiedzą werbalną. Dwie składowe zachowują 67.7% wariancji sześciu testów. Ponieważ wagi PC1 są prawie równe (.37–.45), wynik pierwszej składowej koreluje z prostą sumą wyników standaryzowanych na poziomie r = .9995. W praktyce pierwsza składowa uzasadnia tu po prostu zsumowanie testów.
Wyniki składowych (pca$x w R) mają średnią 0, wariancję równą wartości własnej (3.20 i 0.87) i są wzajemnie nieskorelowane (r = 0). Można ich użyć jako predyktorów w regresji wielorakiej bez problemu współliniowości, pamiętając, że interpretacja składowej wynika z jej ładunków.
Decyzje w PCA: standaryzacja i liczba składowych
Macierz korelacji czy kowariancji? PCA na macierzy kowariancji (dane niestandaryzowane) daje przewagę zmiennym o dużej wariancji. W przykładzie wystarczy zapisać szybkość przetwarzania w milisekundach zamiast w skali T: pierwsza składowa staje się wtedy prawie wyłącznie „szybkością” (waga −.99) i „wyjaśnia” 92.8% wariancji – wyłącznie z powodu jednostek. Gdy zmienne mają różne jednostki, analizuj macierz korelacji (scale. = TRUE), czyli standaryzuj zmienne.
Ile składowych zachować? W redukcji danych decyduje cel: indeks ogólny – jedna składowa; zachowanie np. 80% informacji – tyle składowych, ile potrzeba (tu cztery, 87.9%). Pomocnicze reguły to kryterium Kaisera (tutaj 1 składowa), wykres osypiska, kryterium procenta wyjaśnianej wariancji i analiza równoległa.
Rotować czy nie? Jeśli zachowujesz kilka składowych i chcesz je nazwać, możesz je obrócić, np. rotacją varimax. Rotacja zmienia podział wariancji między składowe, ale nie zmienia łącznej wariancji wyjaśnianej przez cały zestaw. Obrócone składowe tracą jednak własność „pierwsza wyjaśnia najwięcej”. Przy budowie jednego indeksu ogólnego rotacja nie jest potrzebna.
PCA a eksploracyjna analiza czynnikowa
PCA i EFA bywają mylone, bo w SPSS siedzą w tym samym oknie. To jednak dwa różne modele. PCA opisuje całą wariancję zmiennych i nie zakłada żadnej zmiennej ukrytej – składowa to suma ważona. EFA zakłada, że korelacje pozycji wynikają ze wspólnych czynników, i oddziela wariancję wspólną od swoistej (wspólności). Velicer i Jackson (1990) omawiają podobieństwa i różnice obu podejść: rozwiązania bywają liczbowo zbliżone, a zasadnicza różnica dotyczy tego, czy wymiary traktujemy jako zmienne ukryte, czy jako sumy zmiennych jawnych. Jeśli badasz strukturę kwestionariusza i konstrukty, wybierz EFA; co się dzieje, gdy użyjesz PCA jako metody ekstrakcji w analizie czynnikowej, pokazujemy w haśle metoda głównych składowych (analiza czynnikowa).
Jak opisać PCA w pracy (APA)
Podaj cel (redukcja danych), macierz (korelacji), liczbę zachowanych składowych z uzasadnieniem, wartości własne i procent wariancji, ładunki oraz sposób utworzenia wyników (wyniki składowych czy suma). Jeśli stosujesz rotację składowych, napisz to wprost.
Tabelę ładunków przygotujesz według wzoru tabeli analizy czynnikowej w APA. Szerszy kontekst – kiedy redukcja danych, a kiedy model czynnikowy – opisujemy w poradniku Analiza czynnikowa EFA i CFA.
Przykład w R
Kod generuje wyniki sześciu testów, wykonuje PCA funkcją prcomp(), oblicza wartości własne, ładunki i wagi, sprawdza własności wyników składowych, porównuje PC1 z sumą wyników z, liczy odsetek odtworzonej informacji, pokazuje skutek braku standaryzacji i geometrię PCA dla dwóch testów.
Analiza głównych składowych funkcją prcomp()
R
# R172 – PCA (analiza głównych składowych) jako redukcja wymiaru
# Dane symulowane: 6 testów poznawczych u 200 osób dorosłych (wyniki w skali T, M = 50, SD = 10)
suppressPackageStartupMessages(library(MASS))
set.seed(172)
nazwy <- c("pamiec_robocza", "szybkosc", "uwaga", "fluencja", "rozumowanie", "slownictwo")
K <- matrix(c(1.00, .45, .50, .35, .55, .40,
              .45, 1.00, .55, .30, .40, .20,
              .50, .55, 1.00, .30, .45, .25,
              .35, .30, .30, 1.00, .40, .55,
              .55, .40, .45, .40, 1.00, .50,
              .40, .20, .25, .55, .50, 1.00), 6, dimnames = list(nazwy, nazwy))
testy <- as.data.frame(round(mvrnorm(200, rep(50, 6), K * 100)))
round(sapply(testy, function(x) c(M = mean(x), SD = sd(x))), 2)

pca <- prcomp(testy, center = TRUE, scale. = TRUE)   # PCA na macierzy korelacji
summary(pca)$importance                            # SD składowych, % i skumulowany % wariancji
round(pca$sdev^2, 3)                               # wartości własne
ladunki <- pca$rotation %*% diag(pca$sdev)         # ładunki = wektor własny × √wartość własna
colnames(ladunki) <- paste0("PC", 1:6)
round(ladunki[, 1:2], 2)
round(pca$rotation[, 1:2], 3)                      # wagi (wektory własne)

# Wyniki składowych: średnia 0, wariancja = wartość własna, składowe nieskorelowane
wyniki <- pca$x[, 1:2]
round(c(colMeans(wyniki), apply(wyniki, 2, var)), 3)
round(cor(wyniki)[1, 2], 3)
# PC1 a zwykła suma wyników z
round(cor(wyniki[, 1], rowSums(scale(testy))), 4)

# Jak dobrze 2 składowe odtwarzają dane (standaryzowane)?
Z <- scale(testy)
Z2 <- wyniki %*% t(pca$rotation[, 1:2])
round(1 - sum((Z - Z2)^2) / sum(Z^2), 3)

# Bez standaryzacji wynik zależy od jednostek: „szybkość” w milisekundach zamiast skali T
testy_ms <- testy; testy_ms$szybkosc <- 800 - 8 * testy$szybkosc
round(prcomp(testy_ms, scale. = FALSE)$rotation[, 1], 3)
round(summary(prcomp(testy_ms, scale. = FALSE))$importance[2, 1], 3)

# Geometria PCA dla dwóch testów: pamięć robocza i rozumowanie (wyniki z)
dwa <- scale(testy[, c("pamiec_robocza", "rozumowanie")])
pca2 <- prcomp(dwa)
round(cor(dwa)[1, 2], 3)
round(pca2$sdev^2, 3)          # wartości własne = 1 ± r
round(pca2$rotation, 3)
Wynik w R
   pamiec_robocza szybkosc uwaga fluencja rozumowanie slownictwo
M           49.52    49.88 50.48    49.94       49.98      50.53
SD           9.69     8.98  9.71     9.46       10.46       9.93
                            PC1       PC2       PC3       PC4       PC5
Standard deviation     1.787355 0.9305579 0.8368405 0.7158443 0.6467248
Proportion of Variance 0.532440 0.1443200 0.1167200 0.0854100 0.0697100
Cumulative Proportion  0.532440 0.6767600 0.7934800 0.8788900 0.9485900
                             PC6
Standard deviation     0.5553698
Proportion of Variance 0.0514100
Cumulative Proportion  1.0000000
[1] 3.195 0.866 0.700 0.512 0.418 0.308
                PC1   PC2
pamiec_robocza 0.80  0.03
szybkosc       0.66  0.53
uwaga          0.72  0.42
fluencja       0.69 -0.19
rozumowanie    0.79 -0.16
slownictwo     0.71 -0.59
                 PC1    PC2
pamiec_robocza 0.445  0.031
szybkosc       0.370  0.566
uwaga          0.404  0.451
fluencja       0.386 -0.199
rozumowanie    0.444 -0.176
slownictwo     0.395 -0.636
  PC1   PC2   PC1   PC2
0.000 0.000 3.195 0.866
[1] 0
[1] 0.9995
[1] 0.677
pamiec_robocza       szybkosc          uwaga       fluencja    rozumowanie
         0.062         -0.992          0.066          0.052          0.058
    slownictwo
         0.037
[1] 0.928
[1] 0.607
[1] 1.607 0.393
                 PC1    PC2
pamiec_robocza 0.707 -0.707
rozumowanie    0.707  0.707
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja prcomp() z pakietu stats); dane wygenerowano pakietem MASS, rysunek przygotowano w ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- PCA na zmiennych w różnych jednostkach bez standaryzacji – składowe odzwierciedlają wtedy skalę pomiaru, nie strukturę danych.
- Mylenie wag z ładunkami – do interpretacji służą ładunki (korelacje ze składową), do obliczania wyników – wagi.
- Nazywanie składowych konstruktami – składowa to suma ważona zmiennych, a nie zmienna ukryta; o konstruktach mówi model czynnikowy.
- Interpretowanie znaku składowej – kierunek osi jest dowolny: program może odwrócić wszystkie znaki ładunków bez zmiany rozwiązania.
- Zachowanie tylu składowych, ile „wyjdzie” z Kaisera – liczbę składowych wyznacza cel analizy; reguły traktuj pomocniczo.
- PCA na kilku zmiennych prawie nieskorelowanych – jeśli korelacje są bliskie zera, każda składowa wyjaśnia około 1/p wariancji i redukcja nie ma sensu.
Najczęstsze pytania
Co to jest PCA w prostych słowach?
PCA szuka kierunków, wzdłuż których dane różnią się najbardziej, i opisuje każdą osobę kilkoma liczbami zamiast wieloma. Pierwsza składowa streszcza najwięcej informacji, następne – coraz mniej. Przy sześciu skorelowanych testach poznawczych pierwsza składowa może zachować ponad połowę informacji i posłużyć jako ogólny wskaźnik.
Czym różnią się ładunki od wag w PCA?
Wagi (wektory własne) mówią, z jakimi współczynnikami sumować zmienne, aby obliczyć wynik składowej. Ładunki to korelacje zmiennych ze składową, czyli wagi pomnożone przez pierwiastek z wartości własnej. Do interpretacji składowych używaj ładunków.
Czy przed PCA trzeba standaryzować zmienne?
Tak, jeśli zmienne mają różne jednostki lub bardzo różne wariancje – wtedy analizuj macierz korelacji (w R: prcomp(dane, scale. = TRUE)). Bez standaryzacji pierwsza składowa odzwierciedla zmienną o największej wariancji, co może wynikać wyłącznie z jednostek pomiaru.
Kiedy wybrać PCA, a kiedy analizę czynnikową?
PCA, gdy chcesz zredukować liczbę zmiennych lub zbudować indeks i nie zakładasz zmiennej ukrytej. Analizę czynnikową, gdy chcesz poznać strukturę kwestionariusza i oszacować czynniki wspólne, oddzielone od błędu pomiaru, np. przed konfirmacyjną analizą czynnikową.
Dlaczego składowe PCA są nieskorelowane?
Bo wektory własne macierzy korelacji są wzajemnie prostopadłe, a wyniki składowych to rzuty danych na te prostopadłe osie. Dzięki temu składowe można wprowadzić razem do regresji bez problemu współliniowości.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology, 24(6), 417–441. https://doi.org/10.1037/h0071325
- Jolliffe, I. T., & Cadima, J. (2016). Principal component analysis: A review and recent developments. Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences, 374(2065), Article 20150202. https://doi.org/10.1098/rsta.2015.0202 ● Otwarty dostęp: pełny tekst
- Pearson, K. (1901). On lines and planes of closest fit to systems of points in space. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 2(11), 559–572. https://doi.org/10.1080/14786440109462720
- Velicer, W. F., & Jackson, D. N. (1990). Component analysis versus common factor analysis: Some issues in selecting an appropriate procedure. Multivariate Behavioral Research, 25(1), 1–28. https://doi.org/10.1207/s15327906mbr2501_1
Cytowania BibTeX
@article{hotelling1933analysis, author={Hotelling, Harold}, title={{Analysis of a complex of statistical variables into principal components}}, journal={Journal of Educational Psychology}, year={1933}, volume={24}, number={6}, pages={417--441}, doi={10.1037/h0071325}}@article{jolliffe2016principal, author={Jolliffe, Ian T. and Cadima, Jorge}, title={{Principal component analysis: A review and recent developments}}, journal={Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences}, year={2016}, volume={374}, number={2065}, eid={20150202}, doi={10.1098/rsta.2015.0202}}@article{pearson1901lines, author={Pearson, Karl}, title={{On lines and planes of closest fit to systems of points in space}}, journal={The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science}, year={1901}, volume={2}, number={11}, pages={559--572}, doi={10.1080/14786440109462720}}@article{velicer1990component, author={Velicer, Wayne F. and Jackson, Douglas N.}, title={{Component analysis versus common factor analysis: Some issues in selecting an appropriate procedure}}, journal={Multivariate Behavioral Research}, year={1990}, volume={25}, number={1}, pages={1--28}, doi={10.1207/s15327906mbr2501_1}}